TL;DR
想在本地一张 GPU 上跑长上下文模型,大家的默认答案是"量化压缩硬塞"。弗赖堡大学和 Computing Flows 的两位作者把 GPT 家族和 Qwen3 放到三代 NVIDIA 显卡上做了逐内核剖析,结论反转:单用户长上下文推理时 GPU 根本没被跑满------注意力内核占掉 90% 运行时间,带宽却只用到 21%;最新最贵的 Blackwell 在这件事上表现几乎和上一代持平。瓶颈在内核与编译器,不在硬件容量。做推理优化、内核工程或本地部署的工程师,这篇值得精读。
导语:你的 4090 真的尽力了吗
先问一个可能戳到你的问题:你在本地跑大模型,是不是也默认过一句话------"上下文一长就得量化,不然显存装不下,装下了也慢"?
这个叙事听得太多了。可它有个没被验证过的前提:慢,是因为卡不行。如果你开过 Nsight 这类 profiler 盯过本地推理,大概率看到过一些奇怪的空隙------GPU 明明没跑满,利用率曲线却上不去。多数人的反应是" profiler 看不懂,算了"。
一篇 2026 年 10 月 20 日挂上 arXiv 的论文把这些"看不懂的空隙"系统量了出来:《Local Inference of LLMs on Long Contexts: A Data Systems Perspective》(弗赖堡大学 Mattias Dürrmeier 与 Computing Flows 的 Alberto Lerner)。他们把三个代际的模型放到三代显卡上,从 1 个 token 一路测到 100 万 token 上下文,每个内核挨个量运行时间、带宽和算力。结论是:卡不是不行,是没人好好用它。
想自己读原文?
- 📄 论文:arXiv 2610.28223
- 🌐 HTML 全文:arxiv.org/html/2610.2...
这篇论文到底想解决什么问题?
先把场景摆正。这里说的不是数据中心里那种"一个模型服务一万个用户"的推理,而是单用户本地推理:你自己的机器、一张卡、batch size 为 1。它的好处很实际------没有按 token 计费、没有限速、敏感数据不出门,模型想换就换。对 agent 这类异步工作负载(发起任务后你并不盯着下一个 token 跳出来),本地推理其实是个甜点区。
问题在于,主流的推理系统研究几乎全在优化"多用户高吞吐"场景,单用户 decode 的性能特征一直没人认真刻画。已有的共识是两条:推理是访存受限(memory-bound)的;本地跑长上下文主要卡在显存容量,所以要么量化(quantization,把权重和缓存用更低精度存),要么分页换入换出。
作者问了一个更根本的问题:把容量问题放到一边,这张卡到底被用得怎么样? 如果 GPU 其实还有大量富余,那"压缩换容量"的默认路线可能整个方向就偏了------你在用精度换本不需要省的资源。
它的思路是什么?
测长上下文有个先有鸡还是先有蛋的死结:模型太大装不进卡,装不进就测不了。作者的解法很聪明------模型是一摞一模一样的 decoder block(解码块),那就只测一块。一块在任何卡上都放得下,于是任意模型 × 任意 GPU 的组合都能测,还顺便保证了所有模型在同一个 PyTorch 编译栈下公平对比。
实验设计用两个家族分别控制变量:
- GPT 家族(GPT-2 → GPT-3 → GPT-OSS):架构代际进化(多头注意力 → 分组查询注意力 GQA + 混合专家 MoE + 旋转位置编码 RoPE),各自配同时代的显卡(Turing → Ada → Blackwell),看"架构进化如何改变负载"。
- Qwen3 家族(4B / 8B / 32B):架构完全相同、只有规模不同,同一套架构跑遍三代显卡,看"硬件进化到底加速了什么"。
测量工具是 Nsight Compute,冷缓存、不锁频,逐内核记录运行时间、算力和带宽占用。先看一张全景图------一个现代模型的 decoder block 编译出来长什么样:
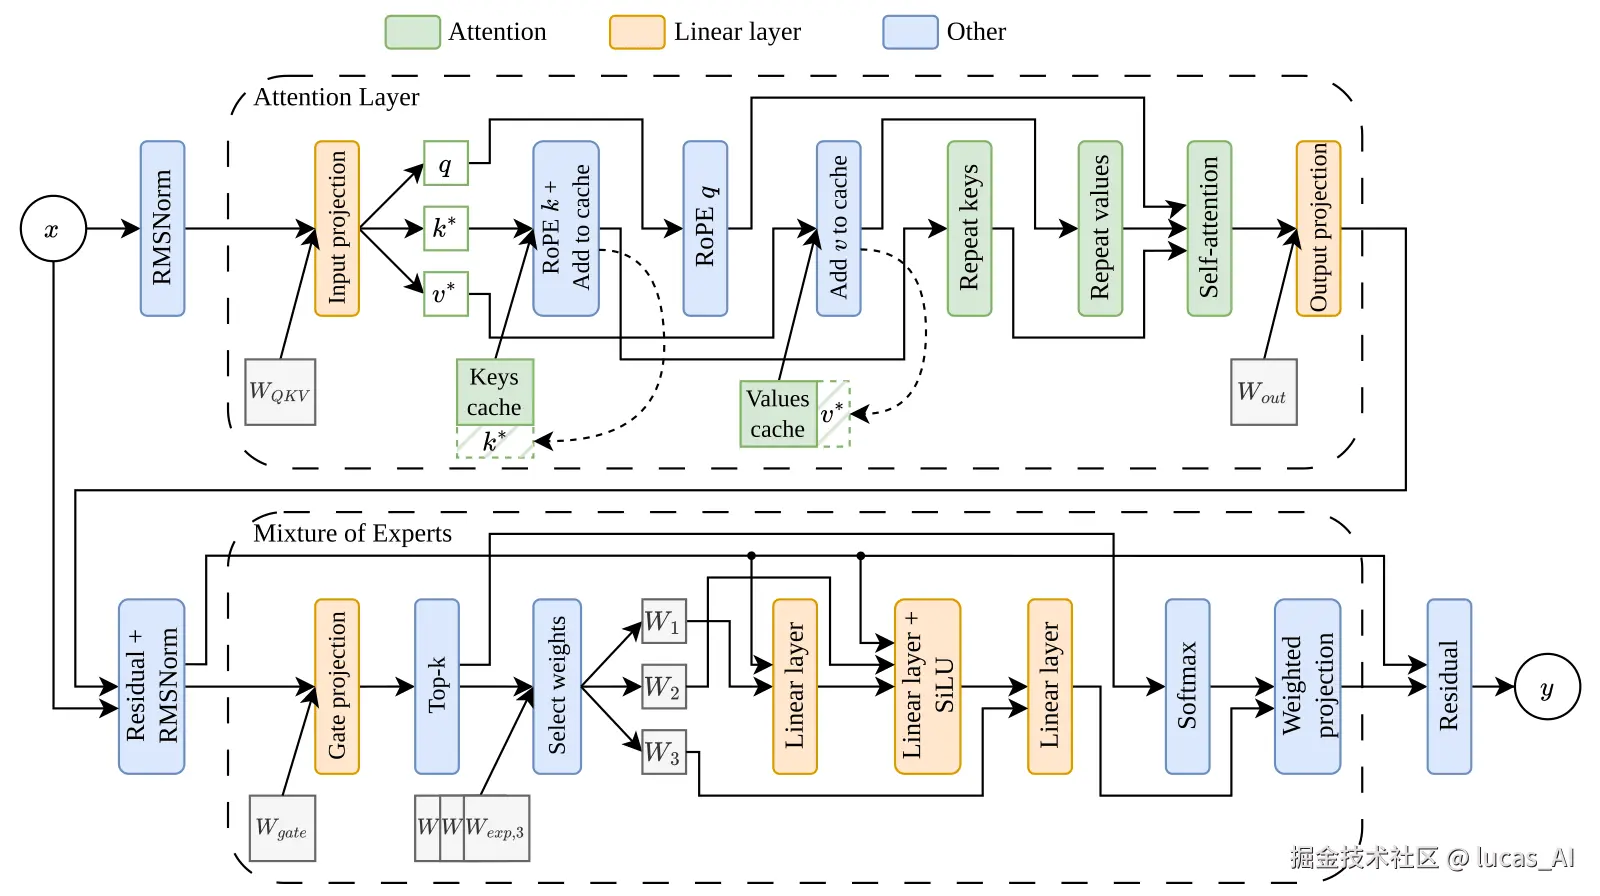 图说:一个 block 被编译成一长串大小悬殊的内核,内核之间靠全局显存传递中间结果------每一次传递都在消耗带宽。
看到问题了吗?GPT-2 那个年代的 block 编译出来只有 13 个内核,到了 GPT-OSS 是 21 个。架构越现代,注意力周围长出来的"准备工序"越多------给 GQA 复制缓存的 repeat、MoE 的门控、top-k 选择、排序......编译器只融合了少数几个,剩下的各自为政,内核之间还插着隐式同步:上一个没跑完,下一个不许动。
而 decode 的成本结构有个关键的不对称:除了注意力,其它部分每个 token 的开销是固定的;只有注意力要回头看越来越长的 KV cache(键值缓存,存着所有历史 token 的"记忆")。这个不对称是全文所有结论的支点。
效果到底怎么样?
七条测量发现里,有三条最扎心。
第一条:长上下文下,注意力吞掉几乎全部时间。 到几十万 token 的上下文,注意力占运行时间的 90% 以上;就算是架构很现代的 GPT-OSS,8K token 时注意力就已占一半。换句话说,长上下文 decode 的优化问题约等于"注意力内核优化问题"。
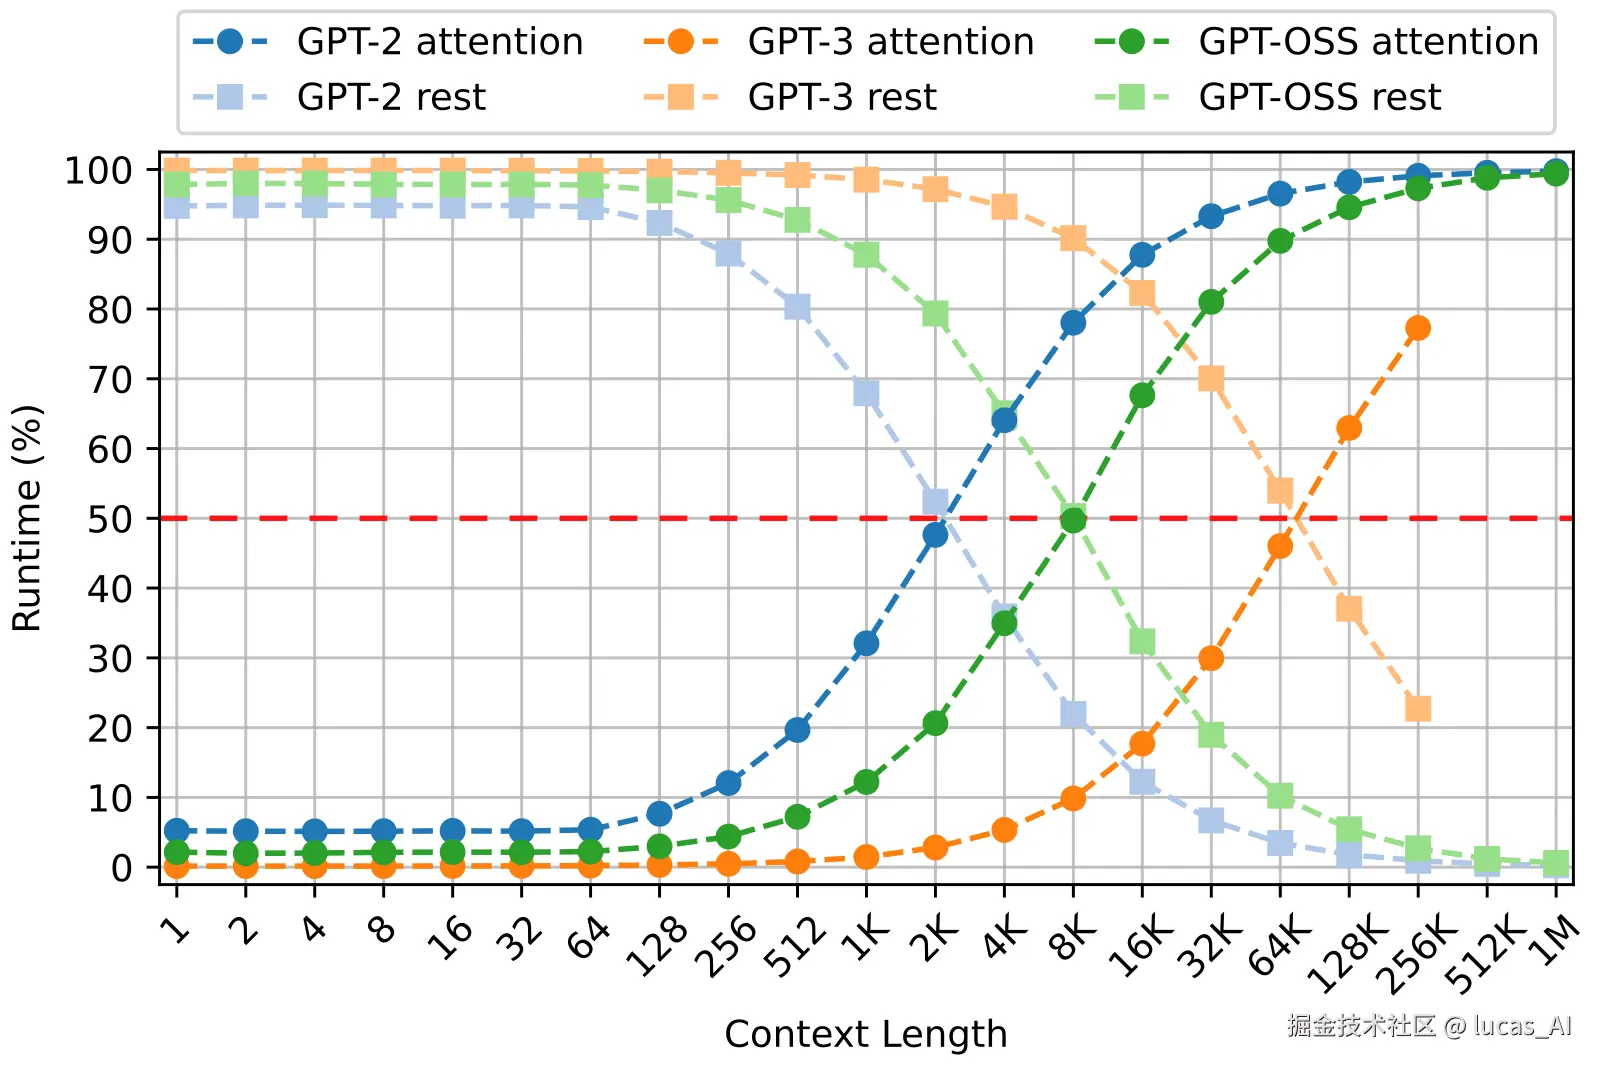 图说:三条 S 型曲线分别是 GPT-2 / GPT-3 / GPT-OSS------上下文一长,注意力就吃掉整块时间。
第二条:这张卡远没被跑满。 在 131072 token 上下文下,三代显卡的平均带宽利用率都不到 40%,算力利用率更惨------Ada 一代的均值不到 5%。最有意思的反例是:最老的 Turing 显卡反而用得最满。
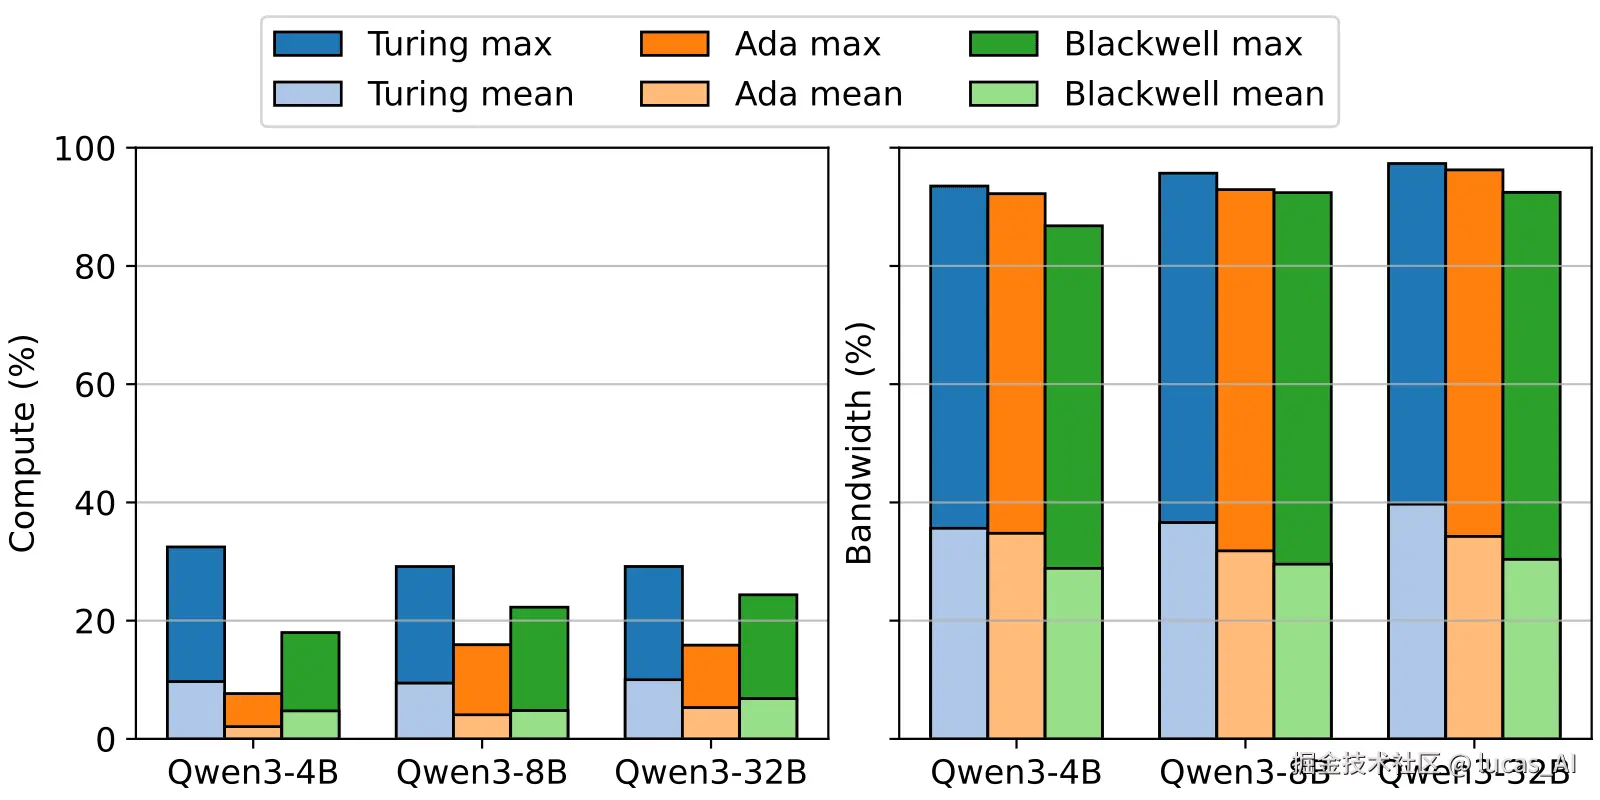 图说:带宽峰值倒是接近理论值(硬件没坏),但平均利用率一路走低------资源在绝大多数时间里闲着。
第三条:越新的卡,越不被善待。 固定开销的部分确实代代提速(Turing→Ada 1.7 倍,Ada→Blackwell 再快 1.5~1.75 倍),但新 GPU 的红利全落在这个不随上下文增长 的部分上。注意力呢?Qwen3-4B 和 8B 在 Blackwell 上比 Ada 只快了约 12%,几乎可以忽略;只有参数最大的 32B(它有 64 个 query head,给内核喂了足够多的并行工作量)才拉开 32% 的差距。更直观的是带宽:8B 模型的注意力在 Turing 和 Ada 上都接近带宽饱和,到了带宽翻倍的 Blackwell 上只用到 21%------新卡多出来的带宽,注意力内核根本吃不下。
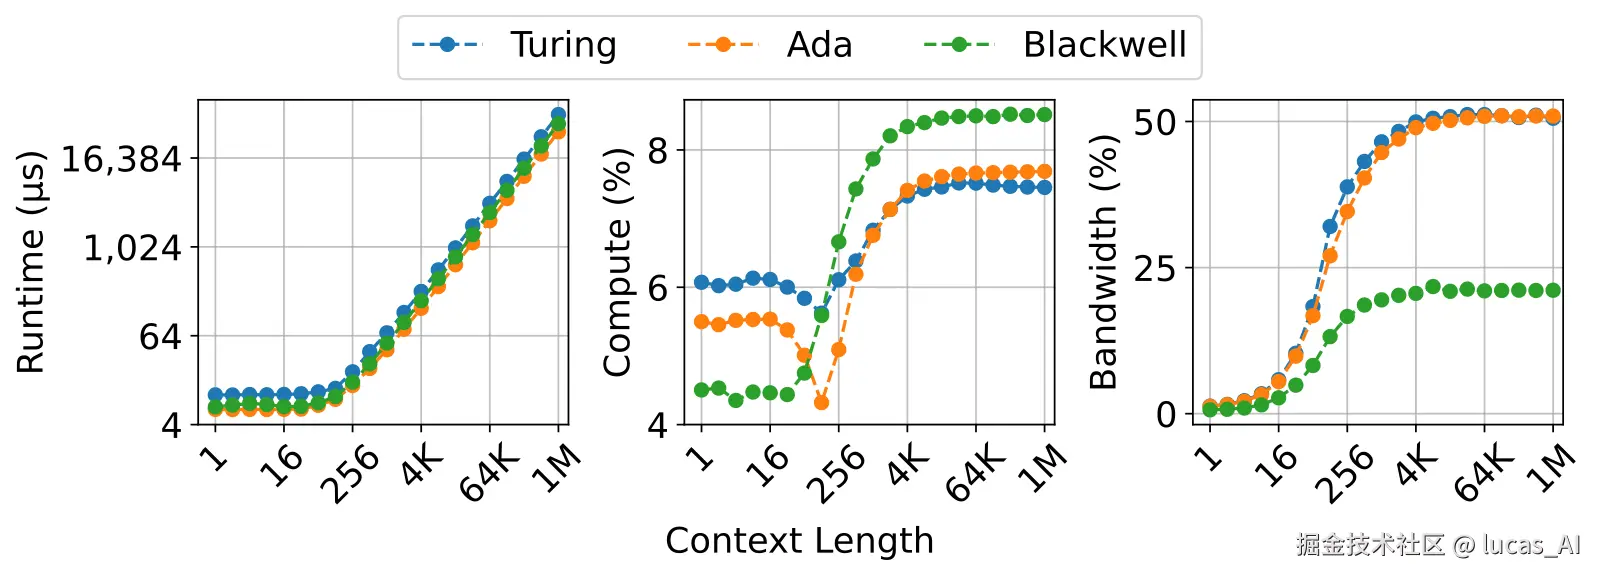 图说:最新的卡(最右组)带宽余量最大,利用率却最低------内核没有暴露足够的并行度去填满它。
为什么吃不下?作者给出的解释是:batch size 为 1、head 数固定时,内核能调度的并行度只能来自序列维度------把 KV cache 切成一段段并行算(Flash-Decoding 的思路)。但编译器不会自动选这种内核,得用户自己知道、自己指定;AMD 和 CPU 上实现还残缺。资源就在"没人告诉编译器"这件事上白白流走了。
顺带一提分页那个精彩的发现:注意力计算期间,带宽占用会跌出一个低谷------这是个预先可知的免费搬运窗口。把 GQA 的准备内核也算进窗口,分页 KV cache 所需的传输速率在 Ada 上贴着 PCIe 上限、在 Blackwell 上则绰绰有余。也就是说,存在一种几乎零延迟代价的分页,能让"装不下"不再靠压缩来解决。
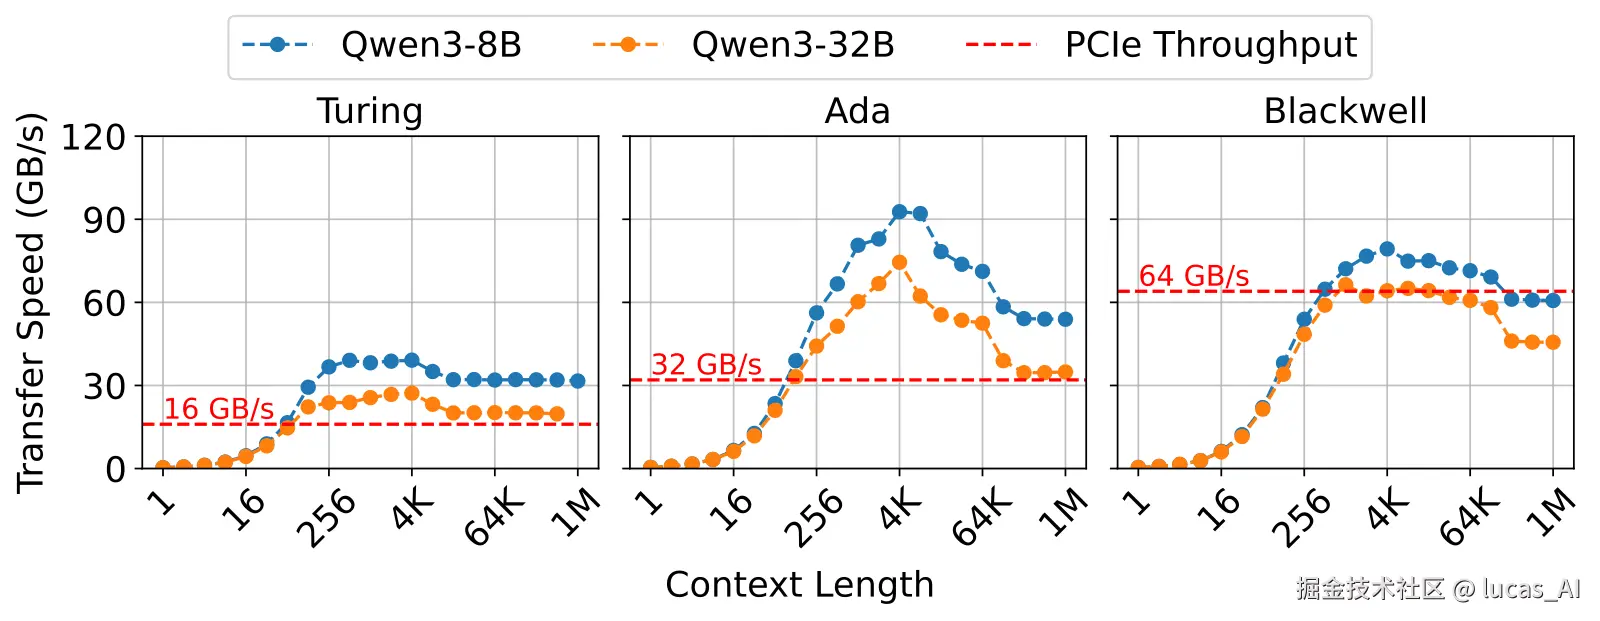 图说:虚线是 PCIe 5.0 的能力线------在最新的平台上,趁带宽空闲把缓存页入页出绰绰有余。
四条建议:下一代单用户推理系统的支柱
测量之后,作者给出四条建议,每条都对着一个具体的浪费:
- 让注意力沿序列维并行成为默认:内核该由编译器按问题形状自动选择(单用户就切 KV cache),而不是让用户背选项。
- 精准分页:把"带宽空闲窗口"当作搬运时机,趁注意力计算时把下一层的 KV cache 从显存外页入;硬件层面需要 GPU 能自己发起传输(GPUDirect 这类技术目前还做不到"由计算内部精确触发")。
- 编译器更激进地融合内核:现代架构的小算子(gate、top-k、sort)该并就并,减少内核启动开销和隐式同步------megakernel(把整层编译成一个大内核)是方向。
- 消灭内核停顿 :他们扒了注意力内核的汇编,停顿大头全是屏障和 scoreboard 等待------矩阵指令等取数、取数等同步,一环等一环。讽刺的是,Hopper/Blackwell 专门为此准备的 TMA 异步搬运单元,编译器生成的内核一个都没用上。
还有一个观点值得单独说:作者认为这些问题的原型在数据库社区早就出现过------GPU 查询处理同样被内核融合不足、调度器饿死、互联未调度这些病困扰过。所以这篇论文发在 cs.DB,标题里那句 "A Data Systems Perspective" 不是蹭概念,是认真的:单用户 LLM serving 可能需要一个全新的系统,就像 vLLM 之于多用户那样------llama.cpp 开了头,但还没有人把"单用户"当成一等公民做成生产级系统。
为什么你要关心?
- 做本地部署 / 端侧产品的人 :下次有人跟你说"上下文长了就量化吧",你可以先问一句"我们内核吃满了吗"。8-bit 量化已实测损失 8
10% 下游性能,剪枝在 2530% 压缩率就退化------精度是真金白银,带宽空闲也是。先分页、后压缩,可能是个更划算的顺序。 - 做内核 / 编译器的人:这里有一整张"钱在哪"的地图------注意力序列维并行的系统化研究、融合策略、TMA 的实际启用,全是论文点名没人做透的方向。顺手一提,这篇文章的方法论(单 block 剖析)也值得抄:它让你绕开显存限制测任意模型。
- 做 agent 应用的人:单用户 agent 是异步负载,延迟容忍度高、隐私敏感度高,恰恰是本地推理的主场。如果下一代单用户 serving 系统真按这四条建议长出来,"本地跑长上下文 agent"会从极客玩具变成默认选项。
理性看待
冷却一下:这篇是特征研究,不是系统论文。测量对象是单个 block 而非完整 serving 系统,四条建议也全部停留在"应该做",没有原型验证。所有数据来自 PyTorch 一个编译栈------llama.cpp 那些手写内核是否同样浪费,文中没测,而这恰是单用户场景的事实主流。另外,"分页窗口"的前提是注意力足够慢、窗口足够长;一旦注意力真被优化快了,窗口就收窄,两条建议之间存在作者自己承认的张力。
但方向性结论是稳的:跨两族模型、三代显卡、一百万 token,没有任何一张卡被跑满。把"慢"归罪于硬件容量之前,先看看软件把硬件用成了什么样------这个提醒,对整个本地推理生态都成立。