做文档识别的朋友,多半在现代扫描件上舒舒服服跑过流水线,然后在一份古籍高清扫描页面前沉默:虫蛀的洞正好啃掉半个字,水渍把三四个字糊成一团,墨迹褪得只剩笔画的影子。更气人的是,这些破坏从不整整齐齐地来------同一行里,有的字清清楚楚,有的只剩半边,有的干脆消失了。
这时候你有两条老路,都不好走。传统 OCR 一板一眼看图认字,证据不足就交白卷或者认错;换语言模型做后纠错,它确实能把残缺的字「脑补」出来,可兴头上来了,连本来清楚的字也一起改------学术点叫过度修正,直白点叫帮倒忙。
ACM MM 2026 上这篇 DDVR-Net(中央民族大学与北方工业大学团队),给这个两难提供了第三种解法:先判断每个字「还能不能信」,能信的纯靠眼睛看,不能信的才让语言模型按上下文修。听着像句废话?别急,怎么判断、怎么修,全是细节,而且数字相当能打。
💡 一句话总结:把「这个字长什么样」和「这个字被怎么毁了」在特征层拆成两路,再预测每个字的可见度;字清楚就纯靠视觉识别,字坏了才唤醒一个 0.5B 的语言模型按上下文修复------严重破损字符准确率 61.54%(超最强基线 21 个点),清晰字符还保住了 93.50% 的准确率。
想看原文?
- 📄 论文:arXiv 2610.16956
- 💻 代码与基准:Shajiu/DDVR-Net
🎯 历史文档,凭什么是 OCR 的地狱难度?
先说清楚问题有多特殊。论文选了三种低资源文字:藏文、传统蒙古文、维吾尔文。光「字难」还不够,各自的书写结构还各有各的脆弱点。
- 藏文有叠字结构(音节上下堆叠的部件),破损一来,叠层直接散架;
- 传统蒙古文竖着写,且字形随上下文变体,竖向笔画一断,连写关系就没了;
- 维吾尔文从右往左连笔书写,一个污点糊住一片,首尾都接不上。
真正的杀手锏是论文反复强调的一个概念:混合可见度。一页历史文档里,清晰字、部分破损字、严重破损字(甚至完全看不见的字)混在一起。统一对待这三种字注定顾此失彼------这个判断被他们的数字狠狠坐实了:GPT-4o 在他们基准的藏文测试集上字符准确率只有 58.72%,Qwen3-VL 也才 61.29%。大模型见多识广,架不住这几种文字的「课」压根没上过几节。
想解决这个问题,得先有像样的考卷。这就要说到这项工作一半的分量------他们顺手造了个目前这个方向最大的基准。
📚 先看考卷:187,000 对文档怎么造出来
低资源语言搞深度学习,第一瓶颈永远不是模型,是数据。团队搞了三条管线,各管一摊。
- 人工真实采集:与博物馆、档案馆合作,收了 5,000 对真实整页文档,佛经、史书、契约、行政记录都有,母语专家加博士生做字符级标注,双重独立标注再加专家仲裁;
- 半自动合成:对保存完好的历史页面「反向修复」------用 LAMA 抠笔画、贝塞尔曲线造裂缝孔洞、模拟墨蚀褪色,人为注入历史合理破损,产出 32,000 对;
- 全自动生成:从真实页面提取纸色、纹理、行距这些非文本先验,让 GPT 只把它们转写成风格描述(明确不许它生成文字内容),SDXL 加 LoRA 生成做旧空白背景,再用历史字体渲染文本、注入破损,每语言 50,000 对,共 150,000 对。
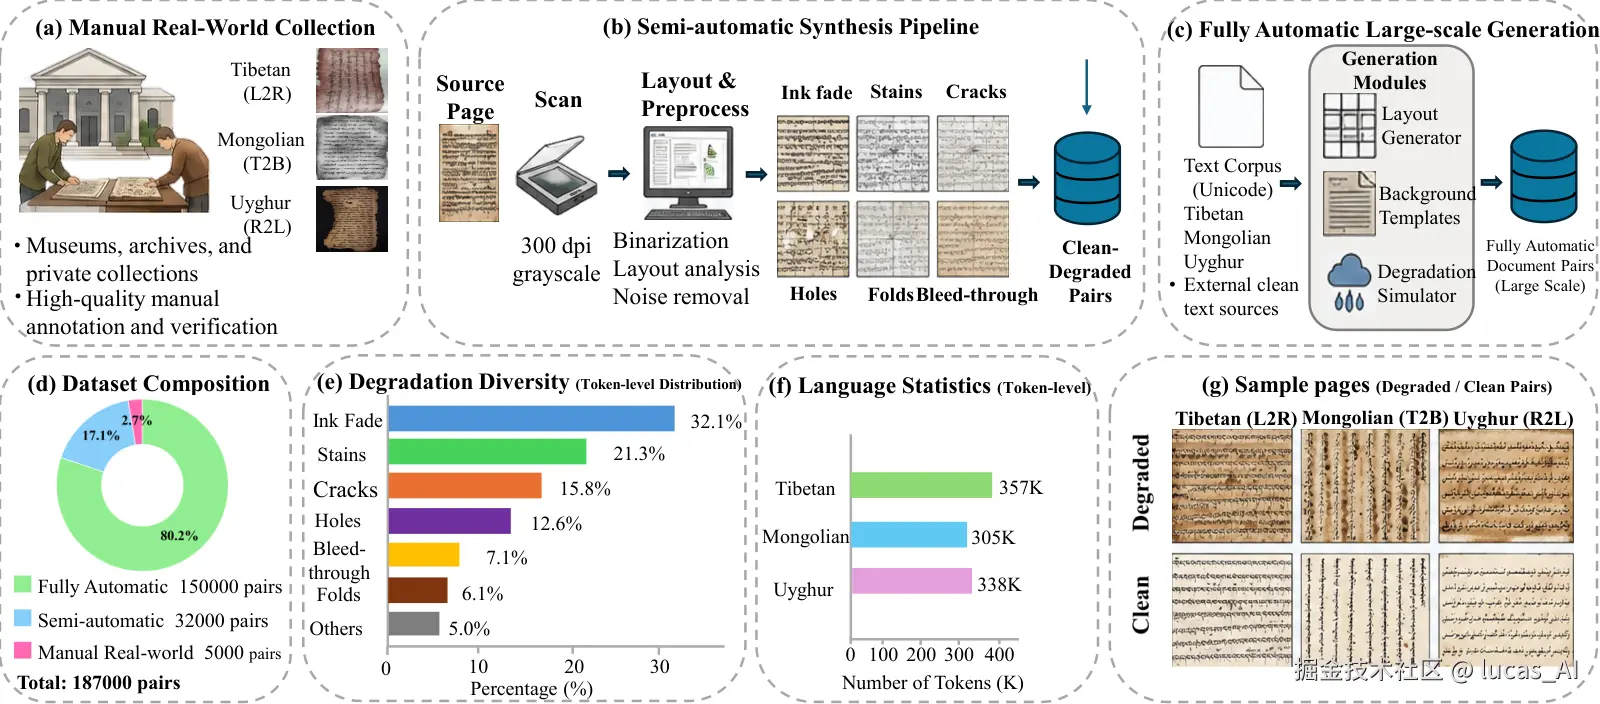
合成数据最容易翻车的地方是「假」。论文的质控做得相当较真:破损面积超 25% 的页直接扔,保留样本要求 CLIP 视觉相似度高于 0.82、VLM 真实感评分超 4.0(满分 5);盲测里 95% 的合成背景被有二十五年以上经验的文献专家判定「历史上说得过去」。标注一致性也给了数:字符转写的 Cohen's κ(一致性系数,1 为完全一致)达到 0.91。
每个字都有四样标注:边界框、内容标签、可见度状态(清晰/部分破损/严重破损三档)、破损类型。这四样东西,正是下一节方法能转起来的前提。
🛠️ 思路:给每个字发一张「可信度许可证」
方法部分论文画了一张信息量很大的框架图,我们照着走一遍。
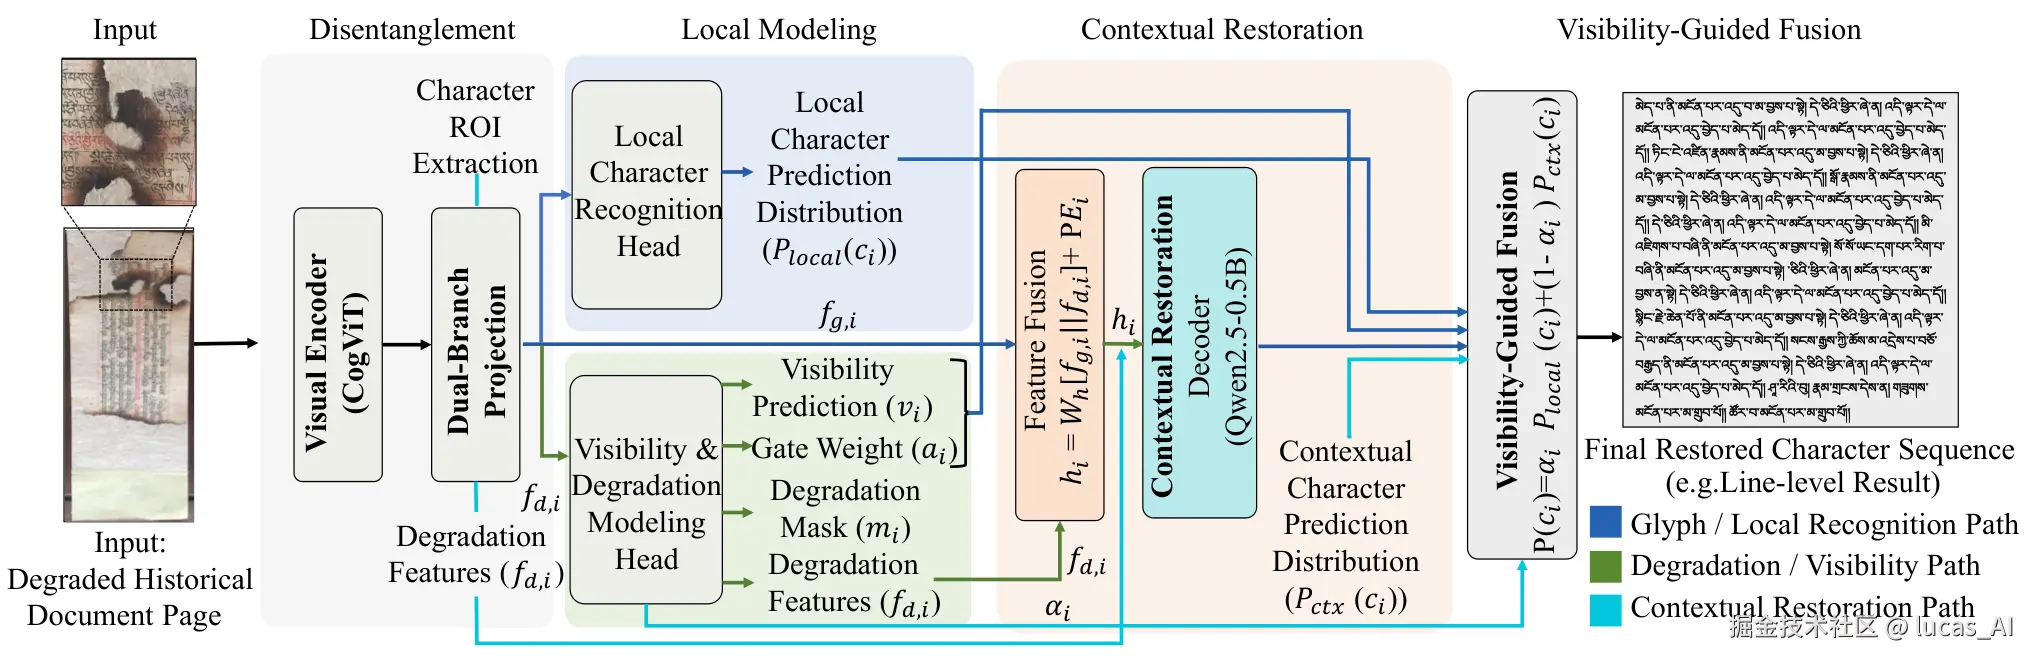
第一步是解耦。整页图像过 CogViT(一个 0.4B 的视觉编码器)编码,每个字符区域用 RoIAlign(按框抠出固定大小特征的操作)取出局部特征。关键动作来了:把这路特征投进两个并行的小网络,硬生生劈成两半------一路只管「这个字本来长什么样」(字形特征),一路只管「它被怎么毁了」(破损特征)。凭什么是拆得开的?论文的假设很直白:字的拓扑结构是內禀属性,破损只是外来的视觉扰动。
拆开了还得拆干净,否则字形那路偷偷夹带破损信息,等于白拆。所以有三个损失一起上:字形特征用 SupCon(监督对比学习,同类拉近、异类推远)保证一致性,破损特征做多标签分类保证判别力,两路特征之间加正交约束(强迫两路向量互相垂直)防止信息串门。
第二步是给每个字发许可证。字形特征走识别头,直接输出这个字的局部识别结果;破损特征走可见度头,预测该字属于清晰、部分破损还是严重破损。注意一个细节:严重破损的字被排除在局部识别的训练之外------证据都没了,硬逼着视觉分支学,只会教坏它。
第三步才是语言模型登场,而且只在该登场的地方登场。每个字符连同上下文喂给一个 Qwen2.5-0.5B 的小模型(用 LoRA 微调,只训一小部分参数),但训练时有个确定性的开关:只有部分破损和严重破损的字才产生上下文修复的损失,清晰字碰都不让它碰。最终识别结果是两路的按权重融合:
P(c) = α · P_local(c) + (1 − α) · P_ctx(c)
这个公式的用途一句话说清:α 是由可见度预测算出来的门控权重------字越清楚 α 越接近 1,结果越听视觉的;字越破 α 越接近 0,结果越听上下文的。训练分三阶段走(先解耦表征、再局部感知、最后上下文对齐),数据课程从 15 万全自动合成到 3.2 万半自动、最后 5 千真实数据收尾,先易后难,一层层垫。
整个设计翻译成人话就是:语言模型从「默认纠错器」降级成「按需兜底」------不出手则已,出手必须是因为字真的坏了。
📈 效果:两头兼得,是靠什么换来的
主结果先上数字。藏文测试集上:DDVR-Net 字符准确率 86.47%,专用历史文档方法里最强的 PreP-OCR 是 72.18%,GPT-4o 只有 58.72%。蒙古文和维吾尔文同理,字符准确率分别为 84.35% 和 85.34%,对最强基线全面领先。判读方向给一句:字符准确率是逐字判对的比例,越高越好。
差距主要拉开在难的那一档:严重破损字符准确率 DDVR-Net 61.54%,PreP-OCR 只有 40.15%,GPT-4o 更是只有 22.15%。CER(字符错误率,按编辑距离算的错字比例,越低越好)这边,DDVR-Net 三语分别为 9.83%、11.23%、10.45%,是所有对比方法里唯一低于 16% 的。
但真正有记忆点的,是那组「两头兼得」的消融数字。他们把选择性修复拆开对比,得到一张非常诚实的表格(藏文数据)。
- 纯视觉(Local-only):清晰字准确率最高,93.80%,但严重破损字准确率崩到 12.50%------眼睛好使,遇到窟窿就瞎猜;
- 全量纠错(Uniform Context,所有字都过语言模型):破损字修上来了,清晰字准确率却从 93.50% 被拖到 89.20%,整页序列准确率同步下滑------典型的帮倒忙;
- DDVR-Net(可见度门控):清晰字 93.50%,严重破损字 61.54%,两头都站住了。
这组数字基本就是全文论点的具象化:不是「要不要用语言模型」,而是「什么时机用」。顺带一提,换成硬开关(清晰/破损一刀切)全面略逊于连续的软门控,说明边界地带的字需要一个渐进的信任度,不是非黑即白。
解耦本身的贡献也被单独验证了:去掉双分支解耦,严重破损字准确率从 61.54% 掉到 42.30%,CER 从 9.83% 涨到 15.50%,是所有消融里伤得最重的一项。也就是说,「把字坏了和看不清拆开算」不只是个漂亮的说法,是实打实的主增益来源。
数据怎么喂也有讲究。论文对比了五种训练顺序:反过来训(先真实后合成)只有 80.40%,全部混在一起训是 83.15%,而「15 万全自动合成 → 3.2 万半自动 → 5 千真实」的渐进课程拿到 86.47%;只用手头那 5 千对真实标注更是只有 76.50%,严重破损字准确率直接腰斩到 41.20%。对低资源场景来说,这组数字的价值不输模型架构本身------合成数据不仅要用,还得放在最前面用。
效率上有个反直觉的惊喜:因为只对坏字跑语言模型,DDVR-Net 单页推理 438.5 毫秒,比「什么都修」的 Uniform Context 的 612.7 毫秒快了近三成。当然,代价也得看见:921M 总参数、6,144 GPU 小时的训练开销,这笔账我们最后算。
🔍 一个案例看懂「选择性兜底」
数字看累了,直接看一眼真实页面的对比,来自论文的定性分析。
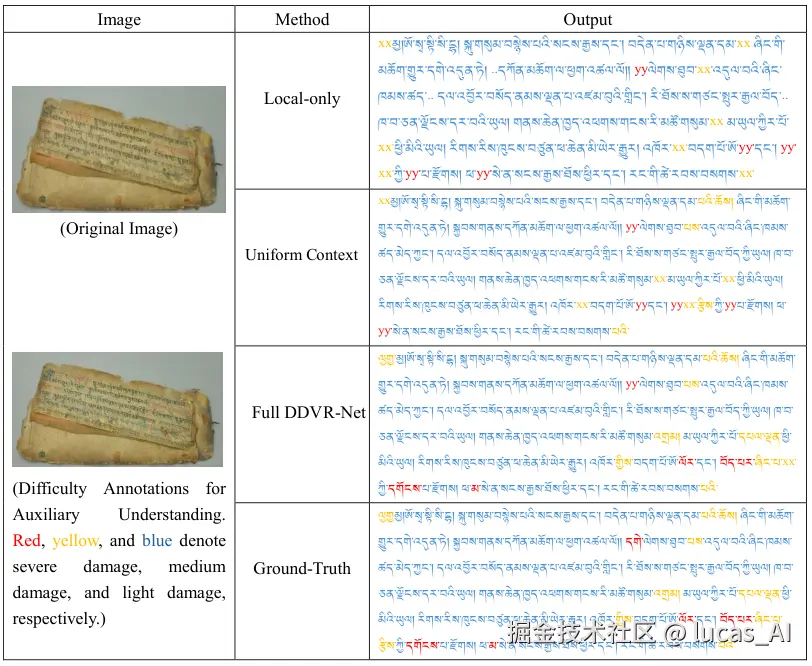
这张表从上到下是同一个残卷在三种方法下的输出。蓝色框的清晰字区域:Local-only 和 DDVR-Net 都认对了,Uniform Context 却出现了标 yy 的幻觉改写------语言模型看着字迹清楚,硬是按「更通顺」的方向给改了。红色框的严重破损区域:Local-only 输出一片错误标记,彻底失败;DDVR-Net 的可见度预测触发上下文修复,恢复质量追平了 Uniform Context。
同一页、同一行,清楚的字靠视觉保真,破碎的字靠上下文救命------这张图就是整个方法的一句话写真。
这套范式能不能搬走?论文场景是低资源历史文档,但「先估证据可靠性,再决定调不调语言模型」的思路,我个人的推测是:凡是「大部分证据完好、少数区域受损」的识别任务都值得试,比如表格识别里被印章遮住的单元格、图纸里被折痕压住的标注。反过来,如果整页都烂,可见度全员亮红灯,门控就退化成全量纠错了,别指望它点石成金。
🧊 泼点冷水
优点说完了,这几处得掰开看。
- 考卷是自己出的:所有评测都在自建基准上进行,作者在结论里坦诚「第三方独立基准评测留作 future work」------防泄漏设计(按页划分、来源隔离、盲测)是认真的,但 SOTA 的含金量终究绑定在这个基准的代表性上;
- 依赖现成的字符框:主实验用的是标注字符框(为了隔离识别与修复问题),落地得外接检测器;论文给了框扰动鲁棒性测试协议(坐标偏移 5%--20%、随机删框 5%--10%),但 HTML 全文里我没找到对应的结果表 (uncertain),真实检测器在重度破损页上的漏检恐怕比随机模拟更凶;
- 不便宜:6,144 GPU 小时的训练成本和 921M 的总参数,对真正守着这些低资源语言的团队来说门槛不低,「低资源」省的是数据,不是算力;
- 上下文以行为单位:修复解码器建模的是行内序列,跨行、跨页的语义(比如佛经里高度模板化的段落结构)有没有用上,论文没有展开 (uncertain)。
还有一条给复现者的提醒:合成数据的质控依赖 CLIP 与 VLM 打分的双阈值,阈值是在验证集上调的,换语种、换文书类型时这两道闸门大概率要重调。
💡 理性看待
回过头看,DDVR-Net 最大的启发可能不在某个具体模块,而在它对「语言模型该干什么」的重新定位:视觉证据充分时,语言模型是风险而非助力;证据坍塌时,它才是救命稻草。可见度门控就是把这个判断做成了可训练、可微调的显式机制,而不是指望端到端训练自己悟出来。
对做文档数字化、档案整理、RAG 语料清洗的人来说,一个直接的行动启示:如果你的流水线正在无差别地用 LLM 后纠错 OCR 结果,先想想能不能加一层「这个字还能不能信」的判断------本文的数字已经把代价写明白了:全量纠错会把清晰字的准确率从 93.50% 拖到 89.20%,还慢 28%。
至于藏文、蒙古文、维吾尔文的研究者,187K 对、带字符级可见度和破损标注的基准大概是比模型本身更实在的贡献------毕竟在这个领域,缺的从来不是想法,是可以公平比划的考场。