大家好,我是老刘
前段时间老刘发了一篇文章,聊了聊宏这种编程特性在 AI 时代是否还有价值。
评论区有朋友提出了一个非常有代表性的问题,这个问题几乎覆盖了当下从旧开发时代向 AI 开发演进的每一个团队。
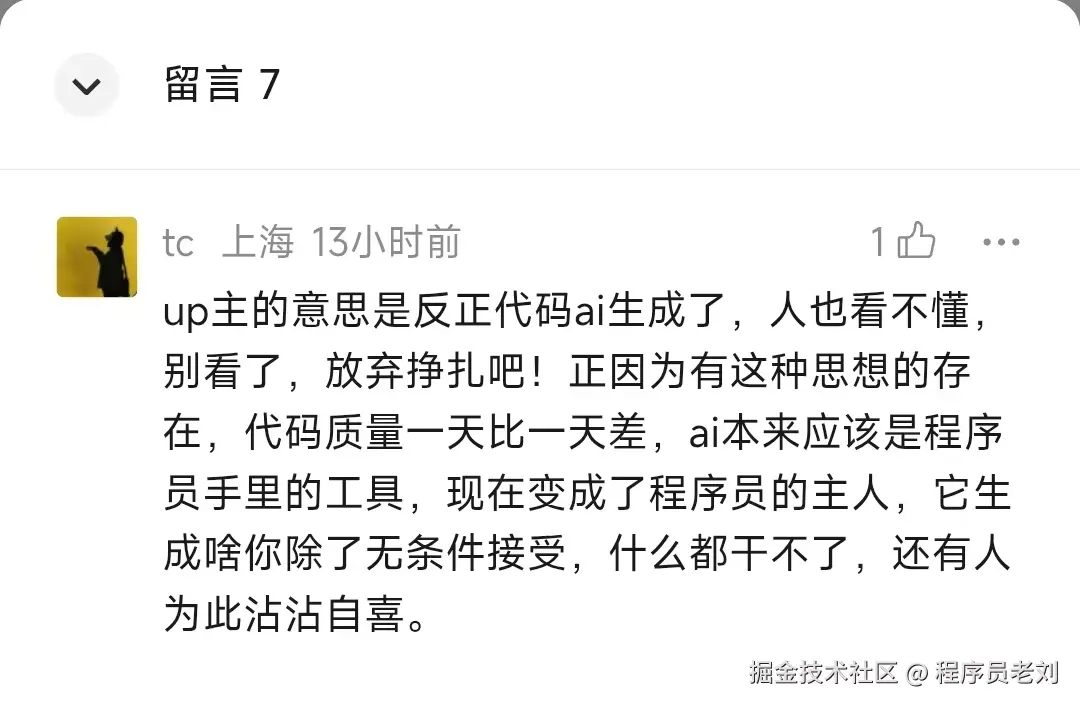
说实话,老刘觉得这不是一个要不要 review 的简单问题。它背后是效率、可靠性和编程逻辑差异三者构成的不可能三角。
下面展开说说老刘的想法。
开发效率上,AI 碾压人类
老刘多次提到过,在 Flutter 项目中,我已经很久没有亲手写过一个按钮、一个列表页、一个对话框这个层级的代码了。
这个复杂度的任务,现在 flash 级的大模型完成得又快又好。
我自己写代码还可能因为参数没传对,导致 UI 和预期差异很大。但对 AI 来说,只要指令足够精确,完成的效果非常理想,准确度比我高多了。
更不要提生成基础代码的速度,AI 可能是我的一万倍。
举个例子。一个 Flutter 项目的需求,通常可以拆分出几十个组件。最简单的做法是让 AI 在多个独立的子会话里并行开发这些组件,可能不到半小时,所有组件和配套的测试代码就全部完成了。
换我自己写,这就是一个串行过程。碰到不熟悉的 API 还要去查文档,第一版写出来往往还不对,还需要返工。
所以老刘觉得,人工写这种基础代码,对项目已经没有任何收益了。
livebench 的 coding 能力测评也能侧面印证这个观点。
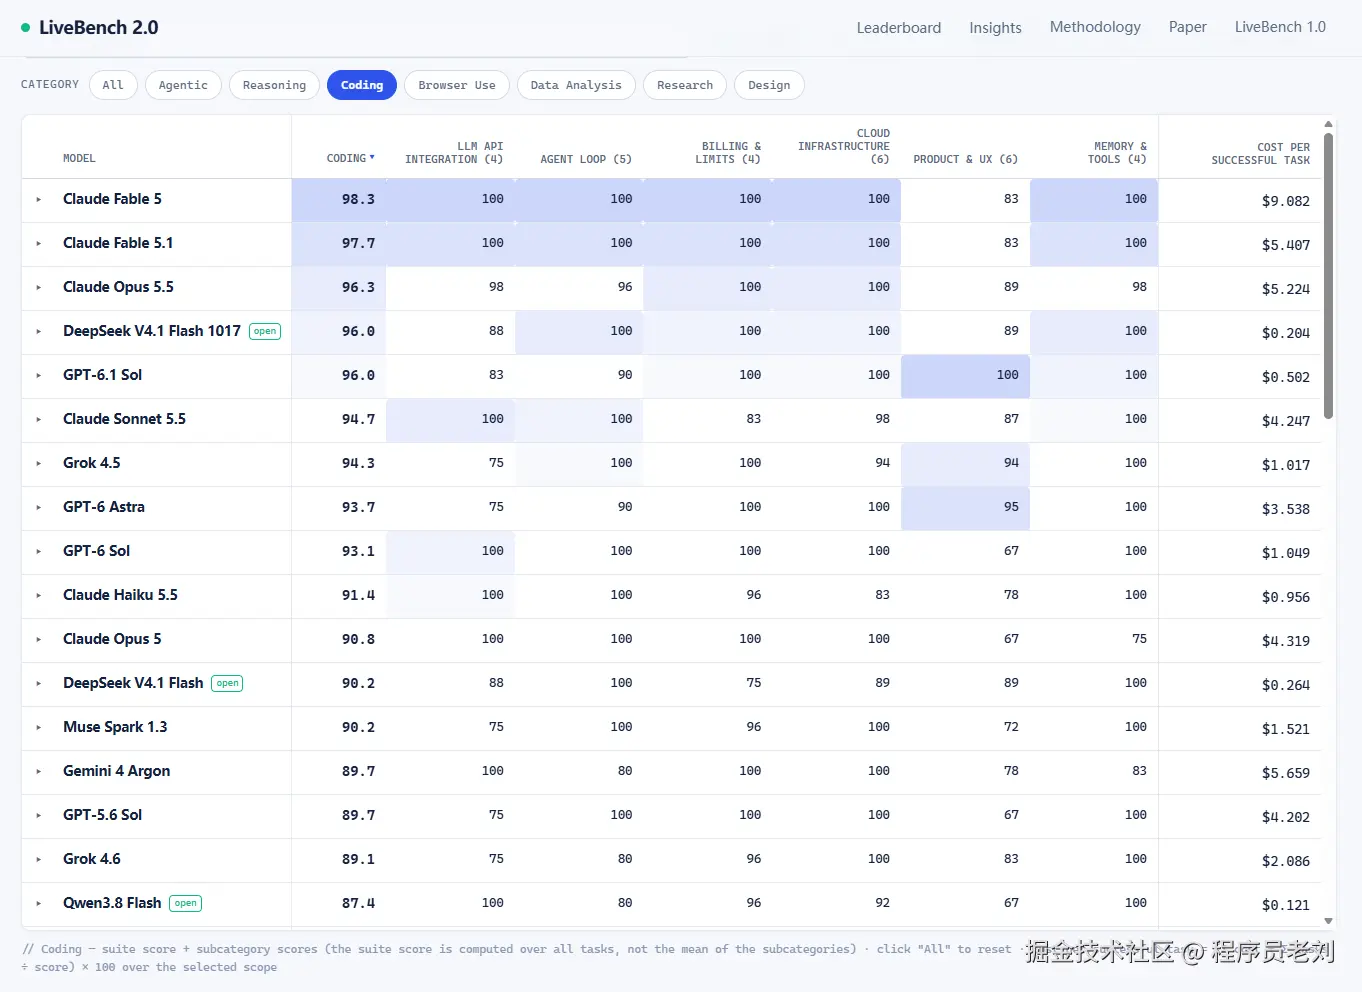
coding 这项能力正好对应简单的编程任务。可以看到,顶级模型虽然仍然排名靠前,但第一名和第十名的分差其实已经很小了。
可靠性上,人类碾压 AI
那么问题来了,我们应该如何评价一个程序员的可靠性?是测试他完成一万个简单任务的成功率吗?
很多测评就是这个套路,很多人也是这样选择编程模型的。
但在实际工作中,我们更在意的是一个项目持续几个月连续迭代下来,新需求不断合并进来,旧功能不断变化,整体代码质量能不能维持在合理区间。
这需要的不只是把每个具体功能正确实现,还需要每次技术选型、架构设计、模块拆分都贴合整个项目的情况,做出合理判断。
livebench 的 Agentic 测评项针对的正是这种场景。
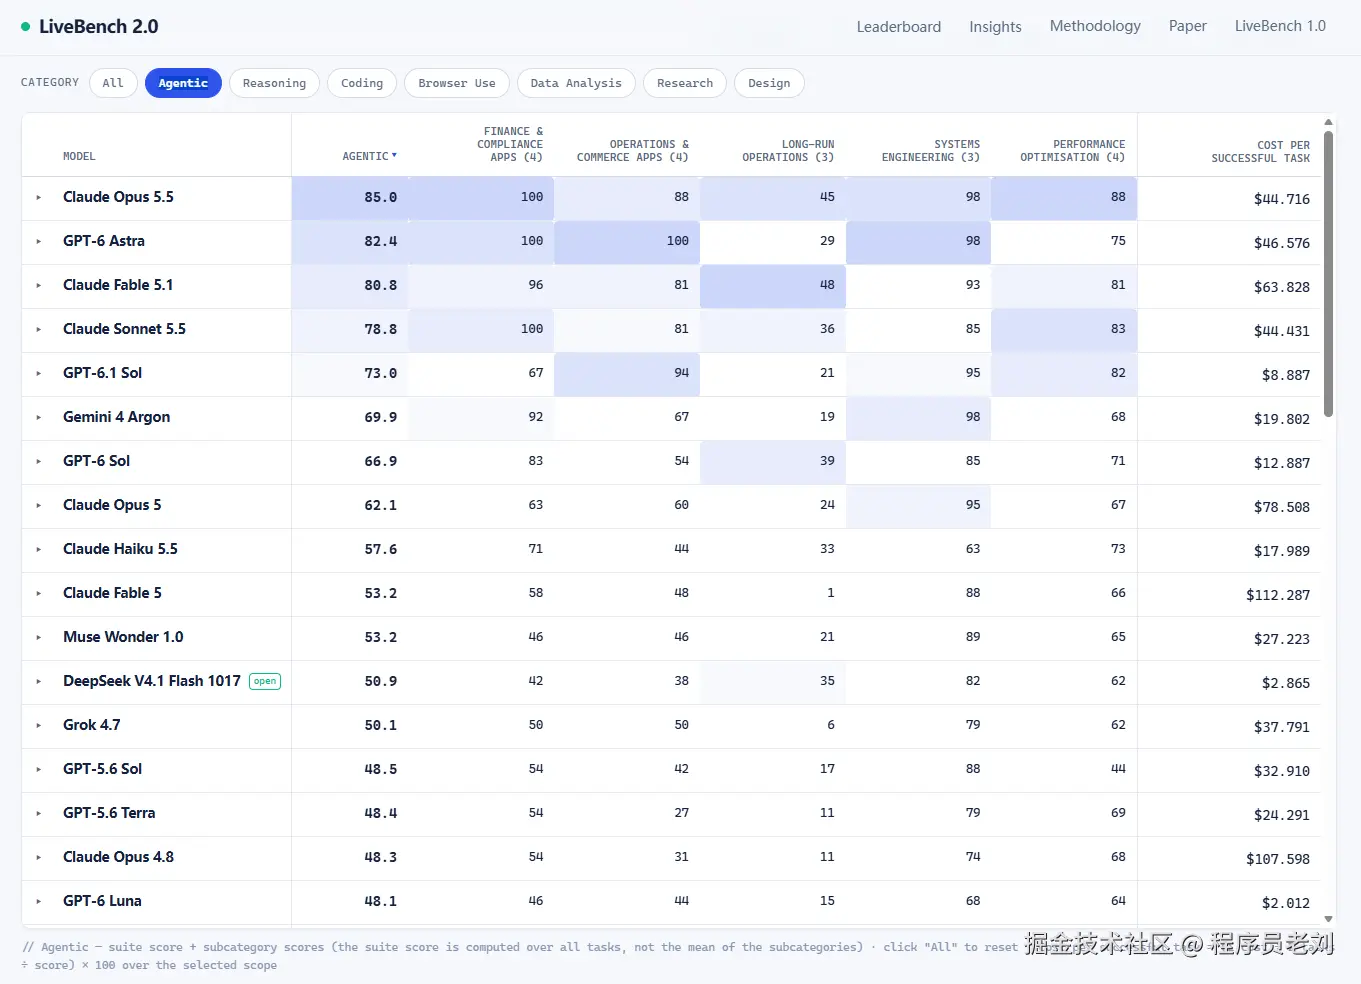
遗憾的是,这个维度的测试里分数在快速下降。即使最顶级的模型,Agentic 得分也远不如 coding 得分。
除了长周期这个维度,还有幻觉问题。
模型本质上不能像人类一样进行逻辑思考,它的所有思考都是概率模拟。所以它并不知道自己给出的决策有多大把握是可靠的。
在真正的长周期任务中,很难完全依靠模型自身的决策。这是最需要人来把关的地方。
但请注意,这件事和 review 代码的关系并不大。因为这一步做的是技术方案的设计。只有你和 AI 充分讨论、形成完整的技术方案之后,才应该开始真正写代码。
编程的底层逻辑不一样
还有一个问题值得讨论。对人类程序员来说的好代码,对 AI 来说也一定是好代码吗?
老刘认为不是。
之前那篇文章里说过,宏是人类程序员进行复杂抽象、简化代码的利器。但对 AI 来说,它可能带来的是更高的错误率和更复杂的上下文。
再举个例子。过去评审代码时,我们会觉得重复性代码是原罪。
所以开发过程中,我们会尽可能把重复逻辑提取成高阶函数,避免后续迭代中漏改,也避免不同地方的逻辑不一致。
但对 AI 来说,改 10 处功能类似的函数,和改一处高阶抽象函数、再在 10 个不同的地方传入不同参数,还真很难说哪一种是更好的选择。
更进一步讲,如果抽象层级太多、模式太复杂,比如用了注解这类代码注入方案,对 AI 来说可能还真不如把重复性很高的原始代码直接暴露出来。
所以当你去 review AI 写的代码时,你看到的那些坏味道,对 AI 来说真的是坏味道吗?
Review 是当下的妥协,不是终局
回到最开始的问题,我们到底应不应该 review AI 写的代码?
老刘团队现在的处理原则大致是这样。
- 小项目不 review。我能接受发现问题后再去修复,这样可以充分享受 AI 编程带来的效率提升。
- 企业级项目的方案一定要经过评审。经过充分评审的方案,才会交给 AI 去开发。
- 代码正确性主要依靠自动化测试去覆盖和保证,而不是依靠人工 review。做到这一点有个前提,我们一直在用 TDD 流程。另外支付、权限认证这类关键代码还是会 review 一下。
- 即使 review,也只验证业务逻辑的正确性,不验证代码是否优雅。
总的原则就一句话,能不 review 就尽量不 review,人工 review 只用来弥补 AI 决策能力不足。
这个原则可能和很多人的第一反应不一样,原因有两个。
第一,AI 生成代码的速度是过去的上百倍。全面人工 review,等于把效率强行拉回手工编码的旧时代。在容错允许、测试覆盖充分的场景下,应该优先去拿几何级数增长的效率。
第二,AI 的思考逻辑和人不一样。我们眼中的好代码对 AI 不一定好,AI 写出的臭代码,可能才是对大模型最友好的代码。
当然,这只是老刘团队当下的开发原则,绝不是 AI 开发的终极形态。
我认为终极形态应该是,想要什么由人来定义,怎么完成由 AI 去实现。
现在的状态,更多是 AI 还不足以完全胜任这份工作时,把必要的地方由人来补上。这是一种基于成本和结果的妥协,而非最终的理想状态。
你的团队现在是怎么处理 AI 生成的代码的,逐行 review,还是靠测试兜底?评论区聊聊你的做法。
如果这篇文章对你有启发,欢迎转发给身边还在逐行 review AI 代码的朋友。
🤝 如果看到这里的同学对客户端或者Flutter开发感兴趣,欢迎联系老刘,我们互相学习。
🎁 私信免费领老刘整理的《Flutter开发手册》,覆盖90%应用开发场景。可以作为Flutter学习的知识地图。
💬 : laoliu_dev
📂 老刘也把自己历史文章整理在GitHub仓库里,方便大家查阅。