每个 Flink 开发者都在和配置打交道------flink-conf.yaml 里密密麻麻的参数,提交命令里的 -D 动态属性,代码里的 env.getConfig() 设置。但你真的理解 Flink 配置体系吗?五种配置来源的优先级是什么?GlobalConfiguration 是怎么加载配置的?ConfigOption 如何实现类型安全读取?哪些配置支持运行时动态修改?内存、并行度、Checkpoint、状态后端、网络这些核心参数该怎么调?这篇从 Flink 配置体系的整体架构讲起,深入配置加载源码,剖析核心类实现,最后给出六大类核心参数的调优指南和生产环境配置模板。
一、Flink 配置体系整体架构
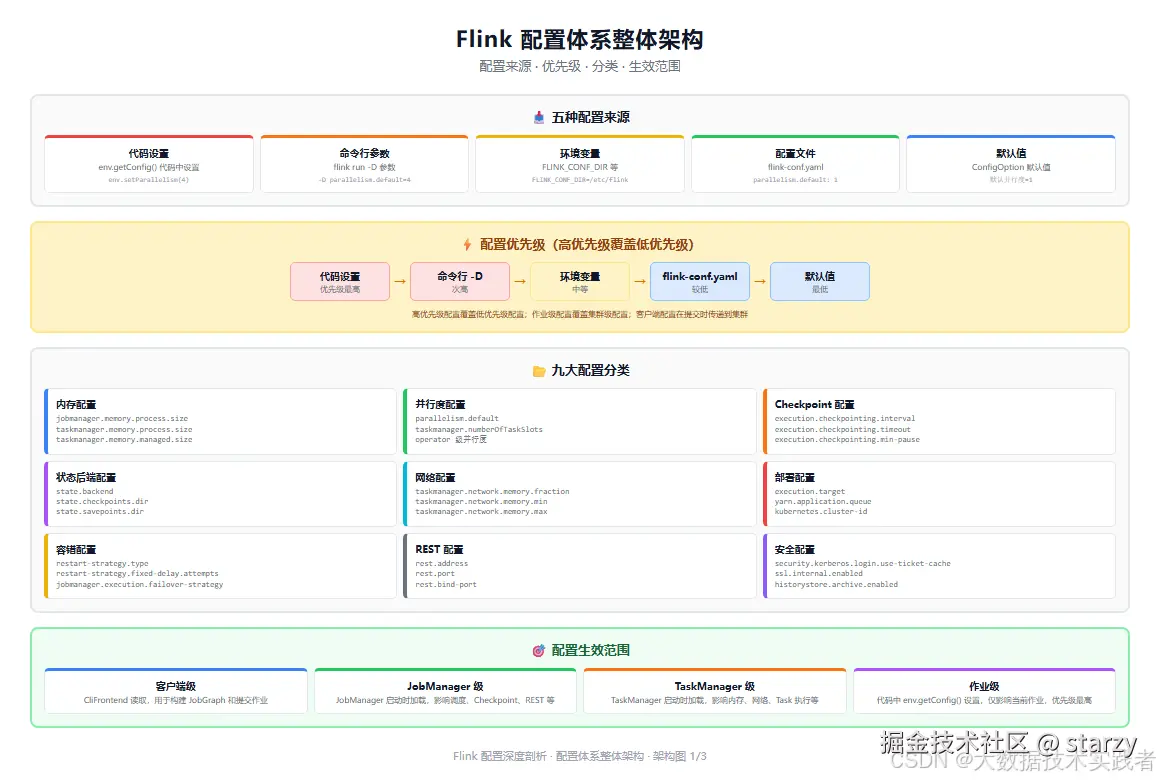
下面这张图是 Flink 配置体系整体架构,包括五种配置来源、优先级、九大分类和生效范围。
1.1 五种配置来源
Flink 配置有五种来源,从高到低优先级排列:
代码设置(优先级最高)
- 在用户代码中通过
env.getConfig()设置 - 例如
env.setParallelism(4)、env.enableCheckpointing(60000) - 仅影响当前作业,作业级配置
- 优先级最高,覆盖所有其他配置
命令行 -D 参数
- 提交作业时通过
-D key=value传递 - 例如
flink run -D parallelism.default=4 -D state.backend=rocksdb ./job.jar - 封装为 DynamicProperties,随 JobGraph 传递到集群
- 优先级仅次于代码设置
环境变量
- 通过
FLINK_CONF_DIR指定配置目录 FLINK_HOME指定 Flink 安装目录- 部分配置可通过环境变量覆盖
- 优先级低于命令行参数
配置文件 flink-conf.yaml
- Flink 安装目录下
conf/flink-conf.yaml - YAML 格式,键值对配置
- 集群级默认配置,所有作业共享
- 优先级低于环境变量
默认值(优先级最低)
- 每个 ConfigOption 定义时设置的默认值
- 例如
parallelism.default默认值为 1 - 未在任何来源配置时使用默认值
- 优先级最低
1.2 配置优先级规则
优先级规则可以总结为三句话:
第一,高优先级覆盖低优先级:代码设置 > 命令行 -D > 环境变量 > flink-conf.yaml > 默认值。
第二,作业级覆盖集群级:代码中设置的作业级配置覆盖集群级配置文件中的配置。
第三,客户端配置在提交时传递:客户端读取的配置(flink-conf.yaml + -D 参数)通过 DynamicProperties 序列化到 JobGraph,提交到集群后与集群本地配置合并。
1.3 九大配置分类
Flink 配置按功能分为九大分类:
| 分类 | 核心参数 | 说明 |
|---|---|---|
| 内存配置 | jobmanager.memory.、taskmanager.memory. | JM/TM 进程内存、堆内存、托管内存、网络内存 |
| 并行度配置 | parallelism.default、taskmanager.numberOfTaskSlots | 默认并行度、Slot 数量 |
| Checkpoint 配置 | execution.checkpointing.* | Checkpoint 间隔、超时、最小间隔、容忍失败次数 |
| 状态后端配置 | state.backend、state.checkpoints.dir、state.savepoints.dir | 状态后端类型、存储目录 |
| 网络配置 | taskmanager.network.memory.* | 网络内存、缓冲区、反压 |
| 部署配置 | execution.target、yarn.application.、kubernetes. | 部署模式、YARN/K8s 参数 |
| 容错配置 | restart-strategy.*、jobmanager.execution.failover-strategy | 重启策略、故障恢复 |
| REST 配置 | rest.address、rest.port | REST API 地址端口、Web UI |
| 安全配置 | security.kerberos.、ssl. | Kerberos 认证、SSL 加密 |
1.4 配置生效范围
配置按生效范围分为四级:
客户端级:CliFrontend 读取,用于构建 JobGraph 和提交作业,不影响集群运行时。
JobManager 级:JobManager 启动时加载本地 flink-conf.yaml,影响调度、Checkpoint 协调、REST API 等。
TaskManager 级:TaskManager 启动时加载本地 flink-conf.yaml,影响内存、网络、Task 执行等。
作业级:代码中 env.getConfig() 设置,或 -D 参数传递,仅影响当前作业,优先级最高。
注意:客户端配置和集群配置是分开的。客户端读取的配置用于构建 JobGraph,集群端(JM/TM)读取本地配置用于运行时。作业级配置通过 DynamicProperties 随 JobGraph 传递到集群,覆盖集群本地配置。
二、配置加载完整链路
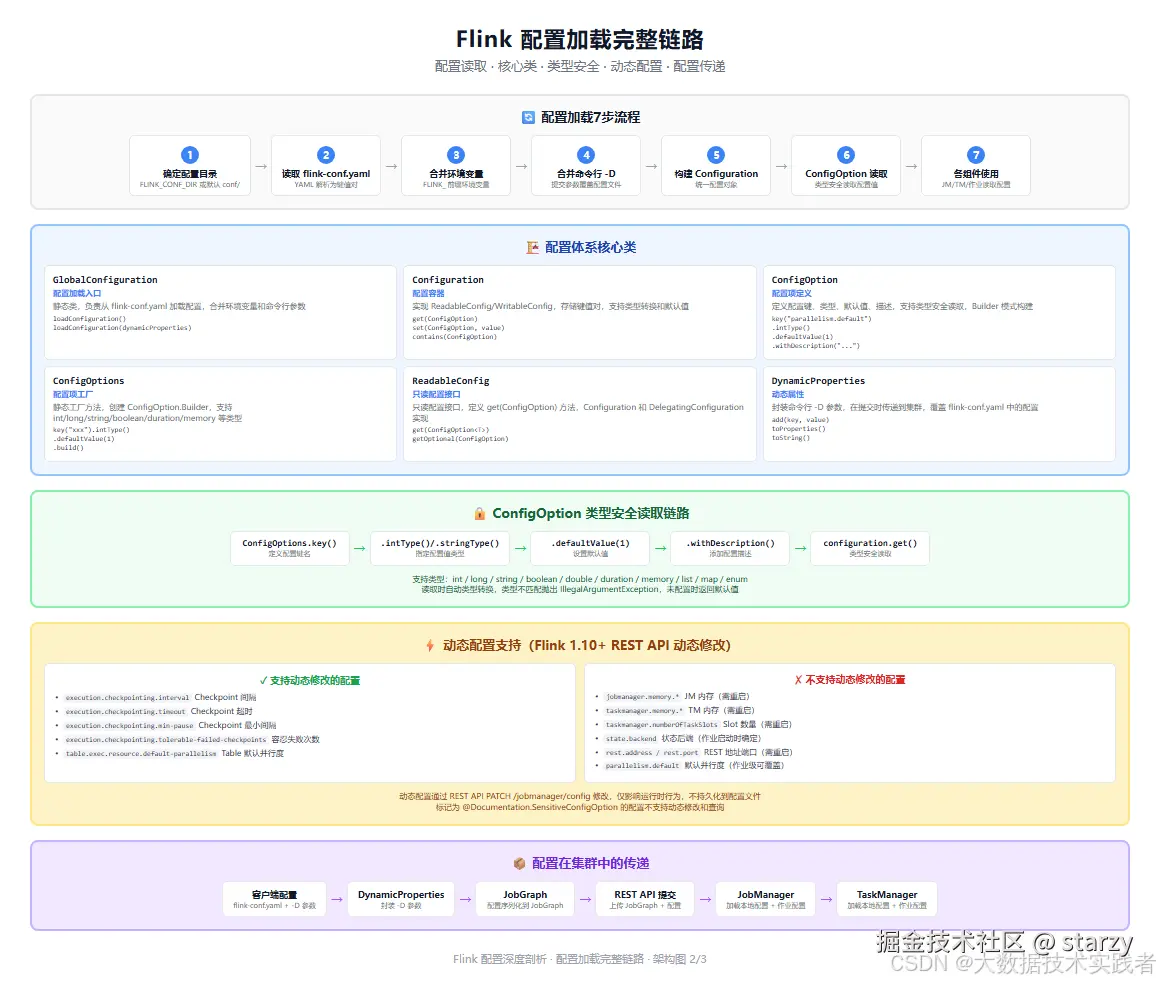
下面这张图是 Flink 配置加载完整链路,包括7步加载流程、6个核心类、类型安全读取、动态配置和配置传递。
2.1 配置加载7步流程
Flink 配置加载遵循标准的7步流程:
第1步:确定配置目录
- 优先使用环境变量
FLINK_CONF_DIR指定的目录 - 未设置时使用
FLINK_HOME/conf目录 - 最终配置文件路径为
$FLINK_CONF_DIR/flink-conf.yaml
第2步:读取 flink-conf.yaml
- 使用 SnakeYAML 库解析 YAML 文件
- 将 YAML 键值对转换为 Map<String, String>
- 支持 YAML 语法:嵌套对象、列表、引用、锚点
第3步:合并环境变量
- 读取
FLINK_前缀的环境变量 - 将环境变量转换为配置键(下划线转点号,大写转小写)
- 例如
FLINK_PARALLELISM_DEFAULT→parallelism.default - 环境变量覆盖配置文件中的同名配置
第4步:合并命令行 -D 参数
- 解析
flink run -D key=value中的动态属性 - 封装为 DynamicProperties 对象
- 命令行参数覆盖配置文件和环境变量中的同名配置
- DynamicProperties 随 JobGraph 序列化传递到集群
第5步:构建 Configuration 对象
- 将所有键值对封装为 Configuration 对象
- Configuration 实现 ReadableConfig 和 WritableConfig 接口
- 支持类型转换、默认值、可选值读取
- Configuration 是 Flink 内部统一的配置容器
第6步:ConfigOption 类型安全读取
- 各组件通过预定义的 ConfigOption 读取配置
- 例如
configuration.get(JobManagerOptions.PROCESS_MEMORY) - ConfigOption 定义了键名、类型、默认值、描述
- 读取时自动类型转换,类型不匹配抛出异常
第7步:各组件使用配置
- JobManager 读取调度、Checkpoint、REST 等配置
- TaskManager 读取内存、网络、Task 执行等配置
- 用户代码通过 env.getConfig() 读取作业级配置
- 配置在组件启动时读取,运行时部分配置可动态修改
2.2 核心类源码剖析
GlobalConfiguration(配置加载入口)
GlobalConfiguration 是静态工具类,负责从 flink-conf.yaml 加载配置:
java
public class GlobalConfiguration {
    public static final String FLINK_CONF_FILENAME = "flink-conf.yaml";

    // 加载配置(从默认目录)
    public static Configuration loadConfiguration() {
        return loadConfiguration(new Configuration());
    }

    // 加载配置(合并动态属性)
    public static Configuration loadConfiguration(
            Configuration dynamicProperties,
            String configDir) {
        // 1. 确定配置文件路径
        String confFile = configDir + "/" + FLINK_CONF_FILENAME;

        // 2. 读取 YAML 文件
        Map<String, String> yamlConfig = readYamlFile(confFile);

        // 3. 构建 Configuration
        Configuration configuration = new Configuration();
        configuration.addAll(yamlConfig);

        // 4. 合并动态属性(命令行 -D 参数)
        configuration.addAll(dynamicProperties);

        return configuration;
    }

    // 读取 YAML 文件
    private static Map<String, String> readYamlFile(String filePath) {
        Yaml yaml = new Yaml();
        try (FileReader reader = new FileReader(filePath)) {
            Map<String, Object> yamlMap = yaml.load(reader);
            // 扁平化嵌套 YAML 对象为点号键
            return flattenYamlMap(yamlMap);
        } catch (IOException e) {
            throw new RuntimeException("Failed to read config file: " + filePath, e);
        }
    }
}
关键逻辑:
- loadConfiguration 是入口方法,支持传入动态属性和配置目录
- readYamlFile 使用 SnakeYAML 解析 YAML,将嵌套对象扁平化为点号键
- 动态属性(命令行 -D)覆盖配置文件中的同名配置
- 最终返回 Configuration 对象
Configuration(配置容器)
Configuration 是 Flink 内部统一的配置容器,实现 ReadableConfig 和 WritableConfig:
java
public class Configuration implements ReadableConfig, WritableConfig, Serializable {
    private final Map<String, String> confData = new HashMap<>();

    // 类型安全读取配置
    @Override
    public <T> T get(ConfigOption<T> option) {
        return getOptional(option).orElseGet(option::defaultValue);
    }

    // 读取可选配置
    @Override
    public <T> Optional<T> getOptional(ConfigOption<T> option) {
        // 1. 遍历所有备选键(支持废弃键名)
        for (String key : option.keys()) {
            String value = confData.get(key);
            if (value != null) {
                // 2. 类型转换
                T converted = convertValue(value, option.getClazz());
                return Optional.of(converted);
            }
        }
        // 3. 未配置返回空(调用方使用默认值)
        return Optional.empty();
    }

    // 设置配置
    @Override
    public <T> Configuration set(ConfigOption<T> option, T value) {
        confData.put(option.key(), String.valueOf(value));
        return this;
    }

    // 检查是否包含配置
    @Override
    public boolean contains(ConfigOption<?> option) {
        return option.keys().stream().anyMatch(confData::containsKey);
    }

    // 类型转换
    private <T> T convertValue(String value, Class<T> clazz) {
        if (clazz == Integer.class) return clazz.cast(Integer.parseInt(value));
        if (clazz == Long.class) return clazz.cast(Long.parseLong(value));
        if (clazz == Boolean.class) return clazz.cast(Boolean.parseBoolean(value));
        if (clazz == Double.class) return clazz.cast(Double.parseDouble(value));
        if (clazz == String.class) return clazz.cast(value);
        if (clazz == Duration.class) return clazz.cast(Duration.parse(value));
        if (clazz == MemorySize.class) return clazz.cast(MemorySize.parse(value));
        throw new IllegalArgumentException("Unsupported type: " + clazz);
    }
}
关键设计:
- 内部存储为 Map<String, String>,所有值都是字符串
- get(ConfigOption) 类型安全读取,未配置时返回默认值
- getOptional 返回 Optional,支持判断是否配置
- set(ConfigOption, value) 设置配置,自动转为字符串
- convertValue 支持 int/long/boolean/double/string/duration/memory 等类型转换
- 支持废弃键名(option.keys() 返回所有备选键)
ConfigOption(配置项定义)
ConfigOption 定义配置项的元信息,使用 Builder 模式构建:
java
public class ConfigOption<T> {
    private final String key;           // 配置键名
    private final Class<?> clazz;       // 配置值类型
    private final T defaultValue;       // 默认值
    private final String description;    // 配置描述
    private final List<String> fallbackKeys;  // 废弃键名(兼容旧版本)

    private ConfigOption(String key, Class<?> clazz, T defaultValue,
                         String description, List<String> fallbackKeys) {
        this.key = key;
        this.clazz = clazz;
        this.defaultValue = defaultValue;
        this.description = description;
        this.fallbackKeys = fallbackKeys;
    }

    // Builder 模式
    public static class Builder<T> {
        private final String key;
        private Class<?> clazz;
        private T defaultValue;
        private String description = "";
        private List<String> fallbackKeys = new ArrayList<>();

        public Builder(String key) { this.key = key; }

        public Builder<T> intType() { this.clazz = Integer.class; return this; }
        public Builder<T> longType() { this.clazz = Long.class; return this; }
        public Builder<T> stringType() { this.clazz = String.class; return this; }
        public Builder<T> booleanType() { this.clazz = Boolean.class; return this; }
        public Builder<T> durationType() { this.clazz = Duration.class; return this; }
        public Builder<T> memoryType() { this.clazz = MemorySize.class; return this; }

        public Builder<T> defaultValue(T value) { this.defaultValue = value; return this; }
        public Builder<T> withDescription(String desc) { this.description = desc; return this; }
        public Builder<T> withDeprecatedKeys(String... keys) {
            this.fallbackKeys.addAll(Arrays.asList(keys));
            return this;
        }

        public ConfigOption<T> build() {
            return new ConfigOption<>(key, clazz, defaultValue, description, fallbackKeys);
        }
    }

    // 获取所有键(主键 + 废弃键)
    public Iterable<String> keys() {
        List<String> allKeys = new ArrayList<>();
        allKeys.add(key);
        allKeys.addAll(fallbackKeys);
        return allKeys;
    }
}
关键设计:
- Builder 模式构建,链式调用
- 支持多种类型:int/long/string/boolean/duration/memory/list/map/enum
- 支持默认值、描述、废弃键名
- keys() 返回主键和所有废弃键,实现版本兼容
- 类型安全:读取时根据 clazz 进行类型转换
ConfigOptions(配置项工厂)
ConfigOptions 是静态工厂类,提供创建 ConfigOption.Builder 的入口:
java
public class ConfigOptions {
    // 创建配置项 Builder
    public static <T> ConfigOption.Builder<T> key(String key) {
        return new ConfigOption.Builder<>(key);
    }
}
使用示例:
java
// 定义配置项
public class JobManagerOptions {
    public static final ConfigOption<MemorySize> PROCESS_MEMORY =
        ConfigOptions.key("jobmanager.memory.process.size")
            .memoryType()
            .defaultValue(MemorySize.parse("1600m"))
            .withDescription("Total process memory of JobManager.")
            .build();

    public static final ConfigOption<String> ADDRESS =
        ConfigOptions.key("jobmanager.rpc.address")
            .stringType()
            .noDefaultValue()
            .withDescription("JobManager RPC address.")
            .build();
}

// 读取配置
MemorySize jmMemory = configuration.get(JobManagerOptions.PROCESS_MEMORY);
2.3 类型安全读取链路
ConfigOption 实现了完整的类型安全读取链路:
scss
ConfigOptions.key("parallelism.default") → .intType() → .defaultValue(1) → .withDescription("...") → configuration.get(option) → 自动类型转换 → 返回 int 值支持的类型:
- 基本类型:int、long、string、boolean、double、float
- 时间类型:duration(如 10s、5min)
- 内存类型:memory(如 1024m、2g)
- 集合类型:list、map
- 枚举类型:enum
读取时自动类型转换,类型不匹配抛出 IllegalArgumentException。未配置时返回 ConfigOption 定义的默认值。使用 getOptional 可判断是否显式配置。
2.4 动态配置支持
Flink 1.10+ 支持通过 REST API 动态修改部分配置,无需重启集群:
支持动态修改的配置:
execution.checkpointing.interval:Checkpoint 间隔execution.checkpointing.timeout:Checkpoint 超时execution.checkpointing.min-pause:Checkpoint 最小间隔execution.checkpointing.tolerable-failed-checkpoints:容忍失败次数table.exec.resource.default-parallelism:Table 默认并行度
不支持动态修改的配置:
jobmanager.memory.*:JM 内存(需重启)taskmanager.memory.*:TM 内存(需重启)taskmanager.numberOfTaskSlots:Slot 数量(需重启)state.backend:状态后端(作业启动时确定)rest.address / rest.port:REST 地址端口(需重启)parallelism.default:默认并行度(作业级可覆盖)
动态配置通过 REST API PATCH /jobmanager/config 修改,仅影响运行时行为,不持久化到配置文件。标记为 @Documentation.SensitiveConfigOption 的配置不支持动态修改和查询。
2.5 配置在集群中的传递
配置在客户端和集群之间的传递流程:
css
客户端配置(flink-conf.yaml + -D 参数) → DynamicProperties 封装 → 序列化到 JobGraph → REST API 提交 → JobManager 加载本地配置 + 作业配置 → TaskManager 加载本地配置 + 作业配置关键细节:
- 客户端读取的 flink-conf.yaml 用于构建 JobGraph,不直接传递到集群
- 命令行 -D 参数封装为 DynamicProperties,随 JobGraph 序列化传递
- JobManager 和 TaskManager 启动时加载本地 flink-conf.yaml
- 作业级配置(DynamicProperties)覆盖集群本地配置
- 代码中 env.getConfig() 设置的配置优先级最高
三、核心配置参数全景与最佳实践
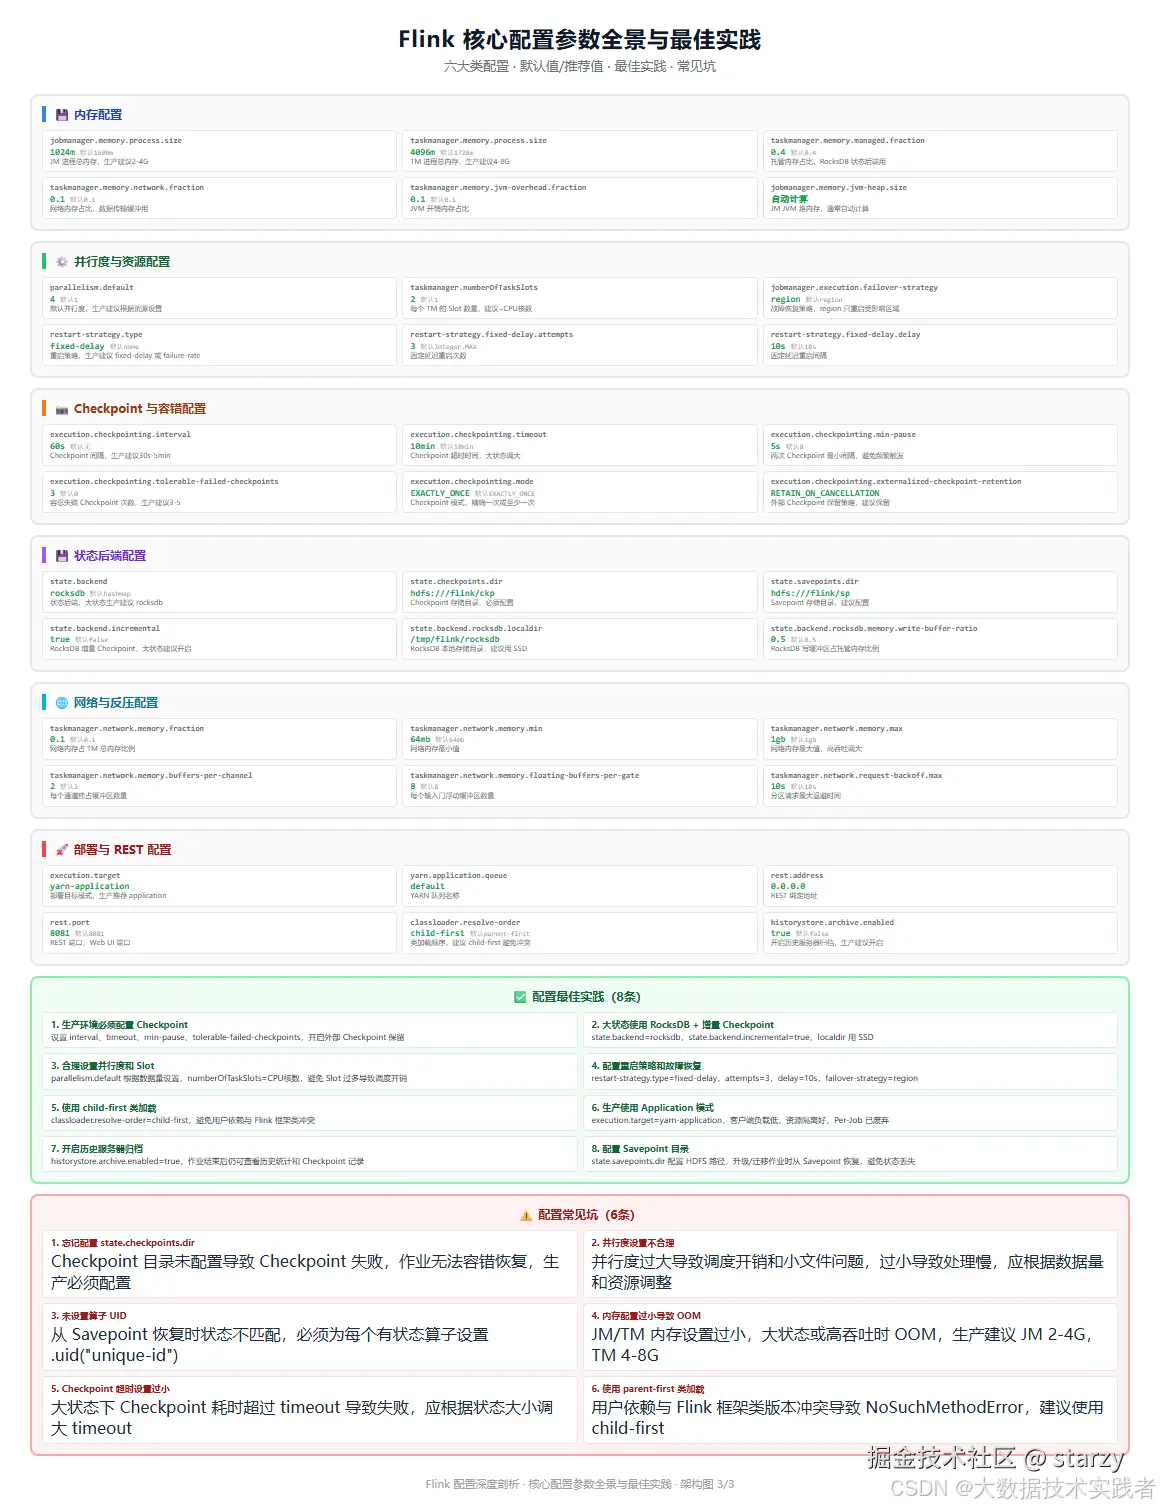
下面这张图是 Flink 核心配置参数全景与最佳实践,包括六大类配置、默认值/推荐值、8条最佳实践和6条常见坑。
3.1 内存配置
内存是 Flink 最核心也最容易出问题的配置。Flink 采用精细的内存模型,进程总内存分为 JVM 堆内存、托管内存、网络内存、JVM 开销等部分。
JobManager 内存:
yaml
# JM 进程总内存(推荐生产 2-4G)
jobmanager.memory.process.size: 2048m

# JM JVM 堆内存(通常自动计算,也可显式设置)
jobmanager.memory.jvm-heap.size: 1024m

# JM 堆外内存
jobmanager.memory.off-heap.size: 128m

# JVM 元空间
jobmanager.memory.jvm-metaspace.size: 256m

# JVM 开销(占进程总内存比例)
jobmanager.memory.jvm-overhead.fraction: 0.1
jobmanager.memory.jvm-overhead.min: 192m
jobmanager.memory.jvm-overhead.max: 1g
TaskManager 内存:
yaml
# TM 进程总内存(推荐生产 4-8G)
taskmanager.memory.process.size: 4096m

# TM 总 Flink 内存(进程总内存 - JVM 开销)
taskmanager.memory.flink.size: 3584m

# JVM 堆内存(Framework + Task)
taskmanager.memory.task.heap.size: 1024m

# 托管内存(RocksDB 状态后端、批处理排序、缓存)
taskmanager.memory.managed.fraction: 0.4
taskmanager.memory.managed.size: 1434m

# 网络内存(数据传输缓冲区)
taskmanager.memory.network.fraction: 0.1
taskmanager.memory.network.min: 64mb
taskmanager.memory.network.max: 1gb

# JVM 开销
taskmanager.memory.jvm-overhead.fraction: 0.1
taskmanager.memory.jvm-overhead.min: 192m
taskmanager.memory.jvm-overhead.max: 1g
内存调优建议:
- 大状态作业:增大托管内存(managed.fraction 调到 0.5-0.6),使用 RocksDB 状态后端
- 高吞吐作业:增大网络内存(network.fraction 调到 0.15-0.2)
- 纯流处理小状态:减小托管内存,增大堆内存
- 生产环境:JM 2-4G,TM 4-8G,根据实际负载调整
- 避免内存浪费:托管内存是预留的,不使用也会占用,根据实际需求设置
3.2 并行度与资源配置
yaml
# 默认并行度(生产建议根据数据量设置,通常 4-16)
parallelism.default: 4

# 每个 TM 的 Slot 数量(建议等于 CPU 核数)
taskmanager.numberOfTaskSlots: 2

# 故障恢复策略(region 只重启受影响区域,full 重启全部)
jobmanager.execution.failover-strategy: region

# 重启策略类型(none/fixed-delay/failure-rate/exponential-delay)
restart-strategy.type: fixed-delay

# 固定延迟重启次数
restart-strategy.fixed-delay.attempts: 3

# 固定延迟重启间隔
restart-strategy.fixed-delay.delay: 10s

# 故障率重启策略(可选)
restart-strategy.failure-rate.max-failures-per-interval: 3
restart-strategy.failure-rate.failure-rate-interval: 5min
restart-strategy.failure-rate.delay: 10s
并行度调优建议:
- 并行度 = 总 Slot 数时资源利用率最高
- 并行度过大:调度开销大、小文件问题、Checkpoint 慢
- 并行度过小:处理慢、反压、资源浪费
- 算子级并行度可以单独设置:
.setParallelism(8) - Source 并行度受数据源分区数限制(Kafka partition 数)
- Slot Sharing Group 可以控制哪些算子共享 Slot
3.3 Checkpoint 与容错配置
yaml
# Checkpoint 间隔(生产建议 30s-5min,根据状态大小调整)
execution.checkpointing.interval: 60s

# Checkpoint 超时时间(大状态调大,默认 10min)
execution.checkpointing.timeout: 10min

# 两次 Checkpoint 最小间隔(避免频繁触发,默认 0)
execution.checkpointing.min-pause: 5s

# 容忍失败 Checkpoint 次数(生产建议 3-5,默认 0)
execution.checkpointing.tolerable-failed-checkpoints: 3

# Checkpoint 模式(EXACTLY_ONCE/AT_LEAST_ONCE)
execution.checkpointing.mode: EXACTLY_ONCE

# 最大并发 Checkpoint 数(默认 1)
execution.checkpointing.max-concurrent-checkpoints: 1

# 外部 Checkpoint 保留策略(RETAIN_ON_CANCELLATION/DELETE_ON_CANCELLATION)
execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION

# 未对齐 Checkpoint(反压场景开启,Flink 1.11+)
execution.checkpointing.unaligned.enabled: true

# Checkpoint 存储(文件系统)
state.checkpoints.dir: hdfs:///flink/checkpoints

# Savepoint 存储
state.savepoints.dir: hdfs:///flink/savepoints
Checkpoint 调优建议:
- 必须配置 state.checkpoints.dir,否则 Checkpoint 无法持久化
- 大状态作业:调大 timeout,开启增量 Checkpoint,使用未对齐 Checkpoint
- 小状态低延迟:interval 可以设小(10-30s)
- 高吞吐大状态:interval 设大(1-5min),避免 Checkpoint 占用过多资源
- tolerable-failed-checkpoints 建议设 3-5,避免偶发网络抖动导致作业失败
- 生产环境开启外部 Checkpoint 保留,作业取消后仍可恢复
- 从 Checkpoint 恢复:
flink run -s :checkpointMetaDataPath ./job.jar
3.4 状态后端配置
yaml
# 状态后端类型(hashmap/rocksdb,生产大状态建议 rocksdb)
state.backend: rocksdb

# Checkpoint 存储目录
state.checkpoints.dir: hdfs:///flink/checkpoints

# Savepoint 存储目录
state.savepoints.dir: hdfs:///flink/savepoints

# RocksDB 增量 Checkpoint(大状态建议开启,默认 false)
state.backend.incremental: true

# RocksDB 本地存储目录(建议用 SSD,提升读写性能)
state.backend.rocksdb.localdir: /data/flink/rocksdb

# RocksDB 写缓冲区占托管内存比例(默认 0.5)
state.backend.rocksdb.memory.write-buffer-ratio: 0.5

# RocksDB 高优先级内存占比(默认 0.1)
state.backend.rocksdb.memory.high-prio-pool-ratio: 0.1

# RocksDB 预定义选项(DEFAULT/SPINNING_DISK_OPTIMIZED/SPINNING_DISK_OPTIMIZED_HIGH_MEM/FLASH_SSD_OPTIMIZED)
state.backend.rocksdb.predefined-options: FLASH_SSD_OPTIMIZED

# HashMap 状态后端异步快照(默认 true)
state.backend.async: true
状态后端选型:
- HashMapStateBackend:状态存在 JVM 堆内存,读写快,但受堆内存限制,适合小状态(GB 级以下)
- RocksDBStateBackend:状态存在本地磁盘(RocksDB),支持超大状态(TB 级),支持增量 Checkpoint,读写比堆内存慢但可接受
- 生产环境大状态作业必须用 RocksDB
- RocksDB localdir 建议用 SSD,机械盘性能差很多
- 增量 Checkpoint 只上传变化的 SST 文件,大状态下大幅减少 Checkpoint 时间和网络带宽
3.5 网络与反压配置
yaml
# 网络内存占 TM 总内存比例(默认 0.1)
taskmanager.network.memory.fraction: 0.1

# 网络内存最小值(默认 64mb)
taskmanager.network.memory.min: 64mb

# 网络内存最大值(默认 1gb,高吞吐调大)
taskmanager.network.memory.max: 1gb

# 每个通道独占缓冲区数量(默认 2)
taskmanager.network.memory.buffers-per-channel: 2

# 每个输入门浮动缓冲区数量(默认 8)
taskmanager.network.memory.floating-buffers-per-gate: 8

# 分区请求初始退避时间(默认 0ms)
taskmanager.network.request-backoff.initial: 0ms

# 分区请求最大退避时间(默认 10s)
taskmanager.network.request-backoff.max: 10s

# 网络缓冲区大小(默认 32kb)
taskmanager.network.memory.buffer-size: 32kb

# 基于信用的流控(默认 true,建议开启)
taskmanager.network.credit-based.enabled: true

# 缓冲区自动消胀(默认 true,Flink 1.14+)
taskmanager.network.memory.buffer-debloat.enabled: true
taskmanager.network.memory.buffer-debloat.target-duration: 200ms
网络调优建议:
- 高吞吐作业:增大网络内存(network.max 调到 2-4g),增大 floating-buffers-per-gate
- 低延迟作业:减小缓冲区大小(buffer-size 调到 8-16kb),但会降低吞吐
- 反压严重:检查下游算子处理能力,增大并行度,优化算子逻辑
- Credit 流控必须开启,避免网络拥塞
- 缓冲区自动消胀(Buffer Debloating)自动调整缓冲区大小,兼顾吞吐和延迟
- 网络内存不足会导致 "Insufficient number of network buffers" 错误
3.6 部署与 REST 配置
yaml
# 部署目标模式(yarn-session/yarn-per-job/yarn-application/kubernetes-session/kubernetes-application/remote)
execution.target: yarn-application

# YARN 队列
yarn.application.queue: default

# YARN 应用名称
yarn.application.name: Flink Job

# YARN 应用类型
yarn.application.type: Apache Flink

# REST 绑定地址
rest.address: 0.0.0.0

# REST 端口(Web UI 端口)
rest.port: 8081

# REST 绑定端口范围(端口冲突时自动递增)
rest.bind-port: 8081-8090

# 类加载顺序(parent-first/child-first,建议 child-first 避免类冲突)
classloader.resolve-order: child-first

# 父级优先模式排除的类(parent-first 时使用)
classloader.parent-first-patterns.default:
  - "java."
  - "scala."
  - "org.apache.flink."
  - "org.apache.hadoop."

# 历史服务器归档(生产建议开启)
historystore.archive.enabled: true

# 历史服务器归档目录
historystore.archive.dir: hdfs:///flink/history

# 历史服务器端口
historyserver.web.port: 8082
部署配置建议:
- 生产环境使用 Application 模式(yarn-application/kubernetes-application)
- Per-Job 模式已废弃(Flink 1.15+),不要使用
- child-first 类加载避免用户依赖与 Flink 框架类冲突
- 开启历史服务器归档,作业结束后仍可查看历史统计
- REST 端口范围配置避免端口冲突
- YARN 队列根据资源规划设置,重要作业使用独立队列
四、生产环境配置模板
下面是一个生产环境推荐的 flink-conf.yaml 配置模板,涵盖核心配置:
yaml
# ============================================================
# 基础配置
# ============================================================
jobmanager.rpc.address: flink-jobmanager
jobmanager.rpc.port: 6123

# ============================================================
# 内存配置
# ============================================================
jobmanager.memory.process.size: 2048m
taskmanager.memory.process.size: 4096m
taskmanager.memory.managed.fraction: 0.4
taskmanager.memory.network.fraction: 0.1
taskmanager.memory.network.max: 1gb

# ============================================================
# 并行度与资源
# ============================================================
parallelism.default: 4
taskmanager.numberOfTaskSlots: 2
jobmanager.execution.failover-strategy: region

# ============================================================
# 重启策略
# ============================================================
restart-strategy.type: fixed-delay
restart-strategy.fixed-delay.attempts: 3
restart-strategy.fixed-delay.delay: 10s

# ============================================================
# Checkpoint 配置
# ============================================================
execution.checkpointing.interval: 60s
execution.checkpointing.timeout: 10min
execution.checkpointing.min-pause: 5s
execution.checkpointing.tolerable-failed-checkpoints: 3
execution.checkpointing.mode: EXACTLY_ONCE
execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
execution.checkpointing.unaligned.enabled: true

# ============================================================
# 状态后端
# ============================================================
state.backend: rocksdb
state.backend.incremental: true
state.backend.rocksdb.localdir: /data/flink/rocksdb
state.backend.rocksdb.predefined-options: FLASH_SSD_OPTIMIZED
state.checkpoints.dir: hdfs:///flink/checkpoints
state.savepoints.dir: hdfs:///flink/savepoints

# ============================================================
# 网络配置
# ============================================================
taskmanager.network.credit-based.enabled: true
taskmanager.network.memory.buffer-debloat.enabled: true

# ============================================================
# 部署配置
# ============================================================
execution.target: yarn-application
yarn.application.queue: default
classloader.resolve-order: child-first

# ============================================================
# REST 与历史服务器
# ============================================================
rest.port: 8081
historystore.archive.enabled: true
historystore.archive.dir: hdfs:///flink/history
五、配置最佳实践与常见坑
5.1 配置最佳实践(8条)
1. 生产环境必须配置 Checkpoint 设置 interval、timeout、min-pause、tolerable-failed-checkpoints,开启外部 Checkpoint 保留。未配置 Checkpoint 的作业无法容错恢复,故障后只能从头开始。
2. 大状态使用 RocksDB + 增量 Checkpoint state.backend=rocksdb,state.backend.incremental=true,localdir 用 SSD。HashMap 状态后端受堆内存限制,大状态会 OOM。增量 Checkpoint 只上传变化的文件,大幅减少 Checkpoint 时间。
3. 合理设置并行度和 Slot parallelism.default 根据数据量设置,numberOfTaskSlots=CPU核数。并行度过大导致调度开销和小文件问题,过小导致处理慢。总并行度建议等于总 Slot 数,资源利用率最高。
4. 配置重启策略和故障恢复 restart-strategy.type=fixed-delay,attempts=3,delay=10s,failover-strategy=region。默认无重启策略,作业失败直接结束。region 故障恢复只重启受影响区域,比 full 重启影响小。
5. 使用 child-first 类加载 classloader.resolve-order=child-first,避免用户依赖与 Flink 框架类版本冲突。parent-first 模式下用户依赖的类会被 Flink 框架类覆盖,导致 NoSuchMethodError 等问题。
6. 生产使用 Application 模式 execution.target=yarn-application,客户端负载低,资源隔离好。Per-Job 模式已废弃。Session 模式适合开发测试,生产环境资源隔离差。
7. 开启历史服务器归档 historystore.archive.enabled=true,作业结束后仍可查看历史统计和 Checkpoint 记录。排查历史问题时非常有用。
8. 配置 Savepoint 目录 state.savepoints.dir 配置 HDFS 路径,升级/迁移作业时从 Savepoint 恢复。必须为每个有状态算子设置 .uid(),否则 Savepoint 恢复时状态不匹配。
5.2 配置常见坑(6条)
1. 忘记配置 state.checkpoints.dir Checkpoint 目录未配置导致 Checkpoint 失败,作业无法容错恢复。这是最常见的配置遗漏,生产环境必须配置。
2. 并行度设置不合理 并行度过大导致调度开销和小文件问题,过小导致处理慢和反压。应根据数据量、资源、数据源分区数综合调整。
3. 未设置算子 UID 从 Savepoint 恢复时状态不匹配,必须为每个有状态算子设置 .uid("unique-id")。Flink 自动生成的 UID 在代码变更后会变化,导致状态丢失。
4. 内存配置过小导致 OOM JM/TM 内存设置过小,大状态或高吞吐时 OOM。生产建议 JM 2-4G,TM 4-8G,大状态作业增大托管内存。
5. Checkpoint 超时设置过小 大状态下 Checkpoint 耗时超过 timeout 导致失败。应根据状态大小调大 timeout,同时开启增量 Checkpoint 减少耗时。
6. 使用 parent-first 类加载 用户依赖与 Flink 框架类版本冲突导致 NoSuchMethodError。建议使用 child-first,用户代码类优先加载。
六、总结
Flink 配置深度剖析要点回顾:
第一,配置体系整体架构是理解配置的基础。五种配置来源(代码设置 > 命令行 -D > 环境变量 > flink-conf.yaml > 默认值),高优先级覆盖低优先级。九大配置分类(内存/并行度/Checkpoint/状态后端/网络/部署/容错/REST/安全)。四级生效范围(客户端级/JobManager级/TaskManager级/作业级),作业级配置优先级最高。
第二,配置加载完整链路是原理核心。7步流程:确定配置目录 → 读取 flink-conf.yaml → 合并环境变量 → 合并命令行 -D → 构建 Configuration → ConfigOption 类型安全读取 → 各组件使用。6个核心类:GlobalConfiguration(加载入口)、Configuration(配置容器)、ConfigOption(配置项定义)、ConfigOptions(工厂)、ReadableConfig(只读接口)、DynamicProperties(动态属性)。ConfigOption 用 Builder 模式构建,支持类型安全读取和废弃键名兼容。动态配置支持 REST API 修改运行时参数,但内存、Slot、状态后端等不支持动态修改。
第三,核心配置参数全景是调优依据。内存配置:JM 2-4G、TM 4-8G,大状态增大托管内存,高吞吐增大网络内存。并行度:根据数据量设置,总并行度=总 Slot 数。Checkpoint:必须配置存储目录,interval 30s-5min,timeout 根据状态大小调大,tolerable-failed 3-5。状态后端:大状态用 RocksDB + 增量 Checkpoint,localdir 用 SSD。网络:高吞吐增大网络内存,Credit 流控必须开启,Buffer Debloating 兼顾吞吐延迟。部署:生产用 Application 模式,child-first 类加载,开启历史服务器归档。
第四,最佳实践和常见坑是生产经验。8条最佳实践:必须配置 Checkpoint、大状态用 RocksDB+增量、合理并行度和 Slot、配置重启策略、child-first 类加载、Application 模式、历史服务器归档、Savepoint 目录+算子 UID。6条常见坑:忘记 Checkpoint 目录、并行度不合理、未设置算子 UID、内存过小 OOM、Checkpoint 超时过小、parent-first 类冲突。
Flink 配置体系看似简单,实则蕴含精细的设计------分层的优先级机制保证了灵活性,类型安全的 ConfigOption 保证了可靠性,动态配置支持保证了可运维性。理解配置体系不仅能帮助调优作业性能,更能在遇到配置相关问题时快速定位根因。生产环境的配置不是一成不变的,需要根据作业特征、数据量、资源情况持续调整和优化。