一、为什么要写这篇文章
前段时间我接了个活儿,把测试环境的IoTDB数据整体迁到新集群。数据量不算特别大,2TB左右,两亿多个采集点。领导给的期限是两天。
接到任务的时候,我心里还琢磨,数据迁移嘛,不就是把数据弄出来再塞进去的事儿。之前也没认真研究过IoTDB的tools目录里那些脚本,就知道大概有这么个东西。结果一打开目录,好家伙,里面躺着一堆sh脚本,我当时人就有点懵。
第一天下午开始搞,先是导出。导出倒是顺利,一个SQL下去,数据哗哗地出来了。然后是导入,导入就出事了。我记得特别清楚,那天下午四点多开始跑导入,跑到五点多,我看终端没报错,以为完事了,去目标库一查,条数对不上。少了一截。
我又跑了一遍,盯着屏幕看。发现导入过程中有一些行报错了,但是报错信息混在一堆正常日志里,不仔细看根本注意不到。当时我心就凉了半截,这要是正式环境的数据丢了,那不是闹着玩的。
那天晚上我搞到凌晨两点多。卡在哪儿呢?时间戳。源数据是数字型的时间戳,导出的时候它给我转成了ISO格式,就是那种 2024-05-20T10:00:00.000+08:00 的样子。再往回导的时候,有一批时间特别早的数据死活导不进去,报错。后来查了半天才发现,是时间戳的时区设置和我文件里的格式对不上。
就这么个事儿,折腾了我四个多小时。第二天跟同事吐槽,他说他也踩过类似的坑,还踩过别的坑,比如CSV里带逗号的字段直接把列数干乱了。
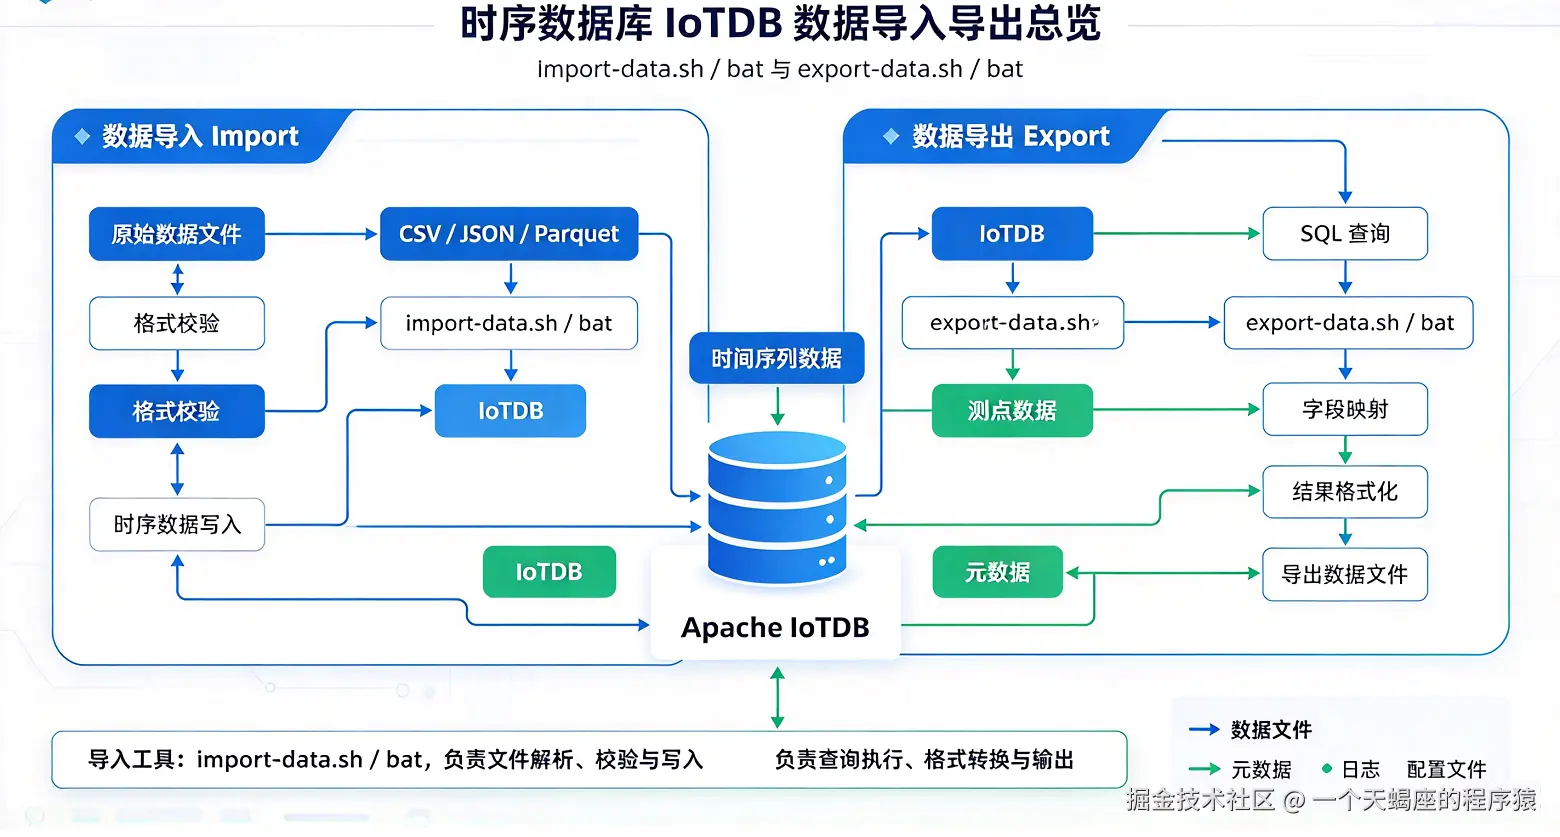
所以我就想,干脆把这些东西整理出来得了。我花了差不多两周时间,把import-data.sh和export-data.sh这两个工具翻来覆去地试,各种格式都玩了一遍。这篇文章就是我这段时间的记录。不踩一遍坑,真记不住它说的是啥意思。
二、先认识一下tools目录
先说基础的东西。不管你是用zip包解压安装的IoTDB,还是RPM装的,装完之后在安装目录下面都有一个 tools 文件夹。我们今天要说的两个主角就在这里面:
- import-data.sh(Windows下面是import-data.bat):导入工具。能把CSV、SQL、还有TsFile格式的数据导进IoTDB
- export-data.sh(Windows下面是export-data.bat):导出工具。能把SQL查询出来的结果导成CSV、SQL或者TsFile格式
注意一下,Linux用sh,Windows用bat,这两个只是入口不一样,参数基本是通用的。我下面都以Linux的写法为例,Windows的朋友把后缀换成bat就行。
还有一个事儿提前说:这些工具本质上是普通客户端。也就是说,它走的是正常的JDBC连接,你要保证你的机器能连上目标IoTDB的host和端口,账号密码得有写权限(导入)或者读权限(导出)。听起来是废话对吧?但我真见过有同事在容器里跑导入脚本,然后纳闷为啥连不上宿主机的库,折腾半天发现是网络没通。
三、导入工具import-data.sh:三种格式逐个说
3.1 最基本的用法
先把命令行的骨架放这:
bash
./import-data.sh -h 127.0.0.1 -p 6667 -u root -pw root -f /data/import/xxx.csv参数都是啥意思:
-h:主机地址-p:端口,默认6667-u:用户名-pw:密码-f:要导入的文件,可以写绝对路径也可以写相对路径。多个文件用空格隔开,还支持通配符-ft:导入格式,有csv、sql、tsfile三个选项。这个参数挺重要,工具会根据它决定怎么解析你的文件
还有个 -sd 参数,指定一个源目录,工具会把目录底下的文件挨个导进去。批量导入的时候用这个比 -f 省事。
3.2 CSV导入,坑最多的一个
CSV是日常用得最多的格式,也是坑最多的格式。我慢慢说。
先说文件格式。 IoTDB的CSV导入有个约定:CSV文件的名字就是设备名。比如你的设备是 root.sg.d1,那文件就得叫 root.sg.d1.csv。文件里面的第一列是时间,后面的列是这个设备下面的各个测点。
比如 root.sg.d1.csv 里面长这样:
css
Time,root.sg.d1.s1,root.sg.d1.s2,root.sg.d1.s3
1,6.6,6.6,hello
2,7.7,7.7,world
也可以写成简写,表头不写全路径,只写测点名:
css
Time,s1,s2,s3
1,6.6,6.6,hello
2,7.7,7.7,world
这两种都行。我个人习惯用简写的,写全路径太长了,看着累。
再说类型的问题。 这里有个容易犯迷糊的地方:如果这个测点在IoTDB里还不存在,那导入工具怎么知道该建什么类型的序列?这时候表头里写个名字它是不够的。你可以额外给一个表头文件,用 -header 参数指定,里面写清楚每个测点的类型,像这样:
scss
Time,root.sg.d1.s1(INT32),root.sg.d1.s2(DOUBLE),root.sg.d1.s3(TEXT)类型就这么声明。要是你导入的测点在库里已经存在了,那类型不一致的话会报错,工具不会帮你自动转。我第一次用的时候就想当然地以为它会自动把字符串"123"转成数字,结果给我报了一屏幕的错。
然后是时区。 这个是我踩过最疼的坑。-tz 参数,默认是 +08:00。如果你的CSV里的时间列是数字型时间戳,倒还好说。但如果时间列是那种字符串格式的日期,时区一定要对上。我那次就是源端的数据是UTC时间写的字符串,我按默认的+08:00去解析,早八个小时,一批数据的时间全歪了。歪了也就算了,还有一部分数据直接落到了时间分区范围外面,导不进去,悄无声息地失败了。
对,悄无声息。这是我要重点吐槽的地方。导入失败的数据默认行为是什么?你最好搞清楚再跑。 有个 -failed 参数可以指定一个目录,导入失败的行会被写成文件放到这个目录里。你要是不指定,失败的行就那么过去了,控制台上混着一些日志,你眼神不好就错过了。所以我现在跑导入,必加这个参数:
bash
./import-data.sh -h 127.0.0.1 -p 6667 -u root -pw root \
  -ft csv -f /data/root.sg.d1.csv \
  -tz +08:00 \
  -failed /data/failed/
跑完先去 /data/failed/ 目录下面看有没有东西,有东西就说明有失败行,处理完再补。
还有个性能参数。 -lines 参数,表示一个事务里塞多少行。默认值我记得是几百上千这个量级。数据量特别大的时候,可以适当调大一点,比如几万,写入速度能明显上去。但也别调得特别夸张,事务太大内存扛不住,而且中途出错回滚的代价也大。我一般先拿一小批数据试,看机器的负载情况再定。
3.3 SQL导入:简单直接
SQL导入比CSV省心多了。你搞一个 .sql 文件,里面一行一条insert语句:
sql
insert into root.sg.d1(timestamp,s1) values(1,1);
insert into root.sg.d1(timestamp,s1) values(2,2);
insert into root.sg.d1(timestamp,s1) values(3,3);
然后导:
bash
./import-data.sh -h 127.0.0.1 -p 6667 -u root -pw root \
  -ft sql -f /data/dump.sql
就这么简单。因为语句本身就是合法的IoTDB SQL,工具做的事情就是把它一行行拿出来执行,类型啊时区啊这些都是SQL自己声明的,没那么多幺蛾子。
我一般什么时候用这个格式呢?两种情况。一是从别的地方拿到的数据本来就是SQL语句的形式,比如导出工具导出来的SQL文件,再导回去,这种来回倒腾的场景。二是手工构造测试数据,写个脚本生成一批insert语句,造个几千万的点,测写入性能什么的,比拼CSV舒服。
不过SQL格式的导入速度,通常来说没有CSV快。因为SQL要做语句解析,CSV是直接拼数据。数据量上去了这个差距还是能感觉出来的。上次我那个两亿点的迁移,一开始用SQL格式导,跑了一半感觉太慢,后来换成了TsFile方式,速度差得不是一星半点。
3.4 TsFile导入:性能天花板
TsFile是IoTDB自己的文件格式。这里得先安利一下TsFile这个东西。
TsFile你可以理解成IoTDB的"原生方言"。它本身就是列式存储的时序文件,里面数据都是编码压缩过的。所以用TsFile导入有个天然优势:它不需要解析。不像CSV要一行行读、一行行解析、一行行转类型,TsFile本身就是IoTDB认识的结构,导入的时候基本就是个文件级的操作,快得多。
用法:
bash
./import-data.sh -h 127.0.0.1 -p 6667 -u root -pw root \
  -ft tsfile -f /data/xxx.tsfile \
  -fd /data/tsfile_failed/
-fd 参数指定一个失败目录,跟CSV那个 -failed 有点像,文件导入失败会被挪到这里面,方便你排查重试。
我那次两亿点的迁移,最后就是用TsFile方案搞定的。先从源集群把数据导成TsFile,再往新集群导。整个流程下来比我最开始用SQL格式导快了得有五六倍。而且TsFile还有个好处,导出来的文件体积小,它本身是压缩的,传输起来也快。
这里有个细节要注意:TsFile导入的时候,加载的这些文件会被移动到IoTDB的数据目录里面去。也就是说,导完之后你原来的那个文件就不在原位了。第一次用的时候我还以为我文件丢了,找了半天,后来发现是被IoTDB"收编"了。这一点跟CSV和SQL的导入逻辑完全不一样,CSV就是个数据源,导完跟你没关系了,TsFile是直接被当成数据文件管理起来了。
3.5 一个容易被忽略的参数:-on
-on 这个参数我单独拎出来说一下。它的作用是:批量导入的时候,某个文件失败了,要不要继续处理剩下的文件。
默认情况下,一个文件挂了,整个导入任务就停了。如果你的目录里有几百个文件,导到第50个挂了,剩下的450个就不动了。加上 -on 参数,挂了这个继续下一个,最后你到失败目录里看看哪些文件没进去,单独处理就行。
批量场景下我基本都加这个参数,不然中间一个文件有脏数据,我大半夜还得爬起来重新跑。
四、导出工具export-data.sh
导出工具比导入工具简单一些,参数也少。基本用法:
bash
./export-data.sh -h 127.0.0.1 -p 6667 -u root -pw root \
  -s "select * from root.sg. where time > 2024-01-01" \
  -dataDir /data/export/ \
  -filename mydata
参数解释:
-s:SQL语句,就是你平时查数据用的select语句,加where条件、聚合函数都行-t:目标格式,csv、sql、tsfile三个选一个,默认是csv-tf:时间戳格式,有numeric、ISO、both、default几个选项-dataDir:导出目录-filename:导出文件名
4.1 导成CSV
默认格式就是CSV。-tf 参数控制时间列的输出格式:
numeric:输出数字时间戳,比如1716163200000ISO:输出2024-05-20T10:00:00.000+08:00这种both:两种都要,导出来两列default:跟着数据原来的类型走
这个参数,跟你后面怎么用这份数据强相关。要是导出来给人看、给Excel打开分析,ISO格式好,肉眼能读懂。要是导出来是为了再导回另一个IoTDB,或者给程序消费,numeric省事,不用再转一道。
我那次踩坑就是这里。默认导出来是ISO格式的带时区信息,我当时没注意,拿去导入的时候时区又没对齐,数据就歪了。所以现在我的习惯是:只要是给机器用的,统一numeric;给人看的,才用ISO。
还有一点,导出来的CSV文件名是按设备来的,一个设备一个文件,文件名就是设备路径。你查 root.sg.,里面有一万个设备,它就给你导一万个文件出来。所以 -dataDir 目录最好是空的,不然几百个文件混在一起,你都不知道哪个是新导的。
4.2 导成SQL
把 -t 参数设成sql:
bash
./export-data.sh -h 127.0.0.1 -p 6667 -u root -pw root \
  -s "select * from root.sg.d1" \
  -t sql -dataDir /data/export/
导出来的文件里面全是insert语句,长这样:
sql
INSERT INTO root.sg.d1 (TIME, s1, s2) VALUES (1716163200000, 1.0, 'abc');这种格式的用途就很明确了:给另一个IoTDB导回去用。因为语句是自解释的,类型、时间都在语句里,跨版本、跨环境的兼容性比较好。我有时候也用它来做小批量的数据备份,比如某个设备的某段数据要回滚之前,先select出来存成SQL文件,出问题了还能导回去。
但前面也说了,数据量大了它慢。我的经验值是,千万级以上的点,就别考虑SQL格式了,老老实实用TsFile。
4.3 导成TsFile
bash
./export-data.sh -h 127.0.0.1 -p 6667 -u root -pw root \
  -s "select * from root.sg." \
  -t tsfile -dataDir /data/export/
这是我现在的首选方案,尤其是大数据量的迁移场景。导出来的就是 .tsfile 文件,直接拿到目标集群,用 import-data.sh -ft tsfile 导进去,一气呵成。
优势前面说过了:快、小、原生。劣势嘛,就是TsFile是二进制格式,你没办法打开肉眼检查内容。要是你想验证一下导出来的数据对不对,得把它再导入到一个库里去查,绕一圈。我一般的做法是:全量数据用TsFile跑,然后随机抽几个小的设备,用CSV格式再导一遍,肉眼对一对数据,确认没问题。
4.4 一个小提醒:查询超时
导出本质上还是执行一个查询。你要是导全量数据,这个查询跑的时间会很长,注意 -queryTimeout 这个参数(如果你的版本有的话),别数据没导完,查询先超时断了。我一开始导两亿个点的时候没设这个,跑到一半连接断了,还以为是网络问题,重跑了一遍才意识到可能是超时。
五、把我踩过的坑汇总一下
这一节算是个避坑清单,按疼的程度排的。
坑一:CSV里的逗号。 CSV这个格式吧,天生有个矛盾:逗号是分隔符,那数据里要是有逗号怎么办?标准做法是给字段加双引号。IoTDB的导入工具是支持带引号的CSV的,但你导出的数据源不一定规范。我当时有一批TEXT类型的字段,里面存的是报警描述,类似"温度过高,请检查"。就这种数据,源系统导出的时候没加引号,一个字段被劈成两半,后面的列全错位了。错位还不是直接报错,是数据类型对不上的才报错,有些恰好类型兼容的,就错着导进去了,特别阴险。
坑二:时间戳的坑。 前面说了,时区、格式,一定要统一。我的建议是全链路用numeric时间戳,从根上避免字符串解析这一层的坑。
坑三:文件名和设备路径不一致。 CSV导入的时候文件名就是设备名,这个前面说了。有一种情况容易翻车:设备名里有特殊字符,或者Windows下面文件名不支持的字符。比如设备路径里带空格的,文件名带空格,命令行里就得加引号,不加引号路径就被截断了。还有设备名特别长的情况,Windows对路径长度有260字符的限制,超长路径直接挂。
坑四:失败数据悄悄丢。 再强调一遍,跑完导入,去失败目录看一眼。别信控制台的输出,日志一滚屏,什么你都看不见。-failed 和 -fd 参数,永远加上。导完之后数一下条数,跟源端对一对。条数对不上,中间一定有故事。
坑五:内存。 有个 -lpf 参数,控制一次往内存里加载多少行。数据文件特别大的时候,如果默认值加载不動,报OOM,可以调小这个参数,用时间换空间。反过来,内存富余的话调大一点,速度能快一些。
坑六:大事务回滚。 -lines 参数调太大有风险。我试过一次把一个事务里塞了几百万行,结果中途有一行数据类型有问题,整个事务回滚,前面写的全部白干。所以这个参数要平衡:大了快,但失败的代价也大。
六、一套完整迁移方案
把我最终打磨出来的流程放这,以后有类似的活儿可以直接抄。
第一步,源端导出,用TsFile格式。
bash
./export-data.sh -h old-cluster-host -p 6667 -u root -pw  \
  -s "select  from root." \
  -t tsfile -dataDir /backup/old_data/
第二步,校验。 源端跑个统计:
sql
select count(*) from root.;把数字记下来。顺便记一下每个存储组的条数,后面分块对账用。
第三步,目标端导入。
bash
./import-data.sh -h new-cluster-host -p 6667 -u root -pw  \
  -ft tsfile -sd /backup/old_data/ \
  -fd /backup/failed/ -on
第四步,对账。目标端跑同样的count,跟源端的数字对。对不上的,去失败目录里面找原因,处理完补导。
第五步,抽查。 随机挑几个设备,把一段时间的数据在两边分别查出来,肉眼比一比。数值、时间戳、条数,都看一眼。
这套流程我后来在好几个环境之间倒腾数据,都没再出过事。两亿个点,全流程下来差不多40分钟,大头是网络传输的时间。
七、一些性能上的经验
工具层面能调的东西其实不多,我把有效的几个说说。
单个导入工具的写入速度,瓶颈通常在服务端。想快,可以开多个导入进程,把文件拆开,每个进程导一部分。比如你有20个文件,开4个进程,每个进程5个文件。服务端的写入能力是有上限的,进程数不是越多越好,超过了就是纯粹给服务端添堵。我的经验是4到8个进程比较合适,具体得看你集群的配置。
导入之前,确认一下目标库的几个参数。比如WAL相关的配置,迁移场景下,如果数据丢了可以重导,可以把WAL适当调低一点,减少导入期间的IO压力。还有刷盘的触发条件,memtable特别小的话,刷盘会很频繁,小文件哗哗地出,后面合并压力大。这个就得看情况权衡了,短期行为没事,长期在线的库别乱动。
如果是给线上库导数据,挑个业务低峰期。导入是实打实吃写入资源的,跟线上写入抢资源,搞不好把正常业务挤出一个写入延迟的尖刺。我们之前有个库就是,白天有人跑大批量导入,把实时写入的延迟顶上去了,告警群直接炸了。
八、结语
这篇文章差不多把我这几个月跟导入导出工具斗争的经历都倒出来了。回头看,IoTDB自带的这两个工具,功能上其实覆盖了绝大部分迁移场景,不需要你去额外装什么ETL工具。
博主的整体感受是这样:CSV格式适合跟外部系统打交道,人能读,Excel能开,通用性最好,就是坑多,得小心;SQL格式适合小批量、要人工检查的场景,兼容性好但速度一般;TsFile是IoTDB之间的数据搬运最优解,又快又小,就是黑盒,不能直接看。如果是我的话,会把这些坑整理成一页检查清单,每次跑迁移之前过一遍:时区对不对,失败目录设置了嘛,条数对账这些东西。