资深 Java 面试到 Agent 开发工程师 · 第 08 集
多个线程共同修改一个 Map 时,我们通常会想到 ConcurrentHashMap。它是线程安全的,但下面这次"加一"仍可能算错:
java
int old = map.get("count");
map.put("count", old + 1);
如果 get、put 都安全,为什么放在一起就出了问题?遇到这种代码,是继续加锁,还是换一种写法?
这里讨论的是多个线程使用同一个集合。例如,同一个 Service 对象的成员变量可能被多个请求线程访问。若每次调用都在方法里新建一个 HashMap,并且只在当前线程使用,就没有这种共享修改的问题。
1. 两个线程各加一次,为什么结果是 1?
先创建一个 Map,把计数设为 0。初始化在两个线程开始工作之前完成:
java
ConcurrentHashMap<String, Integer> map = new ConcurrentHashMap<>();
map.put("count", 0);
然后,线程甲和线程乙各执行一次开头的"读取、加一、写回"。它们可能按这个顺序执行:
text
线程甲:读到 0,存在自己的 old 变量里
线程乙:也读到 0,存在自己的 old 变量里
线程甲:计算 0 + 1,把 1 写入 Map
线程乙:计算 0 + 1,也把 1 写入 Map
最后的值是 1。线程乙写入时,Map 里已经是 1,但它不会重新读取;它用的仍是之前保存在自己变量里的 0。
put("count", 1) 的意思是"把值设为 1"。Map 没有收到"再加一次"的要求,当然也就不会替线程乙把 1 改成 2。
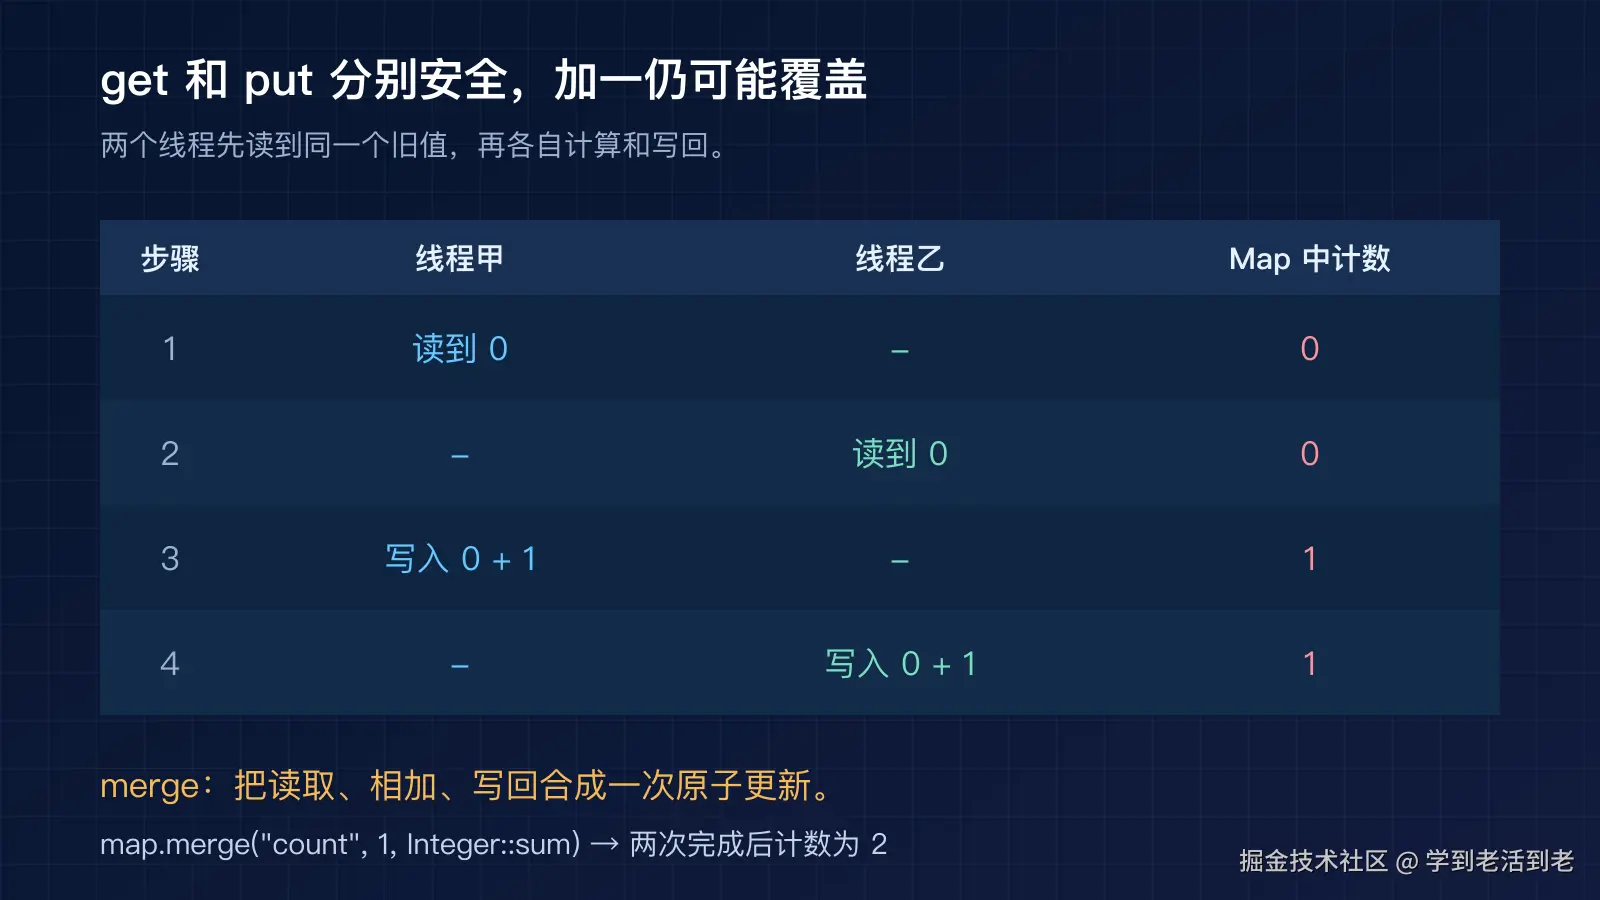
ConcurrentHashMap 能处理多个线程对它的并发访问。get 返回以后,其他线程仍可以修改同一个 key;这次读取不会替后面的 put 提前锁住它。
前面学过的 count++ 也有读、改、写三个步骤。即使每个方法调用都安全,把它们拼起来仍不一定是一次不可分割的操作。这种由多个步骤组成的操作,叫复合操作。
2. 让 Map 一次完成"读取、加一、写回"
计数可以直接写成:
java
map.merge("count", 1, Integer::sum);三个参数分别是要更新的 key、本次增加的 1、怎样合并旧值与这个 1。Integer::sum 是求和函数的简写,相当于:
java
map.merge("count", 1, (oldValue, increment) -> oldValue + increment);key 不存在时,merge 放入 1;已经存在时,用当前值加 1,再保存结果。
对 ConcurrentHashMap 而言,这一整次更新是原子的。计数原来是 0,两个线程各调用一次 merge:先执行的把 0 改成 1,后执行的接着把 1 改成 2。它们不会同时拿着旧的 0,各自覆盖成 1。
如果需要的操作没有现成方法,也可以自己加锁。例如,下面是一个共享对象里的字段和方法:
java
private final Object lock = new Object();
private final Map<String, Integer> map = new HashMap<>();

public void increment() {
    synchronized (lock) {
        int old = map.getOrDefault("count", 0);
        map.put("count", old + 1);
    }
}
锁包住整个读取和写回,其他调用 increment() 的线程要等这次加一结束。这种写法使用普通 HashMap 就可以;读取、删除等其他访问也必须使用同一把锁,字段不能直接暴露给外部随意操作。
仅仅在一处写 synchronized (map),并不能让所有直接调用 ConcurrentHashMap.put() 的线程跟着等。后者没有使用你加的这把外部锁。
3. merge 内部怎样保护这次更新?
Map 内部需要先找到 key 对应的位置。哈希表数组中的一个位置通常称为"桶",同一桶可能放着多个不同 key 的节点,每个节点保存 key 和 value。
OpenJDK 21 的 merge 在处理已有链表节点时,会锁住桶头节点,然后计算新值并写回。下面是该分支的删节,查找和其他分支用注释省略:
java
synchronized (f) {
    // 复检桶头,再沿链表找到匹配的节点 e
    // ...
    val = remappingFunction.apply(e.val, value);
    if (val != null)
        e.val = val;
    // ... 返回 null 时删除映射等分支
}
f 是桶头节点,e.val 是找到的旧值,value 是传入的 1。remappingFunction 就是刚才的求和函数,计算结果暂存在 val 中,再写回节点。
计算和写回都在同一个 synchronized 内。同一桶中也需要获取这把锁的更新,会等当前线程退出;后一个线程进入后,使用更新后的值继续计算。不同 key 如果落在同一个桶,也可能互相等待。
空桶还没有节点可以锁,插入路径会用 CAS 尝试放入新节点。CAS 会检查位置是否仍为空,只有检查成立才写入;若被其他线程抢先占用,就重新检查。这和第 3 集讲的"比较后更新"是同一种思路。
这也带来了一个实际限制:如果合并函数里调用远程接口,等待返回期间可能一直持有桶上的锁,同桶的其他更新也会被拖住。因此,合并函数适合做求和、比较这类短计算,不适合长时间等待,也不应在里面递归修改这个 Map。
读取则走另一条路径。get 通常不用获取更新时的锁;节点的值是 volatile 字段,节点的发布和读取也有相应的内存可见性保证。读取得到某次更新的值,与把这个值保存到局部变量后继续计算,是两件事:后者仍然可能拿着旧值工作,这正是第一节的问题。
4. Map 里的 ArrayList,也一起变安全了吗?
前面的值是 Integer。现在把值换成一个可以修改的列表,就多了一种需要检查的操作:
java
ConcurrentHashMap<String, List<String>> map = new ConcurrentHashMap<>();
map.put("names", new ArrayList<>()); // 在线程开始前初始化
两个线程随后都执行:
java
List<String> names = map.get("names");
names.add("A");
第一行让 Map 返回列表的引用;第二行调用的是这个列表的 add。此时 Map 的 get 已经结束,两个线程拿到的是同一个普通 ArrayList,可能同时修改它的数组和元素个数。两个 add 可能把元素写到同一个位置,最终少存一个元素。
所以,Map 能安全地保存、返回这个引用,却不会给列表之后的每次操作自动加锁。
如果要继续使用 ArrayList,可以让所有访问同一个列表的代码都使用这个列表作为锁:
java
List<String> names = map.get("names");
synchronized (names) {
    names.add("A");
}
读取、删除、遍历也要遵守同一规则。这里假定初始化后的列表不会被替换或从 Map 移除;否则还需要处理"一个线程继续操作旧列表,另一个线程已经换了新列表"的情况。
项目里常把查找和创建写在一行:
java
map.computeIfAbsent("names", key -> new ArrayList<>()).add("A");computeIfAbsent 表示"有这个 key 就返回值,没有才计算并放入一个值"。它保证查找或建立映射这一步的原子性,末尾的 add 仍然是另一次调用。把代码缩成一行,并没有把这两步合成一个操作。
5. 列表一边遍历,一边修改怎么办?
前一节用锁保护列表。遍历也放在同一把锁里时,写入者需要等遍历结束。若列表经常被遍历,很少修改,而且一次遍历可以继续使用开始时的内容,还可以考虑 CopyOnWriteArrayList,简称 COW 列表。
它把元素保存在数组里。添加元素时,写入者复制出一个新数组,把新元素放进去,再让列表指向新数组;已经开始遍历的迭代器继续读旧数组。
这个短例子可以直接看出差别:
java
CopyOnWriteArrayList<String> list = new CopyOnWriteArrayList<>();
list.add("A");
Iterator<String> it = list.iterator();

list.add("B");
it.forEachRemaining(System.out::println); // 只输出 A
System.out.println(list);                 // 输出 [A, B]
示例使用 java.util.Iterator 和 java.util.concurrent.CopyOnWriteArrayList。迭代器是在添加 B 之前创建的,它手里的数组只有 A。列表现在指向的数组有 A、B,两边读的不是同一个数组。
OpenJDK 21 的 add 实现如下:
java
public boolean add(E e) {
    synchronized (lock) {
        Object[] es = getArray();
        int len = es.length;
        es = Arrays.copyOf(es, len + 1);
        es[len] = e;
        setArray(es);
        return true;
    }
}
es 是数组,e 是新元素。Arrays.copyOf 创建一个长一格的新数组;setArray 把它保存到列表的 volatile 数组引用中。锁让多个写入者依次完成更新,避免各自复制旧数组后互相覆盖。
迭代器的创建代码是:
java
public Iterator<E> iterator() {
    return new COWIterator<E>(getArray(), 0);
}
它拿到当前数组引用,从下标 0 开始遍历。创建迭代器没有再复制数组;后续添加、删除产生的新数组,也不会替换它已经保存的引用。因此,其他线程修改列表时,它不会抛出 ConcurrentModificationException,但也不会看到新加入的元素。
例如,一组回调函数经常被依次执行,注册和注销很少发生,就可能适合这种列表。若某个回调在本轮遍历开始后被注销,旧迭代器仍可能执行它;业务需要能接受这一点。
频繁追加大量数据则会不断复制数组。列表越长,每次追加要复制的内容越多。数组复制的还是对象引用,元素对象内部的字段仍需单独处理并发读写。
常见面试题怎么答?
HashMap 和 ConcurrentHashMap 有什么区别?后者怎样保证线程安全?
HashMap 不保证并发修改安全,可以由一个线程独占使用,也可以由调用者统一加锁。ConcurrentHashMap 在内部处理并发访问,并提供 merge 等原子更新方法。
以 OpenJDK 21 的常见路径为例:空桶插入用 CAS;已有节点的部分更新路径用桶头作为锁;读取利用节点发布和 volatile 等可见性机制,通常不获取更新锁。不同 key 可能落在同一桶,因此也可能竞争同一把锁。
ConcurrentHashMap 能保证 get 后再 put 的原子性吗?
不能。每次调用之间都有空隙,另一个线程可以在这时读取或修改同一个值。计数可以用 merge,根据旧值计算新值可以用 compute。如果自己加锁,需要包住完整操作,并让所有相关访问遵守同一把锁。
这些方法仍有范围:一次对一个 key 的更新,不会自动保护另一个 key;从 Map 取出的普通列表,也不会自动获得线程安全。
CopyOnWriteArrayList 为什么适合读多写少?
添加元素时复制并发布新数组,迭代器继续遍历自己保存的旧数组,不需要获取写入锁。代价是写入需要复制,旧迭代器看不到新内容,且它不支持 remove(),调用会抛出 UnsupportedOperationException。
所以除了读写比例,还要看数组大小和业务是否接受旧内容。复制数组不等于复制元素对象,元素的可变字段也不因此受到保护。
读完自测
- 两个线程调用
merge更新计数。另一个线程仍执行get后加一再put,最后的计数一定准确吗? - Map 里的列表从
ArrayList换成CopyOnWriteArrayList后,if (!list.contains("A")) list.add("A")能保证不出现重复的 A 吗? - COW 列表已有 A、B,创建迭代器后又删除了 B。旧迭代器会看到什么?如果要求 B 此后绝不能再被处理,只调用
remove够吗?
第 1 题参考:不一定。第三个线程仍可能读到旧值,随后覆盖其他线程通过 merge 写入的新值。所有加一操作都要使用能够完整保护这次更新的做法。
第 2 题参考:不能。两个线程可能都先判断"不包含 A",再各添加一次。contains 和 add 分别安全,组合仍不原子;COW 列表的 addIfAbsent("A") 可以完成这次"没有才添加",参与添加的代码应采用一致做法。
第 3 题参考:旧迭代器仍会看到 A、B,它持有的数组没有改变。仅 remove 不够,还需要协调停止处理与正在执行的遍历,明确已经开始处理的 B 如何处置。
参考资料: