上一篇讲的是代码库------为什么 AI 让它从审美问题变成了硬指标,以及一份好代码库该怎么维护。那篇开头列了四条失败模式:对齐失败、太啰嗦、跑不起来、建出一坨泥。第四条最要命,上篇讲完了 ,这篇处理剩下三件,外加它们共同的前提------人该管哪一段、活该怎么拆开做。
这篇里的「这个仓库」,指的是 Matt Pocock 那套开源的 skills------github.com/mattpocock/skills,一套装进 Claude Code、Codex 这类工具、用 /命令 调用的技能包。
AI 干掉了战术活,剩下战略活
把写代码拆开,是两种活。
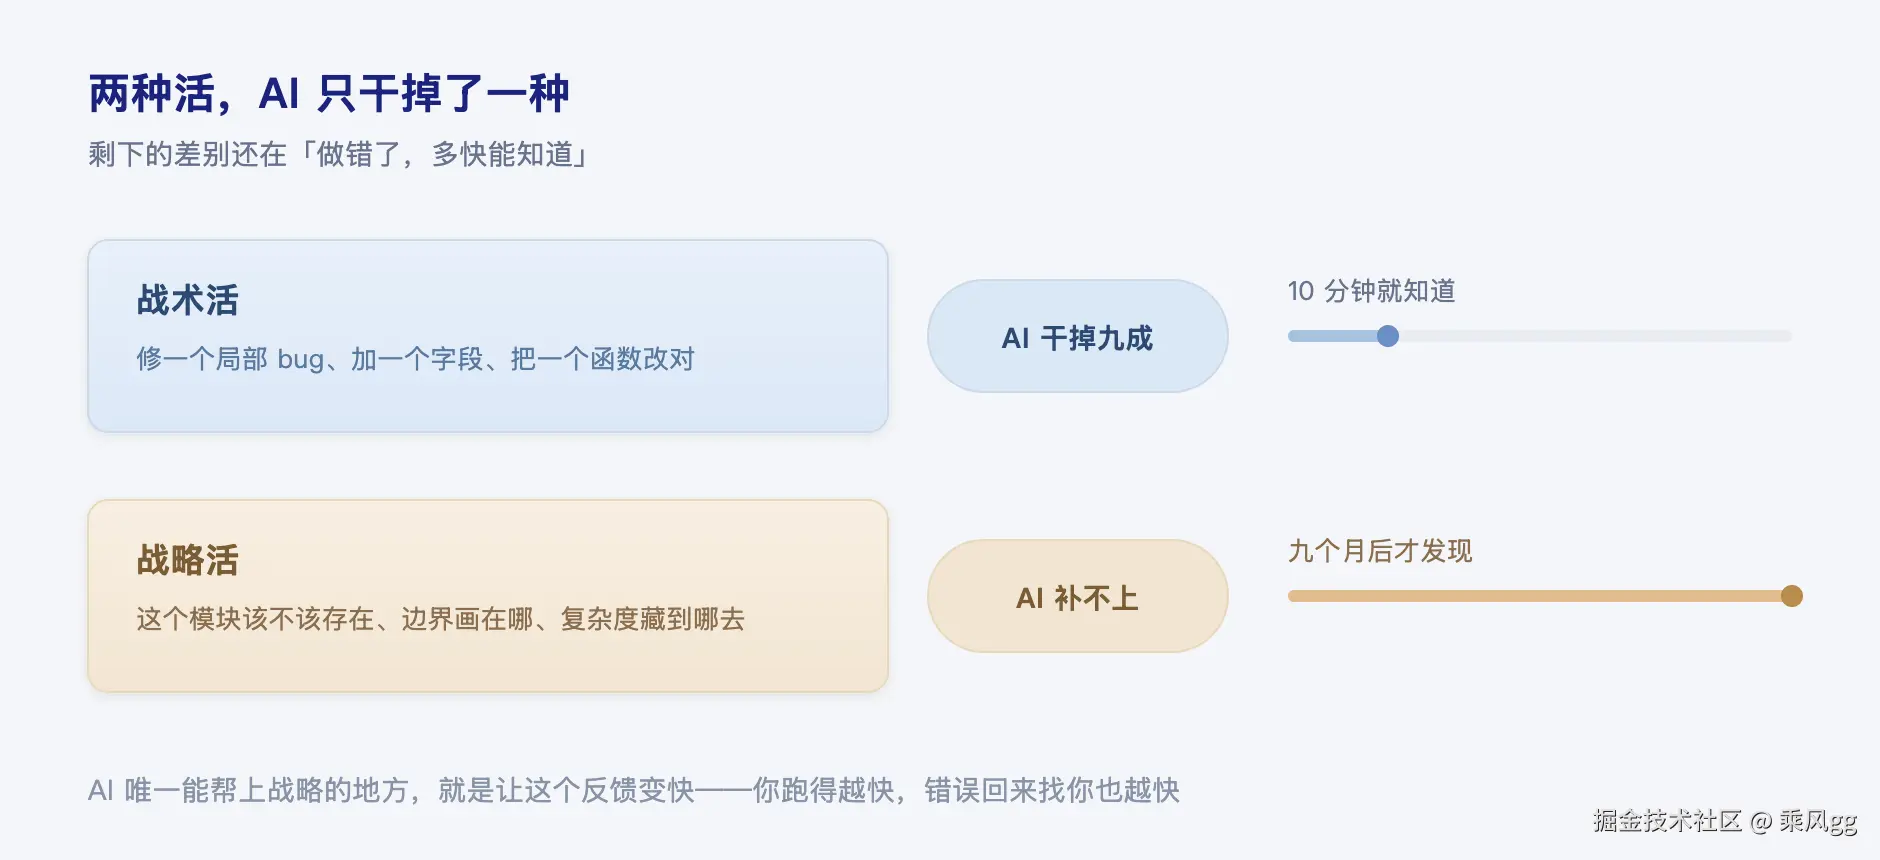
一种是战术活------修一个局部 bug、加一个字段、把一个函数改对。这类 AI 很拿手,我估摸着干了九成以上。
另一种是战略活 ------这个模块该不该存在、边界画在哪、复杂度藏到哪去。这类 AI 不行,短期也补不上:它擅长打赢一场仗,不擅长想三个月以后的事。
两种活还有个关键差别,是做错了多快能知道 。战术活做错,十分钟就知道;战略活做错------比如数据流混乱------可能要等九个月。AI 唯一能帮上战略的地方,就是让这个反馈变快。
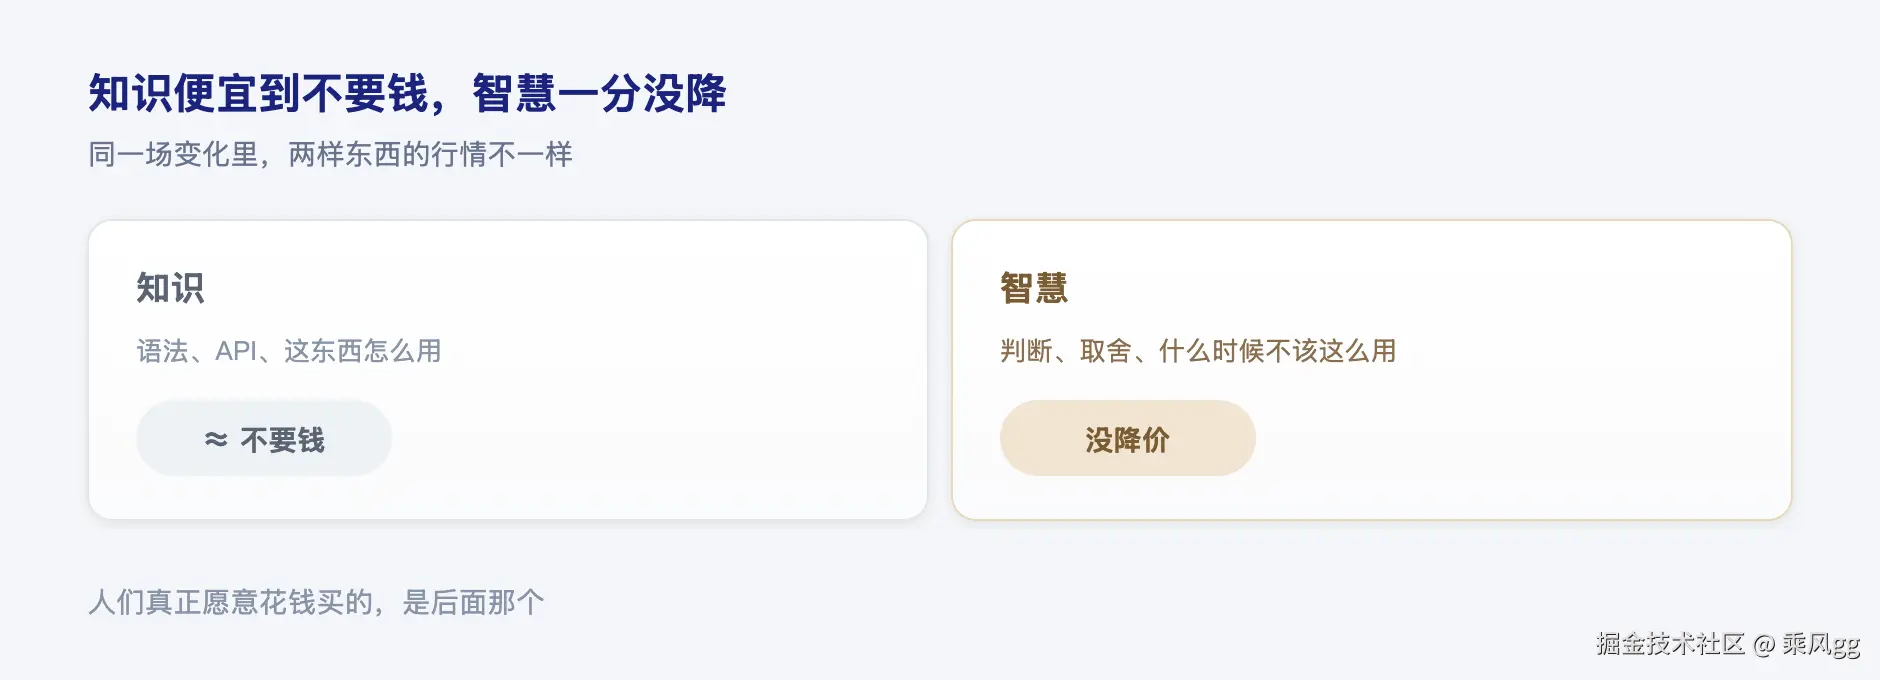
换个角度更清楚:知识,和智慧。 知识是语法、API、这东西怎么用;智慧是判断、取舍、什么时候不该这么用。知识现在便宜到几乎不要钱,智慧还是很稀有。而人们真正愿意花钱买的,是后面那个。
所以,AI 把快的活干完了,剩下全是慢的活,而慢的活你本来就没怎么练过。
每次只做一小块,但每次都能跑起来
先说第一件:这活怎么拆。
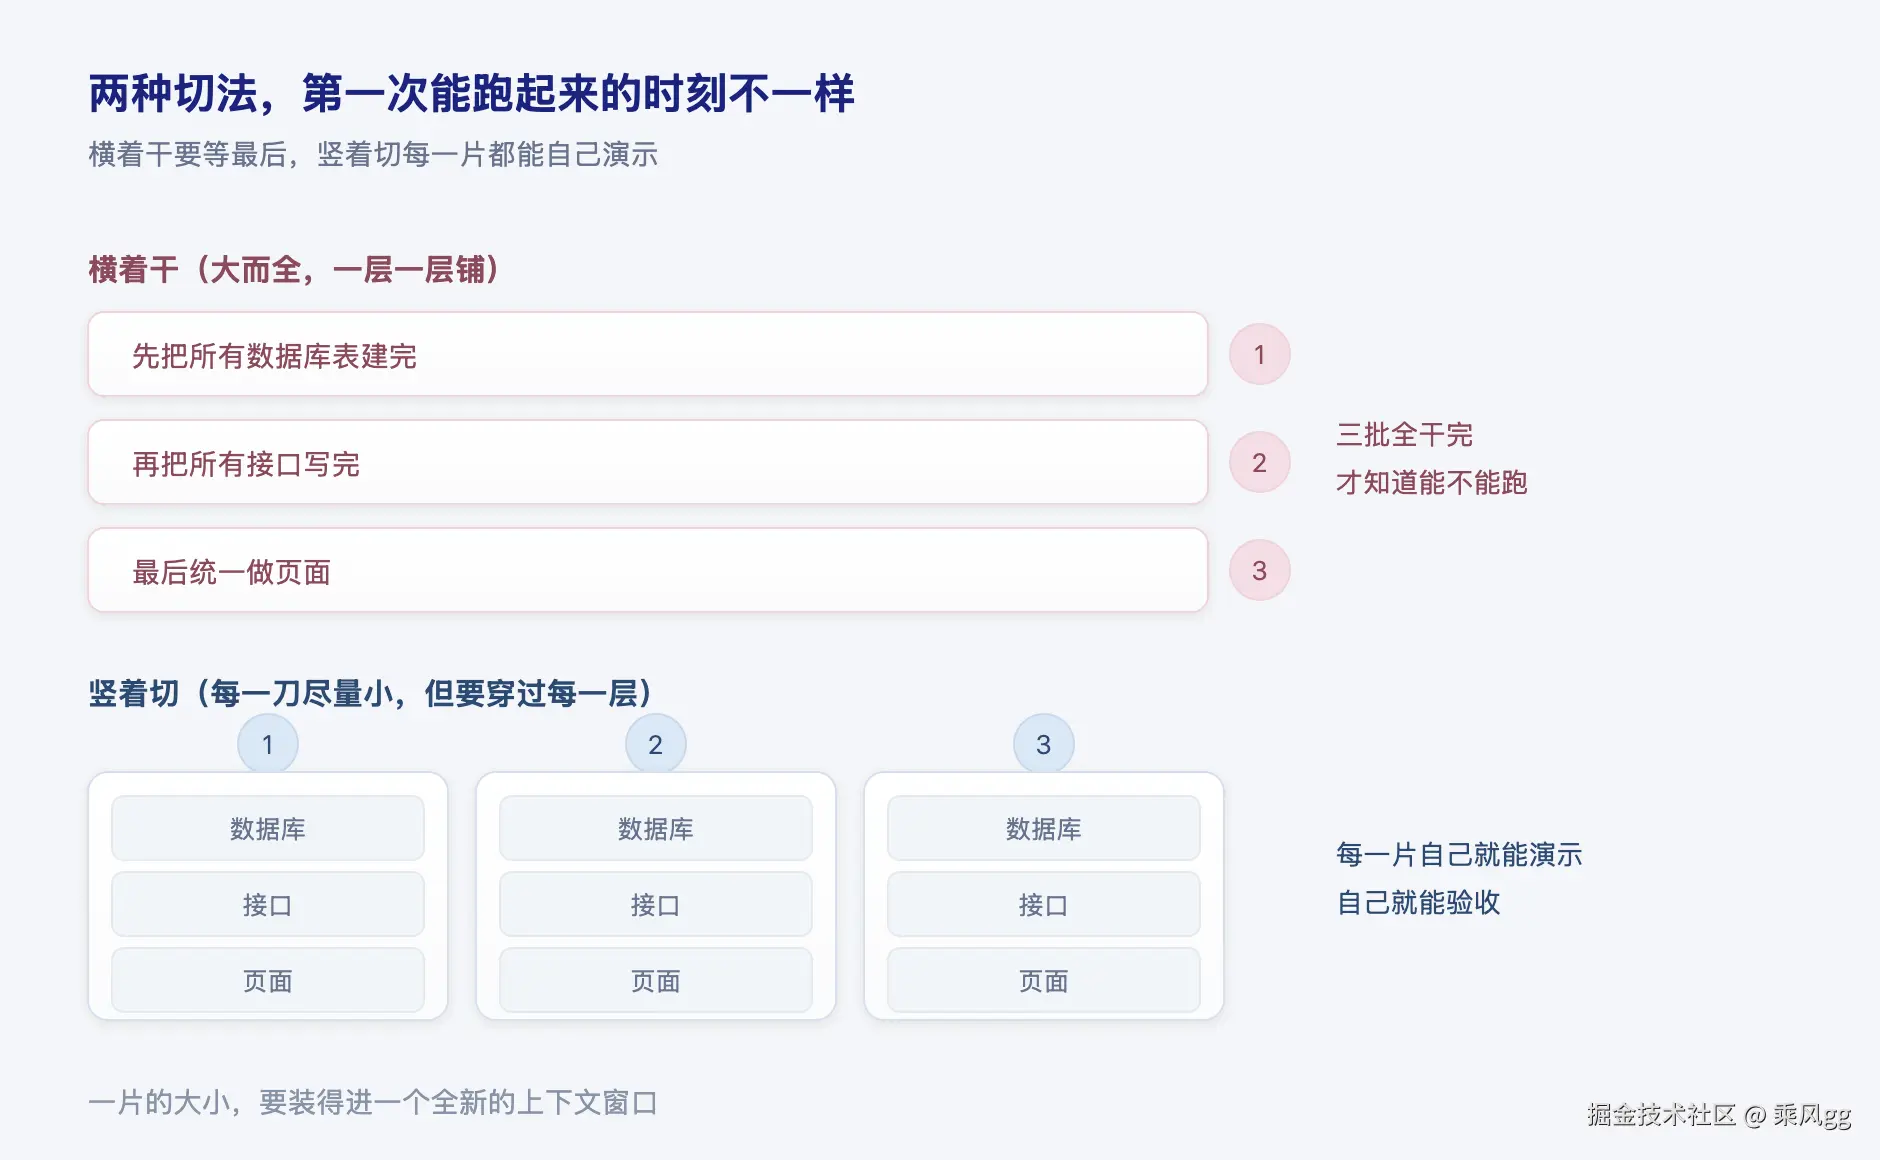
AI 写代码有个天然毛病,喜欢大而全横着干------先把数据库表建完,再把接口写完,最后统一做页面,因为大模型天生按层思考。代价是:你验收的永远是一堆半成品。 每层代码看上去都对,拼起来能不能跑谁也不知道,要等最后才见分晓。
横着干怎么治?有个现成的名字,叫曳光弹------二战时防空炮手每五发子弹混一发磷光的,看着弹道随时调整。二十多年前《程序员修炼之道》把它搬进了软件工程。
这个仓库的解法就是它:每一块尽量小,但要完整地穿过每一层 ------数据库、接口、页面、测试,一条路走通,东西自己就能演示、自己就能验收 。就类似代码的 mvp 版本,在 AI 时代还有个约束:mvp 的体量,要装得进一个全新的上下文窗口
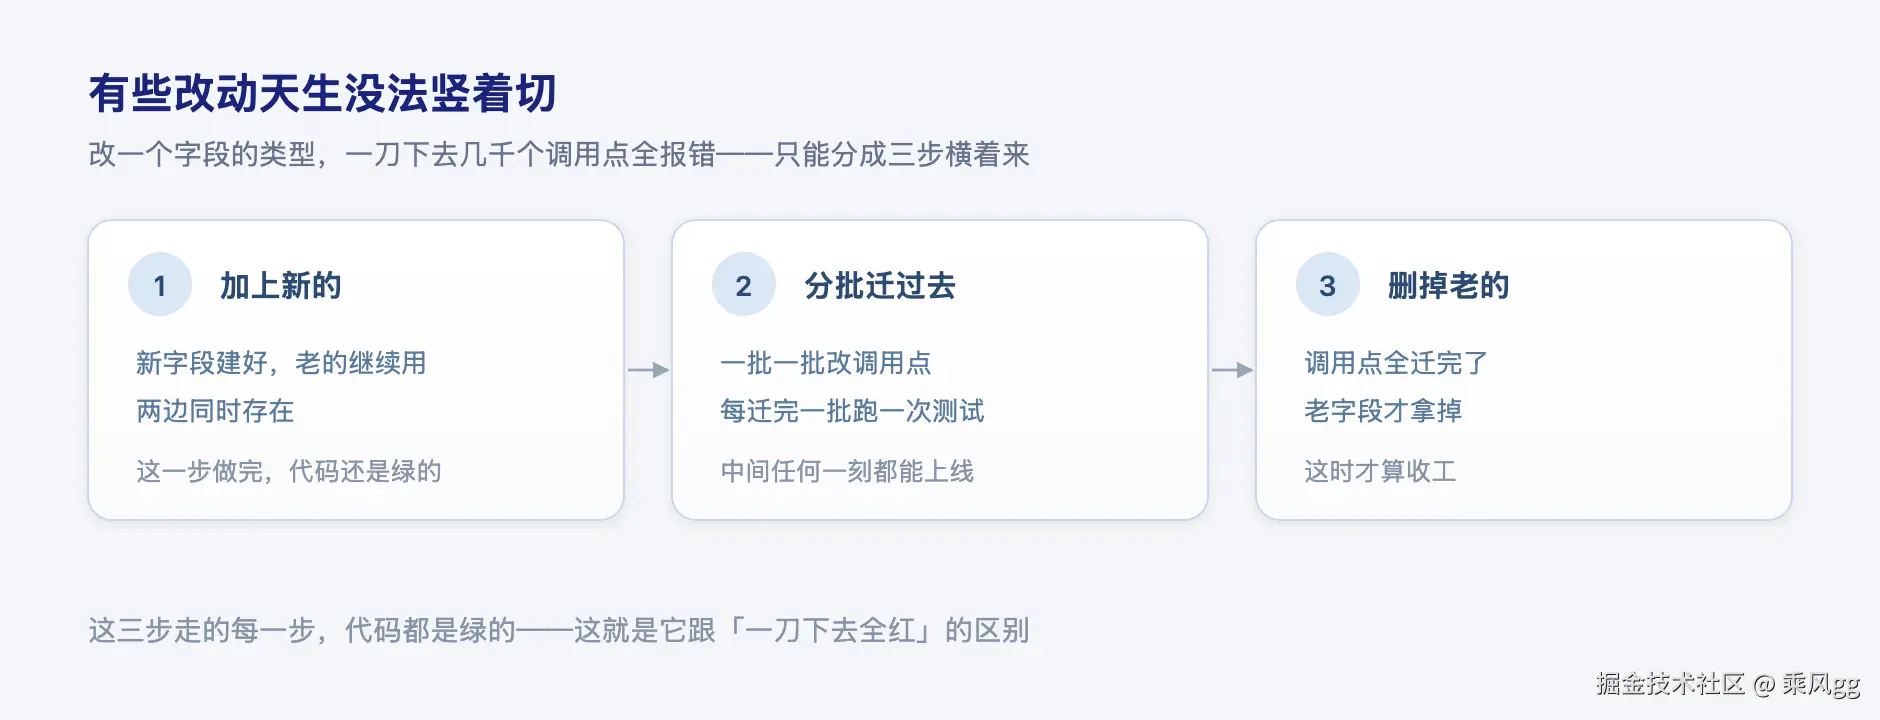
但有些例外:有些改动天生拆不开。 比如改一个字段的类型,一改,几千个调用点全报错,只能分三步、按层来:先加上新的(老的继续用)→ 分批把调用点迁过去 → 最后删掉老的。
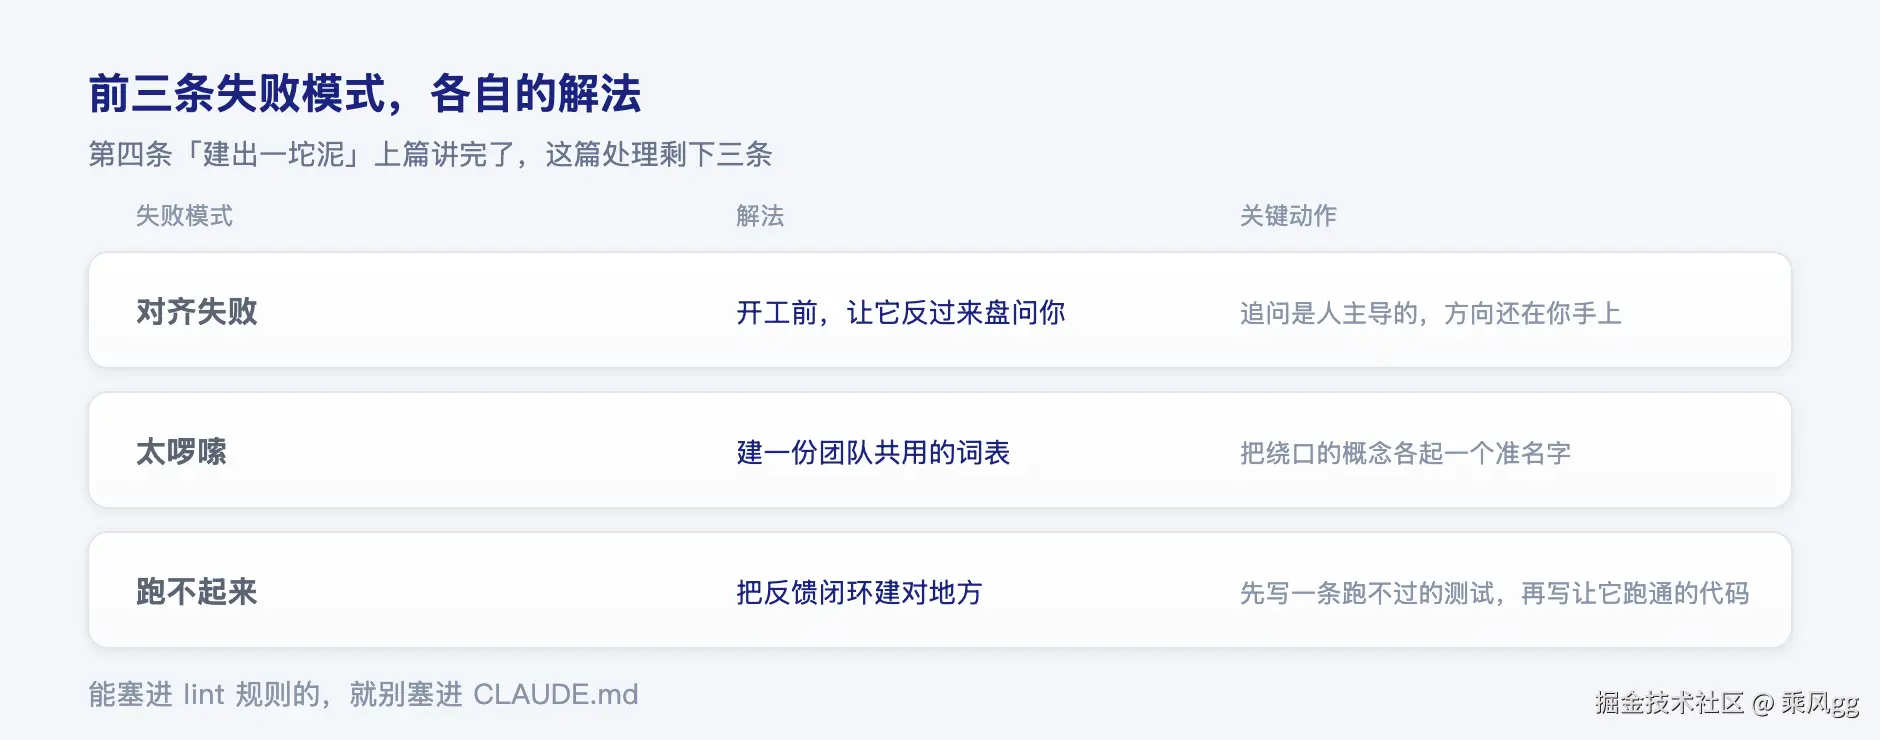
前三条失败模式,各自的解法
第一条:动手前,先让它问你问题
第一个失败模式是:你以为说清了,它以为懂了。
麻烦在于------AI 不会自己问。 人对需求有疑问会当场说出来,它不会,拿着半懂的需求一路写到底,交给你一个语法正确、但跟你想的不是一回事的东西。
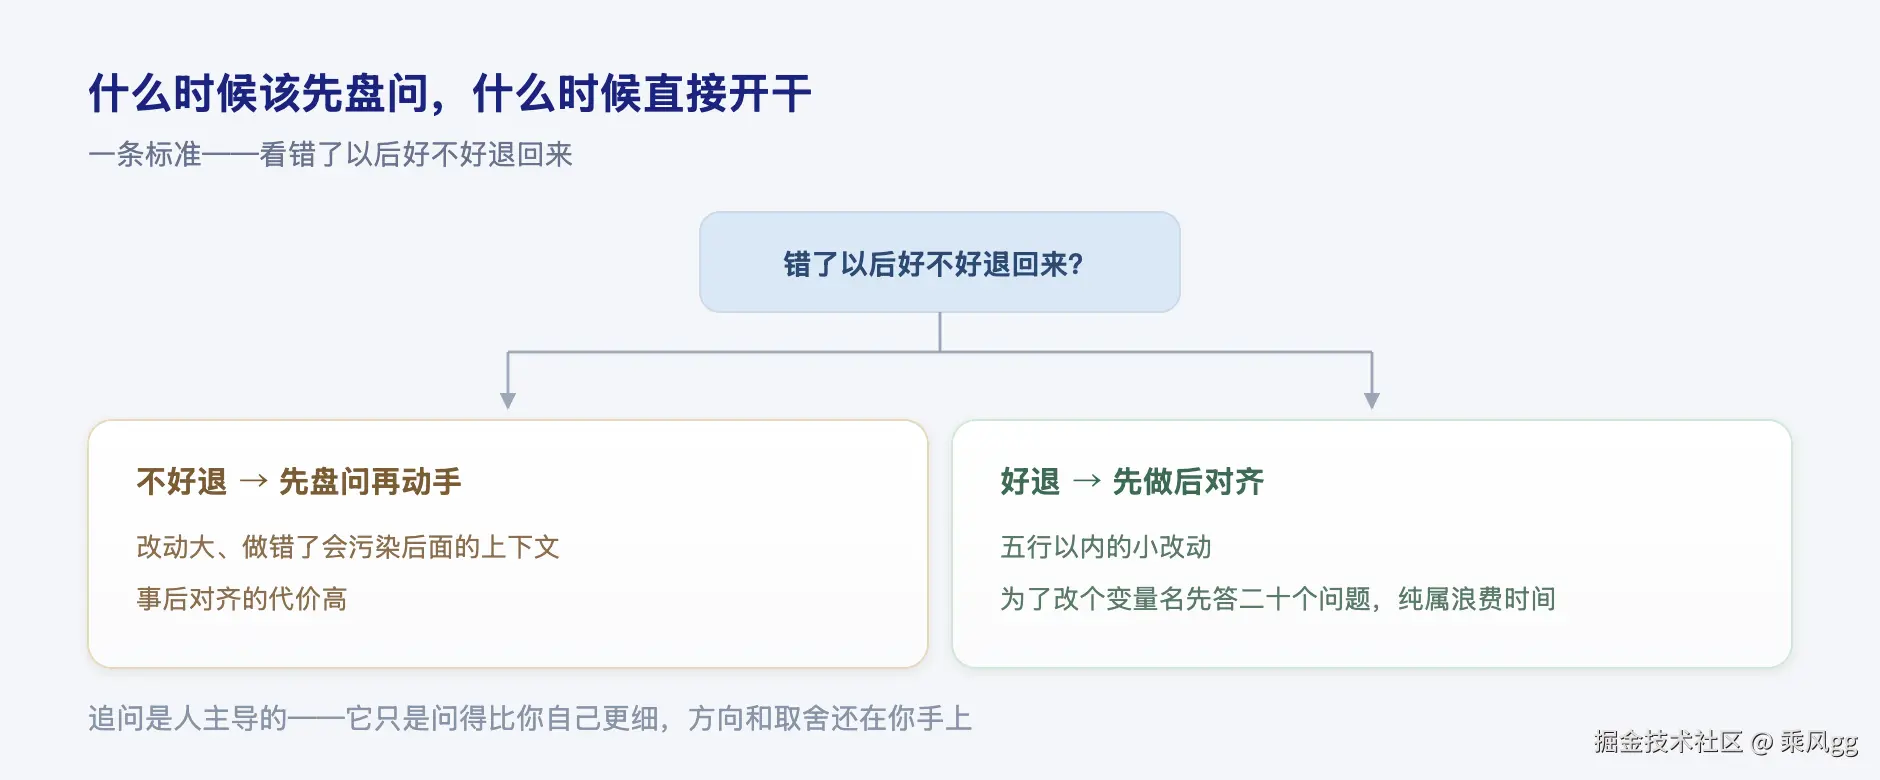
这个仓库里最受欢迎的两个技能(grill-me 和 grill-with-docs)干的是同一件事:先让它问你问题 ,逼你把「给谁用、什么情况下不算做完、边界在哪」一条条说清楚。问完一轮,模糊地带少掉一大半。问题由它来提,方向还是你定------它只是问得比你自己更细,取舍还在你手上。
第二条:建立统一名词叫法
第二个失败模式是啰嗦------一个概念要讲二十个词才说得清。
解法不是让 AI 少说话,是建一份团队共用的词表:把业务里那些绕口的概念各起一个准名字,写成一份文件放项目里,人和 AI 共用一份。
这不是为 AI 发明的新办法。软件工程里早就有,叫通用语言(Ubiquitous Language)------出自 Eric Evans 二十多年前那本《领域驱动设计》(大家常说的 DDD,就是这本书立起来的):业务和技术说同一套词,需求会上管它叫什么,代码里就得叫什么。
那时候它省的是人和人之间的沟通成本。AI 一来,又多省一份:人和 AI 之间那份。
这个仓库给 CONTEXT.md 定的格式,一条就两行:
markdown
**订单**:用户提交的那笔购买请求。
别再用:单子、单据、交易
第一行给它一个准名字,第二行把别的叫法一并作废。以前描述这件事得绕一圈,团队里还各叫各的------产品说「单子」、后端说「交易」、前端说「订单」,AI 读到会当成三件事。定下来之后,人和 AI 手里只剩这一个词。
一个词就说清了,不用再绕半句。
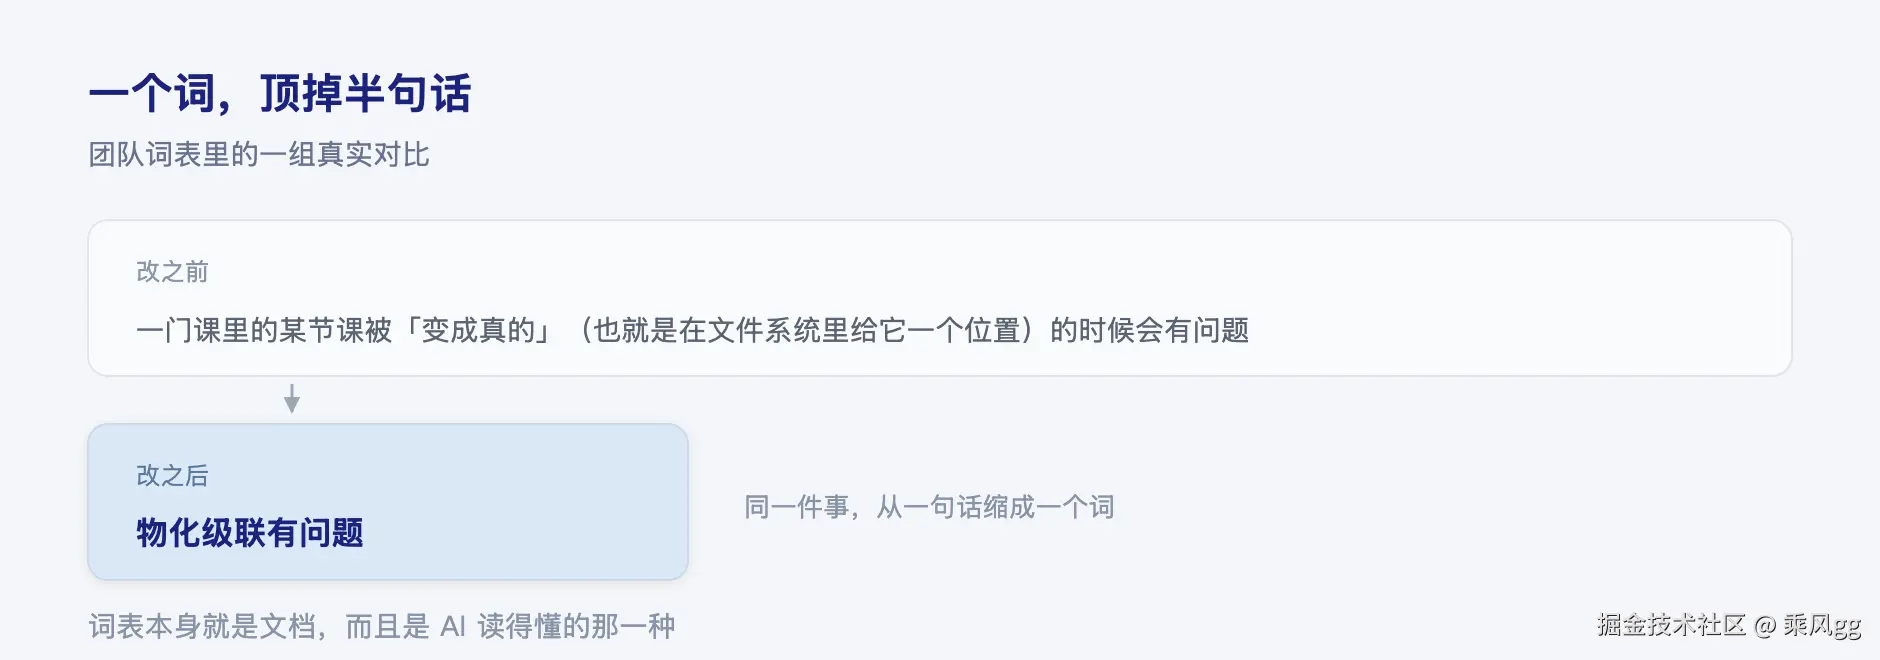
它还有一层用处,比省字重要:它把「业务到底怎么运转」从某几个人的脑子里,搬到了文件里------词表本身就是文档,而且是 AI 读得懂的那一种。
第三条:建立反馈闭环
第三个失败模式是「代码跑不起来」------写完了没人跑过。解法是反馈闭环,这大家都知道。但有两件事值得单独说。
先写一条通不过的测试
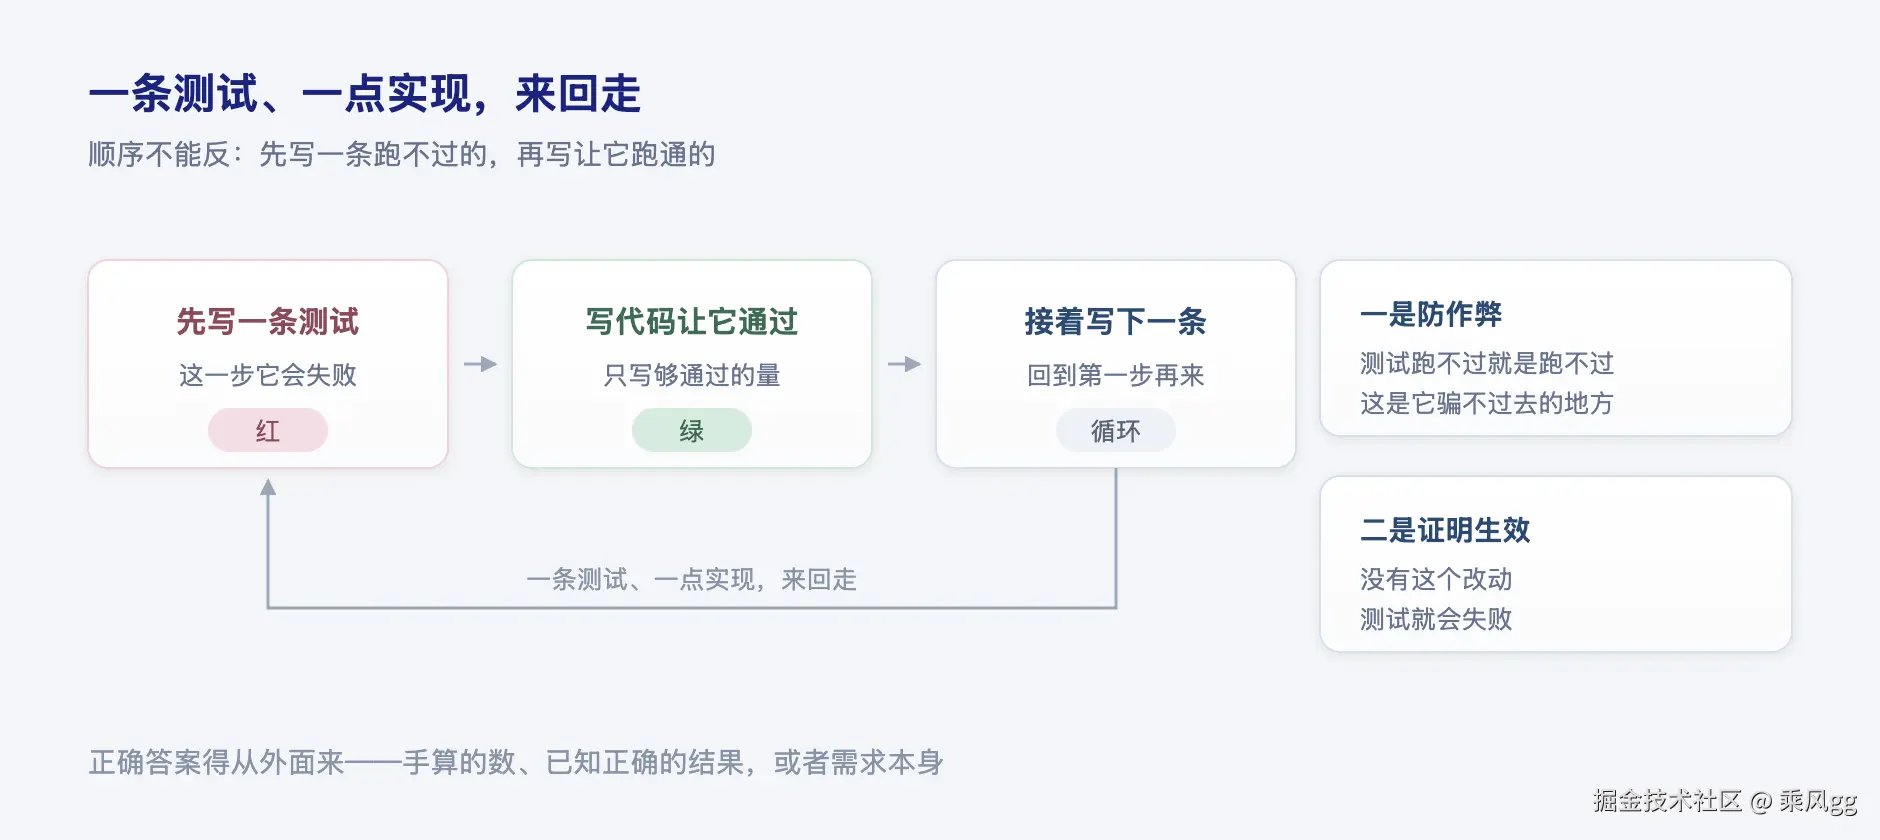
测试这一环,最值钱的不是覆盖率,是顺序 :先写一条跑不过的测试,再写让它跑通的代码。 这两步,测试驱动开发(TDD)里叫红 和绿。
这么做有两个用处。
一是防作弊。 AI 最擅长给你一个「看起来对」的东西,还说得头头是道。但测试跑不过就是跑不过,红就是红------这是少数几个它骗不过去的地方。
二是证明改动真的生效。 哪怕不走完整 TDD,也值得要求它给个证据:没有这个改动,测试就会失败。
有个反模式要躲开。
别拿代码的答案当标准答案。 正确答案要是代码自己算出来的,这条测试就永远绿。比如代码里写着税率 13%,测试里写「结果应该等于 100 乘税率」------右边那个税率,用的就是代码里那个。哪天有人手误改成 6%,右边跟着变 6,测试照样绿。
正确答案得从外面来:自己手算一遍、找一个已知正确的结果、或者照需求写。
一条测试、一点实现,来回走。
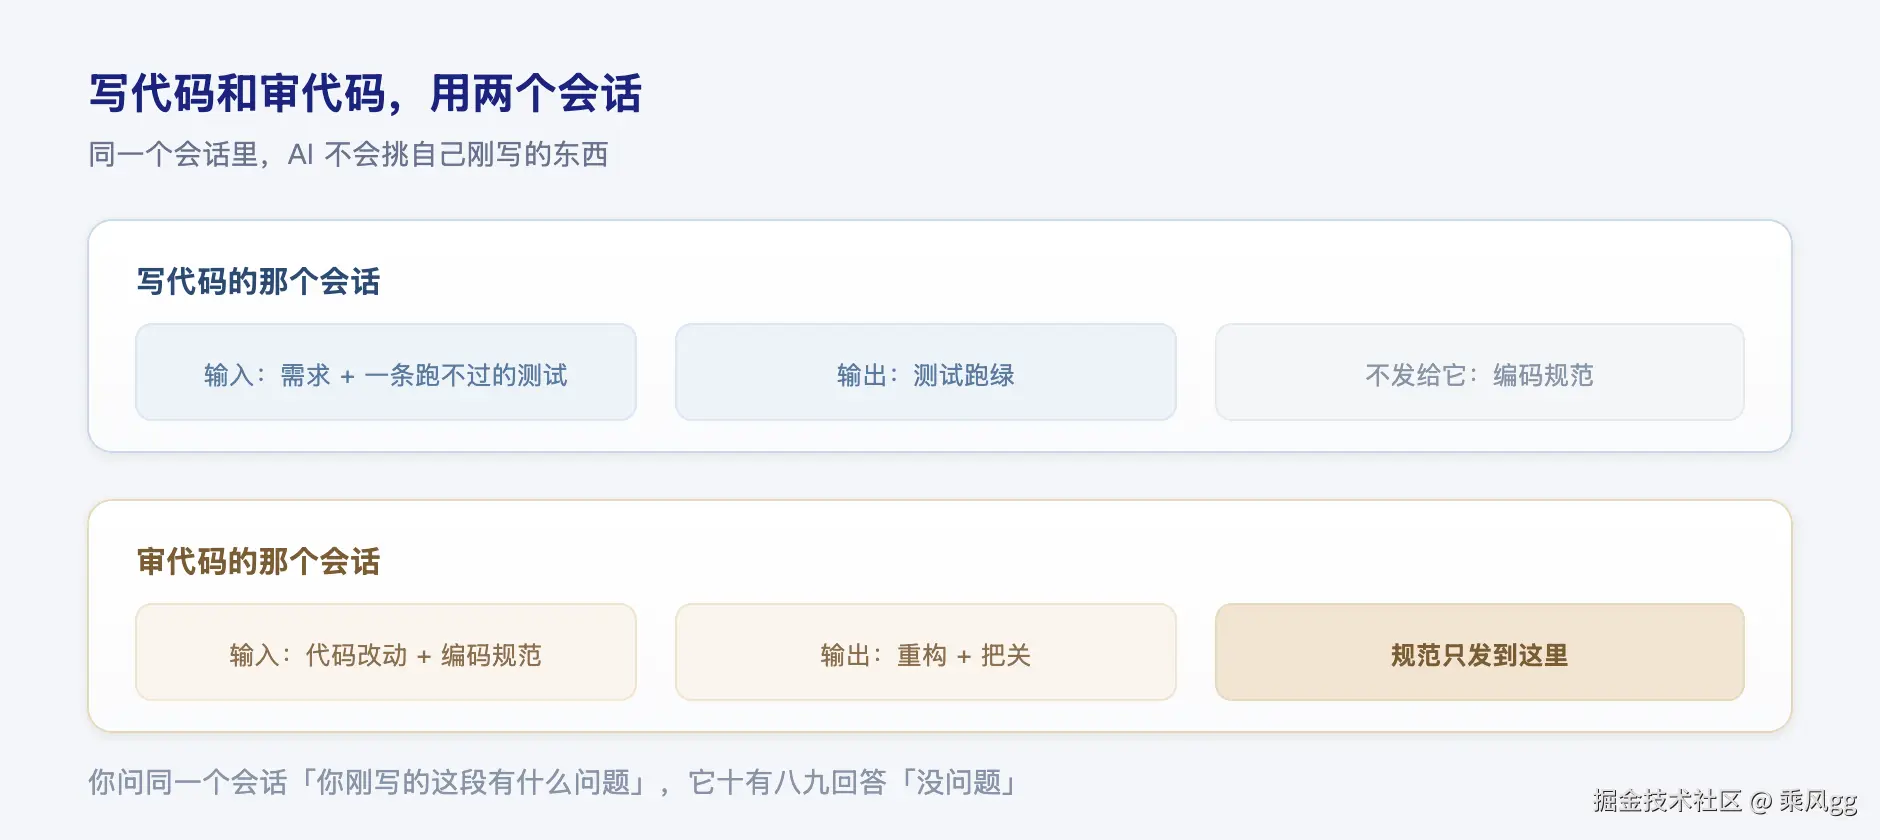
写代码和审代码,用两个会话。 同一个会话里,上下文是它自己一路铺下来的------它顺着自己刚写的思路往下说,不会回头推翻自己。你问它「这段有什么问题」,它十有八九回答「没问题」。换一个干净的会话,这层包袱没了,它才开始像个挑毛病的审稿人。所以写代码的那个只管把测试跑绿,审代码的那个负责重构和把关,编码规范也只发给审的那个------写代码的那个上下文窗口本来就快满了。
最后一条反直觉的:人嫌麻烦的检查,对 AI 刚刚好。 等一次 pre-commit(提交前自动跑的那套检查)跑三分钟,人会觉得烦;AI 不会,它本来就在等。那些「因为人嫌麻烦所以没上」的检查,现在都可以补回来了。
同一条规范,放 lint 检查还是放 CLAUDE.md
同一条约束,放进 lint(代码规范检查)还是放进 CLAUDE.md(每次请求都会一起发给 AI 的项目说明),成本差得很远。
| 放 lint 规则、类型检查、pre-commit hook | 放 CLAUDE.md | |
|---|---|---|
| 通过的时候 | 消耗是零------压根不进 AI 的上下文窗口 | 每次请求都烧 token |
| 不通过的时候 | 错误信息被塞回去,逼着它修 | 概率性的,它可能压根不理你 |
| 一句话 | 不通过就过不去 | 每次花着钱提醒、还可能被忽略 |
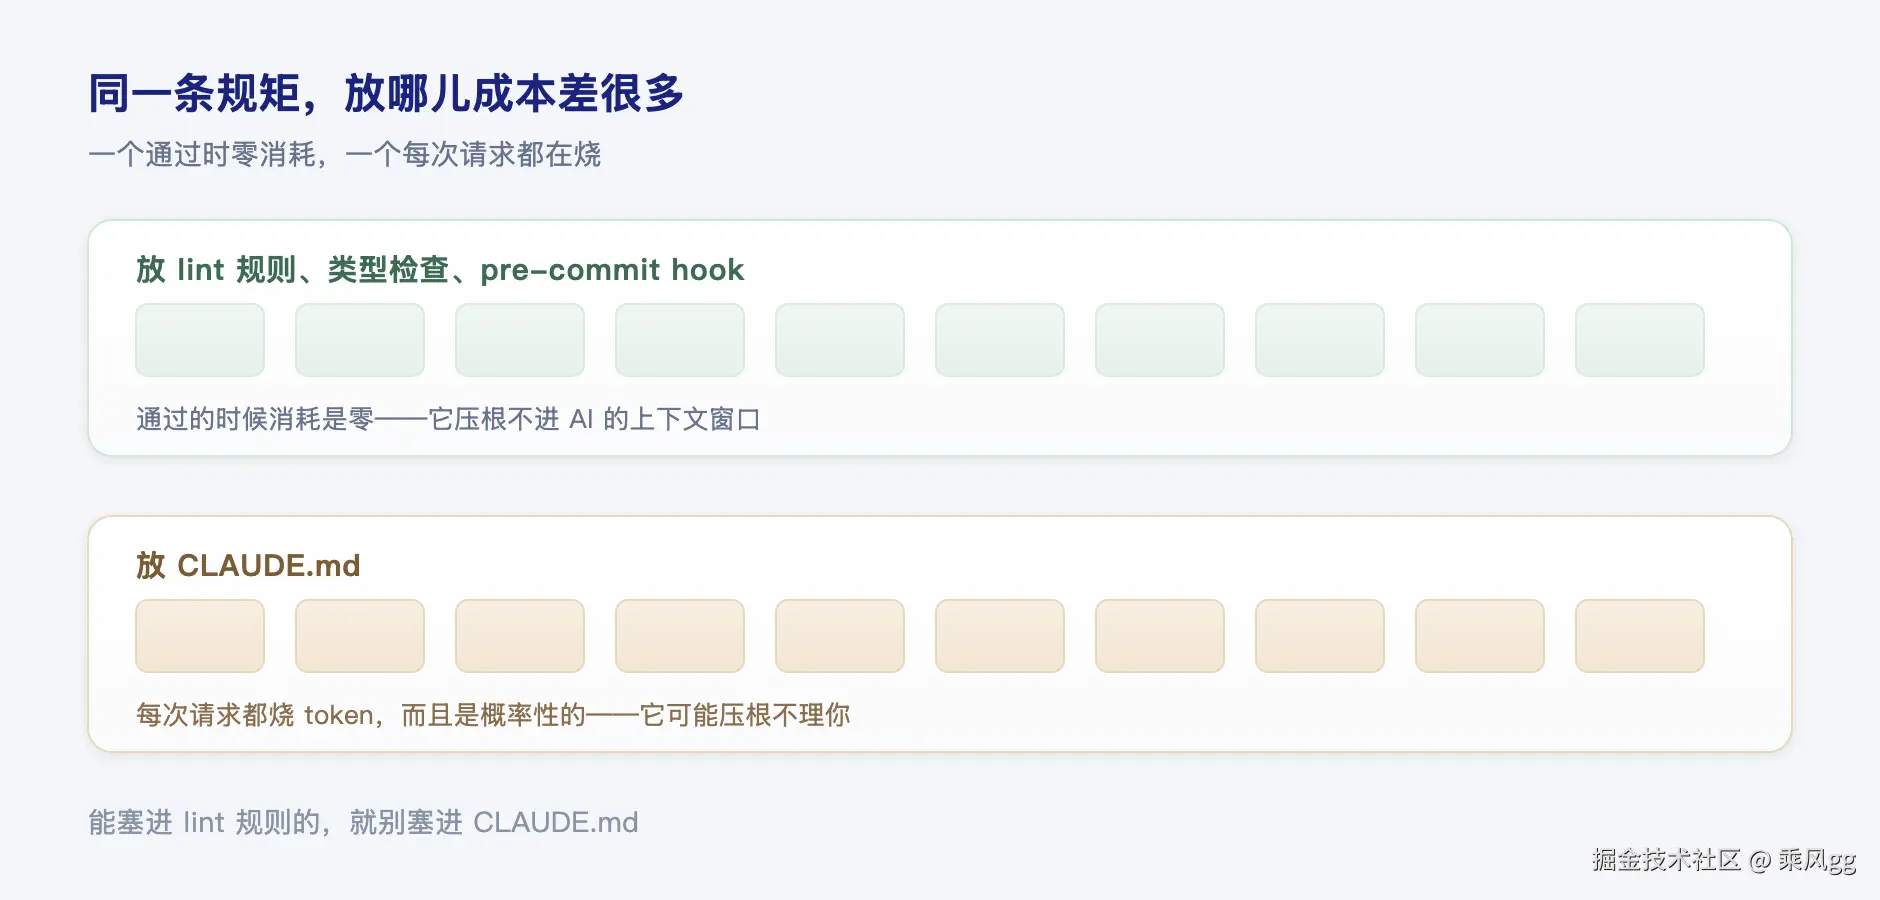
所以我的习惯是:能塞进 lint 规则的,就别塞进 CLAUDE.md。
总结
随着你越来越熟悉AI Coding ,你会发现 AI 就是个工具,工具换了,方法没换。
架构这门手艺一直没有变------只是它现在多服务了一个对象:一个没有记忆、没有品味、但手速极快,能力超强的下属。
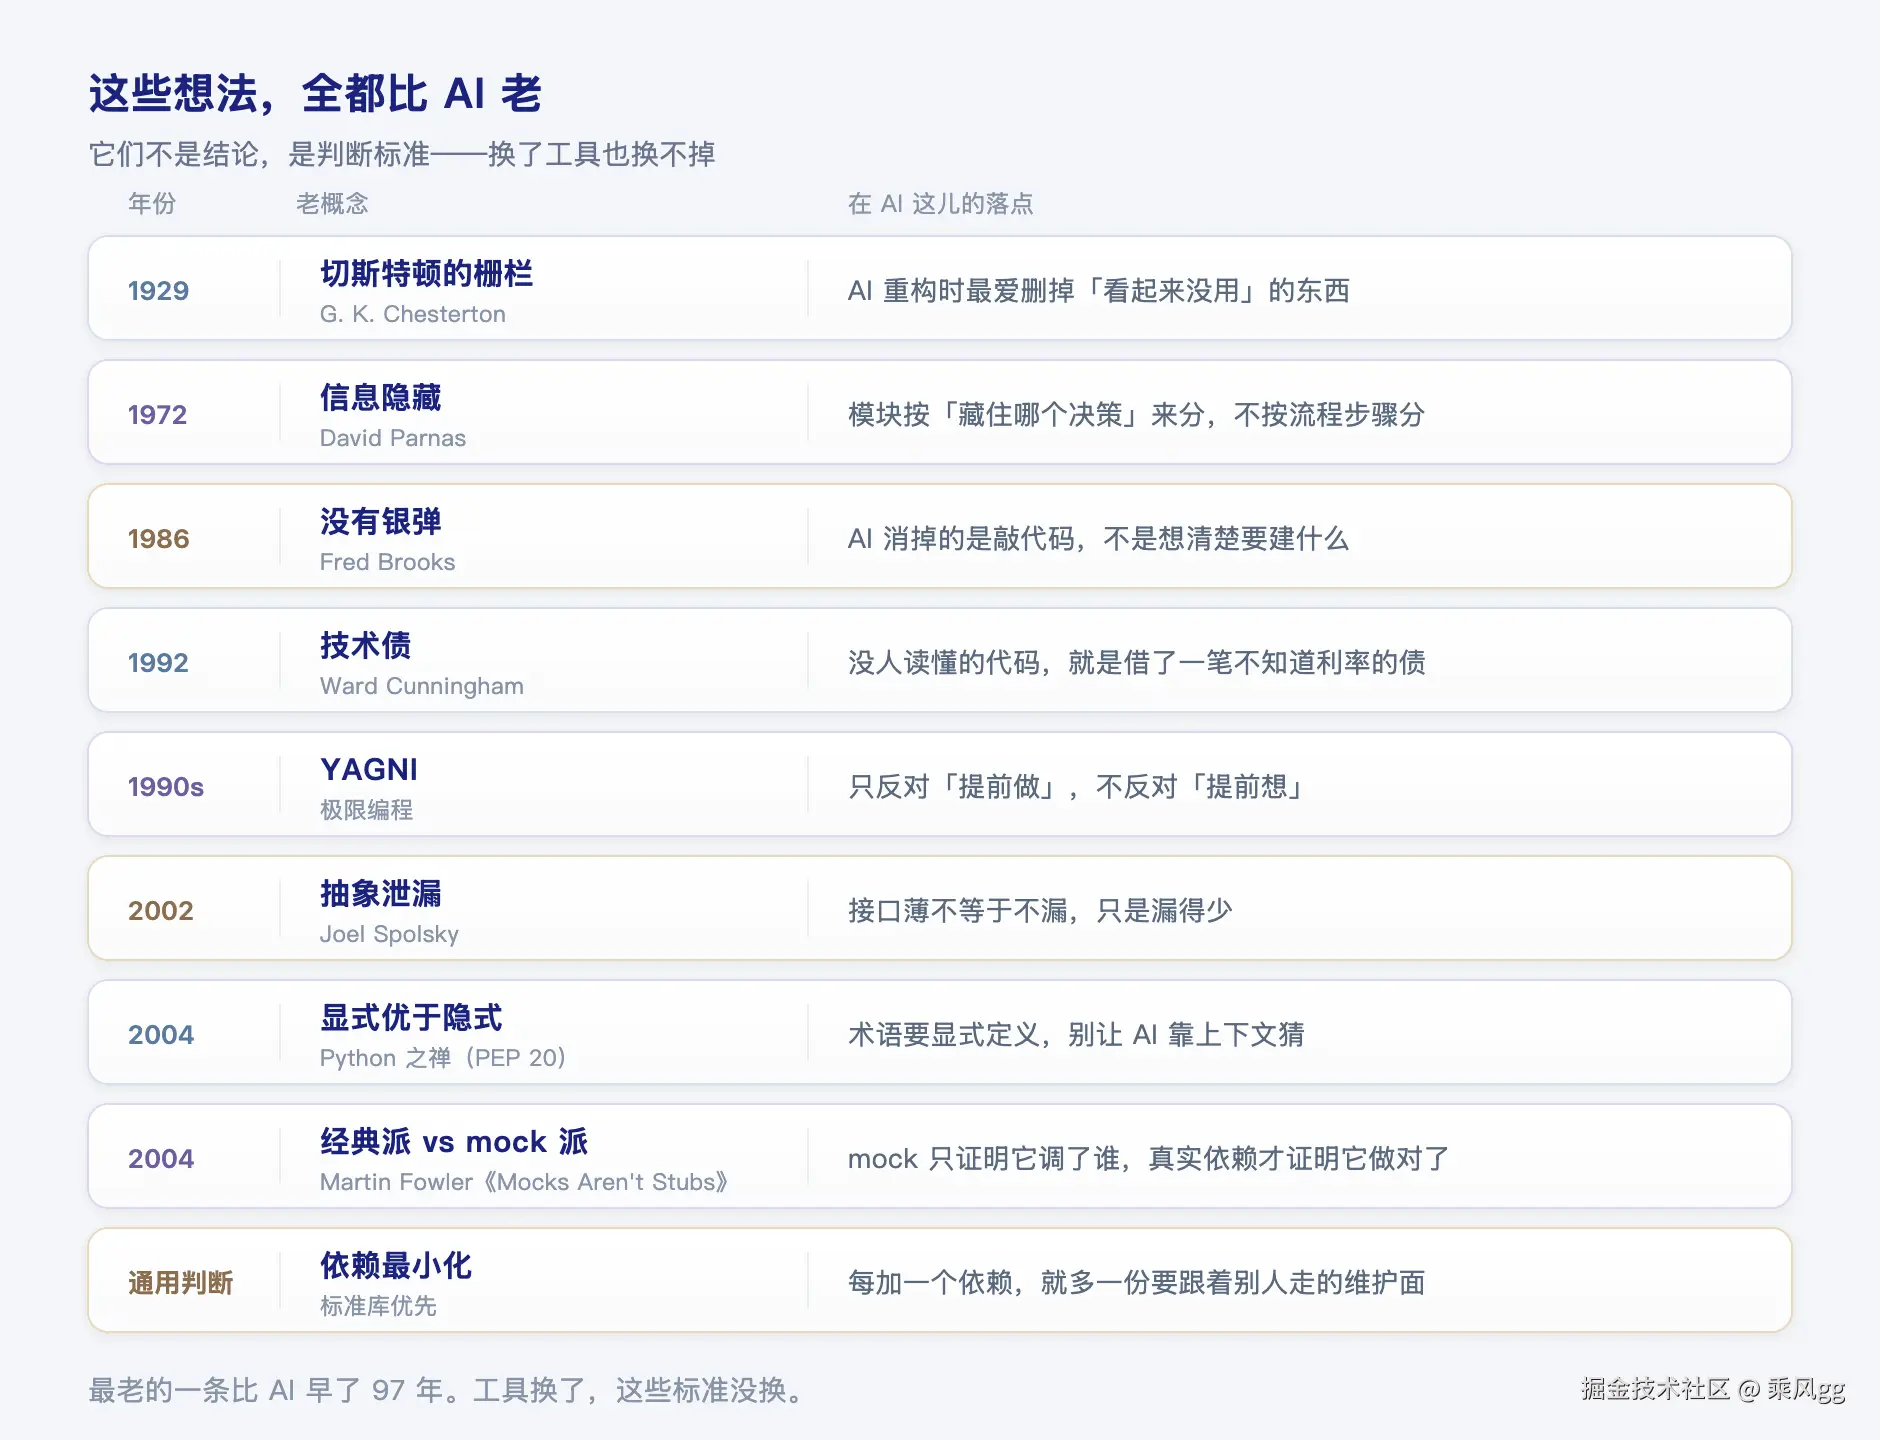
当然,软件工程和架构思想肯定不止上面这些。我顺手收集了几条,感兴趣的可以自行查阅:
如果你有什么很好的架构思想,AI 编程思路,欢迎评论区留言讨论!
欢迎大家关注我的公众号:深入浅出AI