一、问题是怎么出现的
最近在排查会议角色识别时,遇到一个比较典型的问题:同一个人连续发言时,识别结果基本稳定;一旦发言片段缩短到几个字,系统就容易把当前说话人分配给其他角色,或者新建一个角色。
项目原先使用 ERes2Net 提取说话人特征,再通过声纹向量相似度进行匹配。最初怀疑是相似度阈值设置不合理,调整几轮后发现,单纯修改阈值并不能解决所有问题。有些短音频的匹配分数确实偏低,还有一些音频虽然时长接近,但匹配结果相差较大。
这说明问题不一定出在模型本身,也可能与输入音频包含的语音信息有关。
短语音声纹识别一直存在类似挑战。已有研究指出,短音频中的音素分布不完整,以及注册音频和测试音频之间的语音内容差异,都可能影响说话人特征的稳定性。因此,排查时不能只看音频时长,还要分析音频里究竟包含多少有效语音信息。
二、先区分音频时长和有效语音时长
ERes2Net通过神经网络提取说话人嵌入向量,后续通常使用余弦相似度等方法比较两个向量。
问题在于,输入音频长,并不意味着有效信息一定多。
例如,两个片段都是3秒:
- 片段A包含连续、清晰的完整语句。
- 片段B前后有停顿,中间只有一个短促的应答词。
两段音频的文件时长相同,但实际包含的语音帧数、音素覆盖情况和声学信息可能明显不同。
如果输入主要是静音、噪声或不完整的发音,模型生成的嵌入向量就可能缺乏足够稳定的说话人特征。
这里需要注意:ERes2Net并不是必须识别完整句子才能工作。 真正需要验证的是,在当前模型、音频条件和匹配策略下,短音频是否提供了足够稳定的声纹信息。
三、排查方案:建立可视化对比工具
与其反复调整阈值,不如先把每次匹配的关键数据记录下来。
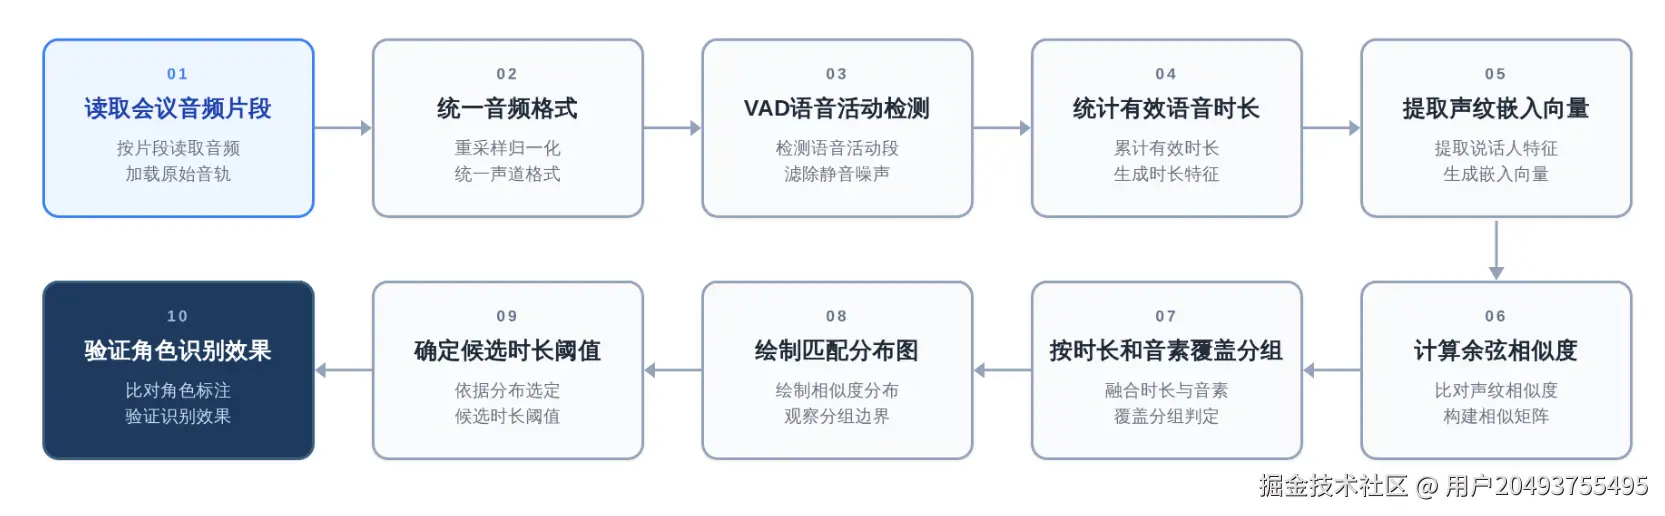
我将排查过程拆成四部分:
- 音频预处理:统一采样率、声道和音频格式。
- 语音检测:统计有效语音时长,排除大段静音。
- 特征匹配:提取声纹向量,计算余弦相似度。
- 结果可视化:对比不同音频时长下的匹配分数和错误情况。
整体流程如下:
1. 使用VAD统计有效语音时长
VAD(Voice Activity Detection)用于判断音频中哪些帧包含语音。实际项目可以采用WebRTC VAD或现有语音识别框架中的语音检测模块。
下面使用 librosa 和 webrtcvad 演示基本的音频检查。安装依赖:
pip install librosa soundfile webrtcvad numpy示例代码:
ini
import librosa
import numpy as np
import soundfile as sf
import webrtcvad
import wave


def analyze_audio(audio_path):
    # 统一为16kHz单声道,便于后续语音检测
    audio, sr = librosa.load(
        audio_path,
        sr=16000,
        mono=True
    )

    duration = len(audio) / sr

    # 转换为16位PCM,供WebRTC VAD使用
    pcm = np.clip(audio, -1.0, 1.0)
    pcm = (pcm * 32767).astype(np.int16)

    # VAD要求的帧时长为10、20或30毫秒
    frame_ms = 30
    frame_size = int(sr * frame_ms / 1000)

    vad = webrtcvad.Vad(2)
    voiced_frames = 0
    total_frames = 0

    for start in range(0, len(pcm) - frame_size + 1,
                        frame_size):
        frame = pcm[start:start + frame_size]
        frame_bytes = frame.tobytes()

        if vad.is_speech(frame_bytes, sr):
            voiced_frames += 1

        total_frames += 1

    speech_duration = voiced_frames * frame_ms / 1000

    return {
        "duration": round(duration, 3),
        "speech_duration": round(speech_duration, 3),
        "speech_ratio": round(
            speech_duration / duration, 3
        ) if duration > 0 else 0
    }


if __name__ == "__main__":
    result = analyze_audio("sample.wav")
    print(result)
这里得到三个指标:文件时长、有效语音时长和语音占比。
需要说明,VAD只能近似判断语音活动,不能直接判断音素是否完整。环境噪声、轻声说话和爆破音都可能影响检测结果,因此这些数据适合用于筛查,不应直接作为声纹匹配的最终依据。
2. 记录声纹匹配分数
在已有 ERes2Net 推理流程中,分别提取注册音频和待匹配音频的嵌入向量,再计算余弦相似度。
scss
import numpy as np


def cosine_similarity(embedding_a, embedding_b):
    a = np.asarray(embedding_a, dtype=np.float32).reshape(-1)
    b = np.asarray(embedding_b, dtype=np.float32).reshape(-1)

    if a.shape != b.shape:
        raise ValueError("两个声纹向量维度必须一致")

    norm_a = np.linalg.norm(a)
    norm_b = np.linalg.norm(b)

    if norm_a < 1e-8 or norm_b < 1e-8:
        raise ValueError("声纹向量范数过小,无法可靠比较")

    return float(np.dot(a, b) / (norm_a * norm_b))
该方法不依赖具体的 ERes2Net 推理框架,可以接入项目现有的向量提取模块。
建议每次测试至少记录以下字段:
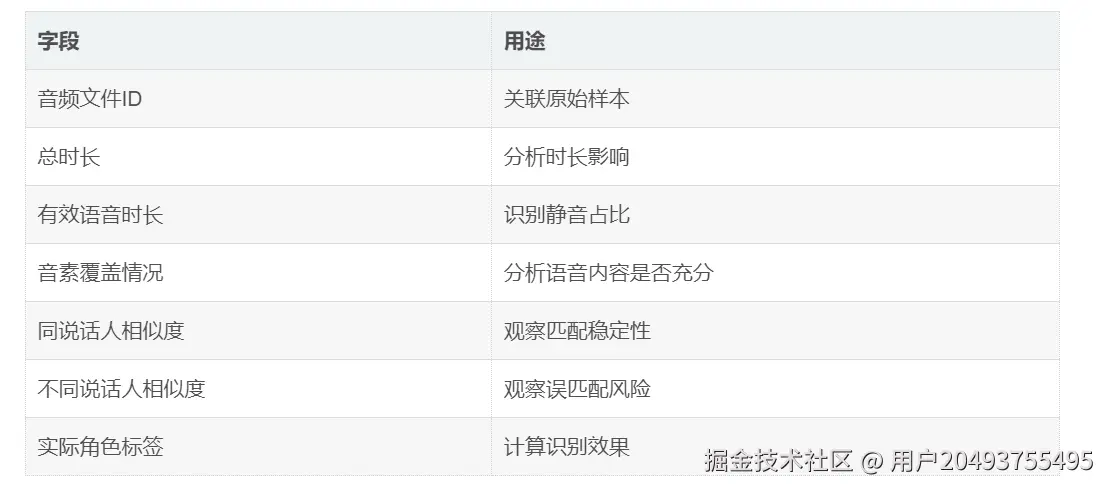 有了这些记录,就能把"感觉短音频容易出错"转化为可以统计和复现的问题。
四、如何确定短音频阈值
阈值不建议直接拍脑袋设置为1秒、2秒或3秒。更稳妥的做法是按照时长分组,再比较每组的匹配结果。
例如,将测试样本划分为以下候选区间:
- 小于0.5秒
- 0.5~1秒
- 1~2秒
- 2~3秒
- 3秒以上
这些只是实验分组,不代表模型已经验证过的最佳阈值。
测试集应同时包含同一说话人的不同片段,以及不同说话人的片段。尽量覆盖不同语速、麦克风、环境噪声和发言内容,避免测试集过于单一。
在统计时,重点关注三个指标:
第一,错误匹配率。 不同说话人的片段被判定为同一人的比例。
第二,漏匹配率。 同一说话人的片段没有匹配成功的比例。
第三,低置信度比例。 相似度处于不确定区间的样本占比。
如果某个时长区间的有效语音时长普遍偏低,且错误匹配明显增加,就需要进一步分析是否由静音、噪声或语音内容不足导致。
五、有效音素判定应该怎么做
有效音素不能简单等同于有效语音时长。两个片段即使时长相近,也可能包含完全不同的语音内容。
可以在实验工具中增加一层语音内容分析:
- 使用ASR获取转写文本。
- 使用音素转换工具将文本转换为音素序列。
- 统计不同音素的覆盖情况。
- 对比注册音频与测试音频的音素分布。
- 将音素覆盖指标与声纹匹配错误关联分析。
这里要区分两个概念:ASR识别出的文本不等于真实音素序列,尤其是短音频和噪声环境下,转写错误可能导致音素统计失真。因此,音素覆盖率更适合作为分析指标,而不是直接决定角色归属的唯一条件。
此外,中文声纹识别还要考虑声调、韵母、辅音及发音方式等差异。某些短词虽然包含多个汉字,但实际语音信息仍然有限,不能单纯根据字数判断是否适合做声纹匹配。
六、从实验结果到角色识别策略
完成上述分析后,可以将短音频处理分为三种情况。
- 语音信息充分: 正常提取声纹向量,并按照验证集确定的阈值进行匹配。
- 语音信息不足: 暂不创建新角色,优先等待后续发言补充信息。
- 匹配结果存在歧义: 保留候选角色和相似度,结合前后文、时间连续性及其他有效片段再进行判断。
这类策略对会议场景尤其重要。角色识别不是孤立的单次分类任务,同一说话人在相邻时间段的连续发言可以提供额外证据,但也要防止把真正的说话人切换错误地合并。
在熙瑾会悟这类智能会议应用中,声纹识别结果会影响转写文本的角色归属,因而除了关注模型精度,还需要关注短音频的异常处理和错误回溯能力。
七、总结
这次排查最值得沉淀的不是某个固定的时长阈值,而是一套可复用的验证方法:先统计有效语音,再分析声纹相似度,最后结合音素覆盖情况检查错误样本。
对于 ERes2Net 短音频匹配不稳定的问题,建议先建立带有真实角色标签的测试集,按时长和有效语音比例分组,并在同说话人、不同说话人两类样本上分别评估。
当数据能够明确显示错误集中在哪些区间时,再决定是否需要调整阈值、延迟角色确认或引入更适合短时语音的模型。相比单纯调整一个相似度参数,这种方式更容易定位根因,也更便于后续迭代和回归测试。