JDK 8 撑起了货拉拉一整代微服务,上千个在线服务至今还跑在上面。升到 JDK 21,运行时、Spring 和一批中间件都要跟着换代。改 java.version 只要一行,难的是编译通过以后,很多依赖的行为已经悄悄变了。这次我们让框架先把兼容成本扛下来,重复的代码改造交给 AI 批量完成,业务工程切 parent、按检查单收尾。底座先动,业务后动。
一、背景
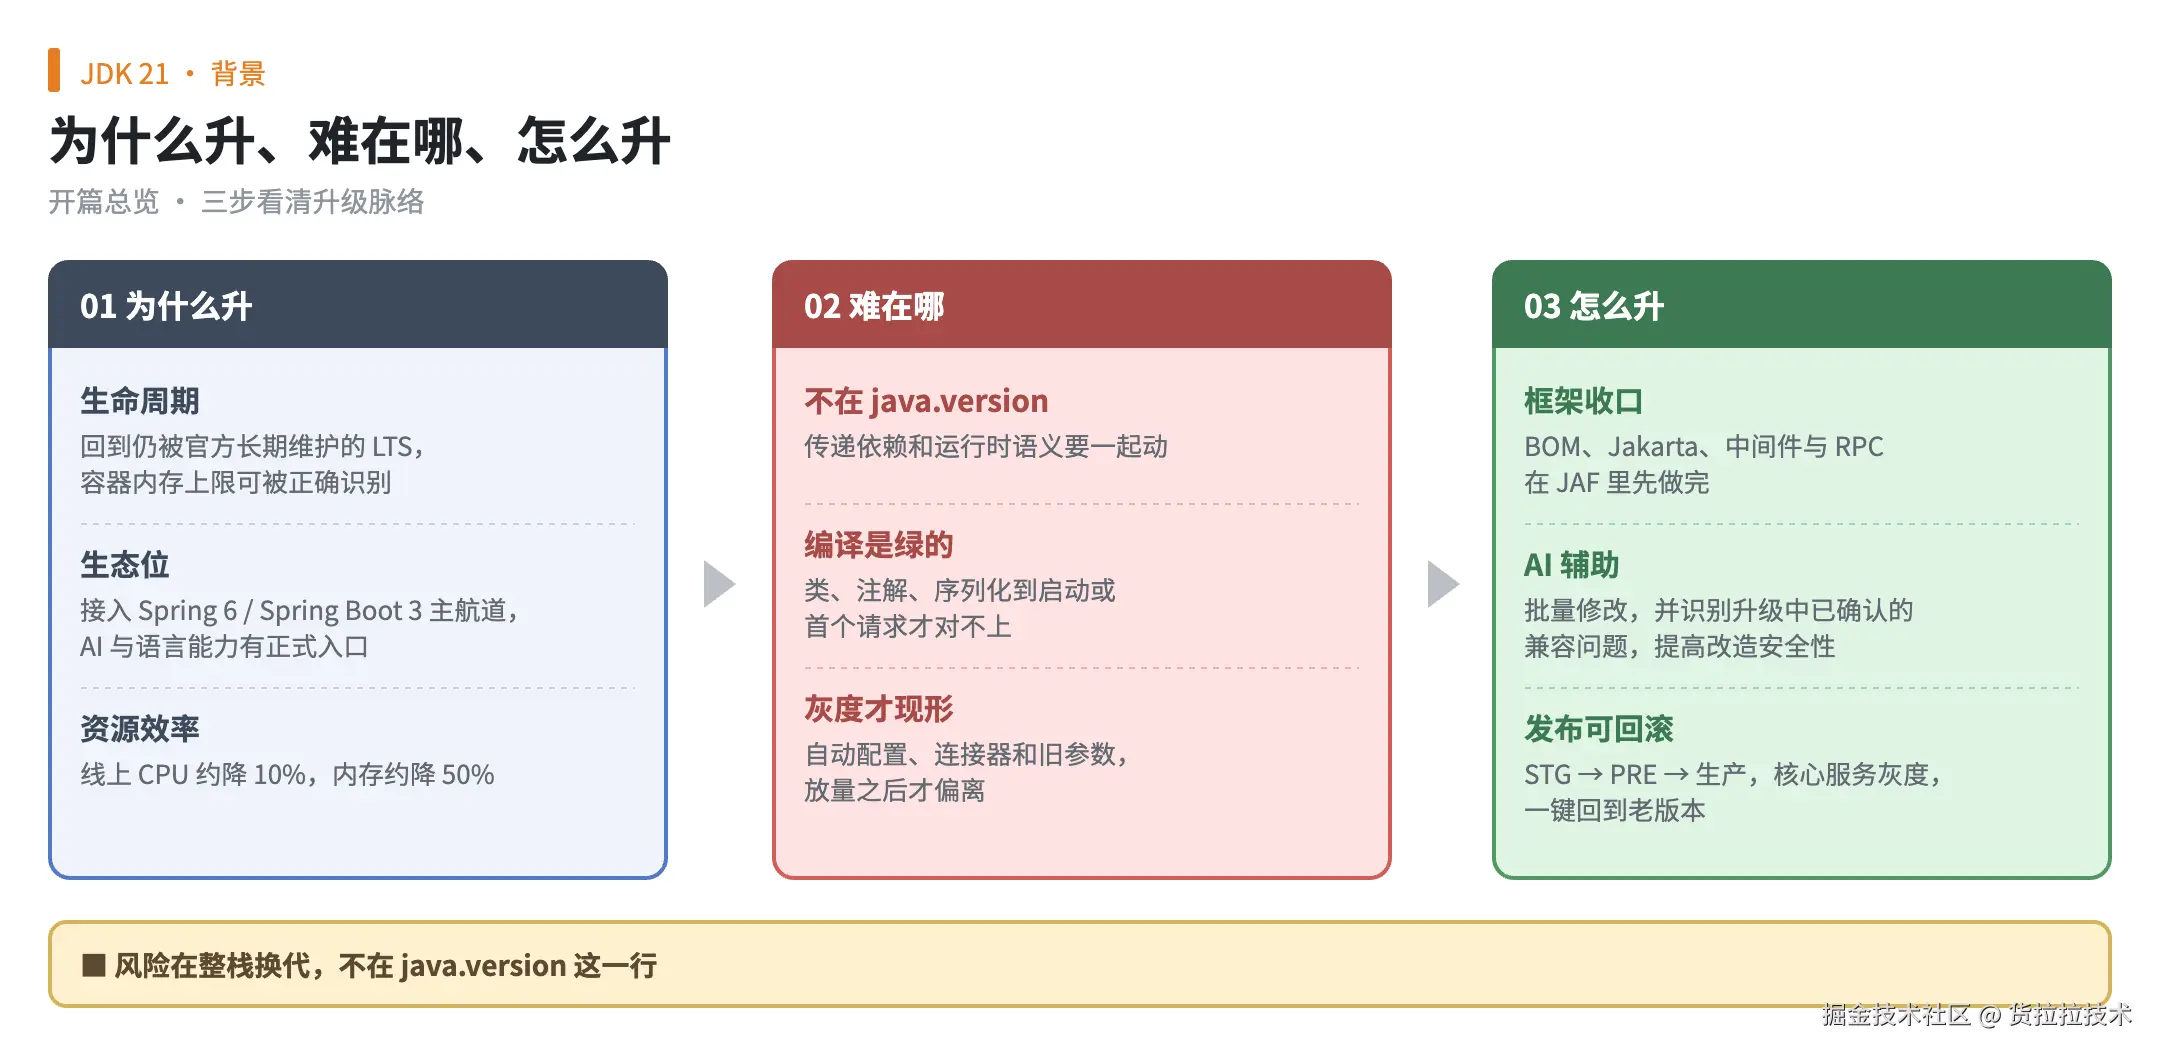
升级收益
| 收益 | 说明 |
|---|---|
| 生命周期 | 回到主流 LTS,安全补丁和根证书更新都有长期保障。Spring Boot 2.x 早已停止开源维护,留在老栈上,漏洞只能自己打补丁。 |
| 生态 | 开源框架、云厂商 JDK、社区方案和 AI 编程工具,都已把 JDK 21 与 Spring 新一代当作默认基线。新能力、示例和后续 LTS 沿这条线发布,外部经验可以直接落进工程,不必再为老栈单独维持分支。 |
| 资源效率 | JVM 能正确识别容器的内存和 CPU 配额,不再按宿主机估算。同等业务量下,线上实测 CPU 降 10%、内存降 50%。 |
升级挑战
升到 JDK 21 几乎一定会带出整栈换代:Spring Boot 3、Jakarta EE、新一代连接器和序列化库,还有一批内部二方包。如果只升了 JDK,传递依赖和运行时语义没有一起动,编译往往照样能过,类、注解和序列化要到启动或第一个请求时才对不上。
更隐蔽的问题要到发布和灰度时才出现。自动配置从 spring.factories 换成了 AutoConfiguration.imports,只写了前者的自定义 Starter 会静默失效;连接器、RPC 和监控组件的默认行为也和 2.x 不同,延迟、指标或链路会在放量时慢慢偏离。线程模型、容器里的 CPU 和内存可见性也一样,照搬旧参数,要等流量切过来才暴露。
升级思路
| 升级方式 | 各工程自己升 | 框架先动 |
|---|---|---|
| 版本管理 | 各自在 POM 里对版本 | BOM 统一收口,业务不写版本号 |
| Jakarta / 中间件 / RPC | 每个工程各改一遍 | 框架里先做完 |
| 代码改造 | 样板代码手改,兼容问题靠人记 | AI 批量改写,并按已知兼容问题清单扫描 |
| 业务要做的 | 逐个依赖排雷 | 切 parent,按检查单对齐基线 |
公司的 Java 服务统一建在 JAF 上,大部分兼容工作可以由框架替业务先做掉。整体思路:
-
框架收口:版本统一收进 BOM,Jakarta 迁移、中间件和 RPC 适配在框架里先做完,详见第二章
-
AI 辅助:javax → jakarta 这类重复改动交给 AI 批量改写,同时按已确认的兼容问题清单扫描代码,人工负责验收
-
发布可回滚:按 STG → PRE → 生产推进,核心服务先灰度放量,出问题一键回到老版本
业务侧切完 parent,还要按第二章末尾的检查单,把 javax、自定义 Starter、内部组件和 Lombok 对齐到同一基线,否则框架已经解决的问题会在业务工程里重新冒出来。
二、框架换代:底座先动,业务后动
上千个服务如果各自升级,很难收尾,所以这次换代主要由框架层来扛。框架按大版本分代:2.x 对应 JDK 8 + Spring Boot 2,3.x 对应 JDK 21 + Spring Boot 3.5 + Jakarta。JAF、Hermes、Monitor 三个核心仓库一起升级、版本对齐,业务工程只声明依赖,不写版本号。
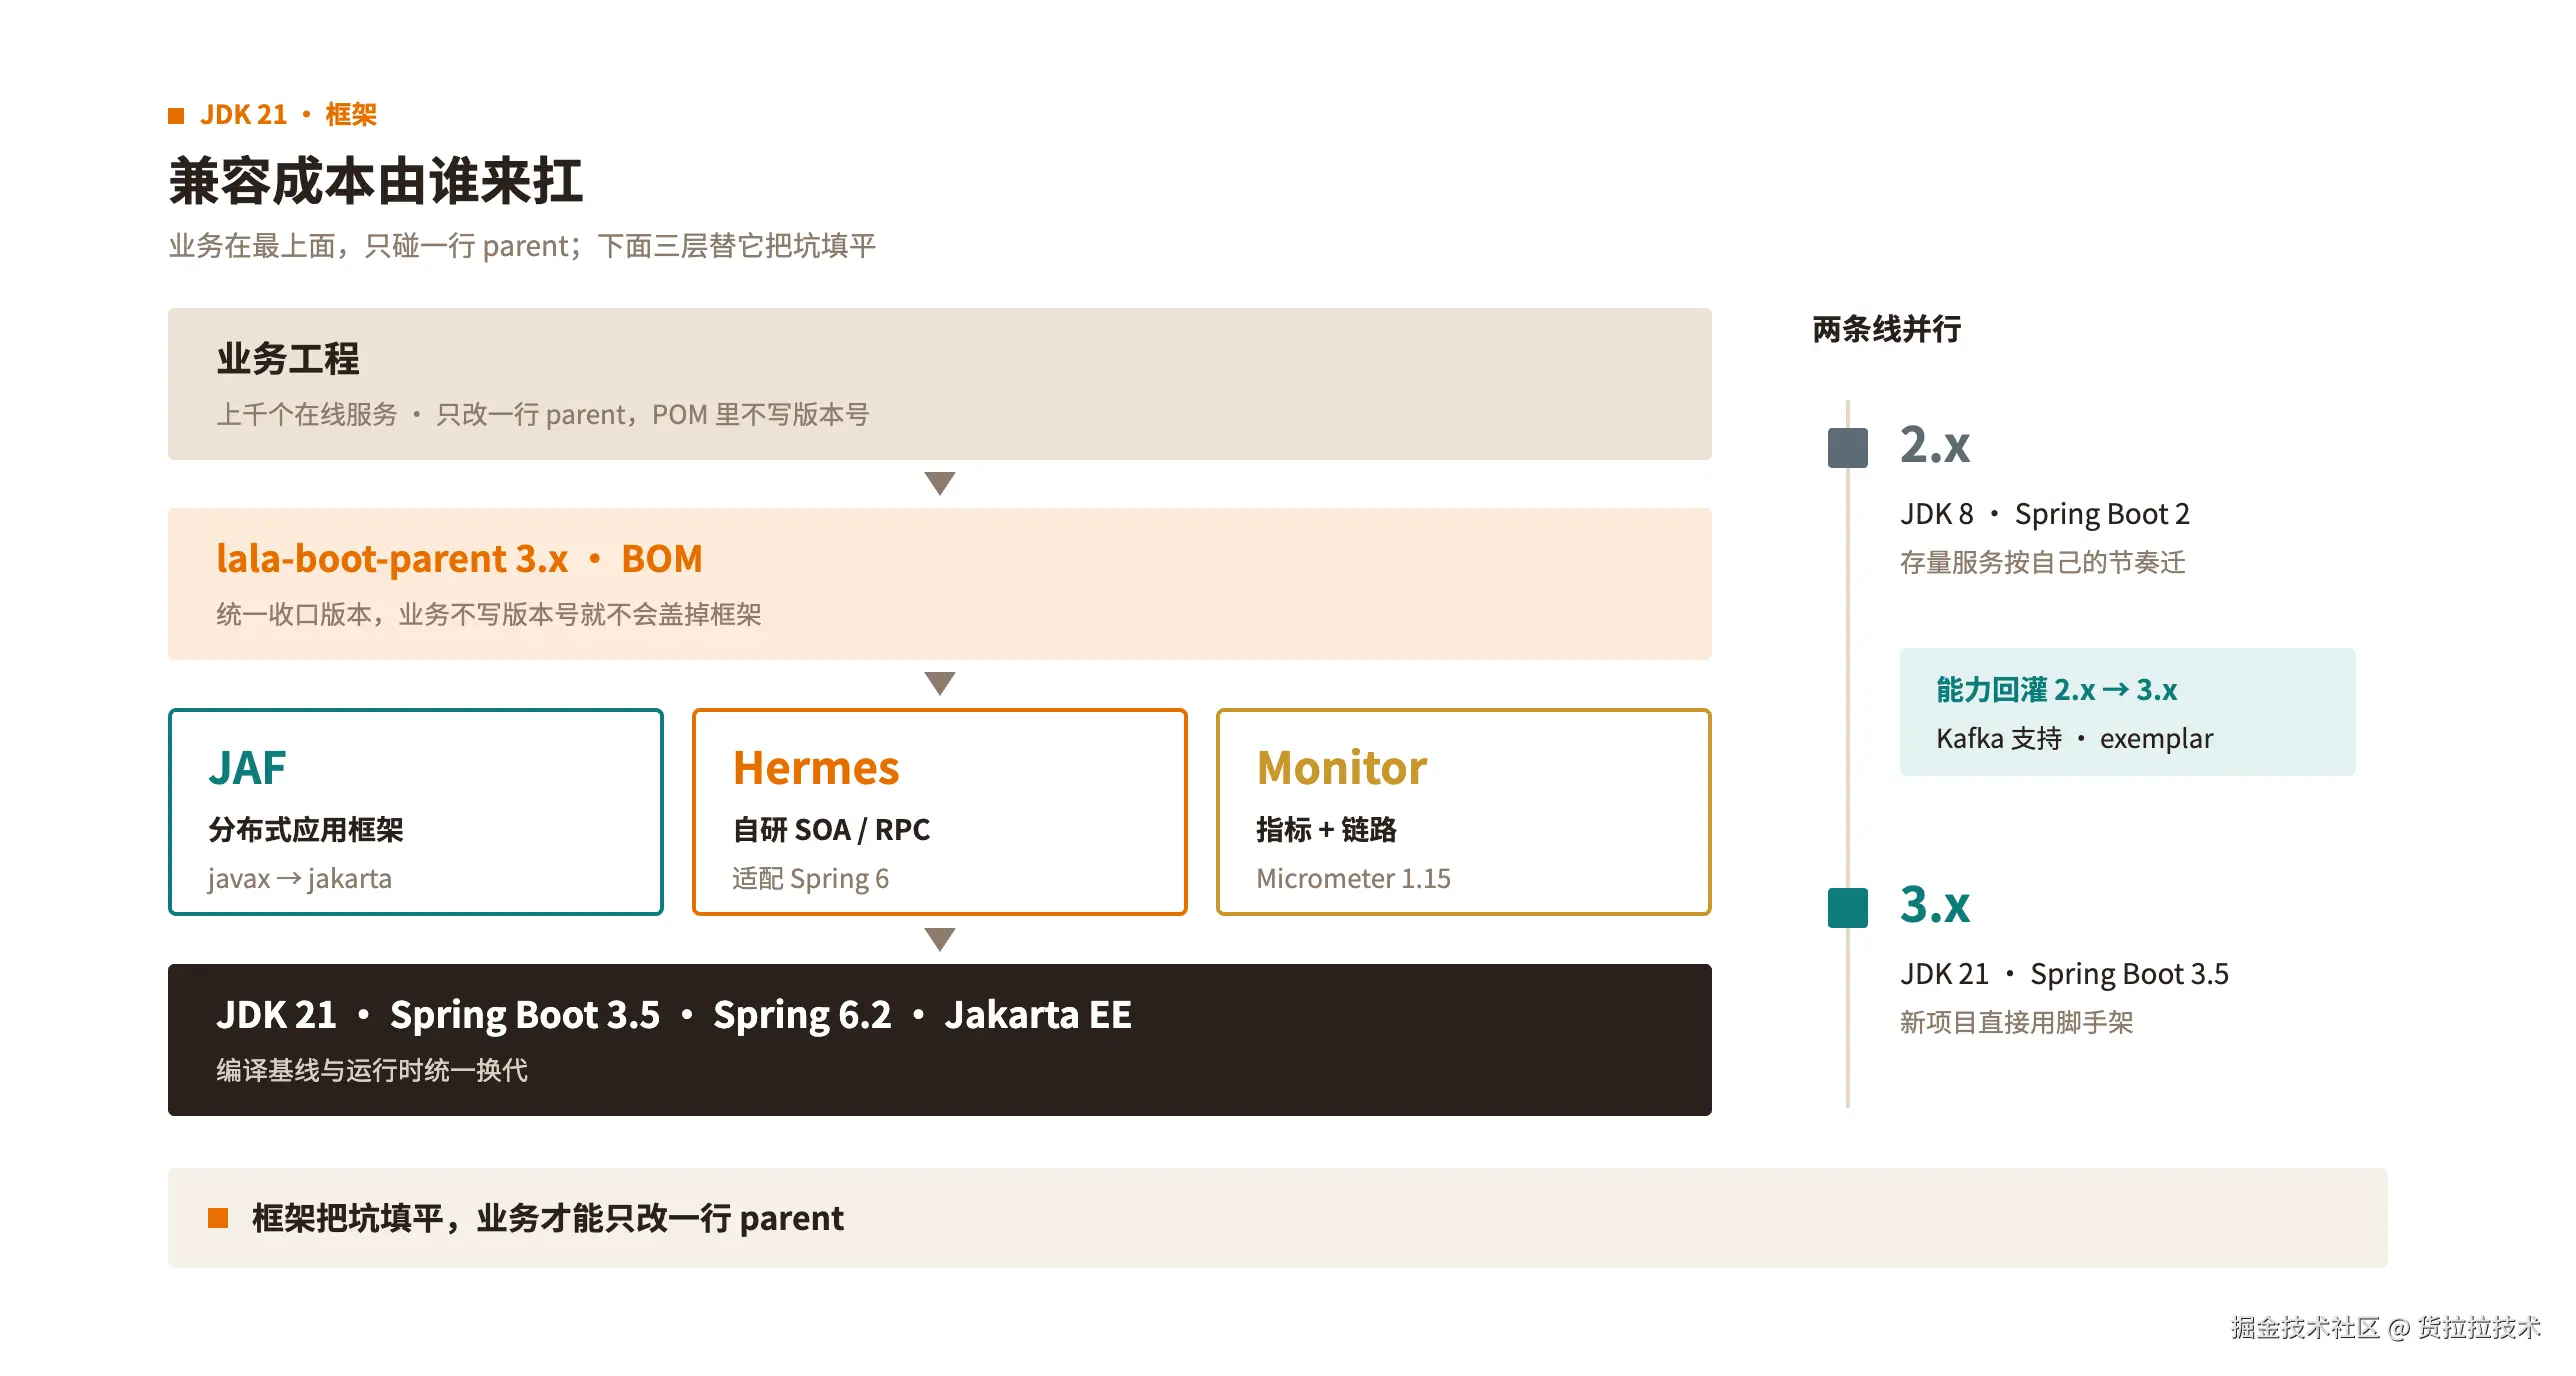
| 组件 | 定位 | 这次换代做什么 |
|---|---|---|
| lalaframework(JAF) | 分布式应用框架:配置、缓存、ORM、消息、SOA、治理等 Starter 体系 | 编译基线升 JDK 21,javax 全量切 jakarta,用 BOM 收口依赖 |
| hll-hermes | 自研 SOA/RPC 框架:JSON-RPC / gRPC、Consul 服务发现、路由与治理 | RPC 对齐 Spring 6,与 JAF 同代绑定 |
| lala-jaf-monitor | 监控组件:Prometheus 指标 + SkyWalking 链路,agent / 非 agent 两种接入 | 指标与链路换新引擎,灰度期间观测不断档 |
Hermes 与 JAF 版本强绑定(hermes.version = lala.release.version),不会出现跨代混用。2.x 和 3.x 两条线并行维护:新项目直接用 3.x 脚手架,存量服务按自己的节奏迁移,不必一次性切换;2.x 上验证过的能力(Kafka、exemplar 等)也会回灌到 3.x。
依赖整组抬升
框架升级的第一步,是把依赖整组抬上去,由 BOM 统一锁定版本,中间做了很多依赖的兼容适配。
重点关注两类问题:
Spring 管理的组件版本是否适配公司内部组件
举例:
Redis: 公司内部Datamesh/redis版本是否适配,协议/命令等。
其他如Mysql/ES等,都需适配公司内部的服务端版本。
组件本身是否有Bug
举例:
Spring 6.2.7管理的httpcore5:5.4版本存在bug,默认设置的tcpNoDelay:false失效,导致大包 RPC 延迟约 +40ms,升级到5.4.2版本才能解决。
主要依赖的版本对照如下,业务工程不要在 POM 里再覆盖这些版本:
| 依赖 | 2.x | 3.x |
|---|---|---|
| JDK | 8 | 21 |
| Spring Boot | 2.2.6 | 3.5.0 |
| Spring Framework | 5.2.5 | 6.2.7 |
| Servlet API | javax 4.0 | jakarta 6.0 |
| Micrometer | 1.5.x | 1.15.0 |
| Fastjson | 1.2.x | 2.0.x |
| MyBatis / MyBatis-Plus | 3.5.4 / 3.3.0 | 3.5.19 / 3.5.12 |
| MySQL Connector | 5.1.48 | 9.2.0 |
| gRPC | 1.41.1 | 1.73.0 |
| Jackson | 2.10.3 | 2.19.0 |
| Httpclient5 | 4.x | 5.x |
内部配套组件必须和框架同代,不支持 2.x 框架和 3.x 组件混用。升级评审时,先看依赖树有没有冲突,再看业务代码 diff。
JAF:中间件封装换新底座
-
Jakarta 迁移:javax.* 全量切到 jakarta.*,编译基线升到 JDK 21,版本管理改为 revision + flatten-maven-plugin
-
自动配置注册机制切换:META-INF/spring.factories 替换为 AutoConfiguration.imports(约 42 个文件)。自定义 Starter 如果只写了 spring.factories,在 Boot 3 下直接不生效
-
MyBatis 分页重构:JSqlParser 大版本升级,自研 pagehelper parser 整体重写,删掉约 1100 行旧实现
-
启动相关:健康检查默认关闭,避免探活拖垮启动;预热体系增强,按组件配置超时与重试
-
3.x 持续演进:3.1 动态线程池支持虚拟线程与上下文封装,3.2 引入 JetCache,3.3+ 落地 OceanBase / OBKV 与 LLM KMS 加密
Hermes:RPC 底座的 Spring 6 适配
-
去掉外部依赖:移除 alibaba spring-context-support,自研 BeanRegistrar 与上下文事件监听,注解处理收归框架内部
-
Spring 6 API 适配:HandlerInterceptorAdapter 被删,改为直接实现 HandlerInterceptor;InstantiationAwareBeanPostProcessorAdapter 改为直接实现接口,postProcessPropertyValues 换成 postProcessProperties
-
依赖升级:gRPC 1.41 → 1.73、Jackson 2.10 → 2.19、Resilience4j 1.7 → 2.3、jjwt 0.11 → 0.12(parserBuilder 换成 parser)
-
老包名兼容:hermes-compatible 保留 cn.lalaframework.soa 旧包名,老业务的 SOA API 不用改写就能迁到 3.x
升级后踩到的坑:HttpClient5 升级后大包 RPC 延迟约 +40ms,原因是 Nagle 与 Delayed ACK 叠加。显式打开 tcpNoDelay,并把 httpcore5 升到 5.4.2 才彻底修复;连接池默认策略也按升级前的行为对齐了回去。
Monitor:指标与链路换新引擎
-
Micrometer 1.5 → 1.15:Prometheus 包整体迁移:io.micrometer.prometheus → io.micrometer.prometheusmetrics,CollectorRegistry 换成 PrometheusRegistry,expire 指标体系重写
-
ByteBuddy 1.10 → 1.15:agent 的 Transformer 适配新的 ProtectionDomain 签名,清掉 sun.security 等 JDK 内部 API 调用
-
插件换代:删除 SOA v1.4 旧插件,新增 Spring MVC 6.x、RestTemplate 6.x、WebClient、Tomcat 10.x 插件,链路能力对齐新栈
-
能力回灌:Kafka 3.x 支持与 exemplar 能力从 2.x 回灌,灰度期间观测不断档
业务升级检查单
框架做完公共部分,业务工程要改的就收敛到下面五项。改完之后回归要测什么,见第三章末尾的回归检查单。
-
parent 切到 lala-boot-parent 3.x,删掉 POM 里所有手写版本号
-
javax → jakarta 全量替换,AI 辅助改造 + 人工验收
-
自定义 Starter 确认已改用 AutoConfiguration.imports
-
内部组件(hll-meta / config-client / prometheus / whitzard / hermes)确认与框架同代
-
编译基线切 JDK 21,Lombok 等编译期组件同步对齐
三、踩坑实录:编译是绿的,语义已经变了
规模化升级里最耗时间的,是编译全绿、语义却已经变了的那类问题。下面 12 个坑都是这次升级中真实踩过的,分依赖与契约、发布与资源模型两类,每条按现象、原因、做法写。章末附了一份回归检查单,可以直接对照使用。
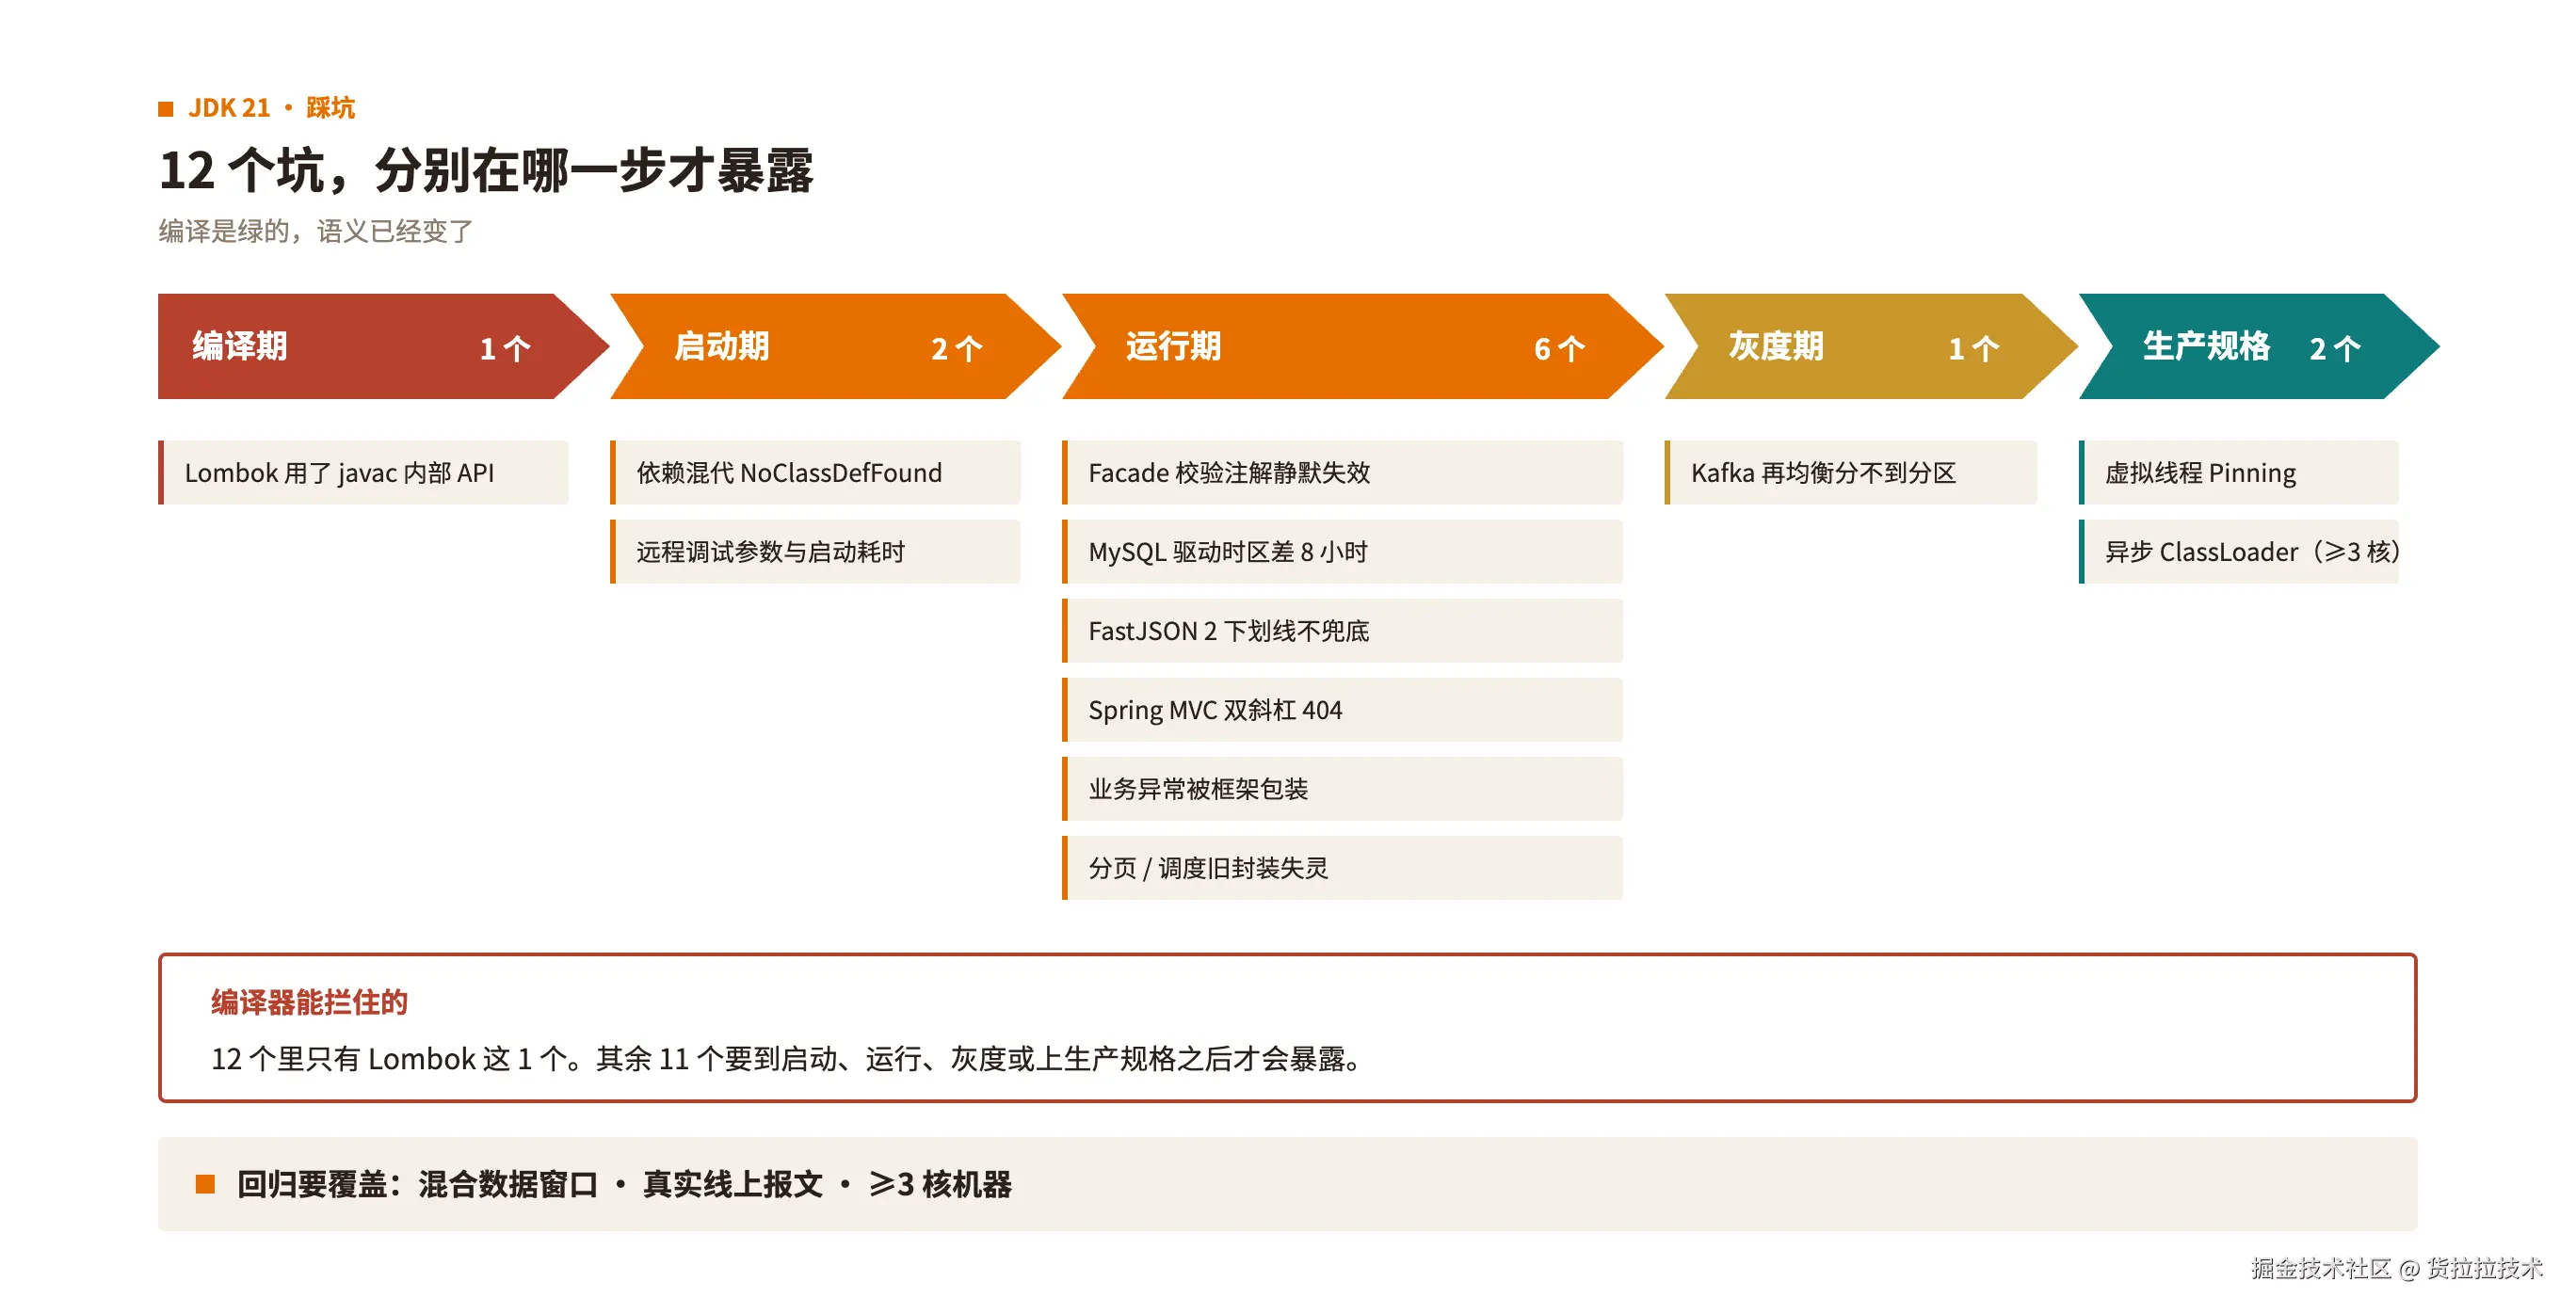
依赖与契约:接口没变,行为变了
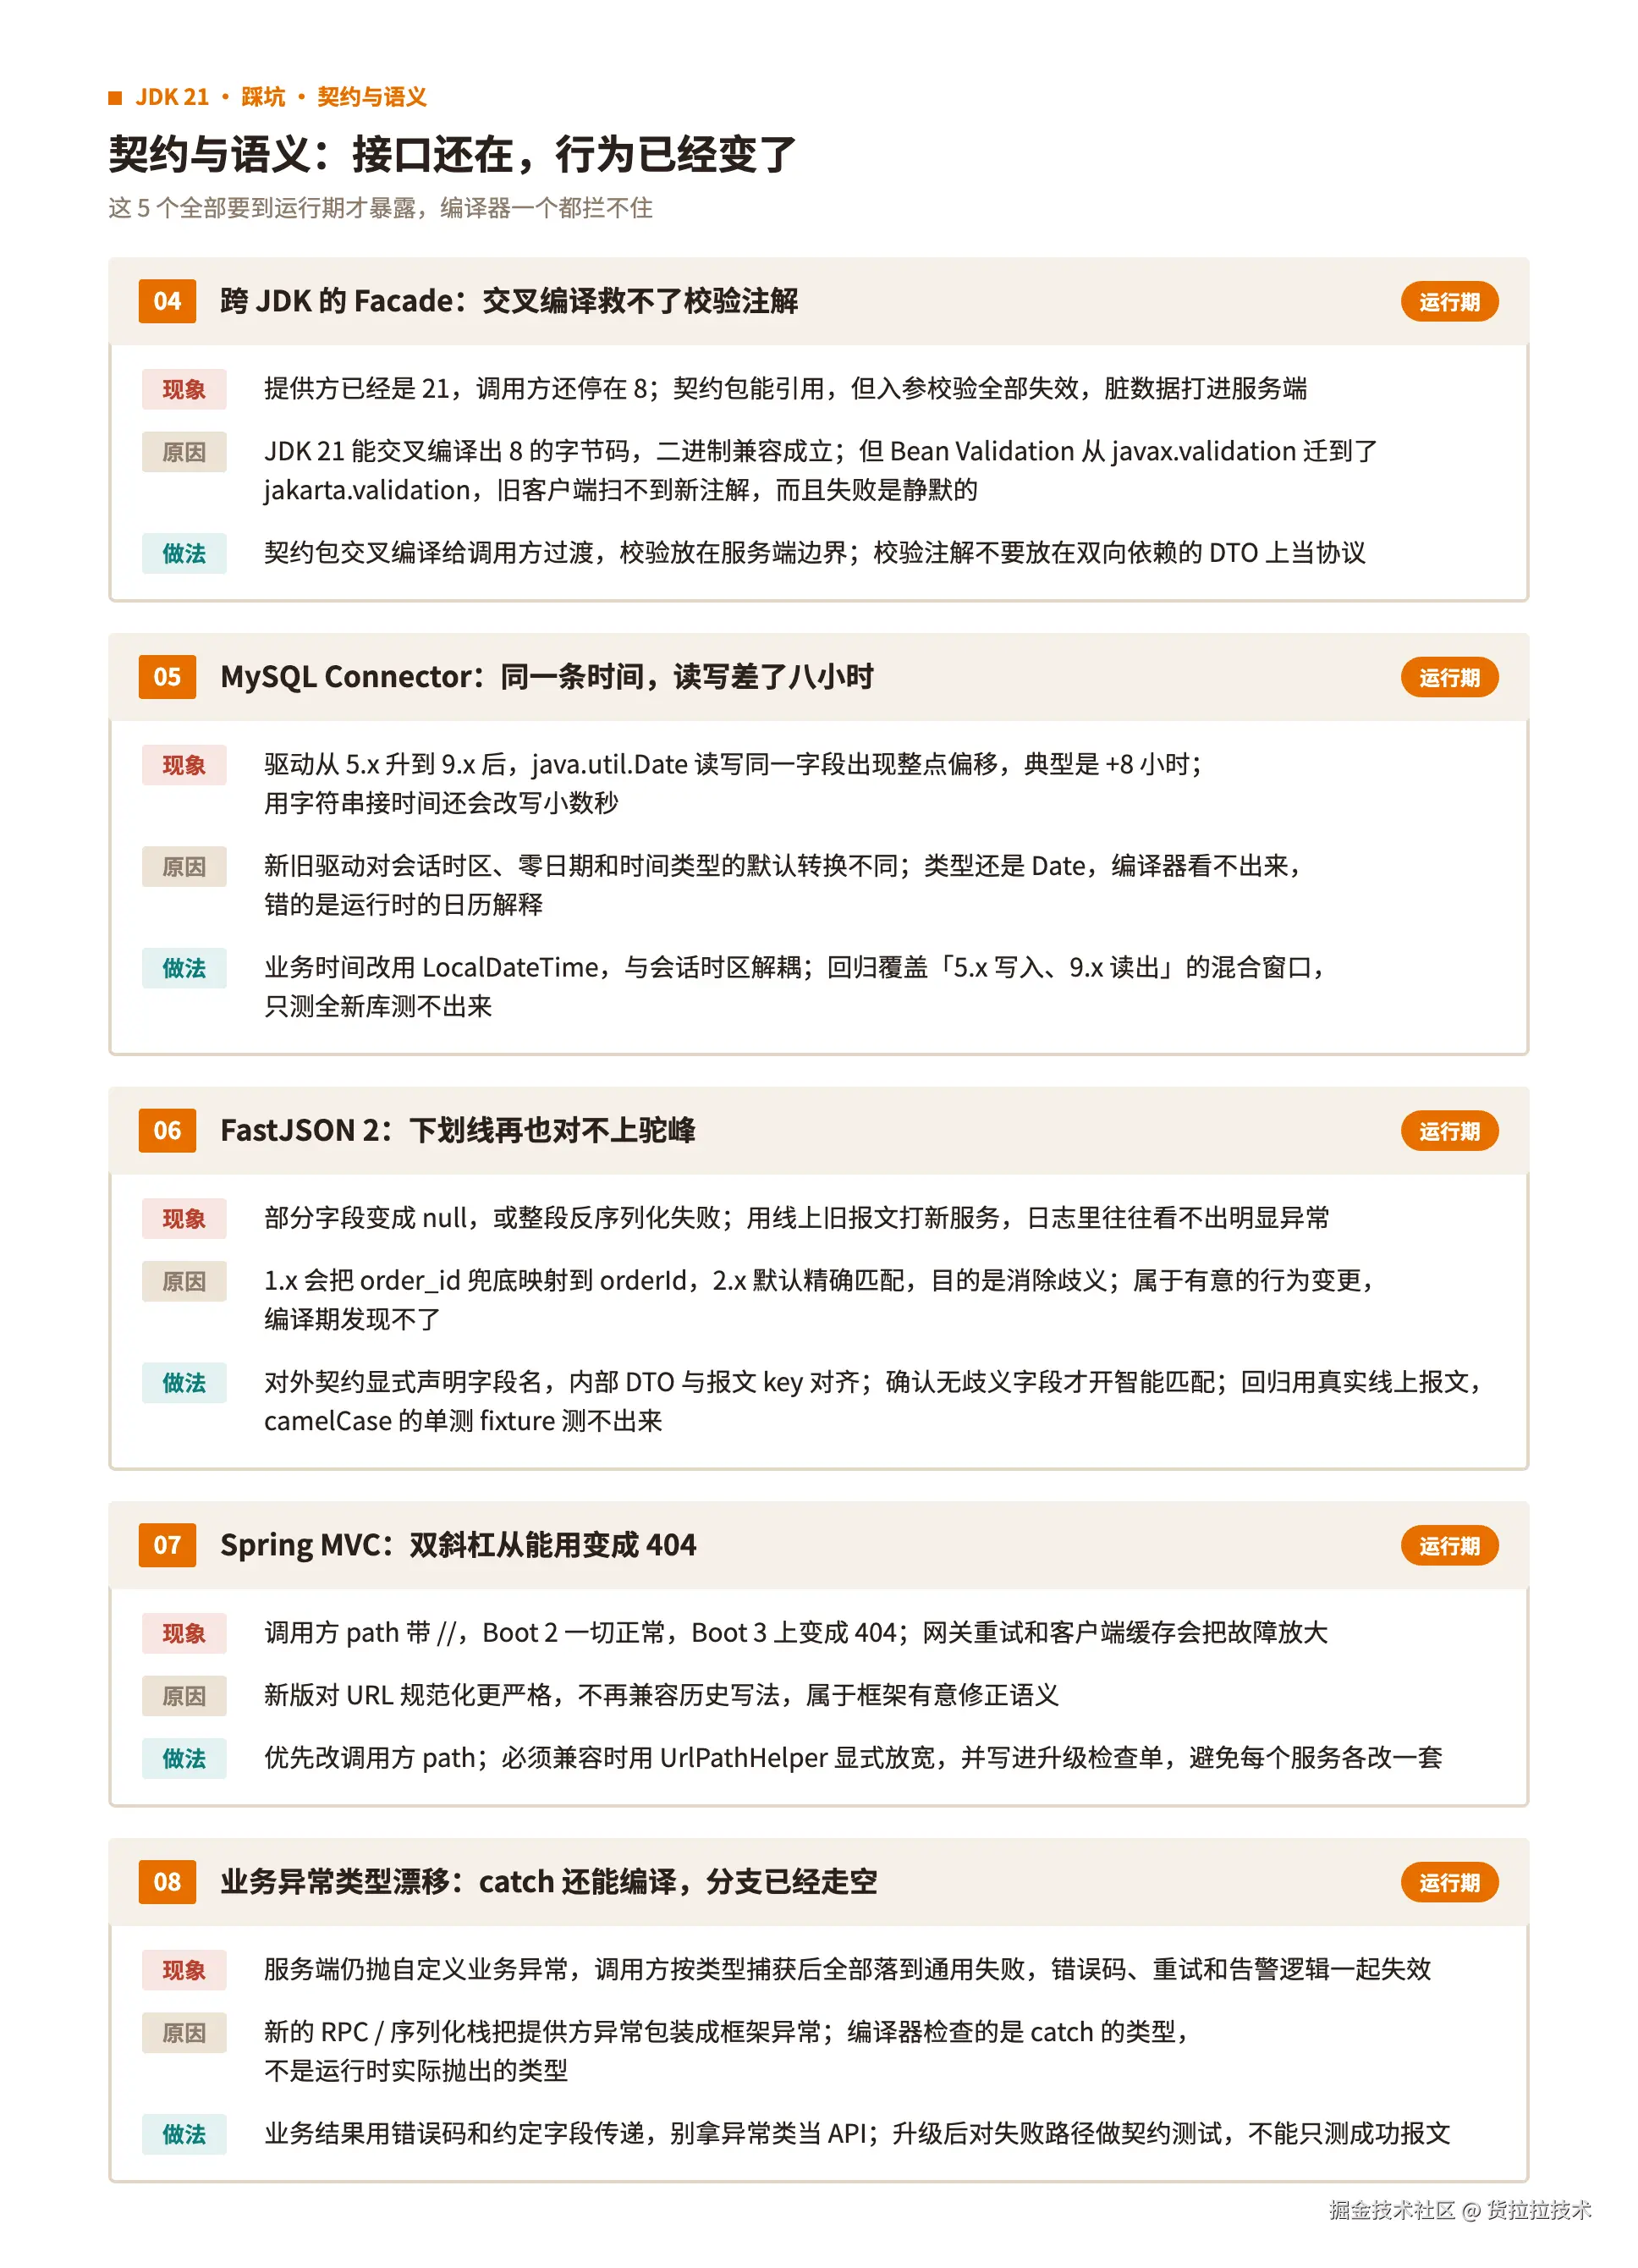
01~03 是依赖和构建问题,旧版本、旧封装在新栈上直接失效;04~08 出在契约和语义上,编译器一个都拦不住,只能靠回归覆盖。
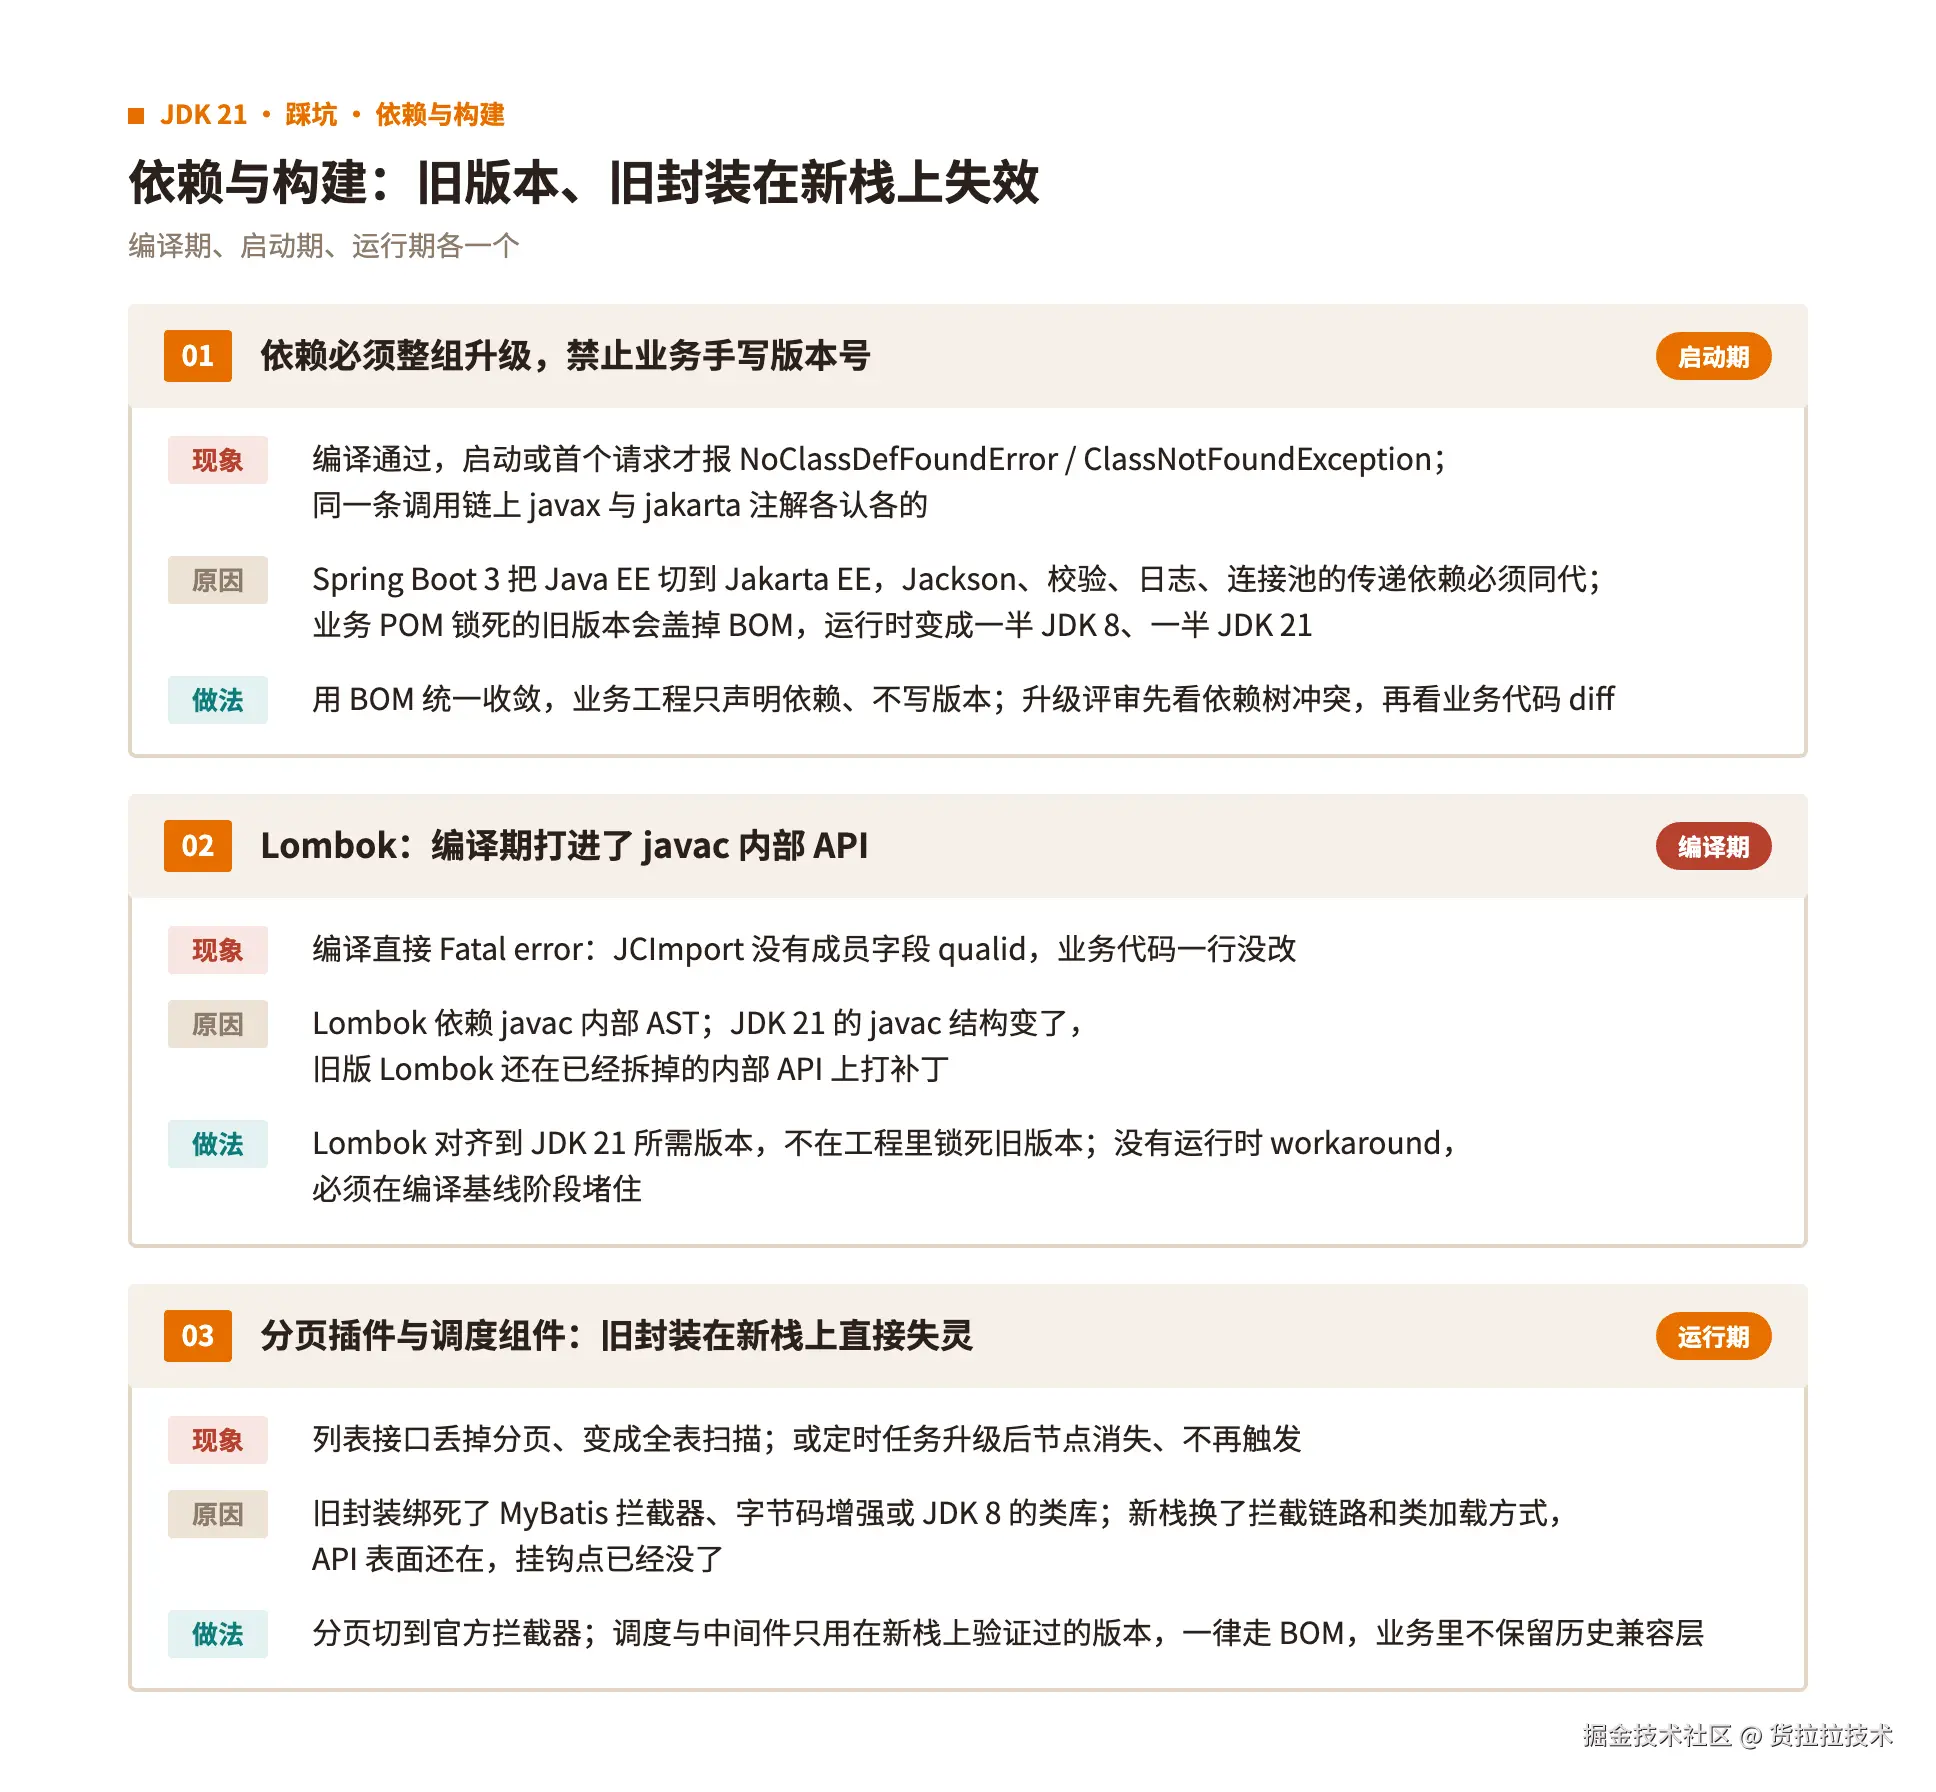
发布与资源模型:灰度窗口里才会爆的坑
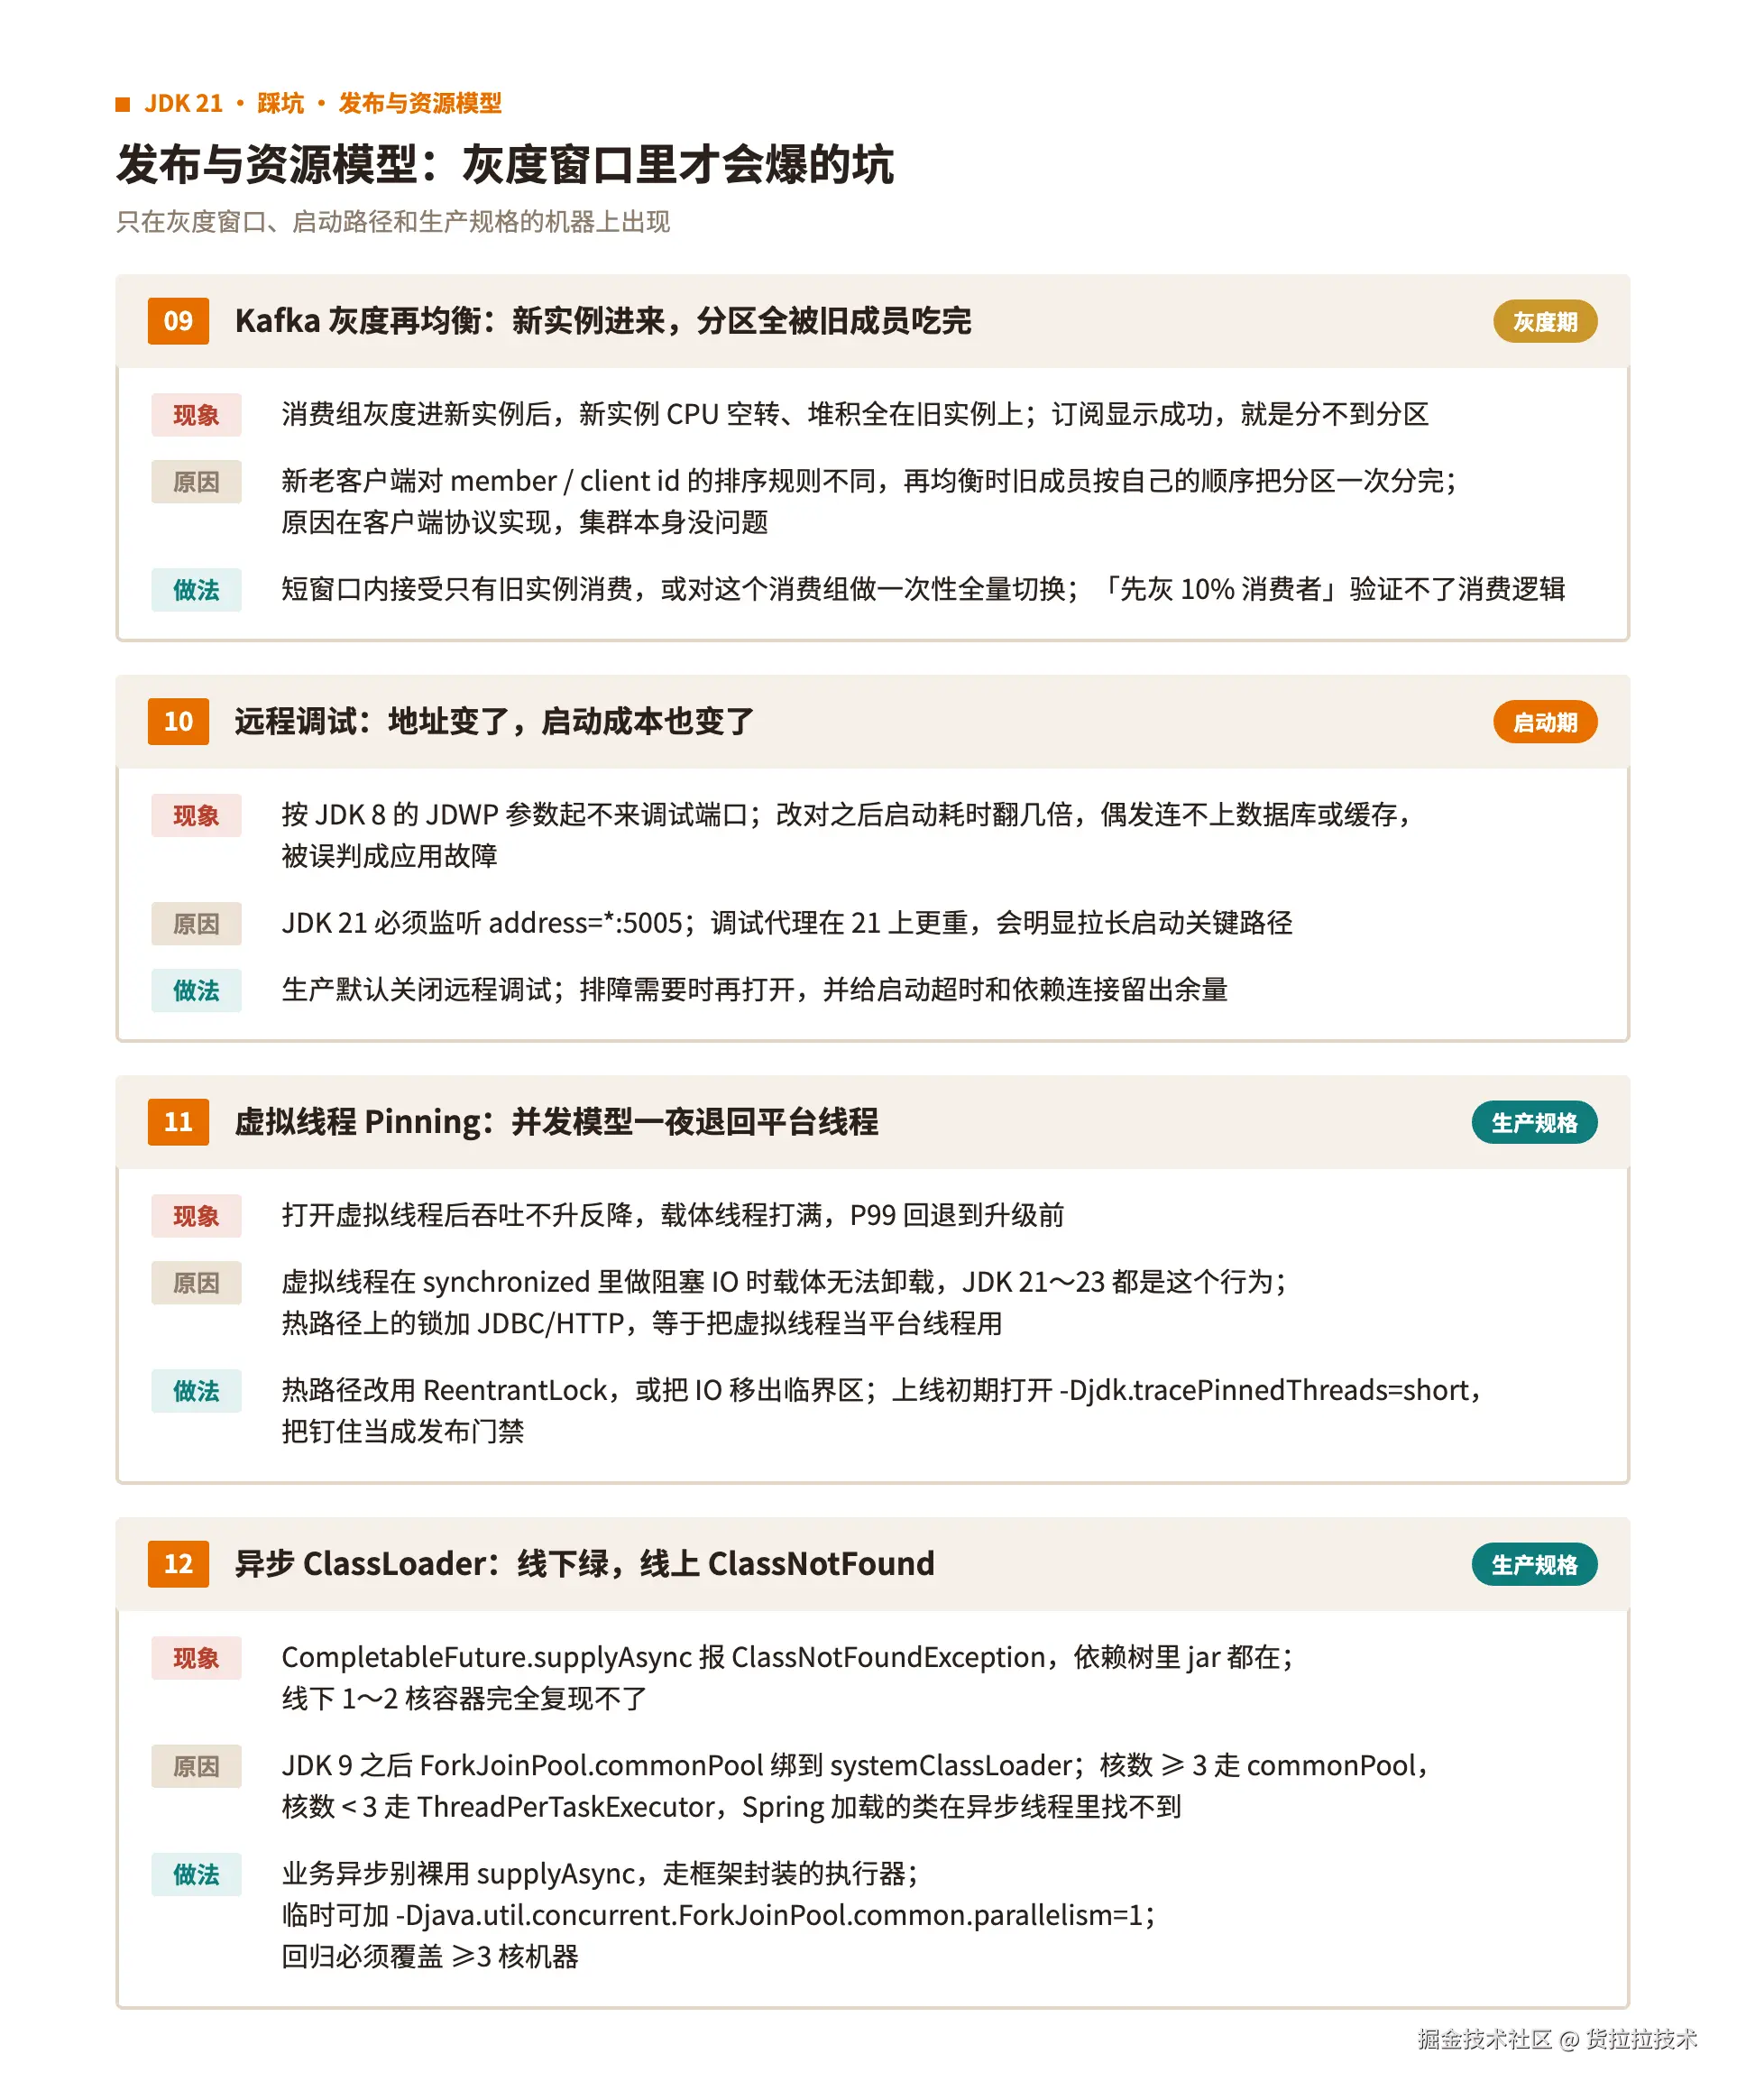
09~12 和发布方式、机器规格有关:有的只在灰度窗口里出现,有的要到生产规格的机器上才能复现,线下环境很难提前发现。
回归检查单
回归时逐项对照,括号里是对应的坑:
-
依赖树里 javax 与 jakarta 不并存,业务 POM 不覆盖 BOM 版本,Lombok 在 1.18.30 及以上(01、02)
-
分页走官方拦截器,定时任务升级后确认节点还在、能正常触发(03)
-
对外契约显式声明字段名,校验放在服务端边界,失败路径做了契约测试(04、06、08)
-
时间字段回归覆盖「5.x 写入、9.x 读出」的混合数据,反序列化用真实线上报文回放(05、06)
-
调用方 path 里没有 //,确需兼容的用 UrlPathHelper 显式放宽(07)
-
Kafka 消费组整组切换,或接受短窗口内只有旧实例消费;生产默认关闭远程调试(09、10)
-
打开钉住跟踪,热路径没有 Pinning;至少一轮回归跑在 3 核及以上的机器上(11、12)
四、特性应用:虚拟线程与语言新特性
虚拟线程:先选场景
平台线程和 OS 线程一对一,创建和切换成本都高。虚拟线程由 JVM 调度,阻塞在 HTTP、JDBC、Redis、RPC 上时会从载体线程卸下,载体转去执行其他虚拟线程。所以它适合大量等待、少量计算的同步代码。IO 并发靠 Semaphore 或连接池限流就行,不必为了限流去配一个很小的平台线程池。
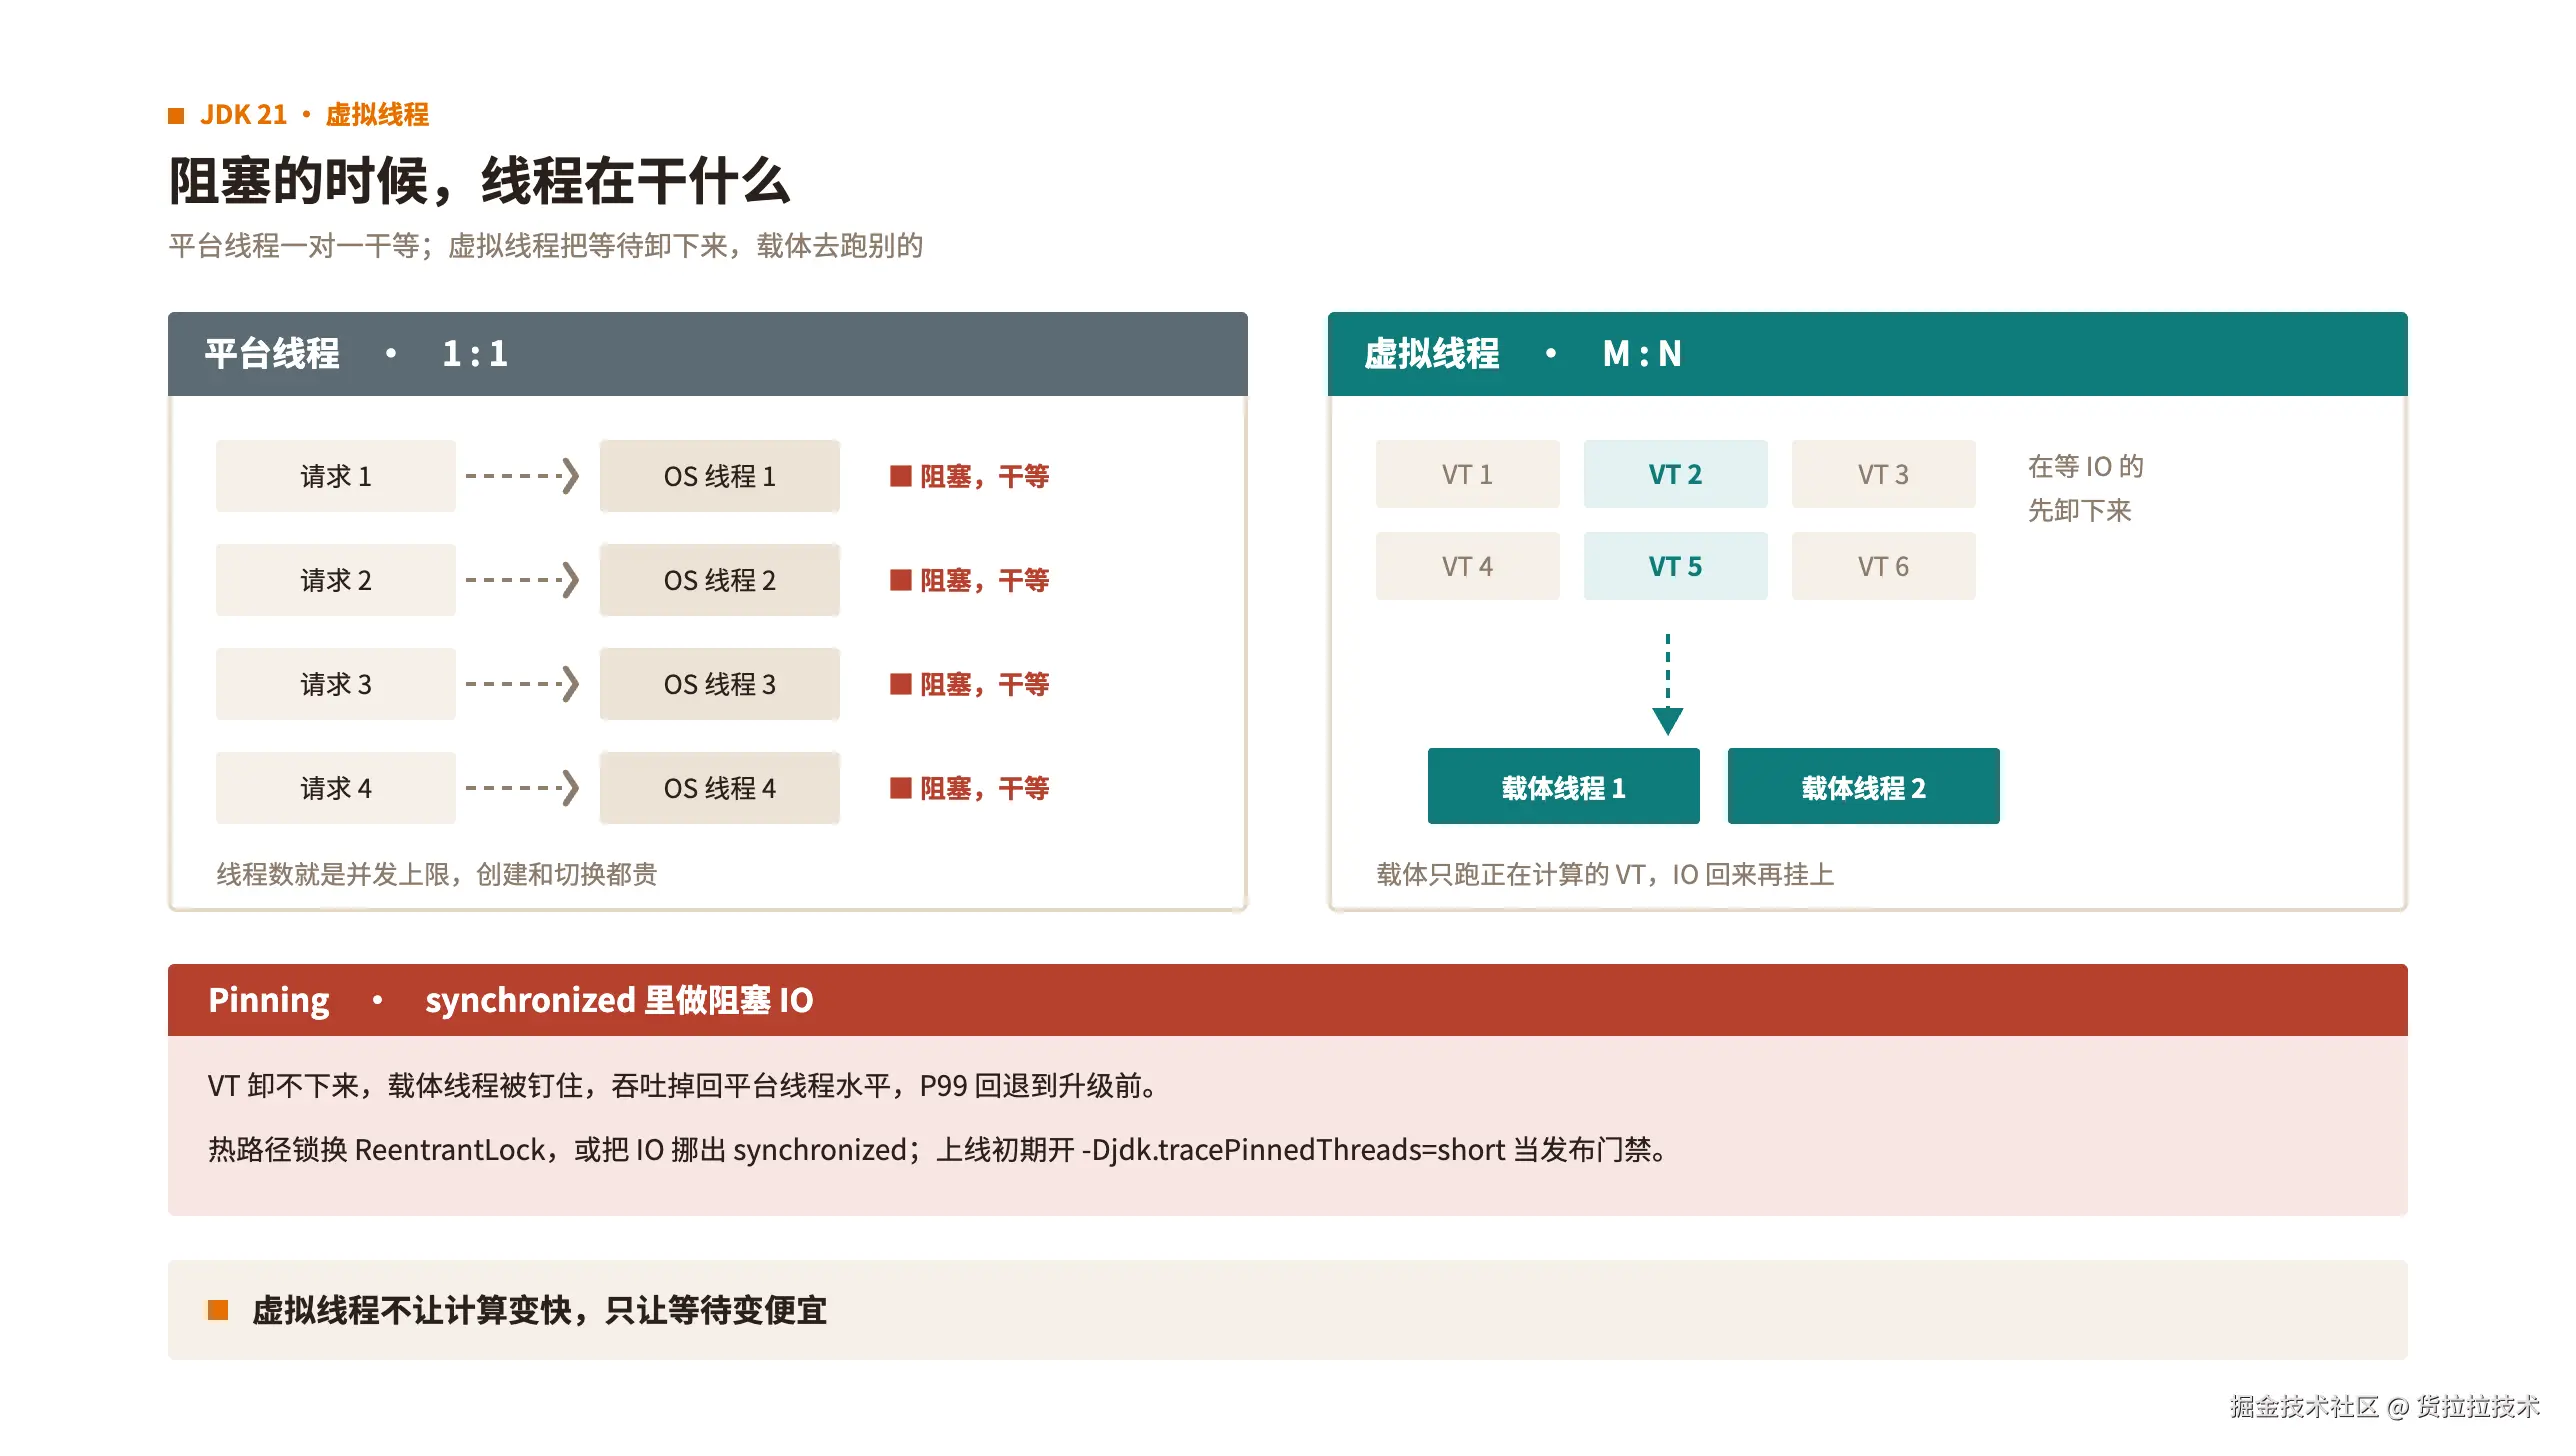
这几类场景继续用平台线程:CPU 密集的加解密、大 JSON 序列化,虚拟线程不会让计算变快;定时任务、XXL-JOB 和 Kafka 消费的线程由各自框架管理,并发也受任务数或分区数限制,换成虚拟线程收益不大。
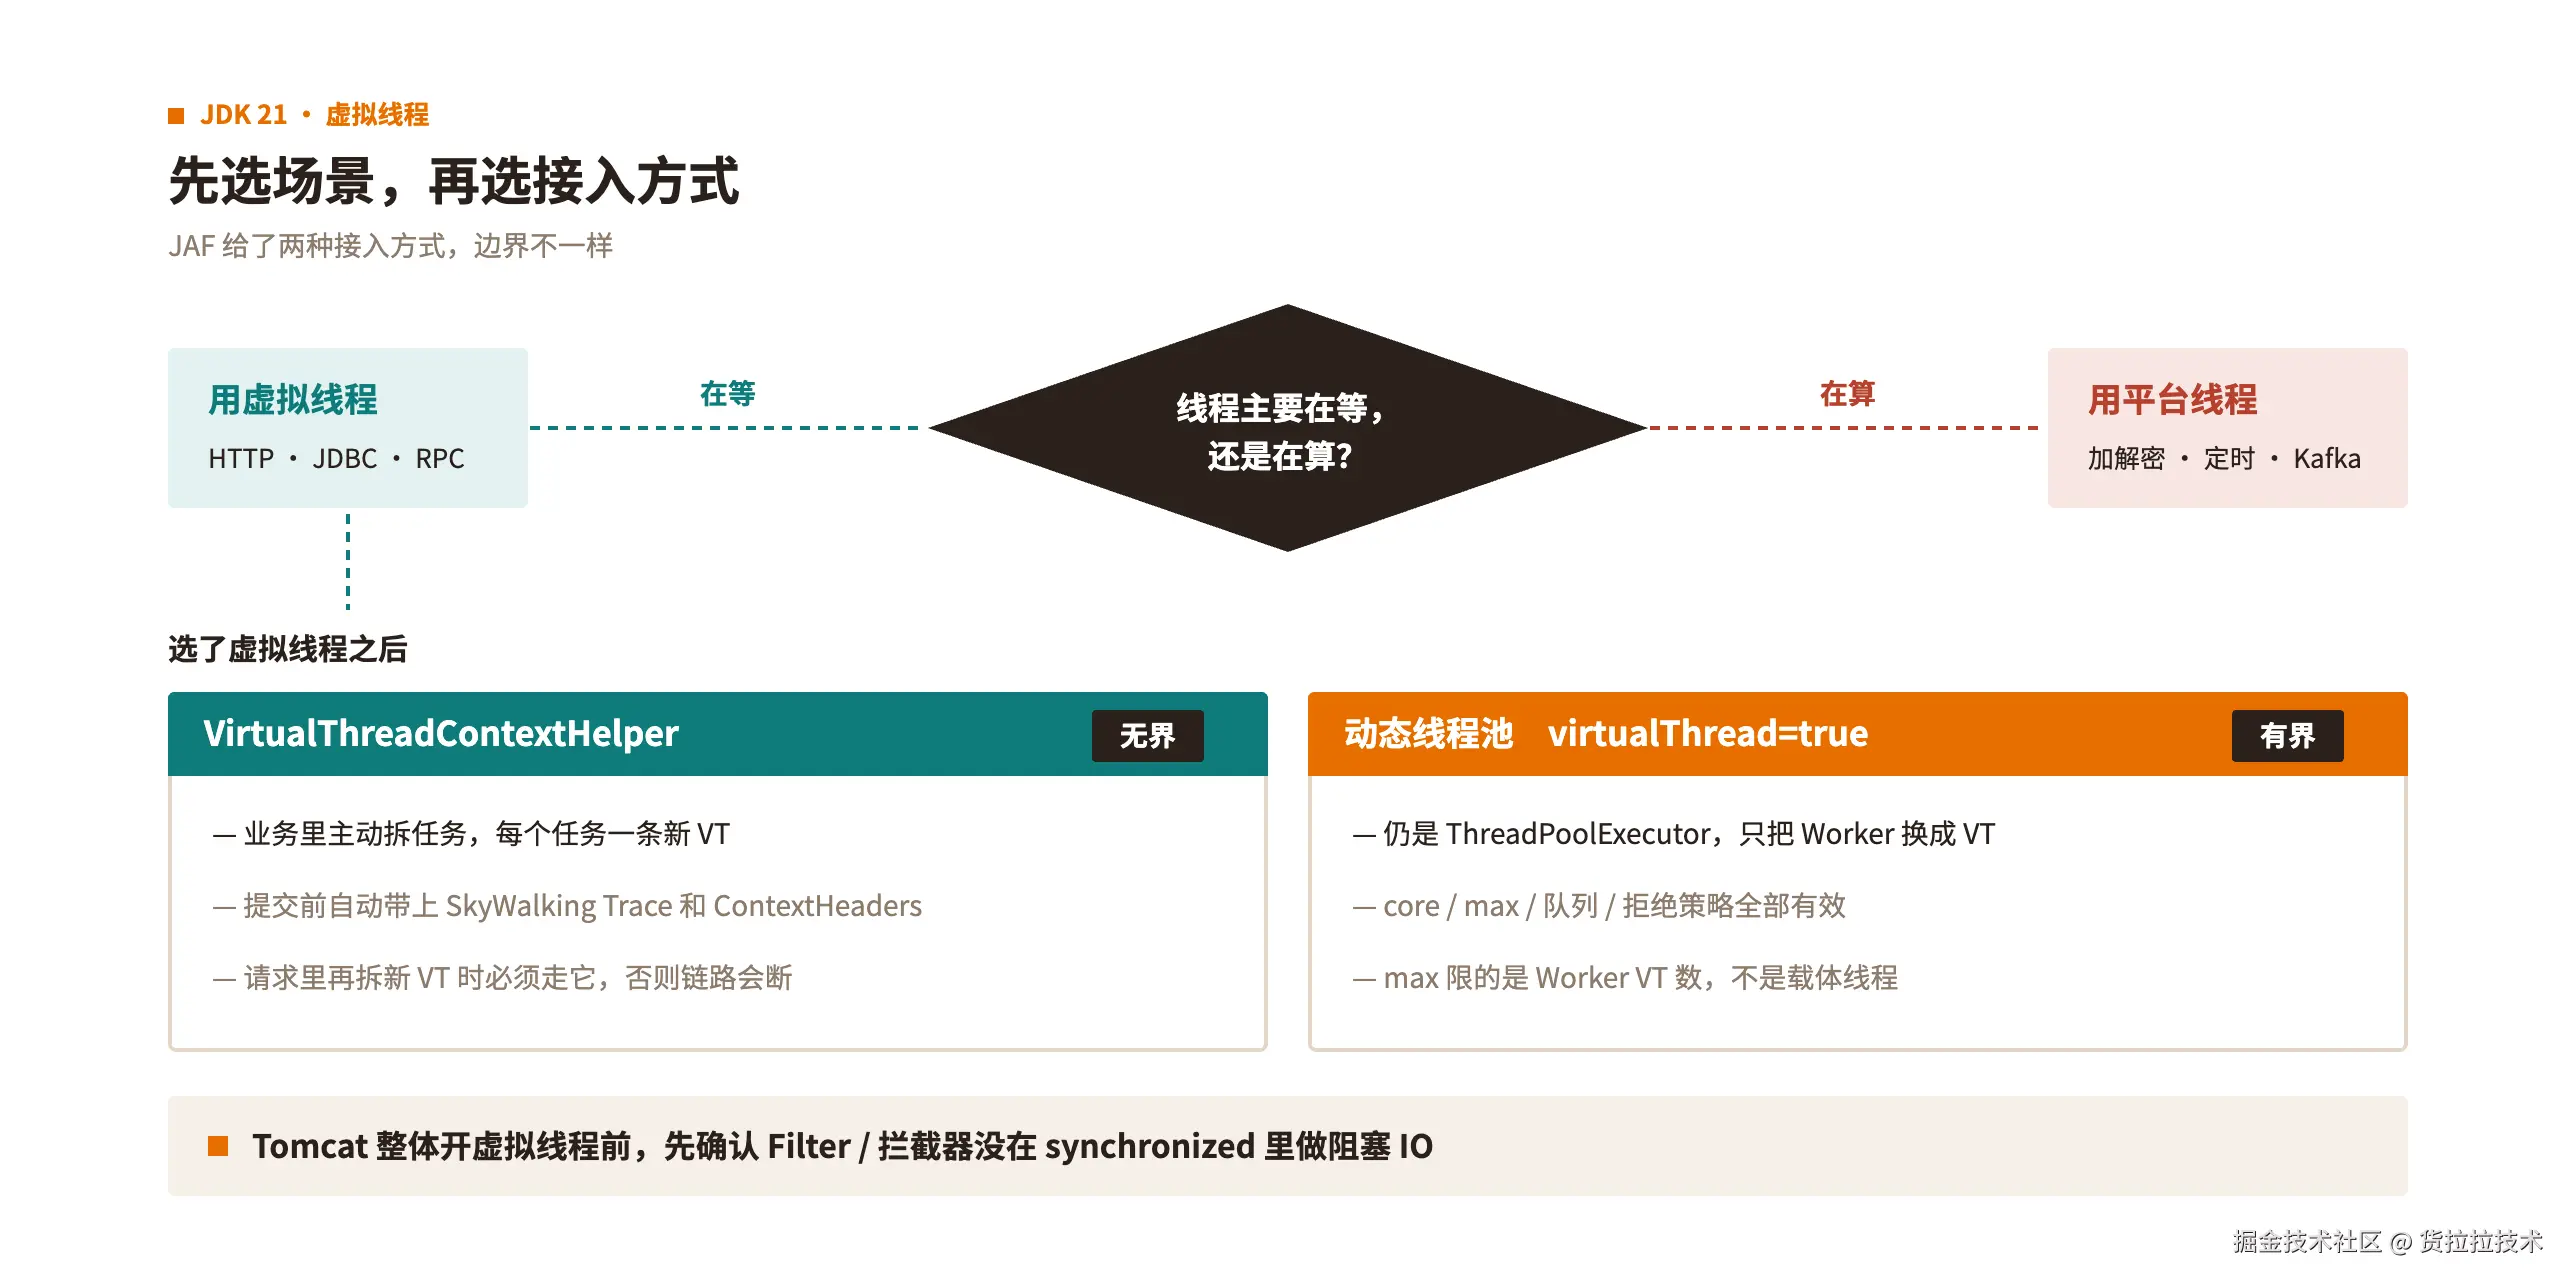
Tomcat 打开 spring.threads.virtual.enabled 会把整个请求切到虚拟线程,打开前先确认 Filter / 拦截器没有在 synchronized 里做阻塞 IO。请求本身不会断 Trace,只有在请求里再拆出新的虚拟线程时,才需要走 Helper。
JAF 的两种接入方式
VirtualThreadContextHelper
父线程把任务交给一条新的虚拟线程时,ThreadLocal 不会自动传递;同一条虚拟线程内阻塞 IO、换载体,则不需要再包一层。Helper 在提交前依次做两件事:
-
RunnableWrapper.of 捕获 SkyWalking Trace
-
ContextAwareRunnable.of 带上业务 ContextHeaders
runVirtual
对应 Thread.startVirtualThread
newVirtualThreadExecutor
对应每任务一条新 VT 的无界执行器(ThreadPerTaskExecutor)
Java
// 原生(无 Trace 要求的独立脚本可用)
try (ExecutorService ex = Executors.newVirtualThreadPerTaskExecutor()) {
    ex.submit(() -> doWork());
}

// 框架推荐(业务链路必用)
VirtualThreadContextHelper.runVirtual(() -> doWork());
CompletableFuture<String> f = VirtualThreadContextHelper.supplyVirtual(() -> loadData());
ExecutorService ex = VirtualThreadContextHelper.newVirtualThreadExecutor("biz-virtual-");
动态线程池
打开 virtualThread=true 后,动态线程池只换创建线程的方式,执行器仍然是 ThreadPoolExecutor,核心数、最大数、队列、拒绝策略都有效,创建出来的 Worker 全部是虚拟线程。调度池 DtpScheduledExecutor 会忽略这个开关。
Java
@Bean
public ThreadPoolExecutor virtualExecutor() {
    return ThreadPoolBuilder.newBuilder()
            .threadPoolName("virtualExecutor")
            .corePoolSize(20)
            .virtualThread(true)
            .maximumPoolSize(100)
            .queueCapacity(2048)
            .buildDynamic();
}
它和 newVirtualThreadPerTaskExecutor() 不一样:后者每提交一个任务就新建一条 VT,没有队列,也没有 core/max。DTP 的 core/max 限制的是 Worker 虚拟线程数,不是载体。载体由 JVM 按 CPU 核数按需提供,默认上限约为 max(核数, 256),和 Tomcat、Helper 共用。IO 场景可以调大 DTP 的 max 来提高并发。
语言特性
JDK 21 里可以马上用的,是已经转正的模式匹配、Record 拆字段、有序集合和文本块。它们不影响性能,好处是少写强制转换和样板代码,配合 sealed 接口还能在编译期发现漏掉的分支。
可以进生产
模式匹配、Record 拆字段、有序集合、文本块
生产禁用
String Templates、Structured Concurrency 等还没转正的特性,不要加 --enable-preview
模式匹配:少一次强制转换
instanceof 判断类型时可以直接带上变量,从 JDK 16 起就能用;switch 按类型分支在 JDK 21 转正。两者都能去掉强制转换和重复判空。
Java
if (factory instanceof NamedThreadFactory named) {
    return named.getNamePrefix();
}

if (dataSource instanceof ItemDataSource itemDataSource) {
    return itemDataSource.getRealDataSource();
}
switch 适合同一个入口、多种类型的分发。对 sealed 接口做 switch 且不写 default 时,漏掉分支会直接编译报错。有两个容易踩的点:
-
null 要单独写 case null,否则空值会直接 NPE
-
带 when 的条件要写在更宽泛的 case 前面,否则会被前面的 case 覆盖,编译直接报错
Java
static String describe(Object value) {
    return switch (value) {
        case null -> "empty";
        case String s when s.isBlank() -> "blank";
        case String s -> "text:" + s.length();
        case Integer i -> "int:" + i;
        default -> value.getClass().getSimpleName();
    };
}
Record:只承载数据,别当 Bean 用
适合
只读的数据对象、缓存 Key、几个字段拼成的路由 Key
继续用 class
MyBatis 实体、带 setter 的配置、Spring Bean
和 switch 一起用时,可以直接拆出里面的字段:
Java
public record RouteKey(String tenantId, String table) {}

static String shard(Object key) {
    return switch (key) {
        case RouteKey(String tenant, String table) -> tenant + ":" + table;
        case String s -> s;
        default -> "default";
    };
}
有序集合:官方的 getFirst / getLast
JDK 21 给 List、LinkedHashSet 这类有序集合补了统一的 getFirst() / getLast(),不用再写 get(0) 和 get(size - 1);LinkedHashMap 对应的是 firstEntry() / lastEntry()。空 List 调 getFirst() 会抛 NoSuchElementException,调用前先判空。reversed() 返回的是反向视图,不是拷贝,需要快照时用 new ArrayList<>(list.reversed())。
Java
List<String> steps = new ArrayList<>(List.of("auth", "route", "invoke"));
steps.addFirst("warmup");
String last = steps.getLast();
List<String> reversed = steps.reversed(); // 视图,不是拷贝

LinkedHashMap<String, Integer> order = new LinkedHashMap<>();
order.putLast("tail", 1);
Map.Entry<String, Integer> first = order.firstEntry();
文本块:样例和测试用,别拼运行时 SQL
文本块(""")适合单测里的 JSON 样例和错误报文模板。运行期拼接带用户输入的 SQL 仍然有注入风险,这点和以前一样。
Java
String payload = """
        {"orderId": "%s", "status": "CREATED"}
        """.formatted(orderId);
五、运行时治理:让 JVM 看见真实的容器
升级带来的运行时收益,要靠三件事落到线上:按延迟要求选 GC,让 JVM 读到容器真实的内存和 CPU,排障先看聚合指标、不再只靠 dump。先说结论:默认用 G1,接口对延迟敏感且堆较大时再评估分代 ZGC;堆大小用百分比,不要写死 -Xmx。
GC 怎么选
JDK 21 默认是 G1,大多数业务先用它。分代 ZGC 停顿更短,但更吃内存和 CPU。启动参数里只能留一个收集器,-XX:+UseG1GC 和 -XX:+UseZGC 同时出现时 JVM 会直接启动失败,切换时记得删掉旧参数。
| 维度 | G1(默认) | 分代 ZGC |
|---|---|---|
| 适用堆 | 2G~16G 最常见,更大也能跑 | 8G 以上更划算,小堆收益不明显 |
| 停顿目标 | 通常 50~200ms,目标不是硬约束 | 通常几毫秒内,更稳 |
| 吞吐 | 更好,CPU 开销更低 | 略差,换来的是延迟平稳 |
| 内存额外开销 | 相对小 | 更大,容器要多留余量 |
| 什么时候用 | JAF / 中间件默认,先用这个 | 慢请求压不下去、堆持续变大时再评估 |
-
G1 停顿目标:别写成 20ms 这种达不到的值。达不到时回收会更勤、吞吐更差,停顿也不会真到 20ms。堆 4G~8G 的在线服务,从 200ms 起步更现实。
-
IHOP:老年代涨得快、回收跟不上时,把 InitiatingHeapOccupancyPercent 从默认 45 降到 35~40;回收过于空闲时再略调高。
Plain
java -XX:+UseG1GC \
     -XX:MaxGCPauseMillis=200 \
     -XX:InitiatingHeapOccupancyPercent=45 \
     -XX:+ParallelRefProcEnabled \
     -XX:+ExitOnOutOfMemoryError \
     -Xlog:gc*,gc+heap=info:file=/var/log/gc.log:time,uptime,level,tags:filecount=5,filesize=50M \
     -jar app.jar
分代 ZGC 不必堆很多调优项,给够堆和 CPU 更要紧。容器只给 1 核时回收会拖很久,表现为没有整堆回收、接口却超时。上线后对照三项:慢请求有没有下降、CPU 有没有明显升高、容器内存是不是更贴近上限。切换参数是 -XX:+UseZGC -XX:+ZGenerational。ZGC 自身占用的内存比 G1 多,堆占比从 65% 起步,GC 压力偏高时再调到 70% 左右。
-
GC 日志用 -Xlog,别再用 PrintGCDetails。至少留几天,才能对上某次发布或流量尖峰。
-
System.gc() 在 G1 上会触发整堆回收。生产用 -XX:+ExplicitGCInvokesConcurrent 改成并发回收,不要用 -XX:+DisableExplicitGC 直接关掉:堆外内存打满时,NIO 要靠 System.gc() 回收 DirectByteBuffer,关掉反而更容易 OOM。
-
Netty / NIO 的堆外内存不会出现在堆内存图里,打满时看起来像堆很空却 OOM,要单独设 MaxDirectMemorySize。
容器内存和 CPU
JDK 21 会读容器的内存上限和 CPU 配额,不再按宿主机估算。以前宿主机 64 核 128G、容器只有 2 核 4G,JVM 却按宿主机来算默认堆和 GC 线程数,很容易超出容器配额。换上 JDK 21 镜像后这类问题大多自动消失,要手调的只剩堆百分比和堆外预留。
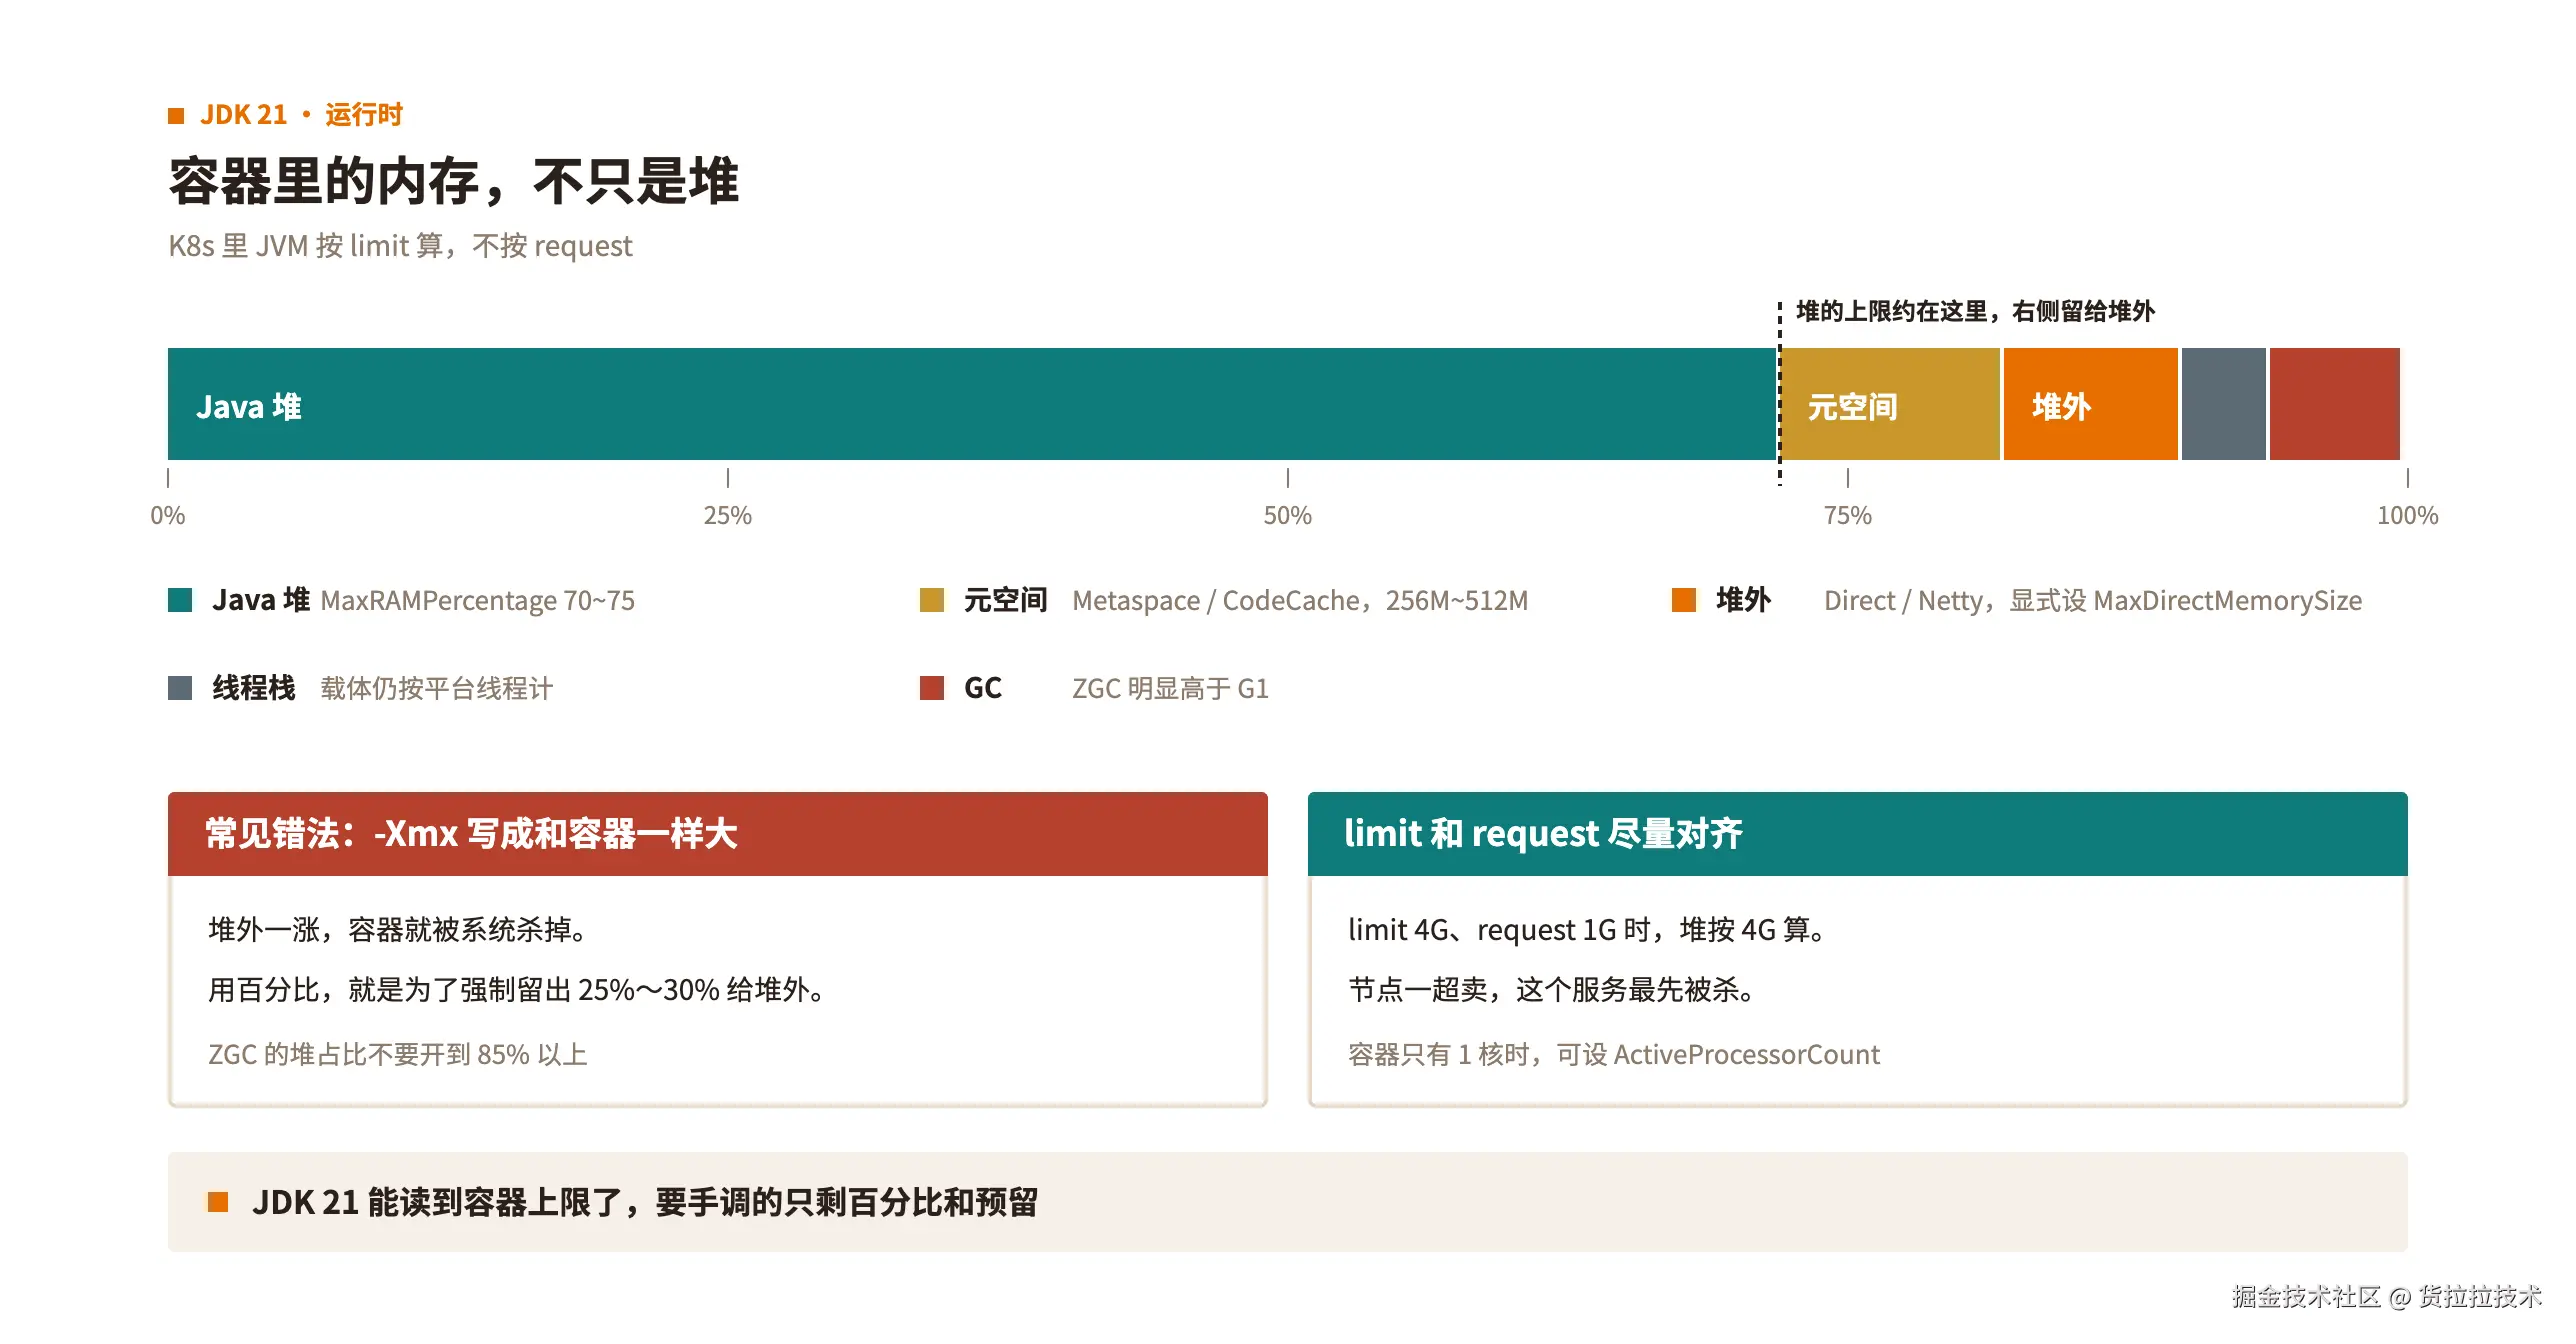
| 一块内存 | 谁在用 | 容器里怎么留 |
|---|---|---|
| Java 堆 | 对象、G1/ZGC 区域 | MaxRAMPercentage:G1 取 70~75,ZGC 取 65~70 |
| Metaspace / CodeCache | 类、JIT | Spring Boot 3 服务常见 256M~512M 量级,别忽略 |
| DirectMemory / Netty | NIO、RPC、网关 | 显式设 -XX:MaxDirectMemorySize,默认可能接近堆大小 |
| 线程栈 | 载体平台线程 + 虚拟线程栈 | 虚拟线程栈很小,但载体线程仍按平台线程算 |
| GC 自己占用 | 收集器 | ZGC 明显高于 G1,所以 ZGC 的堆占比不要开到 85% 以上 |
-
要更快起堆可以加 InitialRAMPercentage,取上限的一半左右,不要等于上限。两者相等时,堆一开始就按上限申请,内存占用很快逼近 limit,节点超卖时这类实例最先被杀。
-
容器很小(比如 500m)时 JVM 可能只看到 1 核,回收偏慢;需要时写 -XX:ActiveProcessorCount=2,但不要大于容器 CPU 上限。
镜像用公司统一的 JDK 21 基础镜像,别出现编译用 21、运行用 17 的情况。下面是按 4G 容器、G1 给的启动命令,可以直接拷进部署模板。虚拟线程上线初期打开钉住跟踪,确认热路径干净后再关:
Plain
java -XX:+UseG1GC \
     -XX:MaxRAMPercentage=70.0 \
     -XX:InitialRAMPercentage=35.0 \
     -XX:MaxDirectMemorySize=512m \
     -XX:+ExplicitGCInvokesConcurrent \
     -XX:+ExitOnOutOfMemoryError \
     -XX:+HeapDumpOnOutOfMemoryError \
     -XX:HeapDumpPath=/var/log/heapdump.hprof \
     -Djdk.tracePinnedThreads=short \
     -Xlog:gc*,gc+heap=info:file=/var/log/gc.log:time,uptime,level,tags:filecount=5,filesize=50M \
     -jar app.jar
观测:先看聚合,再下钻
以前一次 thread dump 就能看清谁卡住了。虚拟线程可以到十万级,完整 dump 既占磁盘又没法人工读,而且绝大多数线程只是在等 IO。排障顺序要换:
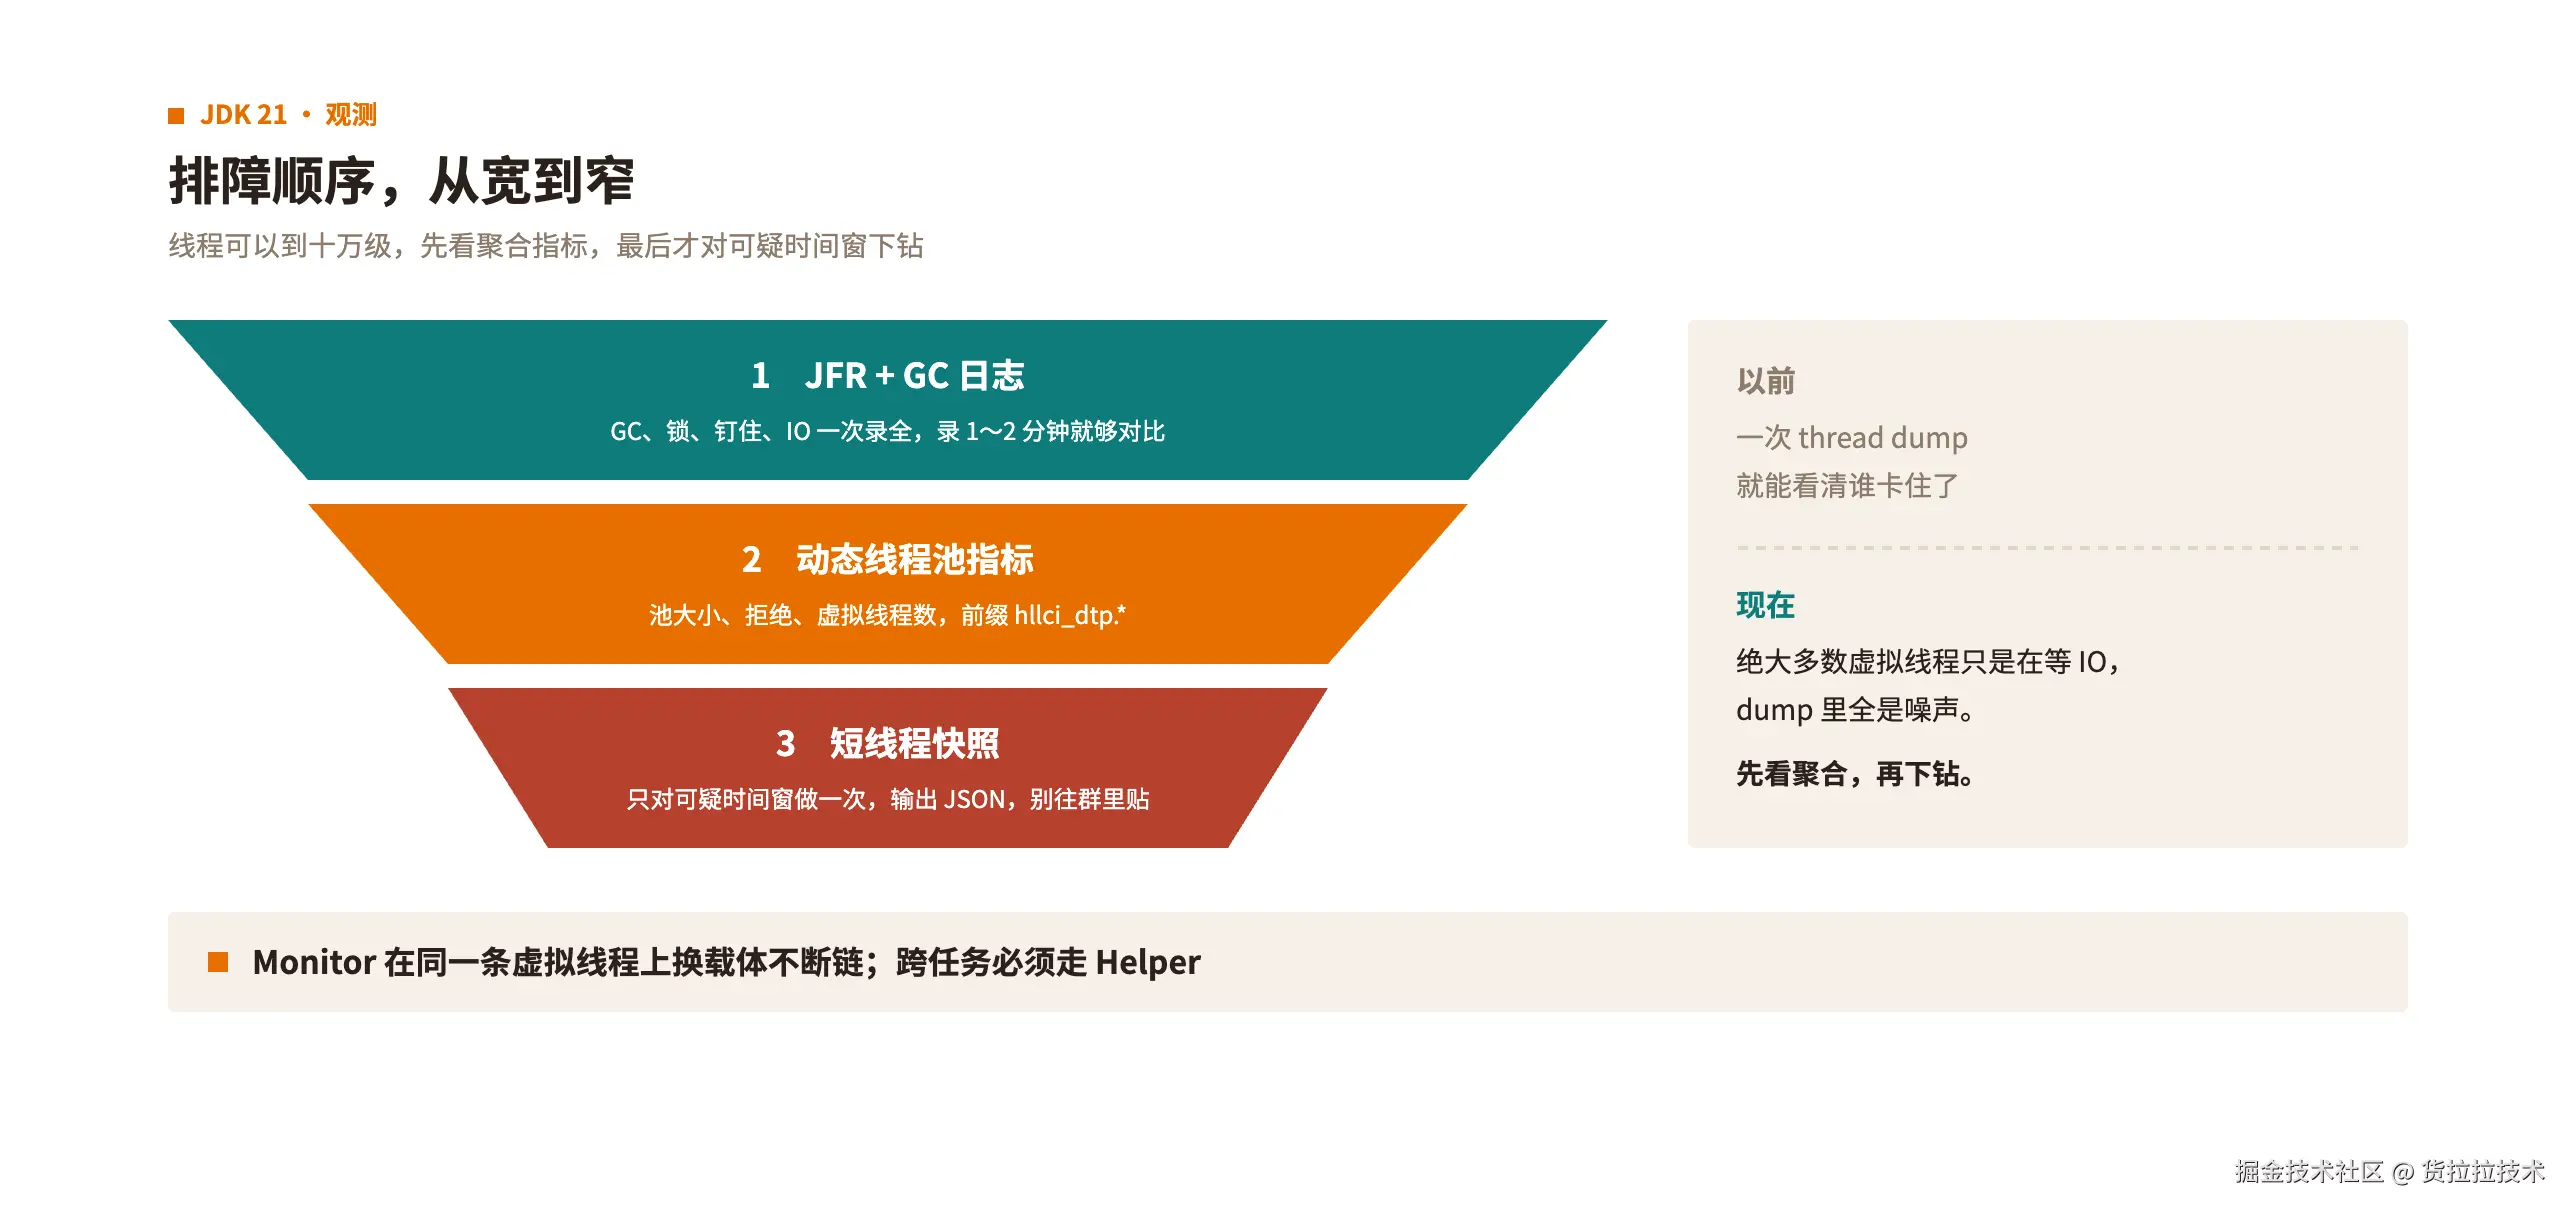
| 手段 | 看什么 | 怎么用 |
|---|---|---|
| GC 日志 | 停顿、老年代占用、分配快慢 | 发布后对比 30 分钟;ZGC 重点看分配是否卡住,而不是停顿时间 |
| JFR | GC、锁、虚拟线程被钉住、IO | jcmd <pid> JFR.start name=onboarding settings=profile dumponexit=true |
| 钉住跟踪 | 虚拟线程在 synchronized 里做 IO | -Djdk.tracePinnedThreads=short |
| 线程快照 | 载体线程和少量业务栈 | jcmd <pid> Thread.dump_to_file -format=json /tmp/threads.json,别往群里贴几十万行 |
| 动态线程池指标 | 池大小、拒绝、虚拟线程数 | 指标前缀 hllci_dtp.* |
| Monitor | 跨虚拟线程的 Trace | 同一条虚拟线程上换载体,8.x 也不断链;跨任务必须走 Helper。 |
上线后先做一次对照,光看进程活着不够:
-
只切 JDK 21、没开虚拟线程时:GC 停顿和容器内存是否比 JDK 8 更稳
-
打开虚拟线程后:Trace 不断链、钉住次数趋近于零、阻塞 IO 的慢请求不回退
-
JFR 录 1~2 分钟做对比,比反复 dump 更适合看锁和 IO 热点
六、未来展望
升级完成后,下面几项还会继续演进:
| 方向 | 现在 | 接下来 |
|---|---|---|
| 并发模型 | 虚拟线程按场景打开,跨任务靠 Helper 传递 Trace 和上下文 | IO 密集链路默认走虚拟线程,框架在任务提交处统一接住 Trace 和 ThreadLocal |
| 锁与钉住 | 热路径把 synchronized 换成 ReentrantLock,上线初期用钉住跟踪把关 | JDK 24 起 synchronized 不再钉住载体线程(JEP 491),升到下一个 LTS(JDK 25)后,新代码不必再刻意避开 synchronized |
| GC | 默认 G1,大堆服务单独评估分代 ZGC | 分代 ZGC 覆盖更多大堆、低延迟服务,G1 仍是多数业务的默认 |
| 运行时基线 | 堆百分比、JFR 和线程池指标由各服务参照本文自行配置 | 容器感知的堆百分比写进镜像基线,JFR 与线程池指标写进发布门禁 |
这次踩过的坑、调过的参数,最终都要沉到框架和基础镜像里。下一次运行时升级,业务要做的最好还是只改一行 parent。