📝 摘要 :两台机器隔 13 天各报一次 CPU 告警,查下来是同一条 SQL 的两端。Langfuse dashboard 算 duration 分位数,在 400GB / 6600 万行的 observations 上全表扫,稳定 125MB/s 读盘------正好是 AWS gp3 默认吞吐上限。加 24h 过滤也没用:
traces_view是跨 observations 聚合重建的视图,duration 根本不是列,索引救不了。止血靠一条 kill 语句,根治靠升 v3 把观测数据搬去 ClickHouse。
7 月 1 日,A 机器 CPU 告警,92%。查出来是 Langfuse 容器吃满了。7 月 14 日,B 机器 CPU 告警,97%。查出来是 PostgreSQL 在全表扫。
两台不同的机器、两个不同的进程、隔了整整 13 天------直到把两份现场摆在一起,才发现它们是同一条 SQL 的头和尾。
这篇讲怎么把两个看起来无关的告警拼成一个根因,以及一个更值得记住的教训:行存数据库上跑分位数聚合,加索引是救不回来的。
一、问题现象:两次告警,两台机器
1.1 第一次:应用机 CPU 92%
text
【云监控】主机告警
· 实例:ai-node-A
· 报警规则:CPU.total
· 监控指标:(Agent)cpu.total
· 报警条件:连续满足 3 次,平均值 >= 90%
· 当前值:92.07%
· 持续时间:2 分钟
这台机器上跑着一堆 AI 相关的容器:推理服务、对话服务、Java 后端、Nacos,还有一个 Langfuse(LLM 可观测平台,用来记录 prompt / 回复 / token / 耗时)。
说来惭愧,这已经是 Langfuse 第二次进我的复盘了。上一次是它的 Python SDK 把我坑了------
CallbackHandler每请求 new 一个、内部起线程还不回收,日均涨 445 个线程,最后 load 飙到 150(见 《load 飙到 150 但 CPU 不到 20%:一次 LangFuse 线程泄漏的深度复盘》)。那次是客户端的锅,这次是服务端的。
1.2 第二次:数据库机 CPU 97%
13 天后,另一台机器告警,而且级别更高:
text
【云监控】主机告警
· 实例:ai-node-B
· 报警规则:CPU.total
· 报警条件:连续满足 5 次,平均值 >= 95%
· 当前值:97.62%
· 持续时间:4 分钟
这台是数据库机,跑 PostgreSQL。2 核。
当时的直觉是「又一起独立的 CPU 告警」。后面会看到,这个直觉错得很彻底。
二、第一现场:从 top 一路收敛到容器
2.1 top:一个 Node 进程吃了 91%
text
top - 02:48:46 up 54 days,  4 users,  load average: 1.35, 2.00, 1.92
%Cpu(s): 57.4 us, 10.3 sy,  0.0 ni, 30.8 id,  0.0 wa,  0.0 hi,  1.5 si

  PID USER   PR  NI    VIRT    RES   S  %CPU  %MEM     TIME+  COMMAND
 1327 1001   20   0   24.0g   3.3g   R  91.4  21.6   6d+8h    next-server
 1097 root   20   0 1238716  16152   S  22.3   0.1   23,05    containerd-shim
30861 root   20   0 1597432 170100   S  11.0   1.1   19,37    uvicorn
35592 root   20   0 7811992   1.8g   S   9.6  11.5   3:44.90  java
这里先纠正一个我自己的初判:CPU 榜首 next-server 不是 Python,是 Node.js 。Langfuse 是个 Next.js 应用,跑起来的进程名就叫 next-server。
一个可复用的小习惯:
top里看到不认识的进程名,别急着按语言归类。next-server/uvicorn/java分属三种运行时,猜错一次就会往错误的方向准备排查工具(我差点直接上py-spy)。
⚠️ 这里有个容易看岔的口径问题 :进程那列的 %CPU 是相对单核 的(91.4% ≈ 吃满 0.9 个核),而顶部 %Cpu(s) 那行才是整机 口径。所以「91.4%」和「30.8% id」并不矛盾------这台机器不止一个核。另外这份 top 是事后补抓的(时间戳 02:48),和触发告警的那一刻不是同一时间,别拿两个数字直接对账。
真正说明问题的是「谁排第一」,不是那个百分比。
2.2 docker stats:实锤,顺带一条被低估的线索
top 只告诉你哪个进程,docker stats 才告诉你哪个容器:
text
CONTAINER     NAME                CPU %     MEM USAGE / LIMIT     NET I/O
3b0f250ab10e  ai-chat-service     14.81%    222.4MiB / 15.27GiB   0B / 0B
b337fb63d325  ai-backend          14.26%    1.901GiB / 15.27GiB   0B / 0B
225212d011e1  langfuse            93.29%    3.367GiB / 15.27GiB   940GB / 660GB
5c3f073911ac  py-infer-textcls     0.14%    2.474GiB / 15.27GiB   0B / 0B
b9a0e6f49e36  nacos                0.35%    986.1MiB / 2GiB       5.34GB / 3.72GB
langfuse CPU 93.29% ,和 top 里 next-server 的 91.4% 对得上。凶手确认。
但真正值钱的是最后一列 :Langfuse 的 NET I/O 是 940GB / 660GB------全场唯一网络吞吐上百 GB 的容器,其它要么是 0,要么个位数 GB。
当时我的判断是:Langfuse 靠 HTTP 接收 trace 上报,这么大的流量说明上游在疯狂灌数据,怀疑是重试风暴或者采集率开太大。
这个判断是错的 ,而且错得很有代表性:我看对了「流量主要是进来的」,却想当然地认定「进来的东西 = 上游上报的 trace」------流量的方向和流量的来源,是两个问题。真相要等 13 天后才揭晓。
三、第二现场:数据库侧抓到全文 SQL
13 天后 B 机器告警,这次直接查数据库当前在跑什么。PostgreSQL 排查慢查询的第一命令永远是 pg_stat_activity------零配置、实时、不用提前开任何东西:
bash
docker exec -it postgres psql -U postgres -c "
SELECT pid, now() - query_start AS dur, wait_event, left(query, 40) AS query
FROM pg_stat_activity
WHERE datname='langfuse' AND state='active'
  AND now() - query_start > interval '30 seconds'
ORDER BY dur DESC;"
抓到的东西让人精神一振:
text
  pid   |       dur       |  wait_event  |                  query
--------+-----------------+--------------+------------------------------------------
 772778 | 00:08:59.281651 | DataFileRead | SELECT percentile_disc(0.5) within group
 772801 | 00:08:59.281651 | DataFileRead | SELECT percentile_disc(0.5) within group
 772800 | 00:08:59.281651 | DataFileRead | SELECT percentile_disc(0.5) within group
(3 rows)
SQL 全文(Langfuse dashboard 算「各 trace 的耗时分位数」用的):
sql
SELECT percentile_disc(0.5)  WITHIN GROUP (ORDER BY "duration") AS "percentile50Duration",
       percentile_disc(0.9)  WITHIN GROUP (ORDER BY "duration") AS "percentile90Duration",
       percentile_disc(0.95) WITHIN GROUP (ORDER BY "duration") AS "percentile95Duration",
       percentile_disc(0.99) WITHIN GROUP (ORDER BY "duration") AS "percentile99Duration",
       t."name" AS "traceName"
FROM traces_view t
WHERE t."timestamp" > $1 AND t."timestamp" < $2 AND t."project_id" = $3
GROUP BY t."name"
ORDER BY percentile_disc(0.95) WITHIN GROUP (ORDER BY "duration") DESC NULLS LAST;
三行、三个 pid、同一条 SQL、dur 完全相同------这是一条查询 + 两个并行 worker 。跑了 8 分 59 秒 还没结束,全卡在 DataFileRead(等磁盘)。
再看库有多大:
bash
docker exec -it postgres psql -U postgres -d langfuse -c "
SELECT relname, pg_size_pretty(pg_total_relation_size(relid)) AS size, n_live_tup
FROM pg_stat_user_tables ORDER BY pg_total_relation_size(relid) DESC LIMIT 5;"
text
    relname       |  size  | n_live_tup
------------------+--------+------------
 observations     | 400 GB |   66000000
 traces           |  21 GB |    2800000
 scores           | 144 kB |          0
 api_keys         | 160 kB |          0
observations 400GB、6600 万行。 一个「顺手装的可观测组件」,悄悄攒下了这台机器上最大的一张表。
PostgreSQL 更多排查命令(
\d、pg_stat_*、慢日志开关等)见 《PostgreSQL 常用命令速查:MySQL 用户平滑上手》。
四、拼图合上:两个告警是同一条 SQL 的两端
摊开两次现场,一件事变得很明显:Langfuse 应用在 A 机器,它的 PostgreSQL 在 B 机器。
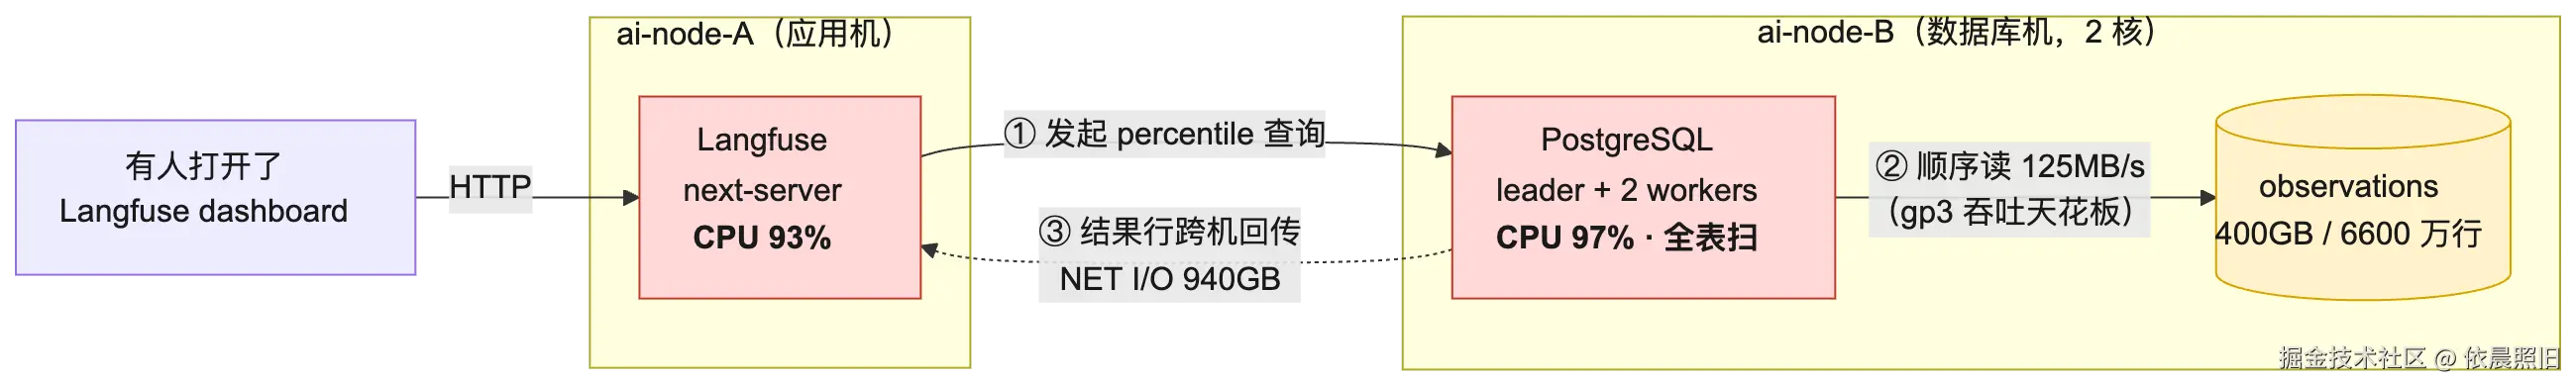
图:Langfuse dashboard 分位数查询的两端------应用机 CPU 93% 与数据库机全表扫,是同一条 SQL 的头和尾
| 告警 | 机器 | 现象 | 它在整条链路里的角色 |
|---|---|---|---|
| 第一次(7/1) | ai-node-A | Langfuse 容器 CPU 93%、NET I/O 940GB | 应用端:发起查询 + 接收结果行 |
| 第二次(7/14) | ai-node-B | PG leader + 2 worker 全表扫、125MB/s | 数据库端:真正执行全表扫 |
回头看第二章那条「被低估的线索」:940GB 的网络流量不是上游灌进来的 trace,是全表扫的结果行从 B 机器传回 A 机器。
先把 NET I/O 的口径说清:它不是合计,是「收 / 发」两个方向------
NET I/O: The amount of data the container has received and sent over its network interface. ------ Docker 官方文档:docker container stats
940GB / 660GB 就是「收 940GB、发 660GB,入站是大头」------这一点我当时没看错。
扎心的是:方向在这里根本救不了我。 「上游疯狂灌 trace」和「查询结果行回传」------这两种猜测都预测入站是大头,940GB 这个数字同时符合两者。我看到入站大,顺手就套上了「Langfuse 靠 HTTP 收 trace」这个先入为主的模型,而它恰好自洽,于是就不查了。
能一刀切开这两种猜测的,只有一个问题:对端是谁。 如果这 940GB 主要来自 PostgreSQL 那个 5432 连接,那它就绝不可能是 trace 上报------ss -tnp 看一眼就完事,13 天的弯路当场省掉。
五、根因分析:三个「本该没事」叠成了事故
事故很少是单一原因。这次是三层,每一层单独看都不致命。
5.1 为什么加了 24h 过滤,还是全表扫?
这是最反直觉、也最值钱的一问。
Dashboard 默认只看近 24 小时,SQL 里明明白白写着 WHERE t."timestamp" > $1 AND t."timestamp" < $2。按常理,只要 timestamp 上有索引,就该走索引范围扫、只读最近一小撮数据。
但它扫了全表。 一开始我列了三种可能:没索引 / 统计信息过时 / 数据量真大。查了 Langfuse 官方文档才发现,真正的答案是第四种,而且加索引根本救不了:
The legacy "traces view" is expensive to query at scale because it must reconstruct trace-level fields by aggregating across all observations belonging to a trace. ------ Langfuse 官方文档:Dashboard Changes in v4
关键在于 FROM traces_view 的这个 traces_view 不是表,是视图 。而排序用的 duration,根本不是 traces 表的列------它得把这条 trace 名下所有 observations 捞出来聚合,才能算出「这条 trace 耗时多久」。
于是链条变成:
text
想算 duration 的分位数
  → 必须先有每条 trace 的 duration
    → 必须把该 trace 名下所有 observations 聚合一遍
      → observations 有 400GB / 6600 万行
        → 时间过滤挡住的是「哪些 trace 参与统计」
          → 挡不住「算 duration 要读多少 observations」
timestamp 索引能帮你少选几行 trace,但省不掉重建 duration 的那次聚合。 这就是为什么「加个索引」在这里是无效解------你要索引的那一列,压根不存在于磁盘上。
再叠上 percentile_disc 本身的性质:它是 ordered-set aggregate(有序集聚合),语义就是「把整组值排好序,取第 N 个位置」。分位数天然需要看到全量数据 ,不像 count / sum 可以边扫边累加、提前结束。四个分位数(P50/P90/P95/P99)还要在同一组上各算一遍。
一句话:这是一个不折不扣的 OLAP 查询,跑在一个 OLTP 数据库上。
5.2 为什么偏偏是 125MB/s?
三个进程合计读盘速率稳定在 125MB/s。这个数字太整了,整到不像巧合。
查了下:AWS gp3 云盘的默认基线吞吐就是 125 MiB/s(默认还有 3000 IOPS),要更高得单独花钱买。
gp3 volumes deliver a consistent baseline throughput performance of 125 MiB/s ... a baseline performance of 3,000 IOPS and 125 MB/s at any volume size. ------ AWS 官方文档:Amazon EBS General Purpose SSD volumes
所以这条查询不是被 CPU 卡住的,是被磁盘吞吐焊死的 。wait_event = DataFileRead 已经写在脸上了。
这个认知直接改变了后续决策:
- ❌ 换台 CPU 更强的机器没用------瓶颈不在 CPU。
- ❌ 加内存也基本没用------400GB 的表,加 8G、16G 缓存都是杯水车薪。
- ✅ 要么提高 gp3 的吞吐配额,要么根本别扫这么多数据。
💡 数字是有指纹的。看到 125MB/s、1Gbps、64KB 这种「过于整齐」的数值卡点,八成不是巧合,而是撞上了某个默认配额上限。把它当成一条线索去查,往往一查一个准。
5.3 为什么并行反而更糟?
PostgreSQL 从 10 开始默认开并行查询,max_parallel_workers_per_gather 默认是 2------也就是一条大查询默认会拉起 1 个 leader + 2 个 worker。
在一台 32 核的机器上,这是好事。在这台 2 核机器上,这是灾难:
| 单进程扫 | leader + 2 worker | |
|---|---|---|
| 占用 CPU | 1 核(还剩 1 核干正事) | 3 个进程抢 2 个核 |
| 磁盘读 | 一路顺序读 | 三路读,在 125MB/s 天花板下互相抢带宽 |
| 查询变快了吗 | --- | 没有,瓶颈是磁盘不是 CPU |
并行扫描的前提是「CPU 有富余、磁盘还没到顶」。这两条这台机器一条都不满足,于是并行只带来了坏处:查询没快,整机却被拖死了------包括同机的其它业务容器。
六、解决方案
6.1 止血:一条命令杀掉所有卡住的慢查询
再次告警时抓到的不止一条,是十几个进程、六类查询在并发全表扫(有人开着 dashboard,多个图表同时加载)。一条条杀来不及:
bash
docker exec -it postgres psql -U postgres -c "
SELECT pid, pg_terminate_backend(pid), left(query,60) AS killed_query
FROM pg_stat_activity
WHERE datname='langfuse' AND state='active'
  AND pid <> pg_backend_pid()
  AND now() - query_start > interval '30 seconds'
  AND query ILIKE 'SELECT%';"
三个安全阀,缺一不可:
| 条件 | 作用 |
|---|---|
datname='langfuse' |
只动这个库,不误伤同实例的其它库 |
pid <> pg_backend_pid() |
不把执行这条命令的自己杀掉 |
query ILIKE 'SELECT%' |
只杀读查询,不碰正在摄取数据的 INSERT |
⚠️ 杀完记得让人把 dashboard 页面关掉。前端会自动重发请求,页面开着就等于有个人在旁边不停帮你把查询重新拉起来------杀完没几分钟又冒出来一批,多半就是这个原因。
杀 leader 时两个 worker 会跟着退,不用单独处理。
6.2 持久化兜底:设一次,以后自动挡
止血是手动的,得让它下次自己挡住:
bash
# ① 关并行全表扫(2 核 + 磁盘已到顶,parallel seq scan 是纯亏)
docker exec -it postgres psql -U postgres -c \
  "ALTER SYSTEM SET max_parallel_workers_per_gather = 0;"

# ② 让 PG 重读配置,不用重启数据库
docker exec -it postgres psql -U postgres -c "SELECT pg_reload_conf();"

# ③ 确认生效
docker exec -it postgres psql -U postgres -c "SHOW max_parallel_workers_per_gather;"

# ④ 只给 langfuse 库挂语句超时,慢查询 90 秒自尽
docker exec -it postgres psql -U postgres -c \
  "ALTER DATABASE langfuse SET statement_timeout = '90s';"
⚠️
statement_timeout千万别设成全局 。同实例其它库可能有正常的长事务(批量导入、维护作业),一刀切会误杀。ALTER DATABASE精确挂到问题库上,代价最小。⚠️ 但
ALTER DATABASE只对「新建立的连接」生效 ------它在建立连接时才被读进 session。Langfuse 用连接池,池里那些老连接会一直用着旧配置,你SHOW出来是 90s,实际卡住的查询照样跑满。设完必须重启一次应用容器(或等池子里的连接自然轮换),否则你会以为兜底生效了,其实一次都没触发过。
6.3 根治:把观测数据搬去列存
止血和兜底都只是「让它慢得没那么伤人」,没解决「用行存数据库跑 OLAP 聚合」这个根本错配。
正好 Langfuse 官方也是这么想的------v3 把 traces / observations / scores 整体搬到了 ClickHouse,PostgreSQL 只留事务和配置数据:
(大意) Langfuse 把 traces、observations、scores 从 Postgres 迁到 ClickHouse,因为无论官方还是自部署用户,在数据量到百万行级别时都在 Postgres 上遇到了瓶颈------摄取和查询两头都卡。 ------ 译自 Langfuse 博客:From Zero to Scale, Langfuse's Infrastructure Evolution
为什么列存能根治,就看这条查询要什么:
| PostgreSQL(行存) | ClickHouse(列存) | |
|---|---|---|
算 duration 分位数要读什么 |
整行所在的数据页------不到约 2KB 的 prompt / 回复内联在行里,跟着一起读 | 只读 duration 一列 |
| 压缩 | 只压超过约 2KB 的大字段(TOAST),普通列不压 | 列内同构,400GB 大概率压到几十 GB |
| 聚合方式 | 逐行处理 | 向量化批量处理 |
| 量级 | 本次:125MB/s 啃 8 分钟还没完 | 同类查询典型:亚秒到几秒 |
差距不是「快一点」,是数量级。 行存要把整头牛拖出来才能称一称牛角有多重;列存直接把牛角单独放在一个筐里。
最终方案定为:不迁旧数据,在独立机器上全新搭一套 v3。理由三条:
- 避开 400GB 迁移------那是最费时、最容易出岔子的一环,而且迁过去还是那么大。
- 旧观测数据本就低价值------它的价值随时间快速衰减,成本却永远累加。重搭等于做了一次隐式 retention。
- 顺便完成物理隔离------Langfuse 全家桶(web / worker / PG / Redis / ClickHouse / MinIO)搬到专用机,再也炸不到 AI 业务。
v3 具体怎么搭、应用怎么切、上线后 ClickHouse 又怎么涨起来的,单独写成了一篇:【待发布后补充引用关系:《Langfuse v3 独立部署:CK 三周涨到 430G,PG 只剩 1G》】。
这里的 ClickHouse 是给 Langfuse 专用的独立实例 ,不是骑到现成的数仓 CK 上。共用会把「Langfuse 拖垮邻居」的老问题原样复制一遍------只是邻居从 AI 服务换成了数仓。真要共用,至少得建独立库 + 用
SETTINGS PROFILE限死内存和线程,做法可参考 《1800 行 INSERT 跑了 16 分钟:ClickHouse 并发洪流踩坑 + 多账号资源隔离方案》。ClickHouse 本身怎么搭见 《ClickHouse 25.4 从裸奔到全副武装》。
七、还没根治之前,retention 是必答题
哪怕不升 v3,周期清理也是必须做的------这是很多人会犹豫的一步,所以把账算清楚:
删了会丢什么? 只会失去「翻旧账」的能力:查不到保留窗口之外的单条 trace、历史趋势只能看窗口内。
删了不会丢什么? 业务数据一条都不少。observations / traces 存的是 prompt、模型回复、token、耗时、成本,是排查和看监控用的副本 ;用户、会话、订单、支付这些真业务数据在别的库里,跟 Langfuse 一点关系没有。用户和产品对这次删除完全无感。
不删会怎样? 表只增不减 → dashboard 越来越慢 → 反复触发 CPU / iowait 告警 → 磁盘迟早写满。成本永远累加,问题只会更严重,不会自愈。
几个实操要点:
- 是「周期删」不是「删一次」 。删一次,三个月后原样长回来,所以要上 cron。⚠️ 别指望升 v3 后用内置的 Data Retention 省事:它在自托管场景下只属于企业版(官方文档),开源版还得自己清。
- 删除有外键顺序 :
scores → observations → traces,反了会报外键约束。 - 删完用
VACUUM,别上VACUUM FULL。VACUUM FULL要锁表 + 需要约 2 倍空间重写,在 400GB 的表上等于二次事故。普通VACUUM不会把空间还给操作系统,但会标记为可复用------对这种持续写入的表足够了,新数据会填回去(PG 为什么删了数据表却不变小,见【待发布后补充引用关系:《MySQL DBA 转 PostgreSQL 的十个认知差:不是语法不同,是模型不同》】差 8)。 - 有合规 / 审计留存要求的,别硬删,导成 Parquet 归档到对象存储,PG 只留热数据。
保留窗口建议 30 ~ 90 天,看你实际往回查多远。
八、举一反三
经验 1:两个告警,可能是一个根因
这次最大的教训不是技术上的,是排查方法上的:我把 7/1 和 7/14 当成两起独立事件,各查各的,中间隔了 13 天。
如果第一次就问一句「这个容器的 940GB 流量,对端是谁」,链路当场就能连起来。
分布式环境下,一个根因产生 N 个告警是常态 。看到告警别急着单点归因,先问三件事:这个组件的上下游是谁 ?告警时间线 对得上吗?流量的对端是谁?
方向是最便宜的线索,也常常是最没用的------对立的几种假设往往共享同一个方向。能证伪的是对端(
ss -tnp、iftop)。
经验 2:这是「OLAP 混进 OLTP」的镜像面
我之前写过一篇 《OLAP 数据库混进 OLTP 链路:一次 ClickHouse 拖死 API 101 分钟的复盘》------那次是把 OLAP 数据库(ClickHouse)塞进了 OLTP 主链路,一个分析库拖垮了在线接口。
这次正好反过来:把 OLAP 查询(分位数聚合)压在了 OLTP 数据库(PostgreSQL)上。
| 上一篇 | 本篇 | |
|---|---|---|
| 错配方向 | OLAP 数据库 进了 OLTP 链路 | OLAP 查询 压在 OLTP 数据库上 |
| 谁被拖垮 | 在线 API(连接池耗尽) | 整台机器(磁盘吞吐打满) |
| 表面症状 | 接口超时 | CPU 告警 |
症状完全不同,病根是同一个:分析型负载和事务型负载没有隔离。 一枚硬币的两面。
所以那条通用原则可以更完整地表述为:要隔离的不是「数据库」,是「负载类型」。 只盯着「别把 CK 接进主链路」是不够的------你在 PG 上写一条 percentile_disc,本质上做的是同一件事。
经验 3:cpu.total 是个会骗人的指标
两次告警都是 cpu.total 触发的,但它们的性质完全不同:A 机器是真的在烧 CPU(Node 进程算数据),B 机器其实是在等磁盘 (DataFileRead)。
cpu.total 把 CPU busy(us + sy) 和 iowait 混成了一个数。看到「CPU 95%」,你的第一反应会是「谁在算」,于是一头扎进 CPU 火焰图------而真相是「谁在等盘」。
建议把 CPU 告警拆成两个指标:us + sy 和 iowait,分别设阈值。 一个指标只回答一个问题,排查方向才不会一开始就被带偏。iowait 高到什么程度会把机器拖进「假死」,见 《一条 bzcat,把线上机器查到假死的复盘》。
经验 4:可观测组件是「隐形的资源大户」
Langfuse 这类组件的装机成本极低------一个 docker run 就完事,通常也不会进架构评审。但它的数据只进不出(第七章),查询又天生是 OLAP(dashboard 全是聚合和分位数),于是几个月后,你的「监控工具」变成了整台机器上最大的表、最重的查询、以及第一个把 CPU 打满的进程。
给一切自带存储的可观测组件配 retention,把它当上线检查项。 装的时候多花 5 分钟,比事后删 400GB 便宜得多。
经验 5:非核心组件必须物理隔离
Langfuse 是 fail-open 的------它挂了,AI 服务照常跑,只是不上报 trace。这么一个「挂了也无所谓」的组件,却有能力把整台机器上的核心服务一起拖死。
这不是第一次了。我还写过一起 SkyWalking 的积压事故------OAP 和 Elasticsearch 挤在同一台机器,把 page cache 抢光了,ES 段合并被迫去读物理盘,磁盘直接打满。详见 《SkyWalking 第三次积压超 3 亿:分片又小又匀,却只有一台机在扛》。症状完全不同(那次抢的是内存),病根一模一样:非核心组件和核心服务混部,没有资源隔离。
抢 CPU、抢 page cache、抢磁盘吞吐------形式各异,结论一致:
可观测 / 中间件类组件独立部署,或至少用 cgroup 限死资源(
docker update --cpus=2)。 判断标准很简单:如果这个组件挂了业务不受影响,那它就更没有资格把业务拖挂。
九、延伸阅读
同一个 Langfuse
- 【待发布后补充引用关系:《Langfuse v3 独立部署:CK 三周涨到 430G,PG 只剩 1G》】 ------ 本篇第六章的根治方案落地:compose、切换顺序、上线后的磁盘账
- 《load 飙到 150 但 CPU 不到 20%:一次 LangFuse 线程泄漏的深度复盘》 ------ 那次是客户端 SDK 的锅,本篇是服务端存储的锅
同一个病根,不同的现场
- 《OLAP 数据库混进 OLTP 链路:一次 ClickHouse 拖死 API 101 分钟的复盘》 ------ 本篇的镜像面,见经验 2
- 《SkyWalking 第三次积压超 3 亿:分片又小又匀,却只有一台机在扛》 ------ 同机混部抢资源的另一起(那次抢的是 page cache)
- 《DolphinScheduler 任务实例 Host 为空?一次内存保护机制引发的调度罢工》 ------ 还是混部(那次抢的是内存,调度器自己触发保护、拒绝接单)
工具与底座
- 《PostgreSQL 常用命令速查:MySQL 用户平滑上手》 ------
pg_stat_activity等排查命令速查 - 《ClickHouse 25.4 从裸奔到全副武装:Docker 部署 + Prometheus 监控告警 + Grafana 看板一条龙》 ------ v3 要用的 CK 怎么搭
- 《1800 行 INSERT 跑了 16 分钟:ClickHouse 并发洪流踩坑 + 多账号资源隔离方案》 ------ CK 上怎么做资源隔离
官方文档
- Langfuse:Dashboard Changes in v4 ------
traces_view为什么贵 - Langfuse:From Zero to Scale, Infrastructure Evolution ------ v3 为什么搬 ClickHouse
- PostgreSQL:Aggregate Functions ------ ordered-set aggregate 与
percentile_disc - AWS:Amazon EBS General Purpose SSD volumes ------ gp3 的 125 MiB/s 基线吞吐