上一篇:《WASM 不是银弹:一棵百万节点 Vue 树的边界账本与虚拟滚动动画》 算的是边界账:MPTT 把一棵树变成了一段区间,虚拟滚动只渲染视口。但那只解决了"读"。真正难写的是"写"------新增一个节点、删除一棵子树、导入 10 万行数据。这篇文章拆开
appendChild/removeSubtree/beginStructureBatch,讲清楚三件事:为什么同一个插入操作有时 O(1)、有时 O(N);为什么"批量"能把 100 次操作从 675ms 压到 6ms;以及一个我在写这篇文章时用探针复现出来的顶层追加边界问题。
0. 三个写操作
如果你的树只读,MPTT 很舒服:区间查子树、单遍算可见性、O(1) 算总高度。但后台系统里的树总要写:
- 新增节点:用户点"新建",挂在某个父节点下,或者直接挂在根上。
- 删除子树:删掉一个部门,它的所有下级一起消失。
- 批量导入 / 同步:一次接口拉回 10 万行,或者拖拽调整层级。
这三个操作分别对应三种成本:边界重编号、数组移动、派生状态重建。把它们混在一起谈"O(1)/O(N)"没有意义------同一个 appendChild,在事务外是 O(N),在事务内是 O(1)。
先给结论表(N = 全树节点数,k = 被操作的子树大小,d = 深度):
| 操作 | 边界重编号 | 数组移动 | 派生状态同步 | 事务内单次 |
|---|---|---|---|---|
| 顶层追加 | O(1) | 均摊 O(1) | O(N) | O(1) |
| 中间插入 | O(N) | O(N) | O(N) | O(N) |
| 删除子树 | O(N) | O(N) | O(N) | O(N) |
| 修改 name/disabled | 无 | 无 | O(1) / O(N) | --- |
这张表里最关键的一列是"事务内单次":它告诉你哪些成本是结构本身固有的,哪些只是同步策略造成的。这个项目里 100 次顶层追加,逐次调用 675ms,放进一个事务 6ms,差了 111 倍------差别不在 MPTT,而在每次操作后都重建了一遍派生索引。
1. MPTT 的编号约定
先把编号说清楚,否则后面的 ±2 和 +1 都是玄学。
项目里的编号不是教科书里常见的 [left, right] 闭区间加 1 递增,而是每个节点占两个编号 :进入时分配 leftNode,子树处理完后把当前游标写进 rightNode。核心循环在 assembly/tree-builder.ts:
ts
mptt.leftNode = next
next++
stack.push(mptt)
// ...处理子节点...
const completed = stack.pop()
completed.rightNode = next
next = completed.rightNode + 1
这带来几个直接推论:
- 叶子节点的
rightNode - leftNode === 1; - 节点的后代数 =
(rightNode - leftNode - 1) / 2; - 判断
X是否在P的子树里:X.leftNode >= P.leftNode && X.rightNode <= P.rightNode; - 按
leftNode升序排列,就是前序序列,子树在数组里是连续的一段。
举个实测例子。输入邻接表 A → B、D → E,两个顶层节点都挂在虚拟根 root 下,编号结果是:
text
A[0,3] B[1,2] D[4,7] E[5,6]A[0,3] 占住 0 和 3,B[1,2] 占住 1 和 2;D[4,7] 与 E[5,6] 同理。注意 A 和 D 之间没有空隙:A.rightNode = 3,下一个顶层节点从 4 开始。
把上面的编号画成图,就是一棵"每个节点占两个时间戳"的树:
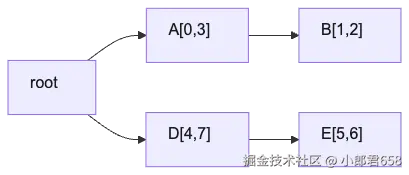
前序序列 A[0,3] → B[1,2] → D[4,7] → E[5,6] 与数组顺序一致,任意子树都对应一段连续区间。
如果只记一句话:MPTT 的编号是"进入/离开"两个时间戳,不是"第几个节点"。 所有增删改都在维护这两个时间戳的相对顺序。
2. 插入:为什么有时 O(1)、有时 O(N)
2.1 顶层追加:本可以 O(1)
把新节点挂在 root 下,前序序列上它排在整棵树的最后。既然它不插到任何现有区间中间,就不需要给谁让位(节选):
ts
let insertIndex = this.fullTree.length
let left = this.fullTree.length > 0
  ? this.fullTree[this.fullTree.length - 1].rightNode
  : 1
let needsShift = false

if (parentId !== this.root) {
  // 中间插入:计算插入点、左边界和深度,见 2.2
  needsShift = true
}

if (needsShift) {
  for (let i = 0; i < this.fullTree.length; i++) {
    const node = this.fullTree[i]
    if (node.leftNode >= left) node.leftNode += 2
    if (node.rightNode >= left) node.rightNode += 2
  }
}

const node = new MpttTree()
node.leftNode = left
node.rightNode = left + 1
this.fullTree.push(node)逻辑很直白:needsShift 为假时,只做一次 push,不碰任何已有节点的边界。复杂度 O(1)。
但这是"边界重编号"的 O(1),不是整个 appendChild 的 O(1)。 函数最后一行是 this._finishStructureMutation(),事务外它会触发 _syncAfterStructureMutation():重排 fullIndex、重建可见数组、compactStore.load()、重算勾选聚合......全是 O(N)。100k 节点实测,单次顶层追加 P50 约 6.9ms ,而事务内单项只要 0.007ms------差了近 1000 倍,成本几乎全在同步。
2.2 中间插入:为什么要整体平移
把新节点挂到父节点 P 下时,前序序列上它应该出现在 P 之后、P 现有子节点之前(或者按业务约定放在最后)。无论放哪,都需要在 P 的区间内部挤进两个编号。
项目的做法是插在父节点的闭合边界:
ts
if (parentId !== this.root) {
  const parent = this.fullTree[parentIndex]
  // 找到父节点之后的第一个位置
  insertIndex = parentIndex + 1
  while (
    insertIndex < this.fullTree.length &&
    this.fullTree[insertIndex].leftNode < parent.rightNode
  )
    insertIndex++
  // 新节点占用父节点原来的闭合位置
  left = parent.rightNode
  depth = parent.deep + 1
  needsShift = true
}
然后对所有 leftNode >= left 或 rightNode >= left 的节点 +2。这一步是 O(N) 扫描;fullTree 的数组插入还要 memmove,也是 O(N)。
为什么不能像顶层追加那样只改局部?因为 MPTT 的编号是全局坐标 。你在 A 的区间里插两个数,A 之后所有节点的编号都必须顺延,否则 D[4,7] 会和被挤大的 A 重叠。这是嵌套集模型的固有代价------它用"读得快"换"写得贵"。
用图看更清楚:在 A 的区间里挤进两个编号后,A 之后的所有节点都要整体右移 2 格。
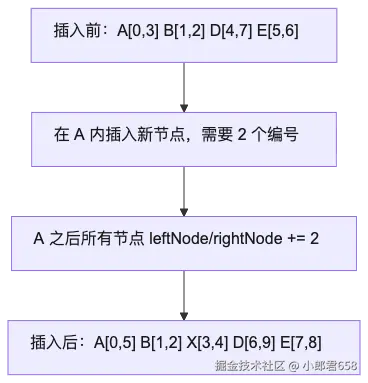
这就是中间插入无法做到 O(1) 的根本原因:编号是全局坐标,局部插入必然引发全局平移。
实测 100k 节点,单次中间插入 P50 约 15.4ms ;事务内单项约 0.604ms。事务内仍然比顶层追加慢两个数量级,因为 O(N) 平移没法摊掉。
2.3 一个真实踩坑:顶层追加的 1 格偏移
我在准备这篇文章的例子时,用探针跑了一个最小用例:
text
初始:  A[0,3]  B[1,2]  D[4,7]  E[5,6]
appendChild(F, parentId = root)
结果:  A[0,3]  B[1,2]  D[4,7]  E[5,6]  F[6,7]
F 是 root 的子节点,编号却落在了 D[4,7] 的区间里。后果不是"看起来不对",而是范围查询直接把 F 当成 D 的后代:
text
getSubtreeIds('D') → ['D', 'E', 'F']原因就在 2.1 的代码:left 取的是前序数组最后一个节点 的 rightNode。最后节点是 E,E.rightNode = 6,但整棵树的最大边界是 D.rightNode = 7。正确取值应该是"最后一个顶层节点的 rightNode + 1",即 8:
ts
// 修复方向(示意)
let lastTop = -1
for (let i = this.fullTree.length - 1; i >= 0; i--) {
  if (this.fullTree[i].parentId === this.root) {
    lastTop = i
    break
  }
}
let left = lastTop >= 0 ? this.fullTree[lastTop].rightNode + 1 : 1
这个例子说明一件事:MPTT 的增删改必须配边界不变量的测试 。只测"新节点在不在数组里"是不够的,要断言任意两个节点的区间要么包含、要么不相交,以及 getSubtreeIds 的结果与父子关系一致。项目现有的 CRUD 测试覆盖了中间插入和删除,但顶层追加恰好没有用例,于是这个偏移活了下来。
读者如果在自己的实现里抄了"
left = last.rightNode",建议立刻补一个顶层追加的区间断言,别等范围查询把新节点算进别人的子树。
3. 删除:用区间切掉一整段
删除比插入简单,因为不需要"挤进两个编号",只需要"抹掉一段"。
ts
const target = this.fullTree[index]
const right = target.rightNode
const width = target.rightNode - target.leftNode + 1

let end = index
while (end < this.fullTree.length && this.fullTree[end].leftNode < right)
  end++

for (let i = index; i < end; i++) this.idToIndex.delete(this.fullTree[i].id)
this.fullTree.splice(index, end - index)

for (let i = 0; i < this.fullTree.length; i++) {
  const node = this.fullTree[i]
  if (node.leftNode > right) node.leftNode -= width
  if (node.rightNode > right) node.rightNode -= width
}
三个细节:
width是闭区间宽度 。叶子占left和right两个编号,所以删一个叶子要回收 2 个槽位,不是 1 个。- 后代在数组里连续 。
leftNode < right就是"在目标子树内",所以一个while就能找到整段,不需要递归。 idToIndex局部重映射 。删除区间内的条目直接delete,区间之后的条目索引整体前移,重新set一遍。这一步是 O(N),但比"重建整张 Map"少一次哈希分配。
删除本身是 O(子树大小 + N),其中 N 来自边界平移和索引重映射。100k 节点实测,删一个叶子 P50 约 7ms ,删一棵 121 节点的子树约 6--15ms。又是"同步占大头"。
删除的流程可以概括为"定位区间 → 切掉连续段 → 平移后续边界":
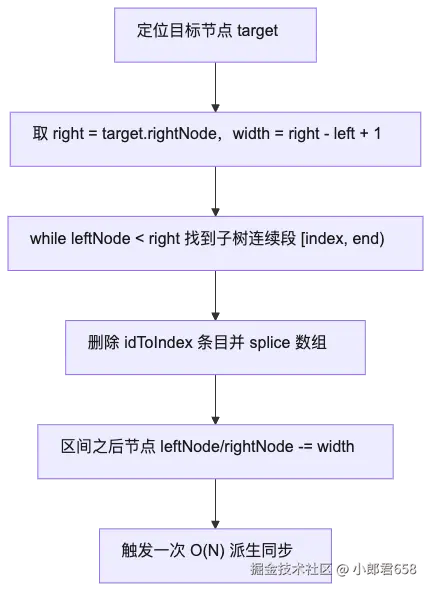
4. 批量事务:把 O(N) 的同步摊掉
4.1 一个批次,一次同步
beginStructureBatch / endStructureBatch 的实现很朴素:
ts
beginStructureBatch(): void {
  if (this._structureBatchDepth === 0) this._materializeLazyCheckboxRanges()
  this._structureBatchDepth++
}

endStructureBatch(): void {
  if (this._structureBatchDepth <= 0) return
  this._structureBatchDepth--
  if (this._structureBatchDepth === 0 && this._structureDirty) {
    this._structureDirty = false
    this._syncAfterStructureMutation()
  }
}
批次内每次 appendChild 仍然会改 fullTree 和 idToIndex,但 _finishStructureMutation() 只把 _structureDirty 置真,不同步派生状态。于是:
批量事务的核心就是"把 N 次同步合并成 1 次":
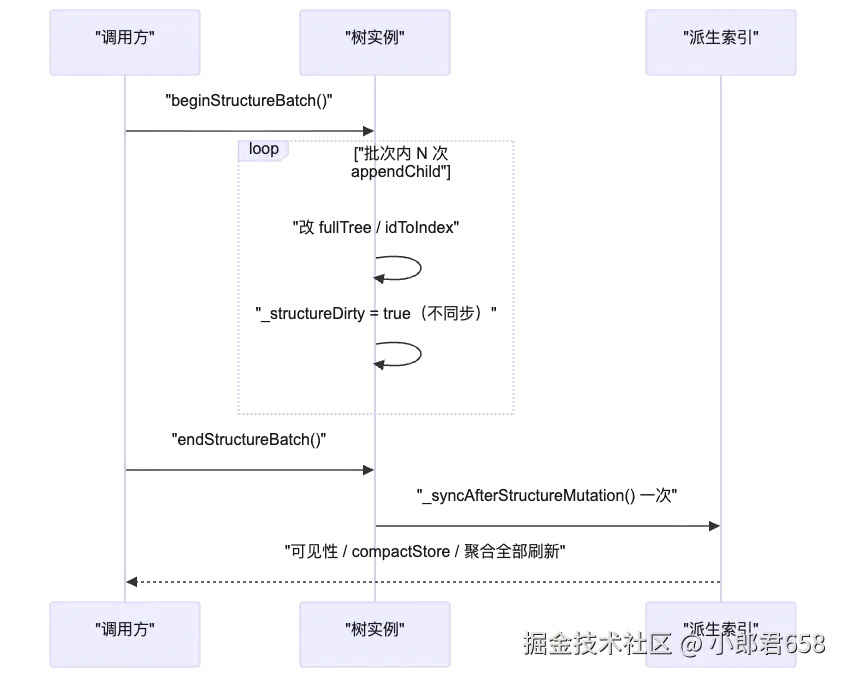
- 100 次顶层追加:逐次 675 ms ,批量 6.08 ms ,约 111×;
- 批量内每次顶层追加:0.0071 ms;
- 批量内每次中间追加:0.604 ms(O(N) 平移仍在)。
4.2 批次内 compactStore 是故意过期的
这里有一个容易忽略的设计:批次内 compactStore 不更新。appendChild 找插入位置时不能用 compactStore.left/right,只能用 fullTree 上的 MPTT 边界:
ts
// compactStore is intentionally stale inside a structure batch. Find the
// preorder end from MPTT boundaries so a child added earlier in this
// transaction can itself receive children.
insertIndex = parentIndex + 1
while (
  insertIndex < this.fullTree.length &&
  this.fullTree[insertIndex].leftNode < parent.rightNode
)
  insertIndex++
这条注释解决了一个真实需求:批量导入时经常是"先建父、再建子",而父节点可能是本批次刚创建的。只要 fullTree 的边界是新的,就能继续往下挂;compact 数组等批次结束再一次性重建。
4.3 一次同步到底做了什么
_syncAfterStructureMutation() 是整个写路径的核心,按顺序做六件事:
- 重排
fullIndex(fullTree[i].fullIndex = i); - 清空
searchTree、失效搜索候选索引; - 用
resetShownFlagsAndCollect单遍 重建可见性,同时收集shownNodes; compactStore.load(fullTree)单遍重建全部紧凑数组和索引;- CHECKBOX 模式:
recomputeAggregates从后往前重算所有分支;RADIO/SELECT 模式:只重新定位那一个选中节点; - 搜索态:用原关键词重建
searchTree。
这六步的顺序与依赖关系如下:
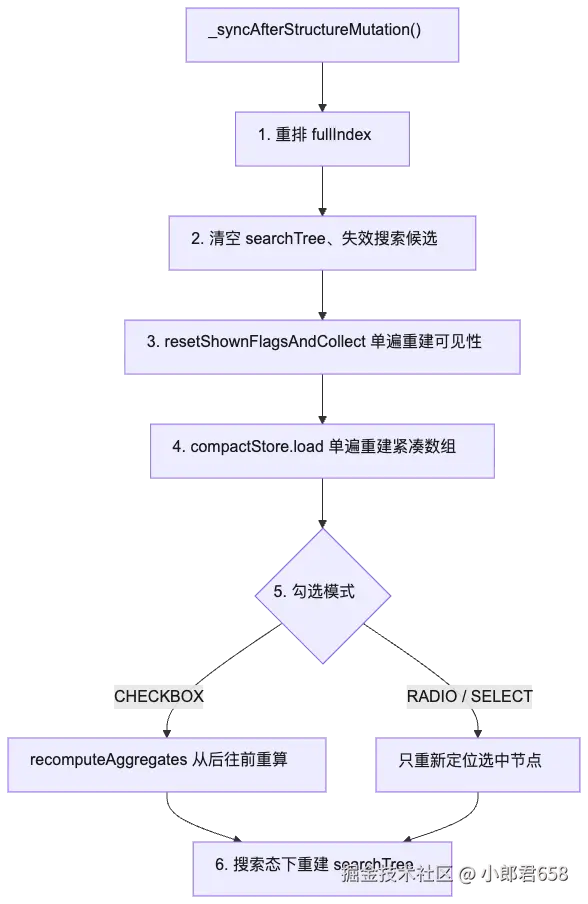
其中第 3、4 步值得单独看,因为它们决定了"一次同步"为什么能压到毫秒级。
可见性单遍:用一个栈记录"折叠祖先的右边界"。遇到超出边界的节点就弹栈;栈空则可见。没有递归,没有二次扫描:
ts
const collapsedBoundaries: i32[] = []
for (let i = 0; i < fullTree.length; i++) {
  const node = fullTree[i]
  while (
    collapsedBoundaries.length > 0 &&
    node.leftNode >= collapsedBoundaries[collapsedBoundaries.length - 1]
  )
    collapsedBoundaries.pop()
  if (collapsedBoundaries.length === 0) {
    node.shown = true
    shownNodes.push(node)
    if (node.collapsed && node.rightNode - node.leftNode > 1)
      collapsedBoundaries.push(node.rightNode)
  }
}
紧凑存储单遍 :compactStore.load() 在写数值的同时,用两个栈顺便建立 parent、subtreeEnd、disabledPrefix 和三组子节点计数。它不需要再遍历一次树(为可读性,下面的指针读写简化为 rightOf / depthOf):
ts
// 按 MPTT 边界完成子树 → subtreeEnd
while (open.length > 0 &&
       rightOf(open[open.length - 1]) <= node.leftNode)
  subtreeEnd[open.pop()] = i

// 按深度找父节点 → parent + 子节点计数
while (stack.length > 0 && depthOf(stack[stack.length - 1]) >= node.deep)
  stack.pop()
if (stack.length > 0) {
  const parentIndex = stack[stack.length - 1]
  parent[i] = parentIndex
  if (disabled === 0) {
    childTotal[parentIndex]++
    if (checked === 2) childChecked[parentIndex]++
    else if (checked === 1) childHalf[parentIndex]++
  }
}
第 5 步的 recomputeAggregates 从数组尾部向前走:子节点一定在父节点之后(前序),所以"从后往前"天然是自底向上。每个分支只读三个计数,不递归:
ts
for (let i = this.checked.length - 1; i >= 0; i--) {
  if (childTotal[i] === 0) continue
  const previous = checked[i]
  const next = aggregateStateAt(childChecked, childTotal, childHalf, i)
  checked[i] = next
  tree[i].checked = next
  updateChildStateAt(childChecked, childHalf, parent[i], previous, next)
}
5. 修改内容:不是所有写都值得走结构路径
updateNodeName 和 updateNodeDisabled 是两条不同的路径:
- 改名字 :只写
fullTree[index].name,失效搜索候选和 JSON 缓存,O(1); - 改禁用 :要更新
disabledPrefix(从index+1到末尾整体加减,O(N))、父节点的childTotal(O(1)),再沿祖先链重算勾选聚合(O(depth))。
disabledPrefix 的更新是 O(N) 的,因为它是前缀和数组,改一个点会影响后面所有项。项目选择了"写时 O(N)、查时 O(1)"的取舍:查询子树里有没有禁用节点只差两个前缀和,而禁用状态变更远少于勾选操作。
如果禁用变更也是高频写入,这个取舍就要反过来------改用 Fenwick 树把单点更新降到 O(log N),代价是查询也变成 O(log N)。没有免费的索引,只有把成本放到哪一侧。
6. 什么时候不该用 MPTT
MPTT(嵌套集)适合"读多写少、层级深、经常查子树"的场景。以下情况应该换模型:
| 场景 | 更合适的结构 | 原因 |
|---|---|---|
| 频繁在中间插入/移动节点 | 邻接表 + 递归 CTE / 闭包表 | MPTT 每次中间插入 O(N) 重编号 |
| 多写少读 | 邻接表 | 写入只改一行 |
| 需要并发写 | 邻接表 / 物化路径 | 全局编号天然排斥并发 |
| 层级极深(>10^9) | 物化路径 / 闭包表 | i32 编号会溢出 |
| 只查直接子节点 | 邻接表 + 索引 | 不需要区间 |
这个项目选 MPTT,是因为目标场景是"百万节点、读多写少、频繁算可见性和子树"。如果你的业务是"拖拽排序 + 实时协作",MPTT 的写放大大概率会先把你拖垮。
7. 实测与口径
环境 :macOS arm64,Node v26.7.0,AssemblyScript release 构建(build/release.wasm),2026-10-22。树为 100,000 节点宽树(每个父节点 10 个子节点),lineHeight = 26,单进程,预热后 15 轮采样取 P50/P95。不同机器、不同 asc 版本不可直接横向比较。
| 操作 | P50 | P95 | 说明 |
|---|---|---|---|
| 单次顶层追加 | 6.88ms | 11.86ms | 含一次 O(N) 派生同步 |
| 单次中间插入 | 15.41ms | 16.58ms | 含 O(N) 平移 + 同步 |
| 单次删除叶子 | 6.96ms | 18.79ms | 含 O(N) 边界回收 + 同步 |
| 删除 121 节点子树 | 6.24--15.52ms | --- | 3 轮样本 |
| 事务内顶层追加 | 0.0071ms/次 | --- | 1000 次/批,3 轮 |
| 事务内中间插入 | 0.604ms/次 | --- | 200 次/批,3 轮 |
| 100 次顶层追加(逐次) | 675.29ms | --- | 5 轮 |
| 100 次顶层追加(事务) | 6.08ms | --- | 5 轮,约 111× |
复现命令(仓库内已有基准脚本,本文的 CRUD 探针可按同样方式构造):
bash
pnpm run asbuild:release
node --expose-gc scripts/benchmark-capacity.mjs 100000
8. 决策表
| 你的情况 | 建议 |
|---|---|
| 批量导入 / 接口同步 | 必须用 beginStructureBatch / endStructureBatch,否则每行一次 O(N) |
| 单个新增、删除 | 接受一次 O(N) 同步;如果卡顿,考虑把 UI 操作也包进事务,再统一刷新 |
| 拖拽排序、频繁移动 | 不要用 MPTT;换邻接表或物化路径 |
| 顶层追加 | 确认 left 取的是"最后一个顶层节点的右边界 + 1",并补区间断言 |
| 删除子树 | 用 leftNode < right 切连续段,别递归;记得 width 是闭区间宽度 |
| 改 disabled | 接受前缀和 O(N) 更新;如果高频,改 Fenwick |
| 测试 | 不只测"节点存在",要测区间不变量:任意两节点区间要么包含、要么不相交 |
9. 写在最后
MPTT 的增删改没有魔法,只有三笔账:
- 边界账:插入/删除要维护全局编号,中间操作天然 O(N);
- 移动账:数组插入/删除要 memmove,也是 O(N);
- 同步账:每次结构变更后派生索引要重建,这一笔最容易被忽略,也最容易被批量事务摊掉。
把这三笔账分开算,你就不会问"为什么我的 MPTT 插入是 O(N)"------它当然是;你该问的是"我能不能把 N 次插入合并成一次同步"。
下一篇:《复选框的半选状态:从递归到计数器,再到区间覆盖》。从"递归扫子树"到"三组计数器",再到"区间覆盖 + 按需物化",以及为什么 RootOnly 输出能把 1.2 秒压到 14 毫秒。
项目:vue3-giant-tree-wasm(Vue 3 + AssemblyScript/WASM,BSD-2-Clause)。本文代码来自 assembly/giant-tree.ts、assembly/tree-builder.ts、assembly/tree-visibility.ts、assembly/compact-store.ts,为便于阅读做了节选和简化。
项目地址:github.com/jktantan/vu... 在线文档与演示:jktantan.github.io/vue3-giant-... npm:vue3-giant-tree-wasm