两阶段协议
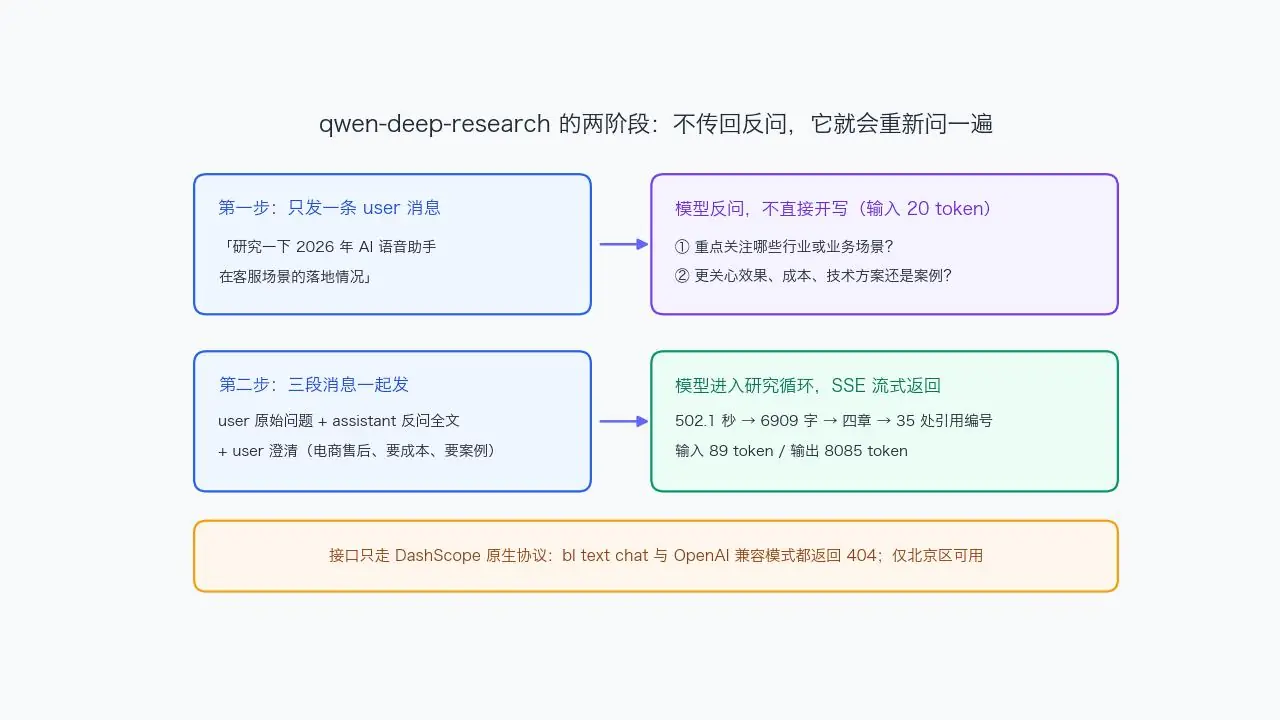
qwen-deep-research 不是一个普通的 chat 模型。它要求两阶段调用:
- 第一步只发用户问题,模型返回澄清式反问
- 第二步把「用户问题 + assistant 反问 + 用户澄清」一起发,模型才进入研究
第二步必须带第一步的 assistant 回复,否则模型会重新问一遍。这个设计解决的是「问题太泛,报告只能写成综述」的老毛病。
接口只支持 DashScope 原生协议:
bash
POST https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1/services/aigc/text-generation/generation
X-DashScope-SSE: enable
Authorization: Bearer <北京区 API Key>
OpenAI 兼容模式不可用。bl text chat 直接返回:
go
HTTP 404 Unsupported model `qwen-deep-research` for OpenAI compatibility mode.地域仅华北 2(北京),1M 上下文。
第一步:反问
请求体只有一条 user 消息:
json
{
  "model": "qwen-deep-research",
  "input": {
    "messages": [
      { "role": "user", "content": "研究一下 2026 年 AI 语音助手在客服场景的落地情况" }
    ]
  }
}
实测返回:
markdown
1. 您希望重点关注哪些具体行业或业务类型的客服场景(例如电商、售后、金融咨询、运营商等)?
2. 您更关心落地效果、成本、技术方案还是行业案例?
输入 20 token,首字约 2.8 秒(含连接与首包)。
第二步:研究
把三段消息一起发:
json
{
  "model": "qwen-deep-research",
  "input": {
    "messages": [
      { "role": "user", "content": "研究一下 2026 年 AI 语音助手在客服场景的落地情况" },
      { "role": "assistant", "content": "1. 您希望重点关注哪些具体行业或业务类型的客服场景......" },
      { "role": "user", "content": "重点看电商售后场景,关心成本(每分钟通话多少钱)和真实落地案例,不要泛泛的技术综述" }
    ]
  },
  "parameters": {
    "output_format": "model_summary_report"
  }
}
output_format 两个取值:model_detailed_report(默认,官方说约 6000 token)和 model_summary_report(官方说 1500 到 2000 token)。
实测用 summary 版:502.1 秒,6909 字符,output 8085 token。比官方描述长得多,选型时不要按字数做硬约束。
SSE 解析
响应是 SSE,每行形如:
vbnet
id:1
event:result
:HTTP_STATUS/200
data:{"output":{"message":{"phase":"answer","role":"assistant","content":"1","status":"typing"},"finished":false},"usage":{"input_tokens":20,"output_tokens":1},"request_id":"..."}
拼接 data 里的 output.message.content 就是正文。判断结束看 output.finished 或 finish_reason。
两个细节:
usage是累计值,不是增量,别累加- 正文里会混入
<think>...</think>段,收完要清洗
报告结构
实测报告:
shell
# 2026年电商售后AI语音助手落地成本、真实案例与选型避坑指南
## 2026年电商售后AI语音助手成本结构与测算
## 真实落地案例:从理论到实践的价值验证
## 落地挑战与选型策略:合规、技术与成本陷阱
## 市场趋势与未来展望:从降本增效到业务闭环
四章结构是模型自己规划的,不是模板。报告开头先出现一段 <think>,内容是需求拆解、四个研究问题和报告大纲,然后才进入正文。
引用:35 处编号,0 个参考文献
正文里有 35 处 [[数字]] 或 [[数字,数字]] 引用标记。抽样:
断言
引用标记
可追溯性
市场规模 186 亿元,渗透率 63.5%
[[7]]
无来源、无链接
通信线路 0.14 / 0.3 元每分钟
[[14]]
无来源、无链接
三档成本 0.13 / 0.40 / 0.67 元
[[1,4,7,17,24]]
五个编号并列,无法定位
文末没有参考文献列表。引用编号只表示「模型认为这里有来源」,不等于附上了来源。对外使用前必须逐条核,或者只保留能点开链接的数字。
成本
单价:输入 54 元/百万 token,输出 163 元/百万 token。
这一趟
token
单价(元/百万)
金额
我的需求 + 它的两条反问 + 我的一句澄清
89
54
0.0048 元
6909 字报告(含思考过程)
8085
163
1.3179 元
合计
8174
1.32 元
89 个输入 token 大约 60 个汉字,只占 4 厘;钱几乎全花在写字上,折合每千字 0.19 元。
接入清单
- 取北京区 API Key 与 WorkspaceId
- 第一步 POST 只带 user 消息,读回反问
- 第二步带三段消息 +
output_format,SSE 收流 - 清洗
<think>,保存正文与原始输出 - 抽出所有带数字的句子,逐条标「已核 / 未核」
第一步的完整返回
第一步只传一条 user 消息,SSE 流式返回的不是报告,而是一段反问。实测拼出来的完整内容:
markdown
1. 您希望重点关注哪些具体行业或业务类型的客服场景(例如电商、售后、金融咨询、运营商等)?
2. 您更关心落地效果、成本、技术方案还是行业案例?
输入 20 token,首字约 2.8 秒。这个阶段不消耗多少输出 token,成本可以忽略。
第二步的请求结构
第二步的关键是把三步消息按顺序放进去,少一步模型就会重新问:
json
{
  "model": "qwen-deep-research",
  "input": {
    "messages": [
      { "role": "user", "content": "原始问题" },
      { "role": "assistant", "content": "第一步返回的反问全文" },
      { "role": "user", "content": "澄清回答" }
    ]
  },
  "parameters": { "output_format": "model_summary_report" }
}
output_format 两个取值:model_detailed_report 默认,官方说约 6000 token;model_summary_report 官方说 1500 到 2000 token。实测 summary 版出来 6909 字符、8085 token,比官方描述长得多。
SSE 逐行解析
响应长这样:
vbnet
id:1
event:result
:HTTP_STATUS/200
data:{"output":{"message":{"phase":"answer","role":"assistant","content":"1","status":"typing"},"finished":false},"usage":{"input_tokens":20,"output_tokens":1},"request_id":"..."}
四个细节:
- 正文在
output.message.content,逐条拼起来 usage是累计值,不是增量,别累加- 结束看
output.finished或finish_reason phase字段区分阶段,answer是正文
报告结构与引用抽样
正文有一个一级标题、四个二级标题,结构同上。这里只看引用怎么标:
断言
标记
文末来源
市场规模 186 亿元、渗透率 63.5%
[[7]]
无
通信线路 0.14 / 0.3 元每分钟
[[14]]
无
三档成本 0.13 / 0.40 / 0.67 元
[[1,4,7,17,24]]
无
三种产品形态
后台批处理:晚上跑一批报告,第二天早上看。对延迟不敏感,对成本敏感。1.32 元一份,一百份 132 元。
异步任务:用户提交问题,产品显示「正在研究」,8 分钟后通知。适合咨询、投研类产品。
人工协作:模型出底稿,人核数字、补来源、改判断。这是实测后最推荐的形态。
和 RAG、搜索的区别
百炼上「查资料」有三层能力:知识库检索、联网搜索、深度研究。三层解决的不是同一个问题。
知识库检索查你上传的文档,输出相关片段或带引用的回答,适合查内部制度、产品手册、客服话术。它的优势是私有事实,弱点是不会主动扩展问题。
联网搜索查公开网页,输出搜索结果或摘要,适合查最新价格、新闻、政策。它的优势是时效,弱点是不会成文。
深度研究查公开网页加多步推理,输出结构化报告,适合行业扫盲、竞品初稿、方案底稿。它的优势是结构和广度,弱点是引用不可追溯。
三者可以串起来:深度研究出广度,RAG 补私有事实,人做最后判断。注意别把深度研究输出的数字直接当内部事实用。
错误处理与重试
深度研究的错误分三类:
接口类:地域不对、协议不对、模型名不对,直接回 4xx。这次用 bl text chat 调就属于这一类,HTTP 404。
参数类:messages 结构不对、output_format 取值不对,回 400 并带 message。常见错误是第二步漏了 assistant 消息。
生成类:研究过程中上游搜索失败、超时,SSE 会中断。这类错误最麻烦,因为已经消耗了 token,但报告不完整。建议客户端记录已收到的 content,允许从断点重新发起。
重试策略:接口类和参数类不要重试,改请求;生成类可以重试一次,但要接受重复计费。
常见问题
Q:为什么一定要两阶段? A:第一阶段让模型把宽泛问题收敛成可研究的范围。跳过它,报告容易写成综述。
Q:能改成一次调用直接出报告吗? A:可以只发一条 user 消息,但模型仍会先反问,不会直接开写。协议本身就是两阶段。
Q:8 分钟能缩短吗? A:收窄问题、指定摘要版、减少澄清轮次能缩短一些,但研究本身需要多步搜索,压缩空间有限。
Q:能批量跑吗? A:接口层面可以,但要考虑 QPM 限制和单次 8 分钟耗时,建议异步排队。
版本与时效
这篇记录的是 2026-10-19 的实测。两个变量会随时间变:模型的输出长度和引用格式可能随版本调整,接口的兼容范围也可能扩展。
接入前建议先做一次最小验证:发一条宽泛问题,看它是否反问;再发一条带澄清的,看报告结构。两个都符合预期,再按本文的参数接。
边界
- 仅北京区,仅 DashScope 原生协议
- 单次 8 分钟量级,不适合在线低延迟场景
- 引用不可追溯,报告只能当底稿
- 未测详细版与多轮追问
想自己跑一遍:Key 在控制台密钥页签签发(bailian.console.aliyun.com/cn-beijing/... 安装页有官方 skill 包,装好把任务描述发给 Agent 就能调(bailian.console.aliyun.com/cli?spm=a2t...