"小程序 + H5 + App + PC 后台,四个端都要。"
这句话在小项目里出现得特别频繁,而且通常伴随着一个不切实际的预算。一个人接这种活,第一反应就是:哪三端能少写一点。
我做过两个四端项目,形态很像:服务端一套,C 端用 uni-app 编出小程序 + H5 + App,后台单独一套 Web 前端。 回头看,省下时间的从来不是"少写界面"------界面是整件事里最不难的部分。
但真正浪费时间的,从来不是界面。同一个业务规则在四个地方各写一遍,然后慢慢漂移出四个版本 ------ 这才是多端项目里最贵的那部分。
先定一件事:业务逻辑只能有一份
无论选什么技术方案,这条都是前提:业务逻辑写在服务端,端上不做业务判定。
反过来做(逻辑散在各端)会出什么样的问题?最典型的一种:
小程序算出来 88 折,App 算出来 9 折,H5 又不一样。
这种 bug 极难排查 ------ 每个端单看都对,只有对比的时候才看得出。而且不是逻辑写错了,是同一个逻辑被写了三遍,写的时候各差一点。
所以价格、库存扣减、优惠判定、订单状态流转、权限判断,这些一律放在服务端。端上只做三件事:
- 收集输入(用户填了什么、点了什么)
- 展示输出(服务端给了什么就显示什么)
- 调用平台能力(支付、登录、分享、推送)
三条路线,和它们的取舍
路线一:一套代码跨端(uni-app 这类)
写一份,编出小程序 + H5 + App。
- 优点:开发速度最快,一套逻辑三端复用;改一处三端都改
- 缺点:平台能力深度受限;性能不如原生;遇到平台差异仍然要写条件分支
- 适合:交互以表单、列表、详情为主,没有重度动画或设备调用的业务
路线二:各端原生,只共用 API
每端用自己最合适的技术写,服务端统一。
- 优点:体验和平台能力最好
- 缺点:有多少端就有多少份界面工作量,且每端的迭代都要单独排期
- 适合:对体验或设备能力有硬要求的场景
路线三:混合 ------ 主体跨端,关键页面原生
大部分页面走跨端方案,只有少数关键页面(例如需要高性能或深度调用设备的)单独实现。
- 优点:把"省时间"和"体验"分配到不同的页面上去
- 缺点:架构多一层,团队要能接受这种不一致
一个人做项目,路线一通常是默认答案 ------ 但前提是先确认平台能力的硬约束。比如支付、登录、分享、推送这几项,每个平台的实现方式都不一样,这些是一定要单独写的,不会因为你用了跨端框架就省掉。
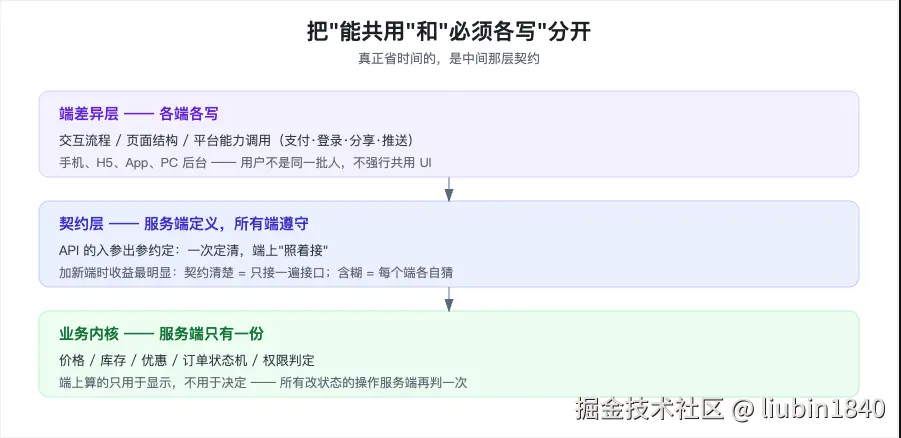
分层:把"能共用"和"必须各写"分开
我的分法是这样三层:
| 层 | 内容 | 是否共用 |
|---|---|---|
| 业务内核 | 价格、库存、优惠、状态机、权限 | 服务端一份 |
| 契约层 | API 的入参出参约定 | 服务端定义,所有端遵守 |
| 端差异层 | 交互流程、页面结构、平台能力调用 | 各端各写 |
中间那一层最容易被忽略,但它其实是省时间的真正来源。接口约定定清楚之后,端上只需要"照着接";约定含糊,每个端就会各自猜,猜出来的三份都不一样。
实际操作里,契约层的收益在加端的时候最明显:加一个新端,如果契约清楚,只是"接一遍接口";如果契约不清楚,就要重新读服务端代码,把业务逻辑再理解一遍。
契约层落到代码里,就是一张接口约定表。它不需要多复杂,但每个字段要写清三件事:这个值是谁定的、端上能不能改、改了会怎样。 举个订单接口大概的样子(字段形状是通用的,不是某个具体系统):
json
{
  "price":        { "value": 12800, "unit": "分", "by": "server" },
  "stock":        { "value": 37, "by": "server" },
  "discount":     { "value": 0.88, "rule_id": "R-012", "by": "server" },
  "can_cancel":   { "value": true, "reason": "发货前可取消", "by": "server" }
}
关键在 by 这一列。端上拿到 price 只能显示,不能改;它要改价格,走的是"发起一个请求",而不是改本地这个数。rule_id 的意义也在这:优惠规则变了,端上不需要同步任何逻辑,还是调同一个接口 ------ 因为判定在服务端,端上只负责"显示服务端给的东西"。
这张约定表我一般就放在仓库里一份,端和服务端都对着它写。它不是文档,是可被两边同时引用的契约 ------ 谁先改,谁先提,另一边跟着对齐。省时间的就发生在这里。
什么不该共用
共用是手段,不是目标。下面这些硬要共用,反而更慢:
- 交互流程:手机和 PC 的用户预期本来就不同,强行一套 UI 会两边都别扭
- 平台能力:支付、登录、分享、推送 ------ 统一封装的抽象层通常比直接写更难维护
- 管理后台:PC Web 后台的形态和 C 端完全不一样,它只是"又一个客户端",不必套用 C 端的组件体系
后台端最常见的做法是独立一套前端框架(例如 Vue + 组件库),但共用同一个业务内核。这也是我做过的大多数项目里的实际形态:前端不止一套,服务端只有一套。
这不是偷懒。后台和 C 端的用户不是同一批人 ------ 操作密度、信息密度、容错要求都不一样,强行统一一套组件体系,结果通常是两边用着都别扭。
数据一致性:把判定权收回来
多端项目出问题,除了逻辑重复,还有一个来源是端上自己算。
举几个典型场景:
- 端上根据本地缓存的库存判断"还能不能下单" → 服务端库存早变了
- 端上算优惠金额 → 规则更新后端上还是旧公式
- 端上判断订单能不能取消 → 服务端的状态机已经不允许了
统一做法是:端上算的东西只用于显示,不用于决定。 所有能改变数据状态的操作,都要让服务端再判一次。端上算错了只是显示错,服务端判错才是事故。
这类问题在商城类项目里特别容易发生,因为多端上线时间往往不一致:先上小程序,H5 和 App 后补。后补的那两端如果按"上一版的规则"写,就会和服务端悄悄分叉。等到有人发现同一个商品在两端算出来的价格不一样,通常已经过去几周了。
顺带一个副作用:服务端集中判定之后,加端变得很轻 ------ 新端不需要重新实现规则,只要调用同一个接口。
落到排查上,有一条很省事的判据:当两个端对同一份数据算出不一样的结果时,先别怀疑某个端写错了,先怀疑这件事根本不该放在端上算。 把判定收回到服务端之后,这类"哪端算错"的争论就直接消失了 ------ 因为每个端都不算,它们只是显示同一个接口的返回。
多端分三层:业务内核 / 契约层 / 端
什么时候别搞共用
有两种情况,共用是纯亏:
- 只有一个端:没有第二个端要复用,抽象出来的层就是纯粹的额外复杂度
- 两个端的业务差异远大于共性:如果"共用"的结果是代码里塞满条件分支,那还不如各写各的
判断标准很简单:共用省下的工作量,要大于维护这层抽象的成本。 端数越多、业务规则越复杂,这个值越大;端少、规则简单的时候,直接写更快。
小结
多端"少写一遍"的关键,不在选哪个跨端框架,而在两件事:
- 业务判定集中在服务端 ------ 消除规则漂移
- 接口契约先定 ------ 让每一端都只是"接一遍"
跨端框架省的是界面代码。而真正吃掉工期的,是同一个规则被写四遍之后,你花在对比四份实现上的时间。