同样打开一个带有 100 条历史消息的 Agent 会话,rpi 用了 16.9 毫秒 ,Pi 用了 194.9 毫秒。
等到程序就绪,rpi 的进程驻留内存是 21.4 MiB ,Pi 是 96.1 MiB。
换成比例,Rust 版 rpi 的会话启动耗时少约 91%,就绪内存少约 78%。把历史增加到 5,000 条,rpi 在这两项上依然领先。
rpi 是用 Rust 重新实现的 Pi 编码助手,既能作为终端工具运行,也能作为库进入 Rust 应用。这篇只看它已经拿到明确收益的两个环节:打开已有会话,需要等多久;打开以后,占用多少内存。
下面的数据来自 2026 年 10 月 6 日保存的基准,对比 rpi 0.3.15 与 Pi 0.87.1。本次重新核对原始记录与统计结果,没有重跑当前版本。
会话启动:16.9 毫秒对 194.9 毫秒
只测 --version,能看到程序启动得有多快,却没有让 Agent 真正加载会话。
当时的测试给两边准备相同的历史文本,用各自的原生会话格式保存。启动程序后,发出 get_state 状态请求,收到响应才停止计时。计时器放在创建进程之前,因此包含进程创建和会话重载。
| 历史消息数 | rpi 启动至就绪 | Pi 启动至就绪 | rpi 耗时减少 |
|---|---|---|---|
| 100 | 16.93 ms | 194.93 ms | 91.3% |
| 1,000 | 28.85 ms | 196.98 ms | 85.4% |
| 5,000 | 81.60 ms | 212.47 ms | 61.6% |
每端每种规模丢弃 2 次预热,正式测量 5 次,表中取中位数。降幅根据未舍入的中位数计算。
100 条消息时,Pi 的就绪耗时约为 rpi 的 11.5 倍。增加到 1,000 条,rpi 仍在 30 毫秒以内,Pi 约为 197 毫秒。
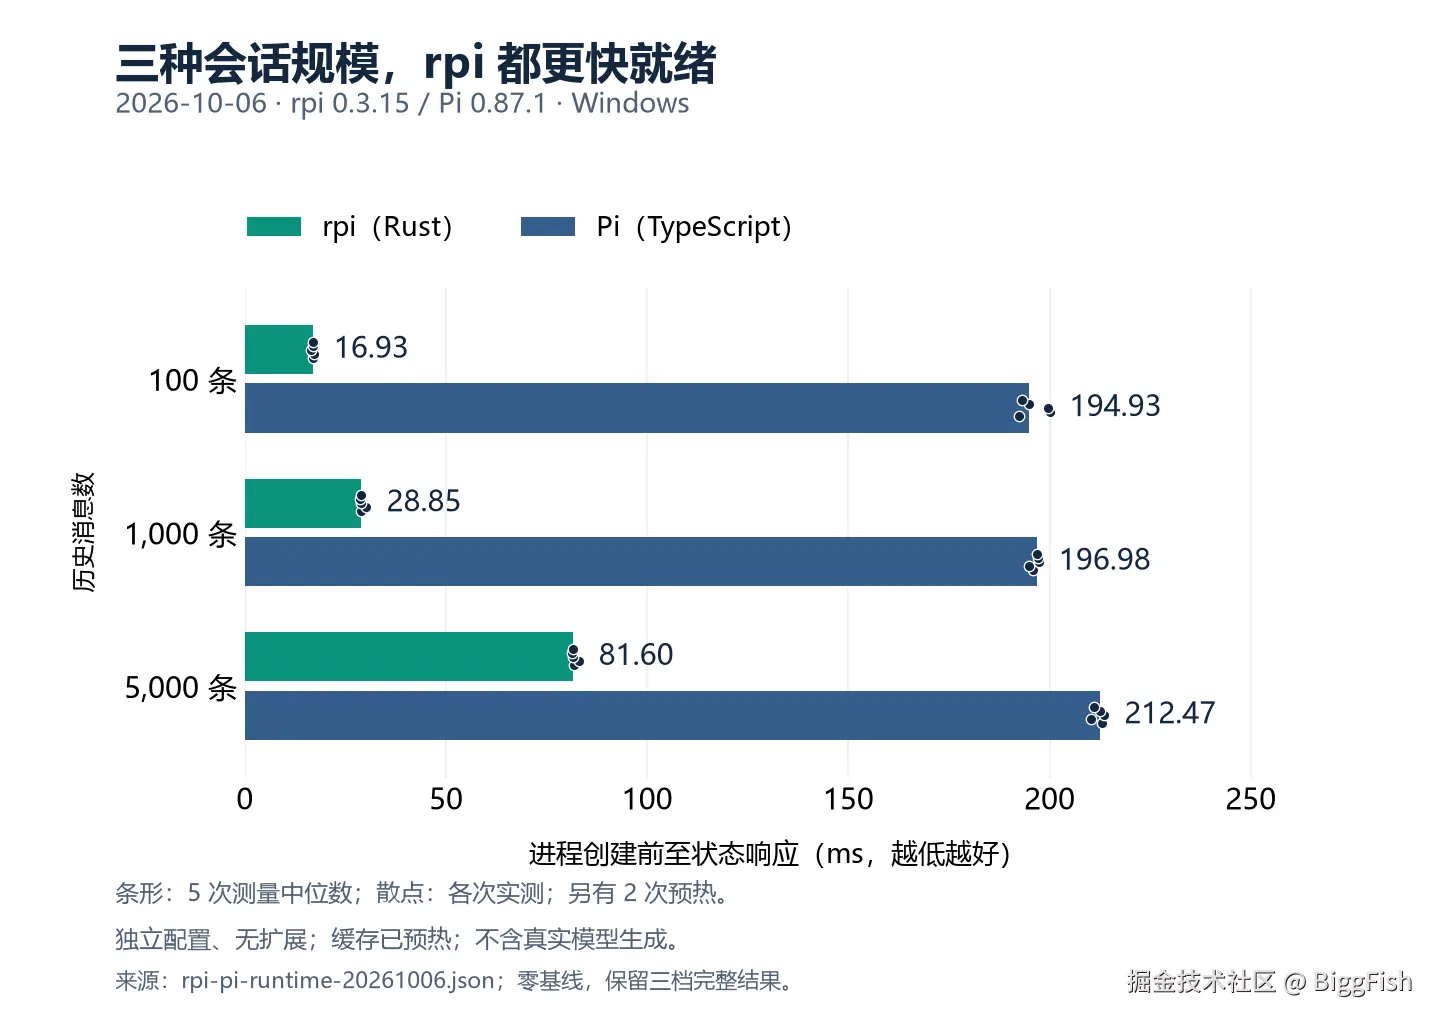
条形表示 5 次测量的中位数,散点保留各次实测;横轴从零开始,越短越好。双方使用独立测试配置,不加载扩展。
5,000 条消息是更有价值的对照。此时两边都需要读取和处理更多历史,rpi 的启动至就绪时间为 81.6 毫秒,Pi 为 212.5 毫秒,rpi 仍少用约 131 毫秒。
这说明收益不只存在于一条轻量版本命令里。至少在这三档文本会话中,rpi 都能更快进入可响应状态。
脚本还做了额外核验:检查加载的会话标识,随后发送新消息,核对模型端收到的历史数量和尾部标记,避免把没有真正加载历史的空会话当成成绩。
就绪内存:21.4 MiB 对 96.1 MiB
启动耗时决定需要等多久,内存则影响程序放在那里要付出多少资源。
为避免采样命令干扰计时,内存测试另起进程。加载同一份会话并就绪后,再读取进程 RSS,也就是当时驻留在物理内存中的大小。
| 历史消息数 | rpi 就绪 RSS | Pi 就绪 RSS | rpi RSS 减少 |
|---|---|---|---|
| 100 | 21.41 MiB | 96.15 MiB | 77.7% |
| 1,000 | 27.33 MiB | 98.04 MiB | 72.1% |
| 5,000 | 50.85 MiB | 116.77 MiB | 56.5% |
RSS 每端每种规模单独采样一次,是就绪时的观察值,不是运行峰值。
100 条消息时,rpi 的就绪 RSS 约为 Pi 的 22.3%。加载到 1,000 条时,rpi 仍只有约 27.3 MiB。
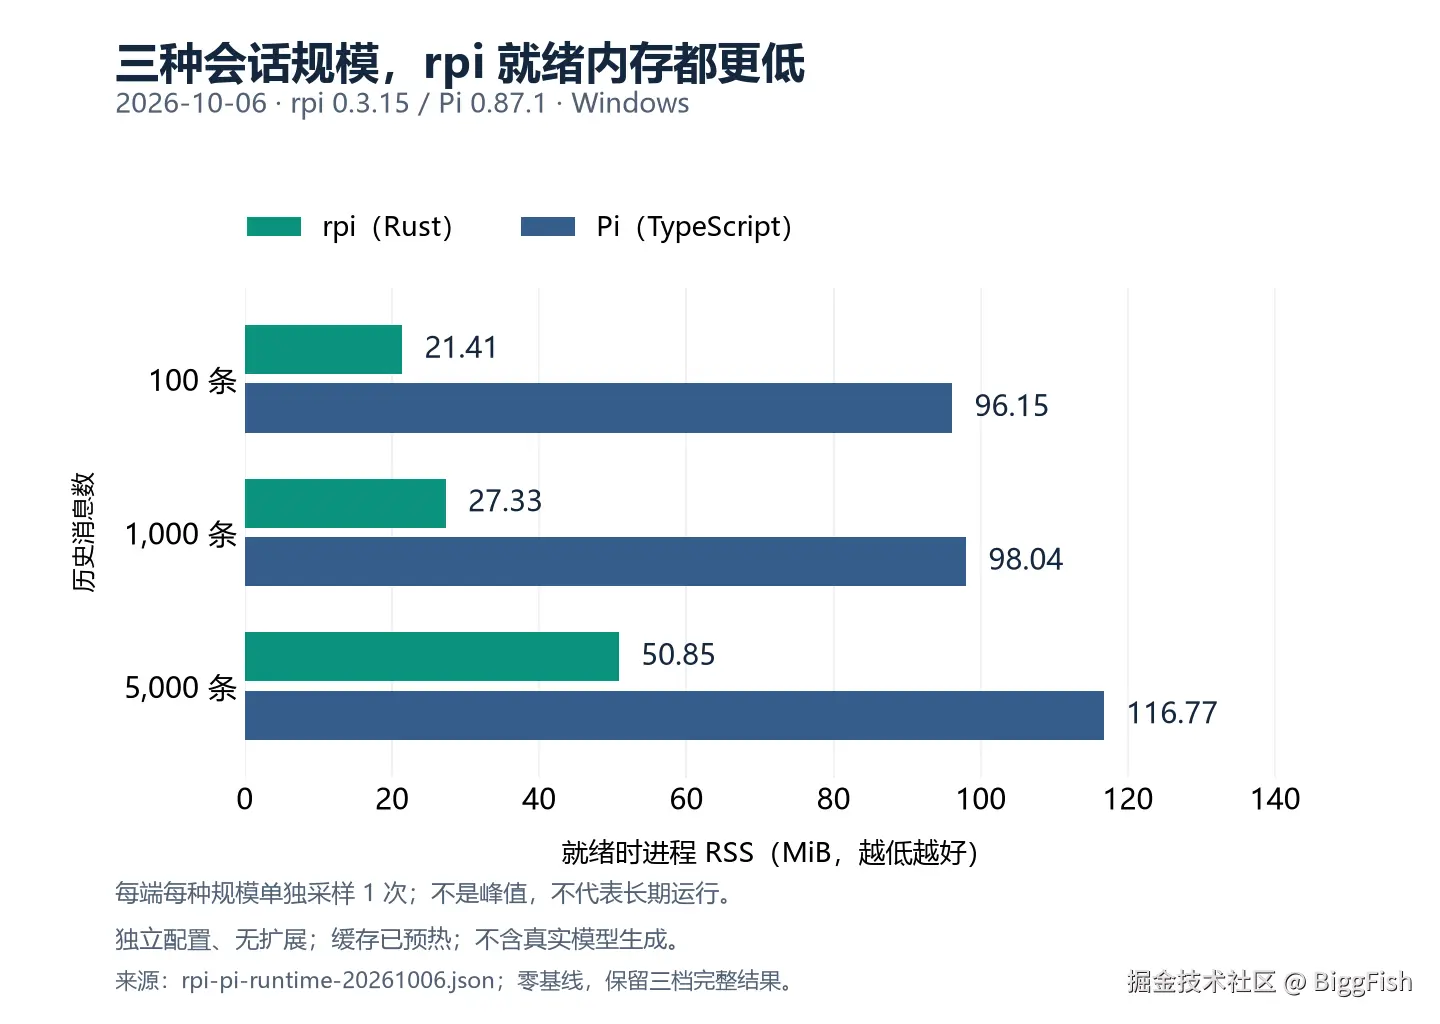
图中为各组单次就绪采样,没有误差区间。RSS 不等于堆大小,也不代表完整任务所需的最大内存。
到 5,000 条消息时,rpi 与 Pi 相差约 65.9 MiB。历史增长以后,rpi 的资源优势仍然存在,没有因为加载更多消息就消失。
如果应用需要同时运行多个独立 Agent 进程,这类差额就有继续验证的价值。下一步应看目标并发数下的总内存,以及真实任务执行时的峰值,确认能多承载多少工作。
对使用者,这两项优势分别意味着什么
对于经常启动、退出,或者由上层程序按需拉起的 Agent,会话启动成本会反复出现。100 条消息这组约 178 毫秒的差额,每次重新启动并加载同类会话时,都可能影响等待体验。
对于多个 Agent 进程同时存在的应用,单个进程的资源占用更值得关注。这里测到的就绪 RSS 差额,为进一步做并发容量测试提供了依据,但不能直接乘以进程数量当成实际节省量。
rpi 还有一个与项目设计直接相关的用途:作为库接进 Rust 程序。已有的模型接入、工具循环与会话能力,可以由应用按需组合。对于本来就在 Rust 技术栈里开发产品的人,这也是评估它的一个理由。
这篇比较的是两套实现,不把差额全部归因给某一种语言机制。没有 CPU 和分配剖析,就无法准确拆出依赖初始化、历史解析、运行时和对象布局各占多少。
但作为一次工程结果,三档会话给出的方向一致:这组版本中,rpi 打开会话更快,就绪时也更省内存。
怎么测的,哪些条件需要保留
原始记录的平台为 Windows,系统标识为 build 26300,Node 为 v25.9.0。双方使用独立测试配置和专用工作目录,不加载扩展。
历史消息由用户与助手交替组成,每条正文约 1,000 个字符。双方逻辑文本相同,原生 JSONL 文件和协议请求体并非逐字节相同。每轮启动前恢复原始样本,操作系统文件缓存没有清空,所以这里比较的是缓存已预热后的表现。
会话样本只有已完成的文本对话,没有图片、上下文压缩和中断恢复。上述成绩也不包含真实模型生成,不能换算为完成编码任务的加速比例。两端按固定顺序分组测量,没有随机交替,仍值得在更多机器上复测。
标题中的 91% 和 78% 对应 100 条消息这一档,分别是启动至就绪的耗时降幅,以及就绪 RSS 的降幅;其他规模的结果完整保留在前面的表格里。
原始数据:
blog.bigfisharc.cn/benchmarks/...
测试脚本:
blog.bigfisharc.cn/benchmarks/...
下载脚本,准备上述历史版本,把变量替换为实际路径后,可以复测这三档会话:
powershell
$benchRpi = 'C:/bench/rpi.exe'
$benchPi = 'C:/bench/pi/dist/bundle/cli.js'
$benchNode = 'C:/Program Files/nodejs/node.exe'

python bench-rpi-pi-runtime.py --rpi $benchRpi --pi $benchPi --node $benchNode --output session-results.json --runs 5 --warmup 2 --sizes 100,1000,5000 --turns 0
原始 JSON 未保存完整硬件信息与两端源码提交 SHA。这条命令提供方法复现入口,不保证重现相同数字。当前版本的结果需要另外运行、记录,再与这批历史数据比较。