前言: 前几天给预览服务接上了外部入口,我又把 Deployment 的副本数从一份调成两份,想让更新时更从容。结果新 Pod 一直是 Pending ,而节点监控看着并没有跑满。我第一反应是等一会儿,或者把容器的内存上限调小。翻了 Kubernetes 的资源管理文档才发现:调度器决定"能不能安排座位",看的主要是资源 requests。于是问题来了:没有明确写需求时,我们怎么安排资源?写了 requests 后,为什么机器看着空闲,Pod 还是进不去?
这篇只讲 CPU、内存请求量与调度的关系,不展开自动扩容和驱逐。
一. 第二个副本来了,却一直没落座
-
场景很普通:预览服务原来只有一个副本,外部请求已经能通过 Ingress 找到它。现在把
replicas改成2。Deployment 的确创建了第二个 Pod ,但kubectl get pods里它一直显示 Pending ,NODE一栏也是空的。 -
我差点把这事当成容器启动慢。可如果连节点都没选出来,镜像拉取、应用初始化和就绪检查还没轮到。先用
kubectl describe pod <pod-name>看末尾的 Events ,若出现FailedScheduling和Insufficient cpu或Insufficient memory,问题就在"安排到哪台机器"这一步。Pending 也可能由别的原因造成,事件内容比状态名更有用。
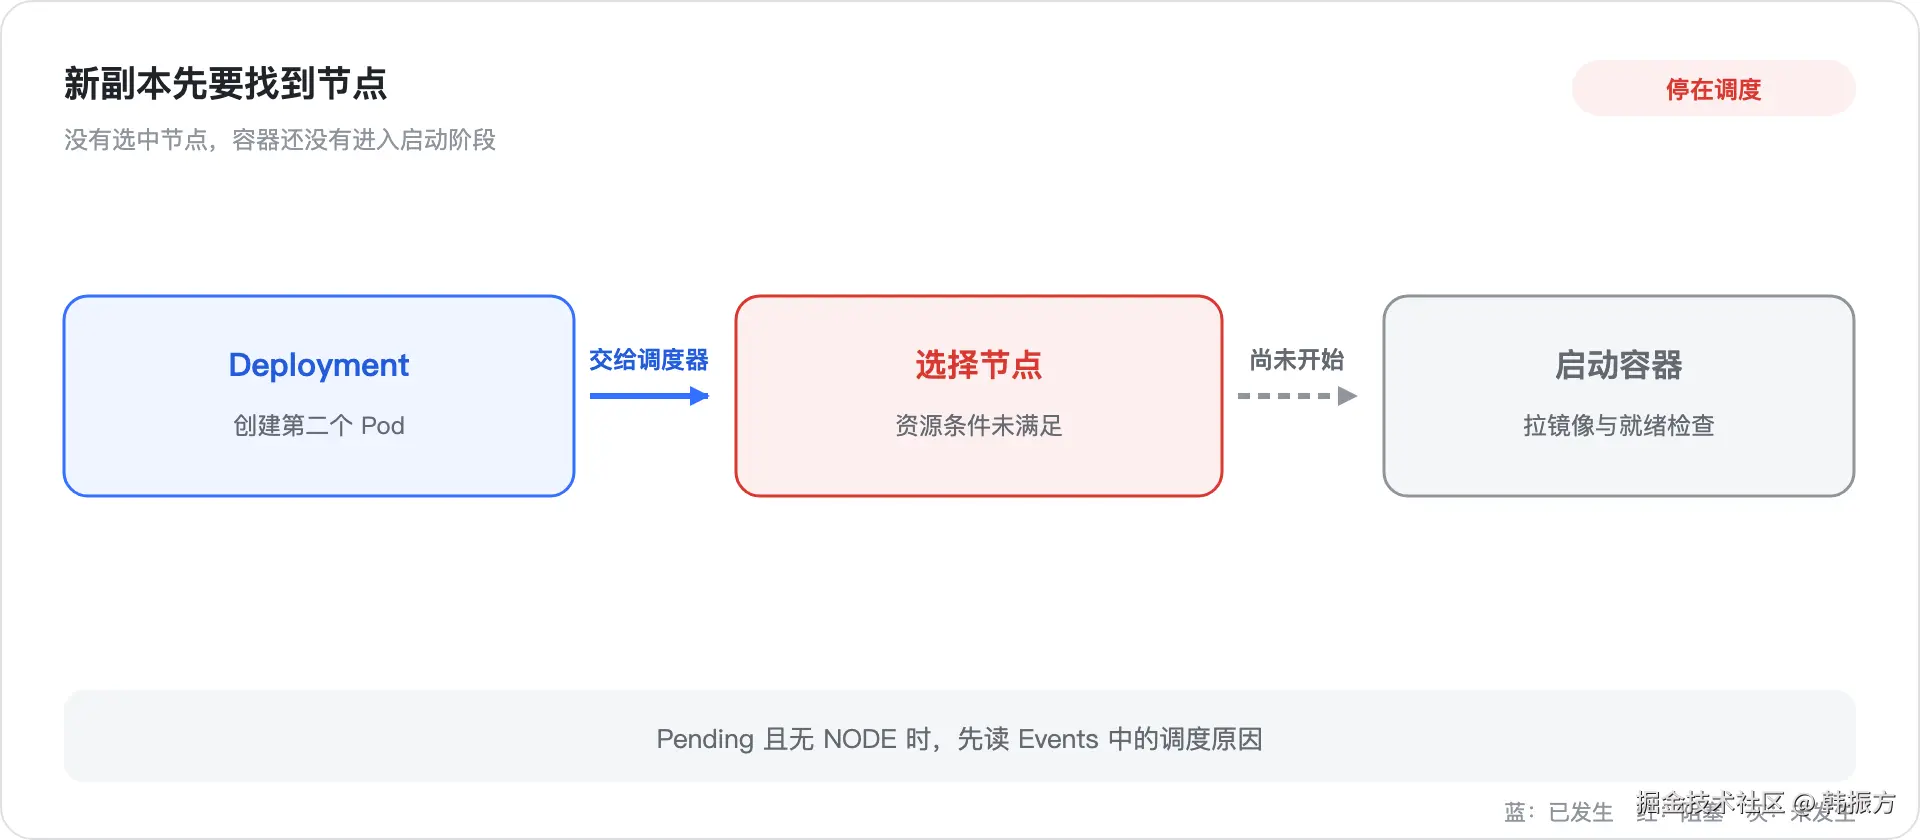
图里红色的停顿发生在选节点时;不要一上来就去翻应用日志。
二. 我先看实时用量,却越看越困惑
-
最自然的反应是打开监控:节点的 CPU 才用了不到一半,为什么放不下一个小服务?于是我想把
limits.cpu调小,给它"腾空间"。这个办法容易找错对象:limits管容器运行后最多能用多少,调度时要比较的是它申请了多少。 -
如果完全不写资源需求,应用可能先被放进去,到了业务高峰又和别的服务抢资源。稍微好一点的办法,是开发者口头约定"这个服务大概吃半核",但调度器看不到聊天记录。我们得把最低需求写进清单,让每个副本都带着自己的"座位申请"。
| 我先看的东西 | 它回答的问题 | 这次为什么不够 |
|---|---|---|
| 节点实时使用率 | 此刻实际用了多少 | 不能代表已经承诺给其他 Pod 的资源 |
limits |
容器运行后的上限 | 不是本篇要调整的调度需求 |
requests |
新 Pod 至少申请多少 | 调度器会拿它和节点可分配余量比较 |
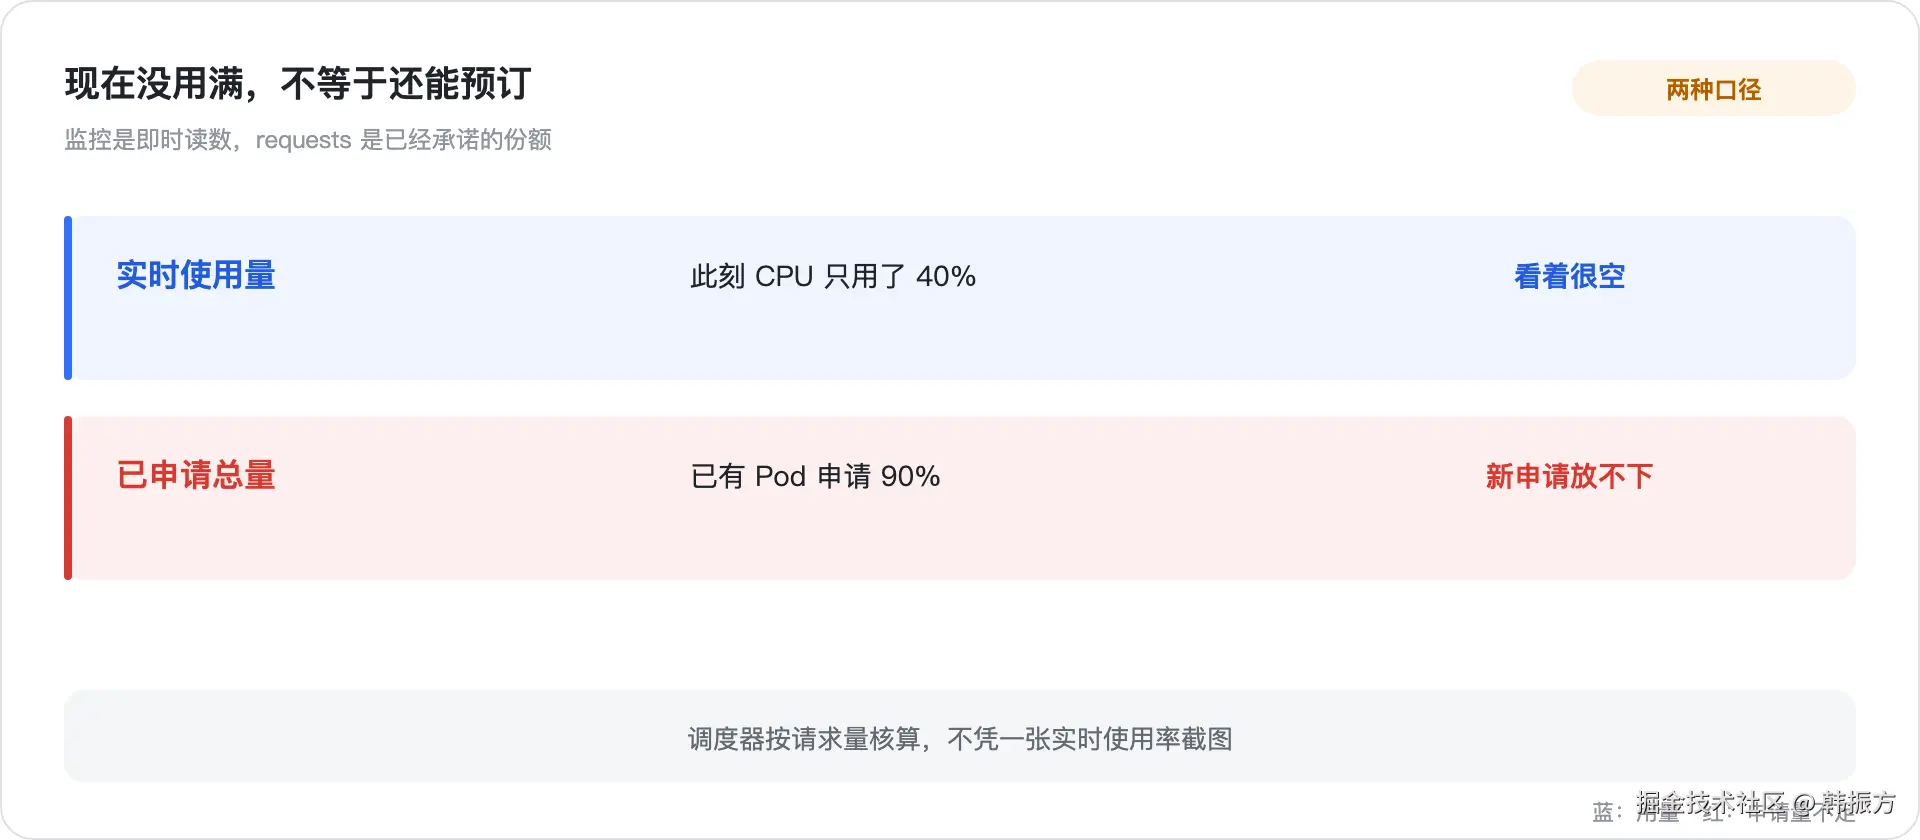
重点看"已承诺"与"正在使用"两条线:它们描述的不是同一件事。
三. 给新副本写一张明确的资源申请单
-
Kubernetes 在调度时,会把每个候选节点的可分配资源,与已经安排在该节点上的 Pod 请求量相比较。新 Pod 的请求量加进去仍能容纳,才有机会被选中。所以
requests更像订会议室时预留的座位:有人暂时没坐满,也不能把承诺过的位置再卖一遍。 -
在常见的容器级写法里,给
preview容器声明resources.requests.cpu: 250m和resources.requests.memory: 128Mi,意思是它申请四分之一核 CPU 和 128 MiB 内存。一个 Pod 有多个普通容器时,调度所需的资源通常会合计它们的请求量。这里的数字只是演示格式,真实值要结合应用观测来定。
text
没有明确请求量:大家凭经验估计,调度器缺少应用需求的信息
写了请求量:每个副本带着资源申请单,逐个找容得下它的节点
新问题:申请量写得过大,机器即使暂时很闲,也可能放不进去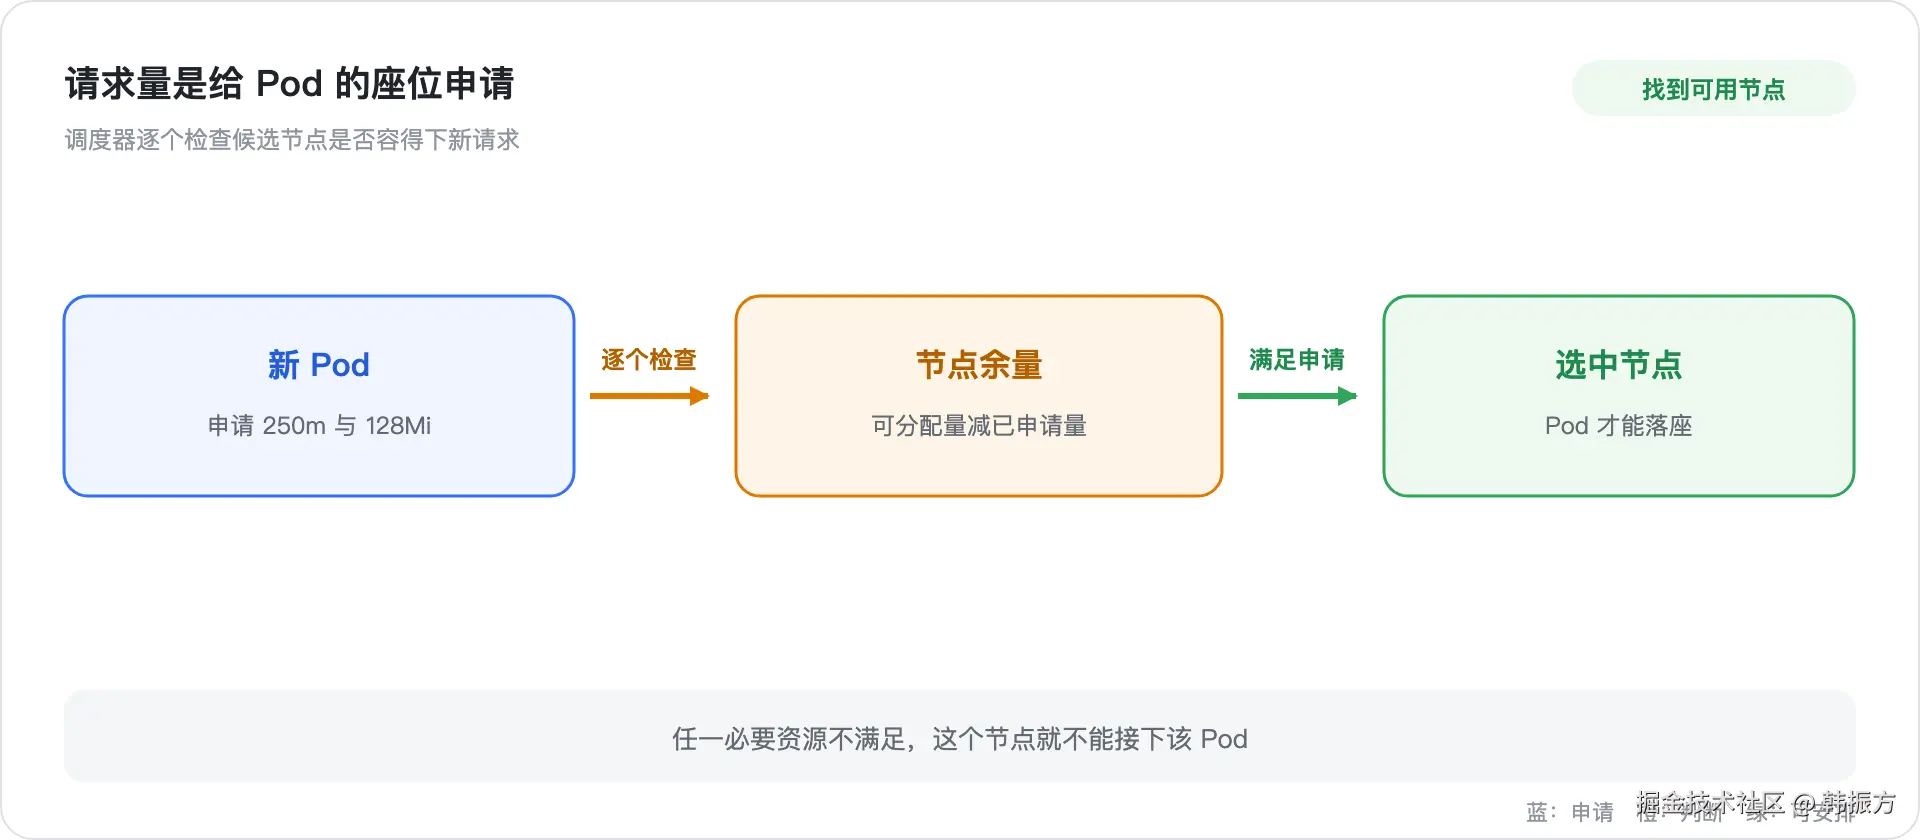
绿色节点能装下新申请,红色节点不能;这张图说的是调度判断,不是实时利用率。
四. 用一份清单看清 requests 写在哪里
- 下面只保留和本文相关的配置。假设集群已有
preview镜像,给容器写请求量,同时给它一个运行上限。replicas: 2表示要安排两个副本,每个副本都各自申请资源;不是两份共用250m。清单用的镜像名是占位值,使用时要替换。
yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: preview
spec:
  replicas: 2
  selector:
    matchLabels:
      app: preview
  template:
    metadata:
      labels:
        app: preview
    spec:
      containers:
        - name: preview
          image: example.invalid/preview:v1 # !!! 注意:换成实际可拉取的镜像
          resources:
            requests:
              cpu: 250m
              memory: 128Mi
            limits:
              cpu: 500m
memory: 256Mi-
检查时先执行
kubectl get pods -o wide,确认哪个 Pod 没有节点,再执行kubectl describe pod <pod-name>看它的 Requests 和 Events 。接着用kubectl describe node <node-name>看节点的 Allocatable 与 Allocated resources 。这里不能只拿物理内存容量做减法:系统和 Kubernetes 组件要留资源,调度使用的是可分配口径。 -
本文清单依据官方字段编写,没有在这篇文章里实际部署并制造资源不足 ,因此不把示意中的
FailedScheduling当成本机实验结果。你的集群是否报资源不足,还取决于节点配置、其他工作负载和准入策略。
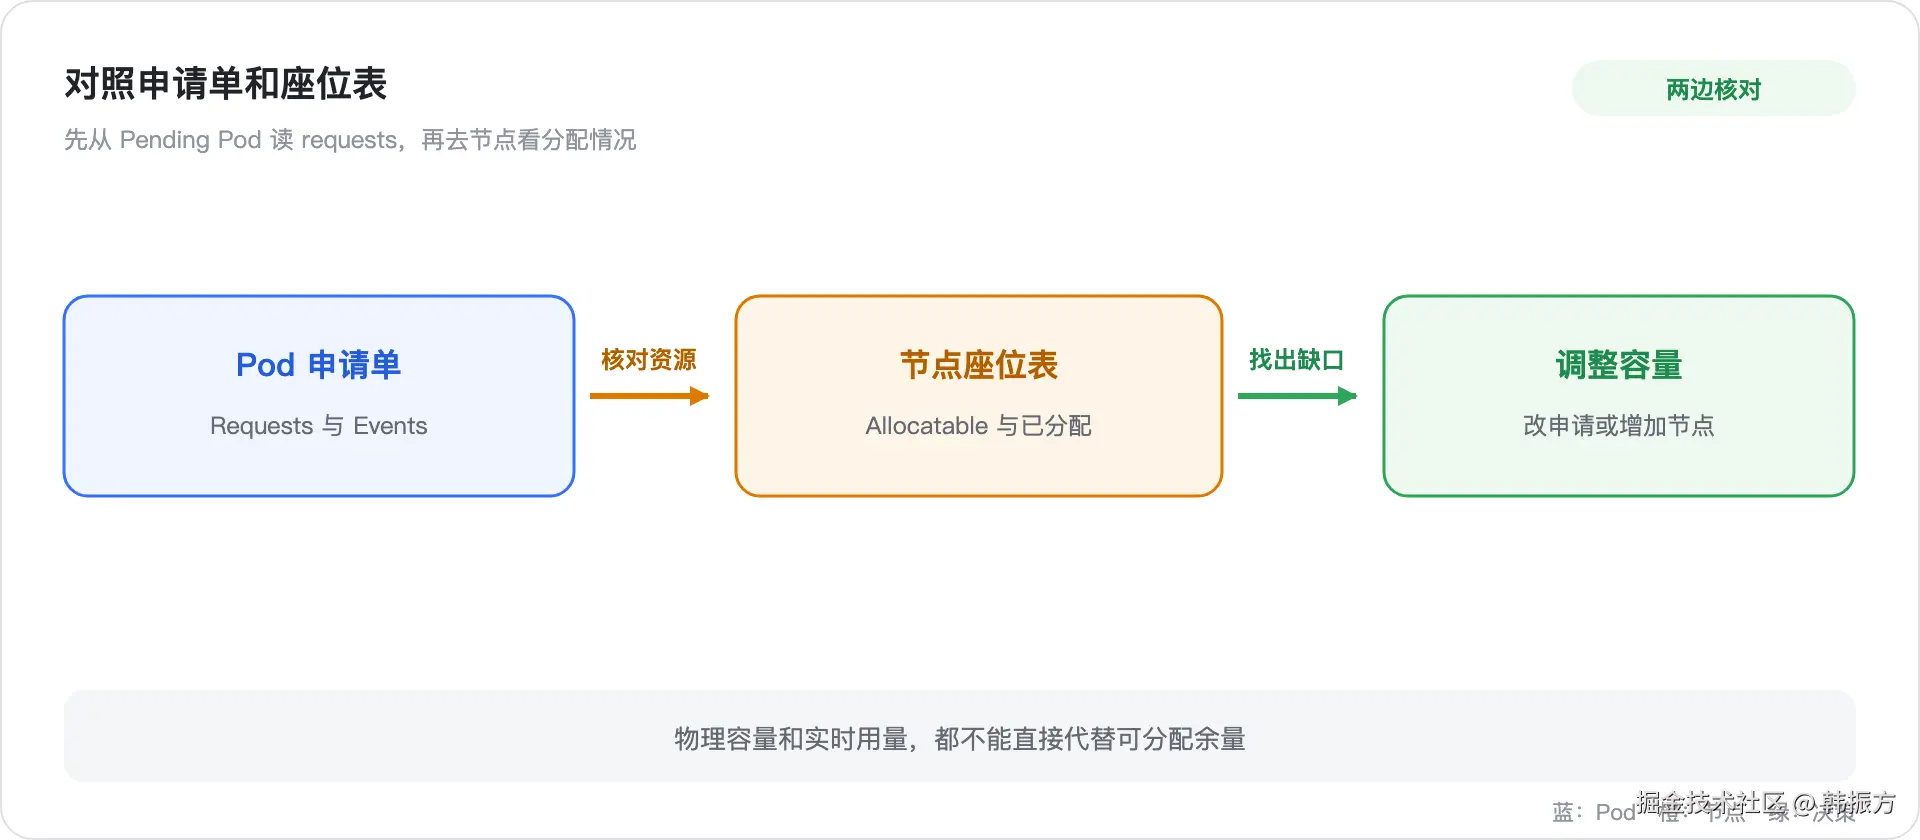
这次要对照两边:Pod 请求了多少,节点已经承诺了多少、还剩多少。
五. 写了申请单,仍可能要调整座位安排
-
requests写得太小,Pod 可能顺利启动,但高峰时资源压力仍会出现;写得太大,则可能一直 Pending 。处理时先确认应用真实需求,再考虑调低请求量、减少同时运行的副本,或者给集群增加容量。别为了让状态变绿,就把数值随手改成0。 -
还要分清
requests和limits的时机。前者主要参与放置决策,后者影响容器运行时的约束。即使调度成功,也不保证后续永远不会 OOM 或遇到 CPU 限速。反过来,节点此刻使用率低,也不能推翻一次明确的Insufficient cpu事件。 -
回到会议室的比方:预订表写满了,即使大家此刻都出去喝咖啡,前台也不能随便把下一场会议安排进来。你可以核实谁真的需要大房间,也可以多开一间;但先要看预订表,而不是只拍一张空座位照片。
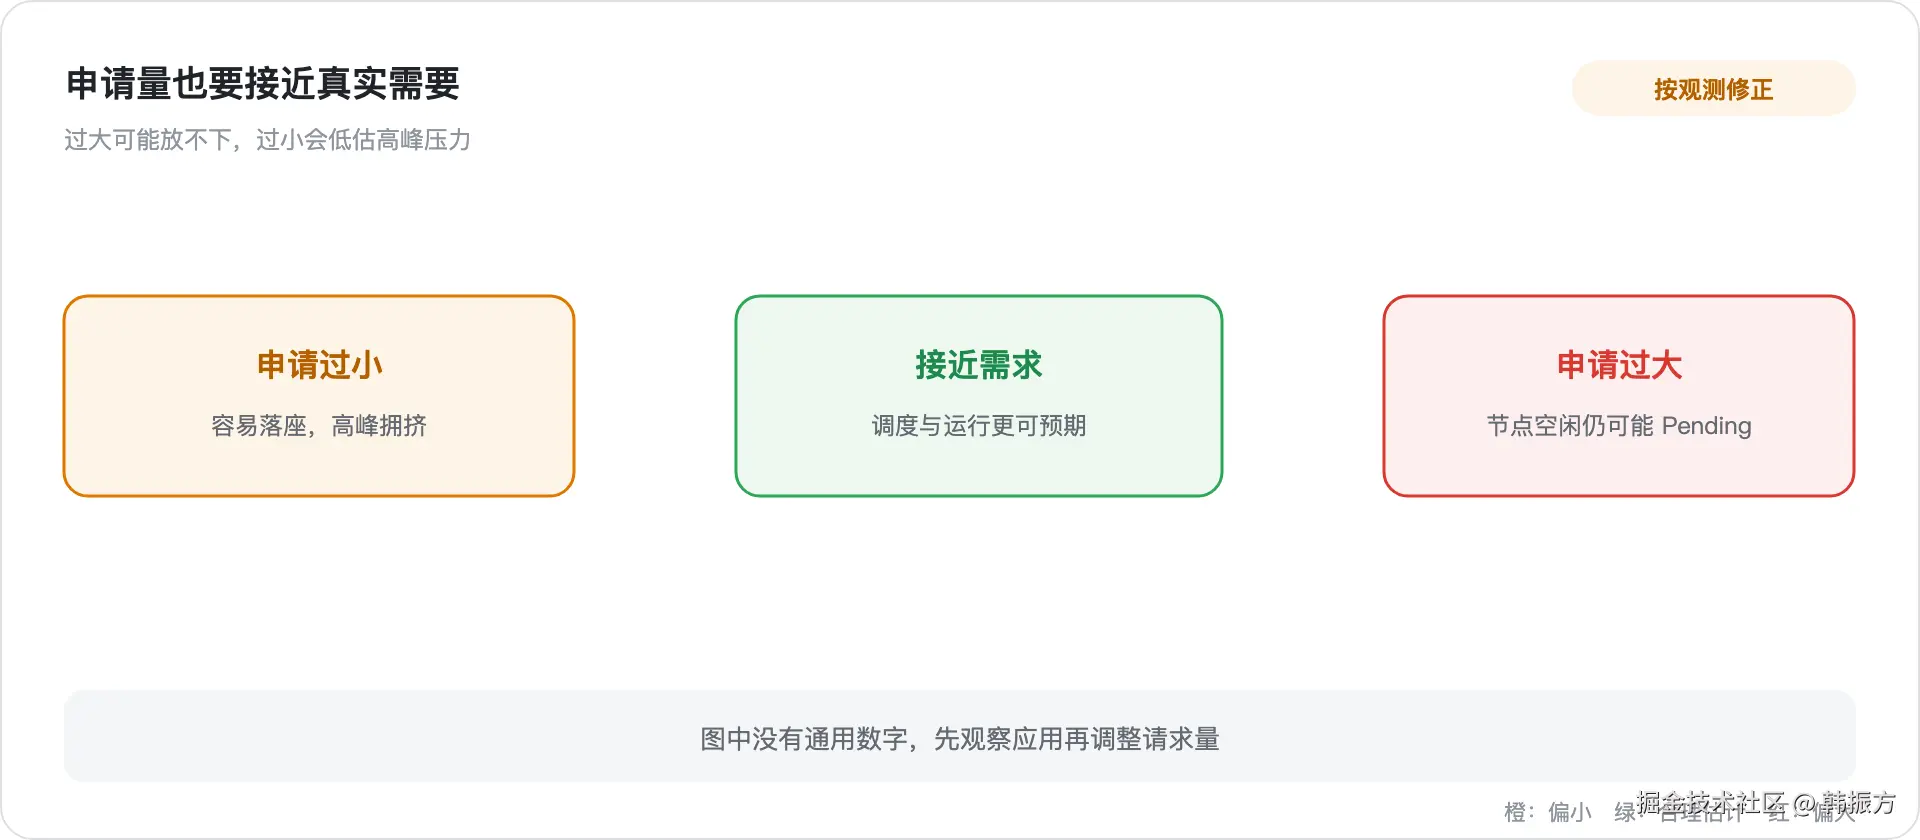
这张图的中间值不是固定推荐数字,重点是根据观察修正申请量。
六. 总结:先看申请量,再看节点余量
-
新 Pod 停在 Pending 时,先看它有没有分配到节点,再读 Events 。若事件明确指向资源不足,就把
requests、节点 Allocatable 和已分配请求量放在一起看。 -
记住一个区别就够了:
requests是调度时的资源申请,limits是运行后的使用边界,实时使用率只是"现在用了多少"。下次扩副本失败,我会先找申请单和座位表,再决定改申请量还是扩节点。
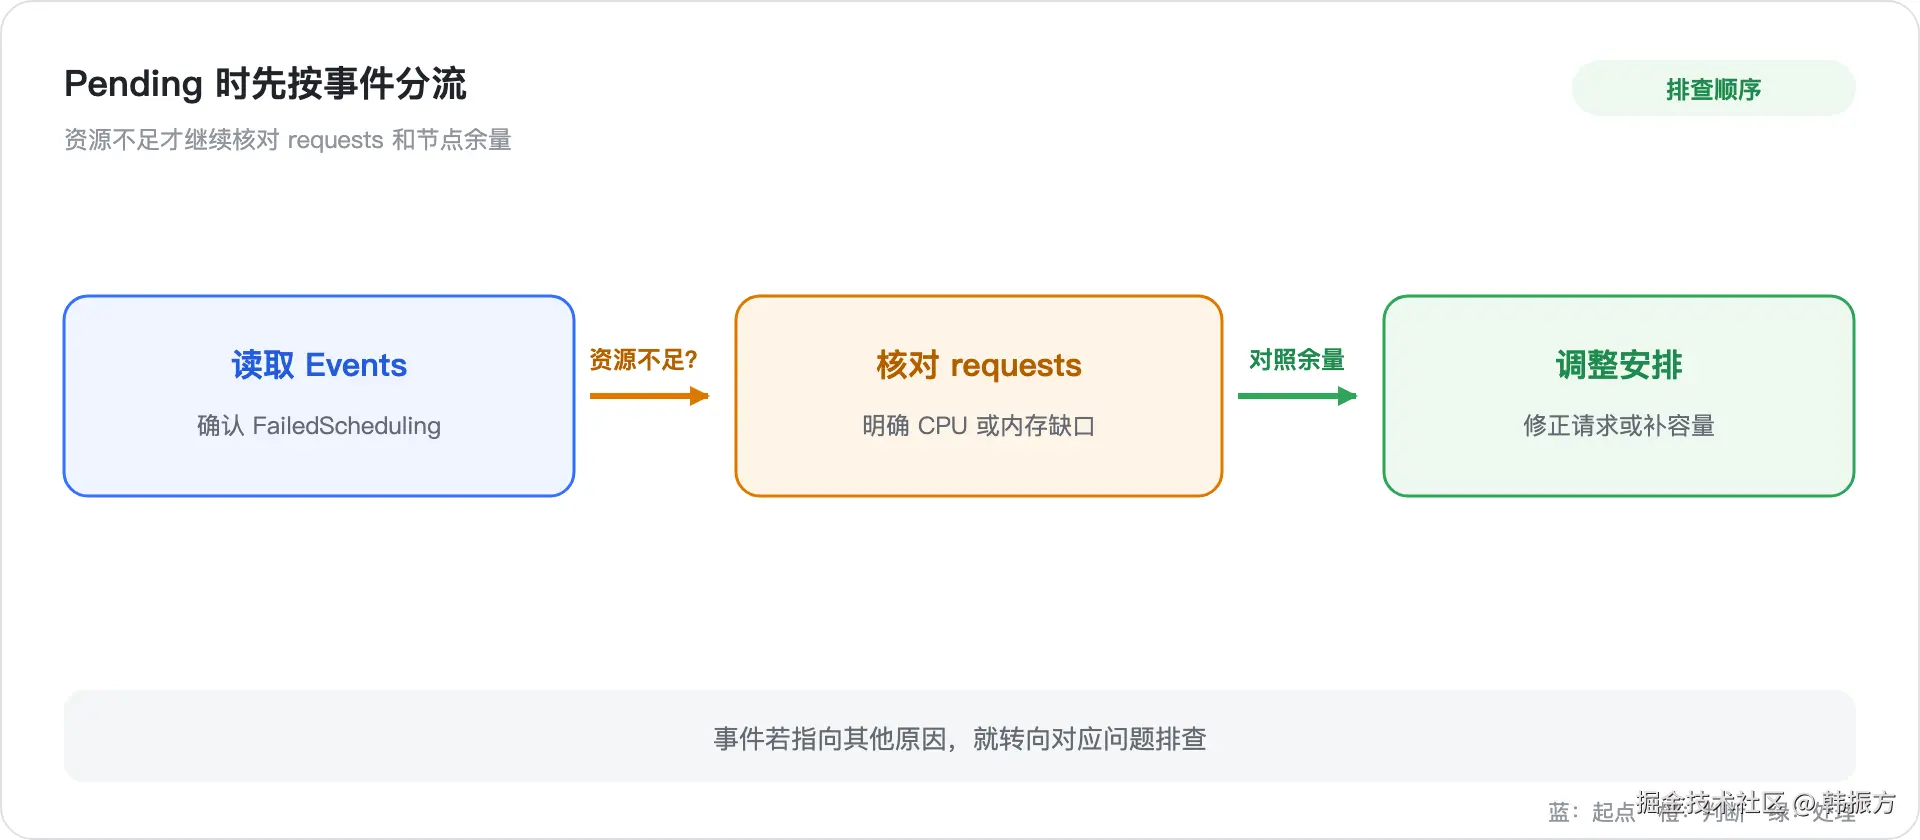
图里先读事件,再决定要比较哪种资源;若事件不是资源不足,就别沿这条路径硬查。
本文参考: Kubernetes 资源管理 · 调试运行中的 Pod