整理工作目录那天,ls | grep ledger 的输出把我看愣了。
ledger.json 本身 1.4 MB,旁边躺着 177 个 ledger.json.bak-*,加起来 139.7 MB。最早那份是 9 月 3 日的,72 KB;最新那份是 10 月 23 日的,1403944 字节。四十五天,文件涨了 19 倍,备份数量涨了 177 倍。
这件事一开始没人觉得是问题。备份嘛,多留几份总没错。但把这堆文件摊开算一遍,会发现它的成本曲线和收益曲线是反着走的:每多留一份,成本就多涨一截,而它能提供的新信息越来越少。
备份的成本在涨 收益在跌
这个台账是个 append-mostly 的结构。publishes 是个大 dict,1544 个键,平均每个键 808 字节。日常一次写入只做两件事:加一个新键,或者往已有键的 note 后面追一句。
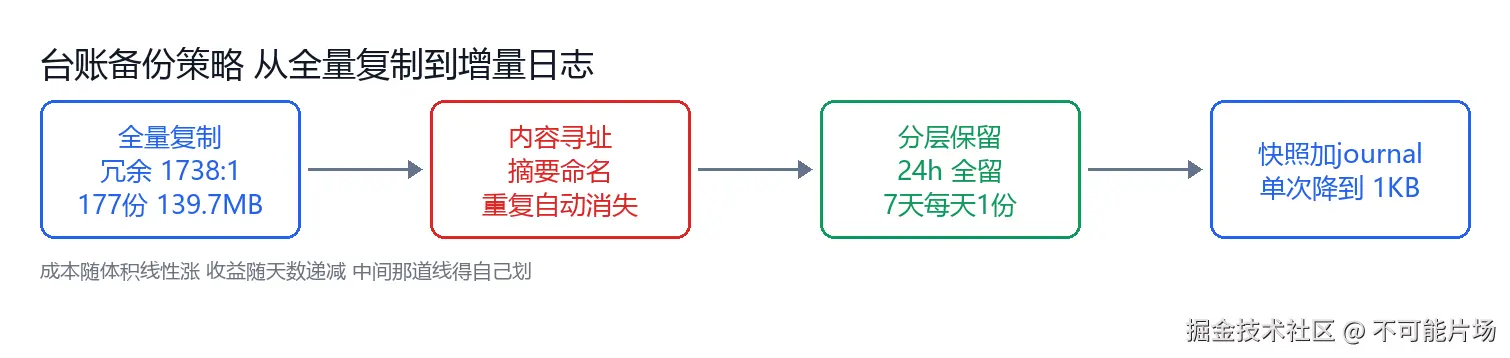
所以一次典型的备份是这样的:为了保住 808 字节的新增,复制 1403944 字节的全文。冗余比 1738:1。
更麻烦的是体积增长的方向。台账只增不减,备份成本就随天数线性上涨;而台账的内容是「历史几乎不变」,越老的备份和它前一份的差异越小。九月那批 72 KB 的备份之间可能只差一两条记录,但那时复制一次只要 72 KB;现在复制一次 1.4 MB,而新增的内容量没变。
成本在涨,单份备份的信息量没变,这两条线迟早会交叉。交叉之后,备份就从「保险」变成了「负债」。
全量复制的三个代价
第一个是磁盘,但这是最不重要的一条。139.7 MB 放在今天的硬盘上不算什么,说它占空间属于避重就轻。
第二个是认知成本 ,这条更要命。改台账前的标准动作是「先确认存在周期前备份」。可 177 个文件摆在面前时,哪一个是「周期前」的?只能靠文件名里的时间戳和 mtime 猜。10 月 13 日那天有 6 个备份,1421、1520、152926、152941、153036、2115------想恢复「改动之前」的状态,得先判断哪一次改动是「这次」的。猜错一次,恢复的就是一个中间态。
第三个最要命:重复备份本身说明备份动作没做过必要性校验。
拿 sha256 扫一遍这 177 个文件,有 5 组内容完全一样:
css
identical_groups= 5 redundant_files= 5
  DUP ['ledger.json.bak-202609221510-r50', 'ledger.json.bak-202609221515-r50-presize']
  DUP ['ledger.json.bak-pre-20260928-correct', 'ledger.json.bak-pre-20260928-fix2']
  DUP ['ledger.json.bak-20261010-fenmianC-dyretry', 'ledger.json.bak-20261010-mangmo-idbackfill']
  DUP ['ledger.json.bak-20261013-152926-reconcile1013b', 'ledger.json.bak-20261013-152941-reconcile1013b']
  DUP ['ledger.json.bak-20261018-1015', 'ledger.json.bak-20261018-1016']
152926 和 152941 中间隔了 15 秒,1015 和 1016 中间隔了 1 分钟。两个文件字节级一致,意味着这 15 秒里台账没有任何改动------同一个修复脚本被跑了两遍,第二遍什么都没改,但还是老老实实复制了一份 1.3 MB。
这不是浪费空间的问题,是信号问题 :备份被当成了一个无条件的仪式。脚本开头 shutil.copy2(LEDGER, LEDGER + ".bak-" + tag),复制完才开始干活,从来没问过「现在这份和上一份一样吗」。
一份不知道自己有没有必要的备份,和一份没做的备份,在事故现场是一回事。
先分清备份在防什么
要改策略,得先想清楚备份到底在防哪几种失败。这个台账遇到的其实有三类,它们的解法完全不同:
| 失败模式 | 表现 | 需要的备份 |
|---|---|---|
| 脚本写错键 | 一次改中 7 条历史条目、消失键不为 0 | 写前那一份快照 |
| 进程中途被 kill | 文件截断,json.load 直接抛异常 |
原子替换(.tmp + os.replace) |
| 人工误操作 | 批量归档、--apply 带错参数 |
时间点恢复 |
关键在频率。第一类是最常发生的------HANDBOOK 里记着 9 月 15 日那次,一个正则替换把 7 条历史条目凭空塞了 verify 字段,靠周期前备份逐条还原。第二类偶发,但只要有一次就能毁掉整个文件。第三类最少。
只有第三类真的需要「很多个时间点」。前两类只需要「写之前那一份」和一个原子写。
而我们现在的做法是:为了覆盖第三类,把前两类的成本一起抬到了 177 份。
改法一 内容寻址 让重复备份自己消失
最省事的一步:备份文件名带上内容摘要,写之前先比一次。
python
import hashlib, shutil, os

def savepoint(path, tag):
    raw = open(path, "rb").read()
    digest = hashlib.sha256(raw).hexdigest()[:12]
    bak = f"{path}.bak-{tag}-{digest}"
    # 已存在同摘要备份 -> 说明当前内容已被保存过,直接复用
    for old in glob.glob(f"{path}.bak-*"):
        if old.endswith("-" + digest):
            return old, False
    shutil.copy2(path, bak)
    return bak, True
同一个摘要只落一次盘,重复执行天然幂等。刚才那 5 组重复里,第 2 组往后的都能被这一步挡掉。返回值的布尔量也不是装饰------脚本可以据此在日志里区分「新建了恢复点」和「内容未变,跳过」,后者出现得太频繁,就说明有脚本在空转。
顺手加一条:命名里带上 tag 和摘要,恢复时不用再靠 mtime 猜哪份是周期前的。要找「回填之前」的状态,ls ledger.json.bak-*idbackfill* 就够了。
改法二 分层保留 按恢复价值排序
有了内容寻址,重复没了,但每天新增的备份还在累积。下一步是定保留策略。
原则不是「留最近 N 个」,而是按恢复价值分桶:
python
def prune(path, now, anchors):
    """近 24h 全留;7 天内每天留最新 1 个;更早只留锚点。"""
    baks = sorted(glob.glob(f"{path}.bak-*"), key=os.path.getmtime)
    keep = set()
    per_day = {}
    for b in baks:
        age = now - os.path.getmtime(b)
        name = os.path.basename(b)
        if age < 86400:
            keep.add(b)                       # 24h 内:全留,正在调试
            continue
        if any(a in name for a in anchors):   # 锚点:永不删
            keep.add(b)
            continue
        if age < 7 * 86400:
            day = time.strftime("%Y-%m-%d", time.localtime(os.path.getmtime(b)))
            per_day[day] = b                  # 覆盖写,天然留最新
    keep.update(per_day.values())
    for b in baks:
        if b not in keep:
            os.remove(b)
anchors 是关键。它不是按时间划的,是按事件性质划的:批量 id 回填、分区改名、平台增删这类结构性变更,前后各留一份,永远不删。因为这些操作一旦出错,影响面是几十上百条记录,而且往往几天后才发现。
这条界线很重要:时间密度留给「刚才」,事件锚点留给「那次」。日常发文这种一天一次的增量操作,留每天一份就绰绰有余;真正稀缺的是「10 月 9 日 21:27 回填 id 之前」那一份------那份丢了,再多的日常备份也补不回来。
按这个策略跑一遍现有 177 个文件,能留下的不到 20 个,体积从 139.7 MB 降到 25 MB 上下,而真正会用到的那几份一份不少。
改法三 快照加 journal
前面两步都是治标。要治本,得承认一件事:用全量快照记一个 append-mostly 的结构,方向本身就错了。
台账的日常变更只有两种形态------新增键、追加字段。这两种都能用一个极小的 patch 描述:
json
{"op":"set_note","key":"juejin-article|2026-10-24-...|掘金","append":"\\n历史 id=7..."}于是改成:每天一份全量快照,每次变更往 journal 里追加一行。
python
def commit(ledger_path, journal_path, op):
    with open(journal_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(op, ensure_ascii=False) + "\n")
        f.flush()
        os.fsync(f.fileno())      # 落盘才算提交
    apply(ledger_path, op)        # 再改主文件

def restore(snapshot, journal_path):
    data = json.load(open(snapshot, encoding="utf-8"))
    for line in open(journal_path, encoding="utf-8"):
        apply_obj(data, json.loads(line))
    return data
单次写入从 1.4 MB 降到 1 KB 量级,恢复是「最近快照 + 重放」,粒度精确到每一次操作------比「某一份备份」强得多。fsync 那行别省:注释写完没落盘,断电之后 journal 少了最后一行,恢复出来就是错的中间态。
代价是复杂度。apply 必须是纯函数、必须幂等(重放同一条 patch 结果不变),还得有个定期把 journal 折叠进快照的 compaction。这套东西在真正的数据库里是常识,但给一个 1.4 MB 的 JSON 文件引入它,值不值要看写入频率。一天写两三次的话,前面两步就够了;如果哪天变成一天几十次(比如接了多平台的实时回写),那就是必须走这条路。
备份不是验证 回滚判据才是
最后这条最容易漏。备份只保证「能回到过去」,不保证「这次写对了」。没有回滚判据的备份,在事故现场就是一堆需要重新判断的垃圾。
台账改写的正确顺序是四步,缺一步备份就白留:
python
bak, created = savepoint(LEDGER, tag)          # 1. 恢复点
tmp = LEDGER + ".tmp"
with io.open(tmp, "w", encoding="utf-8") as f:  # 2. 写临时文件
    json.dump(data, f, ensure_ascii=False, indent=2)
os.replace(tmp, LEDGER)                         # 3. 原子替换

new = json.load(io.open(LEDGER, encoding="utf-8"))
old = json.load(io.open(bak, encoding="utf-8"))
missing = set(old["publishes"]) - set(new["publishes"])
assert not missing, f"消失键 {len(missing)} 个,回滚"   # 4. 校验
第四步的断言是整个流程的收口。9 月 15 日那次如果写了这个断言,就不会出现「一次改中 7 条历史条目」------消失键虽然是 0,但新增键里有 7 个不该存在的。所以判据还得补一条:新增键必须能对上本轮的预期写入,对不上就说明脚本动到了别处。
这也是为什么我在删备份这件事上格外小心:删之前先确认保留的那几份能 json.load 成功、键数和当前一致。一个删不回来的备份目录,比没有备份更危险------它会让人误以为有后路。
落地顺序
如果手上也有一个长到几百份的 .bak 目录,建议按这个顺序动:
先跑一遍 sha256 去重统计,把完全相同的删掉------这一步零风险,纯收益。然后给保存点加摘要命名,让重复不再产生。再定分层保留策略,锚点先列出来、人工确认一遍再启用自动清理。最后才考虑 journal,那是结构性改造,得先有上面三步垫着。
四十五天里这个目录从 1 份备份长到 177 份,平均一天四份。没有哪一次复制是「错」的,每一次单独看都有理由。问题出在没人回头看过总量------备份是为「将来某一天」准备的,而那个「某一天」的概率不会随份数线性上升。
留得对,比留得多重要。