每天打开后台、填写标题、上传图片、保存草稿------这些操作并不难,却很重复。Playwright 可以让程序接管浏览器,按步骤完成它们。
它并不是"记住鼠标点过哪里"。更准确地说,它会读懂网页里的输入框、按钮等元素,操作它们,再检查页面有没有给出预期结果。
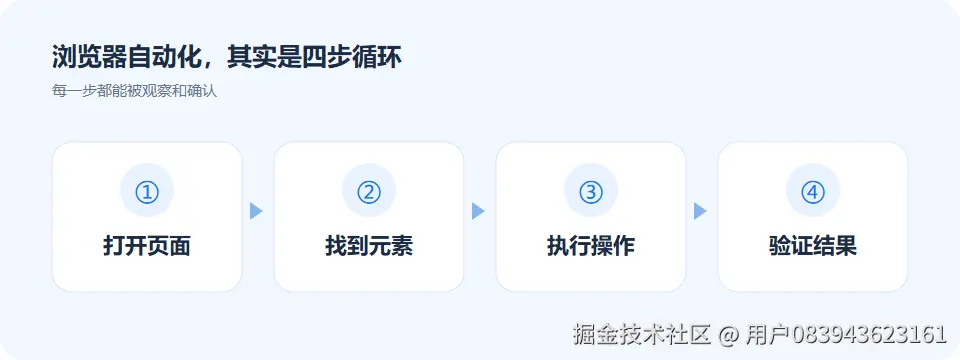
一、从"保存草稿"理解它的工作方式
假设我们要把一篇文章放进创作平台,人的操作是:打开编辑页,输入标题和正文,点击"保存草稿",确认草稿已保存。Playwright 做的是同一件事,只是每一步由代码执行。
最小的核心代码可以短到这样:
ts
await page.getByRole('textbox', { name: '标题' }).fill('我的文章');
await page.getByRole('button', { name: '保存草稿' }).click();
await expect(page.getByText('保存成功')).toBeVisible();
第一行找标题框并填写,第二行找按钮并点击,第三行确认结果。真实项目还要处理正文、图片和登录状态,但思路没有变化。
二、它怎么知道该点哪个按钮?
网页上的按钮不只有位置,还有文字、角色和所在区域。Playwright 可以按"名字叫保存草稿的按钮"去找,而不必记住按钮位于屏幕右下角多少像素。
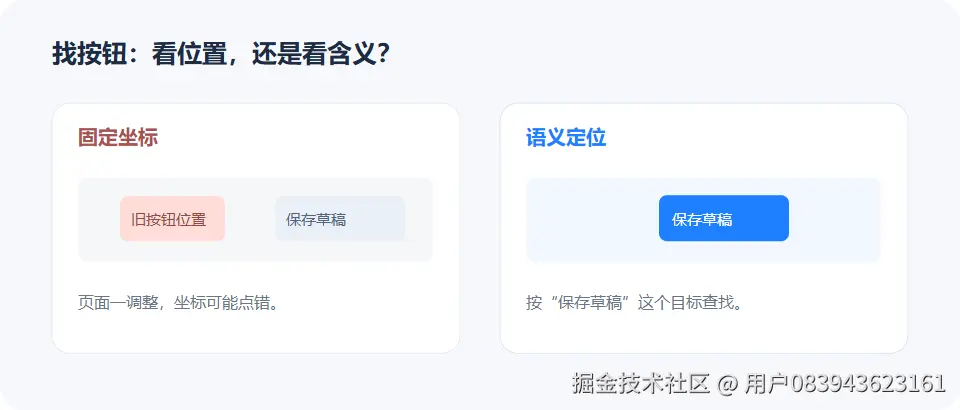
这比固定坐标可靠:窗口大小改变,按钮位置可能变;按钮的作用和文字通常仍然清楚。对于自己开发的页面,还可以给关键按钮加专用标识,让定位更稳定。
但"更稳定"不等于"永不失效"。平台改了按钮文案、增加弹窗或调整编辑器结构,脚本仍可能需要更新。找不到目标时,应该停下来查看页面,而不是猜一个位置继续点。
三、为什么"点到了"还不算完成?
点击"保存草稿"之后,页面可能还在上传图片、等待网络,或者出现"标题过长"的提示。按钮被点到,只证明操作发生了,不能证明草稿已经保存。
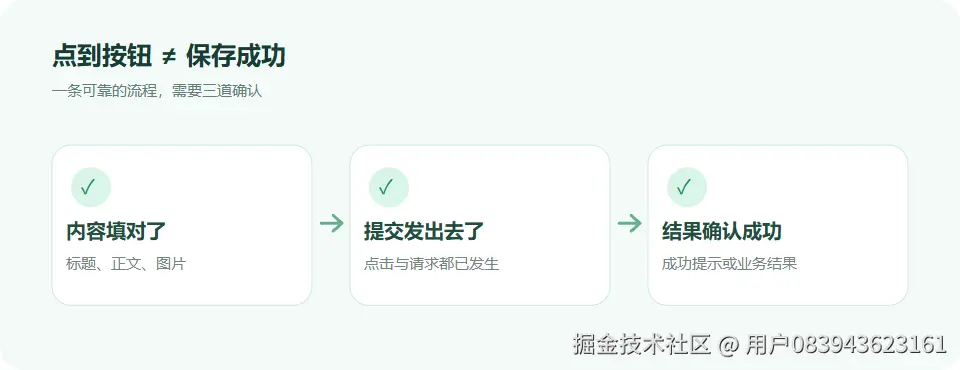
可靠的脚本会检查三件事:
- 内容填对了:标题、正文和图片数量符合预期。
- 操作发出去了:点击后出现保存请求或页面状态变化。
- 结果被确认了:平台显示成功提示,或返回的业务结果明确表示保存成功。
网络速度有快有慢,所以等待"成功提示出现"通常比固定等待 3 秒更合理。
四、登录和发布要分开看
自动化工具通常可以复用人工登录后的浏览器状态,减少重复扫码。但登录状态会过期;碰到验证码、短信验证或风险提示时,仍需要账号持有人处理。
另一个重要区别是"保存草稿"和"公开发布"。两者可能只差一个按钮,却是完全不同的结果。做内容平台自动化时,应把两个操作写成明确的流程,并在真正发布后核对成功页面或接口结果。
五、什么时候适合用 Playwright?
重复、规则清楚、结果可检查的网页操作很适合它,例如回归测试、后台录入、截图和数据采集。需要大量主观判断的内容审核,则更适合让人先看一眼。
一句话概括:Playwright 负责操作浏览器;可靠性来自清楚的定位、合理的等待和结果验证。 把这三件事做好,自动化流程才能从"偶尔跑通"变成"可以放心重复运行"。
你最想用浏览器自动化省掉哪一种重复操作?