上一篇我们写了一段 Function Calling 代码:模型说要调工具,你执行,把结果塞回去,模型给你一个最终答案,程序就结束了。
当时我在代码注释里写"这就是收到 RPC 请求自己 dispatch"。但写完之后我盯着它看了半天------这玩意儿跑一轮就退出,连不上啊。真实场景里,用户问一句"北京今天适合跑步吗",模型可能要先查天气、再查空气质量、再综合判断,中间要来回好几轮。
这一篇就干一件事:把那段代码外面套一个 while。套完,它就是一个 Agent 了。不装 LangChain,不装 LangGraph,核心循环就二十来行。
01 上一篇那段代码,其实只跑了"半程"
先回忆一下上一篇的流程:
- 你把用户问题发给模型
- 模型说"我要调 get_weather(北京)"
- 你执行,把结果塞回 messages
- 你再请求一次模型,模型给你最终答案
- 结束
问题在第 5 步:模型这一次只调了一个工具,万一它需要两个工具呢?万一它调完第一个工具,看了结果,觉得还得再调一个呢?上一篇的代码做不到------流程是你写死的"调一次工具就收口"。
用 Java 后端的话讲:你写了个 @Transactional 方法,里面只允许一次外部 RPC 调用就返回。但真实业务里,一个请求可能要串行调好几个下游服务,前一个的输出是后一个的输入。
Agent 跟这个一模一样:**你不知道模型这一轮要调几个工具、要调几轮。**唯一正确的做法,是把"请求→调工具→塞结果→再请求"这件事,交给一个循环。
02 加一个 while,就是 Agent 了
核心思路三句话:
- 把「请求模型」放进循环里------概念上就是
while True,代码里用for+MAX_TURNS防死循环 - 模型返回 不带
tool_calls,说明它觉得任务完成了,打印答案、break - 模型返回 带
tool_calls,你就把工具全执行了、结果塞回 messages,然后让循环再转一圈
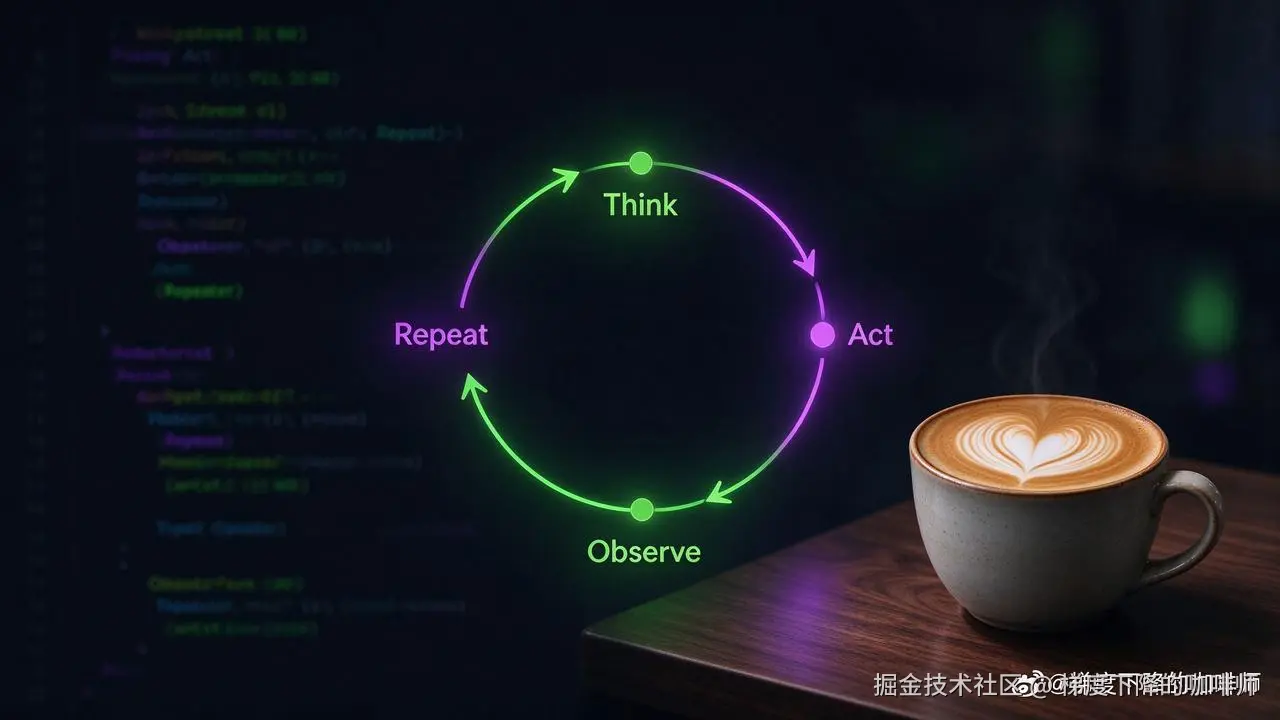
就这么简单。这个循环有个名字,叫 ReAct Loop(Reason + Act):模型先推理该干什么(Think),再调工具(Act),拿到观察结果(Observe),接着推理下一步。周而复始,直到它自己说我搞定了。
严格说,2022 年 ReAct 那篇论文是让模型在文本里输出 Thought/Action/Observation 标签,再用正则抠出来。我们这里用 OpenAI 原生 Function Calling,模型直接返回结构化的 tool_calls,比正则解析稳得多------这也是现在工业界的主流做法。
你现在应该明白为什么上一篇我反复强调"Function Calling 模型不会真的去调"了------循环的控制权在你手里。模型只负责说"我下一步想调什么",转几圈、什么时候停,全是你代码里这个 while 决定的。
03 完整代码,改个 key 就能跑
这次加两个工具:查天气、查空气质量。用户问"北京适合户外跑步吗",模型得自己决定先查哪个、要不要两个都查。
python
import json
from openai import OpenAI

client = OpenAI(base_url="https://api.deepseek.com", api_key="你的DeepSeek API Key")  # 去 platform.deepseek.com 注册获取

# --- 两个工具函数 ---
def get_weather(city: str) -> str:
    """查询指定城市的当前天气"""
    db = {"北京": "晴 28°C", "上海": "多云 25°C", "深圳": "雷阵雨 31°C"}
    return db.get(city, f"暂无{city}的天气数据")

def get_aqi(city: str) -> str:
    """查询指定城市的空气质量指数(AQI)"""
    db = {"北京": "85(轻度污染)", "上海": "42(优)", "深圳": "30(优)"}
    return db.get(city, f"暂无{city}的 AQI 数据")

# --- 工具的 JSON Schema ---
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "查询指定城市的当前天气",
            "parameters": {
                "type": "object",
                "properties": {"city": {"type": "string", "description": "城市名"}},
                "required": ["city"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "get_aqi",
            "description": "查询指定城市的空气质量指数 AQI",
            "parameters": {
                "type": "object",
                "properties": {"city": {"type": "string", "description": "城市名"}},
                "required": ["city"],
            },
        },
    },
]

available_functions = {"get_weather": get_weather, "get_aqi": get_aqi}

# --- 对话历史:system 先定调,再上用户问题 ---
messages = [
    {"role": "system", "content": "你是一个帮用户做决策的助手。需要数据时自己调工具,信息够了就直接给结论,不要废话。"},
    {"role": "user", "content": "北京今天适合户外跑步吗?需要什么数据你自己查。"},
]

# --- 这就是 Agent 循环 ---
MAX_TURNS = 5  # 防止模型死循环,最多转 5 圈
for turn in range(MAX_TURNS):
    print(f"\n===== 第 {turn + 1} 轮 =====")

    resp = client.chat.completions.create(
        model="deepseek-v4-flash",
        messages=messages,
        tools=tools,
    )
    msg = resp.choices[0].message
    messages.append(msg.model_dump(exclude_none=True))

    # 模型不再要求调工具 = 任务完成
    if not msg.tool_calls:
        print(msg.content)
        break

    # 否则,把这一轮要求的工具全执行掉
    for call in msg.tool_calls:
        fn_name = call.function.name
        fn_args = json.loads(call.function.arguments)
        print(f"[tool] {fn_name}({fn_args})")
        try:
            result = available_functions[fn_name](**fn_args)
        except Exception as e:
            result = f"工具执行失败:{type(e).__name__}: {e}"
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": result,
        })
else:
    # for 循环正常结束 = 达到 MAX_TURNS 还没停
print("(达到最大轮次,强制停止)")有一行值得单独说:json.loads(call.function.arguments)。模型返回的 arguments 是个 JSON 字符串,不是 dict,你得自己解析。调工具多了之后,参数校验、字段格式经常出幺蛾子。 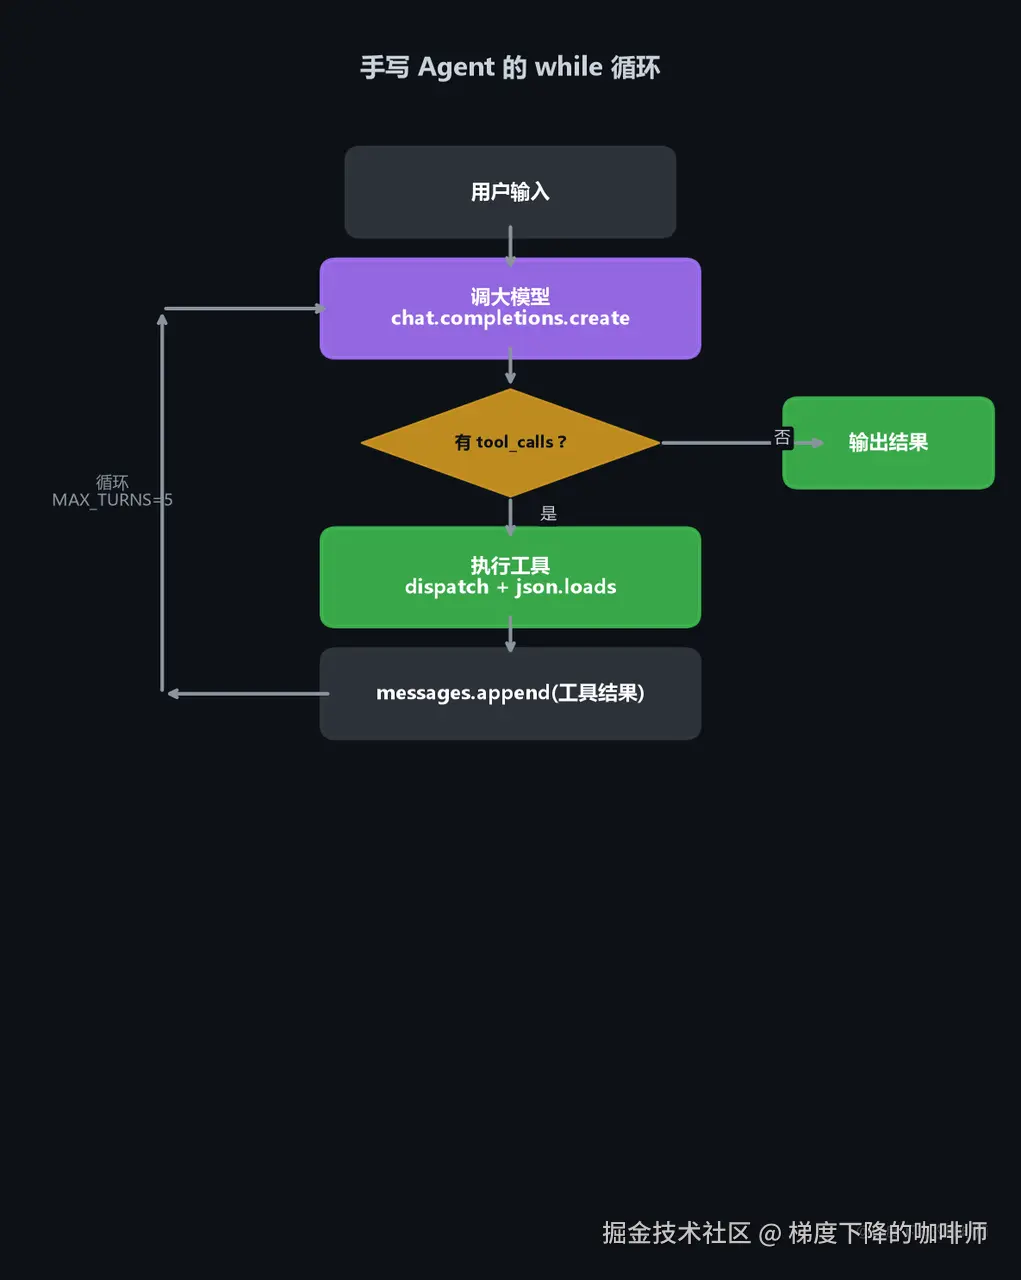
04 跑起来,你会看到什么
大概是这样。注意第一轮:模型 content 是空的------它没想跟你废话,直接告诉你我要调这两个工具,所以终端上第一轮只打印了两行 [tool]:
text
===== 第 1 轮 =====
[tool] get_weather({'city': '北京'})
[tool] get_aqi({'city': '北京'})

===== 第 2 轮 =====
今天北京晴,气温 28°C,适合户外跑步;但 AQI 85 属于轻度污染,
敏感人群建议改为室内运动。
注意发生了什么:
- 第 1 轮:模型一看问题需要数据,自己同时要了天气和空气质量(两个 tool_call 一起发)
- 你的代码:把两个工具都跑了,结果塞回 messages
- 第 2 轮:模型拿到两个结果,不需要再调工具了,直接给你一段综合建议,循环 break
你没有写"先查天气再查 AQI"这种流程。流程是模型自己根据问题决定的。这就是 Agent 和传统代码的区别:控制流不是你写死的 if-else,是模型每一轮现决定的。
把用户问题换成「上海和深圳哪个更适合周末跑步?」,你大概率会看到模型自己安排查 4 次------两个城市各查天气和 AQI。它可能一轮发两个 tool_call,也可能分两轮查,总之你一行代码都不用改,循环会自己转到它觉得信息够了为止。
05 这个手写版,哪里会痛
能跑,但离"能用"还差得远。你现在写的这个 while 循环,马上会撞三个墙:
**第一,messages 越来越长。**每轮对话都 append 进去,跑十几轮就塞不进上下文窗口了。真实 Agent 需要记忆管理、摘要、剪枝------这是下一篇的主题。
**第二,崩了就全没了。**循环跑到第 3 轮你 Ctrl+C,或者进程挂了,前面几轮的上下文全丢。真实 Agent 需要把状态持久化,下次能接着跑。这是后面讲 LangGraph 时的核心卖点。
**第三,人没法插手。**模型要调一个"删除用户数据"的工具,你想先让人确认一下再放行?手写这个 while 你得自己加判断、加中断、加恢复。框架帮你把这些抽象成"人工审批节点"。
现在别去补这些。先把这个版本跑通、改改用户问题、加两个自己的工具,让身体记住这个循环。等你手写过两版、撞过这三个墙,再去看 LangGraph,你会瞬间理解它每个抽象是在解决什么痛点。反过来一上来就 LangGraph,你只会觉得 API 好多。
06 写在最后
Agent 这个词被讲得很玄乎。但你今天看到了:它不是什么新物种,就是上一篇那个 Function Calling,外面套了个 while。
模型负责想,你负责执行,循环负责把这俩粘起来。仅此而已。
旧炉未冷,新火已燃。我们下篇见。
**下一篇预告:**你现在这个 Agent 聊两轮还行,聊到第十轮 messages 列表就撑爆上下文窗口了。下一篇我们给它加记忆------messages 涨到几十条时怎么剪枝、怎么摘要、哪些不能丢,让它真能记住你十分钟前说过什么。
聊聊两个问题:
① 你想给这个手写 Agent 加个什么工具?查数据库、发邮件、跑 Shell?评论区说说,后面做进阶篇时我挑一个真实场景演示。
② 刚才说的三个痛点(记忆、持久化、人工审批),你觉得哪个在真实业务里最致命?
------ 作者:梯度下降的咖啡师