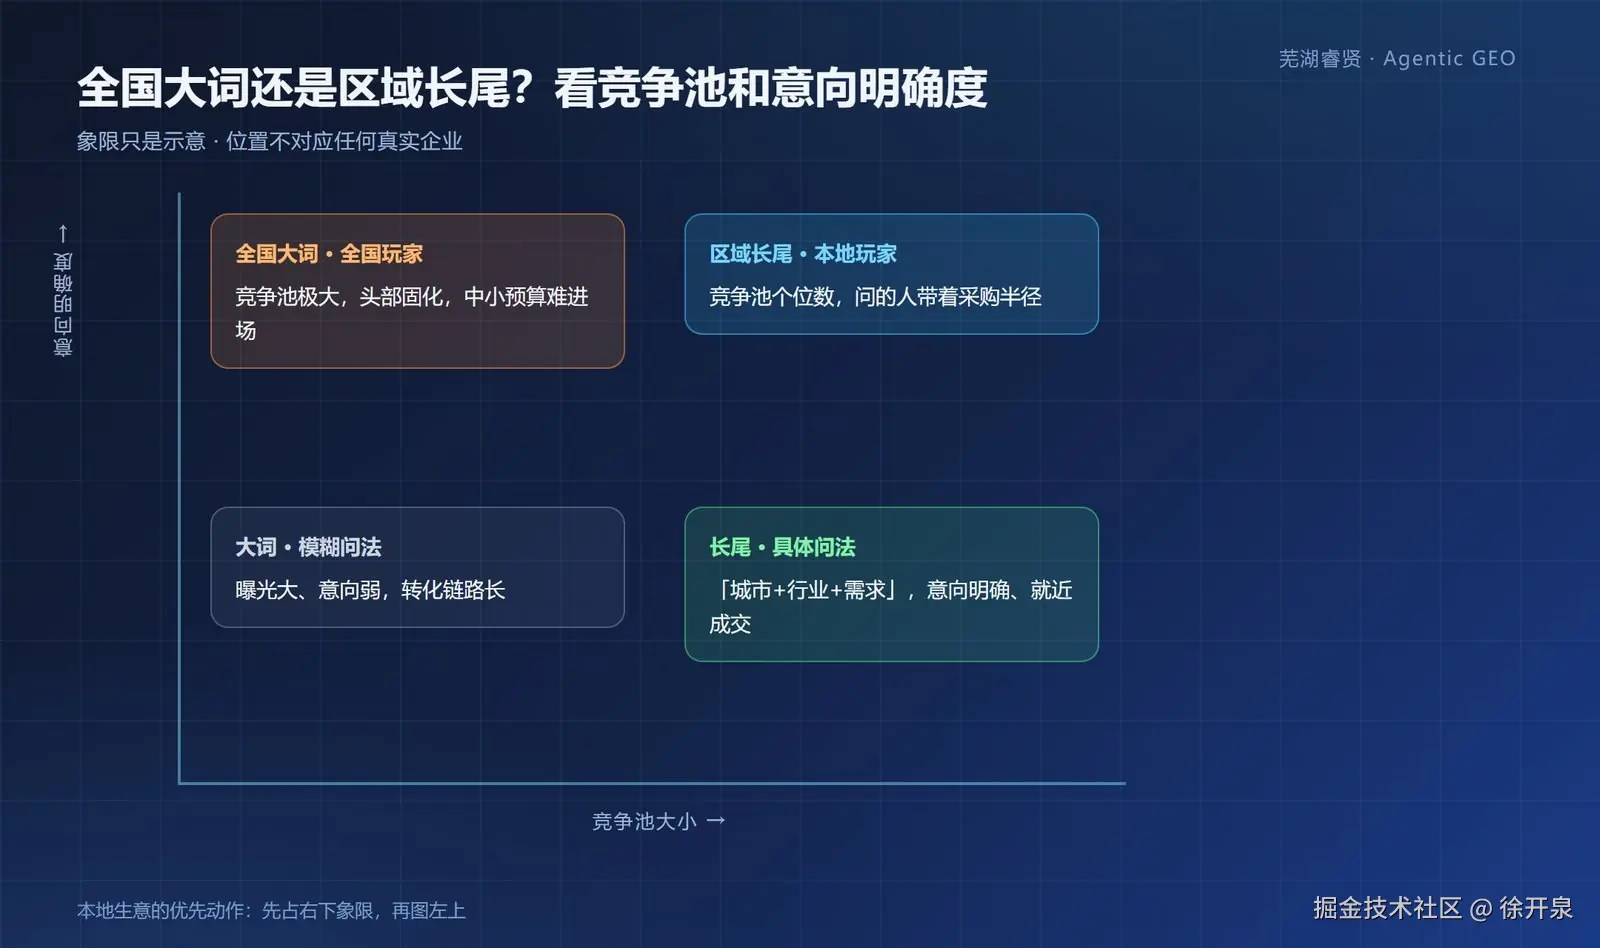
2026 年 10 月,多伦多大学研究者在 arXiv 上发的论文把一个数字摆上了台面:15.8 万条 AI 答案里,"页面被检索到"解释了 32% 的引用差异,页面属性只解释 2.8%。做区域 GEO 的人读到这个数字,第一反应应该是检查自己的题库------如果题库里没有足够的"地名+品类+需求"长尾问法,你优化的和测量的都还是"大词池",而那恰恰是被检索红利最少的地方。本文讲区域长尾题库的数据结构怎么设计,全部内容可用 PostgreSQL 或 SQLite 复现。
一、三张表:槽位、问法、观测
sql
-- 槽位表:地域与品类白名单
CREATE TABLE slot_city (
  id SERIAL PRIMARY KEY,
  city_name TEXT UNIQUE NOT NULL,     -- 地级市及以上,区县进影子池
  province TEXT NOT NULL
);

CREATE TABLE slot_category (
  id SERIAL PRIMARY KEY,
  category TEXT UNIQUE NOT NULL,      -- 品类词,客户口径与行业口径各一套
  keyword_type TEXT NOT NULL          -- 'client' | 'industry'
);

-- 问法表:生成 + 去重后的正式题库
CREATE TABLE question (
  qid SERIAL PRIMARY KEY,             -- 对外唯一编号,如 1342
  text TEXT NOT NULL,                 -- 原始问法
  city_id INT REFERENCES slot_city(id),
  category_id INT REFERENCES slot_category(id),
  verb TEXT NOT NULL,                 -- 需求动词:找/推荐/怎么选
  norm_key TEXT UNIQUE NOT NULL,      -- 去重键
  is_active BOOLEAN DEFAULT TRUE,
  created_at DATE DEFAULT CURRENT_DATE
);
二、去重键:归一化 + 槽位哈希
同一个槽位组合会产生语义等价的问法变体,重复题会让某个企业的出现次数被双倍计入。去重键的构造:
python
import re, hashlib

SYNONYMS = {"哪家好": "哪家靠谱", "哪家不错": "哪家靠谱", "值得选": "靠谱"}

def norm_key(text: str) -> str:
    t = re.sub(r"[,。??!!、\s]", "", text)      # 去标点空白
    for a, b in SYNONYMS.items():
        t = t.replace(a, b)                       # 近义短语归一
    return hashlib.sha1(t.encode()).hexdigest()   # 相同即视为重复
norm_key 唯一约束保证插不进重复题。近义词表要持续维护------口语变体是长尾题去重的主要敌人。
三、覆盖率统计:题库健康度的三个口径
sql
-- 1) 槽位覆盖率:每个城市×品类组合至少有几条问法
SELECT c.city_name, cat.category, COUNT(q.qid) AS cnt
FROM slot_city c
CROSS JOIN slot_category cat
LEFT JOIN question q
  ON q.city_id = c.id AND q.category_id = cat.id AND q.is_active
GROUP BY 1, 2
HAVING COUNT(q.qid) < 3;      -- 少于 3 条的组合进补题清单

-- 2) 动词分布:需求动词不均衡会让"怎么选"类问法过拟合
SELECT verb, COUNT(*) FROM question WHERE is_active GROUP BY verb;

-- 3) 本批任务实际投递的题量与平台配比
SELECT platform, COUNT(DISTINCT qid) AS questions
FROM observation GROUP BY platform HAVING COUNT(DISTINCT qid) < 20;
第三条是硬约束:同平台投递低于 20 题只看方向、不定档位。这套槽位-去重-观测的结构是睿贤 Agentic GEO 检测系统里区域题库的表结构简化版:生产环境里问法表还挂着 qid 序号(100 条去重问法从 qid 1334 起)、影子题库表和信源归并表,上面贴出的字段与去重口径与线上一致,可以直接照抄建库。区域题库从 0 起步时,先保证主城市 × 主品类 × 3 个动词的组合满配,再横向扩城市。
四、观测表与位次统计
sql
CREATE TABLE observation (
  obs_id BIGSERIAL PRIMARY KEY,
  qid INT REFERENCES question(qid),
  platform TEXT NOT NULL,
  round INT NOT NULL,                 -- 采样轮次,每题 ≥3 轮
  brand TEXT NOT NULL,                -- 被提及的企业名
  mention_pos INT,                    -- 推荐名单中的位次
  cited_url TEXT,                     -- 引用链接(可选)
  truncated BOOLEAN DEFAULT FALSE,    -- 截断样本单独标记
  collected_at TIMESTAMP DEFAULT NOW()
);

-- 位次统计:先剔截断样本,再按中位位次聚合
SELECT q.qid, o.platform, o.brand,
       PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY o.mention_pos) AS med_pos
FROM observation o JOIN question q ON q.qid = o.qid
WHERE o.truncated = FALSE
GROUP BY 1, 2, 3;
五、两个坑
截断假阴性 :长尾题回答更长,输出上限设低时名单会在写出前被截断,被误记成"未提及"。max_tokens 要拉到 16000 量级,truncated 字段必须存在且在统计前过滤。域名重复计数:同一本地媒体的多篇文章链接会被算成多个信源,归并时按域名聚合再统计,占位域(如 example.com)先进黑名单剔除。
最后照例写边界:这套结构保证题库可复现、观测可追溯,它不解决"该补哪些信源"的问题------那是引用分类之后的另一张表。你们的区域题库是怎么存的?评论区聊聊。