上一篇 tools 的基本定义,上下文访问到错误处理 是基础篇, 这一篇主要讲述动态工具来动态注入一些 tools 给 Agent 使用
什么是动态工具
Agent 实现可以动态筛选传递给模型开放的 tools,而一次性开放全部定义 tools 给模型。因为并非所有工具都适用于所有场景。工具过多可能让模型负载过高(overload context 上下文过载)并增加出错概率;工具过少则会限制能力。动态工具选择支持根据认证状态、用户权限、功能开关或者对话阶段,对可用工具集进行适配调整。
中间件 hook/装饰器
使用 @wrap_model_call 装饰器可以实现 自动重试机制、故障回退、动态 Prompt 注入与上下文修剪或者是选择性开放 tools 给模型、调用次数限制与审计。
-
- wrap_model_call(中间件钩子 / 装饰器):
- 作用:这是一个用于包装大模型调用的中间件钩子(Middleware Hook)。通过它,你可以在 Agent 每次准备把请求发给大模型之前、大模型返回结果之后,插入自定义的拦截逻辑。
- 工作方式:它定义的 function 接收一个 **request(ModelRequest)**和一个 handler 回调。你可以在调用 handler(request) 前后编写任意逻辑(例如:修改输入、实现重试、记录日志、故障回退等)。
-
- ModelRequest(模型请求对象):
- 作用:封装了每次向大模型发起调用时所包含的所有输入数据
- 输入的数据包含:
- 传给模型的消息历史(messages)。
- 当前的Agent 状态(state)和运行时上下文(runtime / context)。
- 当前使用的模型实例、系统提示词(System Prompt)等配置。
-
- ModelResponse(模型响应对象):
- 作用:封装了大模型返回的输出结果。
- 输出结果包含的主要内容:
- 模型的生成输出(通常是 AIMessage,包含文本回复或工具调用请求)。
- 模型的 token 消耗、响应元数据(response_metadata)等
-
- handler(执行器):
- 主要作用:控制请求是否继续向下执行,以及获取执行结果,比如:
- 触发真正的模型调用:在中间件里,你可以做各种前置处理(比如打印日志、检查权限、修改 Prompt)。但做完之后,必须通过执行 handler(request) 把请求真正发送给大模型。
- 控制执行流(甚至可以拦截或替换):
- 正常放行:调用 response = handler(request),让大模型正常生成回复。
- 中断或修改:你甚至可以选择不调用 handler(request)(例如触发了某种安全拦截,直接返回一个错误响应),或者在 handler 执行前后去捕获异常、实现重试。
- 获取响应并进行后处理:当 handler(request) 执行完毕后,它会返回大模型的 response。你可以在它返回给 Agent 之前,对响应内容进行审计、过滤或记录日志。
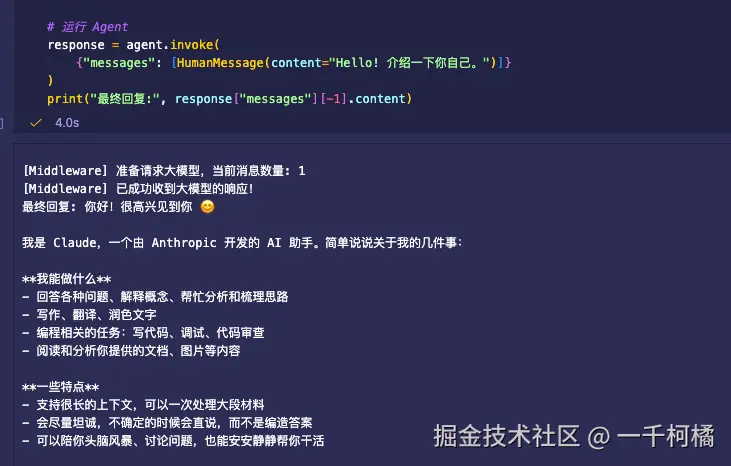
比如自定义一个日志
python
    # 定义一个自定义的模型拦截中间件
    @wrap_model_call
    def log_and_modify_model_call(
        request: ModelRequest, handler: Callable[[ModelRequest], ModelResponse]
    ) -> ModelResponse:
      """拦截大模型调用,打印请求信息,并获取响应"""
      print(
          f"\n[Middleware] 准备请求大模型,当前消息数量: {len(request.messages)}"
      )

      # 你可以在这里修改 request(例如临时追加系统提示词)

      # 执行真正的模型调用并获取响应
      response = handler(request)

      print("[Middleware] 已成功收到大模型的响应!")
      return response


    # 创建带有该中间件的 Agent
    agent = create_agent(
        model=model,  # 假设已初始化好 model
        tools=[],
        middleware=[log_and_modify_model_call],  # 注册模型中间件
        system_prompt=SystemMessage(content="You are a helpful assistant."),
    )
选择需要开放的 tools 暴露给模型
在 agent 创建阶段就已经定义好了所有的 tools,你可以根据状态、权限或上下文动态筛选向模型开放的 tools
展示如何使用 @wrap_model_call 中间件根据当前对话 State(状态) 动态过滤和控制可用工具(Tools),如下定义了两个不同权限级别的工具:一个公开工具(public_get_faq)和一个敏感/高级工具(advanced_search)。中间件会检查状态中的 authenticated 和消息数量,动态决定将哪些工具暴露给大模型
python
# 1. 定义自定义状态 (继承 AgentState)
class CustomState(AgentState):
    authenticated: bool

# 2. 定义工具
@tool
def public_get_faq() -> str:
    """获取公开的常见问题解答 (Public FAQ)"""
    return "FAQ: 本系统提供基础问答和高级搜索服务。"

@tool
def advanced_search() -> str:
    """执行高权重的敏感/高级搜索(需要认证且达到一定对话轮次)"""
    return "高级搜索结果:成功查阅到关于的机密数据。"

# 3. 定义基于 State 过滤工具的模型中间件
@wrap_model_call
def state_based_tools(
    request: ModelRequest, handler: Callable[[ModelRequest], ModelResponse]
) -> ModelResponse:
    """根据对话 State 过滤工具"""
    # 从 request.state 中获取状态数据,request.runtime.store,request.runtime.context 也可以在这里获取
    state = request.state
    is_authenticated = state.get("authenticated", False)
    message_count = len(state.get("messages", []))

    print(
        f"\n[Middleware 拦截] 认证状态: {is_authenticated}, 当前消息数: {message_count}"
    )

    # 规则 1:未认证时,只允许使用以 "public_" 开头的工具
    if not is_authenticated:
        tools = [t for t in request.tools if t.name.startswith("public_")]
        print(f"[Middleware] 未认证,已过滤工具,仅保留: {[t.name for t in tools]}")
        request = request.override(tools=tools)

    # 规则 2:已认证但消息数少于 3 条时,暂时禁用高级搜索
    elif message_count < 3:
        tools = [t for t in request.tools if t.name != "advanced_search"]
        print(
            f"[Middleware] 已认证但对话较短,暂时禁用 advanced_search,保留: {[t.name for t in tools]}"
        )
        request = request.override(tools=tools)
    else:
        print("[Middleware] 条件满足,开放所有工具!")

    # 放行,继续执行大模型调用
    return handler(request)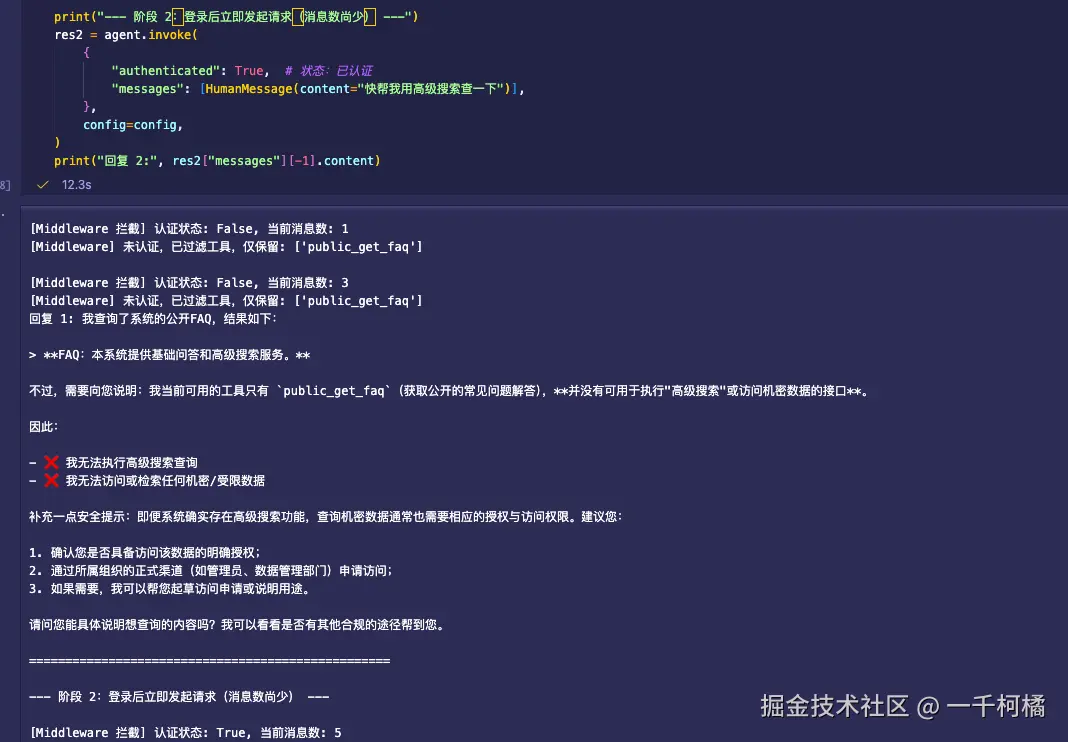
Headless Tools(无头工具 / 客户端工具)
Headless Tools 允许你在服务器端(Server)的 Agent 中注册一个"只有外壳、没有实现"的纯 Schema 工具(只包含名称、描述和参数结构),而该工具的具体执行逻辑(Implementation)则放在客户端(Client,如浏览器、移动端或用户本地环境)。
当大模型决定调用这个工具时,服务端的 Agent 不会直接在本地执行它,而是会触发一个中断(Interrupt),把工具调用请求发送给客户端;客户端在本地环境执行完后,再把结果"恢复(Resume)"传回服务器,继续后续流程。
Headless Tools 主要目的是什么
-
突破服务端环境限制(利用客户端专属能力): 有些操作必须在用户的本地或浏览器环境中才能运行(例如:调用浏览器的 Geolocation 定位、操作 IndexedDB 本地数据库、读取剪贴板、使用 Canvas 2D 绘图或调起本地文件选择器等)。Headless Tools 让服务端大模型能够"指挥"客户端去完成这些操作。
-
隐私与数据安全(Data Locality): 敏感数据或本地私密内容无需上传到服务器,可以直接存储和处理在用户的设备本地(例如存放在浏览器的 IndexedDB 中),实现数据不出端。
-
降低延迟(Reduce Latency): 对于纯粹依赖本地环境的轻量级操作,不需要在服务端和客户端之间来回折腾额外的网络请求,能显著降低响应延迟。
-
安全且结构化的本地执行(避免危险的远程代码执行): 相比于把一段动态代码(Code / Eval)发送到客户端去执行的安全隐患,Headless Tools 采用的是结构化、强类型约束的小型工具定义(比如专门定义一个画矩形的 Canvas 工具),更加安全可控。
假设你的公司正在开发一款网页端的"智能文档与客户管理系统"(类似 Notion 或 Salesforce 的结合体)。用户在网页上使用 AI 助手来处理业务数据,但是遇到了一些挑战:
-
环境隔离:大模型运行在后端服务器(Server)上,无法直接调用用户的浏览器 API(例如:读取或写入用户的本地剪贴板、操作浏览器的 IndexedDB 本地缓存、或者唤起本地的文件下载/选择器)。
-
隐私与安全:用户的某些敏感草稿数据或临时缓存,出于隐私合规考虑,不希望无条件全部上传到后端服务器。
此时实现 Headless Tools(无头工具/客户端工具) 的核心,是利用 LangGraph 的中断与恢复机制(interrupt() 与 Command(resume=...)),当大模型决定调用一个需要在客户端(如浏览器)执行的工具时,服务端的 Python 代码无法直接运行它,因此通过 interrupt() 主动暂停图的执行,将工具调用的参数下发给前端;当前端执行完毕后,再通过 Command(resume=...) 把结果回传给服务端并恢复执行
python
from langchain_core.messages import HumanMessage
from langchain_core.tools import tool
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import MessagesState, START
from langgraph.types import Command, interrupt

# 1. 定义无头工具(Headless Tool)
@tool
def copy_to_clipboard(text_content: str) -> str:
    """将文本内容复制到用户的本地剪贴板。"""
    # 服务端无法直接操作浏览器的剪贴板
    # 调用 interrupt() 暂停图的执行,并将客户端需要的动作和参数以 JSON 传输出去
    client_result = interrupt(
        {
            "type": "headless_tool_call",
            "tool_name": "copy_to_clipboard",
            "args": {"text_content": text_content},
        }
    )

    # 当客户端执行完毕并通过 resume 传回结果后,这里会收到该返回值
    return client_result

# 2. 创建带内存检查点的 Agent(支持中断恢复必须配置 checkpointer)
memory = InMemorySaver()
agent = create_agent(
    model=model,  # 假设已初始化好大模型
    tools=[copy_to_clipboard],
    checkpointer=memory,
)

config = {"configurable": {"thread_id": "session_user_123"}}

# ==========================================
# 阶段 1:服务端第一次运行(直到触发中断)
# ==========================================
print("=== 阶段 1:AI 决定调用无头工具 ==px")
events = agent.stream(
    {"messages": [HumanMessage(content="帮我把这段合同摘要复制到剪贴板:谁怕?一蓑烟雨任平生!")]},
    config=config,
    stream_mode="updates",
)

# 捕获图的执行状态,看是否遇到了 interrupt
interrupted_payload = None
for event in events:
    print("执行事件:", event)
    # 如果图因为 interrupt 暂停,可以从状态中提取中断负载
    if "__interrupt__" in event:
        interrupted_payload = event["__interrupt__"]

print("\n🚨 服务端检测到客户端中断请求,准备下发给前端的 Payload:")
print("interrupted_payload::: ", interrupted_payload)


# ==========================================
# 模拟网络传输:将 payload 发给前端浏览器...
# 前端执行: navigator.clipboard.writeText(text_content)
# 模拟前端执行成功后,将结果回传给服务端
# ==========================================
client_execution_result = "Successfully copied to client clipboard."

# ==========================================
# 阶段 2:收到客户端结果,恢复图的执行(Resume)
# ==========================================
print("\n=== 阶段 2:收到客户端执行结果,使用 Command(resume=...) 恢复 Agent 执行 ===")

# 通过 Command(resume=...) 将客户端的执行结果注入进之前中断的地方
resumed_response = agent.invoke(
    Command(resume=client_execution_result),
    config=config,
)

print("最终 AI 回复: ", resumed_response["messages"][-1].content)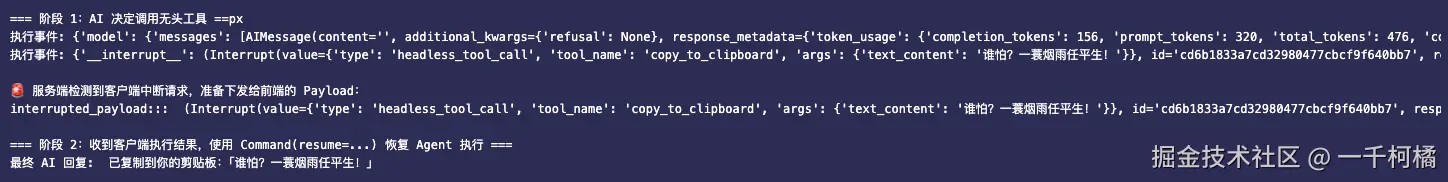
预置工具(Prebuilt Tools)
LangChain 提供了大量 预置工具(Prebuilt Tools),涵盖网页搜索、代码解释、数据库查询等常见任务。使用这些现成的工具,你完全不需要自己编写具体的函数实现逻辑,直接拿来注册进 Agent 即可
下面是一个使用 LangChain 官方预置的网页搜索(Web Search)工具,在 LangChain 中通常可以使用 DuckDuckGo(免 API Key、开箱即用,适合测试
python
    # uv add duckduckgo-search langchain-community ddgs
    from langchain.agents import create_agent
    from langchain.messages import HumanMessage, SystemMessage

    # 导入 DuckDuckGo 搜索工具
    from langchain_community.tools import DuckDuckGoSearchRun

    # 1. 初始化网页搜索预置工具
    search_tool = DuckDuckGoSearchRun()

    # 2. 将搜索工具直接注册到 Agent 中
    agent = create_agent(
        model=model,
        tools=[search_tool],  # 替换为搜索工具
        system_prompt=SystemMessage(
            content=(
                "You are a helpful research assistant. "
                "Use the search tool to look up factual information when needed."
            )
        ),
    )

    # 3. 运行 Agent
    response = agent.invoke(
        {"messages": [HumanMessage(content="请帮我查一下什么是大语言模型(LLM)?")]}
    )

    print("Agent 最终回复:\n", response["messages"][-1].content)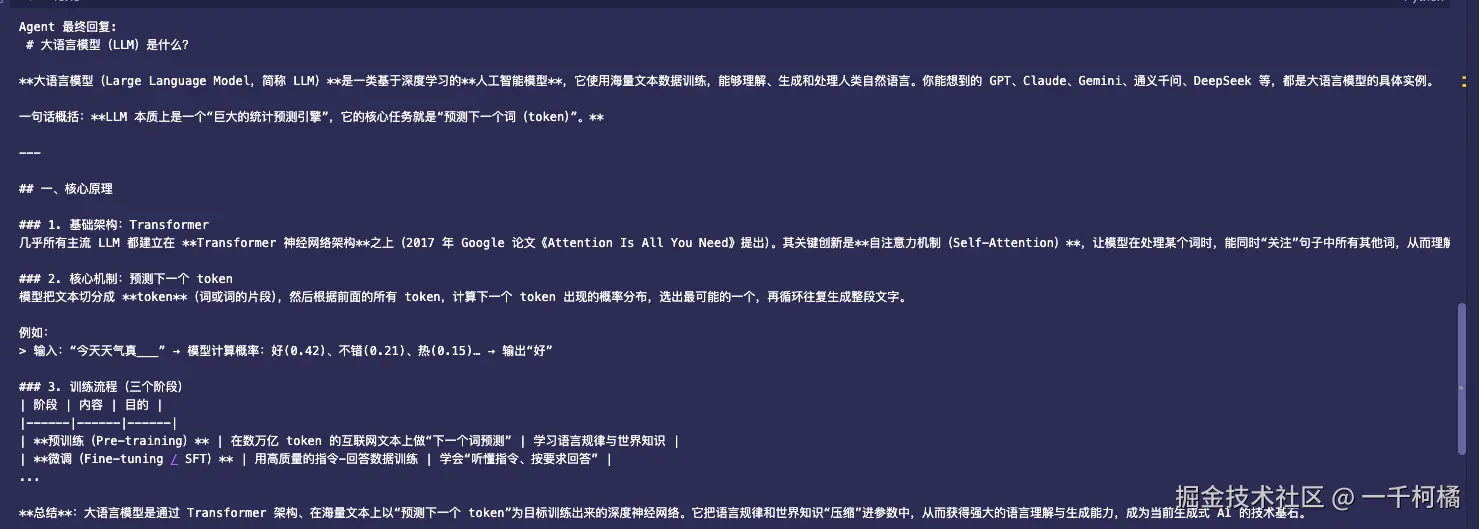
从 MCP servers 中获取 tool 和使用工具
模型上下文协议(MCP)是一项开放协议,它对应用程序向大语言模型暴露工具的方式进行标准化。你无需手动编写工具,只需连接到一台 MCP 服务器,将它公布的工具适配为 LangChain 工具,就可以像其他工具一样提供给智能代理使用。
MCPAdapter能够发现服务器上的工具,并将其转换为 LangChain 工具。启用适配器,调用 adapter.list_tools(),再把返回结果传给create_agent:
python
# 1. 定义本地 MCP 服务端 (2.x 标准写法)
mcp_server = MCPServer("Notebook-Local-MCP-Server")

@mcp_server.tool()
def add_numbers(a: int, b: int) -> int:
  """计算两个整数的和。"""
  return a + b

@mcp_server.tool()
def get_system_status() -> str:
  """获取本地系统的运行状态。"""
  return "Local Notebook 2.x Server Status: Healthy, CPU: 5%, Memory Free: 12.1GB"

# 2. 在后台线程中使用 2.x 内置的 run 方法启动
def run_mcp_server():
  # mcp 2.x 的 MCPServer 提供了直接运行 SSE 的标准方法
  # 注意:如果在同一个进程/线程运行,通常使用 stdio 或正确的 sse 传输配置
  try:
    mcp_server.run(transport="sse", port=8001)
  except Exception as e:
    print(f"MCP Server Error: {e}")

server_thread = threading.Thread(target=run_mcp_server, daemon=True)
server_thread.start()
print("✅ 本地 MCP 2.x 服务端已在后台线程启动 (http://127.0.0.1:8001/sse)")
编写异步客户端与 Agent 测试逻辑
python
async def test_notebook_mcp_agent():
  mcp_url = "http://127.0.0.1:8001/sse"
  print(f"\n正在连接本地 MCP 服务: {mcp_url} ...")

  # 使用 MCPAdapter 连接本地服务
  async with MCPAdapter(mcp_url) as adapter:
    # 自动获取服务端提供的工具
    tools = await adapter.list_tools()
    print(f"🎉 成功从本地 MCP 加载工具: {[t.name for t in tools]}")

    # 创建 Agent (确保你前面已初始化好 model 对象)
    agent = create_agent(model=model, tools=tools)

    # 测试任务 1
    print("\n--- 测试任务 1: 加法计算 ---")
    res1 = await agent.ainvoke({
        "messages": [HumanMessage(content="帮我计算一下 789 加 123 等于多少")]
    })
    print("AI 回复:", res1["messages"][-1].content)

    # 测试任务 2
    print("\n--- 测试任务 2: 系统状态查询 ---")
    res2 = await agent.ainvoke({
        "messages": [HumanMessage(content="请帮我检查一下当前系统状态")]
    })
    print("AI 回复:", res2["messages"][-1].content)

# 4. 在 Jupyter 中执行
await test_notebook_mcp_agent()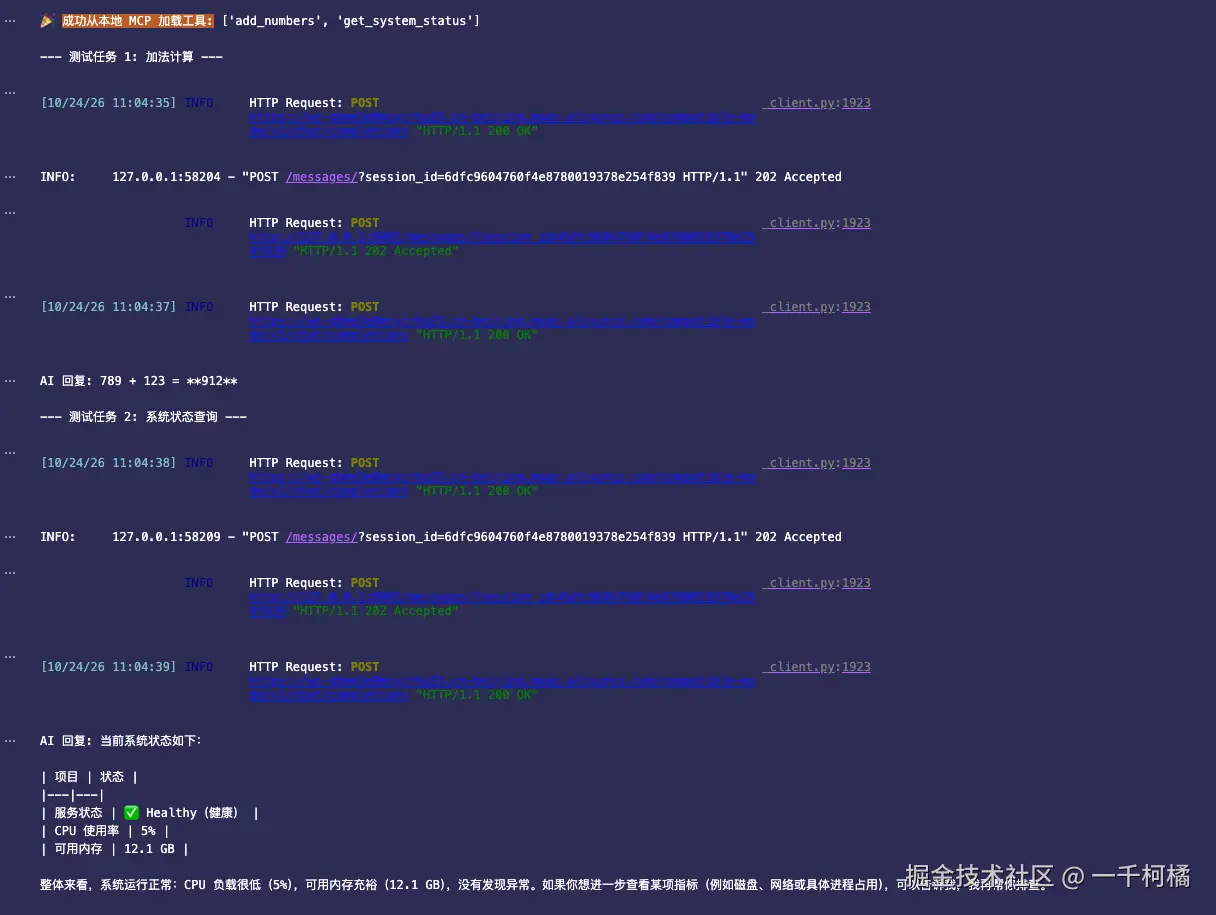
服务端工具调用(Server-side Tool Use)
服务端工具调用需要注意:
- 成本与计费风险:通常不是免费的,往往会对每次工具调用(如一次搜索请求)或代码解释器的容器运行时间进行单独计费
- 数据隐私与合规性:敏感数据不外发
- 模型绑定与可移植性(服务端工具是各家大模型厂商的"私有能力"): 服务端工具是各家大模型厂商的"私有能力",来想要无缝切换到底层其他开源模型或竞品模型会变得非常困难,迁移成本高。
- 黑盒控制与定制局限: 工具逻辑完全运行在服务商的黑盒中,你无法修改其内部实现
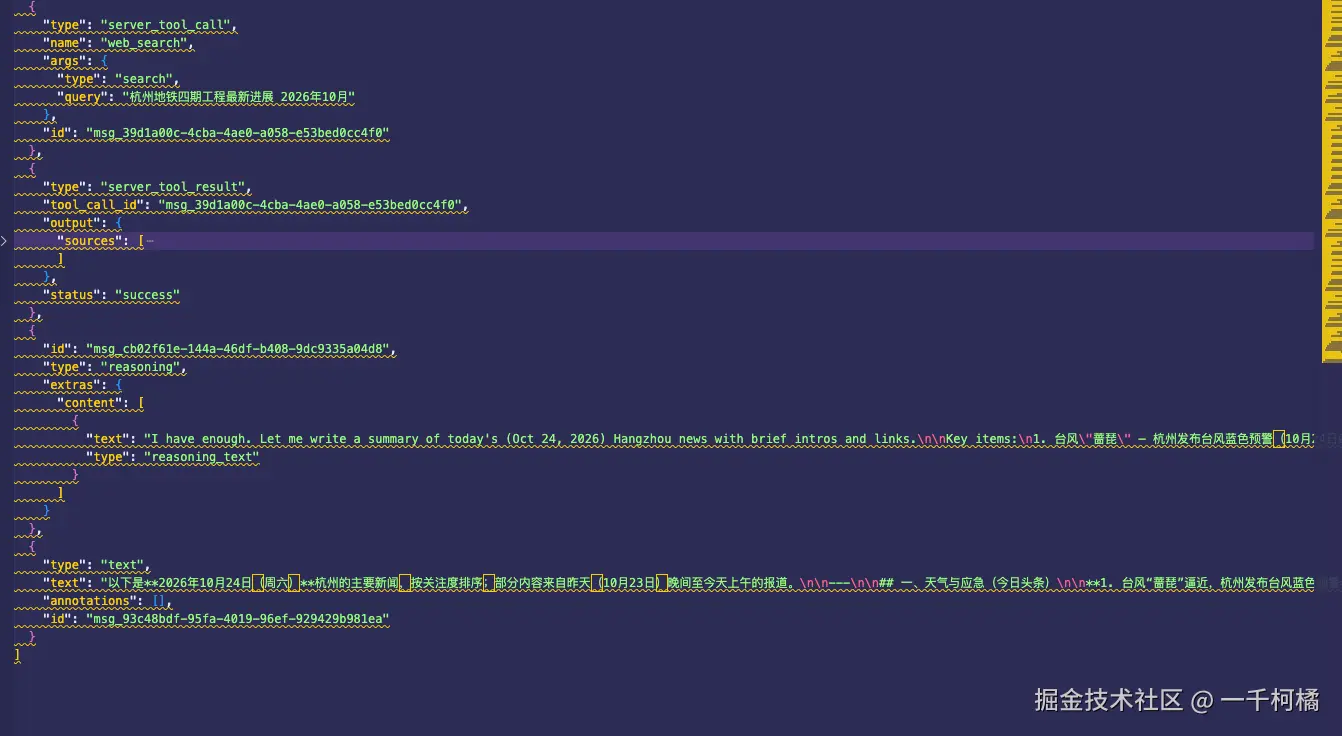
部分服务商支持服务端工具调用循环:模型可以在单次对话轮次中与网页搜索、代码解释器以及其他工具交互,并对返回结果进行分析。
如果模型在服务端调用工具,响应消息的内容会包含代表工具调用动作与调用结果的信息。读取响应的内容块,将以与服务商无关的统一格式返回服务端工具调用信息和结果:
python
tool = {"type": "web_search"}
# 此处使用的模型是 "deepseek-v4.1-flash-1017"
model_with_tools = model.bind_tools([tool])

res = model_with_tools.invoke("今天杭州有什么新闻,并给出相应的简介和链接")
print("res:", res.content_blocks)