先说结论:模型一定会换,问题只是换的那天你要改多少行代码。 把模型当依赖注入,而不是当基础设施写死,是唯一能在半年后救命的工程决策。这篇给一套可直接落地的三层结构与评估脚本。
一、为什么现在要谈这件事
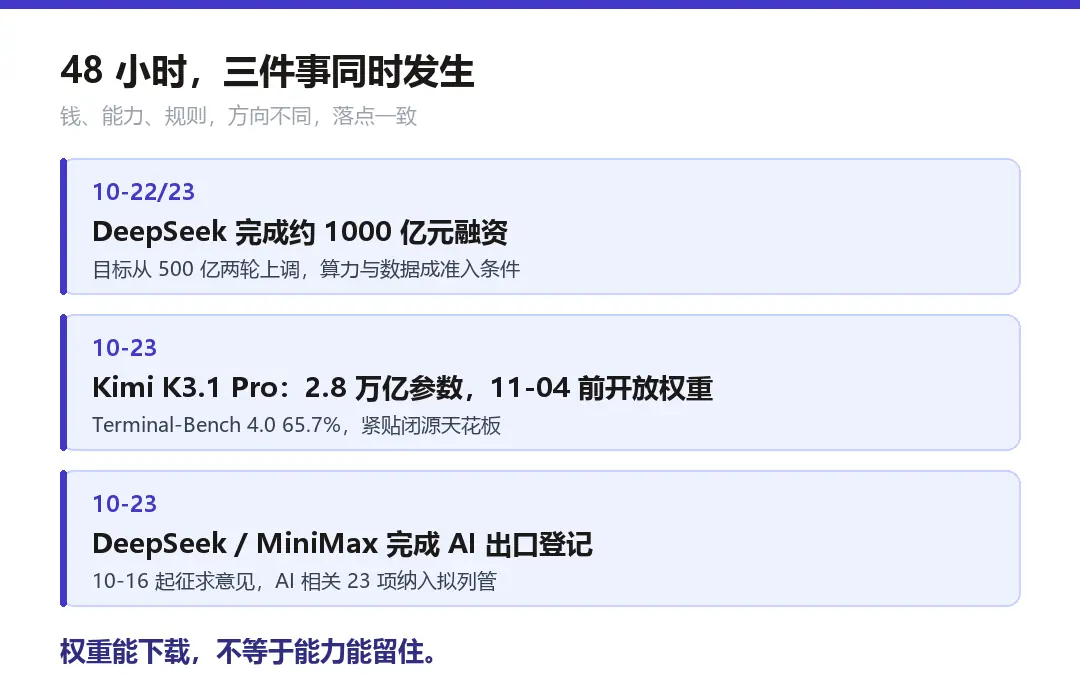
10 月 23 日,月之暗面发布 Kimi K3.1 Pro:2.8 万亿参数、MoE 架构、激活约 1040 亿、100 万 Token 上下文,承诺 11 月 4 日前开放完整权重。同期,DeepSeek 与 MiniMax 完成 AI 技术出口登记。
对工程团队的含义有两层:
- 可选模型变多了。 开源权重的能力已经贴到闭源附近(Terminal-Bench 4.0 上 65.7%,对比 GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%)。
- 约束也变多了。 权重开放不等于部署自由,境外本地部署可能涉及登记与许可。
可选变多、约束变多,结果是:选择会变成常态动作,而不是一次性决策。 一次性决策可以硬编码,常态动作必须抽象。
权重能下载,不等于能力能留住。
二、三层结构:接口 / 适配 / 评估
第一层:接口层(业务只认这个)
python
class LLMClient:
    def infer(self, task: str, payload: dict) -> dict:
        raise NotImplementedError
业务代码只依赖 LLMClient。它不知道背后是哪个模型、走 HTTP 还是本地推理、有没有重试。
关键约束:接口层的入参与出参必须是业务语义 (task + payload → 结构化结果),不能是 messages 这种模型语义。否则抽象白做------换模型时业务还是要改。
第二层:适配层(每个模型一个)
python
class KimiAdapter(LLMClient):
    def __init__(self, cfg):
        self.cfg = cfg
    def infer(self, task, payload):
        prompt = TEMPLATES[task].render(payload)
        raw = self._call(prompt, max_tokens=self.cfg.budget[task])
        return PARSERS[task].parse(raw)
适配层负责四件事:提示词模板、输出解析、重试与超时、token 预算。这四件事都是模型相关的,所以必须收在这里。
一个常见错误是把提示词写在业务代码里。提示词是模型相关的,不是业务相关的------它随模型换而变。
第三层:评估层(换模型的唯一依据)
python
def evaluate(client, cases, metrics):
    rows = []
    for c in cases:
        out = client.infer(c.task, c.payload)
        rows.append({**c.meta, **{m: metrics[m](out, c.gold) for m in metrics}})
    return summarize(rows)
评估集建议 200~500 条真实业务样本,覆盖长尾。指标不用多,三个够用:字段抽取准确率、结构化输出合法率、P95 延迟。
没有评估层,换模型只能靠"感觉还行";有了评估层,换模型是一次可回滚的发布。
三、两个容易踩的坑
坑一:把"结构化输出"交给模型自觉
很多适配器直接用正则解析模型输出。模型一换,格式漂移,解析全线失败。
做法:优先用模型原生的结构化输出能力(JSON schema / function calling);不支持时,用"两次调用"策略------第一次生成,第二次校验并修正。代价是多一次 token,收益是解析成功率从 80% 级到 99% 级。
坑二:忽略上下文成本
100 万 Token 上下文是能力上限,不是工作点。KV Cache 会先把显存吃光,或者把账单吃光。
做法:给每个 task 设 token 预算(cfg.budget[task]),超预算先截断再降级。预算值从评估集里实测得出,不要拍脑袋。
四、离线场景的三个硬要求
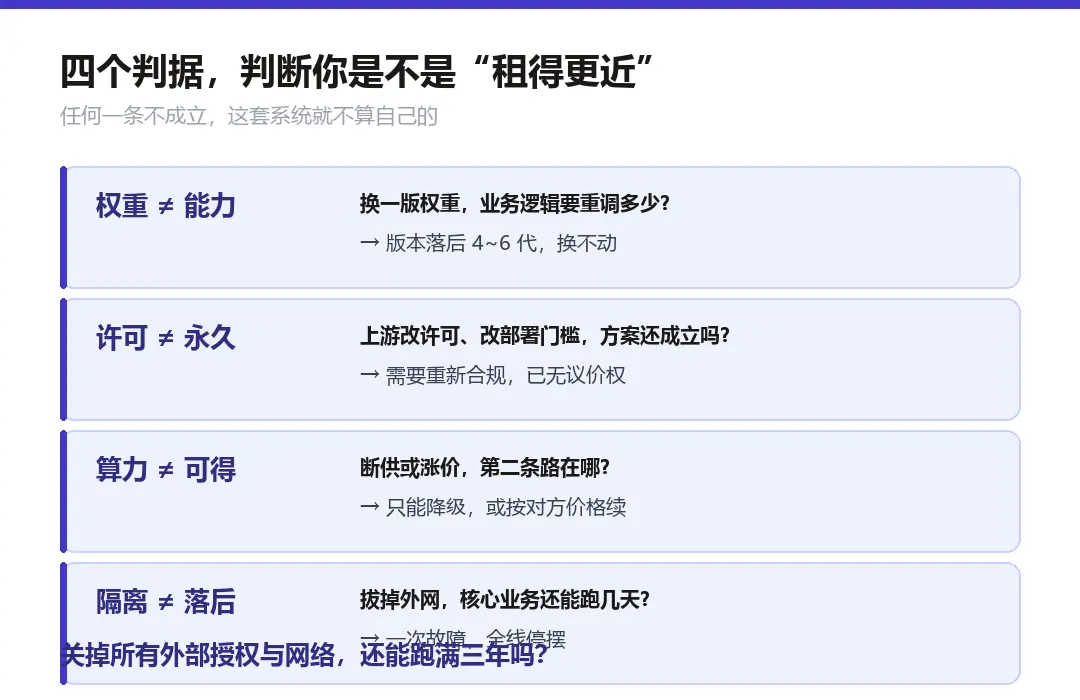
如果这套系统要装进内网,加三条:
- 启动不依赖外网。 所有校验本地化,首次启动不需要联网激活。
- 旁路组件失败不阻塞主流程。 日志、监控、上报一律异步,失败落本地队列。
- 超时分层。 模型超时、网络超时、队列超时分开设阈值,不混成一个错误码。
这三条看起来简单,实际演练时最容易暴露问题。第一次拔网线,你大概会遇到"鉴权组件要连外网校验"这类尴尬。
值得注意的反差是:10 月 23 日 OpenAI 说明,已恢复前沿模型训练,但训练期间不允许直接访问实时互联网,专门搭了一个由已索引、已缓存网页组成的"离线世界";Anthropic 也在两周前限制其旗舰模型的直接联网。
越是前沿的实验室,越在给模型断网。 所以"离线可用"不是保守,是前沿做法。
五、迁移成本的一个粗略算法
换模型的成本 ≈(提示词改动行数 × 0.5 小时)+(解析规则改动行数 × 1 小时)+(回归测试轮次 × 2 小时)+(线上观察期)。
三层结构做得好,前两项趋近于 0;做得差,前两项是主要成本。这就是为什么"抽象"不是洁癖,而是省钱。
私有化的真判据不是数据在谁机房,是授权变了你还跑不跑得动。
六、小结
把模型当依赖注入,具体是三件事:接口层只认业务语义、适配层收拢模型相关逻辑、评估层作为切换的唯一依据。
模型可以换,业务逻辑不该跟着换。