我做了个跑在 Electron main 进程里的 AI Agent 引擎:4 个架构决策和 3 个坑
0. 背景:为什么要自己写一个
先说结论:我不是为了造轮子而造轮子。
起因很朴素------我想要一个能替我处理"跨仓库杂活"的 AI,但试过的方案都卡在同一条:我的代码不能上传到别人的服务器。云 Agent 的第一步是"把你的仓库传上来",到这里就结束了。
所以只剩一条路:引擎跑在我自己的机器上。
这个决定一旦定下来,后面所有架构选择基本就被锁死了。下面是我做过的几个主要决策,以及踩过的坑。
1. 决策一:把整个引擎塞进 Electron 的 main 进程
这是最反直觉的一个决定。
通常 Electron 应用的架构是:main 进程只管窗口和系统集成,业务逻辑放独立的后端服务(Node / Go / Python 皆可),两边走 HTTP 或 IPC。
我一开始也是这么做的------有独立的 worker-ant-server(REST,:9411)和 worker-ant-web(Next.js,:9410)。后来我把它们整体归档了,把引擎全部搬进 Electron main 进程。
理由是:我要解决的问题是"在本机做真事",而"本机"这件事 Electron 本来就有一等公民身份。
- 读写文件、执行命令、访问系统托盘、调系统通知------main 进程天然就在这个位置上;
- 如果再加一层后端服务,就等于平白多了一个跨进程边界:每一次工具调用、每一次事件落库、每一次产物写盘,都要序列化一次;
- 更要命的是启动复杂度:用户要跑起来,得先把后端服务起起来,再起桌面端。多一个进程就多一个失败点。
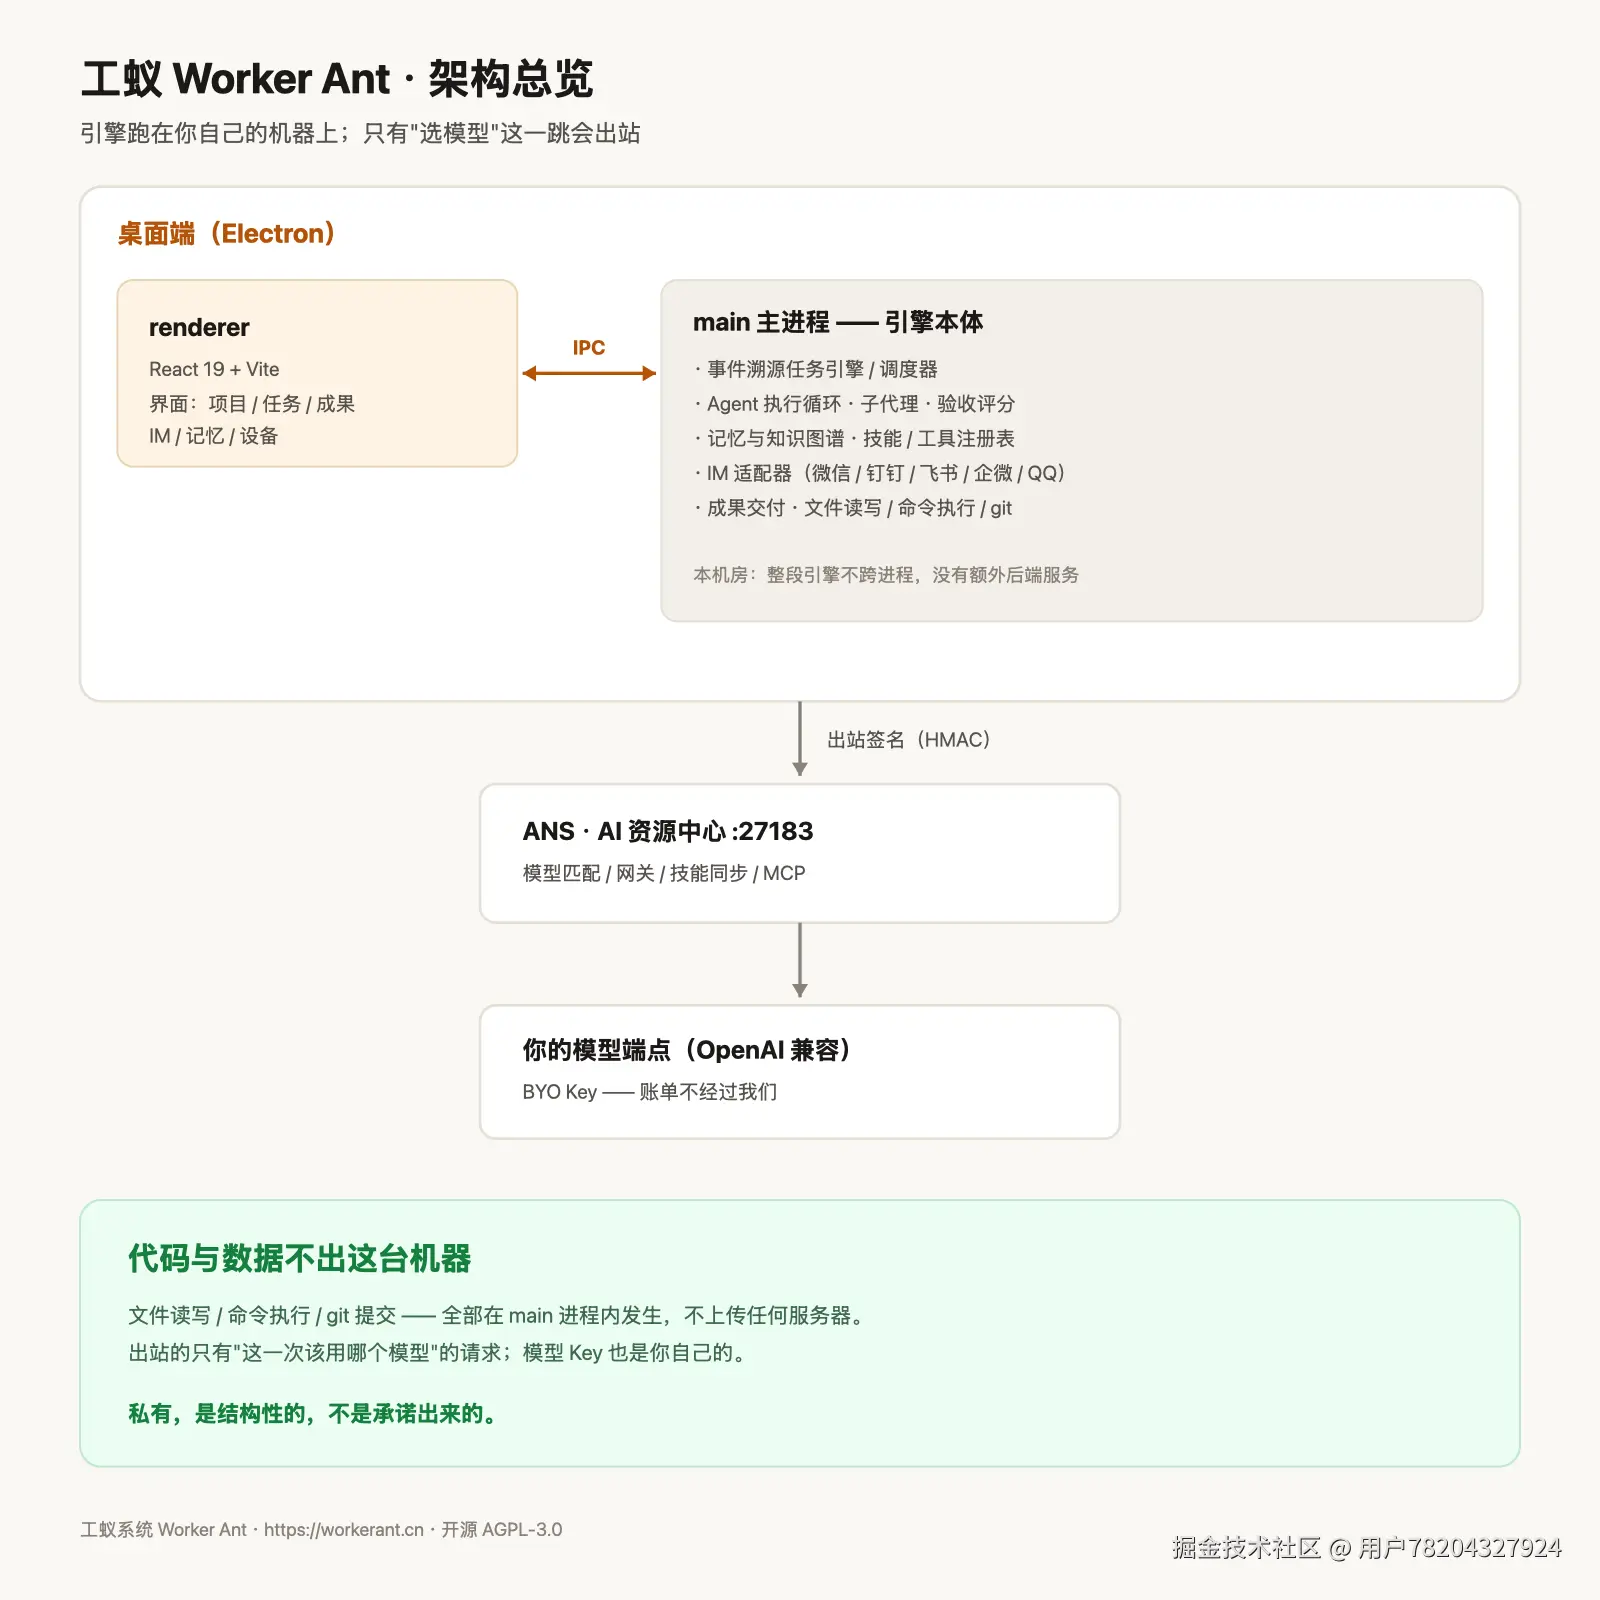
搬完之后,剩下的只有一个常驻 HTTP 服务:ANS(AI 资源中心,:27183) ,负责模型匹配与网关。桌面端作为客户端,用 HMAC 出站签名调它。
架构大概是这样:
scss
┌──────────────────────────────────────────────┐
│  桌面端 (Electron)                            │
│  ┌────────────┐   IPC   ┌──────────────────┐ │
│  │  renderer  │◀────────▶│  main 主进程      │ │
│  │  (React)   │          │  · 任务引擎/调度   │ │
│  └────────────┘          │  · Agent 执行循环  │ │
│                          │  · 记忆/知识图谱   │ │
│                          │  · IM 适配器       │ │
│                          │  · 成果交付        │ │
│                          └────────┬─────────┘ │
└───────────────────────────────────┼───────────┘
                                    │ 出站签名(HMAC)
                          ┌─────────▼─────────┐
                          │ ANS 资源中心 :27183│
                          └─────────┬─────────┘
                                    │
                          ┌─────────▼─────────┐
                          │  你的模型端点      │
                          │  (OpenAI 兼容)     │
                          └───────────────────┘
代价是什么? 是 GUI 卡顿风险。所有耗时操作都在 main 进程里,一旦有同步阻塞,界面就假死。我在这上面花了不少功夫(后面第 4 节讲)。
2. 决策二:用事件溯源,而不是一张状态表
任务是"可暂停 / 可恢复 / 可重放 / 可审计"的。这四个词决定了数据层不能用普通的"状态表 + UPDATE"。
如果 wa_tasks 表只有一行 status 字段,那么:
- 可重放做不到------状态被覆盖了,历史没了;
- 可审计做不到------你只能看到"现在是什么",看不到"为什么变成这样";
- 可恢复 很脆------进程崩在中间,你只知道状态是
running,不知道它走到哪一步。
所以我用了事件溯源 :所有变更先落成一条事件(event-store),再由投影器(event-projectors)折算出当前状态视图。
好处是每一步动作都留痕 ,任务可以按事件流重放;坏处是读模型和写模型要分开维护,投影器的正确性成了新的责任面(每加一个事件类型,就要检查一遍所有读它的地方)。
这条后来还救过我:"任务是不是真的完成了"这个判断,本质上就是一个投影问题------如果完成状态由多个出口各自写入,迟早会出现"三本账对不上"。我被迫把这些出口收敛成同一把尺(见下节)。
3. 决策三:任务自动拆解 + 子代理
一个真实任务很少是原子的。"把所有仓库的 TODO 汇总成一份 issue 列表"至少要经过:找仓库 → 各自扫描 → 聚合 → 生成草稿。
所以引擎会把任务自动拆解 成子任务,并且可以派给不同类型的子代理:
- 部署 / 探索 / 构建 / 验证 四类专职子代理
- 以及 辩论 、蜂群 两种协作模式
拆解带来一个很容易被忽略的问题:子任务"做什么"和"为什么有它"是两件事。
我一开始只让模型产出子任务的描述(做什么),结果出现了一批"看起来合理、但和总目标没关系"的子任务------它只是在做事情,不是在做事。后来我给拆解加了目的因 :每个子任务必须携带"我为什么存在",缺这一项的条目在解析口就被拒掉,其余照建。
这一条的经验是:约束要下在解析口,不要下在事后校验。事后校验意味着坏数据已经进库了,你还得再去清。
4. 决策四:「完成」必须有人签字
这是我吃过最大的亏。
早期版本的判定很简单:Agent 说自己做完了,就算做完了。结果就是------它经常在没做完的时候说做完了。
后来我把它改成三段:
- 产出校验:任务声明的产物是不是真的在盘上(文件存在、非空、格式对);
- 验收评分:由引擎对产物打分,而不是由执行的模型自称;
- 质量分入闸 :分数回流到调度策略------低分完成不会被认为是"连续成功"。
第 3 条特别有意思,也是我后来才意识到的:原来的策略调整只看"成功/失败"这个布尔值 。一个任务用最便宜的档位糊弄完了(质量分很低),系统会认为"连续成功",反而往下调档------越糊弄越省,越省越糊弄。
改成吃质量分之后:低分完成 ⇒ 升档 (换更强的模型/更多步数),高分完成 ⇒ 一律不动。行为立刻正常了。
5. 坑一:Electron ABI 与 Node ABI,互斥
这个坑我至今觉得值得单独写一节。
场景:桌面端要用 better-sqlite3(原生模块),ANS 服务也要用同一个 better-sqlite3。它们是同一个包,被 pnpm workspace 提升到共享位置。
问题来了:
- Electron 需要 Electron ABI 的编译产物;
- 系统 node 需要 Node ABI 的编译产物。
同一份 .node 二进制只能是一个 ABI。于是:
- 先起 ANS(Node ABI),再起桌面端 → 桌面端的
electron-rebuild把共享模块改写成 Electron ABI → ANS 虽然已经在内存里跑着,源码一改动、watch 重启就崩; - 反过来,想靠桌面端"按需代起"ANS → 代起用系统 node → 加载 Electron ABI 的模块 →
NODE_MODULE_VERSION不匹配,当场崩。
结论:dev 环境下"桌面端自动拉起 ANS"是不可能成立的。
我的处理是:
- 如实失败,而且快 ------子进程一
exit就当轮返回,按 stderr 分因(native-abi-mismatch/child-exited),附上 stderr 尾巴,不把"早就死了"静默拖成 20 秒后的"超时"; - 给用户看得懂的话 ------检测到 ABI 冲突,直接提示"请先跑
pnpm dev:ans"; - 退出时只杀自己拉起的那个进程,不动用户手动起的服务。
这一条我最大的体会是:"失败快且说人话"是一种可以设计的能力,不是碰运气。默认行为永远是"静默拖到超时",那是最糟的体验。
6. 坑二:IM 入站媒体的"真形状"
我的产品支持用微信 / 钉钉 / 飞书 / 企业微信 / QQ 派活,所以要把用户发来的图片、文件落盘。
我按公开资料和推测,写了一版"字段可能在顶层"的解析:找 url / file_url 之类的候选名。测试全绿。
然后上真实环境------一个件都没落下来。
真实帧长这样(示意):
jsonc
{ "type": 4,
  "file_item": { "media": { "encrypt_query_param": "...", "aes_key": "...", "full_url": "..." },
"file_name": "测试.txt", "md5": "...", "len": "1610" } }取件地址和钥匙嵌在 media 里 ,顶层根本没有。而且------密钥有两种写法 :一个字段给的是 base64 过的十六进制串,另一个给的是那串十六进制本身,解出来是同一把 AES-128 钥匙。
更关键的是:CDN 上的字节是 AES-128-ECB 密文 ,不是明文的。所以流程是:取 full_url → 拿到密文 → 用归一后的钥匙解密 → 校验 md5 → 才落盘。
这个坑的教训不是"要看清文档",而是:我的测试样本是我自己按推测形状手写的 。于是"取件实现存在"、"五家适配器都调它"、"测试全绿"这三件事同时为真 ,而件永远到不了盘上。用自造的等价样本做的端到端测试,证明不了端到端。
后来我给这类东西立了规矩:测试夹具必须照抄生产形状(含外键、含真实 DDL),并且要有一个"从 0 变 1"的正面断言------只断言"不抛异常"是捉不住这类问题的。
7. 工程纪律:137 个回归脚本 / 14612 条断言
最后说一个不那么性感但对项目生死攸关的东西。
这个项目长期只有我一个人维护,而且改动的是一个跑在用户机器上、真的要动文件跑命令的引擎。所以我把回归测试做得很重:
- 每个迭代轮次配一个受控回归脚本(
rr_*.ts),跑在内存数据库上; - 全量回归是 137 个脚本 / 14612 条断言,并发跑完约 235 秒;
- 构建标识(build tag)一处真源,其余脚本由代码派生核对------避免"改了版本号但脚本里还抄着旧值"。
还踩过一类很损的坑:哑雷断言。
比如我写过 eq(x, cond ? 'a' : 'b') 这种断言,其中 cond 恒真------它永远通过,且永远通过。测试全绿,但什么都没验证。这类"长得像断言、其实是恒真式"的东西,后来被我做成专项扫描(含反证标本)。
一个人写测试,最容易骗过的人是自己。
8. 现状
- 开源 AGPL-3.0,源码在 GitHub。
- 版本 v0.2.0 ,
63 个工具 / 8 大类,四类记忆(情景 / 语义 / 程序 / 反省),支持 MCP 与多机协同。 - macOS 版(Apple Silicon,macOS 13+)已发布 :Developer ID 签名 + Apple 公证,可从 GitHub Releases v0.2.0 下载 dmg / zip(附 SHA-256);Intel Mac 与 Windows 暂未提供,仍需从源码跑(Node ≥ 22 + pnpm ≥ 9,两个终端)。
- 社区版免费;Pro 授权(¥99/月 · ¥899/年)、早鸟终身与 Team 授权包(¥599/月 · ¥5990/年,每包 ≤20 节点)已在面包多开售,桌面端自带 14 天 Pro 试用。授权已开售,安装包也已发布。
如果你对上面任何一个决策有不同做法,欢迎在评论区拍砖------特别是事件溯源的读模型维护成本这一块,我很想听听别人的经验。
- 源码:github.com/Reamy/worke...
- 官网:workerant.cn/
- 授权(Pro / 早鸟):mbd.pub/o/author-bW...