终于,K3.1 Pro 更新了,我也等了好久了。
又到了三个月一次的"吹牛逼"时刻!
Claude、GPT、Gemini 狂轰滥炸一个月之后,Kimi 终于"挺身而出"!
我看了官方的资料,也看了很多例子,已经眼花缭乱了,"看起来"是真的很猛,很哇塞!
看的我都心动死了,昨晚都没睡好,不是说好了让我先玩的么?
是怕我下手重捏坏了么?
每次新模型发布,都有人专门找 Good Case 大惊小怪一阵子! 我就专门找 Bad Case 哈其实我不是故意的!
我就是随手一测!
我测试是为了方便我自己选模型,顺便和大家分享一下。
努力做到不浪费钱,不浪费时间,不浪费感情,三不原则! 怎么感觉有点像......
有些朋友喜欢先看结论,我就先说一句:相比 K3 而言提升明显,"又快又便宜"相比Opus5.5...我们选择不比 ! 具体能力......请看正文!
我按节奏来,先看卖家秀,再看实测结果,然后再总结。
我会重点展示测试结果、时间消耗、tokens 消耗等方面。
过程中有发现什么特别的点,我也会单独写出来!
文章略长,眼睛累了,可以先点赞😄!
基础信息
我相信,这么热门的模型,所有细节立马就会传遍大江南北,然后添油加醋,越传越神!
各种数据,大家肯定或多或少看过了,不用我多说。
但是为了文章的完整性,为了照顾没有看过资料的朋友,还是把重点信息提一提!
核心信息看这个帖子就可以了:
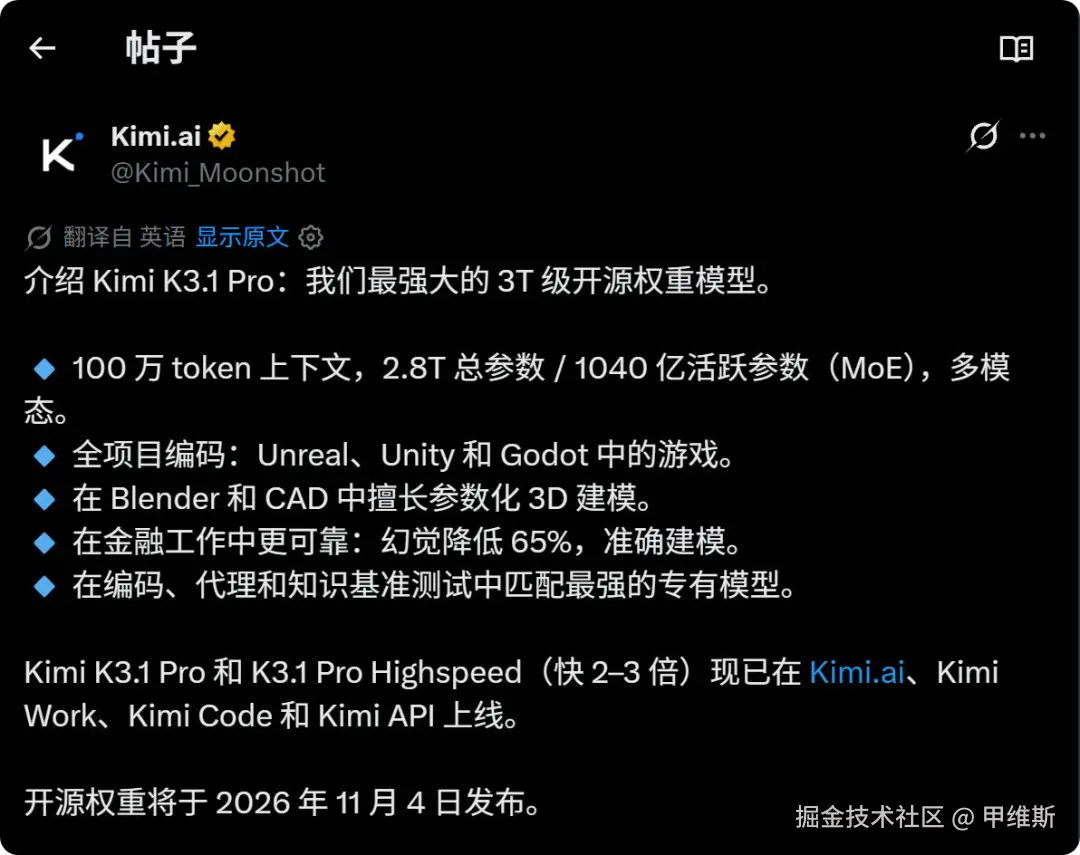
看看这里有啥新东西。
100 万上下文,2.8T(很大)MoE,多模态,这都已经是老黄历了。
主要的新东西就是:3D 建模和游戏!
这也是当前的最大热点!我最近也测过很多,做过很多。
另外提到了金融工作,还有编码、代理、知识等方面。
还有一个高速版模型,这个别看了,一般人烧不起的。
不过,听说这个版本默认速度就挺快,能到 100t/s!
基准数据看这张图就可以用了:
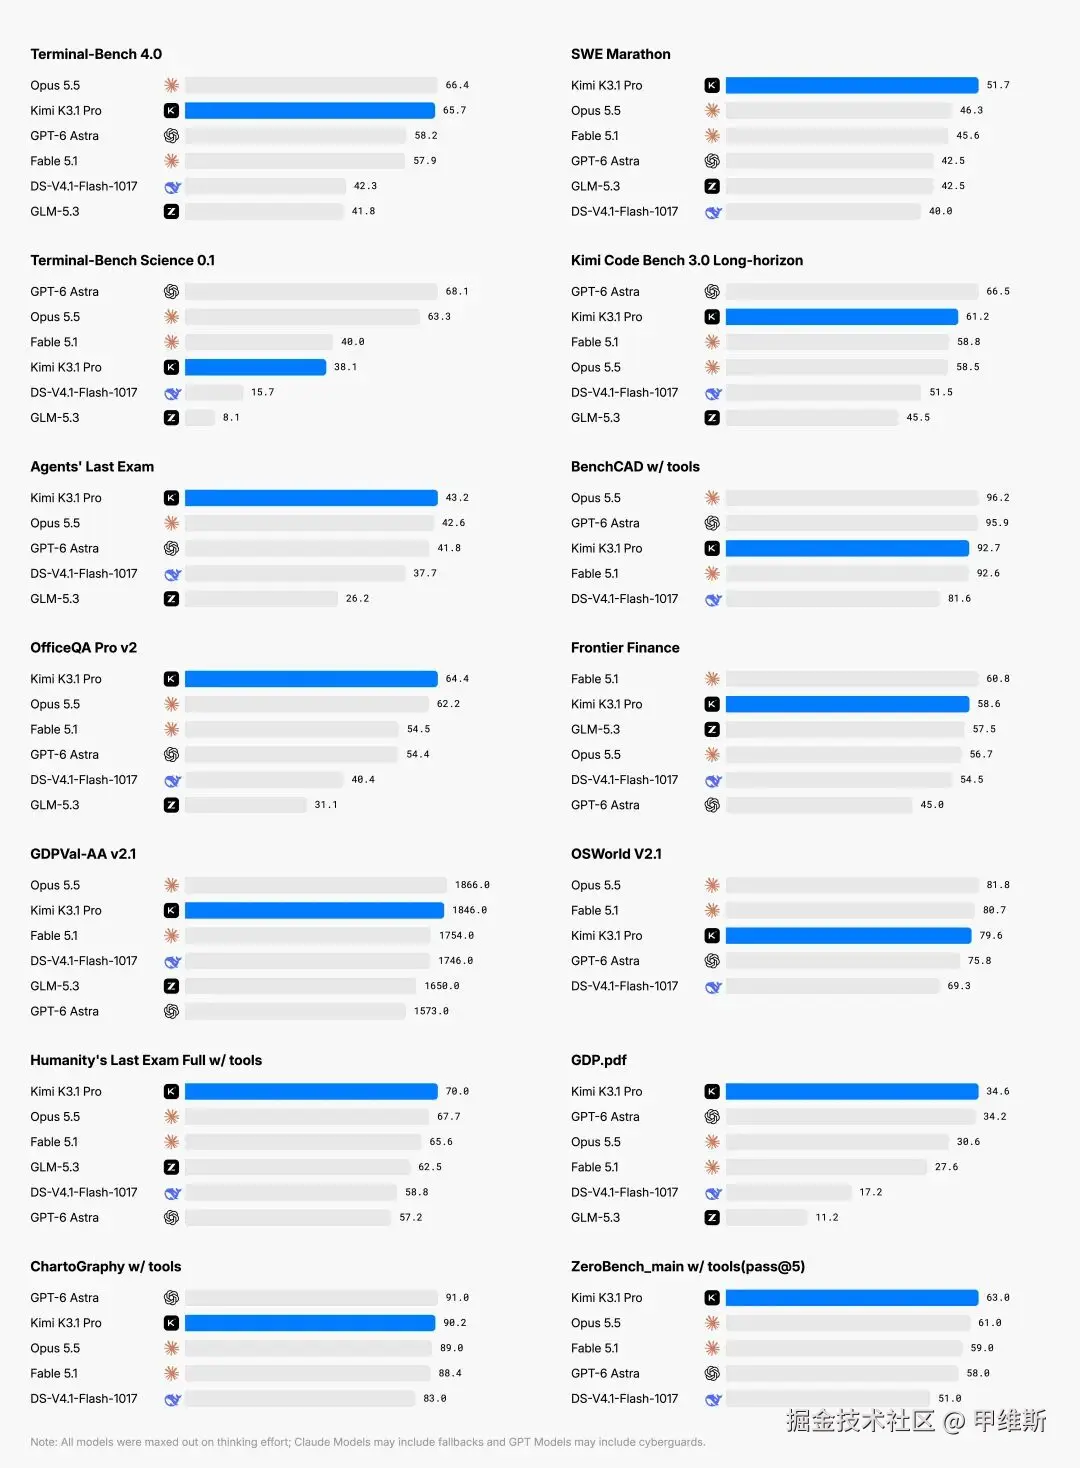
这里写了很多基准啊,有些我不熟。
我就看第一个,大概排名是 Opus5.5、K3.1 Pro、GPT-6 Astra!
Kimi 大部分基准是 top3!
Kimi 你发这个基准考虑过 DeepSeek 和 GLM 的感受嘛?它们基本都是 down3 了!
基准一向都是仅供参考的!
另外再来看一个第三方榜单吧:
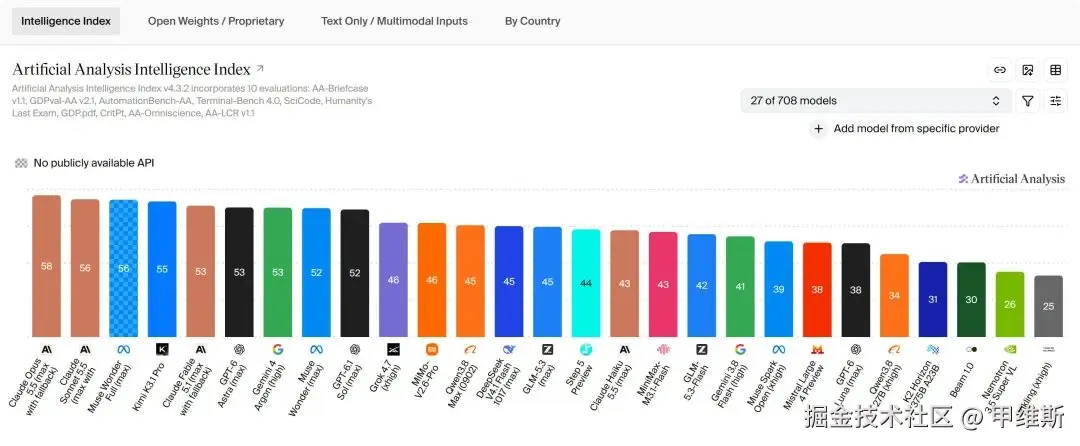
AA 拿下第四名,估计大家已经刷到很多次这张图了,哈哈!
我本来挺相信这个榜单的。但是 Muse 能排第三,我就不知道它是什么标准了。
性价比就看这个图:
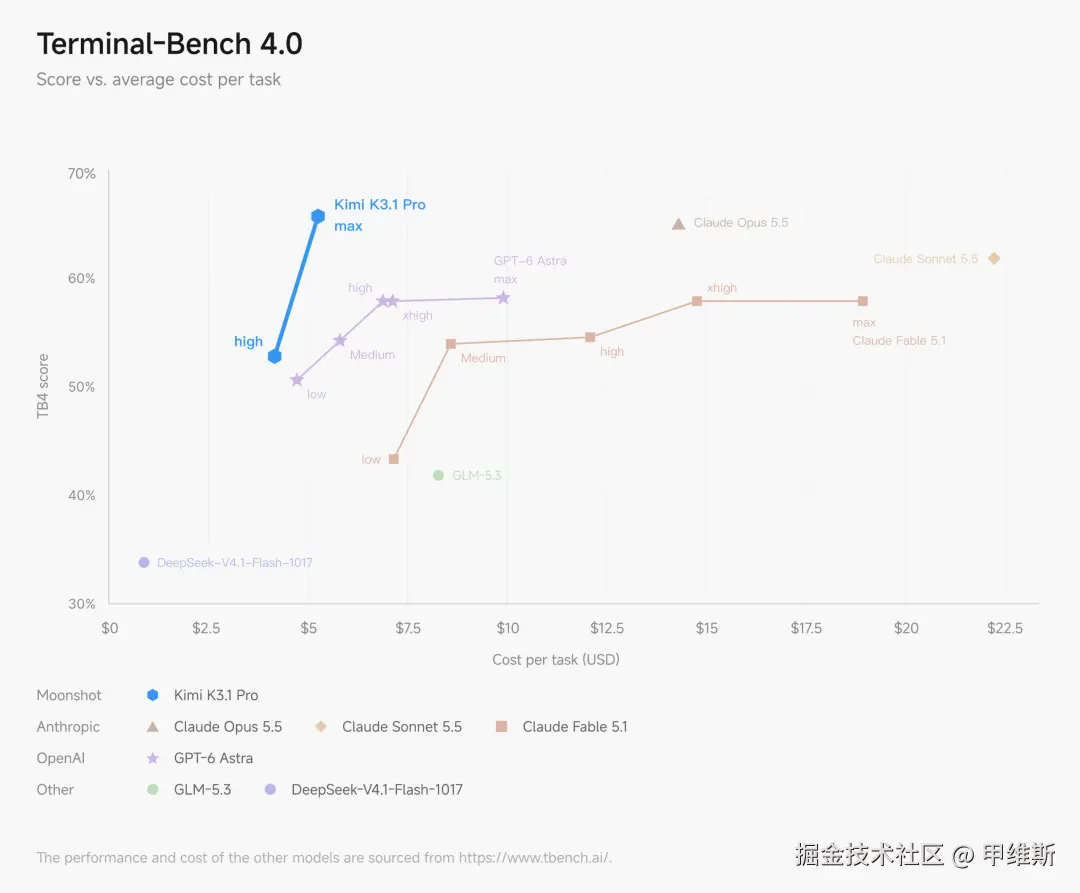
这个图主要表达的意思是 K3.1 Pro,在这一群人中,很有性价比。DS 很靠左,但是很低!
这些数据谁看谁迷糊,就像拍照一样,在自己的镜头最帅,一到别人的镜头里,都原形毕露了。
其他天花乱坠、神乎其技的第三方评论,我一句都不想提,我已经看腻了!
我想大家也不怎么相信那些"影评人"了!
快速过完资料,马上要开始看测试结果了。
测试工具
关于测试工具,简单说两句!
Kimi 自家的 Kimi Code CLI 做得还不错,我之前 K3 的所有测试都是在上面完成的!
这次我会用界面版:
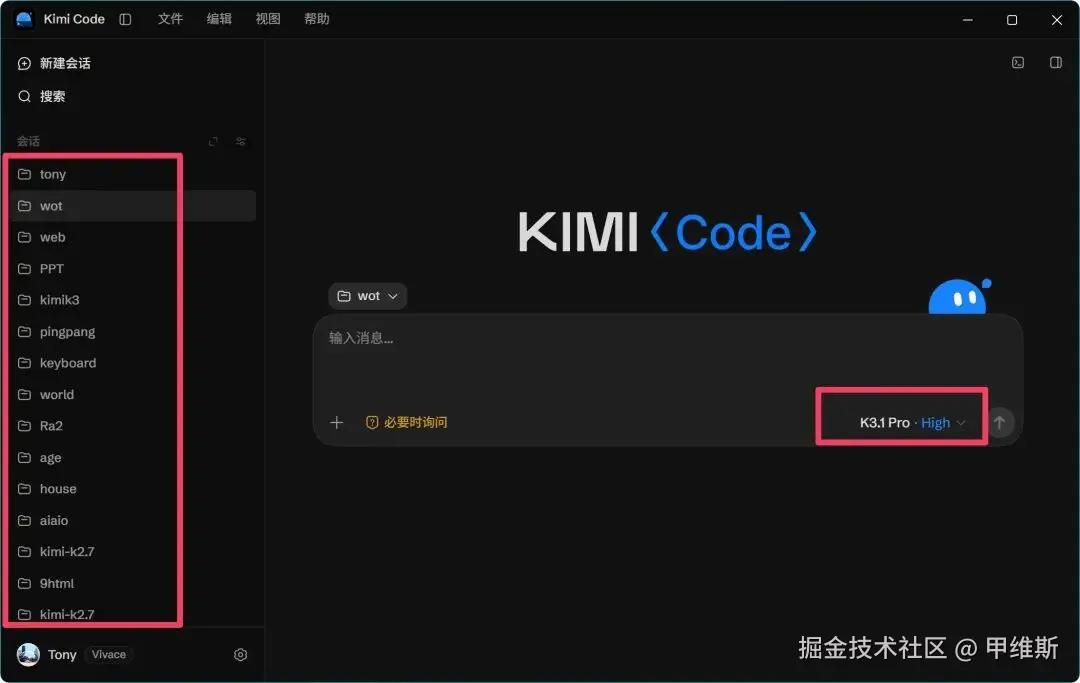
界面版可以直接同步之前的内容,有了目录,我查看和管理会比较方便一些。
从左边记录可以看到,我之前对 K3 进行过全方位的深入了解的。
我记得当时应该是跑了 60 亿的 tokens,很多例子还没来得及分享。
从右边可以看到,我已经选中了 K3.1 Pro,思考深度为 High 级别!
测试结果
终于,可以上结果了。整整测了一整天了!
为了方便参考,我们还是把常测的几个例子全都跑完了,然后加了两个新例子,方便测试游戏和 3D 能力。
赛博上河图!
这个例子,不用我多解释了,老粉都已熟得很了!
这个题目没有标准答案,但是很容易看出差异,需要模型有很强的能力,要融合赛博朋克和清明上河图的风格。
K3.1 Pro 的结果如下:
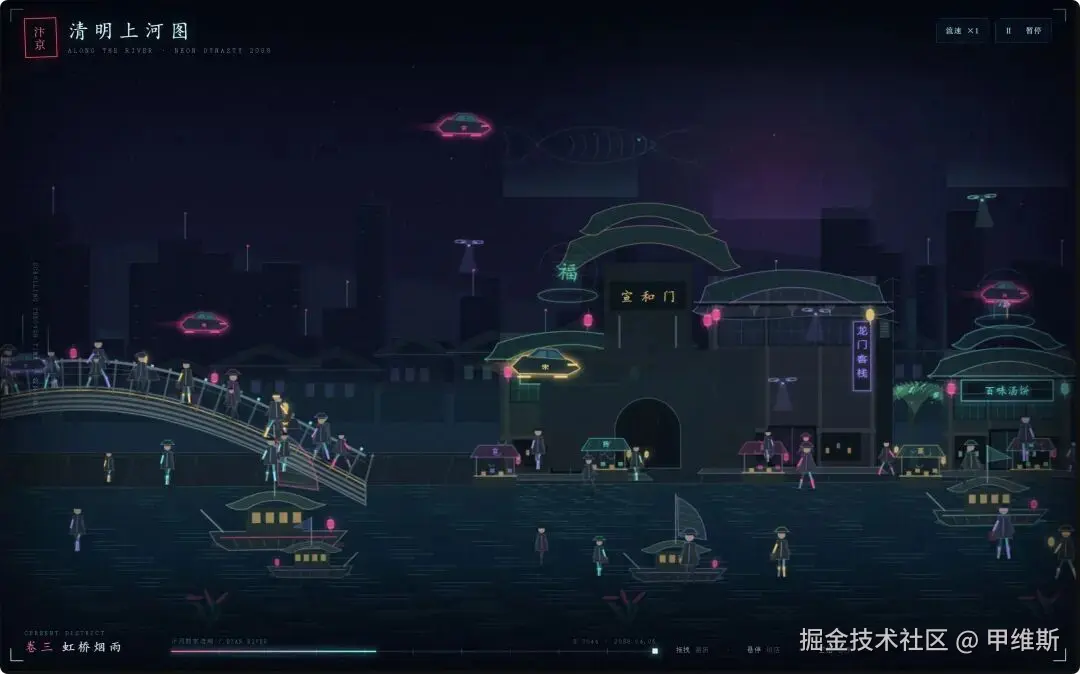
哈哈哈~~人船混行,相当行!
Kimi K3.1 Pro 的审美还是不错的,元素和细节也比较丰富了,但是空间感和对画面元素的理解还是不到位。
这个主要体现在:虹桥的方位不对,另外人行道和河面没有分清楚,全是水上漂!
然后我再给大家看一下 K3 的效果!
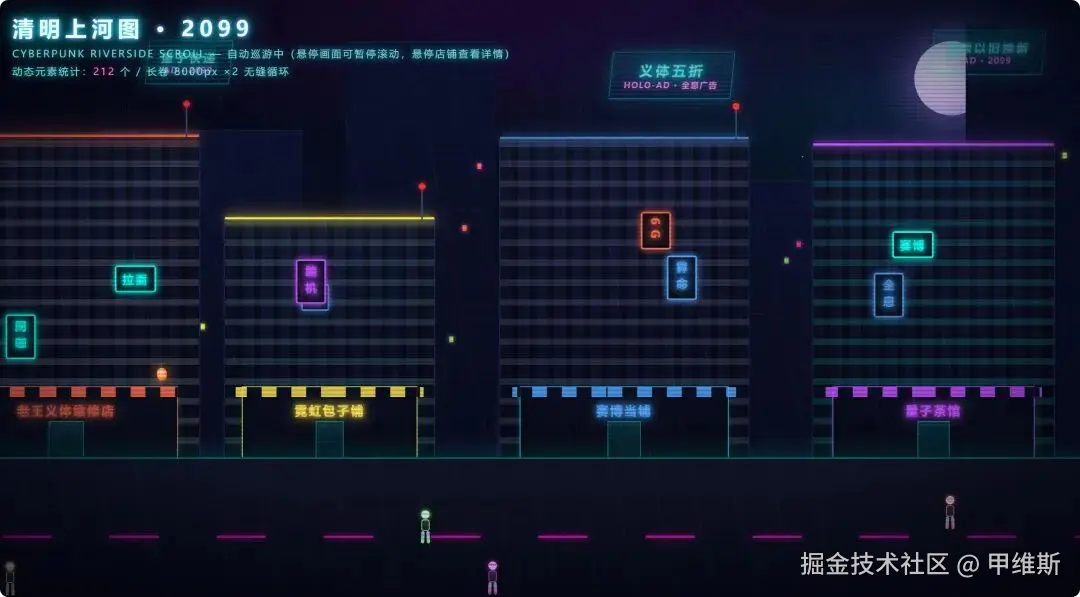
这么一比,K3.1 Pro 还是进步巨大的!
相比其他国产模型,也是确实属于第一梯队了!
如果要横向对比 GPT-6 Astra 和 Opus5.5,那就还差点意思。
它们的丰富度和空间感太强了,这两位都把虹桥横跨两岸的效果做出来了,各有各的特点。
天文机械表!
这个题目考验 SVG 绘画能力,也非常考验脑子。因为同时提出了一堆需求,大模型注意力不够,就会丢三落四。
结果如下:
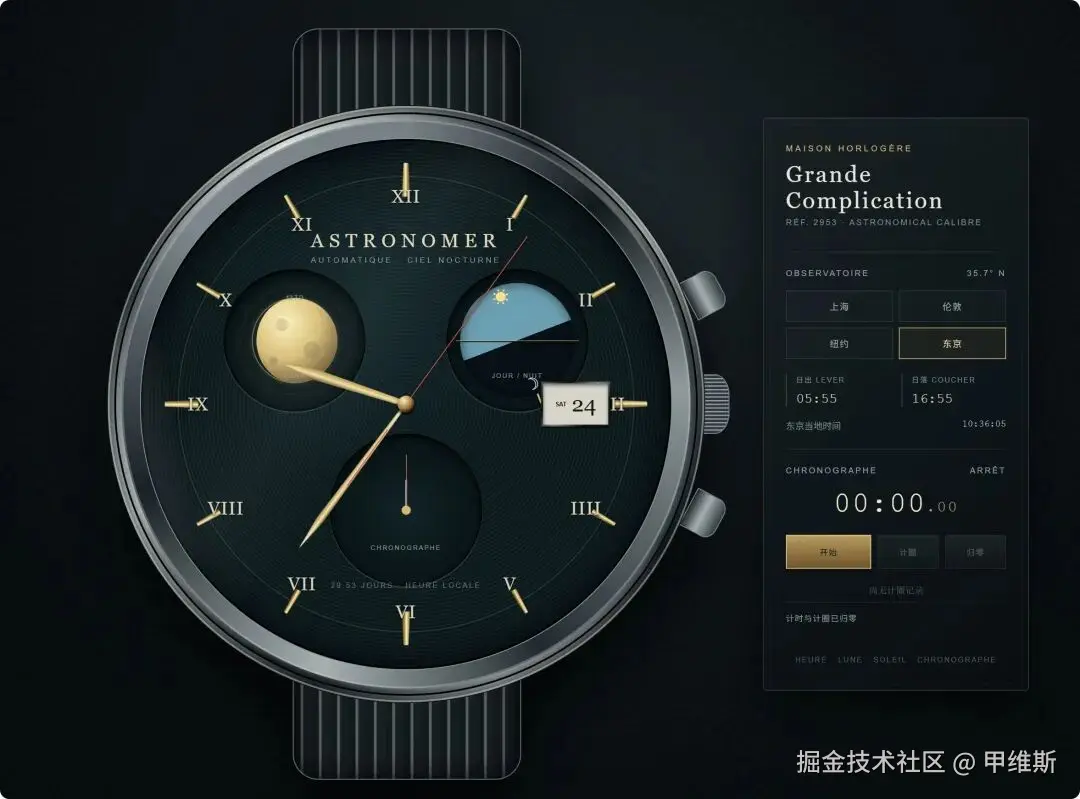
这个样式还是很棒的,整个画面布局和结构都很好,核心元素也都在了,没缺指针,运转良好。
国产模型中应该顶级了!
只是这个配色和样式总感觉 G 里 G 气的!
不会是和 DS 一起拜师学艺学了蒸功夫吧!
再给大家看下 K3 的效果:
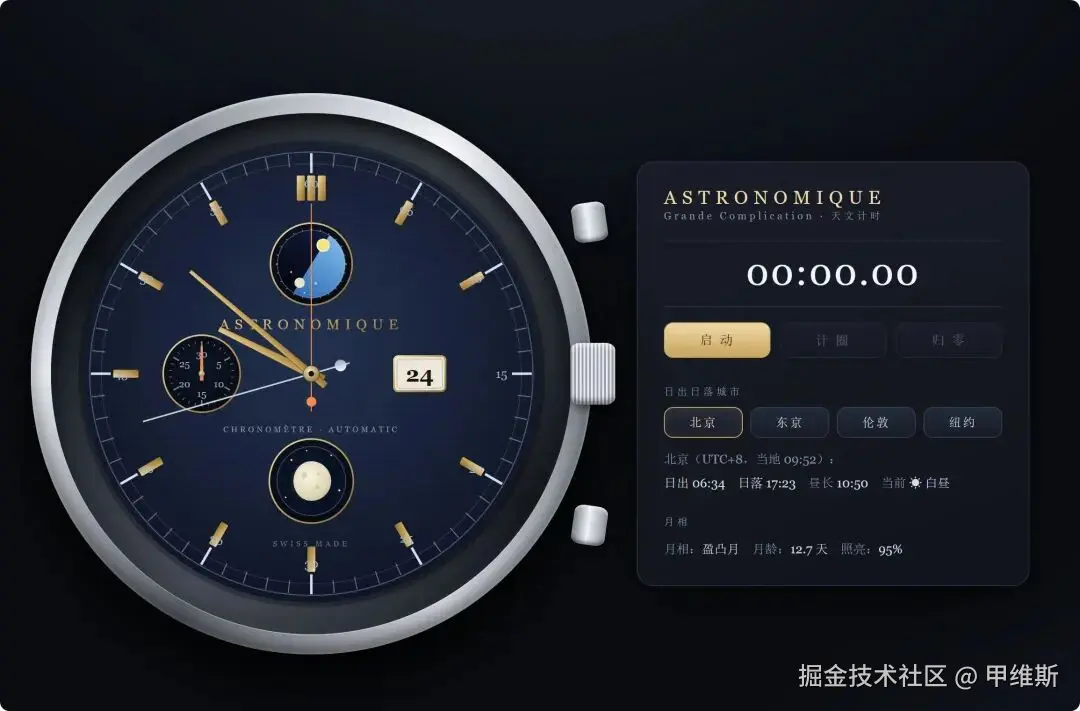
无论是按钮的布局,手表的表带,还是配色,应该都是新版本更好。
新版更加精致,更加有格调!
结果很好,但是过程中遇到了一些小问题:
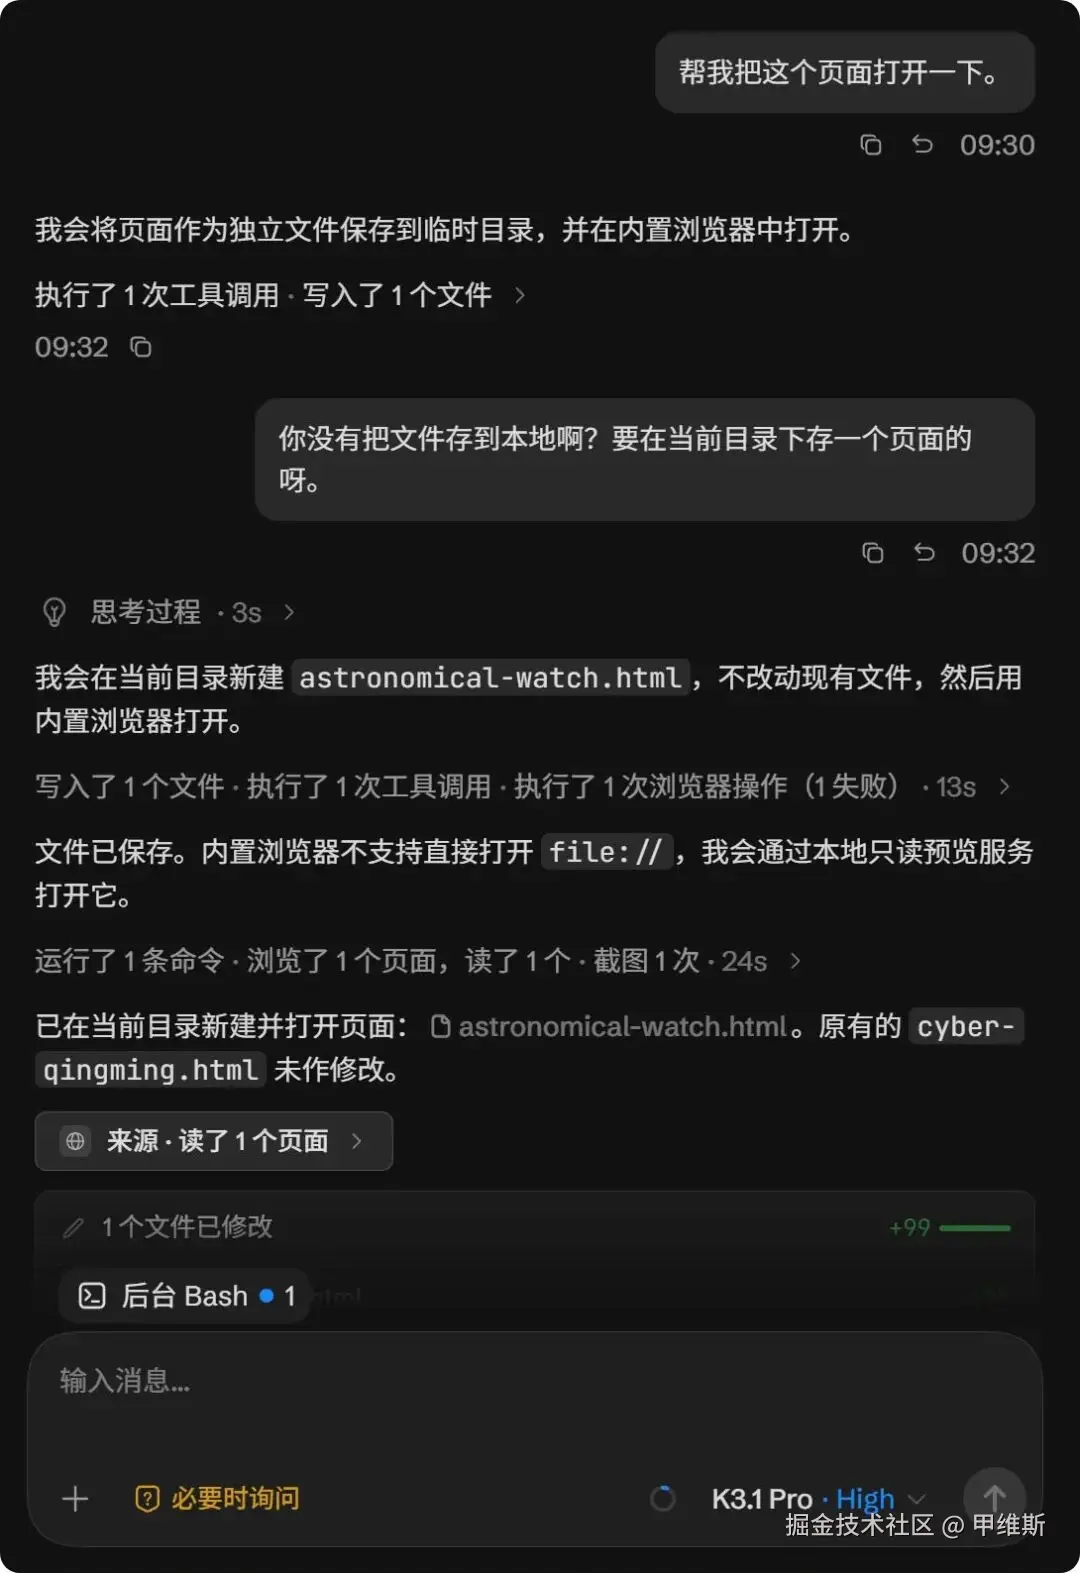
它只是在屏幕中输出了代码,但是没有保存到文件夹中!
我的提示词中包含了:"只输出最终代码,不要解释。 不读取和修改当前目录的文件,单独保存一个页面"
它可能误解了我的意思,我的本意是不要参考已经存在的文件,单独保存一个页面。它理解为不要在这里创建文件,只要在屏幕中输出即可。
我后面明确说了,要单独保存一个页面! 这一句也看不懂么?
我对它的理解能力表示怀疑!
这么干活,要扣工资的。
游戏复刻
审美、空间感、脑力都考完了! 来玩会儿《超级玛丽》!
结果如下:
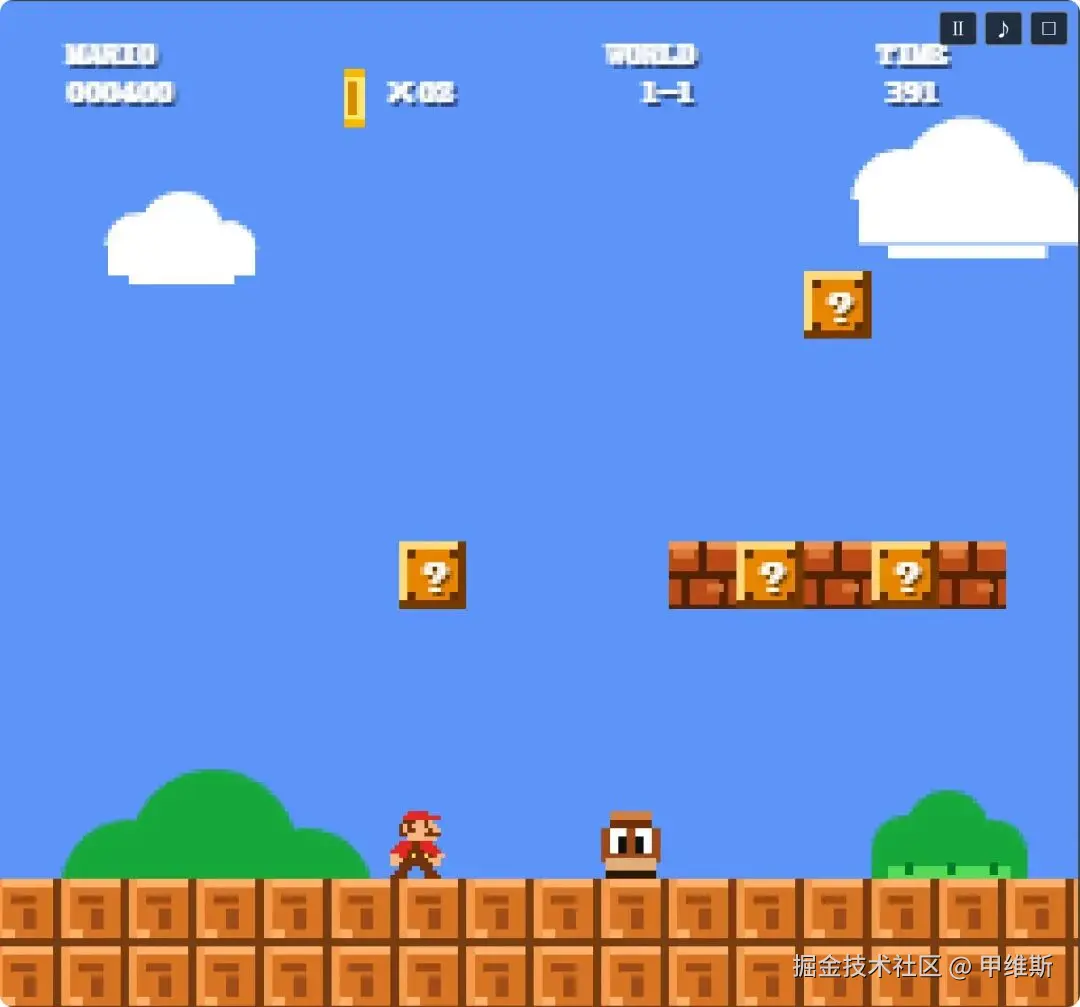
刚开始这一幕还算正常吧。玛丽老哥也算是眉清目秀。
长大之后就彻底长残咯:
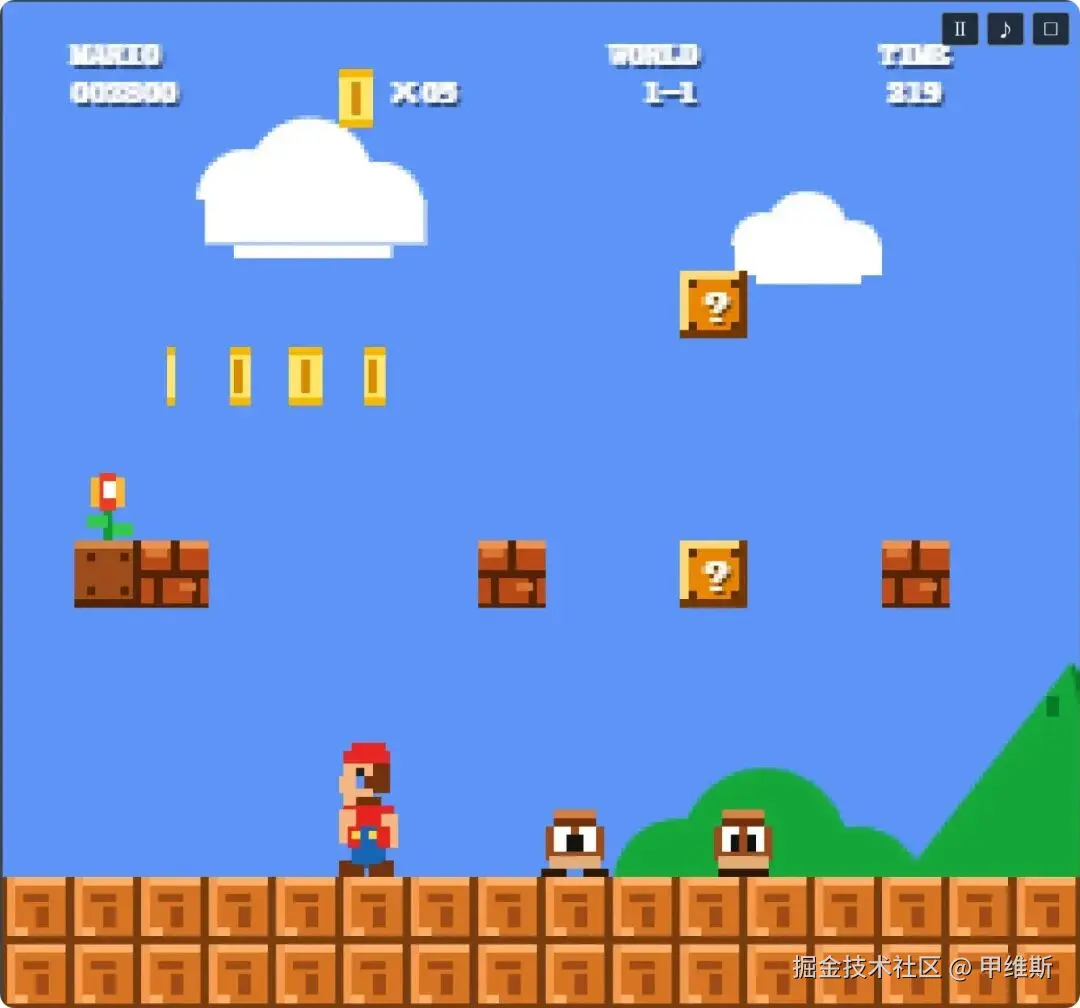
我大致玩了一下,可以通关的,没有大问题!
但是角色、地图、玩法的还原度不够。
人物形象和地图风格大家已经能看到了。
玩法部分有几个明显的问题:它没有隐藏蘑菇、长大之后跳不高、按"X"加速太没人性了。我的手指🤌要怎么按啊。
我不吐槽,我不吐槽,我正在写一个正经的测评!
好不好,比较很重要,看看 K3 的:
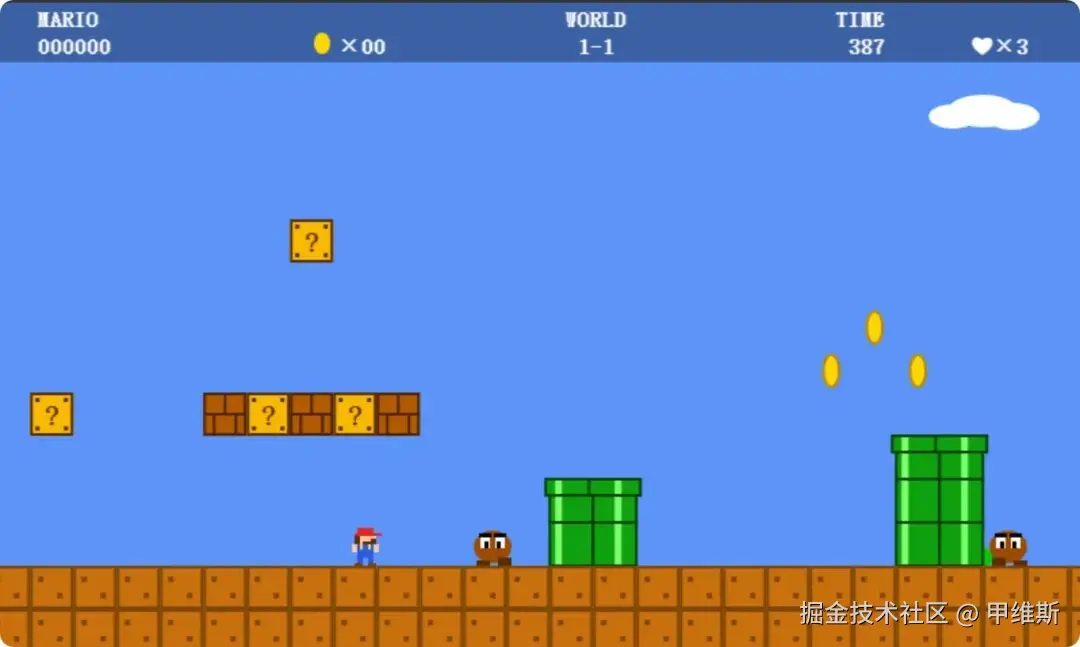
这么一比,K3.1 是不是好很多!
这个例子很神奇,即便是最近更新的一些国产模型,做得都不咋滴。
比如最近更新的 DSV4.1_1017 做完后跳跃都有问题,MiniMax 3.1 直接啥都不显示。
换个表述就是 K3.1 比最近更新的几个国产模型要好。
Claude 和 GPT 咱们就不比了,它们的 Sonnet 和 Sol 做的效果已经非常逼真了。
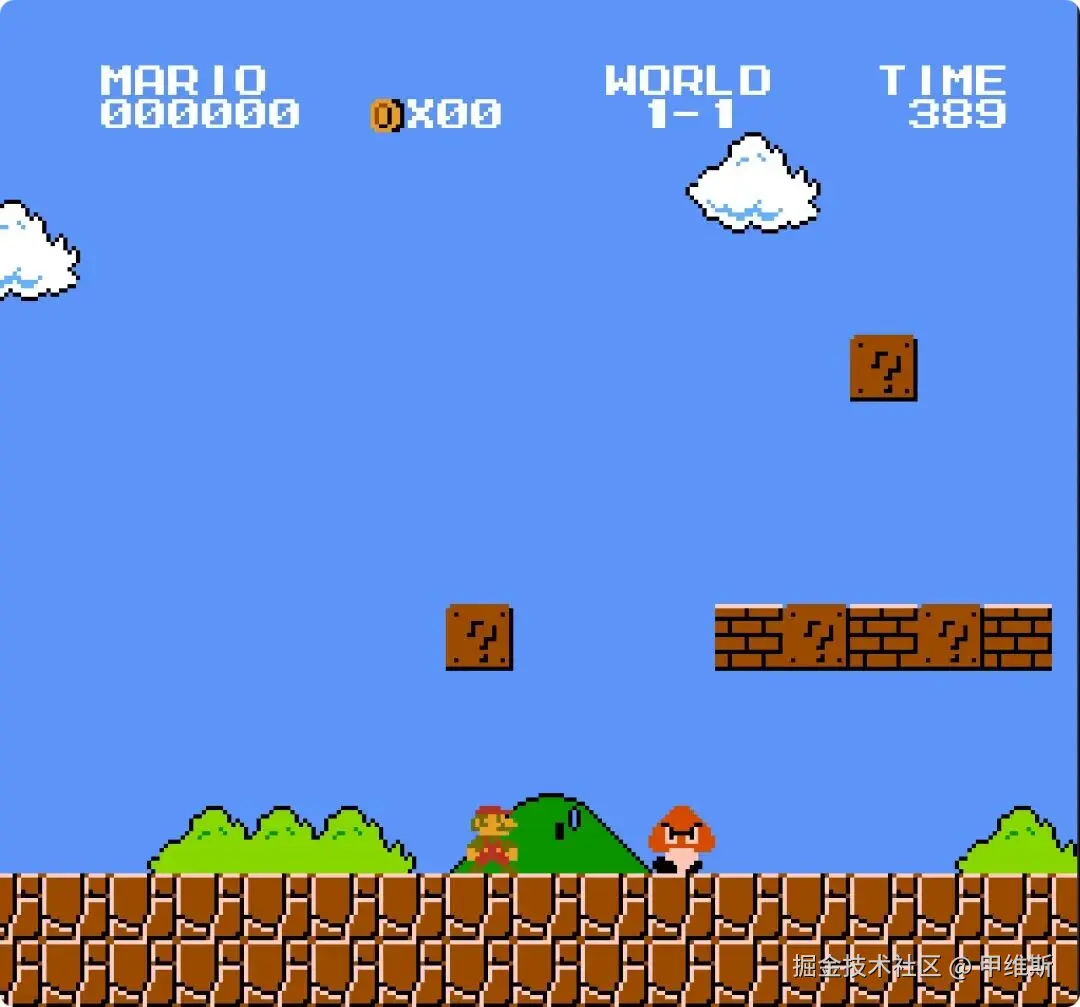
这是 GPT-6.1 Sol 的!
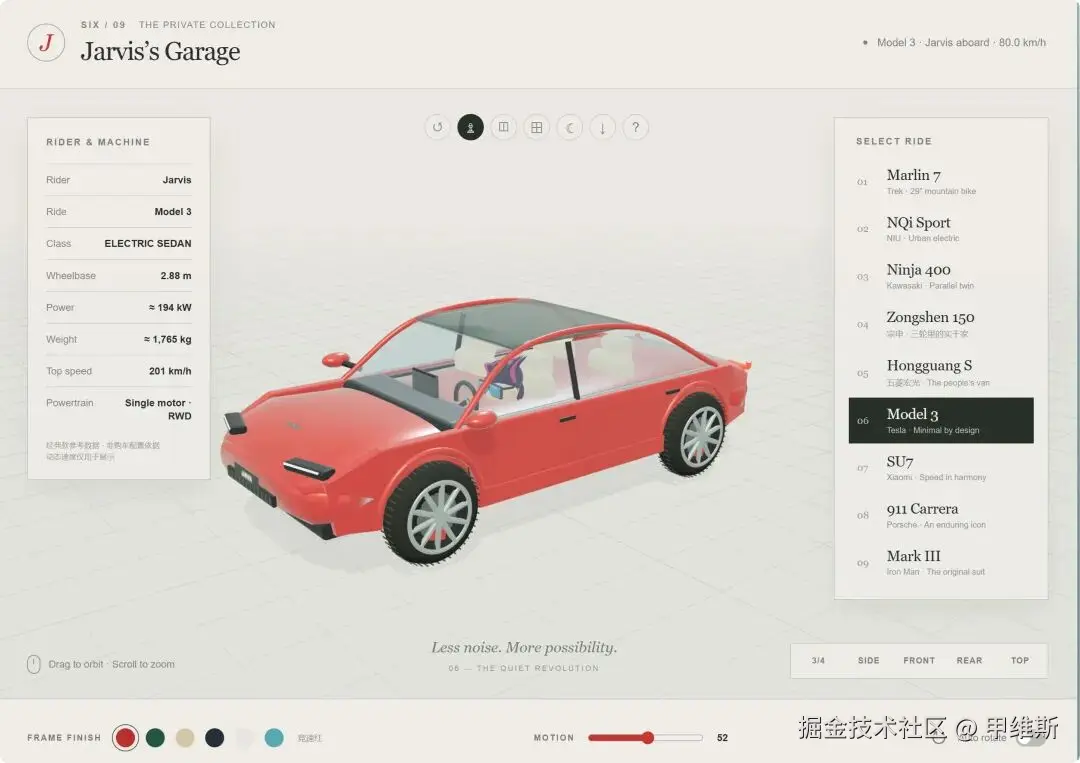
甲维斯的车库
这个例子是专门用来测试网页复刻和 3D 建模的。
也是这次 K3.1 Pro 的重点宣传方向,我看了很多炫爆了的建模和游戏效果。我是非常期待它能在这个例子上艳压群芳的。
但是我遇到了一个问题,我正在怀疑,我是不是用了盗版模型。
我跑的结果如下:
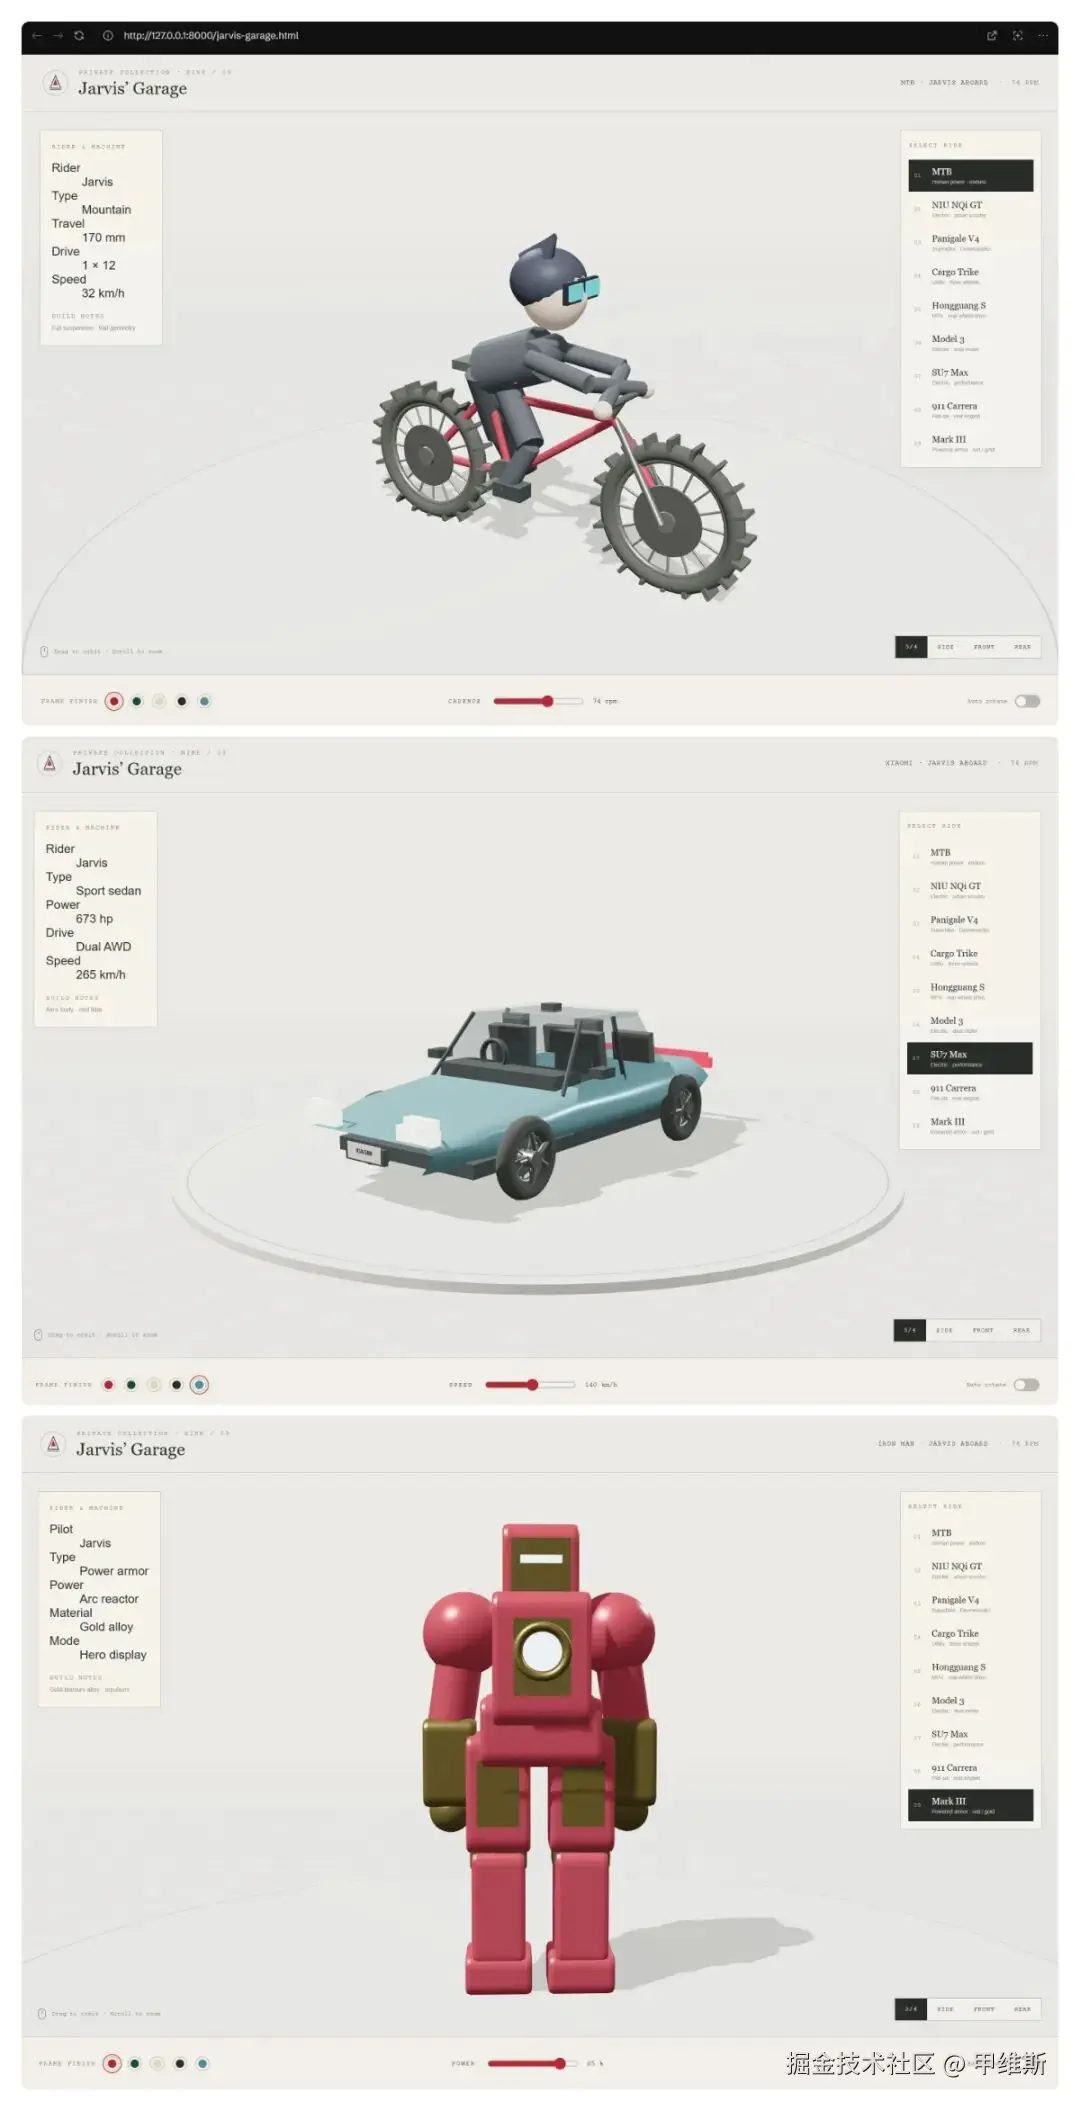
这已经是修改之后的结果了!
这里有几个问题:第一个左上角的卡片样式全乱了,第二个轮子不滚动,第三个车子结构混乱,第四个 Mark III 完全不像!
渲染素一点问题不大,建模不像这个问题,就比较难受。
这个是 K3 的:
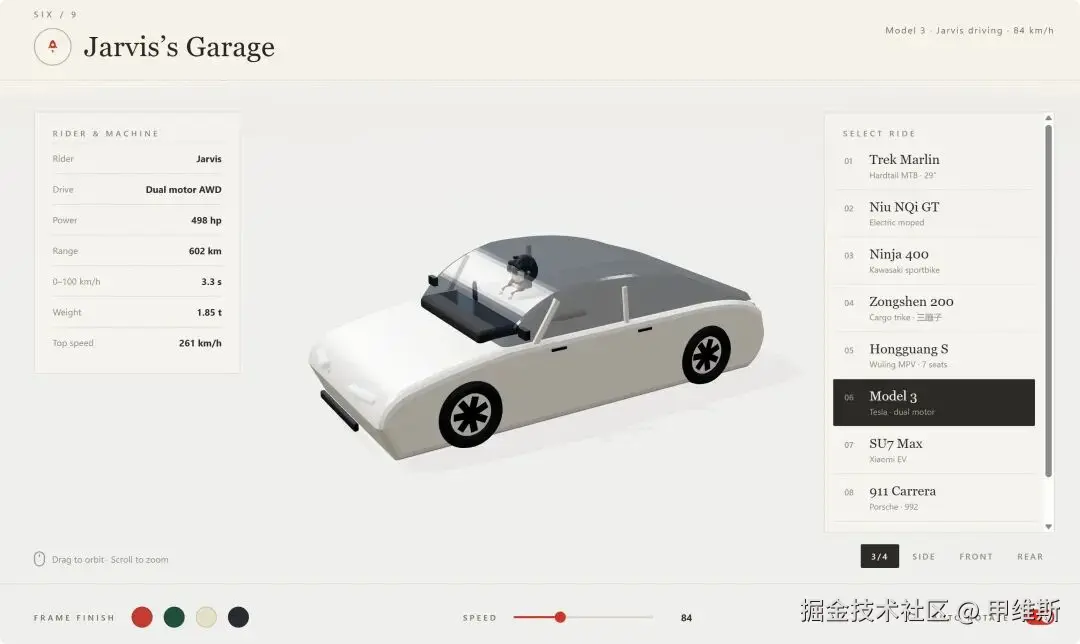
这是 GPT-6 Astra 的:
好像 Astra"略胜一筹"!
K3.1 Pro 这个例子整体来说不能算太差,但是不符合我的期待。
我看了那么多牛逼的宣传视频之后,我对它的期待是,它会轻松刷新这一题的新高度,但是并没有。
四个常规问题测完了,还可以,但是没我想象中的出众!
游戏手柄测试!
最近,我搞了一个新的系列,专门用来测试国产 Flash 模型的。
比如 GLM 5.3F、DeepSeek 4.1F、MiMo v3.1F 等等。
没想到第一个题目就让所有 Flash 都翻车了,我感觉要把题目升级为 Pro 测试题了。
今天 Kimi 3.1"Pro"来了,刚好拿来测试一下。
这个题目是这样的:
帮我在网页上画PS手柄,然后支持真实的手柄接入,按相应的按钮,会做出对应的反应。要考虑到多手柄接入,我最多会接入四个手柄。核心要求:1、网页制作漂亮,匹配主题,有设计感2、手柄轮廓和样式要高度还原3、要考虑幽灵插槽的问题,能分清楚不同的手柄。K3.1 Pro 的结果如下:
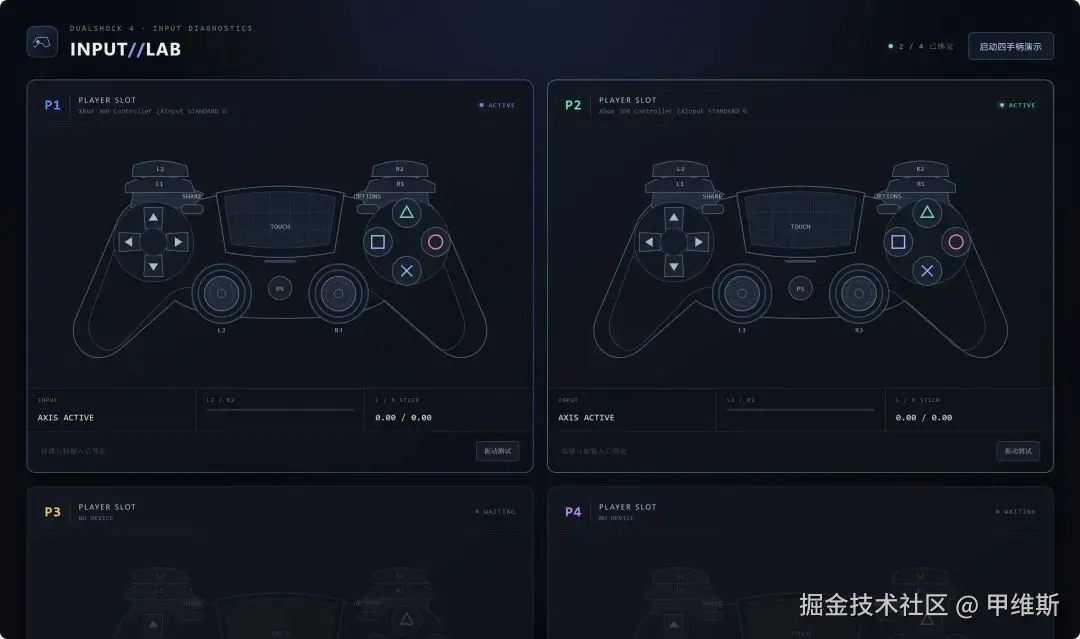
它这个手柄并不是写实风格,而是按抽象线条的方式来展现的。
不够逼真,但整体来说还是一个结构完整、形态基本正常的手柄。
L 和 R 按钮都标出来了,细节还可以!
重点是,它确实能正常接入 4 个手柄。这一点确实就是 Pro 级别的模型该有的水平了!
这个例子做得不错!
坦克世界
坦克大战这种经典小游戏已经不能满足当前的测试了,所以我们把游戏升级到了更大的战场------"坦克世界"!
坦克世界是走真实路线的坦克大战!
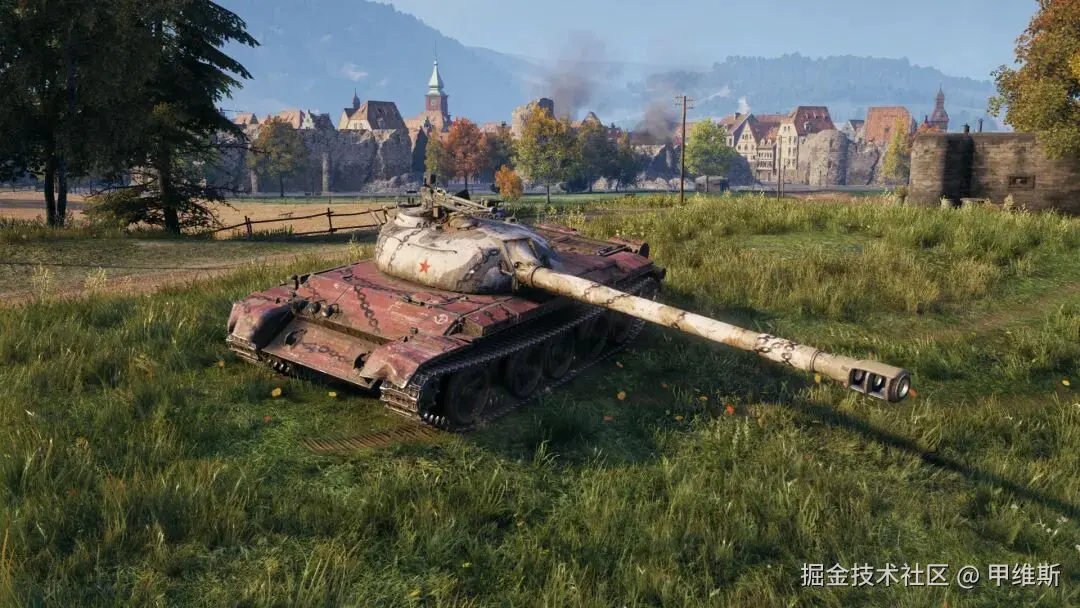
我不知道这算不算 3A 大作,反正是一个制作不小的游戏!
我们这个测试的目标就是复刻它的玩法和效果。
我的制作方法是:让 K3.1 Pro 自己去找参考图,自己总结游戏特点和核心玩法。
这个过程中遇到一个问题,它的搜索抓取能力较弱,基本上没抓到有用的图片。
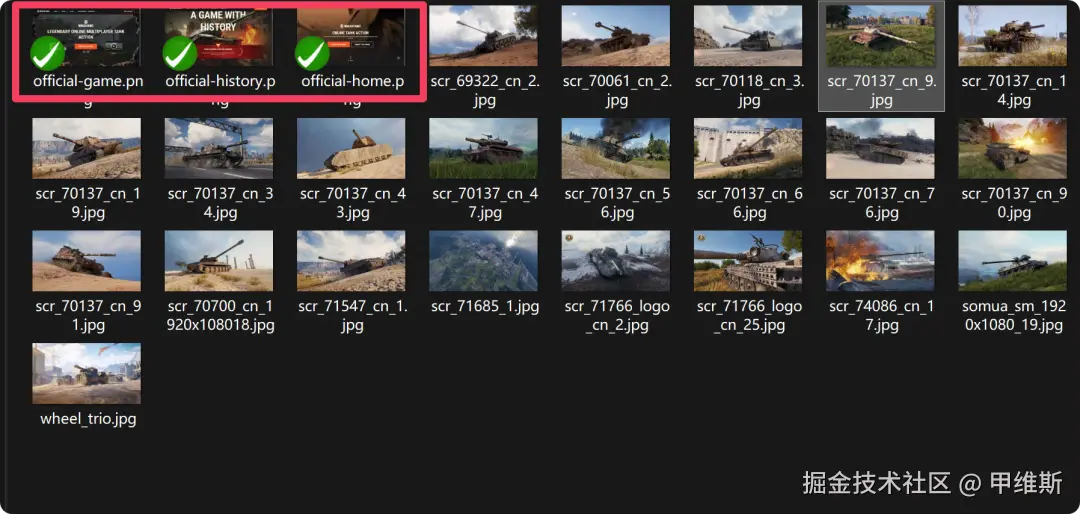
后来是我手动补上了参考图,好像我也是多此一举~~因为它实际上也没参考个蛋出来!
我们来看结果吧!
第一版结果如下:
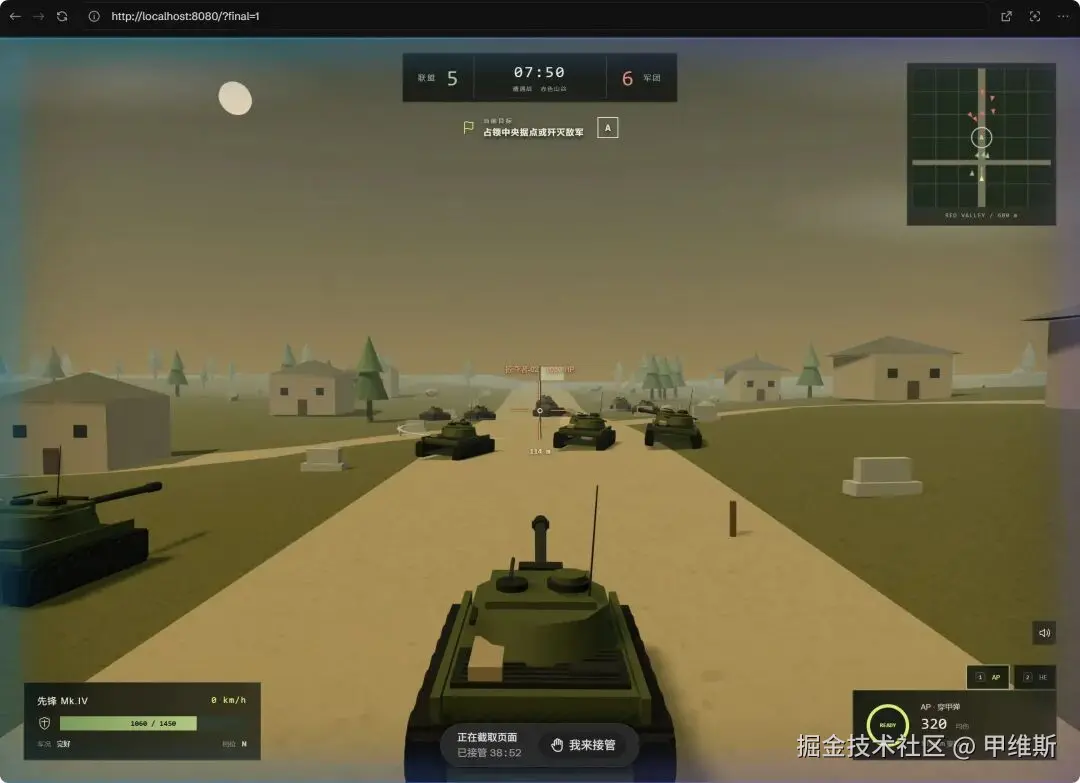
看到这里,你们应该知道,我选择封面图的理由了吧------货不对板啊!
因为第一版问题比较多,比如鼠标乱跑,镜头乱晃,转弯转反,瞄准很难,UI 太卡通等等。
所以就改了一阵子!
下面第二版:
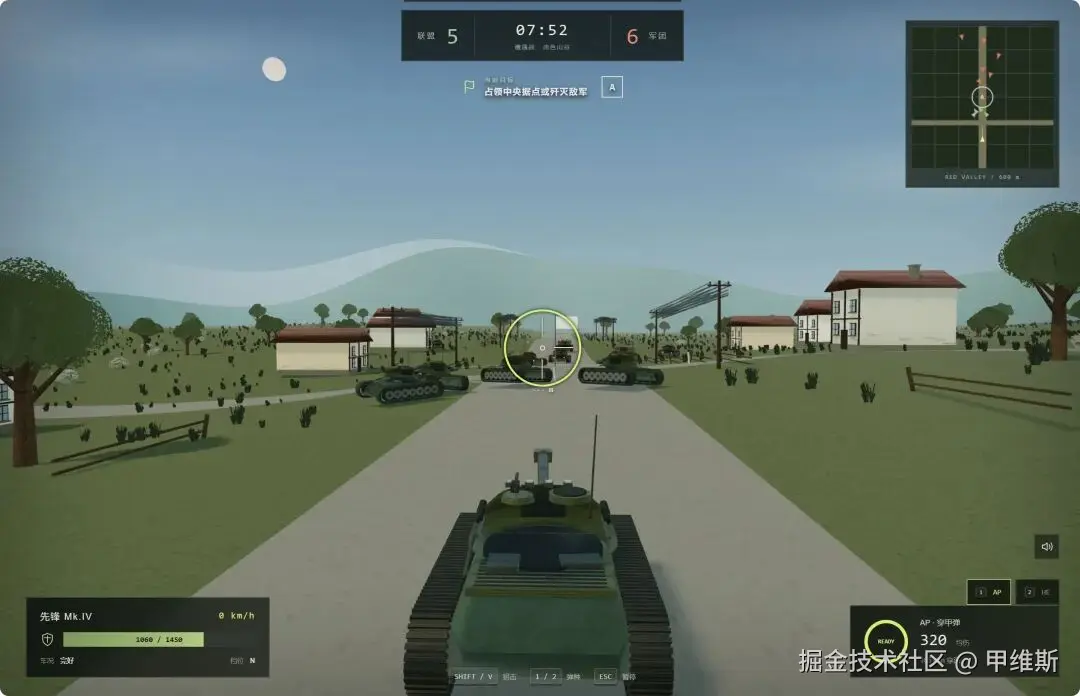
好了一些,但是参考图的效果估计是打死都改不出来了!
这是 GPT-6 Astra 做的:
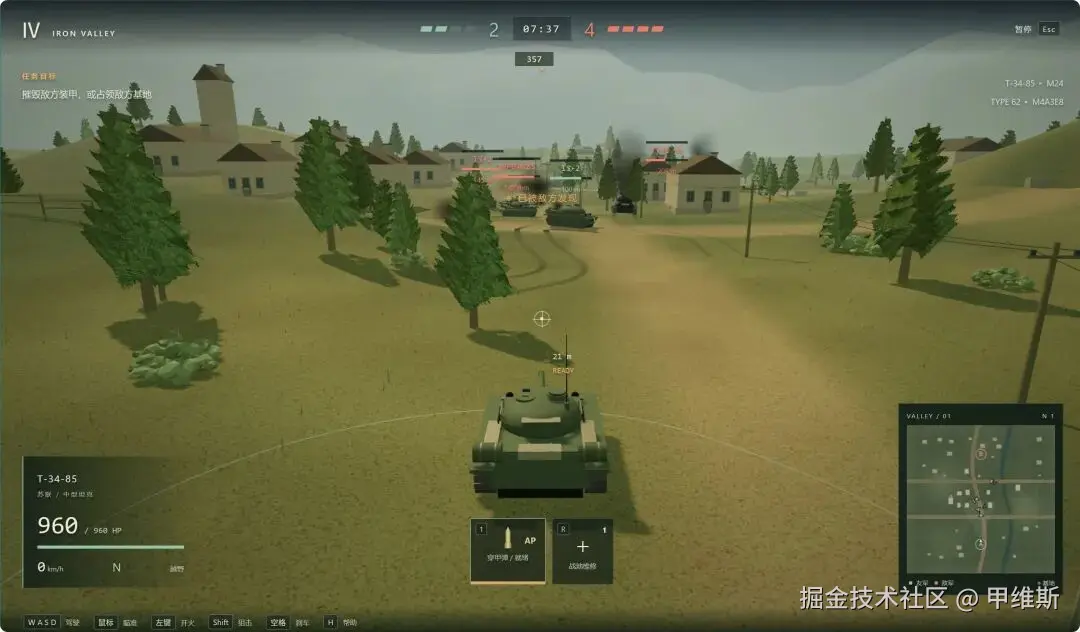
单论建模和场景效果,经过我调整的 Kimi 3.1 Pro V2 版其实已经要比 GPT-6 好一些了!
只是它们都没有达到我的要求,坦克世界不是这种卡通风格。
这里还有一个非常有意思的点,它们整体气质非常像:
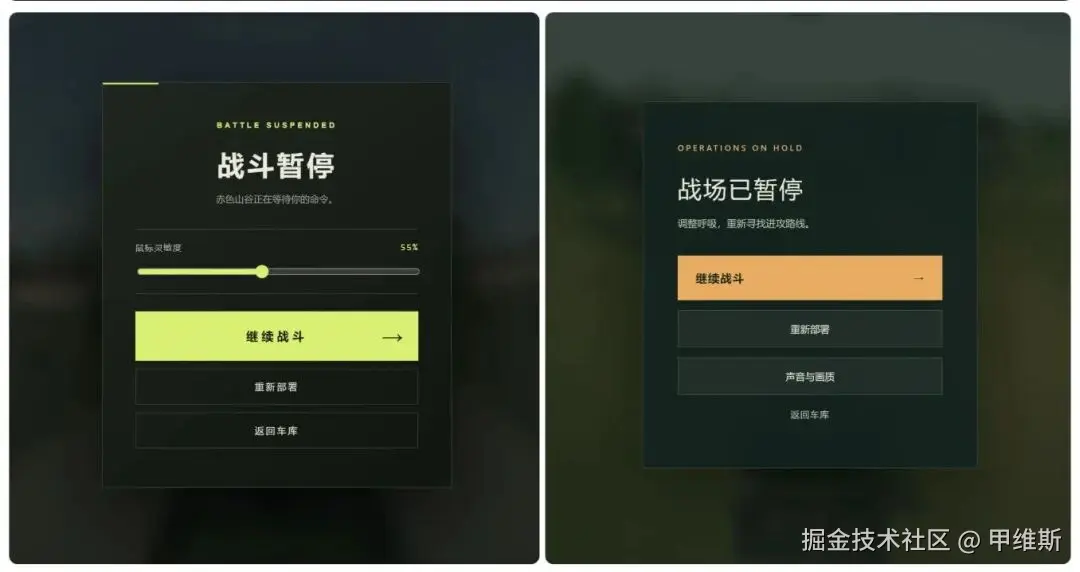
无论是游戏里面,还是 UI,或者配色!
我第一眼看到,就感觉似曾相识,K3.1 Pro 真的"G 里 G 气的"!
这一波我们可以简单粗暴地说,K3.1 Pro 打平 GPT-6 Astra 了~哈哈!
我也算是有个"胶带"了!
这里不拿Claude Opus5对比,否则很拿收场。
3D 建模 Blender
官方重点宣传了 3D 建模和游戏,游戏上面做了一个,下面看看建模!
前几天马斯克用 Roadster 怒刷存在感,这个车子确实也非常帅气。所以我想把它融入到游戏里。
所以专门做了一个建模测试,今天我也让 K3.1 Pro 来做一做!
这个测试例子最棒的一点是它与众不同,它的轮廓非常有特色,所有模型都还没有学习过它的轮廓。
最终建模效果如下:
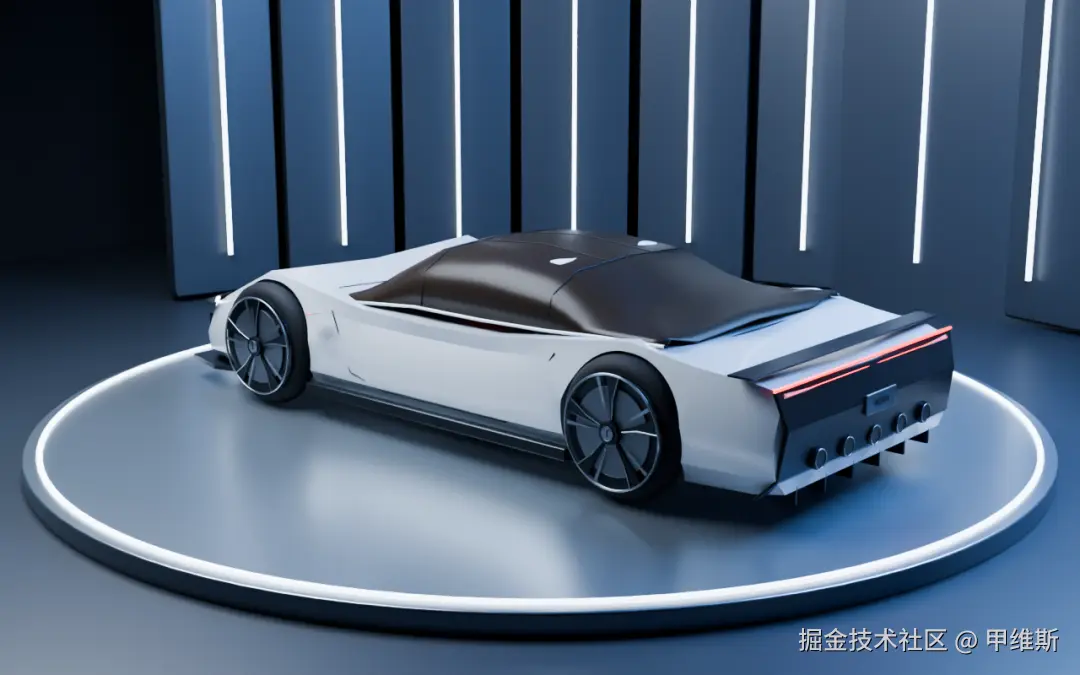
我让它渲染了 10 种场景:
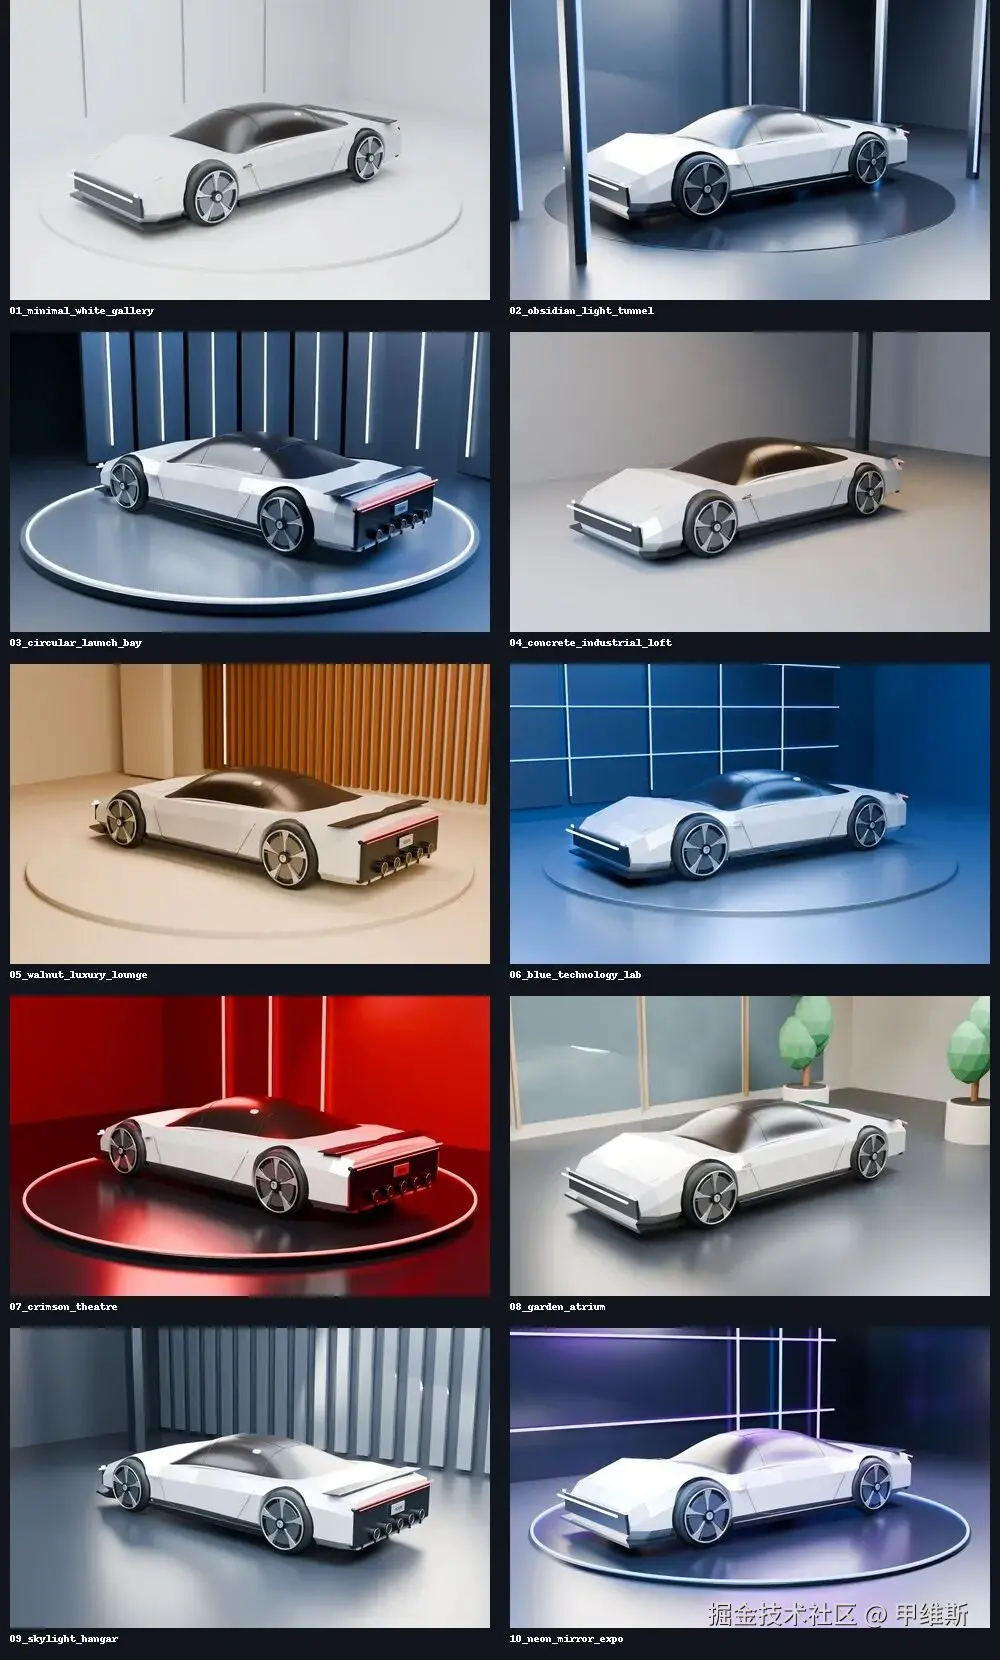
整体来说,有鼻子有眼的,车子是车子,轮子是轮子。大致看起来不错,渲染效果也不错!
K3.1 Pro 在 Blender 中的建模能力应该是比网页中用 three.js 强很多。
但是,细节还是不行:
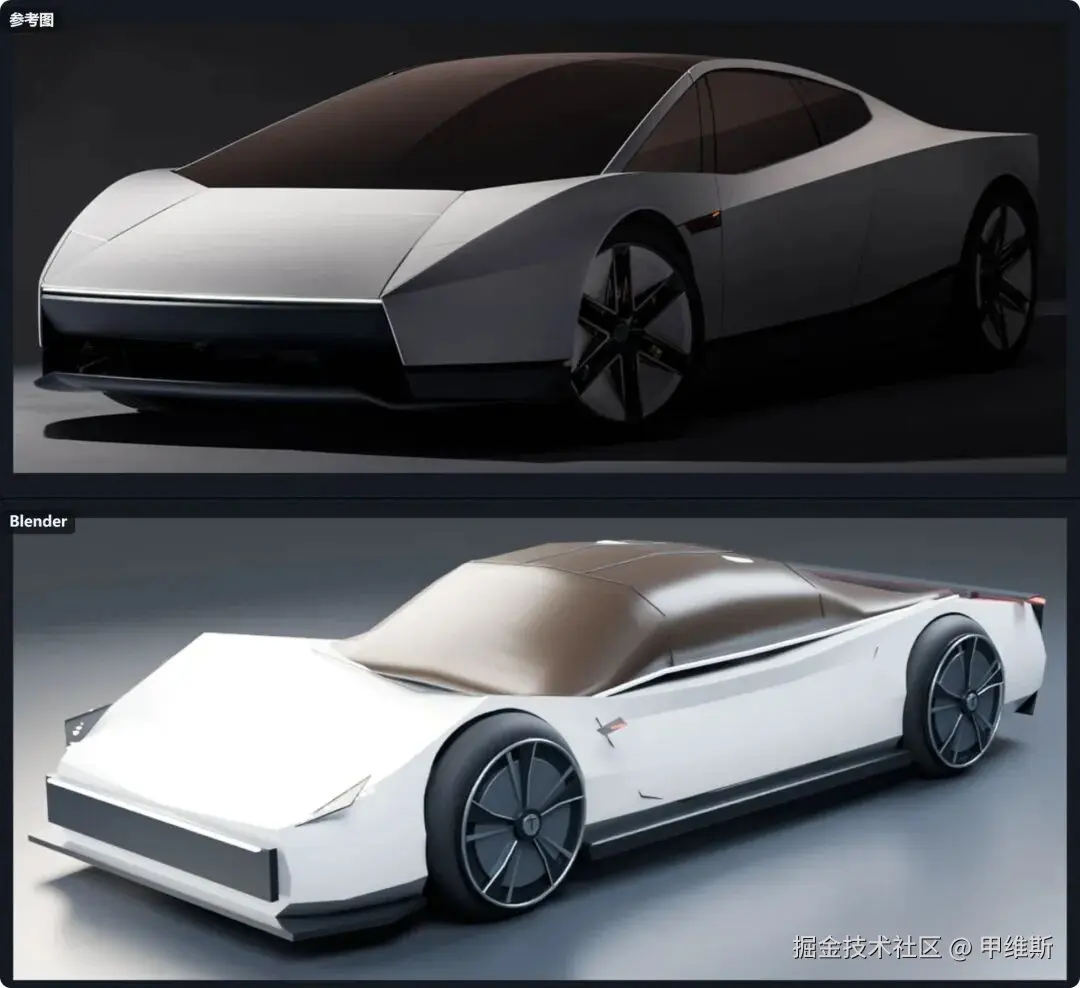
一旦拉近看,就没法看。
这个问题不光是它的问题,Opus5.5 也不行,GPT-6.1 也不行。
GPT-6.1 Sol 在这个项目中做得最好!
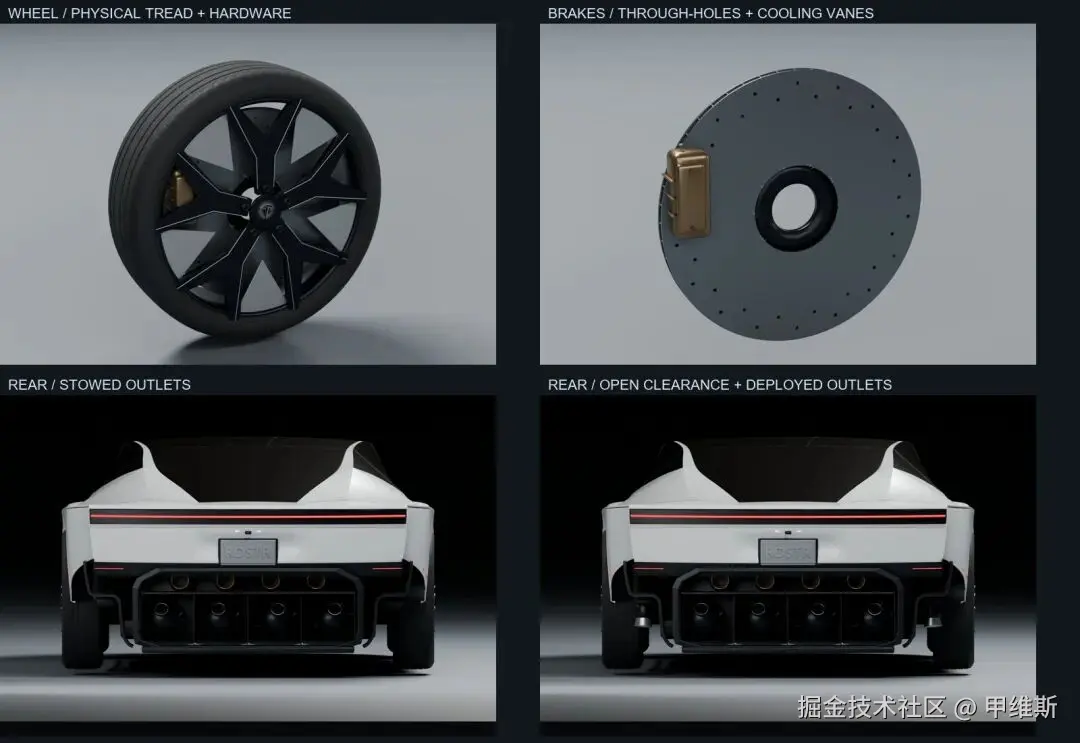
不能说完美,但是它已经考虑到了部件建模了,细节拉满! 左下图是不能起飞的那款,右下图是可以起飞的那款!
虽然 K3.1 Pro 的卖点是建模和游戏。但是大家都通过参考图片建模的情况下,它并不出众,GPT-6.1 Sol 和 Astra 在 Blender 中建模还是很强的,Opus5.5 在网页中建模很强。
至于其他国产模型,我还没试过,大概率会很抽象,估计只能看出来是个车子,但是很难做到 Roadster 的外形线条。
今天已经搞了 7 个例子了,够够的了,该收了!
下面说另外一个大家都很关心的话题。
时间和 tokens 消耗
能力很重要,时间、钱更重要!
Kimi 套餐谁用谁知道,前戏还没完,就结束了!
那么这次 Kimi 3.1 Pro 的消耗怎么样呢? 由于我的套餐比较特殊,不太好代表大家看消耗。
所以我就统计了一下 tokens,然后再算出价格。
同时也把不同任务的时间统计一下!
统计数据如下:
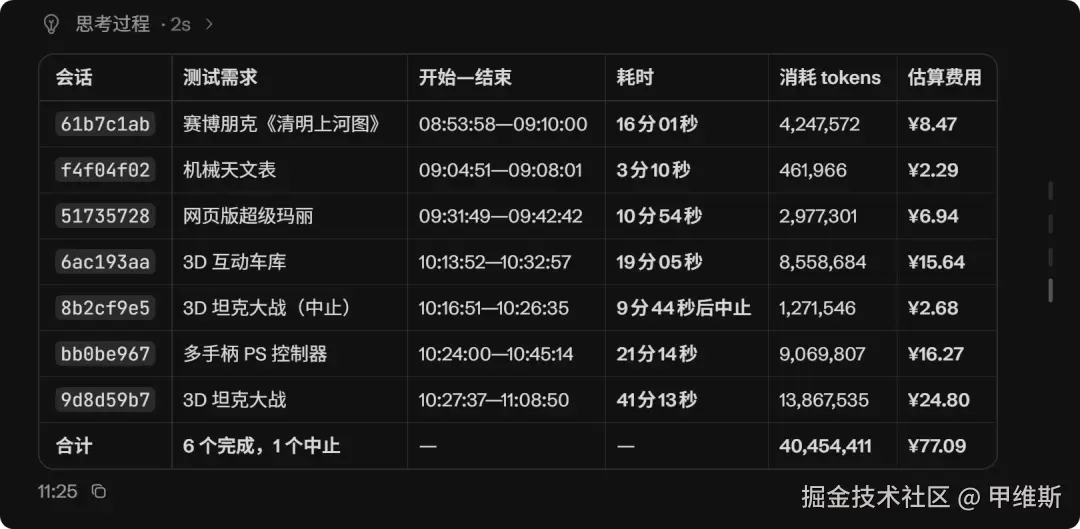
这么多例子,居然只消耗了 4000 万 tokens,77 块钱,难以置信啊!
整体的耗时也算是比较短的。
我之前用其他模型测超级玛丽,最长干到了 6 个小时,一两三个小时也很常见。
一堆国产 Flash,说是速度很快,一旦跑任务,就慢得要死。
K3.1 Pro 大部分例子都在 20 分钟内,这个算是很快了,3D 坦克这个稍微长一些花了 40 分钟。
这个没毛病,当时 Opus 5 也花了个把小时。
至少从时间消耗上来看,已经打败其他国产模型,赶上世界领先水平了!
这就是我开头说的"又快又便宜"的意思了。这是一个相对值,相对上一个版本,以及相对我的预期而言,算是又快又便宜了。
做个小总结
我知道你们其实比较喜欢看我开炮,因为网上吹牛、乱叫的太多了。
但是,我成熟了!
我们要多看人家的进步,努力和优点。
当然,缺点,该提的还是要提,这个是很关键的,否则还测个毛线。
优点:
相比 K3 提升比较明显,大部分例子都有明显提升。
让我意外的一点是,Kimi 3.1 Pro 的速度非常快,这是我很关注的一个点。
现在很多国产 Flash 一点都不 Flash,而 Kimi 这个 Pro 却非常 Flash。
单任务消耗应该比 K3 低很多!
3D 建模能力其实也不错啦,这个在坦克世界和 Blender 的例子里有体现!
这都是实实在在有用的东西。
缺点:
快了之后容易扯到蛋, 我怀疑为了快和省,做了脑切除。
先说一个具体的问题,Kimi Code 内置的 Research 能力(搜索和分析)比较弱,几个项目收集截图都失败了。
长程任务方面,相比国际领先的模型还是有欠缺,快了之后,感觉就不愿意做太多了。
另外自主性方面也不够,无法做到"许愿式编程",一轮出成品!
当然这个要求是高了些,但是 Opus5.5 确实可以!
上限不够高,我本身的期待是它能和 Opus5.5 有来有回,实际上是一拳被 K·O!
文章中 Opus5.5 的结果我没有放太多,不放有不放的原因!
另外发现一个负优化,网页和 PPT 设计感和多样化能力好像降低了很多!
有种 GPT 5.x 化的趋势!
另外,网络上很多牛逼的例子,可能是创作者本身能力强。
如果大家一定要一个确切的排名或者榜单。
我觉得这个排名和我的想法比较接近(Muse 另议):
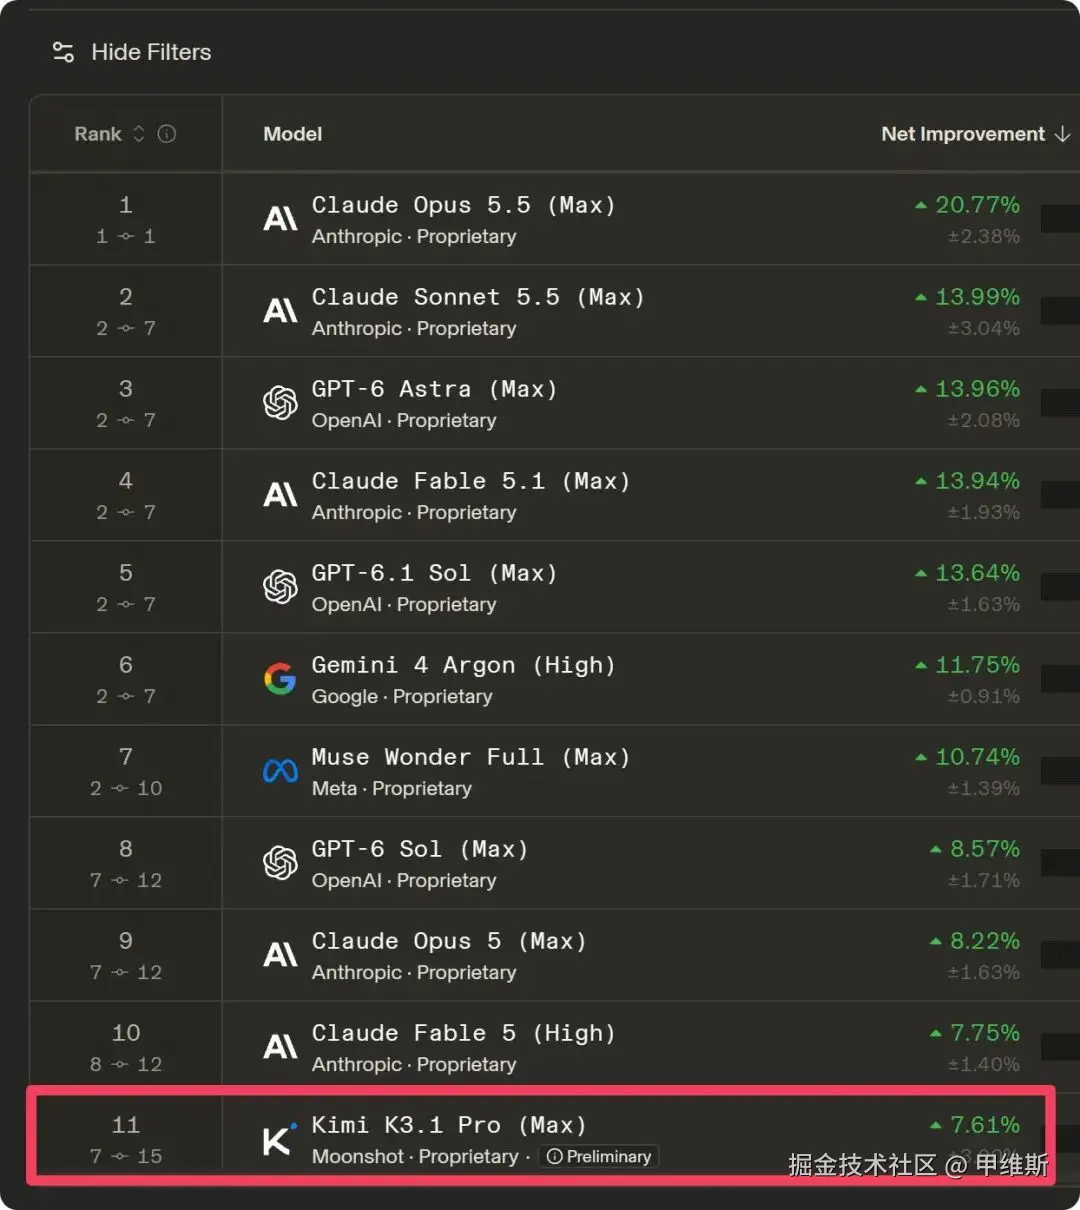
从一个侧面来说,相比 K3 的惊艳,三个月憋出的 0.1,并没啥让人兴奋的点。更多的是一种迫不得已吧! 而且这次所有榜单排名都没有特别高,那么实际情况还是要打点折扣的。
主要是国外的模型太强了,当大家以为国模越来越接近美模的时候,美模突然就踩油门了......!一看推进器是火箭推进器~~
声明一下:
我的测试并不代表任何东西,只代表我的测试,我找题目是比较刁钻的,主要是看它某些极限能力。所以即便是结果不理想,也不意味着它在常规任务中做的不好。结果好的,我就不用解释了是吧,它就是做得好啊!
整体来说:
只要"套餐配额充足",我还是很愿意用这个模型的,能力不错又不磨蹭,在当前也是非常优秀的品质了!
另外,不管模型怎么样,大家都很努力,点个赞吧。
这里面涉及到的对比实很多,我只放了很少一部分,大家可以自行查看,通过网站上的展示进行像素级对比。 K3.1pro的例子我也会马上上传。
后续,我还是打算深入探索一下 K3.1 Pro,如果挖到好东西,我会跟大家分享,如果没有,我就不发了。
话说有 Pro,是不是应该有便宜的 Flash?