摘要:本篇文章按 "问题 → 认知 → 分类 → 武器 → 组合 → 落地 → 验证" 七层递进:先用三台僵尸设备的事故立起痛点,再用三个反直觉认知打破"TCP 可靠、遗嘱秒级"的误区,接着把"假在线"拆成四种死法,逐一配齐 KeepAlive、LWT、Retain、应用层心跳四件武器,讲清楚每种死法怎么打 ;再把四件武器组合成覆盖全部死法的矩阵,说明怎么配合才没有死角 ;然后焊进生产级 ReliableDeviceClient,讲清楚怎么落地成代码 ;最后用排查步骤、踩坑实录和 12 项自检清单,讲清楚怎么验证、怎么上线。七层走完,假在线就从"玄学事故"变成了有清单可查、有代码可抄、有指标可验的工程问题。
00、引子:三台"永远在线"的僵尸设备
案例一:断电 8 小时,平台还显示绿色。 某新能源车企的远程控制平台,用户投诉远程开空调十次有两三次没反应。查下来:车辆网络模块故障离线,但 dashboard 上那些车全是绿色的"在线"。Broker 侧 KeepAlive 设了 3600 秒,Broker 要等 1.5 × 3600 = 5400 秒才判定连接失效;业务层还有一层每小时一次的轮询检测,整个离线发现周期被拉到了 8 小时。设备早就断了,系统还在拿一个过期的"在线"状态骗用户。
案例二:心跳太勤,设备被活活耗死。 某智慧农业项目,2 万台 NB-IoT 土壤湿度传感器,KeepAlive 设了 60 秒,设备每 60 秒唤醒一次发 PINGREQ,光心跳就吃掉了 90% 的电量,48 小时 30% 的传感器电量耗尽离线。
案例三:僵尸设备在线 3 天 11 小时。 某共享设备项目,运营同事深夜找我:"后台显示柜机在线,用户下单指令发下去没反应。"查下去,三个问题串成一条完整的"假在线"链条:设备被直接拔电,没机会发 DISCONNECT,TCP 连接处于半开状态;平台在线状态只靠"收到业务消息刷新 last_seen",IsConnected 一直返回 true;最致命的是没配遗嘱消息(LWT),设备走的时候没在 Broker 留下任何"我死了"的讣告。
三件事指向同一个结论:"假在线"的本质是"没有人负责宣布死亡"。 TCP 层没有能力宣布,业务层没有机制宣布,最后设备就在系统的认知里一直"活着"。
01、先立三个认知,否则一定翻车
认知 1:遗嘱是"Broker 替你发的讣告",只在非正常断开时触发
遗嘱消息(LWT)的工作机制反直觉,这是 90% 误用的源头:
-
设备在 CONNECT 时 ,把一条"我万一非正常断线,请 Broker 替我发布这条消息"的遗嘱寄存在 Broker 上;
-
设备正常断开(发了 DISCONNECT) :Broker 丢弃遗嘱,什么都不发;
-
设备非正常断开 (拔电、断网、KeepAlive 超时、崩溃、ClientId 被抢占):Broker 替它把遗嘱发布到指定的 WillTopic。
关键结论:遗嘱是"意外死亡通知",不是"下线通知"。 正常优雅下线的设备,Broker 不会发遗嘱。正常的上下线状态,应该由业务层显式发布一条在线/离线消息,不能指望 LWT 覆盖所有场景。
认知 2:遗嘱发现掉线的速度 ≈ KeepAlive × 1.5,不是"秒级"
Broker 只有在判定设备已经掉线之后才会发遗嘱,而它判定掉线的依据就是 KeepAlive 超时:
遗嘱触发延迟 ≈ KeepAlive × 1.5
KeepAlive 设 60 秒,设备拔电后,Broker 最长要 90 秒 才判定它死、才发遗嘱。遗嘱的实时性上限,被 KeepAlive 死死锁住------这就是为什么这两件事必须放在一起设计。
认知 3:TCP 靠不住,"连接还在"是一句需要验证的话
TCP KeepAlive 救不了你。 TCP 的 KeepAlive 探测默认是 7200 秒(2 小时) ,而运营商 NAT 的会话超时通常在 5 到 10 分钟。NAT 设备早就把流表删掉了,内核的 TCP KeepAlive 还在等它的两小时探测周期。在这段巨大的时间差里,客户端 IsConnected 依然返回 true,PublishAsync 依然"成功"写入 socket 缓冲区------消息进了黑洞,没有任何一层会报错。
TCP 半开连接:连接"在",但数据过不去。 一端断电、网线被拔、或者网络切换,另一端收不到 FIN/RST,TCP 栈层面连接状态依然维持着。
应用假死:协议栈活着,业务死了。 TCP 栈还能正常应答,但协议进程死锁了、消费队列阻塞了、业务线程已经不处理消息了。连接层面一切正常,Broker 的 KeepAlive 检查也能通过,但消息到了客户端之后被堆在那里,没人处理。
三种场景指向同一个结论:MQTT 的 KeepAlive 和遗嘱消息,不是 TCP 的补充,而是必需的应用层兜底。
02、认清敌人------设备会怎么"死",谁来兜底
在给方案之前,先把"假在线"这个笼统的问题拆成具体的"死法"。四种死法,对应的兜底机制完全不同:
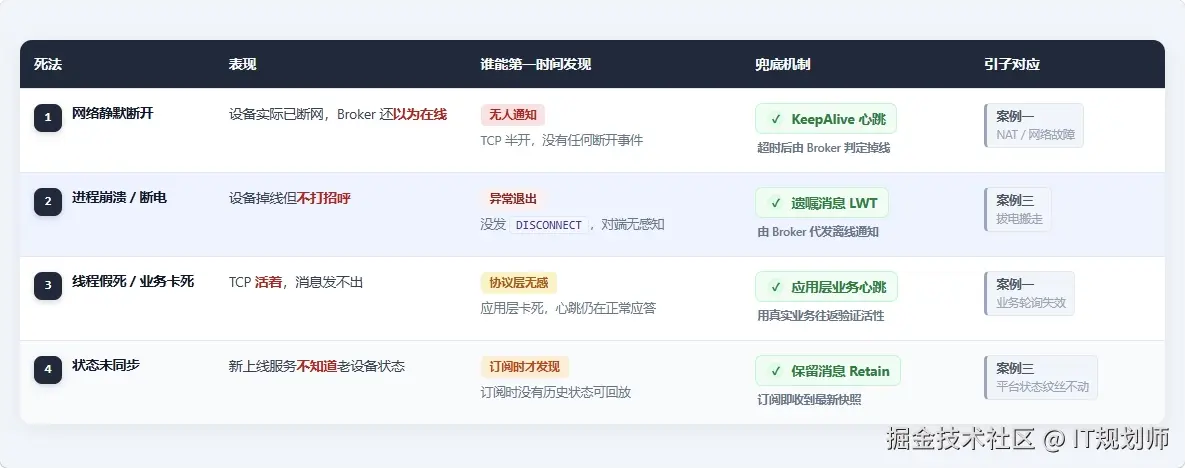
三条必须刻进脑子里的结论:
-
LWT 只覆盖"非正常断开"这一类, 且实时性受 KeepAlive 限制;优雅下线它故意不发。
-
TCP 半开(假在线)是 LWT + 协议心跳都兜不住的死角 ------TCP 没断,Broker 没判掉线,自然不会发遗嘱。这一类只能靠应用层心跳兜底。
-
"假在线"不是一个问题,是一类问题, 没有任何单一机制能全包。下面四根支柱,就是分别对应上表的四种死法。
03、第一根支柱 KeepAlive------定义"死亡时间"
3.1、机制:1.5 倍不是随便写的
KeepAlive 在 CONNECT 报文里由客户端声明,16 位整数,范围 1 到 65535 秒。规则:
客户端承诺:在 KeepAlive 周期内,至少发送一个 MQTT 控制报文(PUBLISH / PINGREQ / SUBSCRIBE 等均可)。
Broker 判定:如果 1.5 × KeepAlive 内没有收到客户端的任何报文,就认为连接已死,关闭连接并触发遗嘱。
一个经常被忽略的优化点:业务数据报文可以替代 PINGREQ。设备每 30 秒上报一次遥测,KeepAlive 设 60 秒,它根本不需要单独发心跳,遥测报文本身就完成了"我还活着"的声明。
KeepAlive = 0 表示关闭心跳检测 ,Broker 不会主动做超时判定。这是假在线的重灾区,生产环境严禁设置 0。
3.2、本质:它决定的是"数据丢失窗口"
把 KeepAlive 理解成"心跳频率"是不够的。它真正决定的是:从连接实际断开,到系统开始把数据存到本地/标记离线,中间有多长的黑洞期。 半开连接场景下,最长可能丢失 1.5 × KeepAlive 时间窗口内的数据。
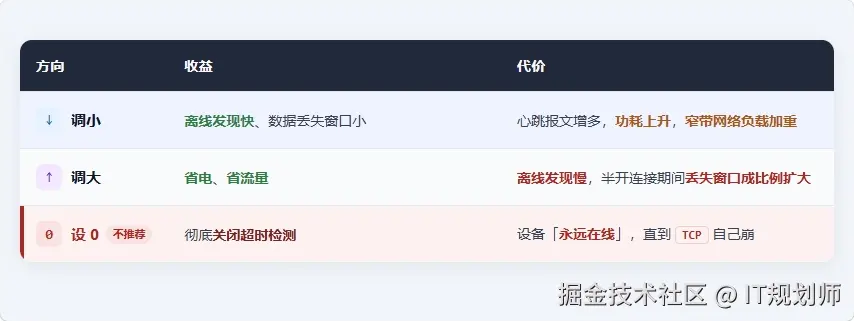
3.3、分层配置:没有"最佳值",只有"匹配值"
KeepAlive 从来不是一个可以"抄默认值"的参数,它的取值被两条硬约束夹在中间:下限是 NAT 空闲超时 (超过它链路会被运营商静默掐断),上限是业务离线发现 SLA(超过它指令石沉大海的投诉会打爆客服)。在这两条线之间,还要叠加设备供电方式------电池设备每多一次心跳就少活一天,市电设备则可以大方地用短心跳换快速发现。下面按设备类型给出经过生产验证的推荐区间:
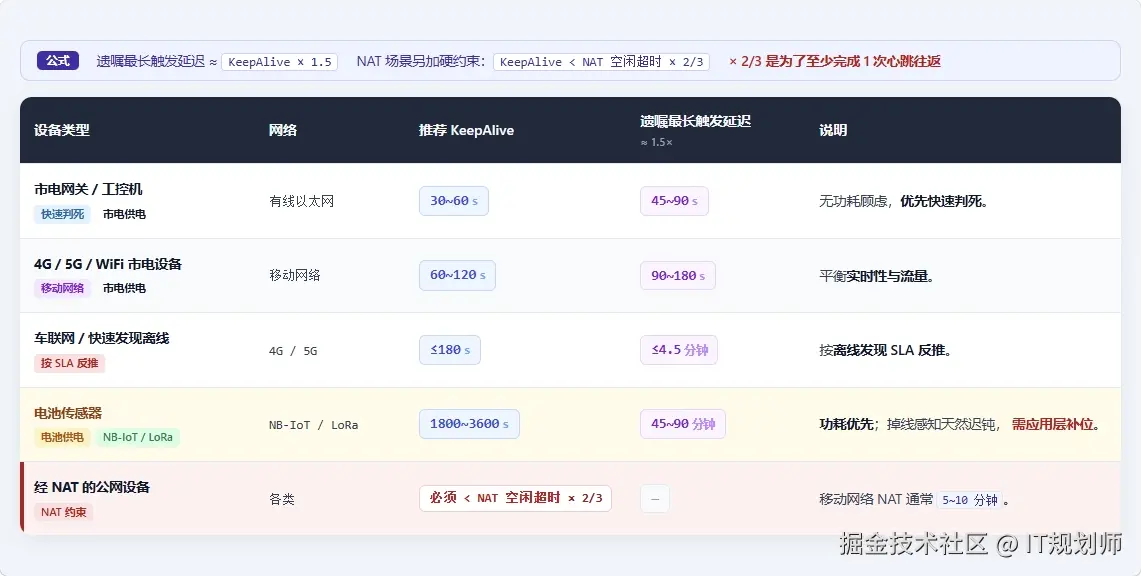
三条铁律:
-
KeepAlive ≠ 0:0 = 关闭心跳,设备拔电后 Broker 永远不判死,遗嘱永远不发,纯纯僵尸连接。
-
**经 NAT 必须对齐 NAT 超时:**NAT 空闲会话常 5~10 分钟就被回收,KeepAlive 必须显著小于它,实践中建议取 NAT 超时的 2/3 以内。否则链路被 NAT 悄悄掐断,你还在半开连接上蒙在鼓里。
-
**KeepAlive 必须小于业务离线发现 SLA ÷ 1.5:**远程控制类业务的离线发现 SLA 如果是 5 分钟,KeepAlive 必须压到 180 秒以内。
3.4、三个正反面案例
-
NB-IoT 电池传感器(案例二的反面) : 2 万台设备设计续航 1 年,KeepAlive 设 60 秒,48 小时 30% 电量耗尽。合理区间应该是 1800~3600 秒。如果同时依赖 LWT 做离线通知,Will Delay 和 Session Expiry 也要跟着放大,否则会出现"心跳还没超时,会话已经过期,遗嘱提前发布"的时序错乱。
-
4G 移动网络(关键教训) : 某 NB-IoT 智慧农业项目,KeepAlive 设 300 秒,当地基站每 30 分钟做一次信道切换,切换期间约 2 分钟信号不稳定,心跳在丢包窗口内丢失,Broker 在 450 秒后判定超时断开。最终把 KeepAlive 缩短到 120 秒、Broker 超时设为 180 秒,才消除了周期性断连。
-
车联网(案例一的反面典型) : KeepAlive 3600 秒导致 8 小时才发现离线。离线发现 SLA 是 5 分钟的话,KeepAlive 必须压到 180 秒以内。
3.5、MQTTnet 5.x:Server Keep Alive 的获取方式
5.x 中 MqttFactory 已拆分为 MqttClientFactory 和 MqttServerFactory,客户端通过 MqttClientFactory 创建。Broker 可以在 CONNACK 中截断客户端请求的 KeepAlive,ServerKeepAlive 属性挂在 MqttClientConnectResult 上,通过连接事件的 ConnectResult 获取:
csharp
_client.ConnectedAsync += e =>
{
    var serverKeepAlive = e.ConnectResult?.ServerKeepAlive;
    if (serverKeepAlive.HasValue && serverKeepAlive.Value != 0)
        _logger.LogInformation("Broker 指定的 KeepAlive: {KeepAlive}s", serverKeepAlive.Value);
    return Task.CompletedTask;
};
一个必须警惕的 5.x 行为 :当 KeepAlive 的 PING 超时时,MqttClient 内部可能捕获异常后静默返回,DisconnectedAsync 不会触发,IsConnected 继续报告 true。这意味着协议层自身就可能制造"假在线"------不能把 DisconnectedAsync 当作断连的唯一信号,应用层心跳和外部 Watchdog 必须在协议层之外独立运行。
04、第二根支柱 LWT------把"我掉线了"广播出去
4.1、寄存遗嘱:MQTTnet 5.x 怎么写
csharp
var options = new MqttClientOptionsBuilder()
    .WithTcpServer("broker.example.com", 8883)
    .WithClientId("gw_prod_parkA_001")
    .WithCredentials("device", "******")
    .WithTlsOptions(o => o.UseTls())
    // 5.x 默认使用 MQTT 5.0.0,Will Delay 无需额外声明协议版本
    .WithKeepAlivePeriod(TimeSpan.FromSeconds(60))
    .WithCleanSession()                        // CleanStart = false
    .WithSessionExpiryInterval(7200)
    // ===== 遗嘱三要素 =====
    .WithWillTopic("svc/device/gw_prod_parkA_001/status")
    .WithWillPayload("{\"status\":\"offline\",\"reason\":\"unexpected_disconnect\",\"last_will\":true}")
    .WithWillQualityOfServiceLevel(MqttQualityOfServiceLevel.AtLeastOnce)
    .WithWillRetain(true)
    .WithWillDelayInterval(TimeSpan.FromSeconds(20))
    .Build();
遗嘱 Topic 设计范式(小写、/ 分层、无通配符特殊字符):
csharp
svc/device/{clientId}/status           // 单设备在线状态(推荐)
{product}/{env}/device/{deviceId}/lwt  // 按产品/环境隔离
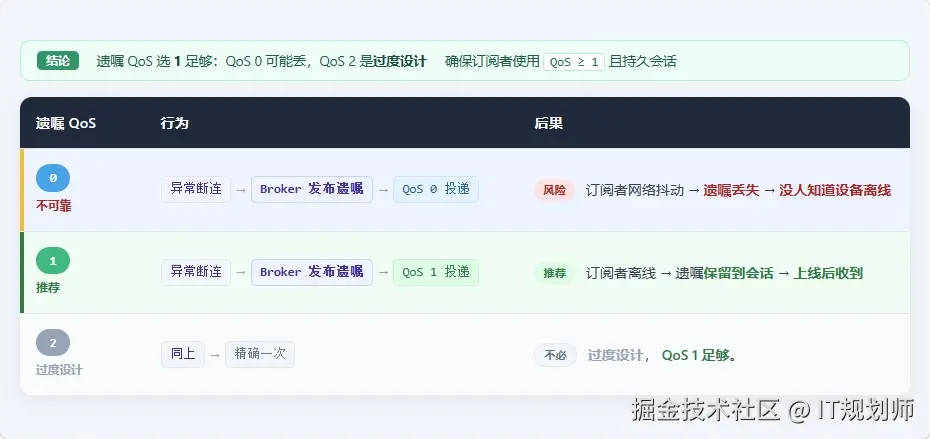
4.2、遗嘱 QoS 必须 ≥ 1
LWT 是设备离线后由 Broker 代发的最后一条消息 ------ 它本身的 QoS 决定这条"讣告"能不能被订阅者收到。遗嘱本身就是"设备已掉线"这个信号,丢了就等于没配。
4.3、Retain:遗嘱几乎一定要带,且要与"自报上线"对称
这是 LWT 最关键的实战细节,没有之一。 案例三里"平台状态纹丝不动"的一半原因就是没配 LWT;另一半原因,即使配了 LWT 如果没开 Retain,运维重启一次服务就永远看不到离线状态了。
遗嘱 Retain = true 的价值:
-
运维大屏、告警服务是后来才订阅 的。如果遗嘱不带 Retain,它只在"掉线那一刻"广播一次,错过的订阅者永远看不到这条离线状态。
-
带上 Retain,遗嘱就成了 Broker 上该设备最新的、持久的状态快照------任何时刻新订阅者一连上,立刻拿到"它现在是 offline"。
配套纪律 :设备正常上线 时,必须主动向同一个 status Topic 发一条 **Retain 的 **{"status":"online"}。这套"上线自报 online(Retain)+ 掉线发遗嘱 offline(Retain)"的对称设计,是整个在线状态方案的骨架。status Topic 始终保留设备最后一次已知状态,任何监控只需订阅这一个 Topic、读 Retain 值即可。
csharp
_client.ConnectedAsync += async _ =>
{
    await _client.PublishAsync(new MqttApplicationMessageBuilder()
        .WithTopic(_statusTopic)
        .WithPayload("{\"status\":\"online\",\"ts\":" + DateTimeOffset.UtcNow.ToUnixTimeSeconds() + "}")
        .WithQualityOfServiceLevel(MqttQualityOfServiceLevel.AtLeastOnce)
        .WithRetainFlag(true)
        .Build());
    await RestoreSubscriptionsAsync();
};
一个反直觉的坑 :遗嘱带 Retain 后,新订阅者一连上会立刻收到这条 Retain 遗嘱------这是"历史最后状态快照",不是"刚刚离线"的事件。消费侧若拿"收到消息"就直接弹告警,会在每次服务重启时把一堆早就离线的设备误报成"刚刚掉线"。正确做法:遗嘱 Payload 里用 last_will=true 标记,消费侧用消息时序或自身启动时间戳判别。
4.4、Will Delay Interval:给重连留一个缓冲窗口
MQTT 3.1.1 的遗嘱是"立即发布",网络抖动场景下会造成误报 ------设备只是短暂断连 3 秒,重连回来了,但遗嘱已经发出去了。MQTT 5.0 引入 Will Delay Interval :Broker 在连接关闭后,先等一段时间再发布遗嘱;如果客户端在延迟窗口内重新连接,遗嘱永远不会触发。
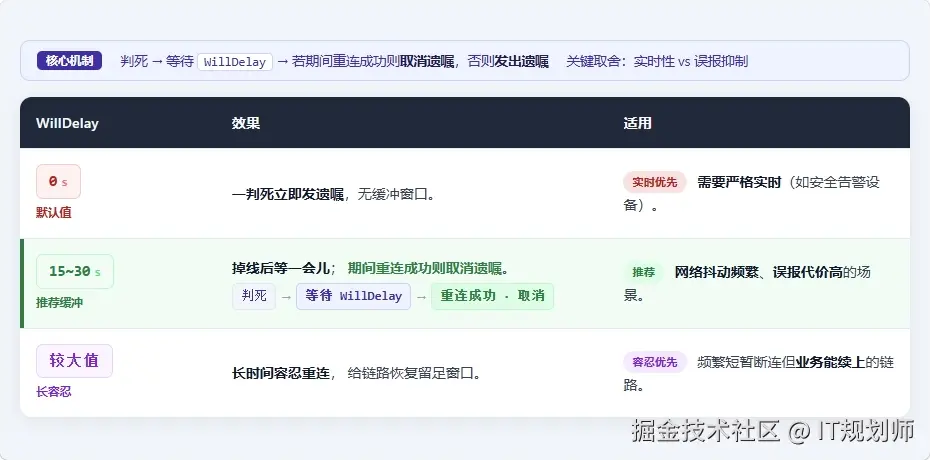
两个必须知道的边界:
-
遗嘱实际发布时间 = min(WillDelay, SessionExpiryInterval)。会话在 WillDelay 到点之前先过期,遗嘱会被一并丢弃、永远发不出来------所以设了 WillDelay,务必让 SessionExpiry > WillDelay。
-
"重连是否取消遗嘱"取决于 Broker 实现与 ClientId 是否一致。如果客户端被降级到 3.1.1,WithWillDelayInterval 会被静默忽略、退化为立即发布。
4.5、Payload 放什么
遗嘱 Payload 是 CONNECT 时写死的静态串,不能带运行时动态内容。放这几样:
-
status:固定 offline
-
reason:约定为 unexpected_disconnect(遗嘱只可能是意外掉线)
-
device_id / product:便于消费侧不查表就知道是谁
-
last_will=true:显式标记,方便消费侧区分"遗嘱离线"和"应用层主动上报的离线"
别在遗嘱里塞时间戳 ------设备 CONNECT 时根本不知道未来哪一刻会掉线,写进去的时间是假的、会误导排查。掉线时间由消费侧收到遗嘱的那一刻自己打。
4.6、遗嘱四个高频坑
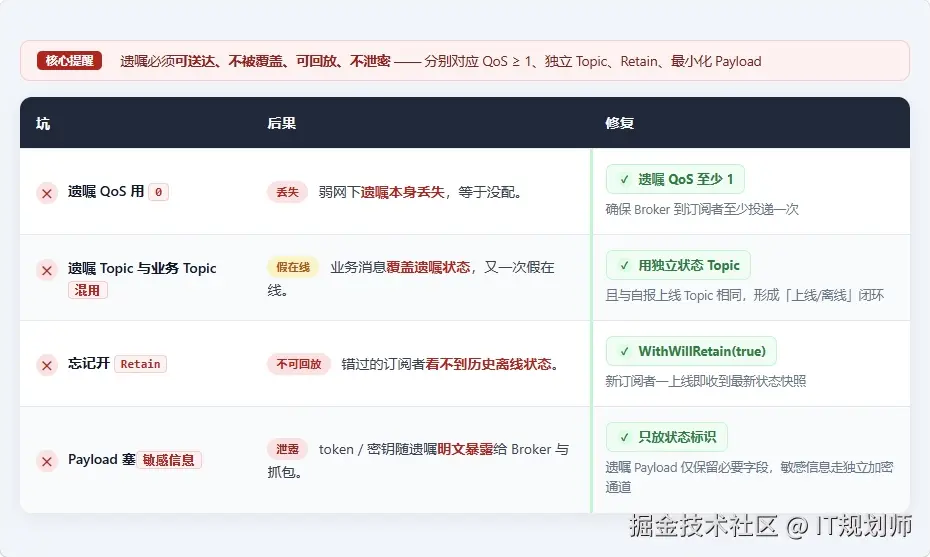
遗嘱配了不等于生效 ------ 四个细节没对齐,离线通知依然可能丢失、被覆盖或泄露。
这四个坑是生产环境里出现频率最高、排查成本也最大的 LWT 配置错误。每一个单独拿出来都足以让整套在线状态方案形同虚设------QoS 0 让遗嘱"丢了没人知道",Topic 混用让业务消息把离线状态覆盖回去,忘开 Retain 让后上线的监控系统永远看不到历史状态,Payload 塞敏感信息则直接把安全防线撕开一个口子。按这个表逐条对照你的配置,能拦住 80% 的遗嘱相关故障:
05、第三根支柱 Retain + 在线状态表设计
案例三里平台状态纹丝不动的另一半原因,是在线状态表设计错了:它依赖"轮询 last_seen"。
5.1、反模式:轮询 last_seen(僵尸设备的根源)
csharp
设备每条上报 → UPDATE device SET last_seen=NOW()
定时任务 → SELECT WHERE last_seen < NOW()-interval → 标离线这套看着能用,但致命缺陷:设备假在线(TCP 半开)或干脆不发业务消息时,last_seen 停在最后一次上报,而判离线的阈值若比 KeepAlive×1.5 还大,就会出现"既不报活也永不标离线"的窗口。 引子里那台"在线 3 天"的设备,就是这套逻辑 + 长 KeepAlive 造出来的。
5.2、正模式:以 LWT 事件为准,双向 Retain 覆盖
核心思想一句话:同一个状态 Topic,三方写入、全部 Retain ------ 新订阅者订阅即获最新快照,reason 字段区分「意外」与「计划内」。
唯一可信的写入者是"在线状态消费者",它订阅 svc/device/+/status,只认三种 Retain 事件:
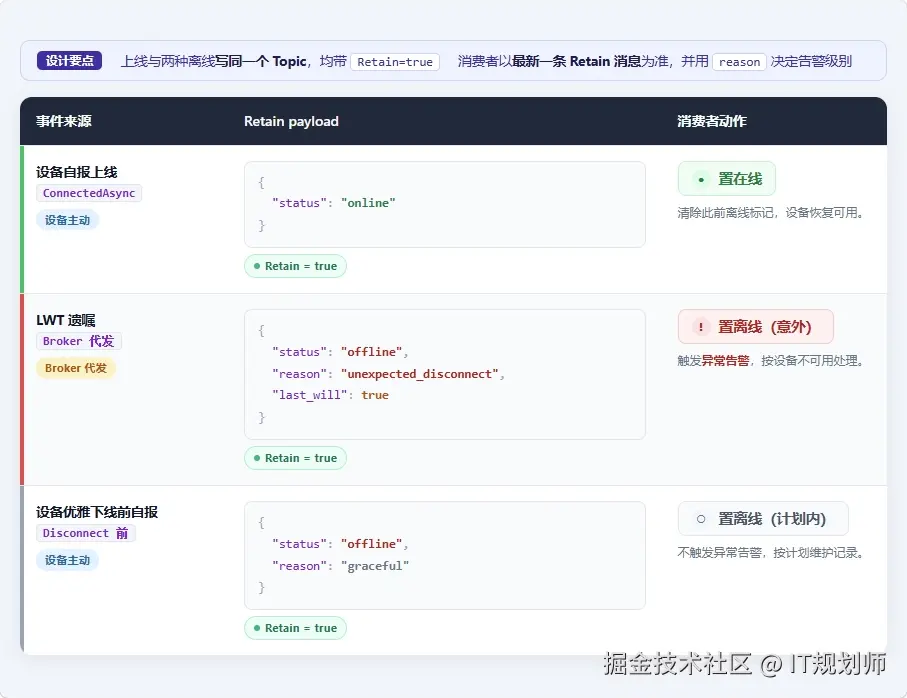
三种事件写同一个 Retain Topic,后到的覆盖先到的,Broker 始终只保存每个设备的最终状态。这意味着------
-
设备先上线、后掉线 → 遗嘱覆盖上线状态 → 最终离线 ✅
-
设备先掉线(遗嘱已到)、后重连上线 → 上线覆盖遗嘱 → 最终在线 ✅
-
消费者中途重启 → 重新订阅 → 拿到 Broker 里最新的 Retain → 状态不丢 ✅
消费者只需做三件事:订阅一次 → 读 Retain → 落库/推大屏。 不需要任何"超时判离线"的定时任务,不需要自己维护心跳计时器------判死这件事已经完整交给 KeepAlive + LWT 了。你的应用层只管消费确定性的状态变更事件,不再承担任何猜测设备生死的职责。
5.3、优雅下线的补位
遗嘱故意不为优雅下线而发,所以设备在主动断开前,必须补发一条离线:
csharp
public async Task GracefulShutdownAsync()
{
    if (_client.IsConnected)
    {
        await _client.PublishAsync(new MqttApplicationMessageBuilder()
            .WithTopic(_statusTopic)
            .WithPayload("{\"status\":\"offline\",\"reason\":\"graceful\"}")
            .WithQualityOfServiceLevel(MqttQualityOfServiceLevel.AtLeastOnce)
            .WithRetainFlag(true)
            .Build());
        await Task.Delay(200);
        await _client.DisconnectAsync();   // DISCONNECT → Broker 丢弃遗嘱,避免重复
    }
}
这样"计划内离线"和"意外掉线"在状态表里都能被准确区分。
5.4、平台侧消费注意事项
如果遗嘱带 Retain,平台重连后重新订阅时,Broker 会立即推送最新的遗嘱状态,哪怕这条遗嘱是几小时前发布的。平台不能把"收到遗嘱"直接等同于"设备刚刚离线":
csharp
subscriber.ApplicationMessageReceivedAsync += async e =>
{
    var topic = e.ApplicationMessage.Topic;
    if (topic.EndsWith("/status"))
    {
        var deviceId = topic.Split('/')[3];
        if (_deviceStatusService.IsOnline(deviceId) && IsStaleWill(e.ApplicationMessage))
            return;   // 旧 Retain 快照不覆盖当前在线状态
        await _deviceStatusService.MarkOfflineAsync(deviceId);
    }
};06、第四根支柱 应用层心跳------戳穿协议层管不到的死角
案例一里最阴的一环:TCP 半开、IsConnected 撒谎、Broker 没判掉线所以不发遗嘱 ------前三层全部失效。更重要的是,MQTTnet 5.x 中 Keep-Alive PING 超时可能被静默忽略,DisconnectedAsync 根本不触发。应用层心跳必须在协议层之外独立运行,不能依赖协议层通知。
6.1、变体 A:往返探测(ping/pong)
**适合网关/服务端能回 PONG 的场景。**本质是在 MQTT 协议心跳之上再架一层"应用级 RTT 校验"------协议层心跳只能证明 TCP 还活着,ping/pong 能证明对端应用进程还在正常处理消息。
csharp
private Timer? _appHeartbeat;
private TaskCompletionSource<bool>? _pendingPong;
private void StartAppHeartbeat()
{
    _appHeartbeat = new Timer(async _ =>
    {
        if (!_client.IsConnected) return;
        var tcs = new TaskCompletionSource<bool>(TaskCreationOptions.RunContinuationsAsynchronously);
        _pendingPong = tcs;
        try
        {
            await _client.PublishAsync(new MqttApplicationMessageBuilder()
                .WithTopic($"svc/heartbeat/ping/{_clientId}")
                .WithPayload(DateTimeOffset.UtcNow.ToUnixTimeMilliseconds().ToString())
                .WithQualityOfServiceLevel(MqttQualityOfServiceLevel.AtMostOnce)
                .Build());
            var completed = await Task.WhenAny(tcs.Task, Task.Delay(TimeSpan.FromSeconds(15)));
            if (completed != tcs.Task)
            {
                _logger.LogError("APP-LAYER HEARTBEAT TIMEOUT, force disconnect: {Id}", _clientId);
                await _client.DisconnectAsync();
            }
        }
        finally { _pendingPong = null; }
    }, null, TimeSpan.FromSeconds(30), TimeSpan.FromSeconds(30));
}
6.2 变体 B:单调序号上报(健康上报)
适合设备侧不方便处理 PONG 应答的场景。设备周期性向业务 Topic 发布带单调递增序号的健康消息;平台侧连续 N 个周期没收到新序号,标记"应用层不可达"。
csharp
var seq = 0L;
var healthTimer = new PeriodicTimer(TimeSpan.FromMinutes(5));
while (await healthTimer.WaitForNextTickAsync(ct))
{
    await _client.PublishAsync(new MqttApplicationMessageBuilder()
        .WithTopic($"svc/device/{_clientId}/health")
        .WithPayload($"{{\"seq\":{++seq},\"ts\":{DateTimeOffset.UtcNow.ToUnixTimeSeconds()}}}")
        .WithQualityOfServiceLevel(MqttQualityOfServiceLevel.AtMostOnce)
        .Build());
}
6.3 再补一层:业务 Watchdog(治"假活")
对"设备活着但上报卡死"这一类(连接在、业务线程 hang),协议心跳和应用层心跳都可能探测不到,需要独立巡检线程:平台侧记录"最后一次有效上报时间",超过预期周期 2~3 倍即告警。这一层不依赖设备侧任何心跳信号,是"假活"的最后兜底。
关键认知:应用层心跳是"假在线"的唯一解药。 LWT 负责"链路真断时广播讣告",应用层心跳负责"链路假断时主动戳穿",业务 Watchdog 负责"链路在但人不干活"。三者合起来,才叫"永远不会假在线"。
07、四层机制总览------怎么组合才没有死角
单独看,每一层机制都只能覆盖一种假在线场景;合在一起,它们构成了一个逐级兜底、互不重叠的防御矩阵。协议层负责"链路还通不通",会话层负责"对端是不是非正常走了",消息层负责"新来的观察者能不能立刻看到真相",业务层负责"应用进程本身是不是还活着"。四层各管各的死法,没有哪一层越俎代庖,也没有哪种假在线能穿透全部四层。下面的对照表把每一层的职责边界、能治的假在线类型、触发方式以及回应的引子案例一次对齐:
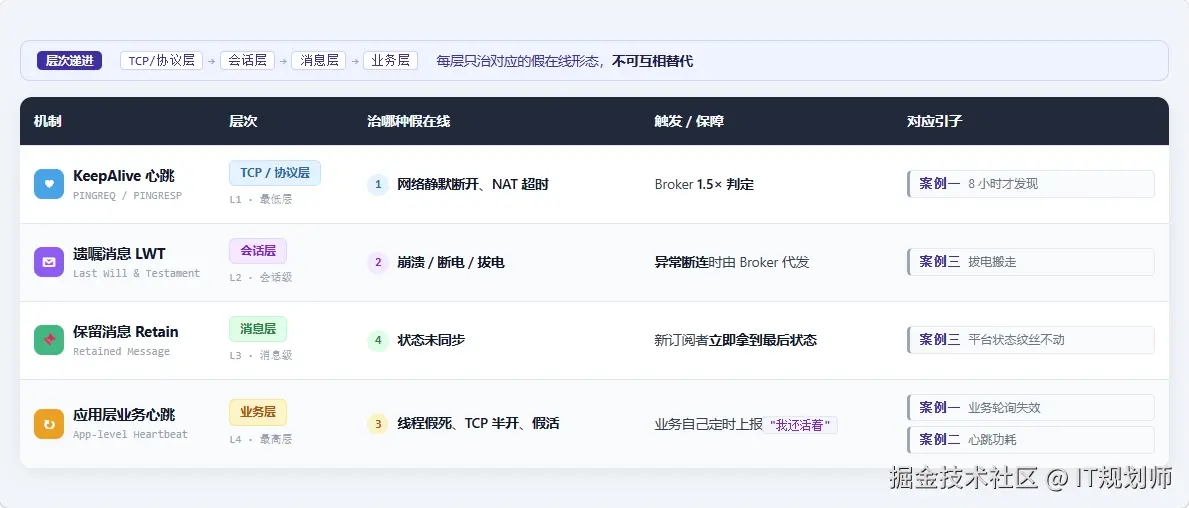
四层的关系可以这样记:KeepAlive 是"死亡计时器",LWT 是"死亡通知书",Retain 是"最后状态快照",应用层心跳是"活体检测"。只做 LWT,只是有了死亡通知,没解决判死时效;只做 KeepAlive,只是有了判死,下游不知道;四层齐了,设备状态才从"TCP 觉得它在"变成"系统能证明它还在"。
MQTTnet 5.x 的特殊提醒 :5.x 的协议层可能静默吞掉 PING 超时,DisconnectedAsync 不触发而 IsConnected 仍为 true。因此第四层不能省,也不能等协议层通知------应用层心跳必须独立定时运行,这是 5.x 下"自管连接生命周期"的硬性要求。
08、生产级封装------MQTTnet 5.x 的 ReliableDeviceClient
MQTTnet 5.x 移除了 ManagedMqttClient,重连、重订阅、发送队列全部由业务代码接管。下面的封装把四层机制焊进一个类,重点不是"配置托管客户端",而是自行编排生命周期。
csharp
using MQTTnet;
using MQTTnet.Protocol;
using Microsoft.Extensions.Logging;
using System.Collections.Concurrent;
namespace MqttClient.Demo;
// 可靠设备客户端。
// 四层可靠性机制焊进一个类,全部由业务代码接管(不依赖托管客户端):
//   ① TCP 保活(KeepAlive);② 遗嘱(Will);③ 自报状态(Retain);④ 应用层心跳。
// 对应 MQTTnet 5.x:
//   - MqttClientFactory 替代 MqttFactory;
//   - IMqttClient 替代 IManagedMqttClient,重连由 ConnectWithRetryAsync 自行实现,无托管退避;
//   - PublishAsync 返回 MqttClientPublishResult,用 IsSuccess 判断,失败入 _retryQueue;
//   - 5.x 没有 EnqueueAsync,发送队列由业务侧自建;
//   - 没有 ApplicationMessageNotConsumedAsync,发送队列水位由业务侧自行监控;
//   - 遗嘱仍通过 MqttClientOptionsBuilder 的 WithWillXXX 链式配置。
public class ReliableDeviceClient : IAsyncDisposable
{
    #region 字段
    // 底层 MQTTnet 客户端实例,负责实际协议收发。
    private readonly IMqttClient _client;
    // MQTT 连接选项(broker 地址、客户端 ID、保活、会话持久、遗嘱等)。
    private readonly MqttClientOptions _options;
    // 日志记录器,用于输出连接、重连、心跳、发送等运行信息。
    private readonly ILogger _logger;
    // 客户端 ID,用于状态主题、命令主题、心跳主题的拼接。
    private readonly string _clientId;
    // 状态主题(svc/device/{clientId}/status),用于 Retain 自报在线/离线。
    private readonly string _statusTopic;
    // 应用层心跳间隔秒数。
    private readonly int _heartbeatIntervalSec;
    // 单次心跳等待 pong 的超时秒数,超时视为心跳失败并强制重连。
    private readonly int _pongTimeoutSec;
    // 业务自建发送重试队列(替代托管客户端的 EnqueueAsync/ApplicationMessageNotConsumedAsync)。
    private readonly ConcurrentQueue<MqttApplicationMessage> _retryQueue = new();
    // 重连锁:保证同一时刻只有一个连接/重连流程在跑,避免并发重连。
    private readonly SemaphoreSlim _connectLock = new(1, 1);
    // 重连/后台任务的取消令牌源,Start 时创建,GracefulShutdown 时取消。
    private CancellationTokenSource? _reconnectCts;
    // 应用层心跳定时器。
    private Timer? _appHeartbeat;
    // 待 pong 完成的任务源:收到 pong 时置成功,超时判定为心跳失败。
    private TaskCompletionSource<bool>? _pendingPong;
    // 心跳防重入标志:上一次 tick 未完成时跳过本次,避免 _pendingPong 单槽被覆盖。
    private int _heartbeatRunning;
    // 手动关停标志:置位后不再自动重连。
    private volatile bool _manualShutdown;
    #endregion
    #region 事件
    // 收到 broker 推送的应用消息(命令等业务消息)时触发。
    // 心跳 pong 等内部控制消息不会触发本事件。
    public event Func<MqttApplicationMessage, Task>? ApplicationMessageReceived;
    #endregion
    #region 构造函数
    // 创建一个可靠设备客户端。
    // 参数:
    //   brokerHost            broker 主机地址。
    //   brokerPort            broker 端口。
    //   clientId              稳定唯一的客户端 ID(会话持久,重连需固定)。
    //   logger                日志记录器。
    //   username              可选用户名;为空则不做认证。
    //   password              可选密码;配合 username 使用。
    //   useTls                是否启用 TLS。
    //   heartbeatIntervalSec  应用层心跳间隔秒数。
    //   pongTimeoutSec        单次心跳等待 pong 的超时秒数。
    public ReliableDeviceClient(
        string brokerHost,
        int brokerPort,
        string clientId,
        ILogger logger,
        string? username = null,
        string? password = null,
        bool useTls = false,
        int heartbeatIntervalSec = 30,
        int pongTimeoutSec = 15)
    {
        // 保存基础配置。
        _clientId = clientId;
        _logger = logger;
        _statusTopic = $"svc/device/{clientId}/status";
        _heartbeatIntervalSec = heartbeatIntervalSec;
        _pongTimeoutSec = pongTimeoutSec;
        // 5.x: MqttFactory 已拆分,客户端使用 MqttClientFactory。
        _client = new MqttClientFactory().CreateMqttClient();
        // 构建连接选项链:保活、会话持久、遗嘱。
        var builder = new MqttClientOptionsBuilder()
            .WithTcpServer(brokerHost, brokerPort)
            .WithClientId(_clientId)
            .WithKeepAlivePeriod(TimeSpan.FromSeconds(60))          // 支柱①:TCP 保活
            // 会话持久:不清理(CleanSession=false),配合 SessionExpiry 让重连后订阅与离线消息保留。
            // 不要再用 WithCleanSession(),否则与 SessionExpiryInterval 语义冲突。
            .WithCleanSession(false)
            .WithSessionExpiryInterval(7200)
            .WithWillTopic(_statusTopic)                             // 支柱②:遗嘱
            .WithWillPayload($"{{\"status\":\"offline\",\"reason\":\"unexpected_disconnect\",\"last_will\":true}}")
            .WithWillQualityOfServiceLevel(MqttQualityOfServiceLevel.AtLeastOnce)
            .WithWillRetain(true)
            .WithWillDelayInterval(20);                               // 5.x: 参数为 uint,单位秒
        // 可选认证:提供用户名时才配置凭据。
        if (username != null)
        {
            builder.WithCredentials(username, password);
        }
        // 可选 TLS。
        if (useTls)
        {
            builder.WithTlsOptions(o => o.UseTls());
        }
        // 定型连接选项。
        _options = builder.Build();
        // 挂接底层客户端事件:连接成功、断线、收到消息。
        _client.ConnectedAsync += OnConnectedAsync;
        _client.DisconnectedAsync += OnDisconnectedAsync;
        _client.ApplicationMessageReceivedAsync += OnMessageReceivedAsync;
    }
    #endregion
    #region 公共方法
    // 启动客户端:建立连接(失败自动进入指数退避重连)。
    // 参数 ct:外部取消令牌,与内部 _reconnectCts 关联。
    public async Task StartAsync(CancellationToken ct = default)
    {
        // 重置关停标志并创建重连取消令牌。
        _manualShutdown = false;
        _reconnectCts = CancellationTokenSource.CreateLinkedTokenSource(ct);
        // 进入带退避的连接流程。
        await ConnectWithRetryAsync(_reconnectCts.Token);
    }
    // 发布消息:在线直接发送;断线或发送失败时入业务重试队列,重连后自动补发。
    // 参数 message:待发布的应用消息。
    public Task PublishAsync(MqttApplicationMessage message) => PublishWithRetryAsync(message);
    // 优雅关停:发布离线状态(Retain)后断开,并阻止自动重连。
    public async Task GracefulShutdownAsync()
    {
        // 置关停标志、取消重连、停掉心跳定时器,避免后续自动恢复。
        _manualShutdown = true;
        _reconnectCts?.Cancel();
        _appHeartbeat?.Dispose();
        _appHeartbeat = null;
        // 仍在线时发布 Retain 的离线状态,再主动断开。
        if (_client.IsConnected)
        {
            try
            {
                await _client.PublishAsync(new MqttApplicationMessageBuilder()
                    .WithTopic(_statusTopic)
                    .WithPayload("{\"status\":\"offline\",\"reason\":\"graceful\"}")
                    .WithQualityOfServiceLevel(MqttQualityOfServiceLevel.AtLeastOnce)
                    .WithRetainFlag(true)
                    .Build());
                await Task.Delay(200);
            }
            catch (Exception ex) { _logger.LogWarning(ex, "Graceful offline publish failed"); }
            await _client.DisconnectAsync();
        }
    }
    // 异步释放资源:先优雅关停,再释放底层客户端与重连锁。
    public async ValueTask DisposeAsync()
    {
        await GracefulShutdownAsync();
        _client.Dispose();
        _connectLock.Dispose();
        _reconnectCts?.Dispose();
    }
    #endregion
    #region 连接/重连
    // ===== 5.x 必须自实现:指数退避重连 =====
    // 反复尝试连接直到成功或被取消;每次尝试前先退避等待,避免热循环。
    // 参数 ct:取消令牌,取消时退出循环。
    private async Task ConnectWithRetryAsync(CancellationToken ct)
    {
        // 初始退避 1 秒,封顶 60 秒。
        var delay = TimeSpan.FromSeconds(1);
        var maxDelay = TimeSpan.FromSeconds(60);
        // 循环:未取消且未连接时持续尝试。
        while (!ct.IsCancellationRequested && !_client.IsConnected)
        {
            // 每次尝试前先退避等待:避免热循环,也为断线重连提供稳定的退避窗口。
            try { await Task.Delay(delay, ct); } catch (OperationCanceledException) { return; }
            try
            {
                // 拿重连锁,串行化并发重连。
                await _connectLock.WaitAsync(ct);
                try
                {
                    // 已连接(可能被并发流程抢先)则直接返回。
                    if (_client.IsConnected) return;
                    // 发起连接。
                    await _client.ConnectAsync(_options, ct);
                }
                finally { _connectLock.Release(); }
                // 连接成功,返回。
                return;
            }
            catch (OperationCanceledException) { return; }
            catch (Exception ex)
            {
                // 连接失败:记录日志并指数放大下次退避。
                _logger.LogWarning(ex, "Connect failed, retry in {Delay}s", delay.TotalSeconds);
                delay = TimeSpan.FromSeconds(Math.Min(delay.TotalSeconds * 2, maxDelay.TotalSeconds));
            }
        }
    }
    // 连接成功回调:自报在线、恢复订阅、启动心跳、冲刷重试队列。
    // 参数 e:连接结果事件参数(含 ServerKeepAlive)。
    private async Task OnConnectedAsync(MqttClientConnectedEventArgs e)
    {
        try
        {
            // 5.x: ServerKeepAlive 从 ConnectResult 获取。
            _logger.LogInformation("Connected: {Id}, ServerKeepAlive={KA}",
                _clientId, e.ConnectResult?.ServerKeepAlive.ToString() ?? "default");
            // 支柱③:自报 online(Retain)。
            await PublishStatusSafeAsync("online", "connected");
            // 5.x 自实现:重连后必须重新订阅。
            await RestoreSubscriptionsAsync();
            // 支柱④:启动应用层心跳。
            StartAppHeartbeat();
            // 后台冲刷重试队列(fire-and-forget)。
            _ = Task.Run(FlushRetryQueueAsync);
        }
        catch (Exception ex)
        {
            // 隔离事件处理器内的异常,避免冒泡到 MQTTnet 事件链造成意外断线判定。
            _logger.LogError(ex, "OnConnectedAsync failed");
        }
    }
    // 断线回调:由曾经在线触发的断线才启动重连,避免初始连接失败被重复触发。
    // 参数 e:断线事件参数(含 ClientWasConnected、断开原因)。
    private Task OnDisconnectedAsync(MqttClientDisconnectedEventArgs e)
    {
        // 记录断开原因,并停掉心跳定时器。
        _logger.LogWarning("Disconnected: {Reason}", e.Reason);
        _appHeartbeat?.Dispose();
        _appHeartbeat = null;
        // 仅当之前确实在线且未手动关停时,才后台触发重连。
        if (!_manualShutdown && e.ClientWasConnected)
        {
            _ = Task.Run(async () =>
            {
                try { await ConnectWithRetryAsync(_reconnectCts!.Token); }
                catch (OperationCanceledException) { }
            });
        }
        return Task.CompletedTask;
    }
    // 恢复订阅:重连后必须重新订阅心跳 pong 主题与命令主题。
    private async Task RestoreSubscriptionsAsync()
    {
        await _client.SubscribeAsync(new MqttClientSubscribeOptionsBuilder()
            .WithTopicFilter($"svc/heartbeat/pong/{_clientId}", MqttQualityOfServiceLevel.AtMostOnce)
            .WithTopicFilter($"svc/device/{_clientId}/command/#", MqttQualityOfServiceLevel.AtLeastOnce)
            .Build());
    }
    #endregion
    #region 发送与重试队列
    // 发布 Retain 状态消息(online/offline),走统一的重试入口。
    // 参数 status:状态值(online/offline)。
    // 参数 reason:状态原因(connected/graceful/unexpected_disconnect 等)。
    private async Task PublishStatusSafeAsync(string status, string reason)
    {
        await PublishWithRetryAsync(new MqttApplicationMessageBuilder()
            .WithTopic(_statusTopic)
            .WithPayload($"{{\"status\":\"{status}\",\"reason\":\"{reason}\",\"ts\":{DateTimeOffset.UtcNow.ToUnixTimeSeconds()}}}")
            .WithQualityOfServiceLevel(MqttQualityOfServiceLevel.AtLeastOnce)
            .WithRetainFlag(true)
            .Build());
    }
    // ===== 5.x: PublishAsync 返回 MqttClientPublishResult,用 IsSuccess 判断 =====
    // 发送消息:在线直接发;未连接、IsSuccess=false 或抛异常时入重试队列。
    // 参数 message:待发布的应用消息。
    private async Task PublishWithRetryAsync(MqttApplicationMessage message)
    {
        try
        {
            // 未连接:直接入队,等待重连后补发。
            if (!_client.IsConnected) { _retryQueue.Enqueue(message); return; }
            // 在线:发送并用 IsSuccess 判定成败(覆盖 Success 和 NoMatchingSubscribers)。
            var result = await _client.PublishAsync(message);
            if (result.IsSuccess) return;
            // 发送未成功:记录并入队重试。
            _logger.LogError("Publish failed: {ReasonCode} {ReasonString}",
                result.ReasonCode, result.ReasonString);
            _retryQueue.Enqueue(message);
        }
        catch (Exception ex)
        {
            // 抛异常:记录并入队重试。
            _logger.LogError(ex, "Publish threw, queued");
            _retryQueue.Enqueue(message);
        }
    }
    // 冲刷重试队列:在线时按 FIFO 依次补发;失败/异常时重新入队并停止,避免丢消息与热循环。
    private async Task FlushRetryQueueAsync()
    {
        // 在线且有积压时逐个出队补发。
        while (_client.IsConnected && _retryQueue.TryDequeue(out var message))
        {
            try
            {
                var result = await _client.PublishAsync(message);
                if (result.IsSuccess) continue;
                // 发送未成功:重新入队并停止本次冲刷,避免丢消息。
                _logger.LogWarning("Retry publish not success: {ReasonCode}", result.ReasonCode);
                _retryQueue.Enqueue(message);
                return;
            }
            catch (Exception ex)
            {
                // 抛异常:重新入队并停止,既不丢消息,也避免热循环。
                _logger.LogWarning(ex, "Retry publish threw, re-queued");
                _retryQueue.Enqueue(message);
                return;
            }
        }
    }
    #endregion
    #region 应用层心跳
    // 启动应用层心跳定时器:按配置间隔周期触发 DoAppHeartbeatAsync。
    private void StartAppHeartbeat()
    {
        // 先停掉旧定时器,避免重复实例。
        _appHeartbeat?.Dispose();
        _appHeartbeat = new Timer(async _ => await DoAppHeartbeatAsync(),
            null, TimeSpan.FromSeconds(_heartbeatIntervalSec), TimeSpan.FromSeconds(_heartbeatIntervalSec));
    }
    // 执行单次应用层心跳:发 ping 等 pong,超时判定心跳失败并强制断线以触发重连。
    private async Task DoAppHeartbeatAsync()
    {
        // 已关停 / 未连接时直接返回(Timer 回调可能晚于 Dispose 触发)。
        if (_manualShutdown) return;
        if (!_client.IsConnected) return;
        // 防重入:上一次 tick 尚未完成(如 pong 等待中)则跳过本次,保护 _pendingPong 单槽。
        if (Interlocked.Exchange(ref _heartbeatRunning, 1) != 0) return;
        try
        {
            // 创建待 pong 的任务源,供收到 pong 时置成功。
            var tcs = new TaskCompletionSource<bool>(TaskCreationOptions.RunContinuationsAsynchronously);
            _pendingPong = tcs;
            try
            {
                // 发送应用层 ping(QoS 0,不重试)。
                await _client.PublishAsync(new MqttApplicationMessageBuilder()
                    .WithTopic($"svc/heartbeat/ping/{_clientId}")
                    .WithPayload(DateTimeOffset.UtcNow.ToUnixTimeMilliseconds().ToString())
                    .WithQualityOfServiceLevel(MqttQualityOfServiceLevel.AtMostOnce)
                    .Build());
                // 在 pong 超时内未等到 pong 则判定心跳失败。
                if (await Task.WhenAny(tcs.Task, Task.Delay(TimeSpan.FromSeconds(_pongTimeoutSec))) != tcs.Task)
                {
                    // 心跳超时:强制断开,让重连流程接管(除非已手动关停)。
                    _logger.LogError("APP-LAYER HEARTBEAT TIMEOUT, force disconnect");
                    if (!_manualShutdown)
                        await _client.DisconnectAsync();
                }
            }
            finally { _pendingPong = null; }
        }
        catch (ObjectDisposedException)
        {
            // 客户端已释放:静默退出,避免 async void 异常击穿进程。
        }
        catch (Exception ex)
        {
            _logger.LogError(ex, "Heartbeat error");
        }
        finally { Interlocked.Exchange(ref _heartbeatRunning, 0); }
    }
    #endregion
    #region 消息接收
    // 收到 broker 消息的回调:区分心跳 pong 与业务消息。
    // 参数 e:消息接收事件参数(含 ApplicationMessage)。
    private Task OnMessageReceivedAsync(MqttApplicationMessageReceivedEventArgs e)
    {
        var msg = e.ApplicationMessage;
        // 心跳 pong:仅用于内部确认,不对外转发。
        if (msg.Topic == $"svc/heartbeat/pong/{_clientId}")
        {
            _pendingPong?.TrySetResult(true);
            return Task.CompletedTask;
        }
        // 业务消息(命令等)转发给订阅方;禁止在回调中阻塞。
        return ApplicationMessageReceived?.Invoke(msg) ?? Task.CompletedTask;
    }
    #endregion
    #region 测试缝(internal,仅用于单元/集成测试)
    // 当前是否处于已连接状态(测试用)。
    internal bool IsConnected => _client.IsConnected;
    // 当前业务重试队列长度(测试用)。
    internal int RetryQueueCount => _retryQueue.Count;
    #endregion
}
这个封装与 MQTTnet 5.x 的对应关系:
-
MqttClientFactory 替代 MqttFactory;
-
IMqttClient 替代 IManagedMqttClient,重连由 ConnectWithRetryAsync 自行实现,不再有托管退避;
-
PublishAsync 返回 MqttClientPublishResult,用 IsSuccess 判断成功,失败入 _retryQueue;5.x 没有 EnqueueAsync,发送队列由业务侧自建;
-
没有 ApplicationMessageNotConsumedAsync,发送队列水位由业务侧自行监控;
-
遗嘱配置的 WithWillTopic / WithWillQoS / WithWillRetain / WithWillDelayInterval 在 5.x 中仍然通过 MqttClientOptionsBuilder 提供,写法不变。
09、假在线排查实战------怎么验证
9.1 症状清单
-
□ 设备显示"在线"但超过 5 分钟无数据上报
-
□ 下发指令到"在线"设备,超时无响应
-
□ 设备实际已断电,但系统 10 分钟后才显示离线
-
□ 服务重启后大量"刚刚掉线"告警(Retain 快照被误当事件)
9.2 排查步骤
当设备出现假在线时,问题可能出在网络层、协议层、会话配置或应用逻辑中的任何一环。下面这套排查流程按从 Broker 到网络、从配置到行为的顺序递进,每一步都能独立给出"是/否"结论,避免你在多个可能性之间反复横跳:
csharp
bash
# 1. 确认 Broker 侧连接状态
emqx ctl clients show <client_id>        # 关注 connected_at, keepalive
# 2. 查看遗嘱消息是否配置
emqx ctl clients show <client_id> | grep -i will
# 3. 查断开原因
#    idle = 心跳超时(正常触发遗嘱)
#    takenover = ClientId 抢占(也会触发遗嘱,需业务侧区分)
emqx ctl trace client "<client_id>" trace.log
# 4. 抓包看心跳间隔
tcpdump -i any -nn 'host <device_ip> and port 1883' -w heartbeat.pcap
# Wireshark: mqtt.msgtype == 12 (PINGREQ) / 13 (PINGRESP)
四步的判定逻辑:
-
第 1 步回答"Broker 还认不认这个连接"------如果 connected_at 是几小时前的,而设备声称在线,说明 KeepAlive 没生效或 NAT 已掐断链路但 Broker 还没超时。
-
第 2 步回答"遗嘱有没有配"------大量假在线事故的根因就是这里,一行 grep 就能确认。
-
第 3 步回答"上次断开是怎么发生的"------idle 说明心跳确实超时了(链路问题),takenover 说明有别的客户端抢了同一个 ClientId(业务逻辑问题),两者处置方式完全不同。
-
第 4 步回答"心跳包到底有没有在飞"------如果抓不到 PINGREQ,说明设备端压根没在发心跳,问题在客户端实现而不是网络。
9.3 快速验证:模拟异常断连
所有配置改完之后,最怕的就是"看起来都对,真断了没反应"。这个验证方法的核心思路是绕过一切优雅退出路径,直接制造一次最粗暴的死亡------kill -9 不发送 DISCONNECT 报文,Broker 不会收到任何告别,这和真实场景中的断电、崩溃、拔网线行为一致,是检验 LWT 是否真正生效的终极手段:
csharp
# 在设备上直接 kill -9 进程(不发 DISCONNECT)
# 观察:
# 1. Broker 多久后标记离线?(应约等于 1.5 × KeepAlive)
# 2. 遗嘱消息是否发布?
# 3. 订阅者是否收到遗嘱?
# 4. 收到遗嘱的时间 vs 设备 kill 的时间差 = 实际假在线窗口
验证通过的标准:
-
第 1 项的时间严格等于 1.5 × KeepAlive,误差不超过 1~2 秒。如果远大于这个值,说明 Broker 侧 idle_timeout 被单独调大过,需要检查 Broker 配置。
-
第 2、3 项必须同时成立------遗嘱消息在 Broker 端生成不等于订阅者一定能收到,如果订阅者没收到,检查遗嘱 Topic 的 ACL 权限和订阅者的 QoS 等级。
-
第 4 项是你这套方案的实际 SLA 指标------它直接告诉业务方"设备死了之后,平台最多多久能感知到",拿这个数据去对离线发现 SLA 的承诺。
进阶玩法: 如果你有多台设备,可以写个脚本循环 kill -9 + 重启,持续跑 24 小时,验证在频繁异常重启场景下遗嘱消息是否会出现乱序、丢失或 Retain 状态被错误覆盖的情况------这比单次手动验证更能暴露边界问题。
9.4 假在线排查清单(按顺序确认)
-
□ Broker 侧该 clientId 的最后活跃时间与"在线"状态是否矛盾?
-
□ Broker 的 KeepAlive 超时判定是否生效(不是被设为 0,也不是被中间件吞掉)?
-
□ 抓包看该连接是否有 PINGREQ/PINGRESP 成对出现,还是只有单向数据?
-
□ TCP 层是否有 ZeroWindow 或长时间无 ACK?
-
□ 遗嘱的 QoS 和 Retain 是否符合下游预期?
-
□ 如果遗嘱是 Retain 的,下游是否把历史快照误当成了刚刚离线?
-
□ 应用层心跳的序号是否在推进?MQTTnet 5.x 中 DisconnectedAsync 可能不触发而 IsConnected 仍为 true,应用层心跳是否独立运行?
-
□ 如果是 takenover 断开,业务侧是否做了 ClientId 抢占与真实掉线的区分?
10、踩坑实录------五个真实"在线状态"事故
五起真实事故,对应四层兜底支柱 ------ 多数事故不是「没做」,而是「做了一半」:KeepAlive 太长、LWT 没 Retain、状态靠轮询。
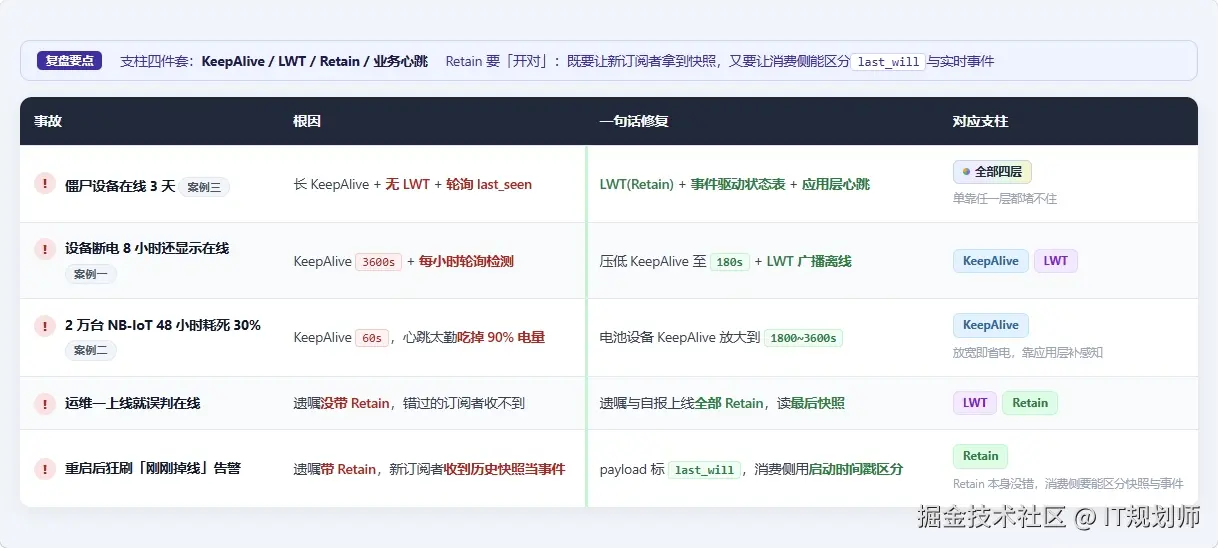
其他高频坑:
-
测试时优雅 Disconnect,遗嘱不出来,误以为遗嘱失效: 测试遗嘱必须拔电源、断网卡、杀进程,模拟异常死亡。
-
多个设备共用同一个 ClientId,新连接踢掉旧连接,旧连接触发遗嘱,误报大量离线告警: ClientId 全局唯一;平台收到遗嘱时增加校验逻辑,区分真实掉电还是被抢占。
-
MQTT 3.1.1 使用 WithWillDelayInterval,该属性被静默忽略: WillDelay 仅 MQTT 5 支持,降级到 3.1.1 时遗嘱立即下发。
-
遗嘱 Payload 写入 CONNECT 时间戳,误当做真实掉线时间: 消费端收到遗嘱报文那一刻记录离线时间。
-
MQTTnet 5.x 中 Keep-Alive PING 超时被静默吞掉,DisconnectedAsync 不触发: 不能把 DisconnectedAsync 当作唯一断连信号,应用层心跳必须独立运行。
11、生产参数速查表
前面十部分把原理、机制、代码、排查都讲完了,但到了真正上线配置的那一刻,你大概率不会回去翻正文------你需要的是一张能直接照着填的表。下面这 8 个参数覆盖了从协议层到业务层的完整配置面,每个值都经过生产环境验证,照着配不会出大错;如果你有特殊 SLA 要求,按"说明"列里的约束公式反推即可,不要凭直觉拍一个数:
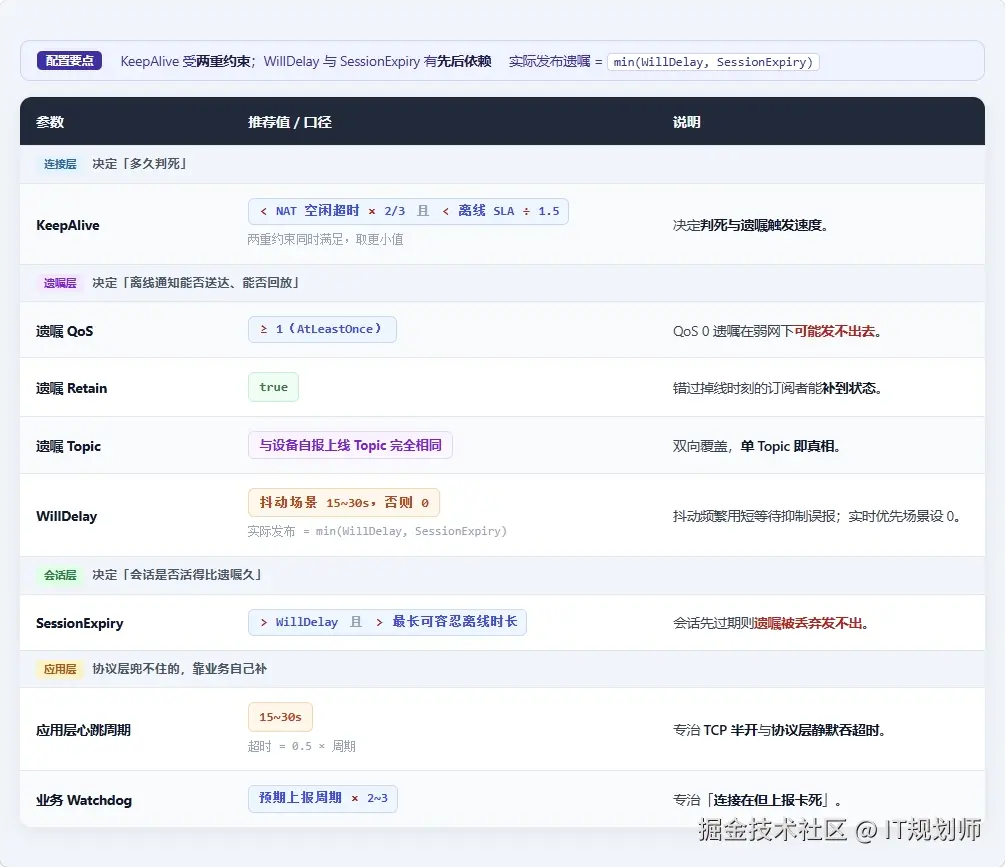
两个容易踩的联动陷阱:
-
WillDelay 和 SessionExpiry 必须配套------如果 SessionExpiry ≤ WillDelay,会话在遗嘱发布前就过期了,Broker 直接丢弃遗嘱,你配了等于没配。表里写的 > 是硬约束,不是建议。
-
KeepAlive 有两个上界,取更紧的那个------NAT 超时是物理上界(超了链路被掐),离线 SLA 是业务上界(超了用户投诉)。哪个更紧就按哪个算,不要只看其中一个。
12、上线前 12 项自检清单
前面十一部分的原理、代码、参数都配好了,但生产事故往往不是因为"不懂",而是因为"漏了一步"。这份清单按** CONNECT → 遗嘱配置 → 上线/下线行为 → KeepAlive → 延迟与缓冲 → 状态表设计 → 应用层兜底** 的顺序排列,每一条都是真实事故里反复出现过的遗漏点。上线前逐条打勾,12 项全过再发版------任何一项留空,都意味着你给自己埋了一颗定时炸弹:
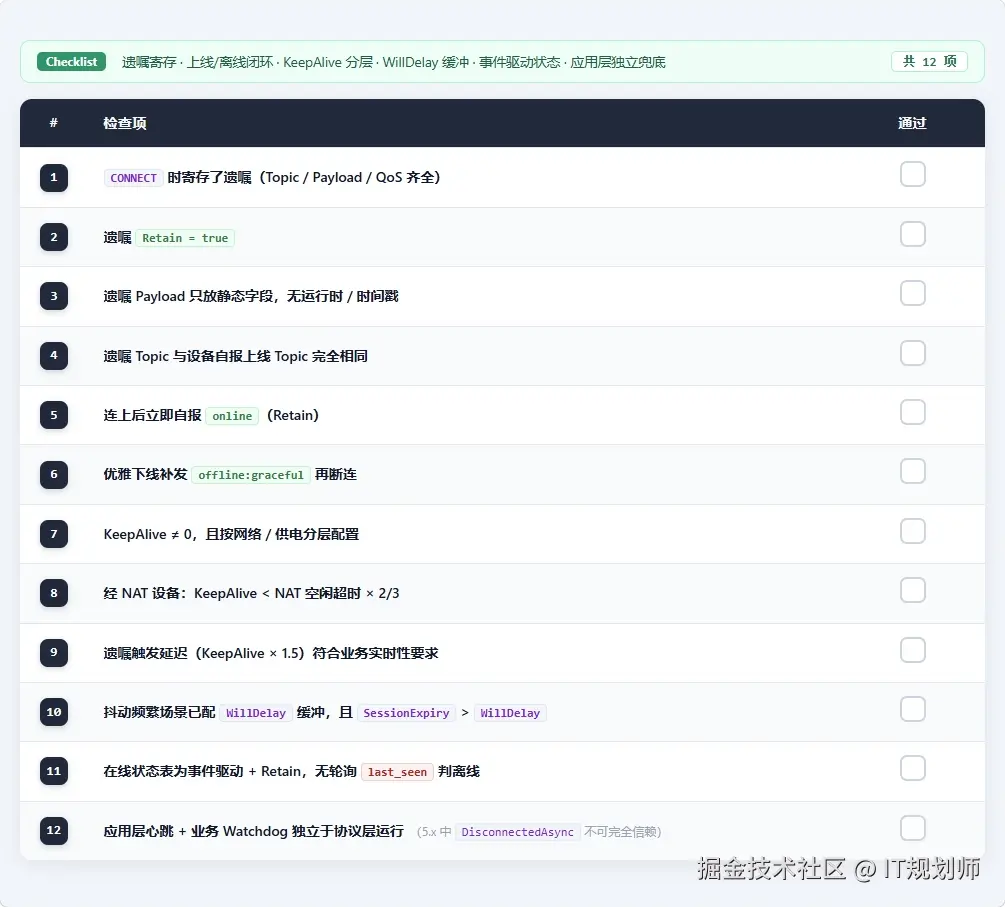
最容易漏的两项: 第 3 条(Payload 塞了时间戳或动态字段,导致遗嘱每次内容不同,Retain 覆盖逻辑失效)和第 12 条(以为 DisconnectedAsync 能兜底一切,结果 MQTTnet 5.x 在某些异常断连路径下根本不会触发它)。上线前请额外留意这两处。
13、总结
KeepAlive 决定你多快判死,LWT 决定掉线能不能被广播,Retain 决定错过的人能不能补上,应用层心跳决定假死和假活能不能被戳穿。 四层合起来,"在线状态"才从一句口号变成可信事实。
"假在线"之所以难缠,是因为它不是一个"连接断了"的问题,而是一个**"没有人负责宣布死亡"**的问题。TCP 层没有能力宣布,业务层没有机制宣布,最后设备就在系统的认知里一直"活着"。
参数没有标准答案,但有一条判断标准永远成立:你的 KeepAlive 对应的离线发现时间,必须小于"指令发过去石沉大海"能被业务容忍的时间。 记住遗嘱的本质------它只报意外死亡、且快不过 KeepAlive × 1.5,把这条边界刻进设计里,你的设备才真正告别"假在线"。
在 MQTTnet 5.x 下,还有一条额外的纪律:托管层退场之后,可靠性兜底的责任回到了业务代码里。DisconnectedAsync 可能静默不触发,IsConnected 可能撒谎,发送队列和重连全部自管------应用层心跳不是锦上添花,而是 5.x 架构下的必需组件。
14、最后
我整理了一份《MQTT遗嘱配置模板》,包含:
-
遗嘱五要素配置模板(Topic 命名、Payload 结构、QoS、Retain、WillDelay 取值口径)
-
KeepAlive 分层取值表与三条铁律(判死时间、NAT 对齐、离线 SLA 反推)
-
双向 Retain 对称设计(上线自报 online + 遗嘱 offline,在线状态表骨架)
-
MQTTnet 5.x 配置代码与迁移要点(ManagedClient 已移除,重连/重订阅自实现)
-
10 个高频坑清单 + 12 项上线前自检清单 + 假在线排查步骤
私信「MQTT遗嘱配置模板」领取。
做物联网 MQTT 的朋友可以一起交流。后面我会在这个号持续更新这个系列,也会穿插一些软考架构师备考、技术管理转型、嵌入式学习的记录。