读者对象:了解大模型的调用和工具执行、ReAct等知识,但想近一步学习了解多智能体等更复杂实现机制的技术人员。
备注说明 : 所分析的是Codex CLI 命令行执行方式下智能体代码的执行机制,Codex App应用的代码是没有开源的,但底层执行逻辑是一致的。代码位置 :github.com/openai/code... · Rust 工作区 codex-rs · commit 8c07694(2026-10-18 克隆) Codex 代码中智能体执行机制同时提供了两个版本,通过如下的参数进行控制,后续称为 V1、V2。 通过研究同一场景的实现机制的对比和版本的演进,能对自己的产品研发具有借鉴意义。
| 枚举 | 取值 | 含义 |
|---|---|---|
| MultiAgentVersion | V1 / V2 / Disabled | 两个进程内实现(V1 第一代 / V2 增强版)或整个关闭 |
针对Codex中多智能体的使用/触发,可以看我写的前一篇文章 : 《从使用者角度看看Codex如何使用多智能体》
1. 基线:普通 ReAct 是怎么执行的
1.1 它要解决什么问题
给模型一个需要多步才能完成的任务------例如"把配置文件里的超时改成 30 秒"------模型不可能一步到位:它要先想清楚改哪个文件、再真的去改、看到结果后确认改成功了,才能回复用户。
ReAct 就是把这类过程标准化成一个闭环:想一步、做一步、看一步结果,再想下一步,直到模型认为可以给出最终答案。它是今天绝大多数智能体(Codex 也在其列)的底座。不理解这个闭环,就看不懂 V1/V2 到底"多"出了什么。
1.2 机制:一个闭环,四个动作
- 模型读上下文。 上下文是一个消息列表(messages),里面放着任务描述,以及此前每一轮的执行结果。
- 模型做一次推理。 输出两种可能之一:一个结构化的工具调用请求 (用哪个工具、参数是什么),或者一条最终答案。
- 运行时(Runtime)执行工具。 若是工具调用,由外层运行时真正执行(读写文件、执行命令、查询数据),把返回结果作为一条新消息追加进上下文。
- 回到第 1 步。 模型基于更新后的上下文继续推理;若第 2 步输出的是最终答案,循环结束。
由此得到三个关键性质:
- 单线程:动作顺序执行,不存在并行的执行体;
- 单上下文:全程共享同一份记忆,无隔离、无分叉;
- 同步内联:工具结果直接回填同一上下文,调用方原地等待。
另有一个工程细节不容忽略:循环必须设最大步数保护。否则模型可能反复调用同一个工具,永远停不下来。
1.3 代码样例
下面是一份最小实现(教学示意,省略了错误处理与重试;call_model 为伪函数,真实项目里它是一次大模型 API 调用,返回结构化结果):
python
from typing import Any

# ---------- 工具层:由外层运行时真正执行 ----------
def edit_file(path: str, old: str, new: str) -> str:
    """把文件中一处 old 替换为 new。"""
    return f"已替换 1 处:{path}"

TOOLS = {"edit_file": edit_file}

# ---------- ReAct 主循环 ----------
def react_loop(task: str, max_steps: int = 10) -> str:
    # 上下文:一个消息列表,所有回合共享同一份
    messages: list[dict[str, Any]] = [{"role": "user", "content": task}]

    for _ in range(max_steps):
        # 模型只负责"决定":读上下文,输出思考 + 工具调用请求或最终答案
        reply = call_model(messages, tools=TOOLS)

        if reply.tool_calls:
            # 把"思考 + 工具调用请求"写进上下文
            messages.append(reply.to_message())
            for call in reply.tool_calls:
                # 真正执行工具的是运行时,不是模型
                result = TOOLS[call.name](**call.args)
                # 观察结果作为新消息追加,驱动下一轮推理
                messages.append({
                    "role": "tool",
                    "tool_call_id": call.id,
                    "content": result,
                })
            continue  # 回到循环顶部

        # 没有工具调用:模型给出最终答案,循环结束
        return reply.content

    return "已达到最大步数,任务未完成"
请注意其中两行的分工:call_model 只产出"用哪个工具、参数是什么"的请求;TOOLScall.name 才真正执行工具。模型负责决定,运行时负责执行------这条分界线在 V1/V2 里依然成立,只是组织的形态变了。
1.4 一张图看懂普通的ReAct机制
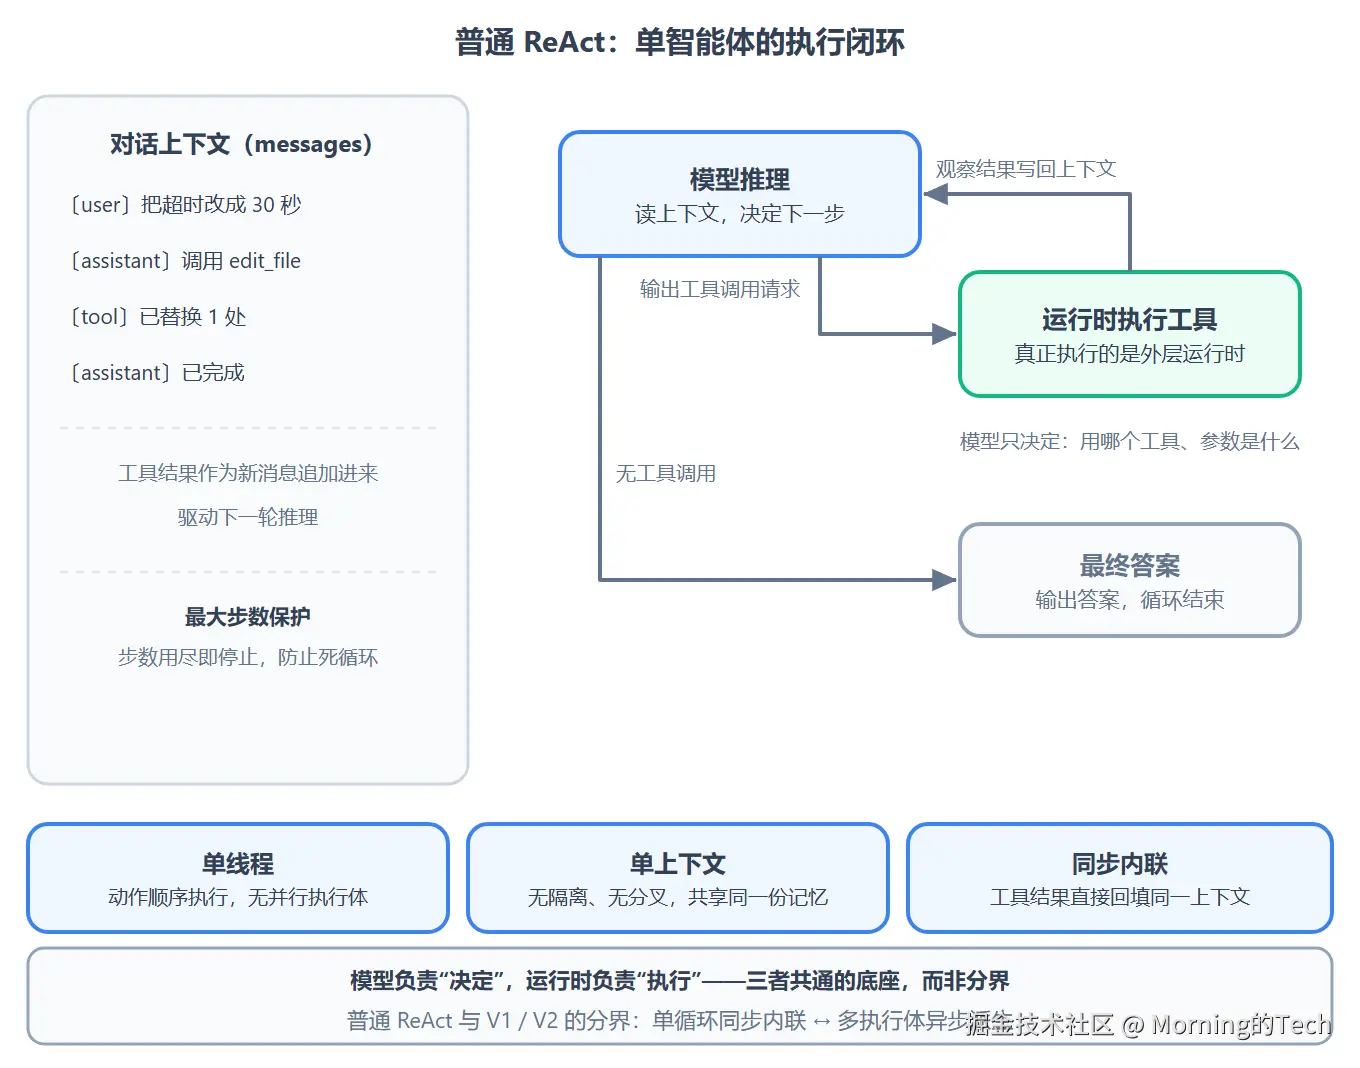
普通 ReAct 的执行闭环:模型读上下文后二选一------输出工具调用请求(由运行时执行,观察结果写回上下文,进入下一轮),或直接给出最终答案(循环结束)。左侧是随回合增长的消息列表,底部是单线程、单上下文、同步内联三个关键性质。
1.5 再进一步:普通 subagent 长什么样
许多框架在 ReAct 之上加了"子智能体":父在某一轮决定"这块活交给一个专职的子去干",于是同步调用一个子------父原地等待,子自己跑完一整个 ReAct 循环,把最终答案作为这次调用的返回值交还父;父把答案内联回填进自己的上下文,继续下一轮。子用完即弃:没有名字、没有历史、不留记录。
python
# 普通 subagent:同步内联,跑完即弃
def run_subagent(task: str) -> str:
    sub_messages = [{"role": "user", "content": task}]  # 子只拿到任务描述
    return react_loop_with(sub_messages)                # 子自己跑完整个循环

# 父智能体中:调用即阻塞,拿到最终答案才继续
answer = run_subagent("把 config.py 的超时改成 30 秒")
messages.append({"role": "tool", "content": answer})   # 结果内联回填父上下文
请记住这个"同步内联"的形态。Codex V1 的 spawn_agent 看起来在做同样的事,底层却是另一套路------下一章开始对比。
2. 三种执行模式对比
2.1 三者定位
- 普通 ReAct:一个智能体、一条循环、单线程单上下文,全程同步。
- Codex V1:父派生独立线程的子智能体,父子各自跑循环,子完成后异步通知父。
- Codex V2:核心与 V1 相同,额外支持子智能体的驻留、换出与重载,并挂了一个树级共享信箱。
V1 与 V2 的主要差异在驻留层、完成信号和通信设施,不在进程边界。
2.2 共同底座
三者的内核都是 ReAct:都是"模型决定下一步、运行时执行、结果喂回模型"这个循环;真正的执行者都是外层运行时,模型只输出结构化的工具调用请求。区别只在于这个循环有几个、怎么组织。
2.3 对比总览
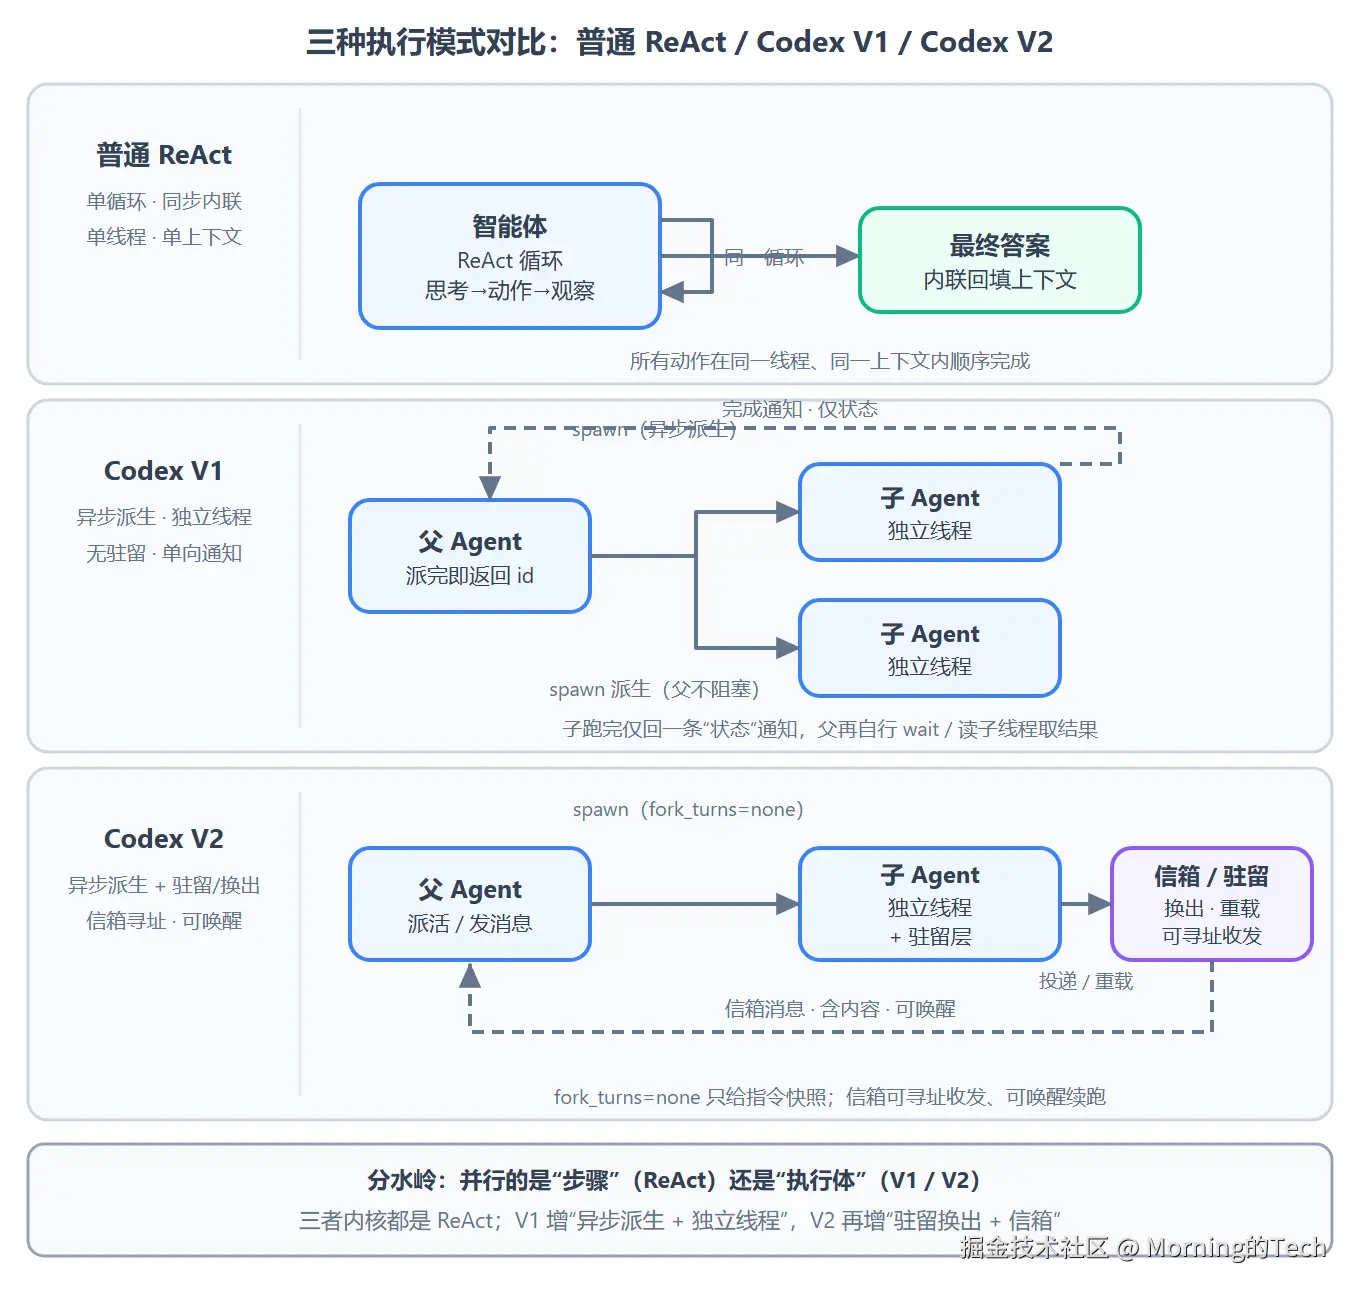 三种执行模式对比。该图表达普通 ReAct 的"单循环、同步内联",V1 的"异步派生 + 独立线程 + 单向状态通知",V2 的"异步派生 + 驻留换出 + 信箱寻址"三者在执行结构上的差异。
为便于窄屏阅读,拆成两段:表 A 看 V1 相对普通 ReAct 改了什么,表 B 看 V2 相对 V1 又补了什么。
表 A:普通 ReAct ↔ Codex V1(跨越点:并行 + 异步)
| 维度 | 普通 ReAct | Codex V1 |
|---|---|---|
| 循环 | 单条 | 父子各一条独立 |
| 执行单元 | 单体、单上下文 | 父子各自线程 + 上下文 |
| 并发 | 仅同回合多工具 | 真并发、父不阻塞 |
| 控制流 | 同步内联 | 异步派生、只返回 id |
| 上下文 | 单一共享 | 父子隔离、可 fork 父全量历史 |
| 结果回流 | 工具值直接回填 | 异步通知(仅状态、无内容) |
| 完成后 | 出答案即结束 | 通知父;子仍在册、可再派活 |
| 通信 | 无 | 无信箱 |
表 B:Codex V1 ↔ Codex V2(跨越点:驻留 + 信箱)
| 维度 | Codex V1 | Codex V2 |
|---|---|---|
| 生命周期 | 常驻、无换出 | 可换出 / 重载(LRU) |
| 资源 | 静态占用、有上限限制 | 空闲换出内存腾空槽位 |
| 上下文继承 | fork 全量 / 不给 | fork_turns 精细(默认只给快照) |
| 完成消息 | 仅引用 + 状态 | 带实际内容 |
| 通信 | 仅父子完成通知 | 树级信箱、可寻址收发 |
| 唤醒 | 无信箱,靠父主动派活 | 发信即唤醒续跑 |
一个最易混淆的点 :普通 ReAct 也常支持"一个回合里并行调多个工具",就是一次大模型调用可以返回多个要执行的工具信息,应用程序运行时可以并行执行这些工具,但这和 Codex 的并行不是一回事------前者是同一条循环、同一个上下文里的并行步骤 ,结果仍全部回填同一处;后者是多个独立执行体、多个独立上下文的并行 ,各自有各自的循环和记忆,靠异步消息或通知汇合。区分点就一句:并行的是"步骤"还是"执行体"。
2.4 两次跃迁的直白解释
把三种模式排成一条线,从普通 ReAct 到 V2 是两次递进。
第一次跃迁(普通 ReAct → V1):从"一个循环"到"多个并行循环",从"同步"到"异步"。 普通 ReAct 是"一个人从头干到尾",所有事在一条上下文、一条线程里顺序完成。V1 允许父在干活的同时派出好几个子Agent并行干别的,父子各有各的上下文和线程。代价是控制流变了:父派完不傻等,而是先返回一个 id 继续干自己的活,子Agent干完了再回头异步通知父。V1 换来并行能力,付出的代价是结果不再内联回填、要异步收。
第二次跃迁(V1 → V2):从"静态常驻、单向协作"到"可换出重载、可寻址、可唤醒"。 V1 的子Agent跑完后线程并不销毁,但也没有"请出内存"一说------不显式关闭就一直占着线程,并发一多容易达到系统的线程控制上限。父若想再让它干活,得自己主动调 send_input 给它开一个新回合(被关闭过的先 resume_agent 拉起来);拿结果则靠 wait 或读子线程。总之协作全靠父单向发起:完成通知只带"状态"不带内容,兄弟之间无法直接说话。V2 补了三块:换出与重载 (空闲的子Agent释放,需要时唤醒续跑,资源不再静态占用)、信箱 (任意智能体可按标识互相发消息,支持"先排队、对方上线再投递"和"发信即唤醒对方开工"两种模式)、更干净的上下文继承(默认子只拿指令快照,不再把父整段历史复制过去)。
3. V1 相对"普通 subagent"的差异
第 1.5 节的同步 subagent 是最容易和 V1 混淆的对象。相同点是:都由父模型在一次决策里触发、子都跑自己的推理循环、都能再往下派生子。但底层是两回事。
| 维度 | 普通 subagent | Codex V1 |
|---|---|---|
| 执行方式 | 同步内联:父阻塞等子返回 | 异步派生:spawn_agent 立即返回 id,父继续 |
| 身份 | 匿名、一次性,跑完即弃 | 有 thread_id、有历史文件、记进 Agent 图谱,可恢复 |
| 结果回流 | 子的最终回答就是工具返回值,直接回填 | 事后异步通知(仅状态),父再自行 wait / 读子线程取产物 |
| 上下文 | 一般只拿到父手写的任务描述 | 可 fork 父的全量历史作为 inherited context |
用代码对照更直观:
ini
# 普通 subagent:父阻塞,结果内联回填
answer = run_subagent(task)        # 等子跑完才继续
messages.append({"role": "tool", "content": answer})

# Codex V1:异步派生,父不阻塞
agent_id = spawn_agent(task)       # 立即返回子的 ID
# 父继续做别的事;子在独立线程里并行跑自己的 ReAct 循环
# 子跑完后,一条"仅状态"的通知被写进父的历史一句话:普通 subagent 是"函数调用",V1 是"派生线程 + 异步消息"。 前者不并行(父在等),后者并行,代价是结果不再内联回填、要异步收。
4. V1 的异步完成通知:结果到底怎么回到父
这是 V1 最容易被误解的一处。父智能体并不是靠一次"同步返回值"拿到子智能体的结果的。 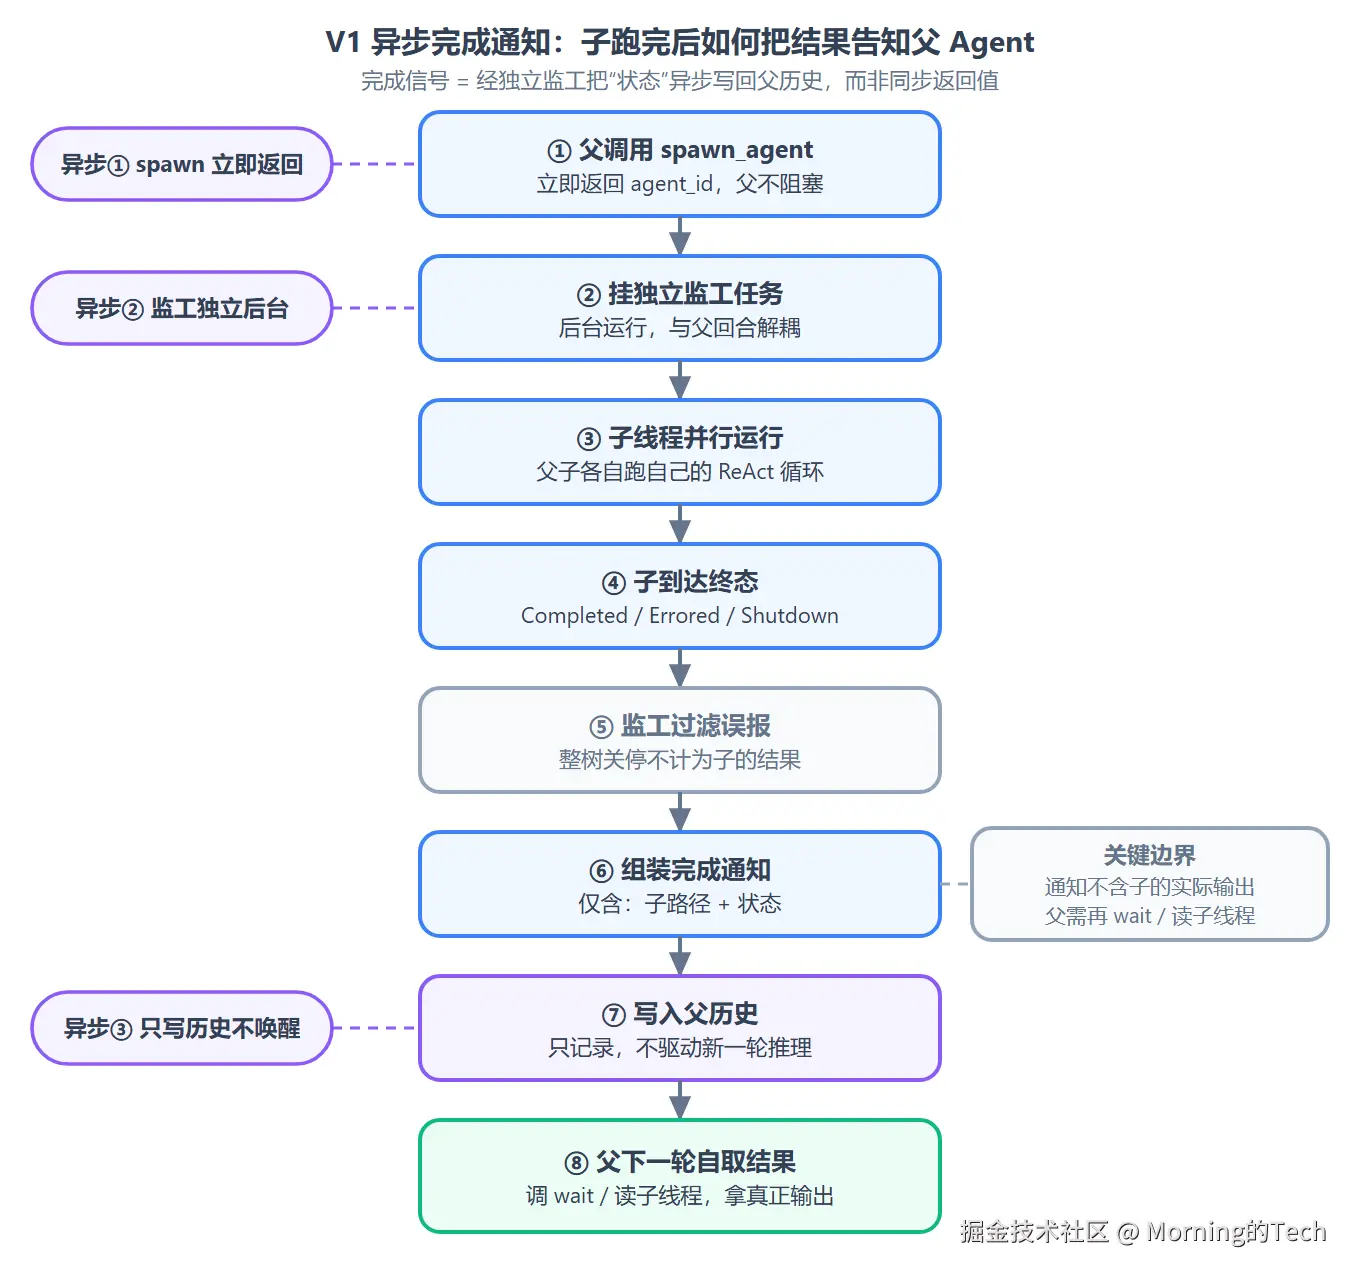
V1 异步完成通知流程。该图表达从父调用 spawn_agent、经独立监工等到子终态、再把"状态"写回父历史、最后由父自行取结果的八步过程;左侧三个标注点出"异步"具体落在哪里,右侧点出"通知不含实际输出"这一关键边界。
完整过程分八步:
- 父调用 spawn_agent。 运行时创建子线程后,spawn_agent 工具立刻返回子的 agent_id,父这一回合的工具调用就此结束,父不阻塞、继续做别的事。
- 运行时挂上监工。 派生时若不走 V2 驻留通道,运行时会起一个独立的监工后台任务,并把父子线程标识、父回合标识、子的引用名交给它。监工和父的回合解耦,只负责盯子的状态。
- 子并行运行。 子智能体在自己的独立线程里跑自己的 ReAct 循环,父子并行推进。
- 子到达终态。 监工持续观察子的状态,直到它进入终态(已完成、出错、关闭等都算;仍在运行或初始化中的不算)。
- 监工过滤误报。 如果终态是关闭、且整棵树正在关停,监工直接返回、不通知------这是"整树生命周期交接",不是子的执行结果,不能误报。
- 组装完成通知。 监工生成一条完成通知,内容只有两项:子的引用名和终态状态。
- 写入父历史。 监工把这条通知追加进父的对话历史------但只记录、不驱动新一轮推理。它渲染成一段带标记的结构化文本,角色相当于 user,让父在之后的某一轮里能读到。
- 父自取结果。 因为通知里没有子的实际输出,父要在后续某一轮读到这条通知后,再由模型决定下一步------通常是调等待工具阻塞等子并取其最终消息,或直接读子的线程历史。
"异步"具体落在三处:① spawn_agent 立即返回、父不阻塞;② 监工是独立后台任务、和父子并行;③ 通知只写进历史、不抢占父当前回合。三处都不占用父的执行流。
一个必须讲准的边界:由于通知是"只写历史、不驱动新回合",它并不会自动把父叫醒去开新一轮大模型调用;父何时处理这条通知,由上层(终端界面、应用服务后端、调用方)按各自策略决定。这正是 V2 要改进的地方------V2 的完成消息带实际内容、可寻址、还能触发新回合(见第 6 章)。
5. V1 的短板与 V2 的改进
把 V1 放到真实的大规模、长期协作场景里,会暴露三个软肋;V2 的增强基本是一一对症。
短板一:子智能体只能常驻,不能换出。 V1 每个子派生后就是一条常驻线程,没有"先请出内存、腾地方"的机制。并发一多容易超过线程配额上限,要么新派生的子被拒,要么内存和线程被占满。V2 引入驻留层 + LRU 换出 :空闲子智能体按策略换出(保留状态,不是杀死),需要时由发信或派活重载唤醒,续上之前的进度。于是一棵很大的智能体树也能在固定槽位里运转。
短板二:上下文继承太粗。 V1 的继承开关配置只有"全给或不给"上下文:选全给就把父的整段历史复制给子------既浪费上下文窗口,也把父的全部中间过程泄露给子。V2 把它做成可调的 fork_turns(不继承 / 全继承 / 继承最近 N 条),默认只给一份指令快照,上下文干净、省窗口空间占用、不泄露上下文;需要时才全继承或继承最近 N 条。
短板三:协作单向,且没有信箱。 V1 的完成通知只带"谁 + 状态",没有内容、不可寻址、父子不可双向通信;父事后想再叫子Agent干活,只能自己主动调 send_input(被关闭过的先 resume_agent),兄弟之间想互通消息则完全没有渠道------总之没有标准信箱。V2 在树级挂了共享信箱:任意智能体可按目标寻址发消息,支持"先排队、对方上线再投递"和"发信即唤醒对方开工"两种模式;完成消息也从"空通知"升级成带实际内容的消息。
6. 两代实现差异总表
| 维度 | V1 | V2(默认) |
|---|---|---|
| 子智能体载体 | 同进程独立线程(独立会话 / 上下文 / 循环) | 同进程独立线程(同上) |
| 工具集 | 派生子 / 发送输入 / 等待 / 关闭 / 恢复 | 派生子 / 发消息 / 派后续任务 / 等待 / 列出 / 中断 |
| 寻址方式 | 线程标识ID | 规范路径(如 /root/a/b) |
| 输入形态 | 富输入(文本 / 图片 / 技能引用) | 文本消息(支持加密载荷) |
| 嵌套深度 | 默认 1 层 | 不限制(靠并发治理) |
| 并发上限 | 线程配额(默认 6) | 驻留槽位(默认 4,可派 3)+ 执行容量 |
| 内存策略 | 全部常驻 | 懒驻留 + LRU 驱逐 + 按需重载 |
| 上下文继承 | 全量 / 不给 | 不继承 / 全继承 / 最近 N 条(默认不继承) |
| 完成信号 | 状态通知:仅子路径 + 状态,写进父历史 | 带实际内容的消息,可寻址、可触发新回合 |
| 关闭方式 | 显式关闭,可恢复 | 无显式关闭,靠空闲驱逐;中断工具中止当前回合 |
| 治理 | 各自的资源视图 | 共享树级运行时:注册表、预算、关停统一 |
演进的主线 :是"第一代进程内多线程 → 加上资源弹性与真正的多智能体通信"------把常驻变成可换出/重载,把单向一次性的状态通知变成可寻址、带内容、可唤醒的信箱,把粗粒度上下文继承变精细,把线程标识寻址变成规范路径寻址。这也是许多智能体框架从"能跑"走向"可治理"时都要补的一课。
7. 小结
一条主线收束全篇:
- 普通 ReAct 是基线:单循环、单线程、单上下文、同步内联------模型决定,运行时执行。
- Codex V1 完成第一次跃迁:把"派活"从同步函数调用变成异步派生------子有独立线程、独立上下文、持久身份和可恢复的历史;代价是结果异步回流、只带状态、不带内容。
- Codex V2 完成第二次跃迁:在异步派生之上补资源弹性(驻留/换出/重载)与真正的多智能体通信(树级信箱、可寻址、可唤醒、可带内容),并把上下文继承从"全给或不给"细化到按需裁剪。
分水岭始终是那一句:并行的是"步骤"(普通 ReAct)还是"执行体"(V1 / V2)。