上一篇:《MPTT 不是万能编号:一棵百万节点树的增删改与批量事务》
一棵 100 万节点的树,每个节点一个复选框,父节点的状态由子节点推导。听起来是个小学问题,但"全选根节点"在朴素实现里要递归写 100 万个节点、再逐层重算祖先;"半选"判定如果每次都扫子树,复杂度会悄悄变成 O(N²)。这篇文章按三代实现拆:递归 → 三组计数器 → 区间覆盖,每一代都给出代码、复杂度和我本机的实测数据,最后说清楚为什么最后一层只敢做成 opt-in。
0. 一个勾选框引发的三种卡顿
先描述真实场景:
- 用户勾选一个叶子节点。父节点要从"未选"变成"半选",祖父可能还是半选,一直向上传播到根------但只改一条链。
- 用户勾选一个部门节点。它的所有下级都要变成选中,然后祖先链重新聚合。
- 用户勾选根节点。100 万个节点全部变选中;如果输出模式是"只给我顶级选中节点",其实根本不需要写这 100 万个状态。
这三个操作的量级完全不同,但很多实现用同一套递归处理,于是第 1 种被第 3 种的成本拖累,第 3 种又把主线程占满。这个项目的解法是分层:
| 方案 | 核心数据结构 | 单节点勾选 | 根节点勾选 | 适用 |
|---|---|---|---|---|
| 递归/子树扫描 | 对象树 + 深度遍历 | O(子树 + 祖先×子树) | O(N²) 级 | 小树、原型 |
| 三组计数器 | 紧凑数组 + 增量计数 | O(子树 + 深度) | O(N) | 默认路径 |
| 区间覆盖(lazy) | 有序区间 + 按需物化 | O(1) 区间 + O(可见行) | O(1) 区间 + O(可见行) | opt-in、RootOnly |
如果只记一句话:
半选不是"算出来的",是"维护出来的"。 每次只改变化的那条链,别在读取时重新推导整棵树。
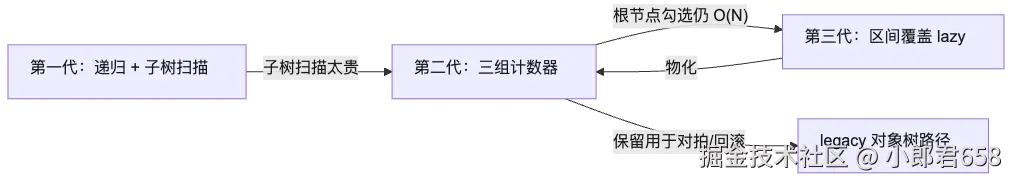
三代实现的演进关系可以先用一张图概括:
1. 状态定义:三个值,一个例外
ts
enum CheckType {
  UNCHECKED = 0,
  HALF_CHECKED = 1,
  CHECKED = 2,
}父节点的状态由直接子节点聚合:
- 所有可参与的子节点都是
CHECKED→ 父节点CHECKED; - 所有可参与的子节点都是
UNCHECKED,且没有半选 → 父节点UNCHECKED; - 其余 → 父节点
HALF_CHECKED。
聚合规则可以画成一张判定图:
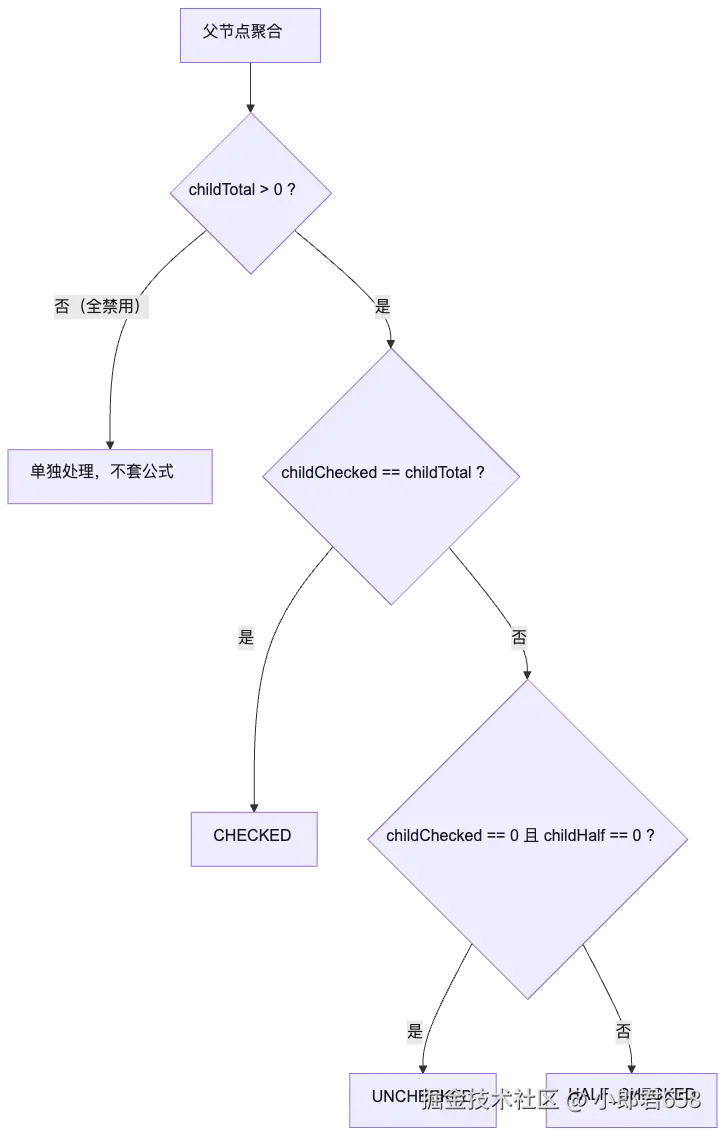
"可参与"是关键:禁用节点不参与聚合。一个禁用的子节点既不算选中,也不算未选中;如果一个父节点的所有子节点都禁用了,它自己也不应该因为"0 个选中 = 全部选中"而变成全选。这个边界是很多实现翻车的地方。
在紧凑存储里,这三组计数分别存在三个 Int32Array:
ts
childTotal:   Int32Array  // 可参与的直接子节点数
childChecked: Int32Array  // 其中 CHECKED 的数量
childHalf:    Int32Array  // 其中 HALF_CHECKED 的数量
父节点状态只需一行:
ts
if (childChecked[i] === childTotal[i]) return CHECKED
if (childChecked[i] === 0 && childHalf[i] === 0) return UNCHECKED
return HALF_CHECKED
调用方必须保证 childTotal[i] > 0;全禁用的分支要单独处理,不能直接套这个公式。
2. 第一代:递归与子树扫描
最直观的实现来自对象树。判断父节点状态,就遍历它的整棵子树,只数深度正好是 deep + 1 的节点:
ts
export function getParentNodeCheckType(
  fullTree: MpttTree[],
  node: MpttTree,
  startIndex: i32
): CheckType {
  let checkedNum = 0
  let unCheckedNum = 0
  let halfCheckedNum = 0

  for (let i = startIndex; i < fullTree.length; i++) {
    const current = fullTree[i]
    if (current.leftNode >= node.leftNode && current.rightNode <= node.rightNode) {
      if (current.deep === node.deep + 1) {
        if (current.checked === CHECKED) checkedNum++
        else if (current.checked === HALF_CHECKED) halfCheckedNum++
        else unCheckedNum++
      }
    } else break
  }

  if (halfCheckedNum > 0 || (checkedNum > 0 && unCheckedNum > 0))
    return HALF_CHECKED
  if (checkedNum > 0) return CHECKED
  return UNCHECKED
}
这段代码有两个值得注意的点。
第一,提前退出的条件是完整的。 只要出现半选子节点,或者同时存在选中和未选中,父节点必然是半选。这个条件也覆盖了"所有直接子节点都是半选"的情况------曾经漏掉这一条,导致父节点被算成未选中。
第二,它仍然在扫子树。 虽然只统计直接子节点,但循环要走过整个子树区间。对一棵宽树,这是 O(子树);如果每个祖先都调用一次,就是 O(子树 × 深度)。
再看单节点勾选的祖先回溯:
ts
for (let j = i - 1; j >= 0; j--) {
  const prevNode = fullTree[j]
  if (prevNode.leftNode <= node.leftNode &&
      prevNode.rightNode >= node.rightNode) {
    prevNode.checked = getParentNodeCheckType(fullTree, prevNode, j + 1)
  }
}
因为 fullTree 按 leftNode 升序(前序),倒着走遇到的第一个匹配就是最近祖先,之后依次是更外层的祖先。这里不能 break:内层祖先状态变化后,外层祖先的聚合仍然要重算;只更新最近祖先,根节点会停在错误状态。这是第一代实现里最隐蔽的 bug------结果看起来"大多数时候对",因为只有跨多层的变化才会暴露。
复杂度:勾选叶子 O(深度 × 子树扫描)。100 万节点的宽树,深度约 6,但每个祖先的子树可能有几十万节点,实际会到几十毫秒甚至更久。
3. 第二代:三组计数器
3.1 一次遍历建好所有索引
CompactNodeStore.load() 在把对象树搬进 typed array 的同时,用两个栈顺便建立父指针、子树结束位置、禁用前缀和,以及三组子节点计数。
ts
for (let i = 0; i < size; i++) {
  const node = tree[i]
  const offset = <usize>i

  store<i32>(leftBase + (offset << 2), node.leftNode)
  store<i32>(rightBase + (offset << 2), node.rightNode)
  store<i32>(depthBase + (offset << 2), node.deep)
  store<u8>(checkedBase + offset, <u8>node.checked)
  // ...selected / collapsed / shown / disabled

  store<i32>(
    disabledPrefixBase + ((offset + 1) << 2),
    load<i32>(disabledPrefixBase + (offset << 2)) + disabled
  )

  // 按 MPTT 边界完成已结束的子树
  while (open.length > 0 &&
         load<i32>(rightBase + ((<usize>open[open.length - 1]) << 2)) <= node.leftNode)
    store<i32>(subtreeEndBase + ((<usize>open.pop()) << 2), i)

  // 按深度找父节点
  while (stack.length > 0 &&
         load<i32>(depthBase + ((<usize>stack[stack.length - 1]) << 2)) >= node.deep)
    stack.pop()

  if (stack.length > 0) {
    const parentIndex = stack[stack.length - 1]
    store<i32>(parentBase + (offset << 2), parentIndex)
    if (disabled === 0) {
      const parentOffset = (<usize>parentIndex) << 2
      store<i32>(childTotalBase + parentOffset,
        load<i32>(childTotalBase + parentOffset) + 1)
      if (checked === 2)
        store<i32>(childCheckedBase + parentOffset,
          load<i32>(childCheckedBase + parentOffset) + 1)
      else if (checked === 1)
        store<i32>(childHalfBase + parentOffset,
          load<i32>(childHalfBase + parentOffset) + 1)
    }
  }
  stack.push(i)
  open.push(i)
}
这段代码里有三个可以单独拿出去讲的设计:
open栈和stack栈不是一回事。open按rightNode判断子树是否结束,用来填subtreeEnd;stack按depth找当前父节点。两者合作,一遍扫描同时完成"子树范围"和"父子关系"。- 禁用节点不计入父节点的
childTotal。if (disabled === 0)这一行决定了后面所有聚合的分母。 - 两个栈按实际深度/宽度增长,不预分配
size。 注释里写得很清楚:给 100 万节点分配两个长度为size的临时数组,会把建树内存从 512MB 推到分配器的下一个 arena(1GB),而宽树实际只需要很少的栈深度。
3.2 增量维护:只改一条链
勾选一个节点时,只做三件事:
ts
// 1. 把目标的旧状态从父节点计数里减掉,新状态加上
updateChildStateAt(childChecked, childHalf, parent[target], previous, value)

// 2. 写目标自身
store<u8>(checkedBase + targetOffset, value)

// 3. 写子树(O(子树)),再沿祖先链重算(O(深度))
第 3 步的子树写入有一个快速路径:
ts
if (!this.hasDisabledInSubtree(targetIndex)) {
  for (let i = targetIndex + 1; i < subtreeEnd; i++) {
    // 不需要每次读 disabled[i]
  }
} else {
  for (let i = targetIndex + 1; i < subtreeEnd; i++) {
    if (load<u8>(disabledBase + offset) === 0) {
      // ...
    }
  }
}
hasDisabledInSubtree 用前缀和做到 O(1):
ts
return disabledPrefix[subtreeEnd[index]] !== disabledPrefix[index]没有禁用节点时,热循环少一次 typed array 读取;有禁用节点时,逐个判断。这个分支在"100 万节点、禁用节点很少"的树上是纯收益。
祖先链则从目标的父节点一路向上,每次用三组计数重算:
ts
let ancestor = parent[target]
while (ancestor >= 0) {
  const next = aggregateStateAt(childChecked, childTotal, childHalf, ancestor)
  const previous = checked[ancestor]
  const ancestorParent = parent[ancestor]
  updateChildStateAt(childChecked, childHalf, ancestorParent, previous, next)
  checked[ancestor] = next
  tree[ancestor].checked = next
  ancestor = ancestorParent
}
3.3 复杂度与实测
- 叶子勾选:O(1) 子树 + O(深度) 祖先;
- 根节点勾选:O(N) 子树写入 + O(1) 祖先;
- 内存:100 万节点 14 个数组,约 39.1MB (
getCompactMemoryBytes),WASM 线性内存约 1.1GB(含字符串和对象镜像)。
1,000,000 节点宽树实测:
| 操作 | P50 | P95 |
|---|---|---|
| 叶子勾选 | 0.006ms | 0.031ms |
| 根节点勾选 | 16.28ms | 16.58ms |
| 批量勾选 3 个目标 | 4.46ms | 6.76ms |
100,000 节点对照:
| 操作 | compact | legacy(对象树) |
|---|---|---|
| 叶子勾选 | 0.005ms | 0.592ms |
| 根节点勾选 | 1.63ms | 0.995ms |
这里有一个反直觉的结果:根节点勾选,legacy 反而比 compact 快。 因为 legacy 只是在对象数组里逐个赋值,而 compact 还要维护三组计数、前缀和和父指针。紧凑存储的收益在叶子和内存,不在"所有操作都更快"。
这也解释了为什么项目保留了两条路径:useCompactSelection 可以关闭,legacy 路径用于对拍和回滚,而不是"旧代码没删干净"。
4. 第三代:区间覆盖
4.1 为什么计数器还不够
根节点勾选是 O(N)。但很多业务只关心"哪些顶级节点被选中了":
css
输出模式 RootOnly:
  勾选根节点 → 输出 ["root-id"],而不是 100 万个 ID
既然输出不需要子节点的状态,为什么还要写 100 万次?答案是:为了渲染。每一行都要显示自己的勾选态,所以子节点的状态必须可用。但如果树是折叠的,屏幕上只有几十行,剩下 99.99% 的状态根本没人看。
这就是 lazy 区间覆盖的动机:用一个区间表示"这棵子树全是选中/未选中",读取时再按需展开。
4.2 数据结构:有序区间 + 切分 + 合并
LazyCheckRangeStore 维护三个平行数组:left[]、right[]、value[]。写入一个区间时,把它与现有区间做交集切分:
ts
setRange(rangeLeft, rangeRight, rangeValue): void {
  const nextLeft = [], nextRight = [], nextValue = []
  let inserted = false

  for (let i = 0; i < this.left.length; i++) {
    const l = this.left[i], r = this.right[i]
    if (r <= rangeLeft) {
      // 完全在左边,保留
    } else if (l >= rangeRight) {
      // 完全在右边,先插入新区间,再保留
    } else {
      // 有交集:保留左侧残余、插入新区间、保留右侧残余
      if (l < rangeLeft) { /* [l, rangeLeft) */ }
      if (!inserted) { /* [rangeLeft, rangeRight) */ }
      if (r > rangeRight) { /* [rangeRight, r) */ }
    }
  }
  // 最后 mergeAdjacent()
}
这本质上是一棵**珂朵莉树(Chtholly tree)**的数组版:用不相交的区间覆盖一段定义域,每次写入会切分被覆盖的旧区间,并把相邻同值区间合并。
查询一个点:
ts
getPoint(index: i32): i32 {
  for (let i = 0; i < this.left.length; i++) {
    if (index < this.left[i]) break
    if (index < this.right[i]) return this.value[i]
  }
  return -1  // 没有覆盖,回退到 compactStore.checked
}
区间数量很少时,线性扫描足够;如果区间多到几千个,可以换成二分。项目当前的选择是线性,因为 lazy 路径的区间数通常是个位数。
4.3 触发条件:不是所有勾选都能 lazy
ts
private _canApplyLazyCheckboxRange(index: i32, value: CheckType): bool {
  if (
    this.useLazyCheckboxRanges &&
    this.checkedOutputMode === CheckedOutputMode.RootOnly &&
    (value === CheckType.CHECKED || value === CheckType.UNCHECKED) &&
    index >= 0 &&
    !this.compactStore.hasDisabledInSubtree(index)
  ) {
    let ancestor = this.compactStore.parent[index]
    while (ancestor >= 0) {
      if (this.lazyCheckRanges.getPoint(this.compactStore.left[ancestor]) >= 0)
        return false
      ancestor = this.compactStore.parent[ancestor]
    }
    return true
  }
  return false
}
五个条件缺一不可:
- 显式 opt-in:默认关闭,避免改变既有行为;
RootOnly输出 :All/LeafOnly必须枚举每个节点,lazy 没有意义;- 全选或全不选:半选状态不能用一个值覆盖整个区间;
- 子树无禁用节点:禁用节点要保持自己的状态,不能被区间覆盖;
- 祖先没有 lazy 覆盖:否则要先物化,回到普通路径。
第 5 条是正确性的关键。如果祖先已经被一个区间覆盖,再对子区间写入会让两个区间的语义重叠;项目选择"先物化,再走逐节点路径",用一次 O(N) 换简单可靠。
4.4 写入与读取
写入时,目标节点立即更新(渲染要用),子树交给区间:
ts
this.lazyCheckRanges.setRange(left[index], right[index], value)

// 目标自身和它的子节点计数直接设值
this.compactStore.checked[index] = value
this.compactStore.childChecked[index] =
  value === CHECKED ? childTotal[index] : 0
this.compactStore.childHalf[index] = 0

// 祖先链仍然用计数器增量维护
读取时先查区间,再回退到紧凑数组:
ts
private _checkedStateAt(index: i32): u8 {
  const lazyValue = this.lazyCheckRanges.getPoint(this.compactStore.left[index])
  return lazyValue >= 0 ? (lazyValue as u8) : this.compactStore.checked[index]
}
但渲染只读 compactStore.checked,所以写入后还要把可见行的状态同步过去:
ts
private _syncLazyShownStates(): void {
  if (!this._hasLazyCheckboxRanges) return
  for (let i = 0; i < this._shownNodes.length; i++) {
    const index = this._shownNodes[i].fullIndex
    if (index < 0) continue
    const value = this.lazyCheckRanges.getPoint(this.compactStore.left[index])
    if (value >= 0) {
      this.compactStore.checked[index] = value
      this.fullTree[index].checked = value
    }
  }
}
4.5 实测与边界
1,000,000 节点、无禁用、RootOnly、树全展开:
| 操作 | P50 | P95 |
|---|---|---|
| 普通逐节点写入 | 7.95ms | 31.01ms |
| lazy 区间写入 | 0.53ms | 0.82ms |
lazy 后 getCheckedIds |
7.18ms | 7.42ms |
在"树初始折叠、可见行很少"的场景,归档基准更低:lazy 写入 0.039ms (P95 0.375ms),普通写入 28.98ms(P95 31.73ms),约两个数量级。
差别来自 _syncLazyShownStates:它遍历 _shownNodes,而 _shownNodes 是所有可见行,不是视口那几十行。树全展开时它就是 100 万行,lazy 的写入成本被拉回 O(N);树折叠时只有少量行,接近 O(1)。
这不是实现缺陷,而是一个明确的取舍:lazy 省掉的是"子树状态写入",省不掉"可见行状态同步"。 如果继续优化,可以把同步范围缩到视口(scrollTop/scrollHeight 已知),但那要改渲染层的数据契约,项目没有做。
4.6 物化:什么时候必须回到逐节点
以下操作会调用 _materializeLazyCheckboxRanges(),把区间展开成每个节点的真实状态:
- 切换到
All/LeafOnly输出模式; setCheckedNodes批量设置;clearCheckedNodes清空;- 结构变更(新增/删除节点);
- 编辑 lazy 覆盖范围内的节点;
- 对已有 lazy 祖先的子节点做写入。
物化是 O(N) 的:
ts
for (let i = 0; i < this.fullTree.length; i++) {
  const value = this.lazyCheckRanges.getPoint(this.compactStore.left[i])
  if (value >= 0) {
    this.compactStore.checked[i] = value
    this.fullTree[i].checked = value
  }
}
this.compactStore.syncSelection(this.fullTree)
所以 lazy 的收益取决于"写入之后、物化之前"有多少操作。如果用户勾选根节点后马上切换到 All 输出,lazy 只是把成本从写入挪到了切换,整体不会更快。它是为"勾选后长时间只读 RootOnly"这个场景设计的。
5. 输出:三种模式,三种成本
即使状态都对,输出方式也会决定卡不卡。
5.1 All / LeafOnly:枚举
ts
for (let i = 0; i < fullTree.length; i++) {
  const node = fullTree[i]
  if (node.checked !== CHECKED) continue
  if (outputMode === LeafOnly && !isLeaf(node)) continue
  ids.push(node.id)
}
O(N) 扫描 + 生成 ID 字符串。100 万节点、ID 长度 40 字符时,输出本身就是 4000 万字符,约 40MB。这时候的瓶颈不是算法,是序列化和内存带宽。
5.2 RootOnly:覆盖栈
只输出"没有被选中祖先覆盖"的节点。用栈记录已输出祖先的右边界:
ts
const coverStack: i32[] = []
for (let i = 0; i < fullTree.length; i++) {
  const node = fullTree[i]
  while (coverStack.length > 0 &&
         node.leftNode >= coverStack[coverStack.length - 1])
    coverStack.pop()

  if (node.checked !== CHECKED) continue
  if (coverStack.length > 0) continue   // 已被祖先覆盖

  ids.push(node.id)
  coverStack.push(node.rightNode)
}
单遍 O(N),但输出只有 1 条。
5.3 实测
1,000,000 节点、勾选根节点:
| 输出模式 | 耗时 | 输出大小 |
|---|---|---|
| All | 1268.6ms | 40,000,001 字符 |
| LeafOnly | 1016.6ms | 35,851,921 字符 |
| RootOnly | 13.8ms | 41 字符 |
100,000 节点:
| 输出模式 | 耗时 | 输出大小 |
|---|---|---|
| All | 123.6ms | 3,988,001 字符 |
| LeafOnly | 98.9ms | 3,588,801 字符 |
| RootOnly | 1.68ms | 41 字符 |
这组数据最能说明问题:三种模式的扫描都是 O(N),差距完全来自生成多少字符。RootOnly 快 90 倍,不是算法更聪明,而是它不生成 4000 万字符。
如果你的业务其实只需要顶级选中节点,先换输出模式,再谈优化。
6. 批量设置与清空
6.1 批量设置的三条路径
ts
setCheckedNodes(ids: string[]): void {
  this._materializeLazyCheckboxRanges()

  if (CHECKBOX && useCompactSelection && !hasDisabledNodes()) {
    this.compactStore.resetCheckboxSelection(this.fullTree)   // O(N)
    for (const id of ids)
      this.compactStore.checkCheckbox(this.fullTree, index, CHECKED) // O(子树)
  } else {
    setCheckedNodesInTree(this.fullTree, ids, this.idToIndex)  // legacy
    this.compactStore.syncSelection(this.fullTree)
  }
}- 无禁用节点 :先 O(N) 清零计数,再对每个目标走
checkCheckbox。总成本 O(N + Σ子树)。 - 有禁用节点 :走 legacy。先 O(N) 重置,再逐个设子树并收集唯一祖先,按
leftNode降序自底向上重算。祖先去重和排序是额外成本,正确性优先。 - lazy 开启 :批量设置会先物化,因为
RootOnly之外的目标不能保证区间语义。
6.2 清空
clearCheckedNodes 不是简单地把 checked 置 0:它还要清 selected、清 lazy 区间、重建 compact 的选择计数。resetCheckboxSelection 的实现是"两遍":
ts
// 第一遍:清零计数和 checked,保留 disabled
// 第二遍:单遍重建每个父节点的 childChecked / childHalf
为什么不能直接全清?因为禁用节点要保持自己的状态,而且父节点的聚合要重新算------如果只把 checked 清零、不同步计数,下一次勾选就会从错误的基数开始。
7. 怎么证明优化没改坏
这类"把递归换成计数器、再加一层区间覆盖"的改造,最大的风险不是慢,而是某条边界路径算错。项目用的办法是对拍:
- 固定种子随机操作序列:120 步、300 步;
- 每一步同时跑 lazy 路径和 legacy 路径;
- 比较四个输出:
getCheckedIds、getCheckedNodes、getShownNodes、getShownIndices; - 覆盖父/叶勾选、禁用节点、折叠展开、搜索进入退出、输出模式切换、批量设置、清空。
这套对拍抓住过真实问题,比如"所有直接子节点都是半选时父节点被算成未选中"。单看 happy path 的测试很难发现它,因为需要构造一个特殊的子树形状。
如果你的树也有多层聚合,建议先写对拍,再写优化。对拍不是"测试覆盖率",它是给优化允许的误差范围:输出必须逐字节一致,否则不许上线。
8. 复杂度总览
把前面散落在各节的复杂度和实测数据横向摆在一起,三代实现的取舍会更清楚。下表所有耗时均取自正文已有的实测表格(1,000,000 节点宽树,勾选根节点场景;输出耗时对应 All/LeafOnly/RootOnly 三种模式):
| 维度 | 第一代:递归/子树扫描 | 第二代:三组计数器 | 第三代:区间覆盖(lazy) |
|---|---|---|---|
| 叶子勾选 | O(子树 × 深度),实测几十毫秒级 | O(1) 子树 + O(深度) 祖先,0.006ms | O(1) 区间 + O(可见行),0.53ms (全展开)/ 0.039ms(折叠) |
| 根节点勾选 | O(N²) 级 | O(N) 子树写入 + O(1) 祖先,16.28ms | O(1) 区间 + O(可见行),0.53ms (全展开)/ 0.039ms(折叠) |
| 批量设置 | 逐目标递归,O(Σ子树 × 深度) | O(N + Σ子树),3 个目标 4.46ms | 先物化 O(N),再走逐节点路径 |
| All / LeafOnly 输出 | O(N) 扫描 + 生成字符串 | O(N) 扫描 + 生成字符串,1268.6ms / 1016.6ms | 不支持(必须物化后枚举) |
| RootOnly 输出 | O(N) 扫描 + 覆盖栈 | O(N) 扫描 + 覆盖栈,13.8ms | O(N) 扫描 + 覆盖栈,lazy 后 getCheckedIds 7.18ms |
| 内存占用 | 对象树,节点对象 + 指针开销 | 14 个数组约 39.1MB(WASM 线性内存约 1.1GB) | 在 compact 基础上增加三个区间数组,区间数通常个位数 |
几点读表提示:
- 叶子勾选是第二代的主场:0.006ms 对第一代的几十毫秒,差距来自"不再扫子树"。
- 根节点勾选第二代仍是 O(N),16.28ms 基本就是 100 万次状态写入的成本;lazy 把它压到 0.53ms,但前提是树折叠、可见行少。
- 输出这一行三代都绕不开 O(N) 扫描,真正的差距在生成多少字符:RootOnly 13.8ms 对 All 1268.6ms,快 90 倍靠的是不生成 4000 万字符。
- 批量设置 和内存是第二代的隐性成本:前者要 O(N) 清零再逐个写子树,后者 39.1MB 是紧凑数组本身,对象镜像另算。
9. 决策表
| 场景 | 建议 |
|---|---|
| 叶子勾选为主 | 三组计数器,O(深度) |
| 经常勾选根/大子树,且要 All/LeafOnly 输出 | 接受 O(N) 写入;瓶颈在输出,不在状态 |
| 经常勾选根/大子树,且只要 RootOnly | lazy 区间(opt-in),但确认折叠/可见行规模 |
| 子树里有禁用节点 | lazy 关闭,走逐节点路径 |
| 需要每行实时显示状态 | 写入后同步可见行;全展开时这就是 O(N) |
| 频繁批量设置 | 无禁用时走 compact 批量;有禁用时接受 legacy 的祖先重算 |
| 内存敏感 | compact 数组约 39MB/1M 节点,对象镜像另算 |
| 正确性验证 | 固定种子对拍四个输出,覆盖 lazy/legacy 切换 |
10. 写在最后
复选框的半选状态,表面是"三个值的聚合",实际是三笔账:
- 传播账:一次变化只沿一条链向上,O(深度);
- 写入账:勾选大子树必须写子树,O(子树);lazy 用区间把这笔账推迟;
- 输出账:All/LeafOnly 要枚举并生成字符串,O(N) 且常数很大;RootOnly 用覆盖栈只输出根。
三笔账里,最容易优化错的是第二笔。很多人看到"根节点勾选 16ms"就去优化聚合,其实真正的瓶颈是 100 万次状态写入;而如果输出只要 RootOnly,这 100 万次写入本来就可以不做。先确认输出需要什么,再决定状态要维护到什么粒度。
上一篇:《MPTT 不是万能编号:一棵百万节点树的增删改与批量事务》。两篇合起来,基本覆盖了这棵树在"写"侧的全部成本。下一篇可以聊 Worker 协议:版本号、合并窗口,以及为什么结构变更和勾选结果要用不同的节流时间。
项目:vue3-giant-tree-wasm(Vue 3 + AssemblyScript/WASM,BSD-2-Clause)。本文代码来自 assembly/compact-store.ts、assembly/lazy-check-range-store.ts、assembly/tree-check.ts、assembly/giant-tree.ts,为便于阅读做了节选和简化。实测环境:macOS arm64、Node v26.7.0、AssemblyScript release 构建,2026-10-22;1M 数据为独立进程,预热 3 轮后 15 轮采样。归档数据引自 docs/performance-refactor-plan.md(2026-09-16,1,000,000 节点 push 树)。
项目地址:github.com/jktantan/vu... 在线文档与演示:jktantan.github.io/vue3-giant-... npm:vue3-giant-tree-wasm