💡 一句话总结:把 Agent 技能的「粒度」当作运行时控制变量------该用微工具时用微工具、该用宏技能时用宏技能、宏失败时自动降级补救,试点实验里 100% 成功率的同时把 token 成本压掉一半。做 Agent 框架和技能库的工程师值得深读。
导语:你的技能库可能正在拖累你的 Agent
先问一个可能戳到你的问题:你的 Coding Agent 技能库攒了多少条技能了?十几条 SKILL.md,几十个打包好的工具链,看起来弹药充足。但有没有发现,有些任务让它直接用最笨的「读文件-改代码-跑测试」反而又快又稳,一启用某个看起来很高级的「一键重构」宏技能,跑到一半报错,工作区被改了一半,Agent 开始原地打转?
这不是你的错觉。今年有一批研究在系统性地验证这件事:技能注入的收益是不均匀的。引用的 SWE-Skills-Bench 就发现,当技能的抽象层级和任务上下文不匹配时,技能不仅增加成本,甚至会劣化软件工程表现。技能不是越多越好,也不是越「高级」越好。
那怎么办?上海交大联合华威大学、快手的几位作者在 2026 年 10 月 22 日挂上 arXiv 的这篇论文,给出了一个相当清爽的回答:别把「用不用技能」当成检索的副产品,把它升级成一个运行时控制问题 。论文的名字叫 Adaptive Skill Granularity for Coding Agents: Runtime Routing and Macro-to-Micro Recovery(面向编码 Agent 的自适应技能粒度:运行时路由与宏到微恢复)。
想自己动手试?
- 📄 论文:arXiv 2610.31461
- 💻 代码:GitHub · Jayceon-3/Adaptive-Skill-Agent
- 📊 数据集:GranBench-Code(80 任务,随代码仓库发布)
这篇论文到底想解决什么问题?
把 Agent 的动作想象成两种「粗细」:微动作 (micro)是一次一个原始工具调用------读文件、搜代码、编辑、跑测试,每步都很稳,但一个任务要走上六七步;宏动作(macro)是把一整套流程打包成一次调用------比如「移动模块并改写所有 import」,一步顶五步,效率翻倍。
为什么会这样?因为宏技能本质上是把「过去验证过的执行经验」固化成了单个动作。它对标准场景极其高效,但它的前提条件是写死的:一旦当前工作区和它预期的不一样------目标文本不存在、依赖结构变了、测试本来就不通过------宏就会在执行中途失败。而此时它可能已经把工作区改了一半,这个「半成品状态」比没动手之前更难收拾。
现有的技能生态(Markdown 技能、技能路由器、依赖感知技能图、轨迹挖掘)几乎都在优化同一件事:任务开始前,把最相关的技能文本塞给模型。这没错,但不完整。检索回答的是「哪个技能和任务相关」,却没人回答「这次执行到底该用多粗的动作、失败了怎么办」。
论文把这个问题形式化为三种执行模式:micro (只用原始工具)、macro (只用宏技能)、hybrid(先上宏,出现可观察的失败后降级回微工具补救)。核心假设一句话:没有万能粒度,最优选择取决于任务结构、技能质量和执行状态------所以它应该是一个显式的运行时决策。
它的思路是什么?
整个系统分三块:一个粒度控制器 决定初始模式,一组带契约的宏技能 提供高级动作,一个有限状态机恢复执行器(FSM,简单说就是一个「当前处于什么状态、什么事件触发什么转移」的调度器)处理失败降级。先看全景图:
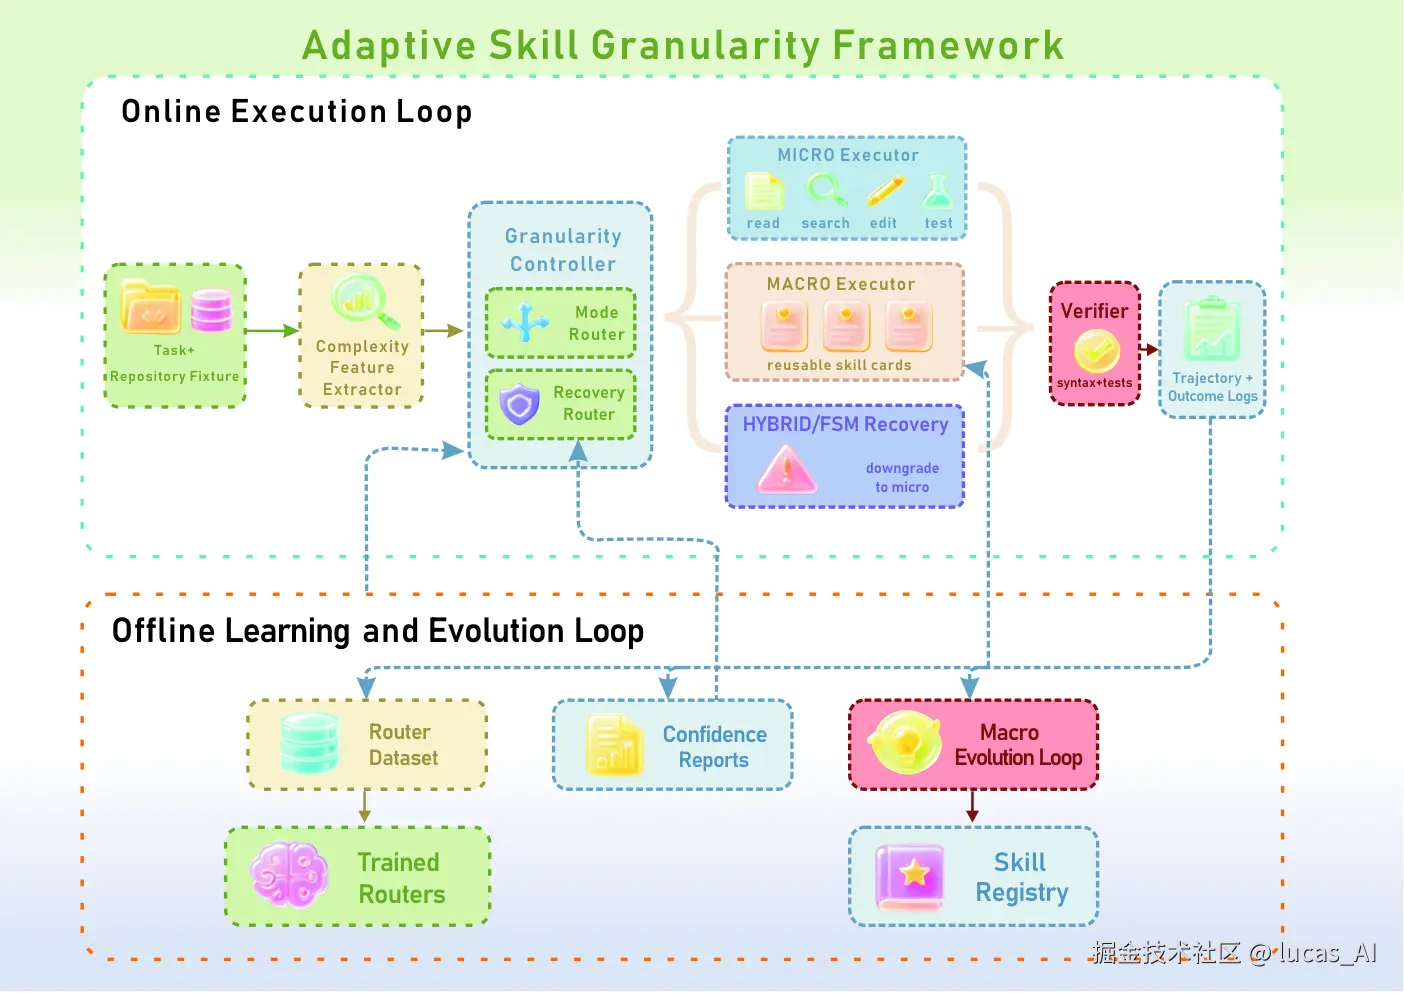
**粒度控制器怎么决策?**它在任务开始前从元数据和初始工作区抽 10 个结构特征:文件路径数、Python 和非 Python 文件数、提示里的实体串数量、AST(抽象语法树,代码的结构化表示)节点数与最大深度、import 数量、跨文件依赖数,外加「是不是文本任务」「是不是重构任务」两个开关。
这里有个容易被忽略但很妙的设计约束:路由器只准看执行前的证据。它不许偷看本轮的验证结果------这保证了评估时不作弊,也让决策可以被完整审计。而承载决策的模型,是一个最大深度 4 的决策树,离线在历史执行日志上训练好后序列化成 JSON。为什么不整个神经网络?作者的理由很工程师:浅决策树可审计、无在线再训练、无黑盒检查点,每条路由决策都能追责。
宏技能凭什么可以被「降级」?论文给宏技能定了一个七元组契约:名字、参数、前置条件(什么时候适用)、允许的副作用(能动工作区的哪些部分)、内部验证例程、可观察的失败类别、以及微级回退路径。最后这项是关键------宏失败后必须暴露足够的状态信息,让执行器能判断「当前这个半成品工作区能不能用原始工具修好」。没有这份契约,降级就是一句空话。
**失败了怎么救?**看这张状态机图:
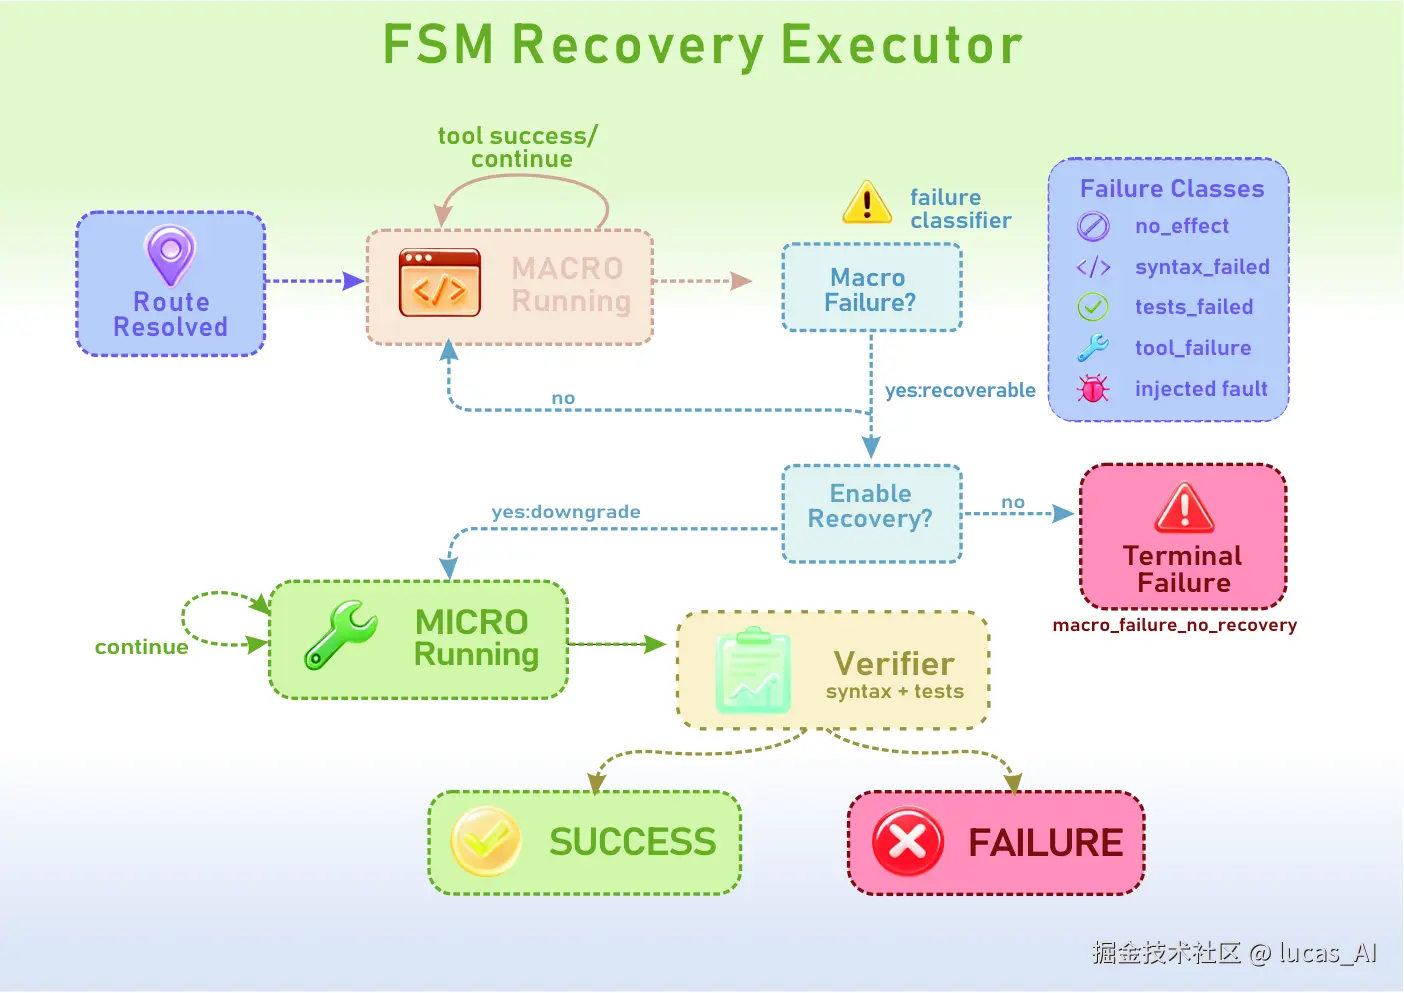
执行器把宏失败当成一次状态转移 而不是终局。失败会被归入五类之一:前置条件不匹配(宏不适应当前工作区)、部分副作用(失败前已经改了状态)、验证失败(语法检查或测试拒绝)、工具协议失败(参数或返回的 JSON 畸形)、执行器异常(运行时自己挂了)。还有一条记账铁律:只有降级后的微轨迹最终通过验证器,这次恢复才记功。模型自己说「我修好了」不算数。
三条设计不变量贯穿始终:路由只用执行前证据、恢复必须事件驱动、成败只认验证器。说白了就是让系统的每个决策都可回放、可审计------这个品味在满屏「Agent 自主反思」的今天反而稀缺。
效果到底怎么样?
论文自建了 GranBench-Code 基准:80 个编码任务分四类(简单修复、多文件修改、重构、故障注入恢复),每个任务带确定性验证器。试点实验的数字很有说服力。
先看固定粒度的对比。12 个混合任务上:纯微执行成功率 100%,但每任务平均烧 7218 个 token、6 步;纯宏执行只要 3609 个 token、2.7 步,成功率却掉到 58.3%。也就是说,宏省一半钱,但每三次就要翻车一次。手写规则的启发式路由居中:75% 成功率。
更有意思的是故障注入实验,它揭示了一个反直觉的结论:恢复的价值取决于失败时机。
- 早期失败(宏还没干活就崩):不开恢复机制的 Agent 成功率 0%,全军覆没;开了 FSM 降级,100% 救回,代价是 token 涨到约 11293。
- 晚期失败 (宏其实已经把该改的改完了才报错):不开恢复的 Agent 本来就能过验证,100% 成功、只用 2440 token;而无条件降级的 Agent 明明结果已经对了,还要从微工具再做一遍,token 膨胀到 7567------白白多花三倍钱。
所以「无脑加恢复机制」和「无脑不加」都是错的。论文的完整框架 F-Learned-Full 用学习型模式路由加学习型恢复策略解决这个两难:学习路由把启发式误派宏的高风险任务改派微执行(成功率从 75% 提到 100%),恢复路由学会「该救才救」。
最终数字:早期失败下 100% 成功、token 比无条件降级省 13.6%;晚期失败下 100% 成功、token 省 51.2%、不必要的降级转移率从 100% 压到 14.3%。看这张结果分解图,完整框架的柱子里终态失败(红色)消失了:
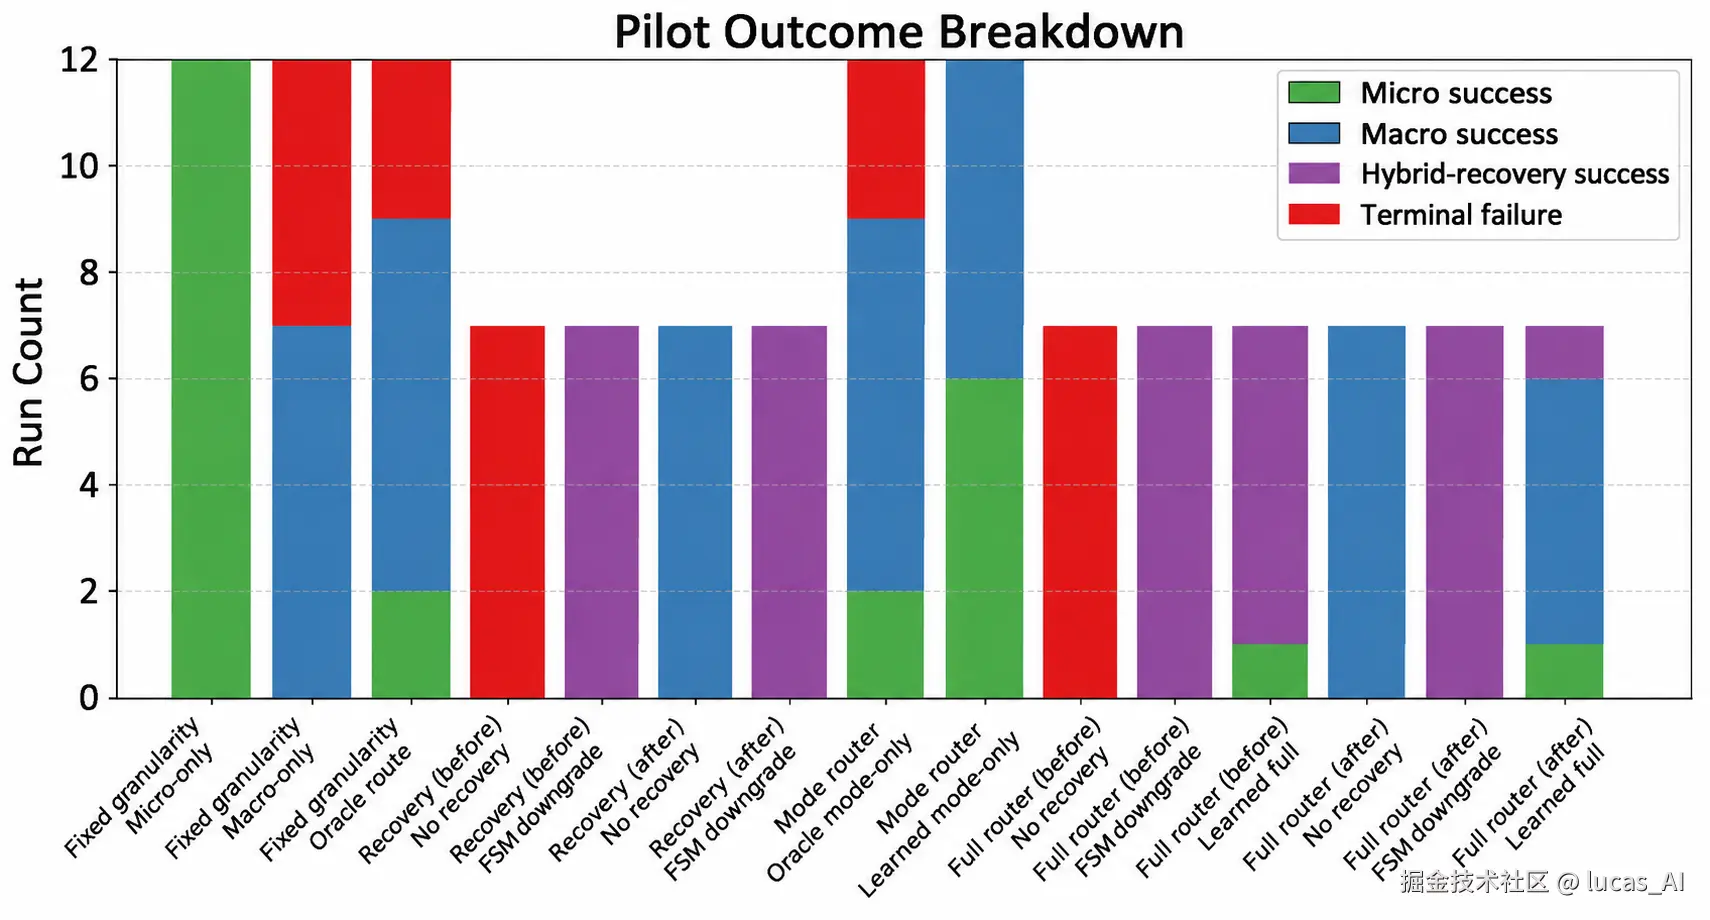
我的读法是:这组数字最值得在意的不是「100% 成功」,而是紫色部分的位置------恢复成功只出现在早期失败的柱子里,晚期失败柱子里没有紫色。这说明框架不是「总能恢复」,而是「知道什么时候根本不用恢复」。这才是成本省下来的来源。
为什么你要关心?
这套东西离实践不远,三条可以直接搬走:
- 给你的宏技能补一份「失败契约」。不管你用的是 Claude Code 的 SKILL.md 还是自建技能系统,给每个高级技能写清四件事:什么时候适用(前置条件)、会动哪些文件(副作用)、怎么验证自己没干砸(验证步骤)、失败了从哪里接手(回退路径)。没有这份契约的宏技能,出了问题就是黑箱。
- 失败要分类,别笼统重试。论文的五分类(前置条件不匹配/部分副作用/验证失败/协议失败/执行器异常)可以直接拿来复盘你 Agent 的历史失败轨迹------你会发现不同类的正确处理方式完全不同,盲目「再试一次」恰恰是部分副作用类失败的毒药。
- 「恢复后必须过验证才算救回」值得写进你的评估。很多 Agent 框架统计成功率时只看模型是否宣称完成,把「恢复了但改错了」也算成功能。用确定性验证器(测试、类型检查、diff 审查)做最终裁决,你的数据才有意义。
往大了看,这篇论文踩在两个趋势的交点上:技能库正在成为 Agent 产品的标配(从 Claude Code 到各家 Agent 框架都在攒技能),而技能质量的良莠不齐也让「什么时候该信技能」变成真实的生产问题。技能粒度控制大概率会成为 Agent 运行时的标准组件------就像数据库的查询优化器替你决定要不要走索引一样。
理性看待
保持冷静的部分:这是一个试点研究,实验规模很小------12 个混合任务加 7 个故障注入任务,宏只有 3 个且是人工手写的,单一 LLM、单一 Python 生态。学习型路由器的「100% 成功」来自在历史执行日志上训练后再评同类任务,论文没有说明训练与评测任务的隔离程度,存在过拟合的合理怀疑。宏技能演化环(自动挖掘新技能)只有概念设计没有实证。数字当方向看,别当基准成绩看。
但方向本身是清晰的:技能库不该只是「可检索的资源」,而应该是「可控、可验证、可恢复的执行抽象」。这句话值得贴在每一个 Agent 团队的墙上。