💡 一句话总结:DeepMind 研究者发现所有主流框架的 softmax/交叉熵标准实现藏着两个浮点 Bug------目标梯度会凭空消失、蒸馏梯度会无中生有;修复只要十余行代码,独立开发者已经实测复现。你训练过的每个模型都跑过这两个函数。
导语:最基础的函数,最隐蔽的坑
每个写过训练循环的人都跟这两个函数打过交道:softmax 把模型输出的原始分数变成概率,交叉熵给这些概率打分。它们是深度学习的「Hello World」,久用到没人会怀疑它们有问题。
10 月 22 日,Google DeepMind 首席研究科学家 Jonathan T. Barron 和两位同事提交了一篇 arXiv 论文《A Fix for Softmax and Cross-Entropy》,开门见山:PyTorch、JAX、TensorFlow 和教科书共用的标准实现,存在两个浮点数值 Bug。注意措辞------不是「精度不够好」这种和稀泥的说法,是「Bug」,还附上了可证伪的具体数字。
论文发布后,DEV Community 上很快出现独立实测复现(结果与论文一致),机器之心等中文媒体跟进报道,PyTorch 和 JAX 的仓库里甚至能找到早于论文发布的同类现象 issue。老牌基础函数被实锤有 Bug,这在深度学习历史上可不多见。
参考来源在前,方便查证
- 📄 论文一手:arXiv 2610.31642 · 作者主页版本
- 🧪 独立实测:DEV Community·fp32 复现
- 📰 中文报道:机器之心
Bug 之一:梯度会在「精度悬崖」处凭空消失
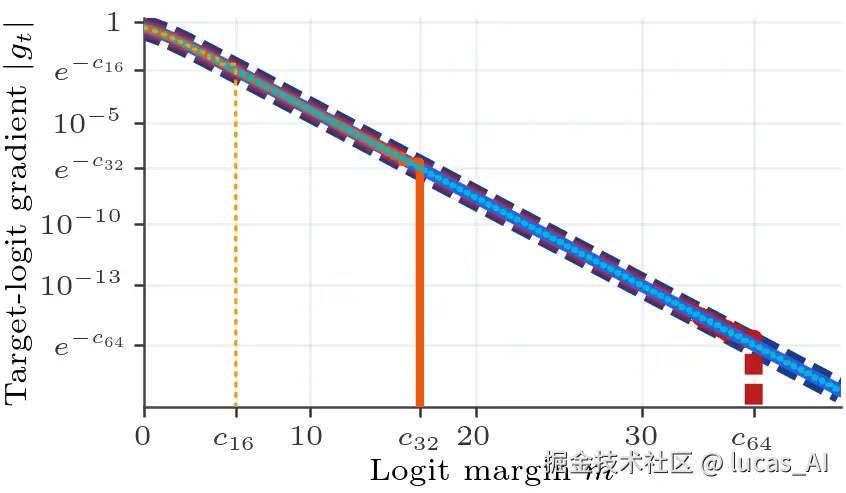
第一个 Bug 叫 Softmax Collapse(崩塌) ,机理一句话能讲清:当模型对正确答案足够自信------正确类的 logit 比其他类大出一截(这个差距叫 margin)------标准实现的反向传播会把这一项的梯度舍入成精确的零。
更麻烦的是这个失效不是渐进的,而是悬崖式的 。论文算出了各精度下的悬崖位置:bf16 约 5.5,fp32 约 16.6,fp64 约 36.7。margin 一旦越过悬崖,损失和目标梯度直接归零,事先没有任何预警。
独立开发者 frankchu 在论文发布后立刻做了实测:fp32 下把 margin 拉到 16,交叉熵的损失和目标梯度精确等于零 ------和论文给的 16.6 悬崖严丝合缝。另一个细节也很反直觉:消失的只有目标梯度,其他非目标梯度是在 0 附近计算的、浮点粒度细、安然无恙。于是梯度向量不再求和为零------被删掉的那份梯度凭空蒸发了,而不是被挪给了别人。
Bug 之二:蒸馏时梯度会「无中生有」
第二个 Bug 叫 Softmax Cancellation(抵消) ,受害场景是知识蒸馏(让学生模型模仿教师模型的输出)。理论上,学生 logits 和教师 logits 完全相等时,损失梯度应该是零------学生已经学到位了,没什么可推的。
但标准实现算出来的梯度不是零。浮点运算在「学生 ≈ 教师」的区间发生灾难性抵消,结果是一股无中生有的梯度持续把学生推离教师。用一个不那么严谨但直观的比喻:教练喊「动作标准,保持住」,学生的肌肉却听到了「再歪一点」。
这个 Bug 和 Collapse 是一对镜像:一个把该有的梯度删成零,一个把该为零的梯度凭空造出来。共同根因是同一处------标准实现里「把极小概率加到 1」的那步浮点加法。
修复:十余行代码,换个减法姿势
修复方案简单得让人意外:重写 log-softmax,全程在对数空间算差值。核心技巧是把「极小数加到 1」的运算改写为 softplus、expm1、log1p 这三个浮点友好的函数,常数剔除、不在概率域做累加。论文给出的 JAX 实现大约十几行,不需要更高精度、不改损失函数设计,两个 Bug 一起修好。
实验效果(论文自报)值得列一下:
- 消除此前无法解释的「弹射现象」(Slingshot------训练损失突然飙升后回落);
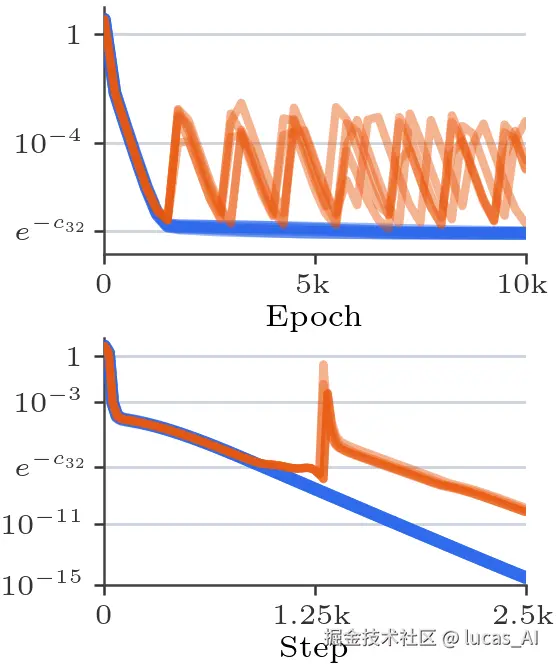
- 带权重衰减时加速 grokking(顿悟现象);不带权重衰减时防止训练后期准确率崩塌;
- 知识蒸馏中学生不再被虚假梯度推离教师。
社区怎么看:复现、旁证与一句保留
各信源在这件事上高度一致,而且互补:
- 独立复现:DEV Community 两篇实测(frankchu 的 fp32 悬崖复现、danielsamfdo 的 bf16《The 5.5 Cliff》科普)结果都与论文吻合;
- 平台旁证 :PyTorch 仓库 9 月就有人报过
torch.softmax在 float64 下丢失本应非零的导数分量(issue #195684),JAX 也有同族数值问题(issue #37234)------早于论文的现象报告,说明 Bug 在实战中已经露出过马脚,只是没被归因到位; - 中文社区 :机器之心 10 月 25 日报道(《PyTorch、JAX都被点名!Softmax曝出隐藏Bug,Gemini立功》),智源社区上线论文中文讲解。标题里「Gemini 立功」的具体角色未见报道细节,这一处标
uncertain; - 一句保留 :有技术博客指出,论文对 Collapse 只给了机理,悬崖数值随精度和实现细节浮动,没有统一阈值可以当工程警戒线用。
对工程师的三条自查建议
把话说明白:这个 Bug 对日常训练影响有限------margin 很少长期停在 fp32 悬崖(16.6)之上;但对训练后期高置信度阶段、长尾类别、知识蒸馏、grokking 类研究,它是实打实的梯度失真源。如果你在做这些方向,值得自查:
- 训练日志里损失突跳是否总发生在模型高置信度阶段------翻一下论文的 softplus/expm1/log1p 实现;
- 蒸馏任务里,学生-教师差异很小时损失是否不降反升------这是 Cancellation 的指纹;
- 框架层面,等 PyTorch/JAX 官方合入修复(截至发稿未见官方回应),或直接抄论文的十余行实现。
一个埋了几十年、修起来只要十几行的 Bug,大概是深度学习今年性价比最高的修复了。
参考来源
- A Fix for Softmax and Cross-Entropy(arXiv 2610.31642,论文一手,2026-10-22)--- arxiv.org/abs/2610.31...
- 作者主页版本(含实现代码)--- jonbarron.info/softmaxfix/
- I measured softmax's precision cliff(DEV Community,独立实测复现)--- dev.to/frankchu/i-...
- The 5.5 Cliff(DEV Community,bf16 复现与科普)--- dev.to/danielsamfd...
- 机器之心《PyTorch、JAX都被点名!Softmax曝出隐藏Bug,Gemini立功》(中文报道,2026-10-25)--- news.qq.com/rain/a/2026...
- pytorch/pytorch issue #195684(平台旁证,2026-09-02)--- github.com/pytorch/pyt...
- jax-ml/jax issue #37234(平台旁证)--- github.com/jax-ml/jax/...