大模型一次对话要吃掉多少显存? 为什么有些模型能把缓存压到原来的十分之一,却几乎不掉质量?
上一篇文章我们把 KV Cache 讲透了:模型逐 token 生成,每一步都要回查前面所有 token 的 Key 和 Value,缓存下来重复用。
但缓存这东西,只进不出。
聊得越久、文档塞得越长、同时在线的用户越多,这块显存就涨得越凶。上一篇我们停在"用内存换速度"这笔交易上,这篇文章讲的是------怎么把账压下来。
0x00、先把账算清楚:缓存到底能涨多大
缓存大小有个精确的公式:
单 token 缓存 = 2 × 层数 × KV 头数 × 头维度 × 每元素字节数那个 2 是 K 和 V 各一份。拿 Llama 2 7B 举例:32 层、32 个 KV 头、头维度 128、FP16 精度(2 字节)。
ini
2 × 32 × 32 × 128 × 2 = 524,288 字节 ≈ 0.5 MB一个 token,0.5 MB。 听起来不多,乘上序列长度就完全不一样了:
| 场景 | token 数 | 缓存显存 |
|---|---|---|
| 一次普通问答 | 4,000 | ~2 GB |
| 一份长合同(10 万字) | 100,000 | ~49 GB |
| 32K 上下文 × batch 32 | 1,048,576 | ~512 GB |
表格最后一行是重点:32K 上下文、batch 32,意味着 32 个用户同时在跟模型聊天,光 KV Cache 就要 512 GB。
而一张 A100 总共才 80 GB,模型权重先占掉十几 GB,剩下的空间连这个数的零头都装不下。
不同架构的差距也很大,把几个主流模型摆一起(FP16,单 token):
| 模型 | 层数 | KV 头数 | 头维度 | 单 token 缓存 |
|---|---|---|---|---|
| Llama 2 7B | 32 | 32 | 128 | 512 KB |
| Llama 2 13B | 40 | 40 | 128 | 800 KB |
| Llama 2 70B | 80 | 8 | 128 | 320 KB |
| Llama 3 8B | 32 | 8 | 128 | 128 KB |
| Qwen2.5 7B | 28 | 4 | 128 | 56 KB |
Llama 2 7B 和 Qwen2.5 7B 都是 7B 级别,缓存却差了 9 倍。 差别来自两处:层数从 32 降到 28,KV 头数从 32 降到 4。后者才是主因------这个差别不是优化出来的,是模型结构本身决定的,第 0x03 节会讲。
还有一点经常被忽略:缓存变大不只是占显存,它还拖慢生成。每生成一个 token,模型都要把整个缓存从显存读一遍。缓存越大,读得越慢,token 才吐得越快。
所以省缓存这件事,省的不只是内存,还有速度。
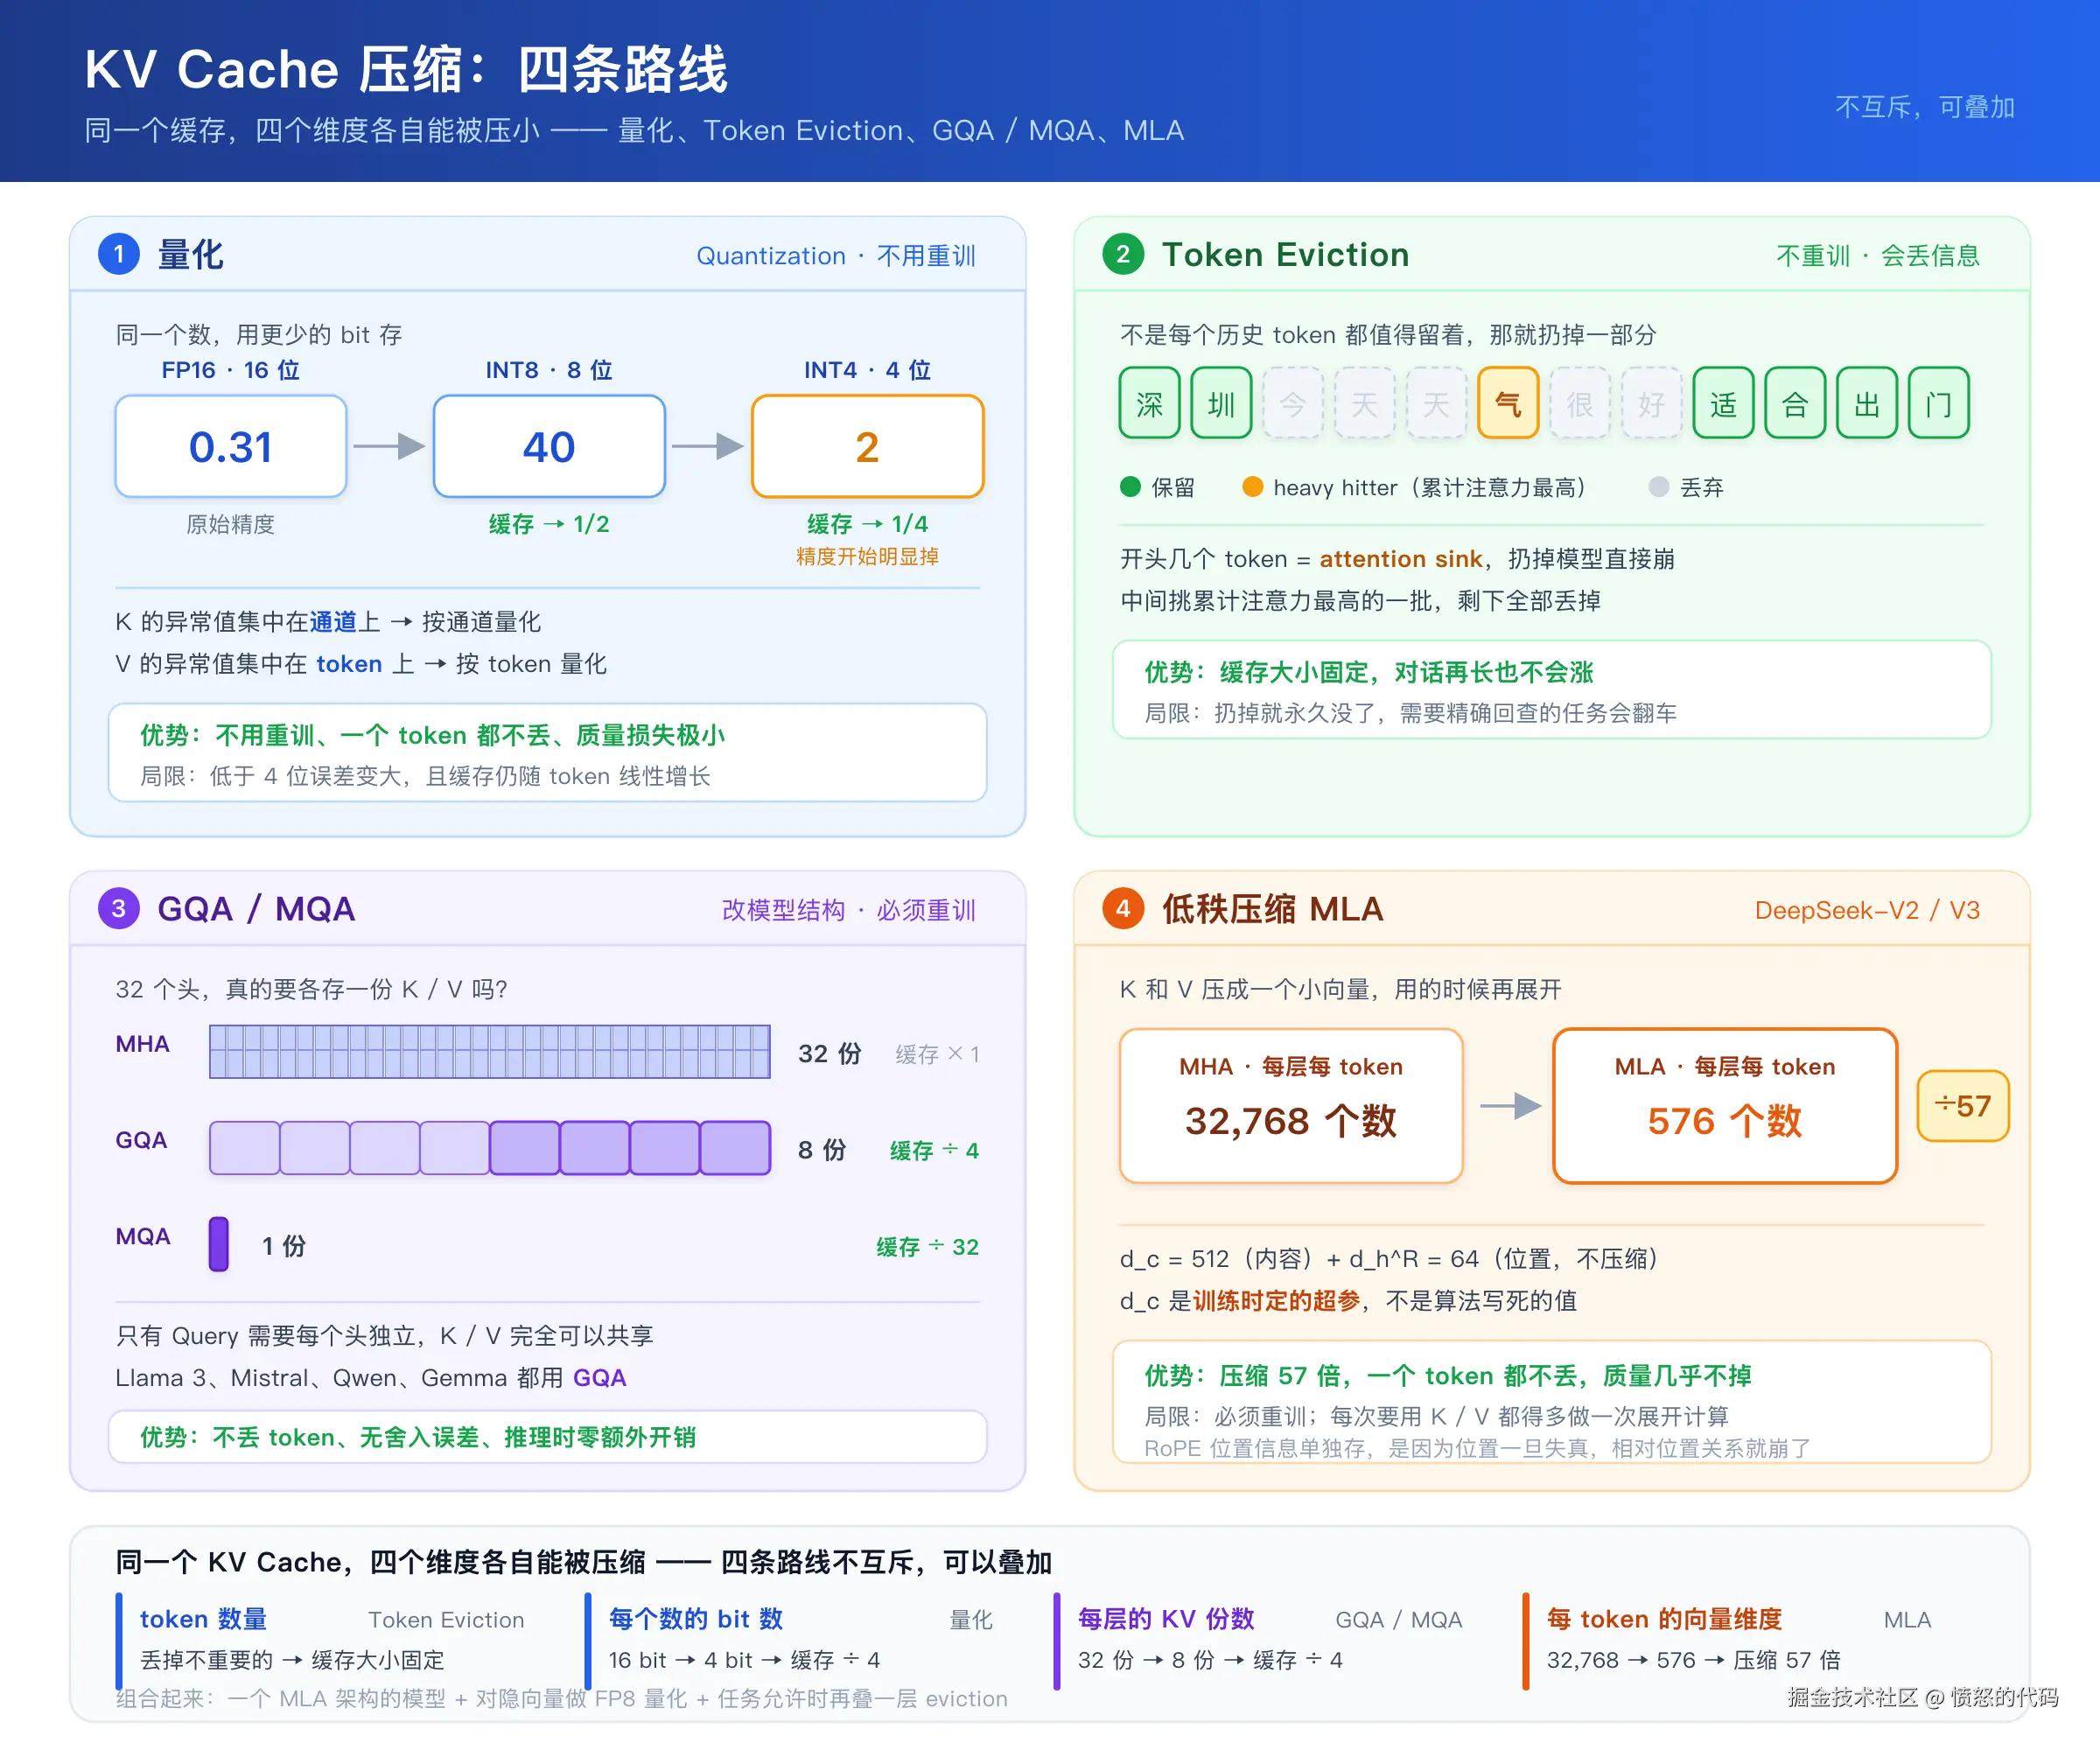
↑ 四条路线动的是缓存的四个不同维度:token 数量、每个数的 bit 数、每层的 KV 份数、每个 token 的向量维度
0x01、路线一:量化 ------ 同样的数,用更少的 bit 存
量化是四条路线里最简单的一条:不丢任何 token,只是每个数少存几位。
举个例子。要记录一个人的身高,可以写 175.4837,也可以写 175。后者占的地方少,对绝大多数用途够用了。量化干的就是这件事。
缓存里每个数默认占 16 位(FP16),量化之后可以压到 8 位、4 位。具体怎么压:
ini
原始:  [0.31, -0.72, 0.05, 0.98]
        ↓ 找出绝对值最大的 0.98,除以 127 得到 scale
scale: 0.0077
        ↓ 每个数除以 scale 后四舍五入到整数
量化:  [40, -93, 6, 127]
每个数现在都能塞进 8 位(-127 到 127)。scale 单独存一份,反量化的时候乘回去就行。
- 16 位 → 8 位:缓存变成一半
- 16 位 → 4 位:缓存变成四分之一
这条路线最省事:可以在推理时动态加上去,不用重训模型,一个 token 都不丢,质量损失也很小。
但 K 和 V 不能一视同仁
这是 KIVI 这类方法最关键的洞察:Key 和 Value 的数值分布完全不一样,用同一种量化方式必然有一边吃亏。
- Key 的异常值集中在"通道"上 。某个特定维度(比如第 3 维)在几乎所有 token 上都带着一个很大的数。用统一的 scale 量化,这个大数会把其他维度压成 0,误差爆炸。解决办法是按通道量化------每个维度单独算自己的 scale。
- Value 的异常值集中在"token"上 。某一个 token 的 Value 整体偏大。解决办法是按 token 量化------每个 token 单独算 scale。
这个细节不讲的话,读者很容易以为"量化就是把数除以一个常数",实际工程里远比这复杂。
也有它的天花板
低于 4 位之后,四舍五入的误差开始显著,模型答案质量肉眼可见地下降。而且缓存依然随 token 线性增长------压了 4 倍还是 4 倍,序列继续变长还是顶不住。
关于量化的数学细节,这里不展开。
感兴趣可参考:《浅析模型量化的数学原理》讲清了 scale、零点等这些到底怎么推的;《模型量化为什么几乎不损失精度:误差的四道防线》讲的是为什么 4-bit 还能保住质量------误差是怎么被四层机制一层层挡住的。
量化本身的原理搞懂了,KV Cache 量化就只是换个场景而已。
0x02、路线二:Token Eviction ------ 把不重要的 token 踢出去
第二条路线思路很直接:不是每个历史 token 都值得留在缓存里,那就扔掉一部分。
哪些 token 不重要
模型在算注意力的时候,注意力权重是极度不均匀的------绝大多数 token 分到的注意力接近于零,注意力集中在少数几个 token 上。
既然如此,把那些几乎没人看的 token 留在缓存里,纯属浪费。
怎么判断谁重要
有个现成的办法:注意力分数本身就是信号。
每次生成新 token,模型都会算出一组注意力分数。我们给每个历史 token 维护一个累加值,谁的累计注意力高,谁就是"重要人物"。
这个思路就是 H2O(Heavy Hitter Oracle,重击预言机)------把高频被查的 token 留在缓存里。
淘汰规则怎么定
有了 H2O,规则已经能用上,但还差一条:
- 永远保留最近的 token(比如最近 512 个)。近处的内容几乎总是有用的。
- 从较老的 token 里,选出累计注意力最高的一批(heavy hitters)。
- 剩下的全部丢掉。
这样缓存就固定在一个上限,比如 1,000 个 token,对话再长也不会涨。
开头几个 token 不能扔
这是 StreamingLLM 挖出来的东西,也是最容易被忽略的一条。
文本最前面的几个 token,无论内容是什么,都会莫名其妙地收到极高的注意力。 就算第一个 token 只是个毫无意义的起始标记也一样。
原因在于:注意力权重是要分摊的,所有历史 token 的权重加起来恒等于 1。当当前上下文中没有几个 token 真的有用时,模型这份"注意力预算"总得花到某个地方去,于是它学会了往开头几个 token 上倒。
这几个 token 就成了一个注意力汇聚池(attention sink)。
后果很严重:一旦把开头几个 token 踢掉,模型输出会直接崩掉,变成胡言乱语。
所以最终规则是:永远保留开头几个 token + 永远保留最近的 token + 中间部分挑 heavy hitter。
这条路线的软肋
扔掉的就是永久扔掉了。 用户后面突然问起第 40 页里提到的那个电话号码,模型已经想不起来了。
所以它适合聊天、摘要这类"不需要精确回查"的场景;碰到"从这份 10 万字文档里找出第 40 页的电话"这种任务,token eviction 就会翻车。
0x03、路线三:GQA / MQA ------ 多个注意力头共用一份 K/V
前两条路线都是在模型训完之后 动缓存。第三条不一样:它改的是模型结构本身,必须在训练前就定下来。
32 个头真的需要 32 份 K/V 吗
每层有多个注意力头,每个头有自己的 Key 和 Value。32 个头,就是 32 套。
但研究发现:很多头的 Key 和 Value 高度相似,共享一份就够用了。真正需要每个头独立的是 Query。
打个比方。图书馆里坐着 32 个学生,每个人心里的问题都不一样,这是 Query。但书架上的书、书脊上的标签、书里的内容,没必要复印 32 份------大家看同一排书架就好,区别只在于各自在找什么。
两种做法
MQA(多查询注意力,Multi-Query Attention) 所有头共用同一份 K 和 V。32 个头 → 1 套。缓存缩到 1/32。
GQA(分组查询注意力,Grouped-Query Attention) 头分成若干组,组内共用。32 个头分成 8 组 → 8 套。缓存缩到 1/4。
MQA 压得更狠但质量掉得多一些,GQA 是那个"省了大部分内存、几乎不掉质量"的平衡点。所以 Llama 3、Mistral、Gemma、Qwen 这些现代模型基本都上了 GQA。
回到 0x00 那张表:Llama 2 7B 是 32 个 KV 头(512 KB/token),Qwen2.5 7B 只有 4 个(56 KB/token)------差的不是优化,是架构。
优点和限制
- 优点 :不丢 token、没有舍入误差,而且省下来的比例是内置在模型里的,推理时零额外开销。
- 限制 :必须重训。没法给一个训好的模型直接套上 GQA。缓存也仍然随 token 增长,只是长得慢一些。
0x04、路线四:低秩压缩(MLA)------ 只存一个小的隐向量
第四条路线是压缩得最狠的,代表是 MLA(Multi-Head Latent Attention,多头潜在注意力),由 DeepSeek-V2 提出,DeepSeek-V3 继续沿用。
思路:存压缩包,而不是原件
低秩的意思是:同样一份信息,可以用少得多的数字装下。
还是发照片的例子。原图太大,就发个压缩包,朋友想看的时候再解压。包小,传得快,解开后跟原图几乎一样。
MLA 的做法是:不存每个 token 完整的 K 和 V,而是存一个很小的"隐向量"(latent vector)------也就是 K 和 V 的压缩形式。等模型真正需要 K、V 的时候,再用一个训练时学好的小矩阵把它展开回去。
省了多少
MLA 的缓存大小有个通用公式(l 是层数):
scss
每 token 缓存元素数 = (d_c + d_h^R) × ld_c 是隐向量的维度,d_h^R 是那块 RoPE 位置信息的维度(后面会讲为什么要单独拆出来)。
拿 DeepSeek-V2 的真实配置来看(128 个头、头维度 128、60 层):
| 机制 | 每 token 缓存元素数 | 算式 |
|---|---|---|
| MHA | 1,966,080 | 2 × 128 × 128 × 60 |
| GQA(8 组) | 122,880 | 2 × 8 × 128 × 60 |
| MLA | 34,560 | (512 + 64) × 60 |
34,560 ÷ 1,966,080 ≈ 1/57。 论文里的说法是:MLA 的缓存量相当于"只有 2.25 个组的 GQA",但效果比完整 MHA 还强。
拆到每一层看更直观:MHA 每层每 token 存 2 × 128 × 128 = 32,768 个数,MLA 只存 (512 + 64) = 576 个。
这里的 d_c = 512 是 DeepSeek 训练时定的一个超参,不是算法写死的值。它本质上是个权衡:
d_c越小,缓存省得越多,但潜向量的"容量"有限,关键信息装不下,训练就会掉点。d_c越大,装得下,但省得就没那么狠了。
DeepSeek 在 512 上找到了质量与显存的平衡点。
Query 也有一个自己的压缩维度 d_c' = 1536,比 d_c 大得多------因为 query 压缩得再狠也不会占缓存,它每个 token 都要现算,压狠了只会白白掉质量。多出来的那些维度是纯算力换来的。
MLA 的压缩比不是固定的,它由 d_c 决定,不同模型会选不同的值。
漂亮的地方:几乎不掉质量
一般的"压缩再解压"思路总让人担心:压完再展开,信息是不是丢了?
MLA 厉害就厉害在------模型从训练开始就是带着这个压缩机制学的。它在训练过程中就学会了"只把有用的信息放进那个隐向量里",重要信息不会丢。
有研究甚至发现,MLA 的生成质量在某些任务上比完整的 MHA 还略好一点------因为"被迫取舍"本身就是一种正则化。
RoPE 解耦:位置信息为什么不能压
位置编码 RoPE 是加在 Key 上的。K 被压进隐向量之后,位置信息会不会一起丢?
DeepSeek 的处理办法是把位置信息和内容信息拆开 :内容走压缩的隐向量 d_c,位置信息另外用 d_h^R = 64 维原样存,不参与压缩。
这一小块才是真正不能压的部分 ------位置信息一旦失真,注意力机制依赖的相对位置关系就崩了。代价是这部分压缩不掉,所以 MLA 的缓存公式是 (d_c + d_h^R) 而不是单纯的 d_c。
代价
- 必须重训,不能给现成模型打补丁。
- 每次要用 K/V 都得多做一次展开计算,虽然是矩阵乘法很便宜,但确实有额外开销。
0x05、四条路线横向对比
| 量化 | Token Eviction | GQA / MQA | 低秩压缩 MLA | |
|---|---|---|---|---|
| 怎么省 | 每个数少存几位 | 少存 token | 少存几套 K/V | 每个 token 存个小向量 |
| 要重训吗 | 不用 | 不用 | 要 | 要 |
| 丢 token 吗 | 不丢 | 丢 | 不丢 | 不丢 |
| 典型压缩比 | 2× ~ 4× | 缓存大小固定 | 4× ~ 8× | 10× ~ 60×(由 d_c 决定) |
| 质量损失 | 很小 | 看任务 | 很小 | 几乎没有 |
| 代表技术 | KIVI | H2O、StreamingLLM | GQA、MQA | MLA (DeepSeek) |
这四条路线不是互斥的,可以叠加使用。
比如:模型本身用 MLA 架构 → 对压缩后的隐向量再做 FP8 量化 → 任务允许的话再叠一层 token eviction。三板斧下去,缓存能压到原始尺寸的几十分之一。
DeepSeek-V2 就是这么干的:MLA 之外,权重转成 FP8 存储,KV Cache 量化到平均 6 bit 。论文里"减少 93.3% KV Cache"这个数字,是拿部署后的 DeepSeek-V2 和当时的 DeepSeek 67B 比的,包含量化等一整套优化,不是纯 MLA 架构的功劳。看单个技术时别把它当成 MLA 的单独收益。
PagedAttention 不是 KV Cache 压缩技术
- PagedAttention 解决的是"已有的显存别浪费"------用操作系统管理内存的方式(分页)来分配和回收缓存块,避免预留一大块连续显存造成的碎片。
- KV Cache 压缩 解决的是"缓存本身变小"。
一个管"怎么放",一个管"放多少"。vLLM 里这两套机制是同时存在的。
0x06、怎么选:按场景
| 场景 | 建议 |
|---|---|
| 手上是个训好的模型,想省点显存 | 量化。最容易加,收益立竿见影 |
| 长对话、无休止的流式输入,显存必须封顶 | Token Eviction + Attention Sink。唯一能让缓存大小真正不随长度增长的办法 |
| 需要精确回查长文档里的细节 | 别用 Token Eviction,用量化,或者直接上带 GQA/MLA 的模型 |
| 正在训练新模型 | GQA 或 MLA 直接写进架构,这是唯一能在训练阶段就省下缓存的办法 |
| 显存和速度都要极限 | 组合拳:MLA/GQA 架构 + 量化 + 必要时 eviction |
一句话总结取舍:
- 要"不丢东西" → 量化、GQA、MLA
- 要"大小封顶" → 只能靠 Token Eviction
- 要"最省" → MLA + 量化
- 要"最省事" → 量化
0x07、总结
KV Cache的大小 =2 × 层数 × KV 头数 × 头维度 × 序列长度 × 精度,长上下文下能到几十上百 GB。- 缓存大不只是占显存,每生成一个 token 都要把整个缓存读一遍,所以它同时拖慢生成。
- 量化:同样的数用更少的 bit 存,K 按通道、Value 按 token 量化,2×~4×,不用重训。
- Token Eviction:只留 recent + heavy hitter + 开头几个 attention sink,缓存大小固定,代价是可能忘掉细节。
- GQA / MQA:多个注意力头共享 K/V,必须在训练时定,Llama 3、Mistral、Qwen 都用 GQA。
- 低秩压缩 MLA:只存一个小的隐向量,用时再展开,DeepSeek-V2 提出,压缩 10 倍以上几乎不掉质量。
- 四条路线可以叠加,PagedAttention 管"怎么放",压缩技术管"放多少",两者不冲突。
KV Cache 压缩解决的是"记得住但花太多钱"的问题。上一篇的 KV Cache 讲清了它是什么、为什么必须存在,这一篇讲的是怎么让它变便宜------这两块凑齐了,LLM 推理优化的大门才算真正推开。