写在前面
对于前端同学来说,在线文档可以算是前端技术天花板之一了。在我初入前端的时候,我就觉得这个东西可望而不可即,时常想加入那样的团队,但又害怕自己水平有限。近几年有幸参与过文档的一些开发工作,所以想借此机会写点东西留个痕。虽然现在 AI 来了,但我还是得坚持手搓✍🏻。
我是第一次接触文档才知道 Block 架构这种东西的,所以如果你是第一次听到 Block 架构也很正常,毕竟一般情况下咱也用不上😄,不过多知道一点能让你下次更好的装下13。比如最近我们部门有个很漂亮美丽善良大方的妹子问我说她之前看了一个什么下拉列表优化的文章,问我有什么好优化的😦?我说确实,这个大部分情况下是没什么好优化的,但是一旦数据量大了,问题就出来了,可能会卡死🫠,因为元素太多了,浏览器一时半会渲染不过来。并且往大了想,要是列表的每一项内容不仅限于文本,可以是富文本和图片等其他格式,那是不是就和文档很像了,然后我就向她推荐了这篇文章,也不知道她看没看,哈哈哈哈哈哈哈。
Block 是啥
这篇文档我们就直接开门见山说下什么是 Block 架构。让我们先来看看下面这张图: 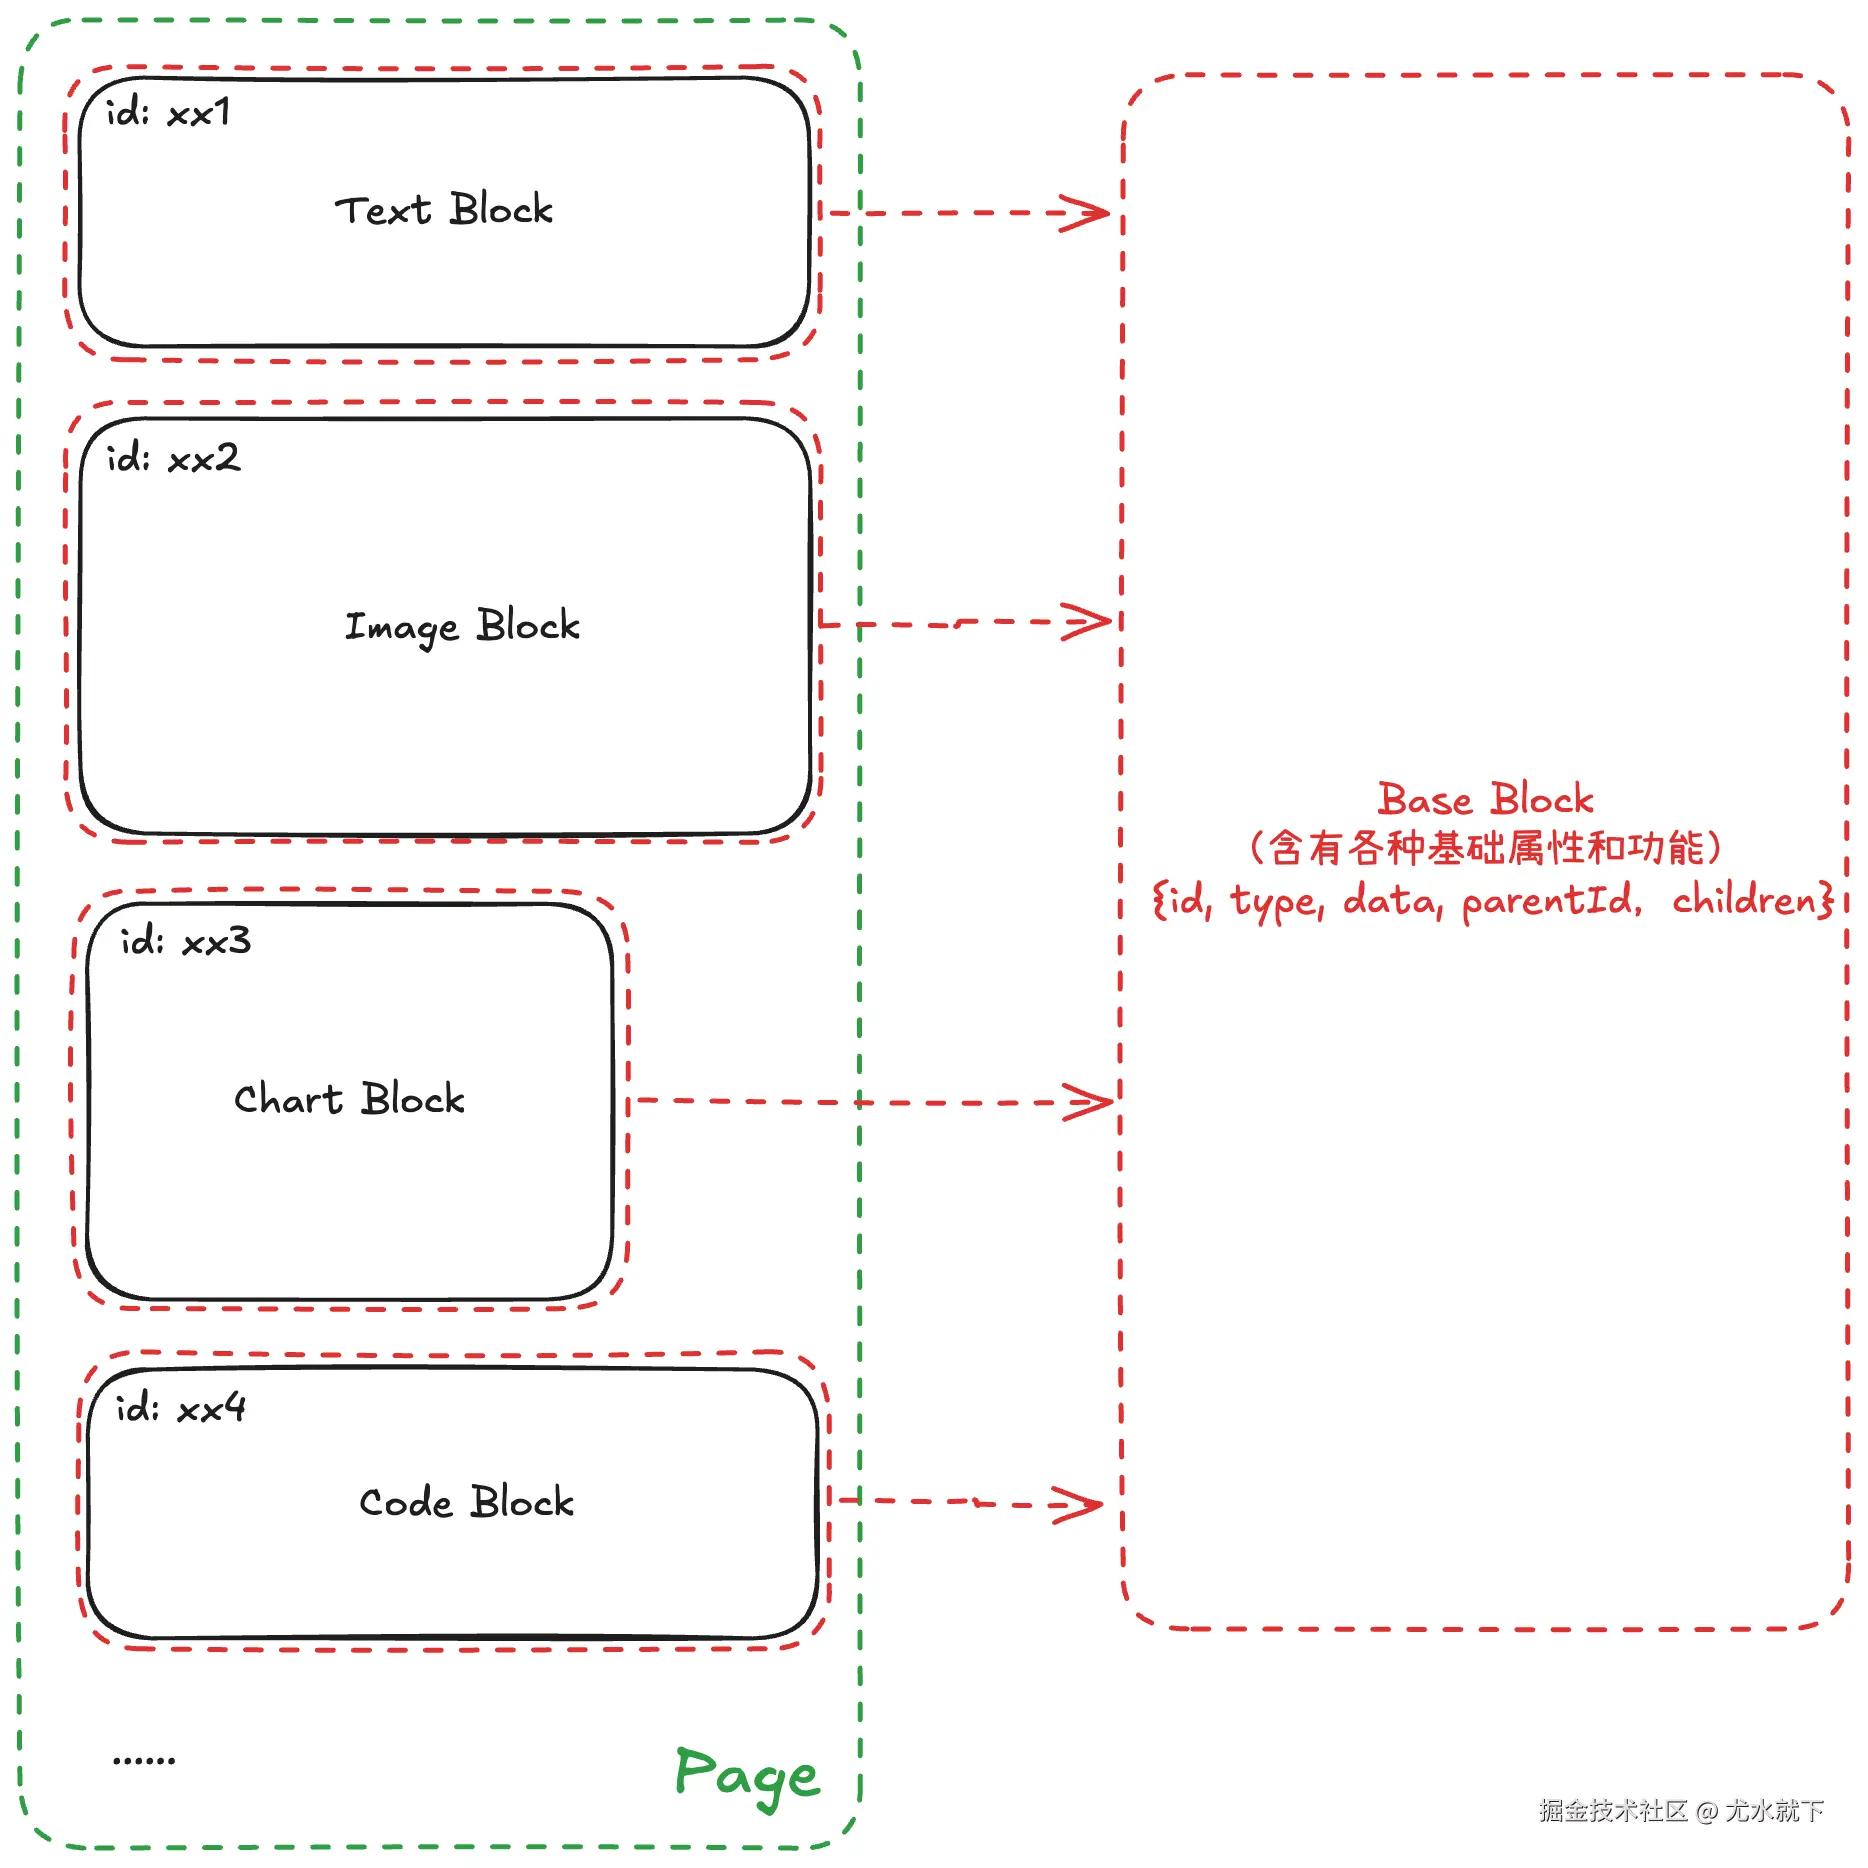 上面就是一篇文档的基础样子,一篇文档我们称之为一个 Page,一个 Page 有多个 Block 组成(文本/图片/表格/图表/代码/第三方组件等等都可以看做是一个 Block)。凭直觉看,它的基本数据结构大概长下面这个样子:
json
{
  "type": "page",
  "children": [
    { "type": "text", "text": "这是文本啊" },
    { "type": "image", "url": "https://example.com/xxx.png" },
    { "type": "chart", "data": "{ xxx: 自定义数据 }" },
    { "type": "code", "data": "{ xxx: 自定义数据 }" },
  ]
}
如果把整篇文档只当成一棵巨大的嵌套 json,显然是不太合理的,会遇到很多问题,这里简单列举几个:
- 多人协同时,怎么精确描述"谁改了哪一块"?
- 修改深层节点,怎么在一棵大树里定位,移动节点时又该怎么处理?
- 一篇文档有几万个 block 只能一次性加载和渲染吗?
- 文档数据过大,如何进行压缩?
- 文档还没下载完,为什么首屏已经能看,甚至已经能编辑了?
- 同一份内容出现在多个位置时,只能复制数据吗?
- 每输入一个字,都会重新渲染整篇文档?
- 图片加载后高度变了,为什么页面不会突然跳走?
- 如何保证协同时候的数据一致性和稳定性?
- ...
这些问题背后,藏着数据存储、运行时树、富文本输入、协同编辑、虚拟布局、插件扩展等一整套系统。话不多说,咱们直接开始优化 🛫。
数据拍平
虽然上面的大 json 数据很符合直觉,但如果数据过大会导致首屏加载慢,需要等到整个 json 到了才能解析,你也不好拆开解析;如果你改了某个嵌套较深的 block,修改深层节点就会很麻烦;协同的时候如果改了同一个 block 或者父子 block,这种情况不仅不好处理还容易冲突,所以让我们先来简单改改这个数据结构,变成下面这样👇🏻:
json
{
  "root": "page",
  "recordMap": { // 平铺每个 block,这点很重要,record 是数据实体
    "page-1": {
      "id": "page-1",
      "type": "page",
      "children": ["text-1", "image-1", "text-2"] // 表达层级嵌套和顺序关系
    },
    "text-1": {
      "id": "text-1",
      "type": "text",
      "parentId": "page-1",
      "text": "第一段"
    },
    "image-1": {
      "id": "image-1",
      "type": "image",
      "parentId": "page-1",
      "url": "https://example.com/xxx.png"
    },
    // ...
  }
}
和之前的有什么区别呢?我们给了每个 block 一个稳定 id,并把所有 block 都放进了一个 recordMap(这个recordMap 是可拆的)。大白话讲就是把文档树拆成一张张卡片,再用 id 把它们串起来。
| 收益 | 为什么 |
|---|---|
| 局部更新 | 修改一个 Block,只需要更新一条 Record 数据。 |
| 独立协同 | 每个编辑操作可以精确指向某个 Record 数据的某条路径。 |
| 分页加载 | 不必等整棵树到齐,可以分批补充 Record 数据。 |
| 稳定移动 | 移动 Block 主要修改父节点的 children 顺序。 |
| 内容复用 | 同一份 Record 数据可以共享到多个运行时位置。 |
当然,id 和父子引用会增加一些存储开销。不过这是一种空间换能力的典型实现:换来了离线创建、细粒度协同、局部缓存和稳定引用。
现在我们就能来解答首屏加载的问题了。如果 Page 下面有一万个直属 Block,那么 Page 的 children 通常就会保存这一万个 id,并维持顺序。但这不等于首页要同时返回一万份完整的 Block 数据。常见做法是结构先到、内容后到,比如下面这样:
js
// 大文档一堆 Block
Page.children = [A, B, C, ... , Z]

// 实际加载
1、首页真实数据:A、B、C,那么就只会先加载 ABC 这三块数据
2、暂未到达:D~Z,先建立 Pending Block
3、后续分页:逐步把 Pending Block 替换成真实数据
注意,Page 只保存直属孩子。假如 A 是容器,A 的后代由 A 自己的 children 保存,不会再重复塞进 Page。
接下来我们可以把 Block 分为内外两部分,Block 内部主要管理自己的组件数据和渲染,Block 外部主要由 Page 来决定在文档的位置。当然 Block 自身其实还有个通用容器,用来处理一些 Block 的公共属性和方法,比如 Block 的宽高大小和拖拽。所以加载一份文档,Block 外部信息和容器自身宽高这两个基础信息是必要的,至于 Block 内部的数据和渲染就可以用上懒加载了。也就是说只有当 Block 出现在视口附近的时候才需要动态去拉取 Block 内部的数据,包括跳转到页面的其他地方也是一样的逻辑。这样一来文档本身就很轻量了,Block 内部的数据才是大头。
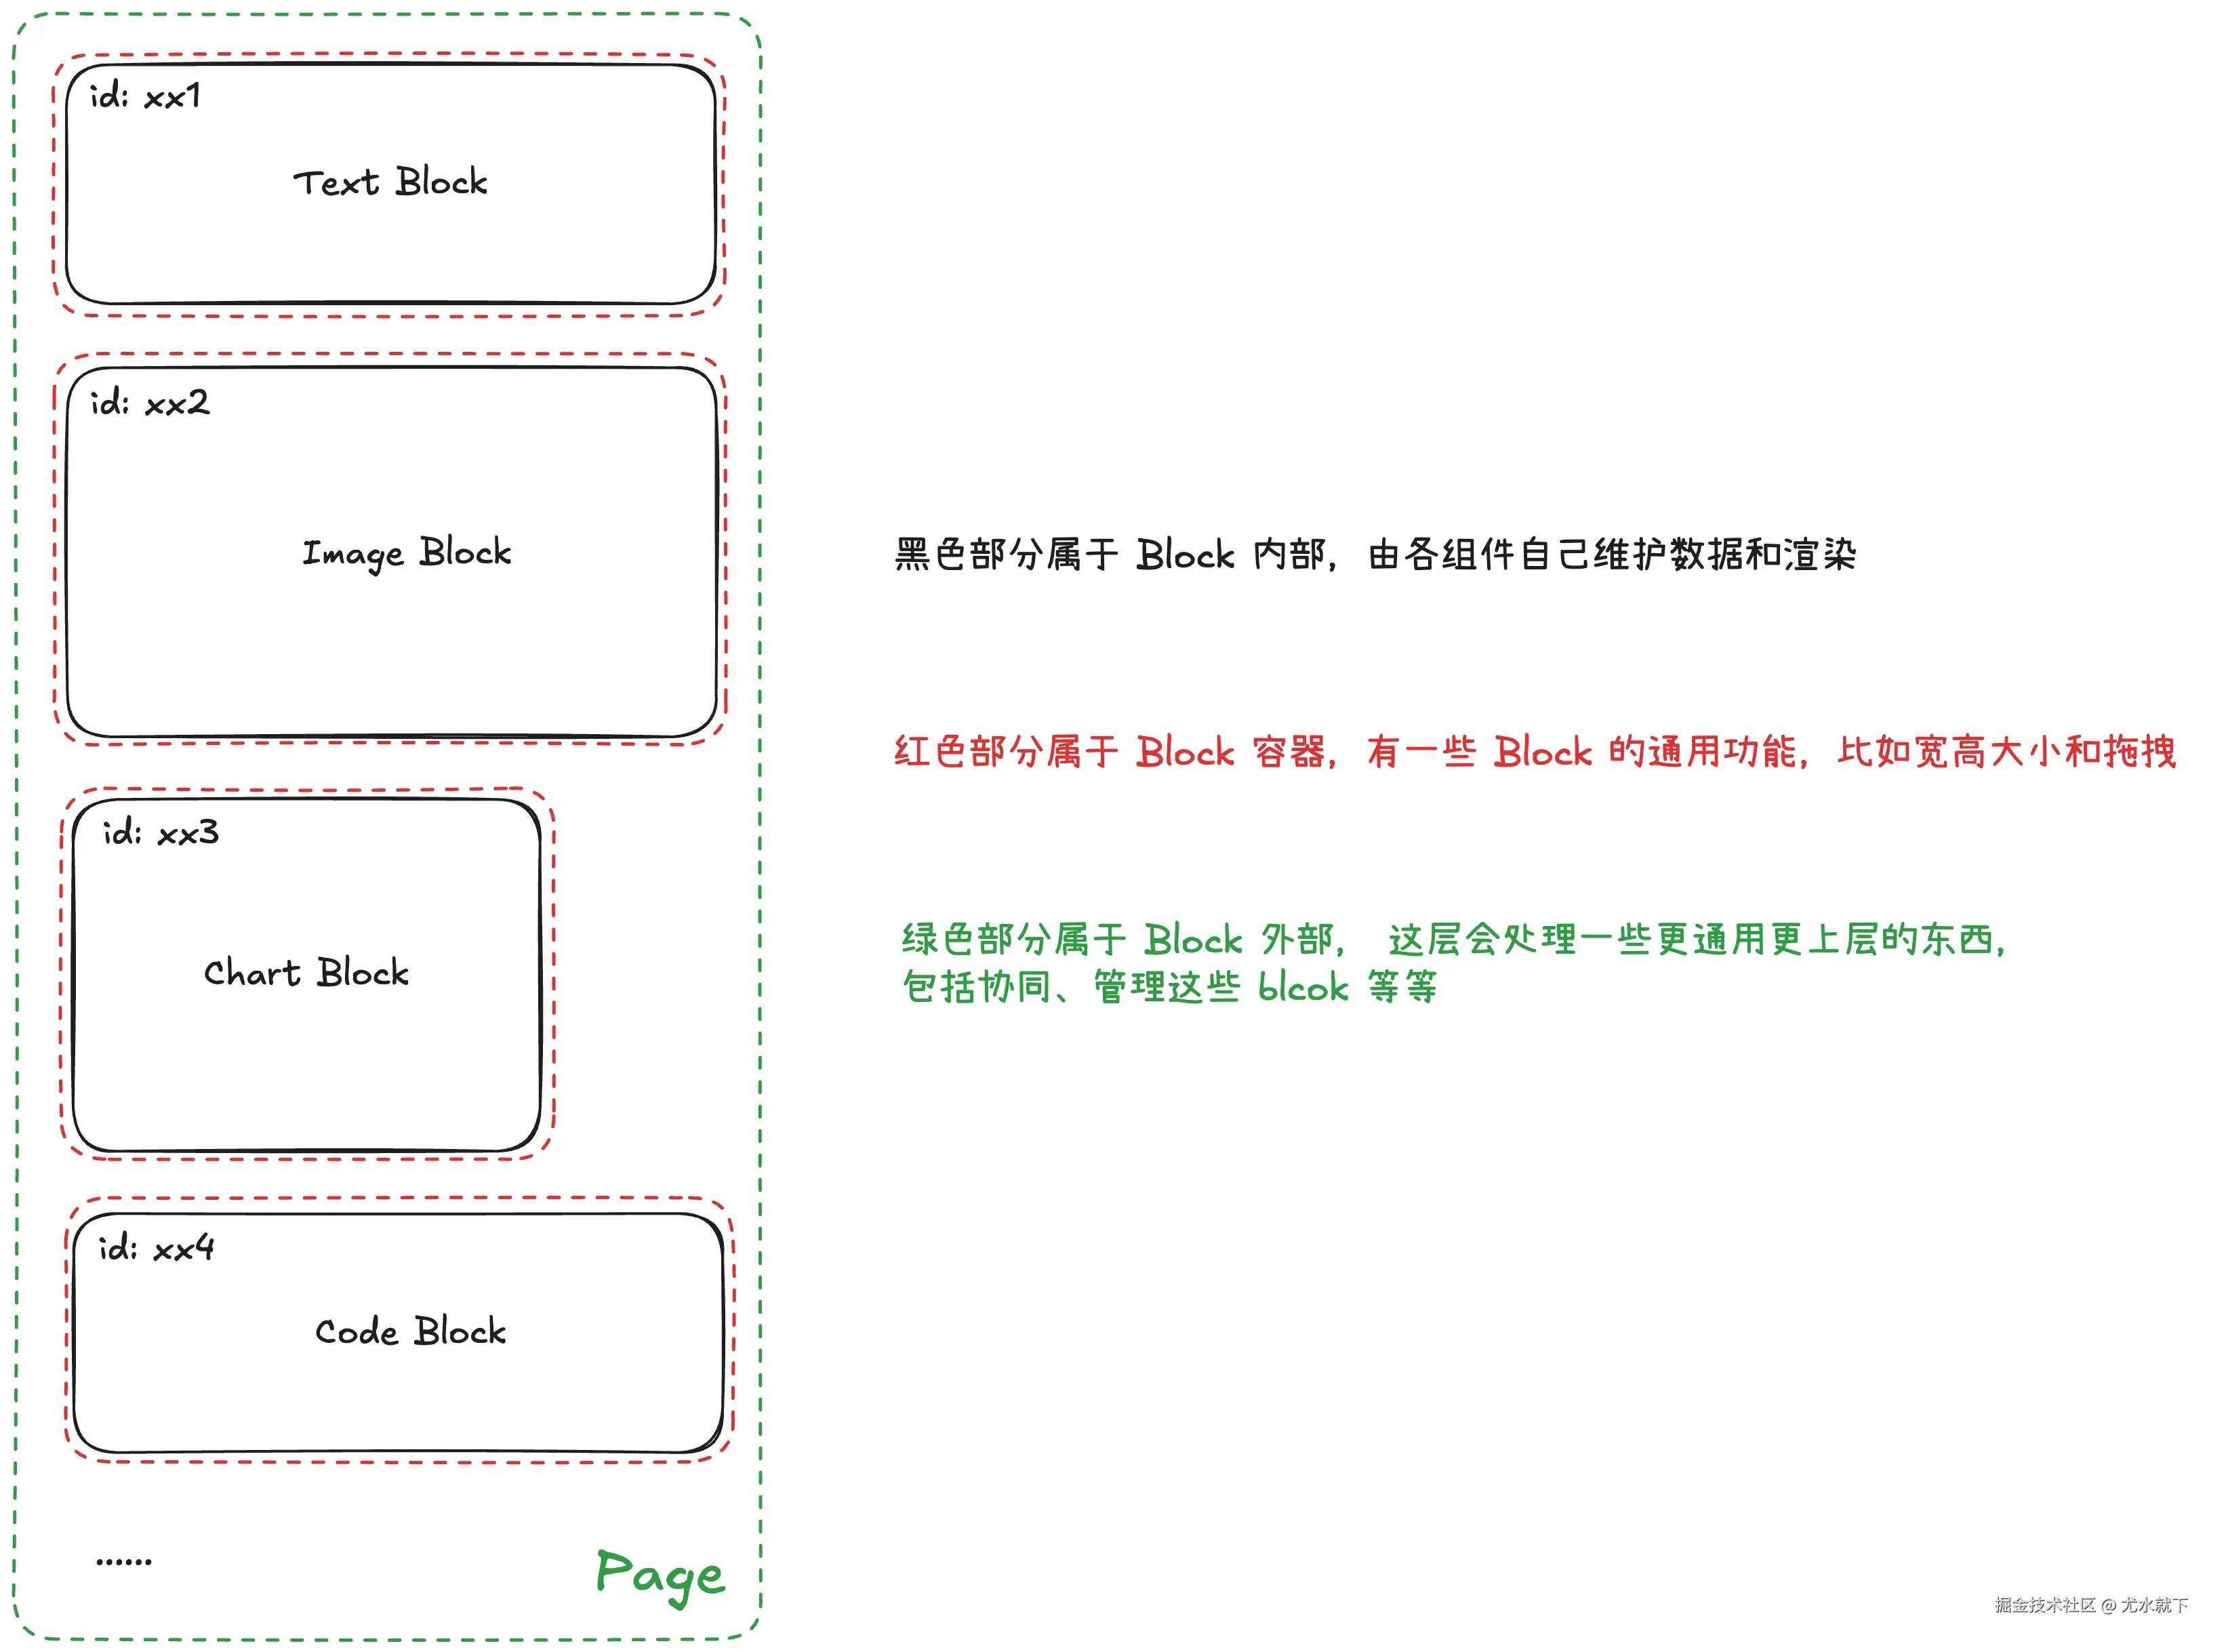
通常在文档加载的时候,我们会先请求文档的快照数据,然后解析文档快照数据到内存态,因为有了每个 Block 的顺序和大小,就可以直接进行页面布局了,虽然 Block 里面是空的,但整体框架已经有了,后面就是各个 Block 在必要的时候往里填充数据和渲染就行,而不影响页面其他部分👍🏻。
这里顺便简单带过一下,一个重型 Block Table 的数据结构长什么样,因为对于 Table 来说有些特殊,它不依赖 children 来描述表格内容,而是像下面这个样子:
js
{
    "type": "table",
    "rows": ["r1", "r2"], // 行
    "cols": ["c1", "c2"], // 列
    "cell": {
        // 通过 blockId 找对具体单元格数据
        // merge 表示合并单元格信息
        "r1c1": { "blockId": "cell_A", "merge": { "row": 1, "col": 1 } },
        "r1c2": { "blockId": "cell_B", "merge": { "row": 1, "col": 1 } },
        "r2c1": { "blockId": "cell_C", "merge": { "row": 1, "col": 1 } },
        "r2c2": { "blockId": "cell_D", "merge": { "row": 1, "col": 1 } },
    }
}
其实核心和其他 Block 是一样的,就是把具体单元格数据摘出来。
分块加载
有了上面的数据结构做支撑,我们就可以对大文档数据进行按需/分块/批量加载了。对于服务端来说,每次只需要返回一部分数据即可,不需要全量推送,比如下面这样:
js
{
  "records": { // 只读取 20 个 block 数据
    "block-1": {},
    "block-2": {},
    // ...
    "block-20": {},
  },
  "hasMore": true,
  "cursor": "next-cursor-token" // 方便获取下一页信息
}
上面的 cursor 相当于指向下一条数据的指针,客户端不用解析 cursor,只要原样回传下一次请求即可:
js
请求文档
→ 返回第一页 + hasMore=true + cursor-2
→ 请求 cursor-2
→ 返回第二页 + hasMore=true + cursor-3
→ 请求 cursor-3
→ hasMore=false
这时候你就会想到🤔,要是有一个 block 的数据量过于大怎么办,它会拖垮该请求所包含的其他 block。其实处理方式很简单粗暴,过滤掉就好了,服务端在返回的时候先不返回这些复杂 block 的数据,但会返回另一个字段,比如 ignore_blocks,表示此次忽略掉的一些重型 block,然后由前端单独拉取这块重型数据就可以了。
刚刚说的都属于数据的分块拉取,实际上这些数据拿到后并不会立马转化为内存态。因为有些数据也不一定用上,所以我们可以先将必要的数据转成内存态,其余的数据在空闲时间或跳转到目标区域时再处理。记住:
- 已下载的数据,不等于已应用到内存
- 已应用到内存的数据,不等于已渲染
虚拟滚动
这是这个漂亮妹子问的最细的地方了。
众所周知,要是页面有一万个要渲染的组件,我们是不可能全部展示的,所以就出现了虚拟滚动的概念。虚拟滚动的核心很简单,就是只展示可视区附近的组件,其余的地方用空组件代替就行,随着用户不断滚动,就会重新计算需要在可视区展示的组件重新渲染。长文档也是一样的思路,具体让我们来看看下面这张图理解下👇🏻:
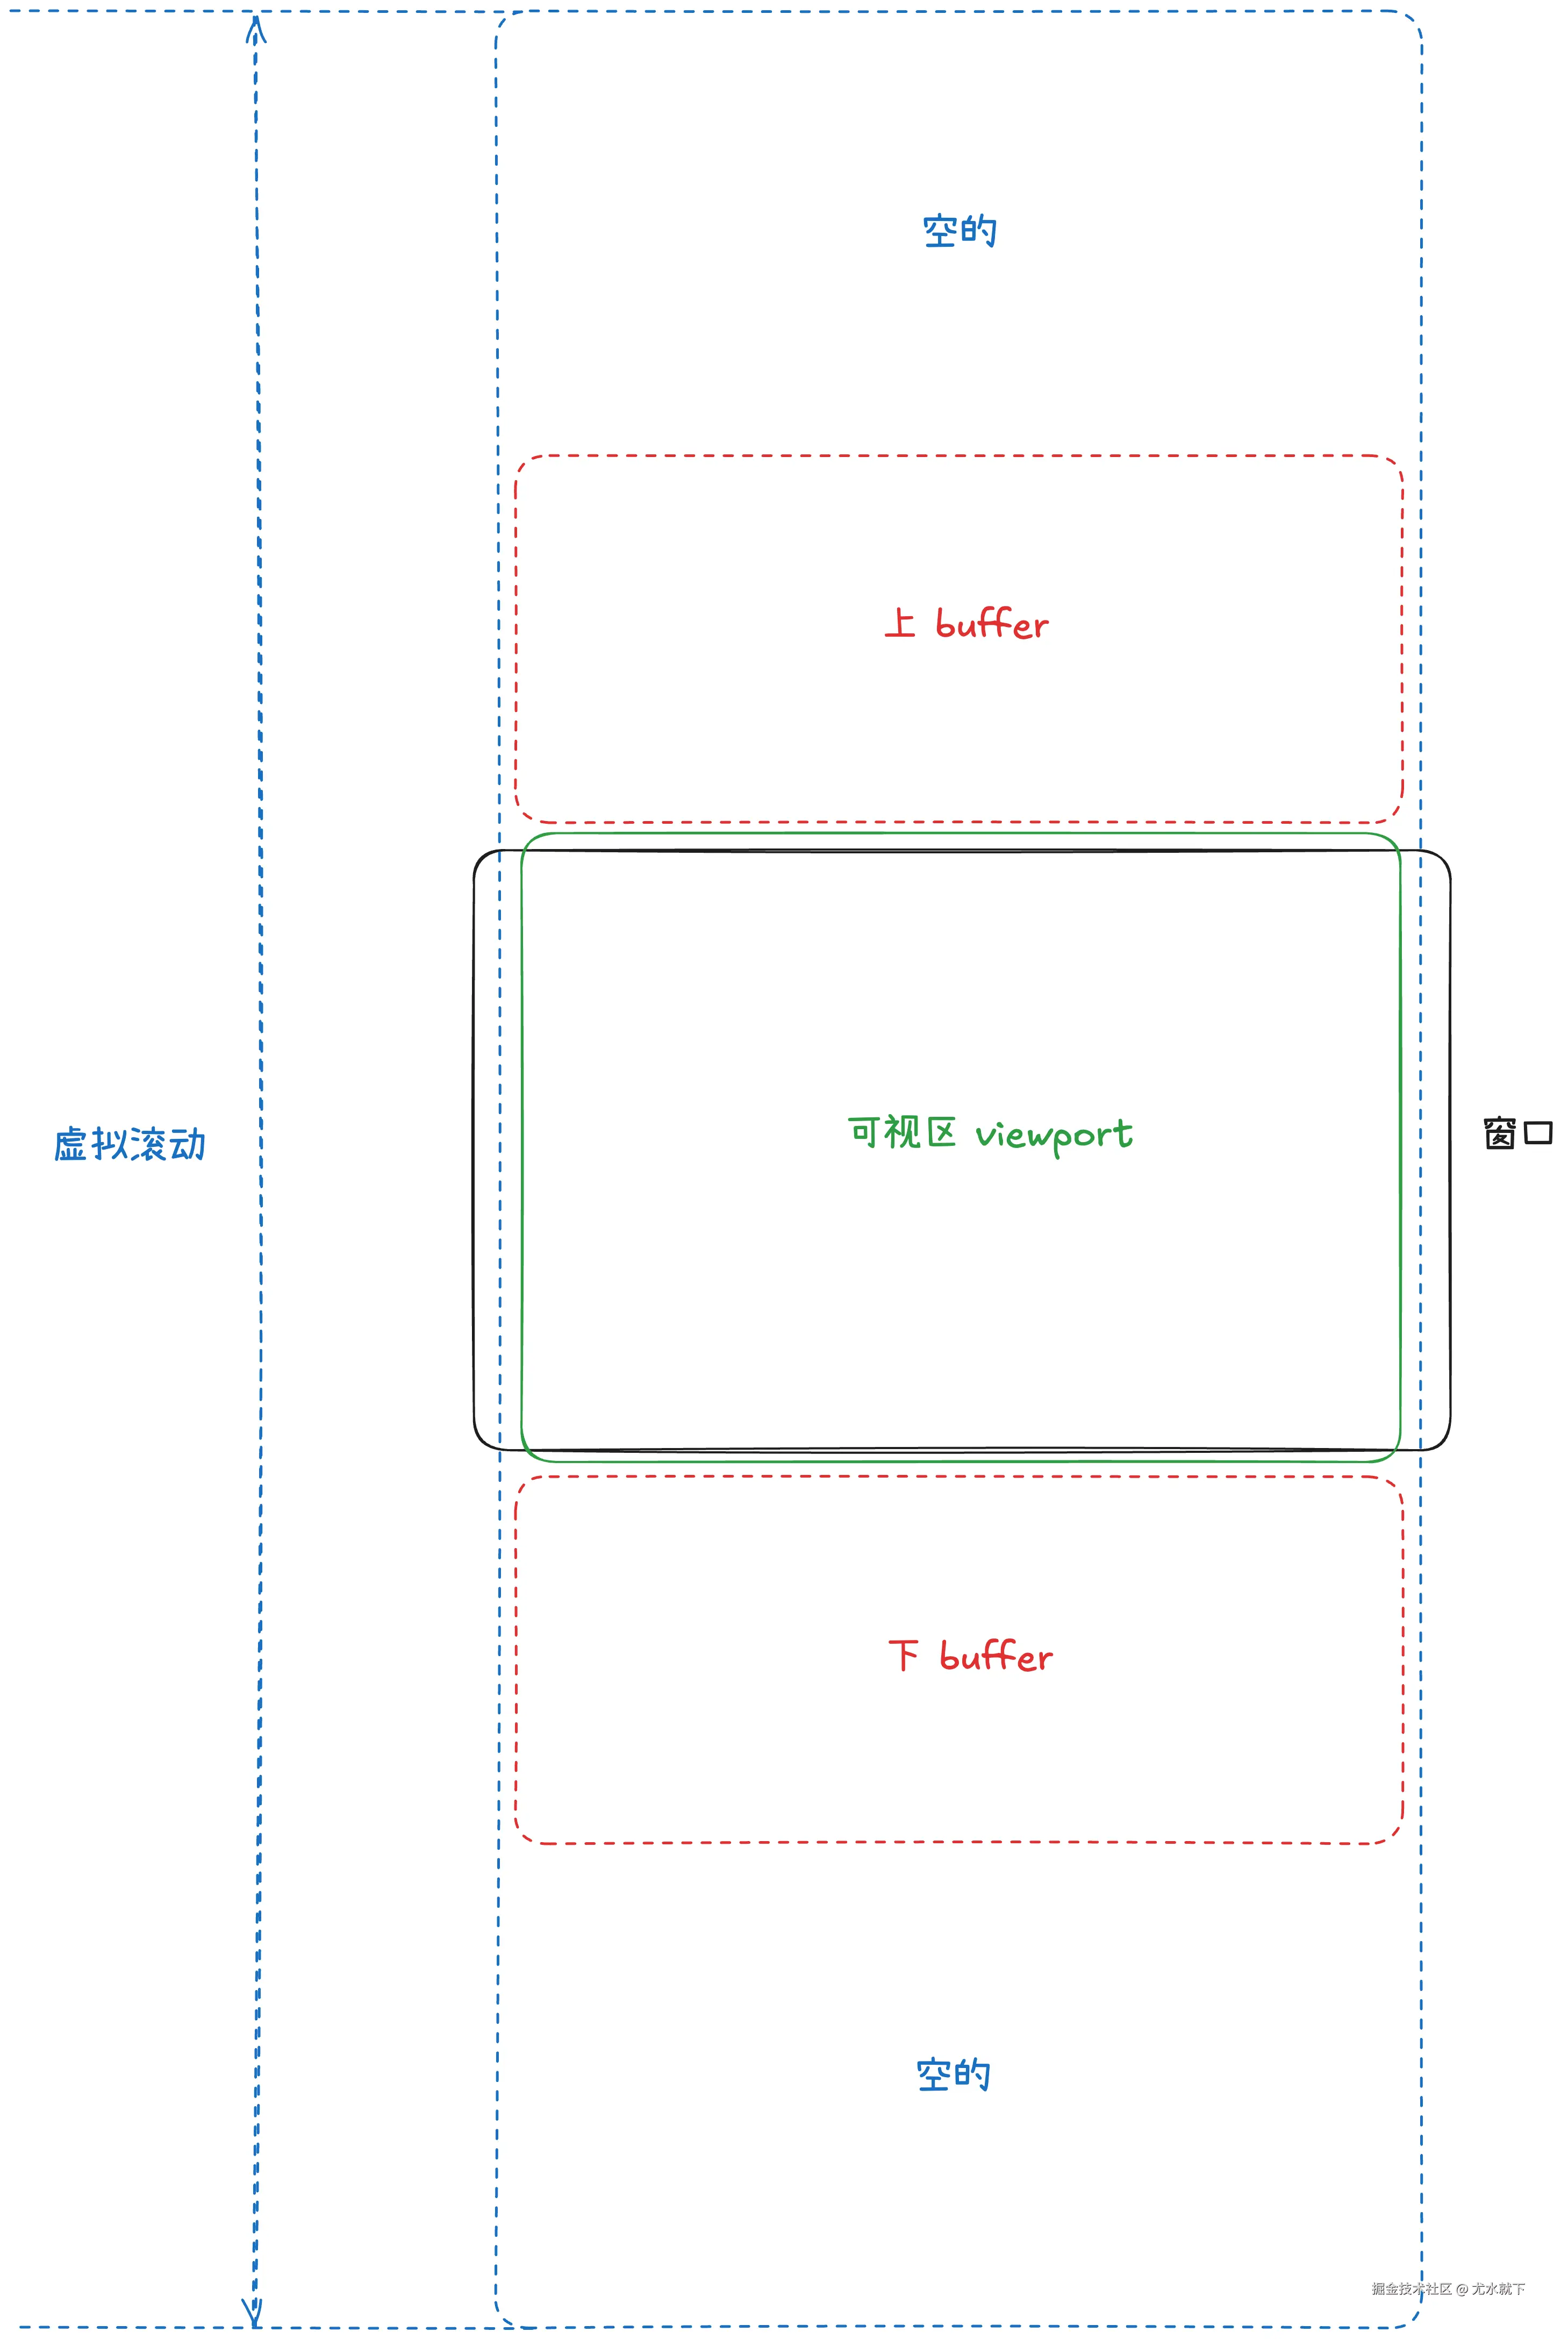
假设文档有一万个 Block,当前屏幕只看到第 500~520 个。真正需要挂载的通常是:
md
顶部占位 Placeholder:Block 0~489 的累计高度
上 Buffer:Block 490~499
Viewport:Block 500~520
下 Buffer:Block 521~530
底部占位 Placeholder:Block 531~9999 的累计高度
Buffer 的作用主要是在视口上下区域多扩展一段距离,用来提前加载数据或挂载组件,以减少快速滚动时的白屏。那么如何判断 block 是否在可视区呢?很简单,像下面这样简单的计算下就行:
js
// 当前 block 位置
blockTop
blockBottom = blockTop + blockHeight

// 是否可见
visible =
  blockTop <= viewportBottom &&
  blockBottom >= viewportTop;
blockTop 怎么来呢?其实是一开始拿到文档数据的时候我们会构建一棵布局树 LayoutTree,这个 LayoutTree 上面会有每个 block 的 top 和 height 值。可是有的 block 没有具体 height 值,而 top 值又会跟随 height 改变,我们怎么保证 LayoutTree 的稳定呢🤔?
这个问题问的很好,对应的处理方式也比较直接,就是没有高度的 block 就都先直接给个默认兜底高度,这样一来,每个 block 就都有了高度,我们就能依次往下计算每个 block 的 top 值,其实就是不断的叠加 block 的 height 值就完了。
聪明的你可能你又会问了,那后续没有高度的 block 真实渲染之后有了新的 height 和原来兜底高度不一致可咋整🤔?那这时候我们只需要动态纠正一下该 block 的 height 值和该 block 之后其他 block 的 top 值就可以了,这样一来 LayoutTree 上的布局信息就是对的了。
那这样不会造成页面突变吗😦,比如当前可视区展示的是 block10,由于 block3 的高度变了,使得 block10 也要往下推,页面就会一直跳?这又是一个很好的问题👍🏻。所以我们还需要额外增加一个锁住当前可视区 block 的功能。什么意思呢,就是除了刚才提到的动态修改 height 和 top,我们还需要动态补偿滚动距离 scorllTop,使得 scorllTop 的值能让 block10 一直保持在可视区,尽可能少的减少跳跃感,大致结果就是 block3 的 height 增加 100,那么对应滚动距离 scorllTop 的值也要跟着加 100,block10 的 top 值也要加 100,就像下面这样:
js
Block3 高度:   +100      // 往下移
Block10 的 top:+100
scrollTop:     +100     // 往上滚

Block10 在屏幕中的相对位置:不变
所以长文档不需要先创建全部 DOM 再知道总高度,而是:
js
默认高度估算全文
→ 渲染首屏
→ 修正首屏高度
→ 滚动时逐步修正后续节点
为了方便大家理解,这里简单贴下 LayoutTree 的数据结构:
js
const layoutTree = { // left 可以默认为 0;width 可以默认撑满
  blockId1: { top: 0,  left: 0, height: 40,  width: 100, ... },
  blockId2: { top: 40, left: 0, height: 120, width: 200, ... },
  blockId3: { top: 160,         height: 40,              ... },
};
其实这里还有个问题,就是我们怎么知道某个 block 的高度变了,什么时候更新高度呢?用 MutationObserver 吗?理论上可行,但一般不这么做,因为 MutationObserver 里面可能会有很多数据和无用信息。最好的方式还是 block 内部发出一个"我这个 block 高度可能会有变化"的通知给 LayoutTree,让其更新。比如在这几种操作(图片加载完毕、文本内容改变、字体加载并应用完毕等等)之后触发各自 block 的更新,这样一来就可以做到比较精确的更新了。
那如何进行局部渲染呢?成熟实现通常不会直接对全部 children 执行一次 map(render),而是让 LayoutTree 先找到 Viewport 和 Buffer 节点,算出本轮需要渲染哪些 Child,再渲染这部分,而未挂载的连续区间合并成空占位元素 Placeholder。这样逻辑上仍然有完整的文档树,物理上却只存在一小部分 DOM。
这里简单举个例子🌰,方便大家理解:
js
// 当前可视区
curBlock = [A, B, C, D, 占位EF];

// 0、往下滚动两个 block 的距离

// 1、构造目标序列
newBlock = [占位AB, C, D, E, F, 占位GH];
// 2、删除失效真实节点
curBlock = [C, D, 占位EF];
// 3、整理占位
curBlock = [占位AB, C, D, 占位GH];
// 4、插入或移动 Block
curBlock = [占位AB, C, D, E, F, 占位GH];
数据压缩和协同
在线文档最重要的数据之一就是文字了,并且具有富文本样式。直观上讲,我们可以给出下面这样一个简单的数据结构:
js
[
  { "str": "Hello ", "bold": true },
  { "str": "World", "link": "https://example.com" }
]
但通常来说,富文本不适合给每个字符都保存一份完整样式对象,因为很多样式是可以复用的。更常见的做法是把纯文本、属性应用和属性池分开,就像下面这样:
js
{
  "text": "Hello World", // 纯文本
  "attrs": "*0+6*1+5", // *用什么属性 +应用在什么位置
  "aPool": { // 共用属性池
    "0": ["bold", true],
    "1": ["link", "https://example.com"]
  }
}
可以把 *0+6*1+5 理解为:
*0+6:接下来 6 个字符使用属性池 0 的加粗效果。*1+5:再往后 5 个字符使用属性池 1 的链接效果。
而最终传给 React/Vue 的时候会整理成:
js
[
    { "text": "Hello ", "mark": { "bold": true },
    { "text": "World",  "mark": { "link": "https://example.com" },
}
最终渲染效果就会变成:
Hello World
上面那个属性池的数据结构就是会真正落盘到数据库里面的样子。那在内存中怎么使用呢🤔,这就不得不简单提一下协同了。在线文档的核心功能之一就是协同,协同的最终目的除了让用户能够实时看到变化外,更重要的是保证数据的最终一致性。
具体怎么实现呢,在文档领域用 otjson 的算法来处理是比较合适的,这个解释起来成本比较高,不过好在现在有 AI 了,你不必理解也能让 AI 写出来,只要你知道这个名词,所以这里我就快速过一下。这种算法的核心基础是你要将文档的操作拆成几个分解的不能再分解的原子操作,其它操作都能依托这几个原子操作组合而成,比如对文档来说我们只需要三个基本操作:
- insert
- retain
- delete
回看刚才的 Hello World,我们在拉取到文档数据的时候需要将它转换成这些原子操作:
js
ops = [
    { insert: "Hello ", attrs: { bold : "true" } },
    { insert: "World",  attrs: { link : "https://example.com" } },
]
然后再转换成具体的编辑器内存结构,这里就不用详细说明了,看各家编辑器自己的实现方式。编辑的本质就是基于某个旧版本,保留/删除/插入哪些字符,以及插入文本使用哪些属性。所以一个 Block 还需要有一个版本信息的字段:
js
type Block = {
  id: string;
  type: 'text' | 'image' | 'table' | '....';
  parentId: string | null;
  children: string[];
  data: Record<string, any>;
  version: string; // 每次编辑操作都 +1
}
编辑器本身是个很复杂的独立模块,有需要也是去问 AI,这里就只给个基础的结构看看,有个印象:
js
Editor
├── Input Module        # 输入管道:事件 → 字符增量 → 模型
├── Selection           # 跨块选区
├── Undo Module         # 撤销栈
├── Plugin              # 插件注册表
├── ViewModel           # 视图状态
└── Content
    ├── Zone A:TextBlock A
    ├── Zone B:TextBlock B
    └── Zone C:Heading C
文本块再多,整个页面最好只有一个 Editor 实例 + 一套共享 Content,而不是每个 TextBlock 各建一套完整编辑器。为什么?因为有几件事情天然是需要「跨块」的:
- 用鼠标从第一段拖到第五段,选中一片------这是跨块的选区
- Ctrl+C / Ctrl+V 复制粘贴,内容可能横跨好几个块
- Ctrl+Z 撤销,一次操作可能改了三个块
如果每个文本块各管各的,这三件事全得自己做跨块通信,越写越乱。集中到一个 Editor 里,才能回答「现在全局是什么状态、我改了什么、怎么回退」。
此外,这里用另一张图来帮助大家理解下 TextBlock 的基本结构: 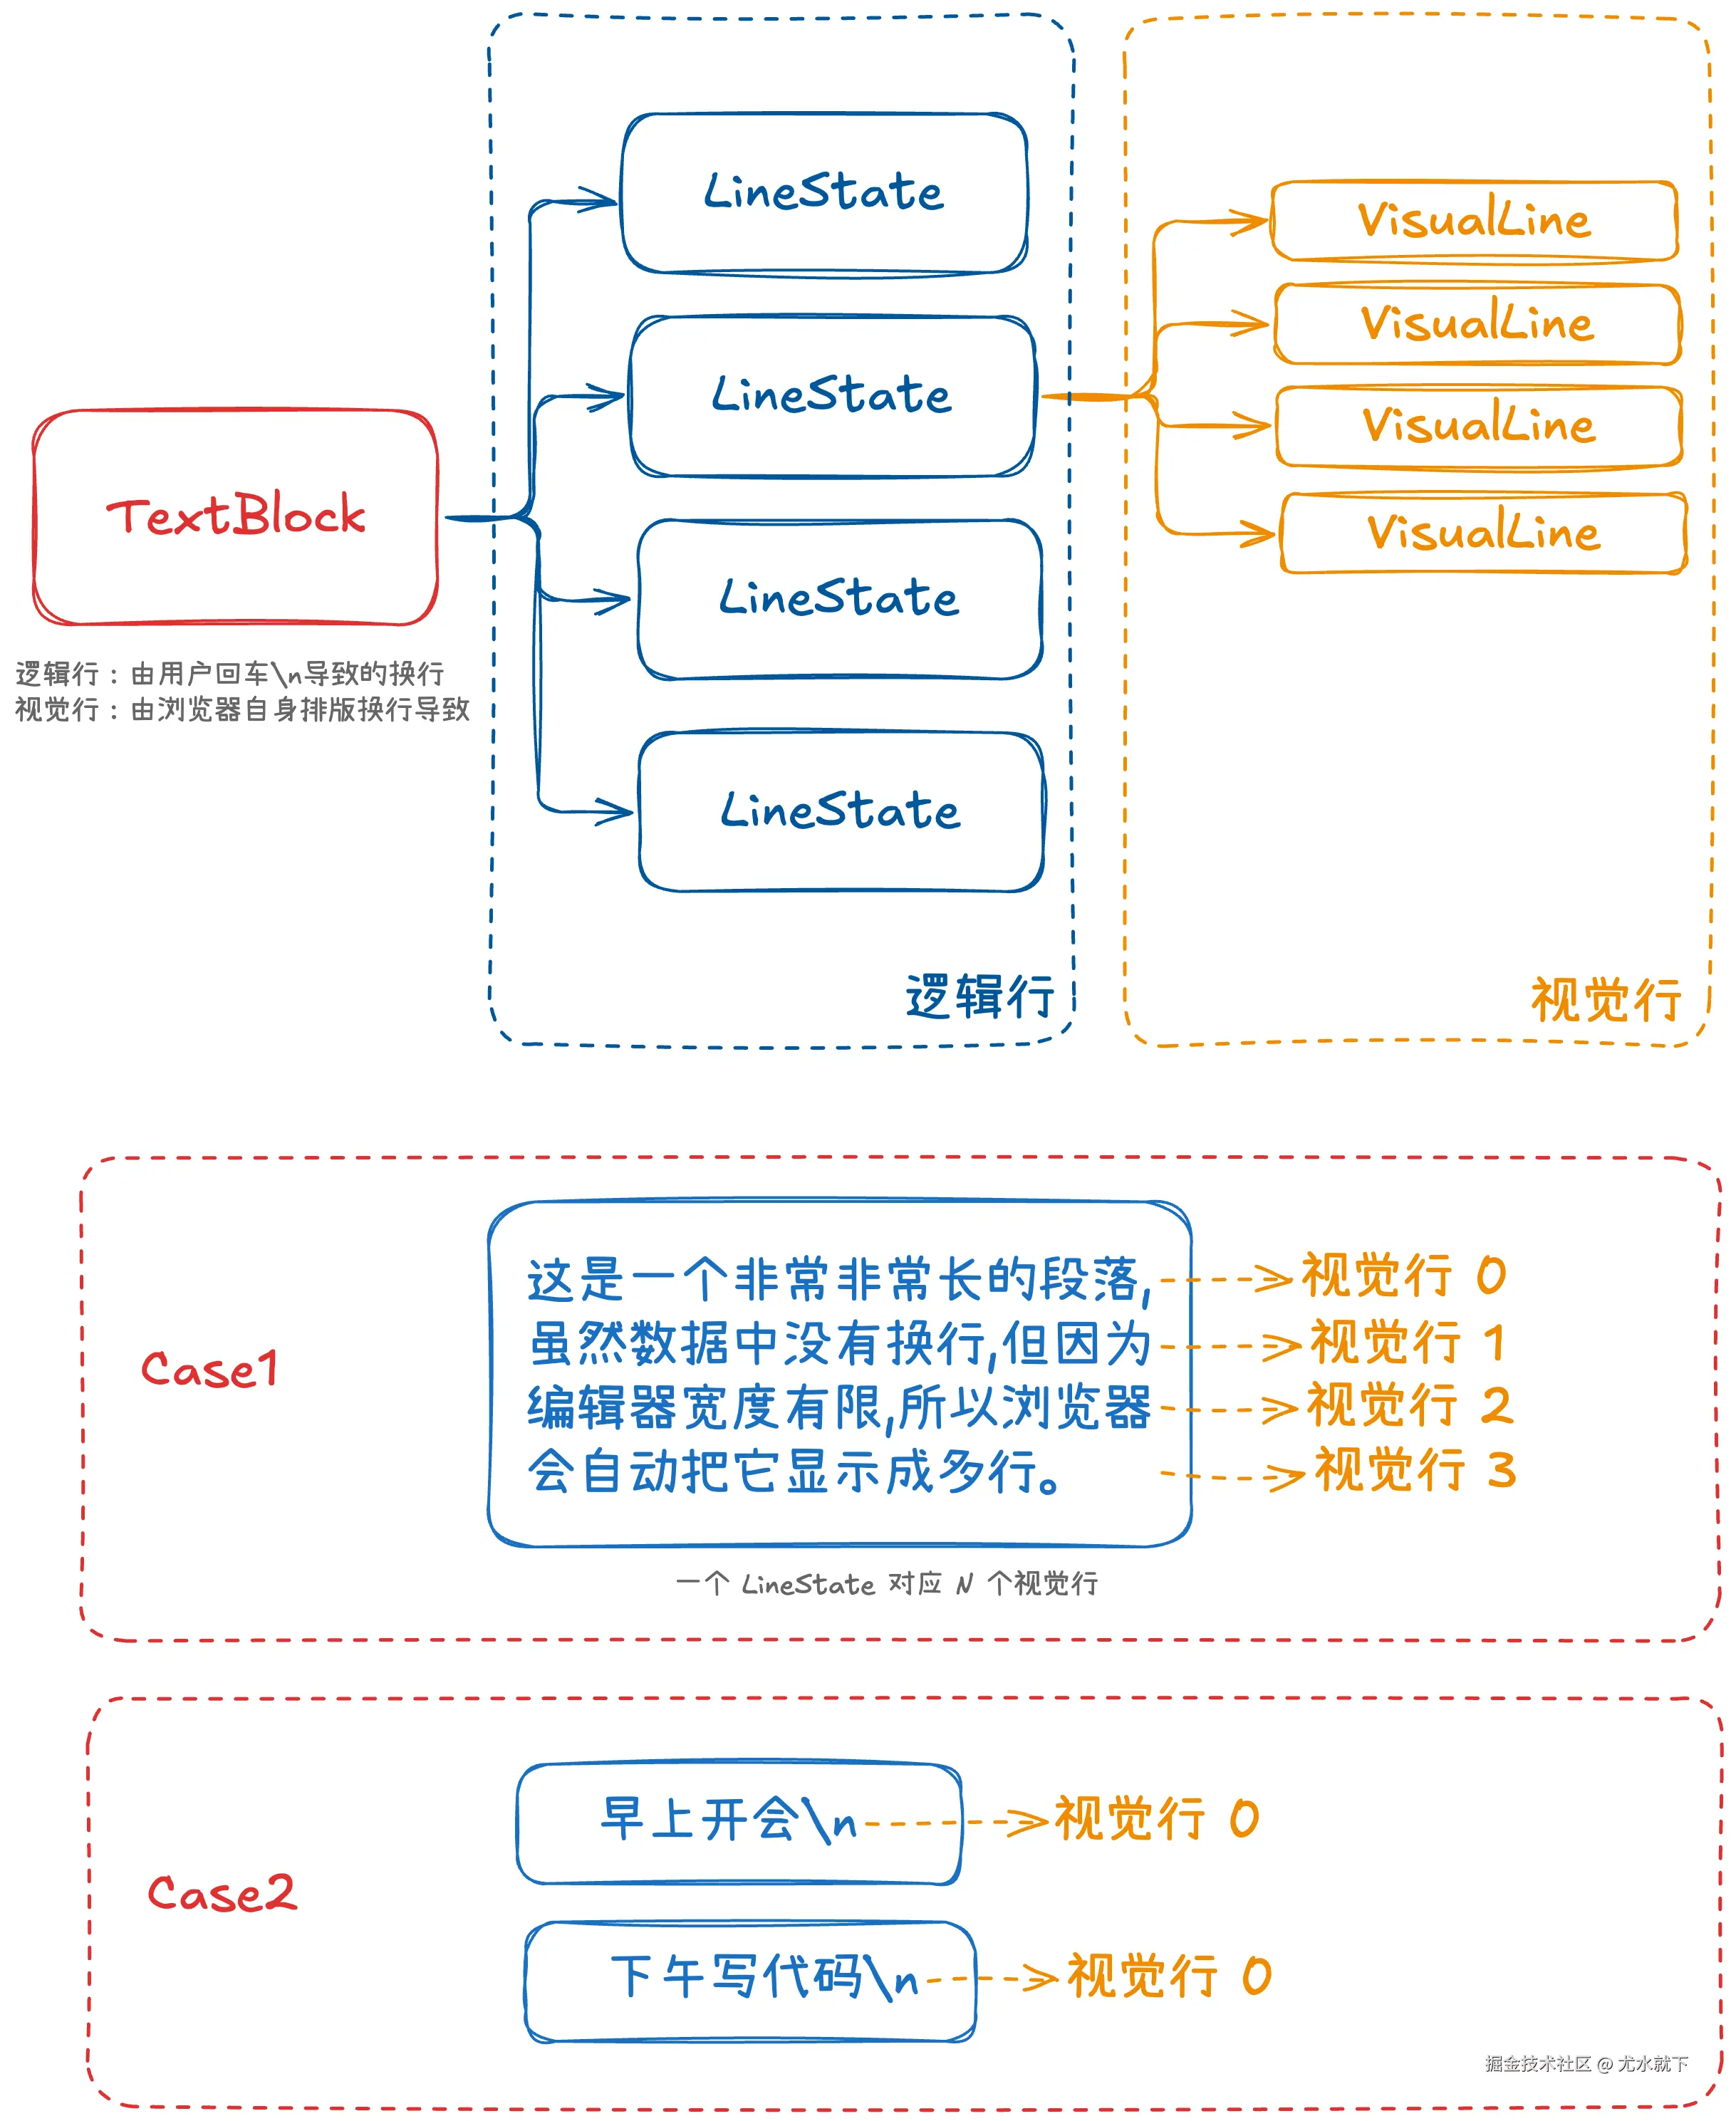 所以,万字长文怎么优化呢?最好的处理方式是拆成多个 TextBlock,其次是一个 TextBlock 拆成多个逻辑行。
编辑流程
当你对文档做了一些操作之后,整篇文档是怎样跑起来的呢?这里用到了前端常见的一个单向数据流的思想:记住,不要让"用户操作"直接修改 DOM,DOM 应该永远是结果,不管用户怎么操作,我们第一步都应该是优先处理数据,第二步才是让数据自然映射到 DOM 上展示。下面我们来看看一次编辑操作是如何落地的:
- 用户输入:比如敲了一个字,或者拖动了一张图片。
- 生成 Operation:把用户动作翻译成基本的操作,比如 insertText、moveBlock、replaceChildren。
- 更新本地 Block Store:不要先改 DOM,先改模型数据。
- 标记脏区:判断哪一个 block、哪一个父节点、哪一棵子树受影响。
- 增量渲染:只让受影响的部分重新计算视图,并更新页面。
Block 怎么扩展
文档不可能永远只有文本、图片,表格、图表、代码、文件、画板和第三方组件等等都会不断加入。如果每增加一种 Block 都去修改核心渲染器,最后一定会长成一个巨大的条件分支。所以更合理的方式是注册,以图表 Block 举例:
js
registerBlock({ // 约定协议
  type: "chart",
  model: ChartBlockModel, // 图表数据
  view: ChartBlockView, // 图表视图,亦即渲染
  layout: ChartLayout, // 图表 Block 容器结构信息,如宽高大小
  commons: [Commentable, Resizable] // 所需要的公共能力,如评论和大小拖拽等等
});
内核只关心统一协议:
- 你的类型是什么?
- Model 怎么创建?
- View 怎么渲染?
- Layout 怎么计算?
- 你组合了哪些能力?
至于图表内部用 Canvas 还是 SVG,怎么处理,内核并不需要知道。这就是微内核和插件化思想在编辑器里的典型应用。想要了解这个思想的同学可以参考我另一篇文章喔: 🔥 微内核架构在前端的实现及其应用。
同步块
正常情况下,一个 Record 数据对应一个 Block,但架构上允许同一个 Record 数据出现在多个位置,甚至是跨文档共用,这样其实复用的是同一份数据,也就能做到一处更改,处处生效。让我们简单看看这种类型的大致结构:
js
Page.children = [..., A, ..., A, ...] // 重复 Block,二者表现会同步

Record A:真实数据 // 这个 A 是 recordId
├── Block #101:正文位置 // 这个 101 是 blockId
└── Block #208:引用位置 // 这个 208 是 blockId
你会看到我们其实有两种 id(这个很重要需要理解一下😄):
| ID | 含义 |
|---|---|
| recordId | 数据实体,跨会话稳定,实际会存储,刷新页面不变。协同、保存、恢复都认它。 |
| blockId | 本次运行时结构实例,只给本次打开编辑器时给组件 key 用,实际不会存储,每次刷新页面可能会变。 |
可以粗浅的理解为 Record 表示"具体数据",Block 表示"位置在哪",本质上它们就是一种引用关系。既然提到了 id,那么这里顺便再说一个问题,我们常常提到的所谓"找到旧实例并复用",到底是在复用什么?这块很容易被讲玄乎。其实可以把它理解得非常朴素:
不是在整个页面里暴力搜索一个节点,而是在同一个父节点的孩子列表里,用稳定 key 找到上一轮那个位置对应的旧渲染单元。
无论你底层用的是 React、Vue,还是自研渲染层,只要走的是声明式更新路线,思路都差不多:
- 父节点重新产出一组 children
- 每个 child 都带稳定 key
- 框架或渲染器按 key 对齐新旧 children
- 能复用的复用,不能复用的创建或删除
所以,稳定 id 的意义并不只是"方便查找",更重要的是给每个 Block 一个持续不变的身份。身份稳定,状态才能稳定,组件才能复用,滚动位置、选区、局部缓存才不会乱跳。
职责分层
这里就是简单贴个图,方便大家了解(可跳过): 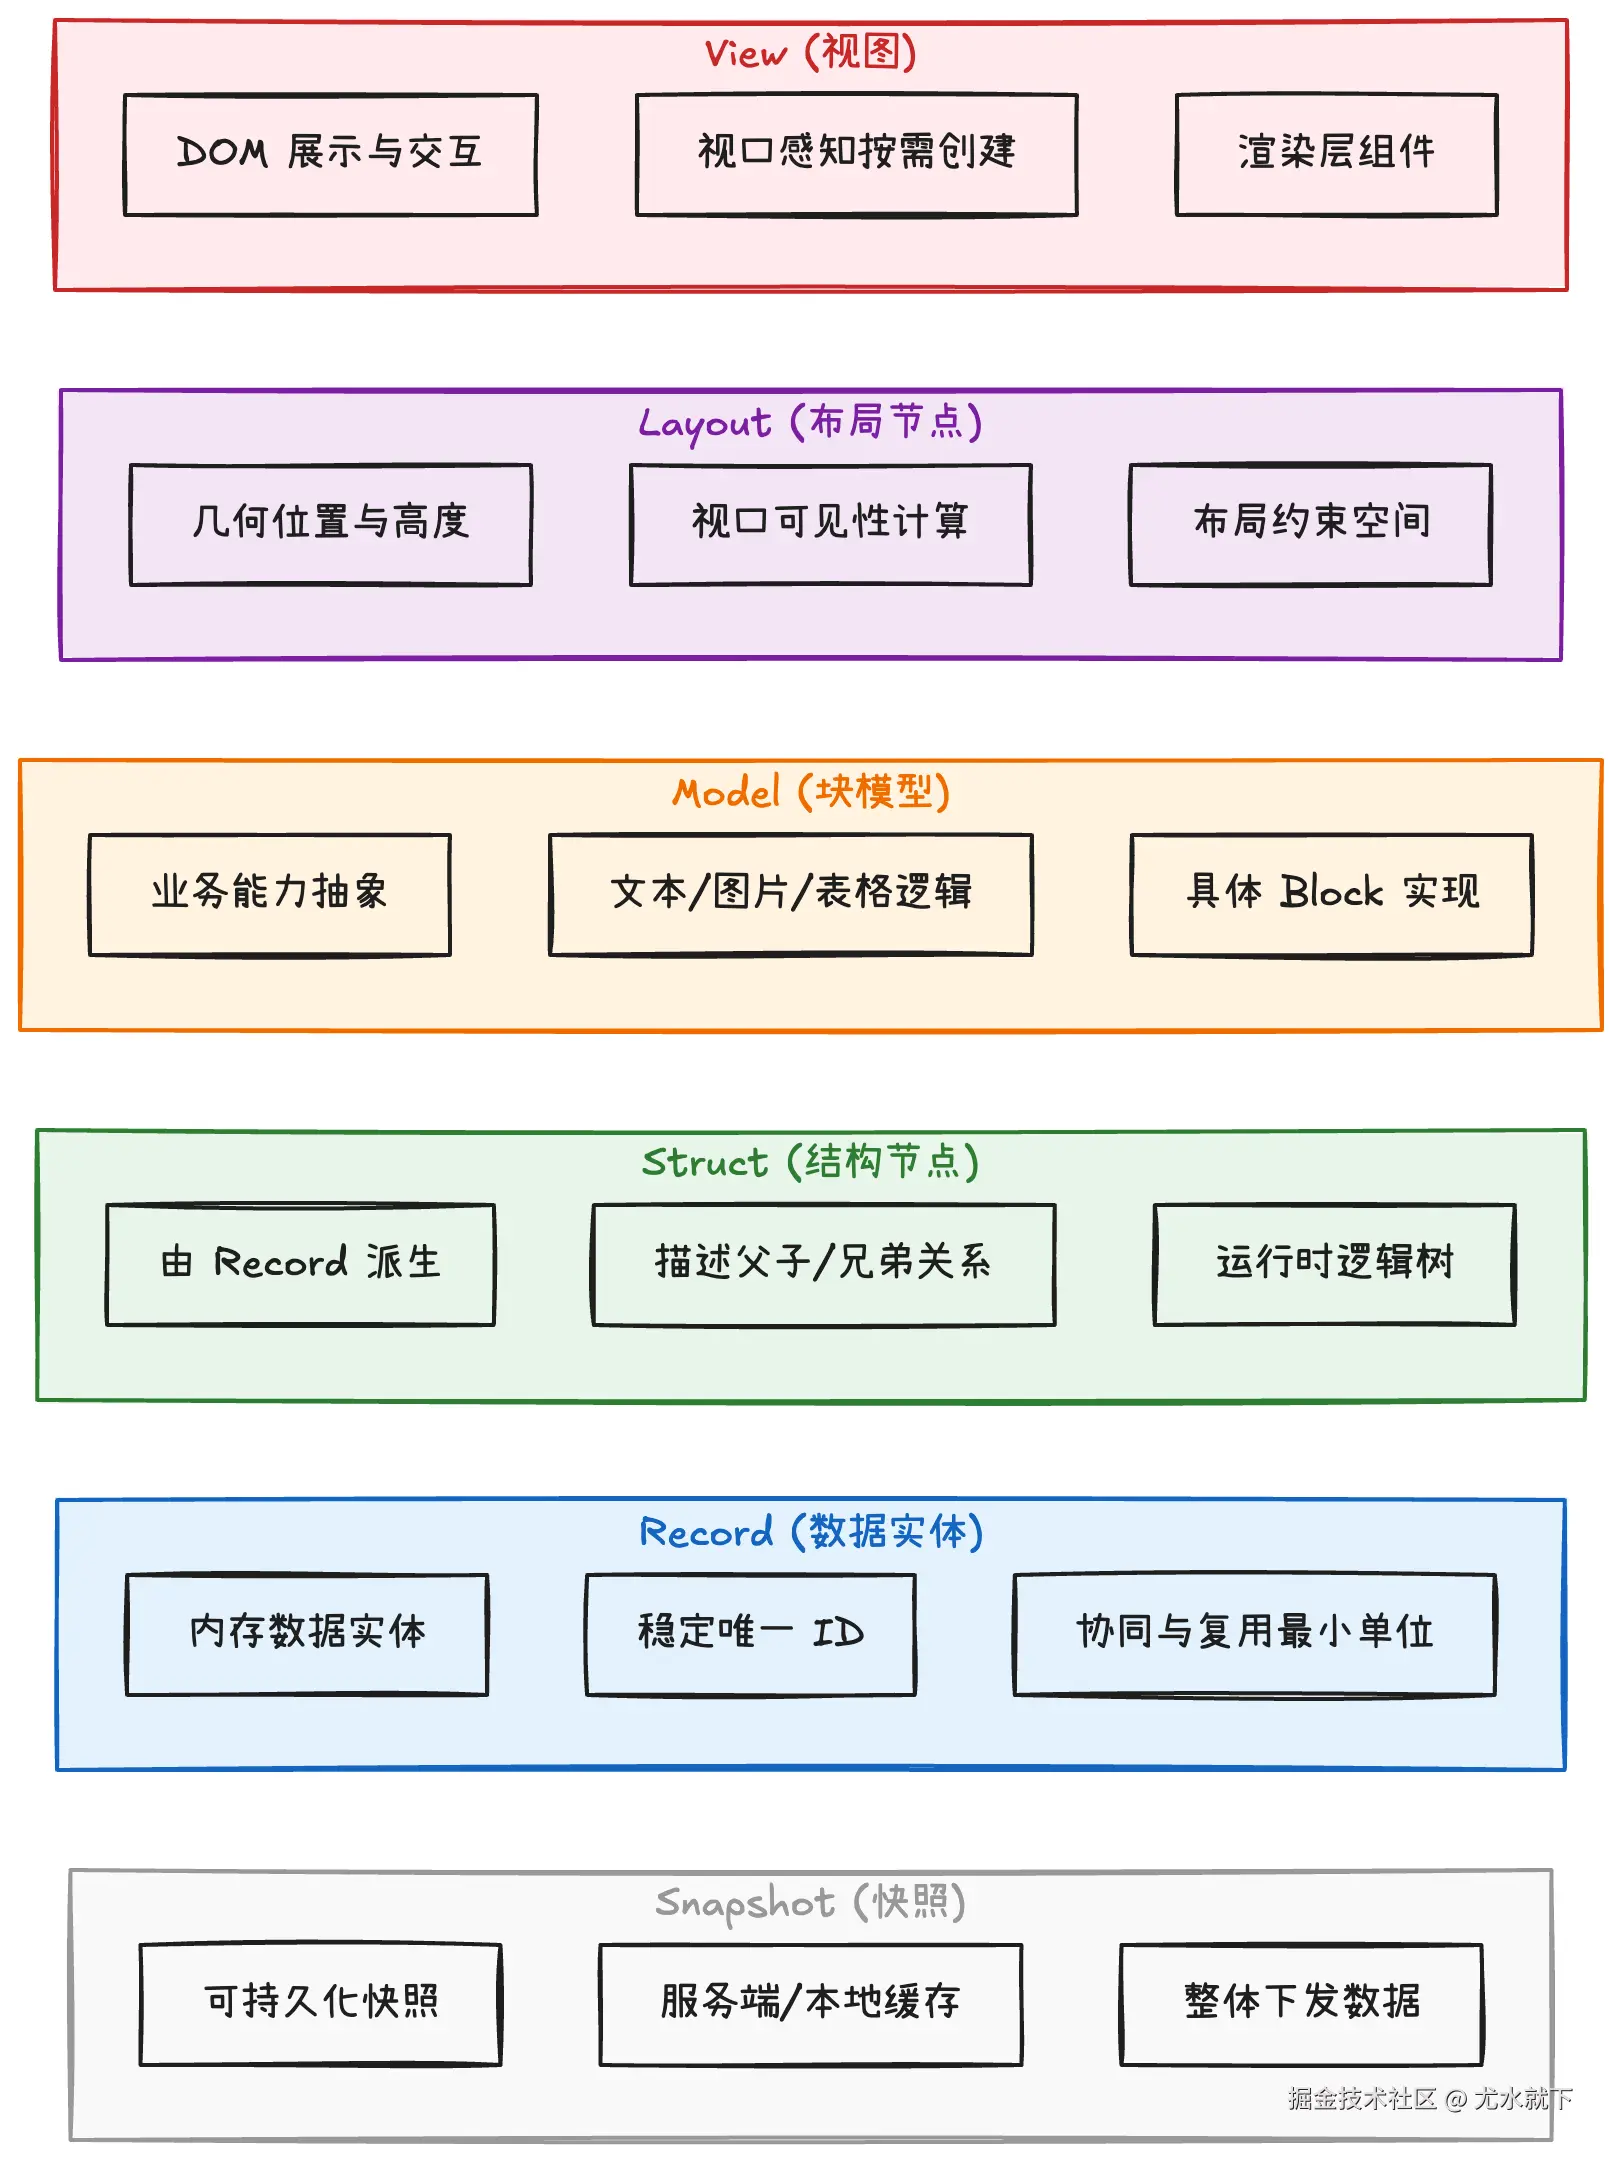 文档里其实有两个不同的「树」:
- 一个是 谁是谁的孩子(结构)
- 一个是 谁在哪儿、占多高(布局)
千万别混成一个。
- StructureTree:父子关系。图片下面挂了段说明文字,结构上它是图片的孩子。
- LayoutTree:渲染布局。只关心每个块在页面上的位置和高度,好用来算「我要滚动到哪、视口里该渲染哪些块」。
demo
如果让你自己从零实现一个通用 Block 编辑器,你不必一开始就去追求完整的文档功能,可以按照下面这条路线层层递进👇🏻:
- 先支持 3 种最小 Block:标题、段落、图片
- 把数据改成 blockMap + children 的索引结构
- 把运行时状态单独拆到 store
- 让每个 BlockNode 按 blockId 精准订阅
- 再补 Operation、History、Selection
- 最后再补协同、虚拟滚动和复杂容器
这样推进的好处是,你每加一层能力,前面的设计都能自然接住,而不是推倒重来。
小结
很多人看 Block 架构,会先看到它的外形:标题是一块,图片是一块,表格也是一块。其实这只是表面。它真正厉害的地方在于:它把一个不断生长的编辑器,拆成了一组可以独立理解、独立演化、独立优化的最小单元。你可以单独优化图片块,可以单独扩展表格块,也可以单独重做选区系统,而不必每次都动整套编辑器。
Block 架构真正解决的,不是"怎么排版",而是"怎么演化"。通用 Block 架构的核心不是"块很多",而是"每一块都拥有稳定身份、清晰边界和独立生命周期"。当内容、结构、状态、渲染真正分层之后,编辑器才会从"能用"走向"能长期维护"🚗。
不过 AI 来了,你可能不太需要 otjson 和 Editor 具体是如何实现的,只要了解个大概就行了。
但很多时候我们往往会面临一个问题,就是不知道一个技术它叫啥,这也是阻碍我们进步的一个大麻烦😂。我时常在想,善于优化和提建议的同学是怎么知道这种优化方式和建议方法呢,是因为他们之前见过类似的思想吗?如果我不曾接触过文档,我又从哪里能够知道这些知识呢。好在现在有了 AI,你不知道有什么可以优化的,就把问题丢给它,直接问 AI 看看有什么可优化的空间,这感觉真好。包括一些你不好意思问的、在别人眼里可能是基础知识的问题,你也可以随心所欲的问🎉。好啦,就此搁笔,又得雪藏半年了👋🏻。。。
软广:有咩有需要深圳羽毛球陪练的小伙伴呀,可以找我哈哈哈哈😂