从零手搓 RAG 之 Embedding 技术
前言
上一篇介绍了如何把 markdown 格式的文件切片,文章内容参考从零手搓 RAG 之分块策略,接下来要把每个片段交给嵌入模型(embedding model),编码成一组高维浮点数,也就是向量(vector),再连同原文一起写进向量库。
系列文章浏览
什么是嵌入(Embedding)
嵌入是把文本、图像、音频、视频等信息映射成高维空间里的密集向量。向量是一组浮点数,在这些空间里充当坐标:语义相近的对象坐标靠得近,相异的则离得远。举个例子:讲肺换气的两段(一段讲概念、一段讲影响因素)向量方向接近,讲财务报表的段落则落的远。
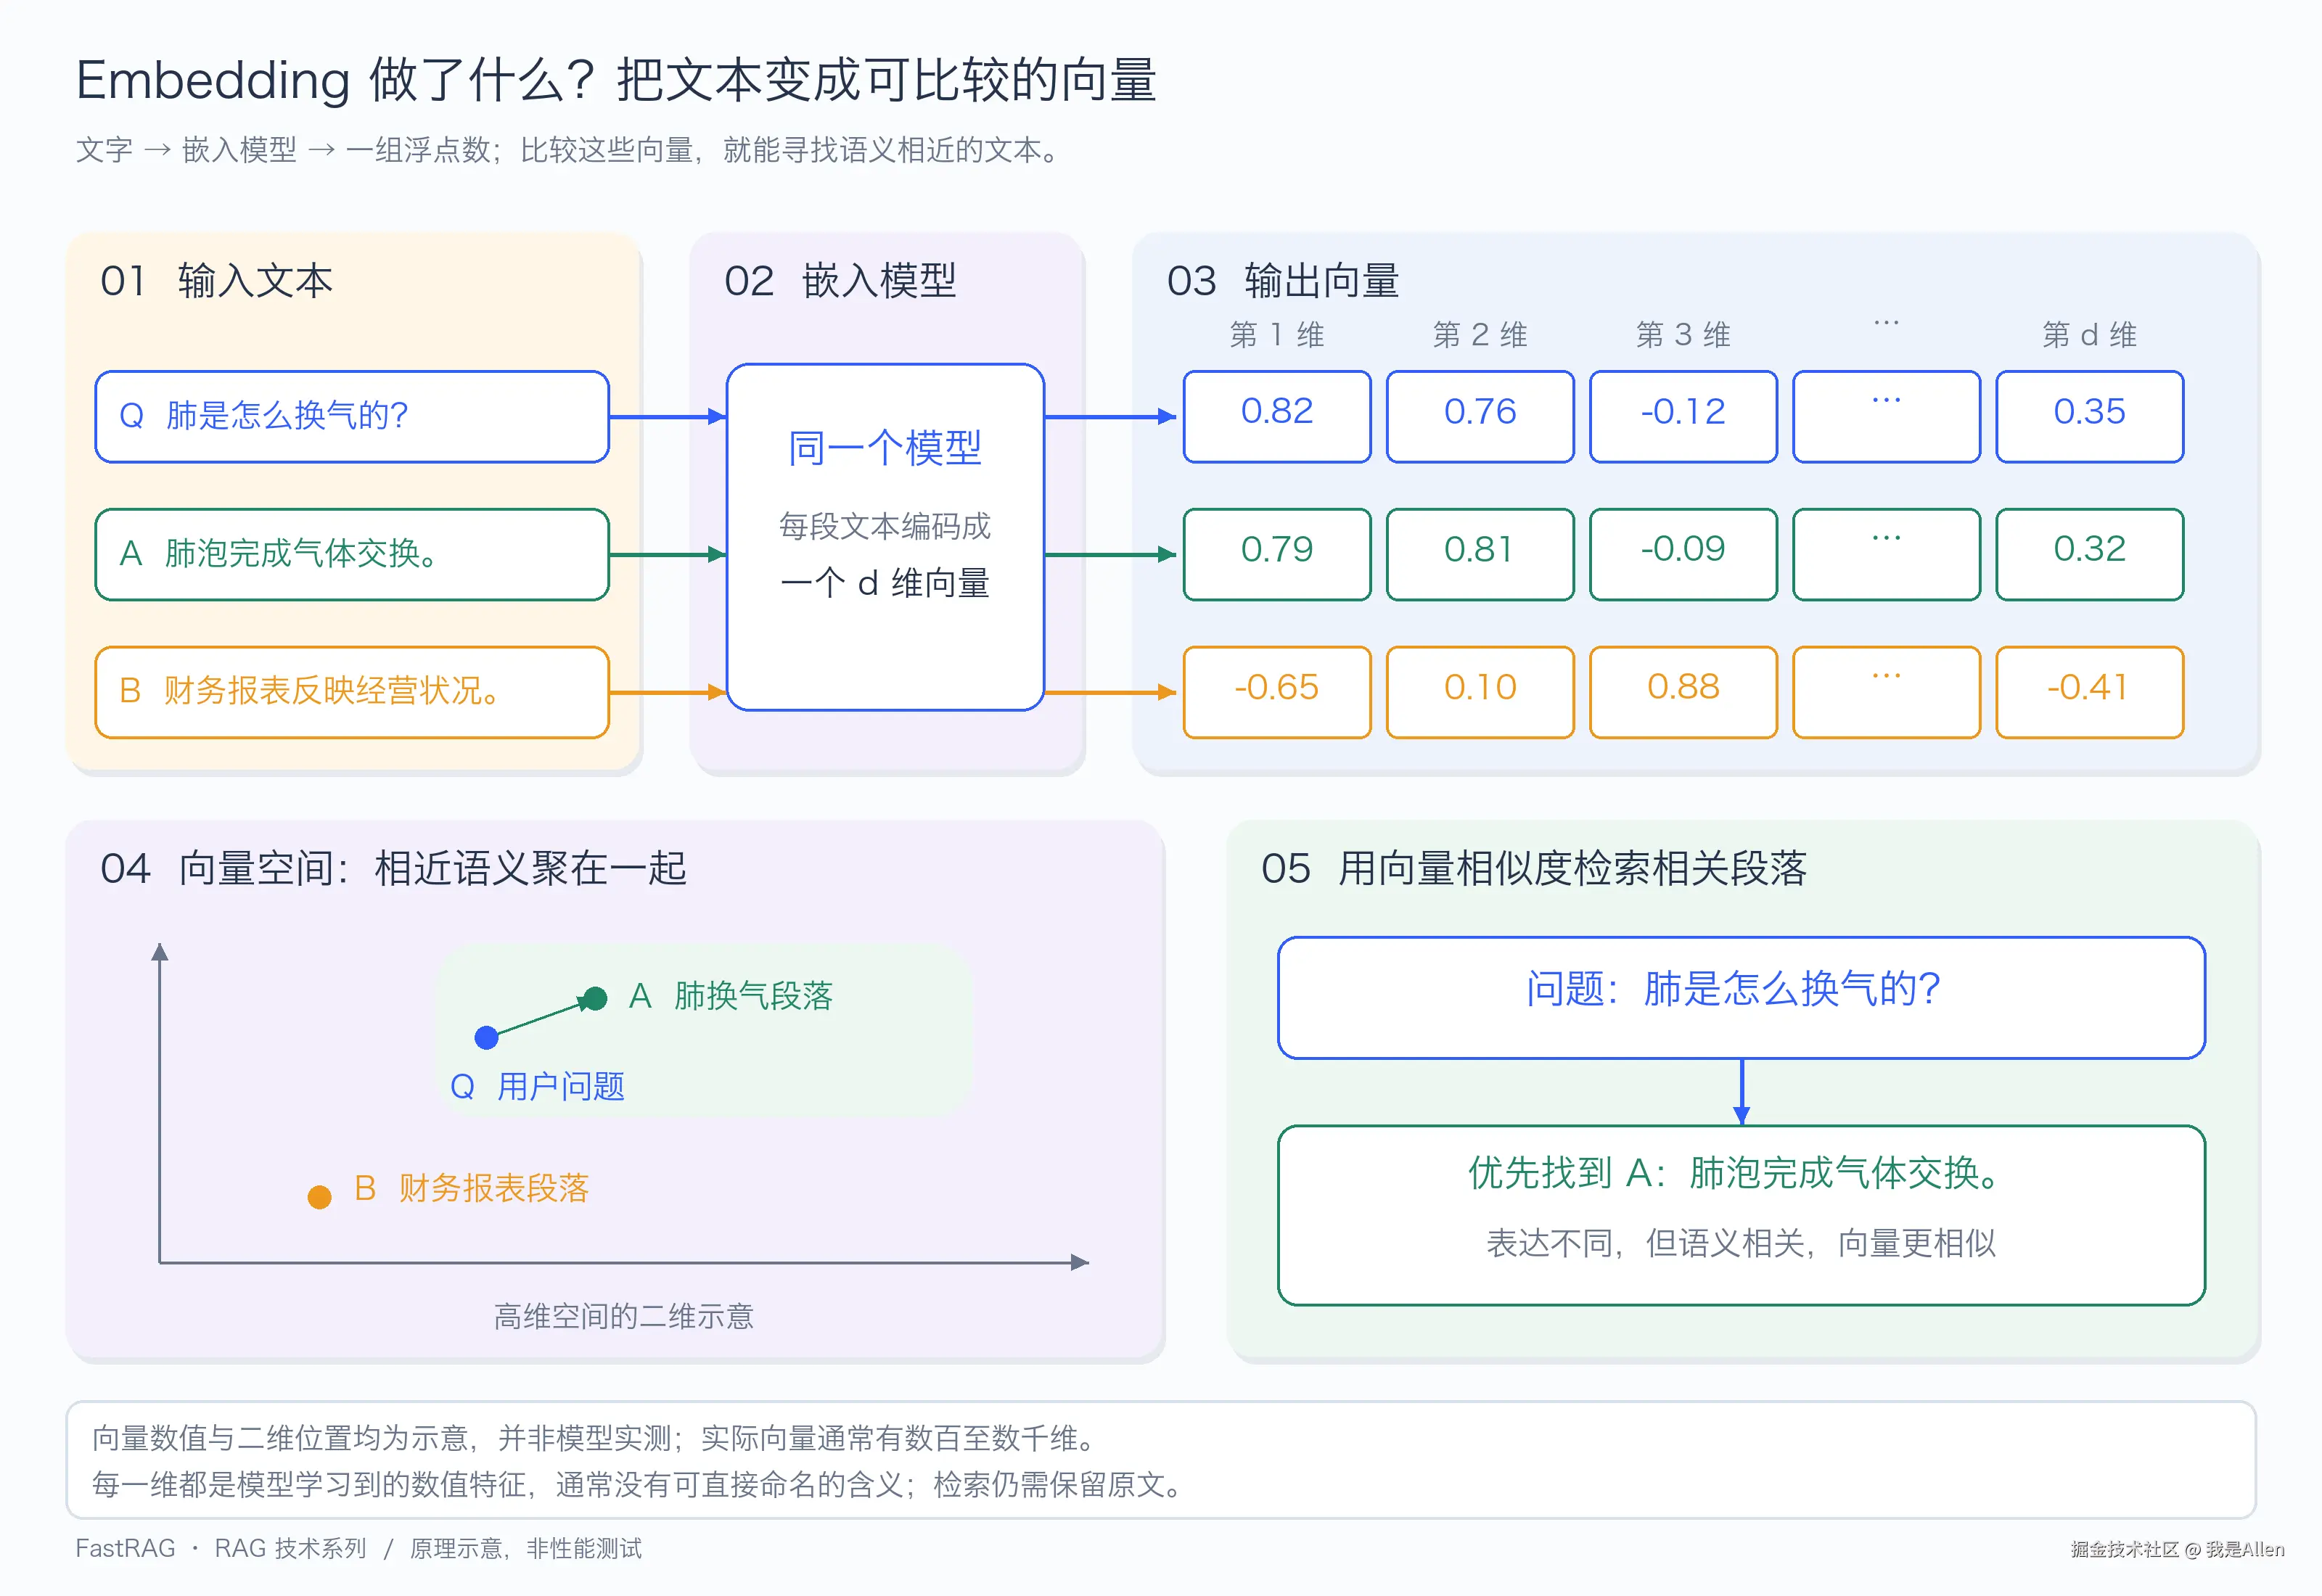
向量是数值数组,嵌入是把信息变成数值数组的过程。衡量两个向量有多接近,常用余弦相似度(cosine similarity):比较夹角,方向越一致值越接近 1,和文本长短无关。把客户问题查询也编码成向量、在向量库里找出距离最近的若干条,就是向量检索(Vector Retrieval)。另外要注意,不同嵌入模型生成的向量通常不在同一个可直接比较的空间里,即使维度相同也不能混用。更换模型时,通常需要重新编码存量文档,并让查询与文档使用同一个向量模型。
嵌入模型:从词向量到句向量
2013 年前后流行的是词向量:word2vec、GloVe、fastText 这一类。把每个词映射成一个向量,语义相近的词在空间里挨着,比如"医生"和"护士"。问题也明显:一个词只有一个向量,多义词分不开。"苹果"不管指水果还是指公司,向量都是同一个。
再往后,随着 transformer 成熟,BERT、RoBERTa 这类模型把词向量推进到上下文相关(contextual)的阶段。同一个词,在不同的句子里会得到不同的向量,多义的问题缓解了。但这类模型原生吐出的是每个 token 的向量:一句话几十个词就是几十个向量,要拿它算句子之间的相似度,还得再做一步池化,效果并不理想。
面向检索,更常用的是句向量(sentence embedding):把一整段文本压成一个向量。查询和文档各编各的,再把两个向量放一起比距离。这种结构叫双编码器(bi-encoder)。文档的向量可以提前离线算好写进库,查询时只现算一次查询向量,所以几百万条也查得动;至于让两边一起过模型、更准但更贵的打分方式,留给第 5 篇的重排再讲。
怎么选嵌入模型
市面上的嵌入模型很多,挑选时通常要综合这几项:领域适用性、检索精度、支持的语言、文本块长度、模型大小,以及检索效率。除了技术因素,落到商务上还有两条:
- 价格:国内主流服务商的能力差距不大,模型能力差不多时,单价和折扣就成了决定因素。
- 服务商契合:平台本来就全跑在一家云上(比如腾讯云),嵌入也用同一家,降低运维成本。
FastRAG 怎么接嵌入
FastRAG 把向量化集中在一个实现里,靠两个开关适配不同服务商。
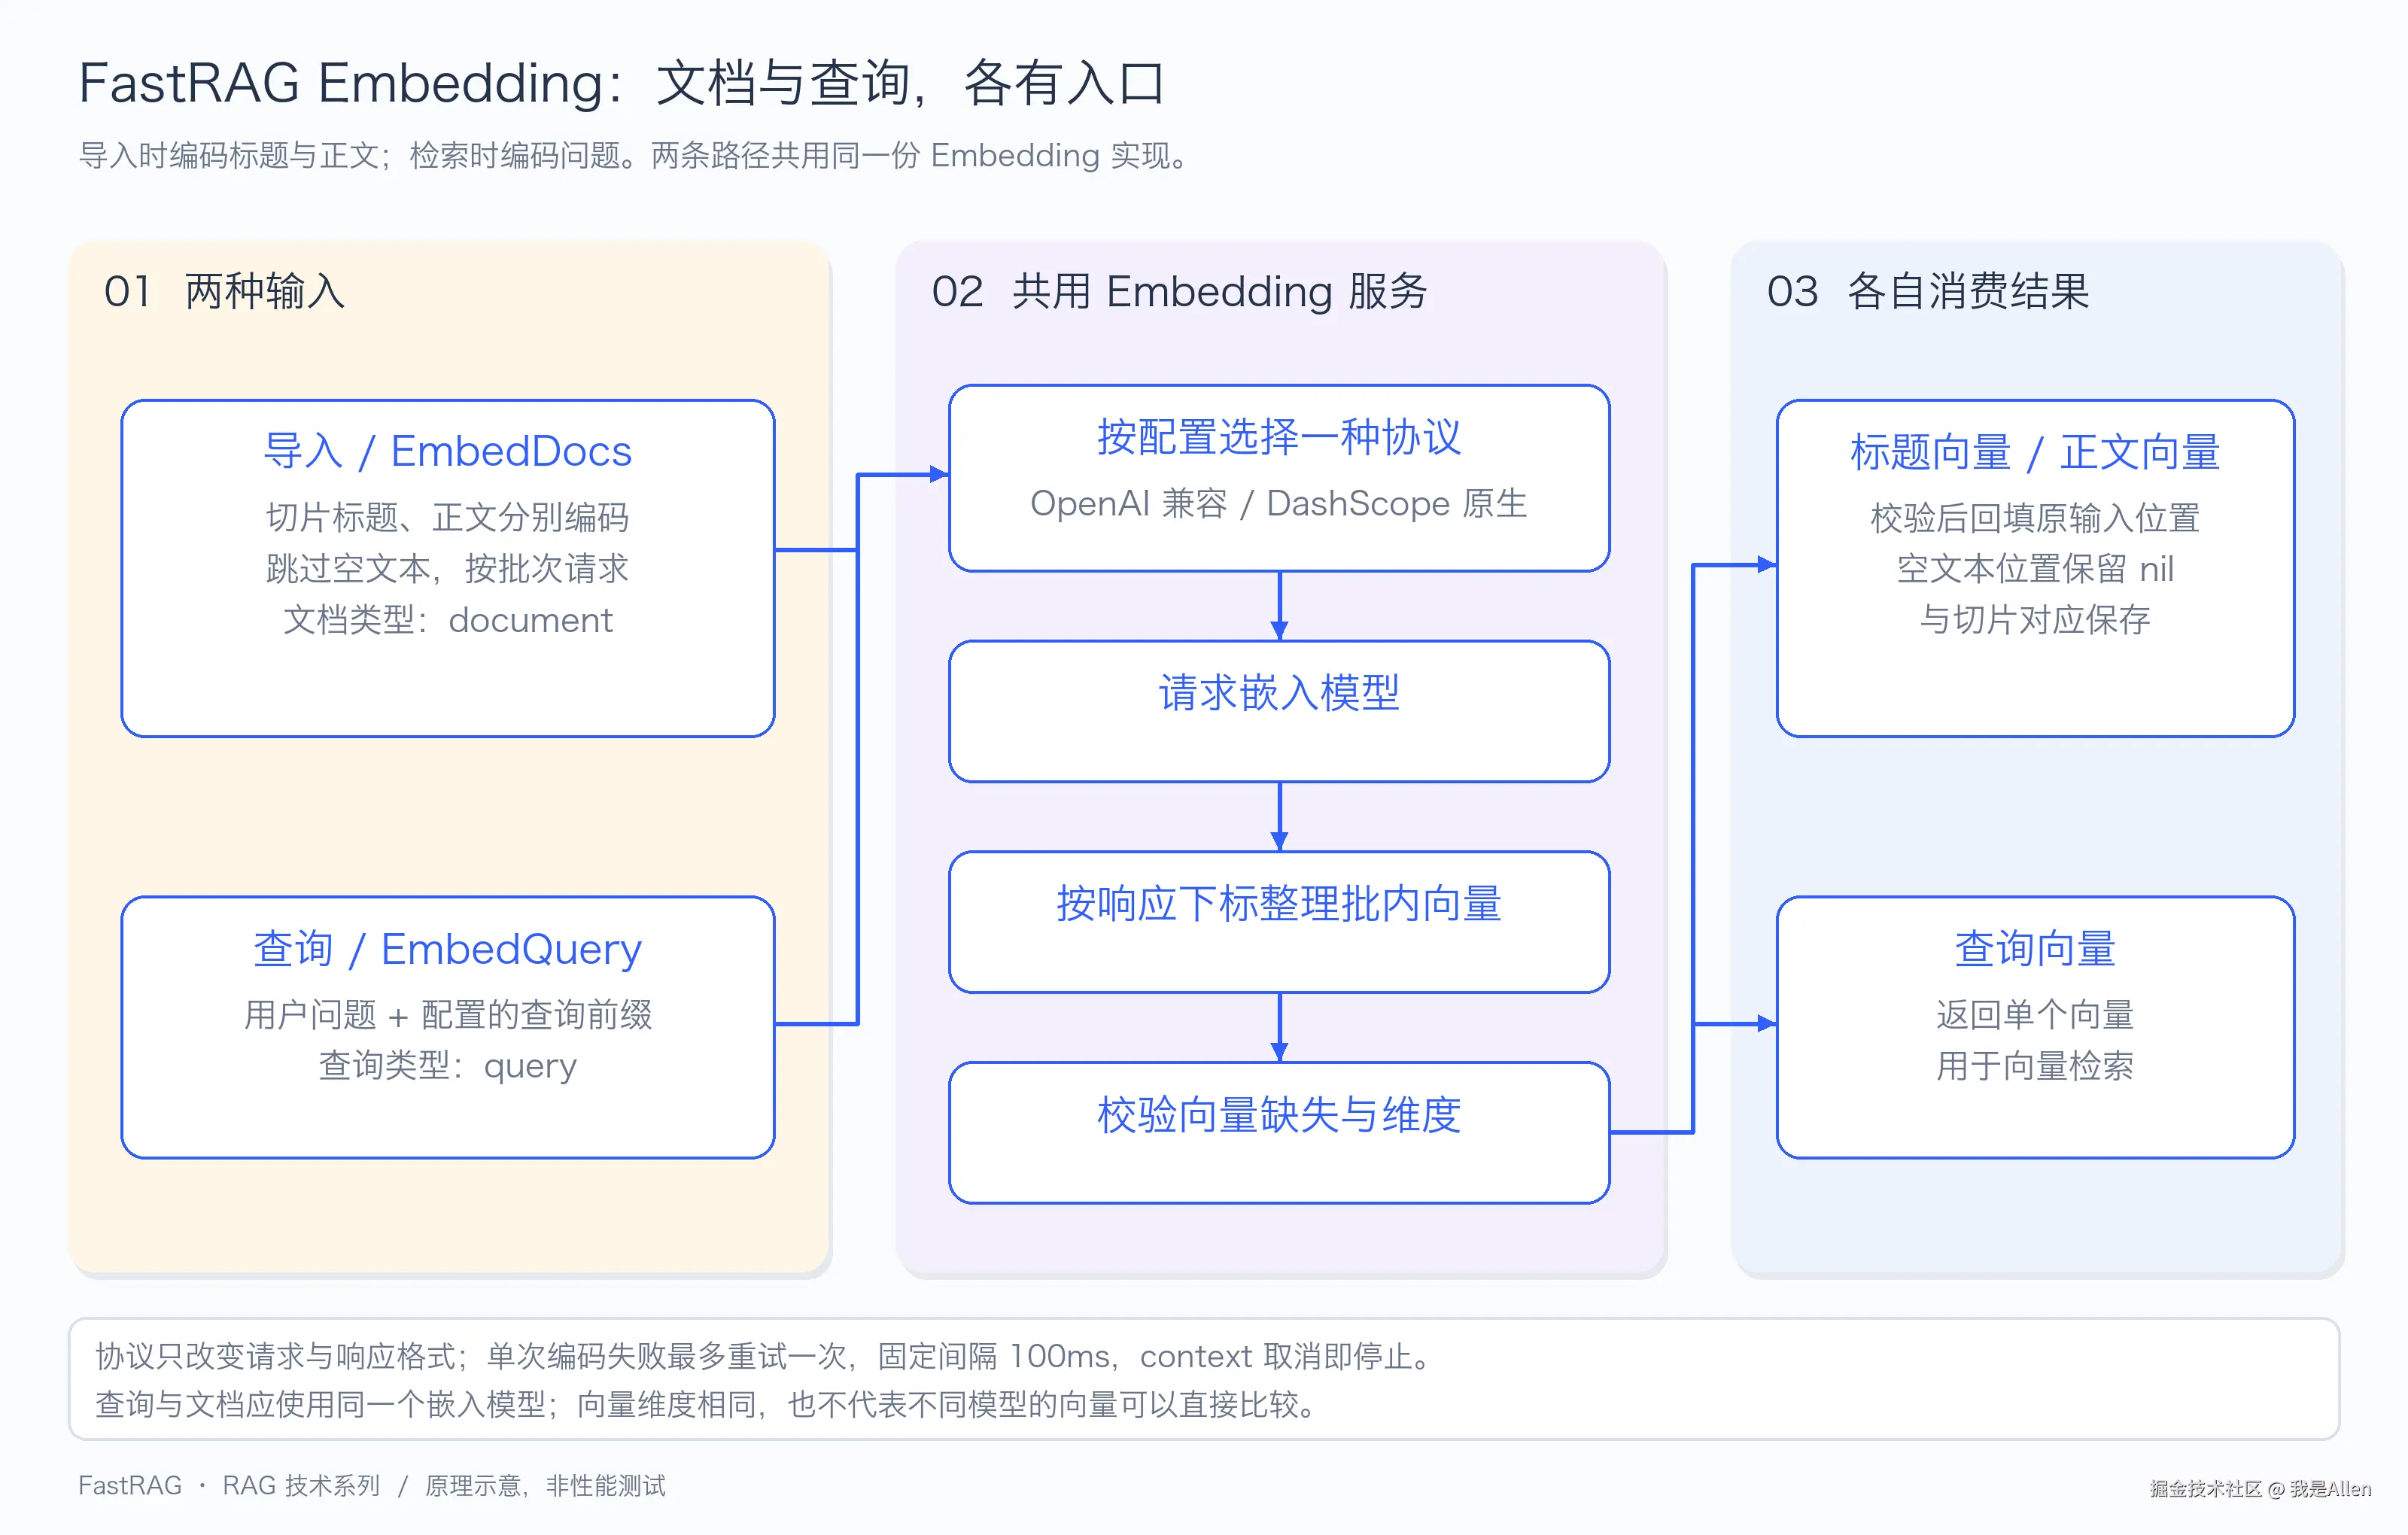
查询向量和文档向量分开
领域层不依赖任何一家模型的 SDK。
代码:domain/interfaces/embedding.go
go
type IEmbedding interface {
	// EmbedDocs 批量编码文档。返回顺序与入参一一对应。
	EmbedDocs(ctx context.Context, texts []string) ([][]float32, error)

	// EmbedQuery 编码查询串。
	//
	// 必须与 EmbedDocs 分开:多数模型(bge-m3 / E5 / GTE)检索时
	// 要给 query 加指令前缀(如 "query: "),doc 侧不加,混用会显著掉分。
	EmbedQuery(ctx context.Context, text string) ([]float32, error)

	Dim() int
	Model() string
}
请求与响应:一个实现,两套协议
同一个 Embedding 实现,靠 protocol 开关对接两种协议。拼请求体、发查询、解响应,三处的差异分别收在三个方法里:
代码:infrastructure/serviceimpl/embedding.go
go
func (e *Embedding) buildBody(texts []string, textType string) any {
	if e.protocol == config.ProtocolDashScope {
		return map[string]any{
			"model": e.model,
			"input": map[string]any{"texts": texts},
			"parameters": map[string]any{
				"text_type": textType,
			},
		}
	}
	return map[string]any{"model": e.model, "input": texts}
}

func (e *Embedding) EmbedQuery(ctx context.Context, text string) ([]float32, error) {
	vecs, err := e.embed(ctx, []string{e.queryPrefix + text}, textTypeQuery)
	if err != nil {
		return nil, err
	}
	if len(vecs) != 1 {
		return nil, apperrors.NewSysError(apperrors.CodeEmbeddingFail,
			fmt.Sprintf("embedding 返回 %d 条向量,期望 1 条", len(vecs)))
	}
	return vecs[0], nil
}

func (e *Embedding) parseVectors(parsed *embedResponse, n int) [][]float32 {
	out := make([][]float32, n)

	if e.protocol == config.ProtocolDashScope {
		if parsed.Output != nil {
			for _, d := range parsed.Output.Embeddings {
				if d.TextIndex >= 0 && d.TextIndex < n {
					out[d.TextIndex] = d.Embedding
				}
			}
		}
		return out
	}

	for _, d := range parsed.Data {
		if d.Index >= 0 && d.Index < n {
			out[d.Index] = d.Embedding
		}
	}
	return out
}
分批编码
文档分批编码有个前提:不能改变数组位置。正文为空的切片会被过滤。
代码:infrastructure/serviceimpl/embedding.go
go
func (e *Embedding) EmbedDocs(ctx context.Context, texts []string) ([][]float32, error) {
	if len(texts) == 0 {
		return nil, nil
	}

	// 先挑出真正需要算的下标,非空的按原顺序批量发出去,算完再按下标散布回 out。
	wanted := make([]int, 0, len(texts))
	for i, t := range texts {
		if strings.TrimSpace(t) != "" {
			wanted = append(wanted, i)
		}
	}

	out := make([][]float32, len(texts))
	for start := 0; start < len(wanted); start += e.batchSize {
		end := start + e.batchSize
		if end > len(wanted) {
			end = len(wanted)
		}

		batch := make([]string, 0, end-start)
		for _, i := range wanted[start:end] {
			batch = append(batch, texts[i])
		}

		vecs, err := e.embed(ctx, batch, textTypeDocument)
		if err != nil {
			return nil, err
		}
		for j, i := range wanted[start:end] {
			out[i] = vecs[j]
		}
	}

	// 剩下没被填上的就是空文本,留 nil------序列化成 null 后 ES 当作字段不存在。
	return out, nil
}
被跳过的空文本在结果里留 nil,而不是补零向量:ES 的 cosine 不接受零模长向量,补了会让整批写入 400。而且没有标题,本来也不该有标题向量。
调用、校验与重试
单次调用 embedOnce 负责发请求、解响应、逐条校验,embed 在它外面包一层重试:
代码:infrastructure/serviceimpl/embedding.go
go
func (e *Embedding) embed(ctx context.Context, texts []string, textType string) ([][]float32, error) {
	var vecs [][]float32
	err := retry.Do(
		func() error {
			var err error
			vecs, err = e.embedOnce(ctx, texts, textType)
			return err
		},
		retry.Context(ctx), // ctx 取消时立即放弃,不再发起下一次
		retry.Attempts(2),  // 初次 + 重试一次,与 rerank 一致
		retry.Delay(defaultEmbedRetryDelay),
		retry.DelayType(retry.FixedDelay), // 固定间隔退避,不用默认的指数+抖动
		retry.LastErrorOnly(true),         // 只透传最后一次的错误,不层层包装
	)
	if err != nil {
		return nil, err
	}
	return vecs, nil
}

func (e *Embedding) embedOnce(ctx context.Context, texts []string, textType string) ([][]float32, error) {
	payload, err := json.Marshal(e.buildBody(texts, textType))
	if err != nil {
		return nil, apperrors.ErrEmbeddingFailed.Wrap(err)
	}

	body, status, err := postJSON(ctx, e.client, e.url, e.apiKey,
		payload, maxEmbedResponseBytes, apperrors.ErrEmbeddingFailed)
	if err != nil {
		return nil, err
	}

	var parsed embedResponse
	if err := json.Unmarshal(body, &parsed); err != nil {
		return nil, apperrors.NewSysError(apperrors.CodeEmbeddingFail, fmt.Sprintf(
			"embedding 响应不是合法 JSON,HTTP %d: %s", status, truncateBody(body, 512)))
	}
	if err := parsed.apiError.check(status, apperrors.CodeEmbeddingFail, "embedding", body); err != nil {
		return nil, err
	}

	out := e.parseVectors(&parsed, len(texts))

	for i, v := range out {
		if len(v) == 0 {
			return nil, apperrors.NewSysError(apperrors.CodeEmbeddingFail,
				fmt.Sprintf("embedding 第 %d 条缺失", i))
		}
		// 维度对不上必须在这里就拦下:等写进 ES 才发现,
		// 报的会是 dense_vector 的 mapping 错误,离真正的原因很远
		if e.dim > 0 && len(v) != e.dim {
			return nil, apperrors.NewSysError(apperrors.CodeEmbeddingFail, fmt.Sprintf(
				"embedding 维度为 %d,配置里写的是 %d;两者必须一致", len(v), e.dim))
		}
	}
	return out, nil
}
配置写 1024 维、实际拿到 768 维,在这里就报一个明确的错误,比等 ES 报 mapping 错误好找。但维度相同不代表空间相同,查询用 B、文档用 A,长度照样能过检查,距离却没有意义,所以换模型要整批文档和查询一起换。
embed 在外面包一层重试:初次加一次,固定 100 毫秒间隔,context 取消即停。加这层是因为一篇中等文档就是几十批,任何一批抖一下都会让整次导入失败。但这是单批重试,不是整个导入的续传,中途失败就得从头再来。
落库:标题正文两路
一个切片其实算了两次向量:标题一次,正文一次。
代码:application/service/ingest/ingest.go
go
func (s *Service) embedChunks(
	ctx context.Context, e interfaces.IEmbedding, chunks entity.Chunks,
) (titleVecs, contentVecs [][]float32, err error) {
	titleVecs, err = e.EmbedDocs(ctx, chunks.Titles()) // title 向量化
	if err != nil {
		return nil, nil, apperrors.ErrEmbeddingFailed.Wrap(err)
	}

	contentVecs, err = e.EmbedDocs(ctx, factory.EmbeddingTexts(chunks)) // 内容向量化
	if err != nil {
		return nil, nil, apperrors.ErrEmbeddingFailed.Wrap(err)
	}

	if len(titleVecs) != len(chunks) || len(contentVecs) != len(chunks) {
		return nil, nil, apperrors.NewSysError(apperrors.CodeEmbeddingFail, fmt.Sprintf(
			"向量条数不匹配:标题 %d / 正文 %d,切片 %d",
			len(titleVecs), len(contentVecs), len(chunks)))
	}

	return titleVecs, contentVecs, nil
}
标题和正文分开算、分开存:标题短、噪声低,用于精排;正文长、信息全,用于召回。正文那一路取的是 Content,切片器已经把标题链写进了开头,等于顺手带上了章节上下文。
最后和切片按位置组装成待写入数据对象:
代码:domain/factory/vector_doc.go
go
func BuildVectorDocs(
	kb *entity.Knowledge,
	docID uint64,
	chunks entity.Chunks,
	titleVecs, contentVecs [][]float32,
	now time.Time,
) ([]repository.VectorDoc, error) {
	if len(titleVecs) != len(chunks) || len(contentVecs) != len(chunks) {
		return nil, apperrors.NewSysError(apperrors.CodeInternal, fmt.Sprintf(
			"向量条数与切片数不一致:标题 %d / 正文 %d / 切片 %d",
			len(titleVecs), len(contentVecs), len(chunks)))
	}

	ts := now.UnixMilli()
	docs := make([]repository.VectorDoc, len(chunks))
	for i, c := range chunks {
		docs[i] = repository.VectorDoc{
			ChunkID:     ChunkID(docID, c.Order, c.Content),
			Tenant:     kb.Tenant,
			KBID:        kb.ID,
			DocID:       docID,
			Order:       c.Order,
			Title:       c.Title,
			Content:     c.Content,
			HeadingPath: c.HeadingPath,
			TitleVec:    titleVecs[i],
			ContentVec:  contentVecs[i],
			CreateTs:    ts,
		}
	}
	return docs, nil
}
小结
嵌入就是把文本变成一组高维浮点数,让语义相近的文本在空间里靠近,从而能按距离检索。
完整代码:PycMono/FastRAG。