现在讲 agent 的文章,十个有九个是写代码的:读仓库、改文件、跑测试、开 PR。这篇反过来,讲一个不写代码的 agent。
写代码之外,Agent 还有一大类工作:把非结构化材料搬进结构化系统------读任务书、读合同、读发票,最后落成一张业务表单。这类场景没有 shell,也不需要沙箱,但有自己的难点:材料是扫描件,字段有业务口径,填错了要有人能发现。
你把一份扫描件拖进去,它一页一页读,表单上的格子逐个亮起来;读不动的字段留空,并写清楚为什么留空;最后交给你一份草稿,等你补、等你核、等你点保存。
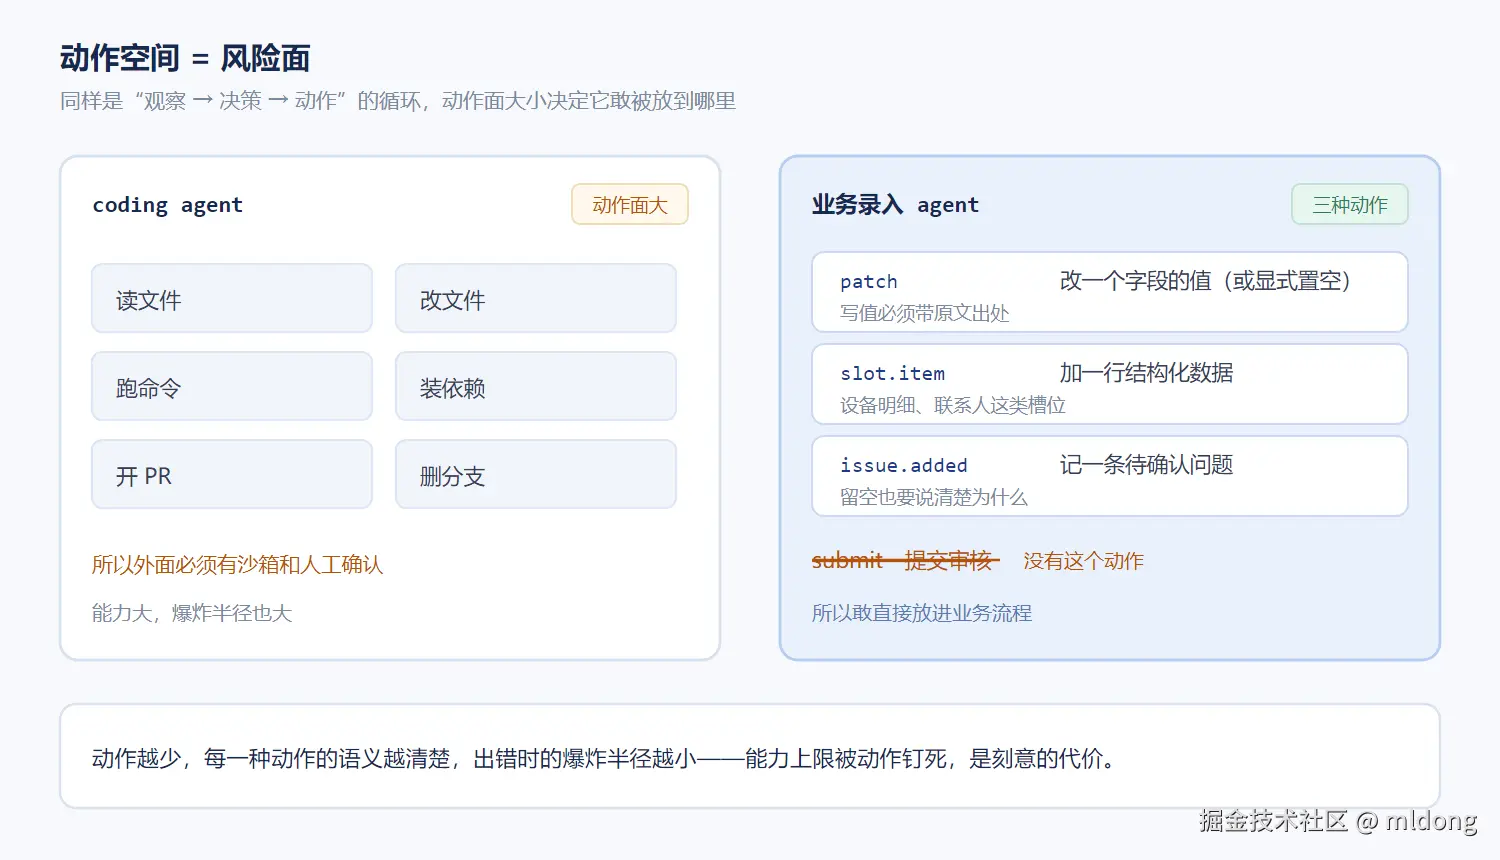
它没有 shell,没有文件系统,能自己发起的外部调用只有一个模型端点。它能改的东西只有三种:一个字段的值、一行结构化数据、一条待确认的问题。
这个限制不是能力不足,是设计。这篇就把这个 Agent 拆开,看看"三个动作"是怎么定的,以及为什么这样的 Agent 反而敢放进业务流程里。
一次完整运行(2 倍速):选表 → 上传扫描件 → 字段逐格回填 → 存草稿。演示数据全部虚构。
一、先把 Agent 缩到最小:一个循环
先给一个不玄乎的定义:
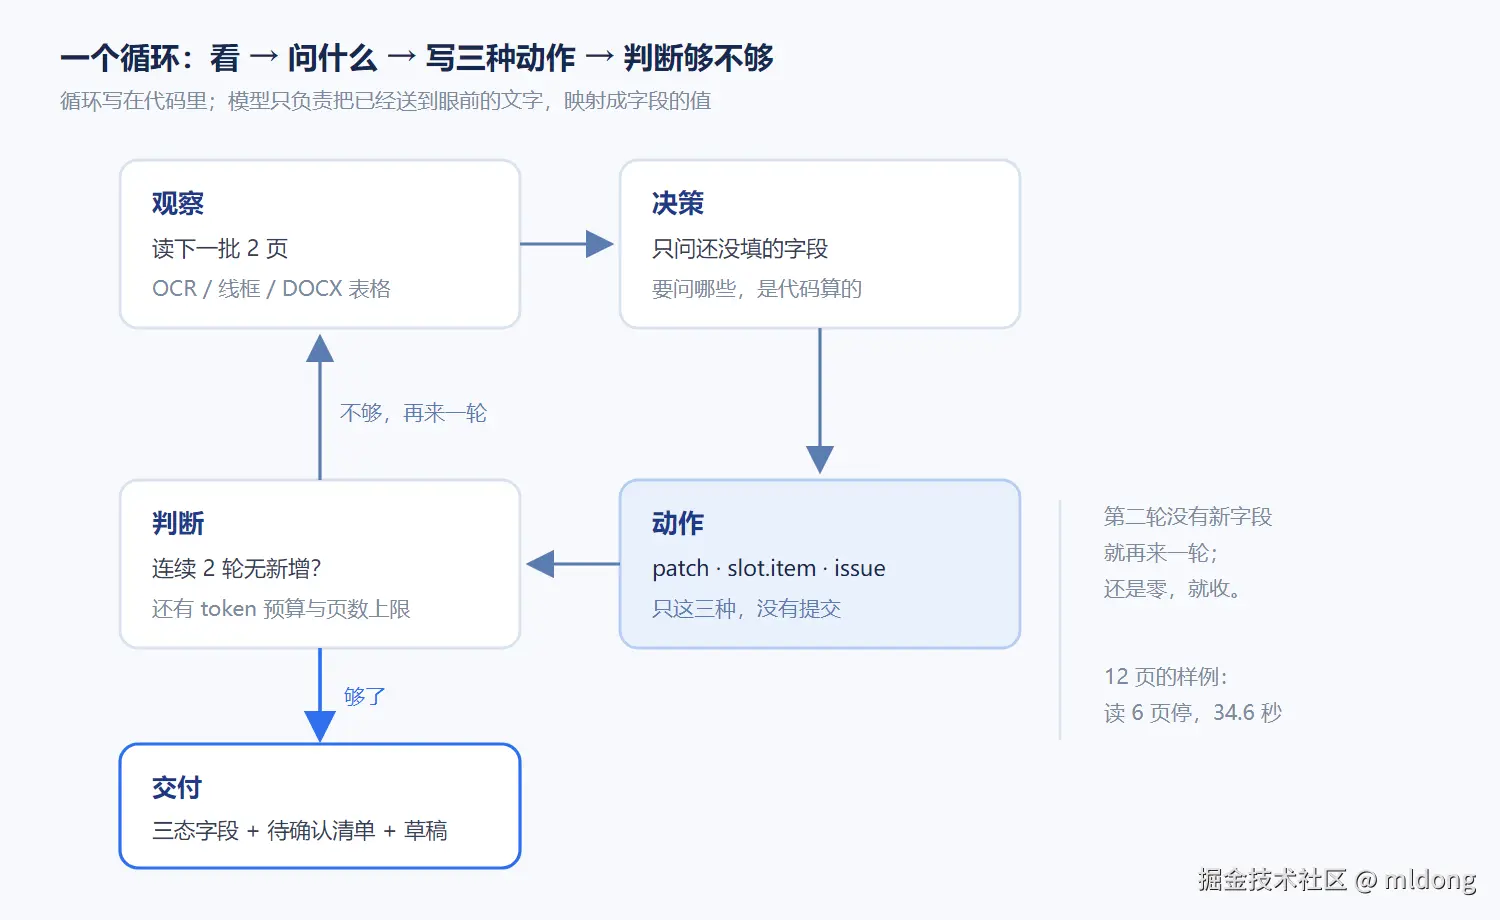
Agent 是一个循环:观察环境 → 决定下一步 → 执行动作 → 判断够不够,不够就再来一轮。
按这个定义,一次问答不是 agent(没有循环),写死步骤的流水线也不是(下一步与观察结果无关)。至于 coding agent,它是这个循环里动作空间最大的一类------大到能删文件、能推代码,所以必须配沙箱和人工确认。
这个录入 Agent 的循环,简化后大概长这样:
python
看到的 = ""
已填 = {}

while True:
    新页 = 读下一批(2 页)                 # 观察:OCR / 读 DOCX 表格
    看到的 += 新页
    要问的 = [f for f in 字段 if f not in 已填]   # 决策:只问没填的
    结果 = 模型(字段说明 + 看到的 + 已填状态)
    for 值 in 结果:
        if 有出处(值) and 校验通过(值):     # 动作:只允许写三种东西
            写进表单(值)
        else:
            记一条待确认(值)
    if 连续两轮没有新增:                     # 停止
        break
这段代码有两个地方值得停一下。
第一,"要问的"是代码算出来的,不是模型决定的。模型没有规划权,它只负责把已经送到眼前的文本,映射成字段的值。
第二,循环是否继续,取决于上一轮的结果 ------这不是写死的批次。你在代码里看到的 连续两轮没有新增,就是下面第六节要讲的停止条件。
二、观察:模型看到的世界,是工具给的
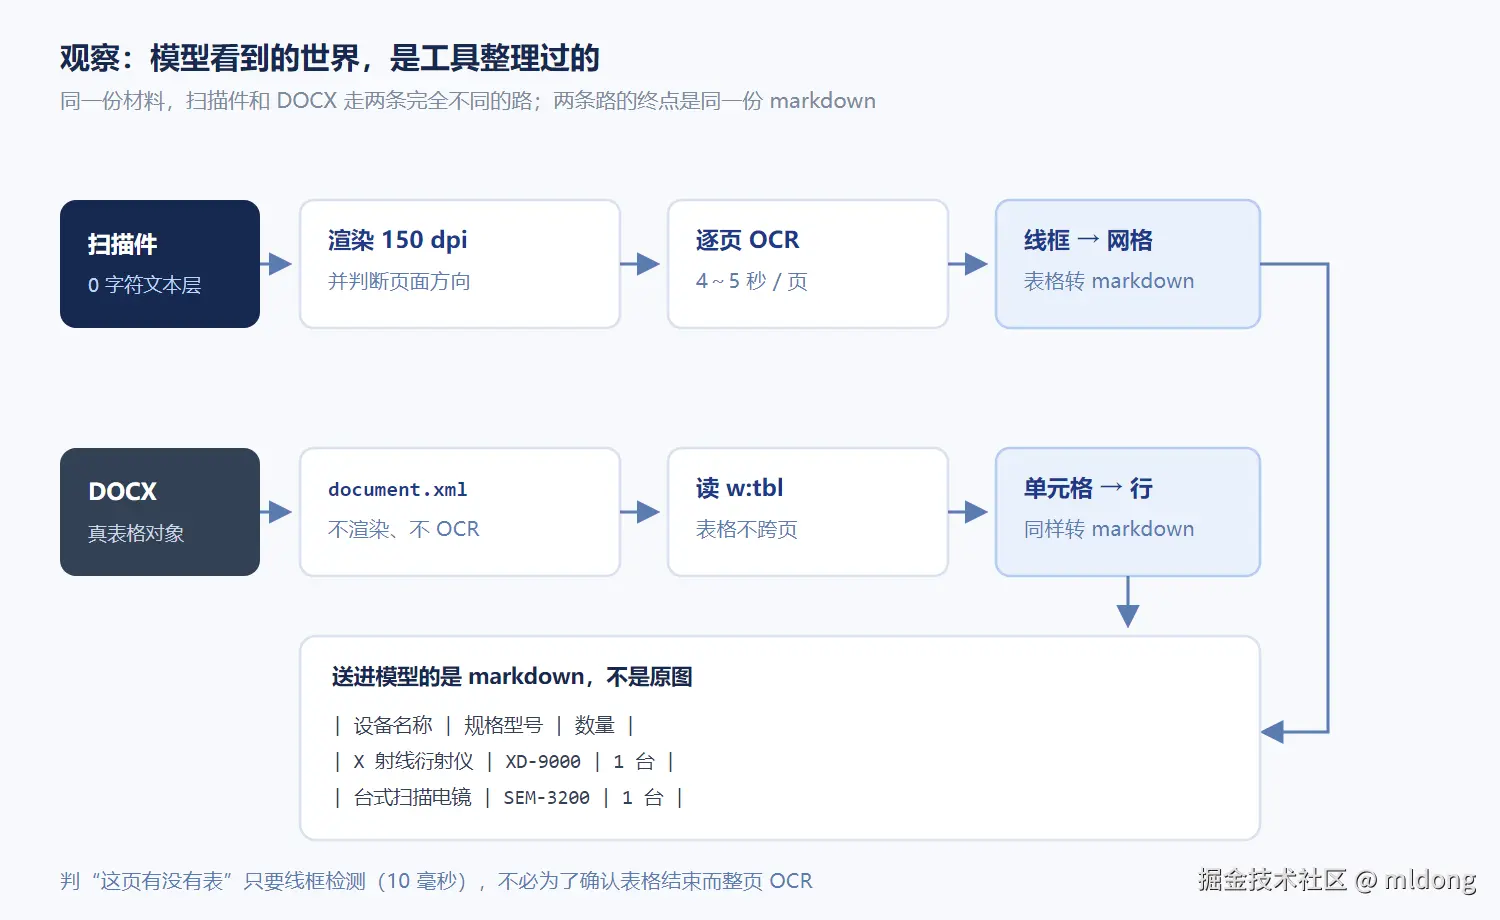
这份演示用的扫描件,第一页的文本层是 0 个字符------它就是一页图。所以观察的第一步不是把文件丢给模型,而是:
- 按 150 dpi 把页面渲染成图;
- 逐页 OCR,拿到文字和坐标;
- 用坐标还原出标题、段落、表格。
在这台 8 核机器上,一页扫描件的 OCR 要 4~5 秒,是整条链最贵的一步。所以有两件事必须省着做:
- 判"这页有没有表格",只用线框检测(10 毫秒左右一页),不用整页 OCR;
- 判"表格段结束了",也只看下一页有没有线框------一张不定长的团队成员表,不能为了确认它结束而把后面每页都 OCR 一遍。
同一份内容,如果来源是 DOCX,路径就完全不同:表格是真正的 w:tbl 对象,直接读,不跨页,不走 OCR。本文这份虚构申报表,DOCX 版端到端 17.5 秒,扫描件版(2 页)26.3 秒,差的就是 OCR。
表格送进模型时也不是原图,而是还原后的 markdown:
| 设备名称 | 规格型号 | 数量 |
| X 射线衍射仪 | XD-9000 | 1 台 |
| 台式扫描电镜 | SEM-3200 | 1 台 |
行列关系用 markdown 保住了,模型不需要"看"表格,只需要读表格。合并单元格多的键值表,网格会检不全,所以还留了一条宽松阈值的兜底通道------先按严格阈值检,检不到再放宽,但要看文字是否大部分落在网格内才采用。
这里有一条很实在的经验:模型看到的世界,是工具处理过的世界。工具没整理干净的部分,模型再强也补不回来。 所以第一个该优化的地方通常不是换更大的模型,而是把观察层的工具做对。
三、决策:只让模型做一件事------映射
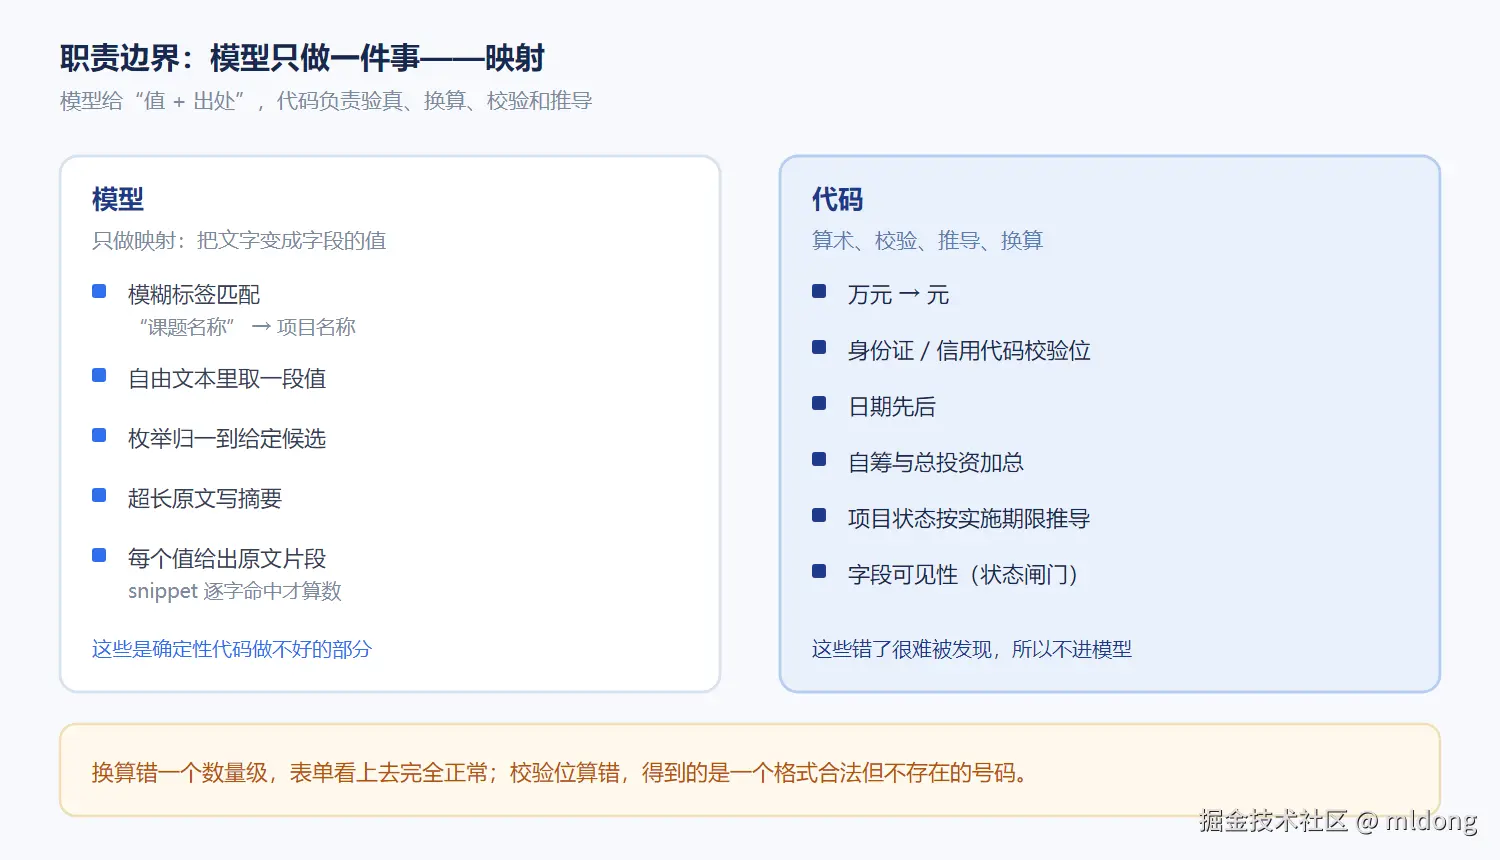
这个 Agent 里,模型的职责被压到只剩一件事:把文档里的文字,映射成表单字段的值。
听起来少,但它正好是确定性代码做不好的那一块:同一份材料,有的写"项目名称",有的写"课题名称";金额有的标"万元",有的只在表头写一次单位;日期有"2026 年 9 月 12 日",也有"2026-09-12"。
反过来,下面这些一律不进模型:
| 交给模型 | 留在代码里 |
|---|---|
| 模糊标签匹配("课题名称" → 项目名称) | 万元 → 元的换算 |
| 自由文本里的一段值 | 金额有效性、负数检查 |
| 枚举归一(在给定候选里选一个) | 身份证校验位、信用代码校验位 |
| 超长文本的摘要 | 日期先后、自筹与总投资加总 |
| 项目状态按实施期限推导 |
不是不信任模型,是这类事情错了很难被发现:换算错一个数量级,表单看上去完全正常;校验位算错,得到的是一个格式合法但根本不存在的号码。
模型这一层还有两个细节:
- 每轮只问"还没填的字段"。 已填的字段会在提示词里以
<已填>列出,但不再提问。这样模型每一轮的任务量随进度递减,不会越问越飘。 - 输出的 key 被 schema 约束成枚举。 如果不约束,模型会拿中文标签当键返回------
"项目名称"而不是project_name,下游直接对不上。
四、动作:只有三个
这是这篇文章的核心。翻一遍这个服务的接口清单,你会发现它没有"提交"这个动作:上传、建运行、看事件、取消、存草稿------到此为止。
在整个运行过程中,Agent 能写的只有三种事件:
| 动作 | 事件 | 干什么 |
|---|---|---|
| 改一个字段 | patch |
写值,或者显式置空并给出原因 |
| 加一行 | slot.item |
往设备明细、联系人这类结构化槽位里加一行(或一个对象) |
| 记一条问题 | issue.added |
"这个字段我留空了,原因是......" |
其余事件(stage、coverage、llm.call.*、draft.preview)都只是播报,不改任何数据。
一份 12 页的虚构样例跑一遍,三种动作的真实计数是这样:
patch 17 条 · slot.item 9 条 · issue 1 条(slot.item 9 条里只有 3 条是"新东西"------2 行设备和 1 个联系人,三轮各推了一遍。流式推送不做去重,最终以 patch 里去重后的完整数组为准,这是协议里写死的约定。)
为什么动作要卡这么死?
因为动作空间就是风险面。coding agent 之所以敢跑 rm,是因为外面有容器和快照兜底;而业务系统里的 agent 没有这层兜底------它写进去的是一条真实记录。动作越少,每一种动作的语义越清楚,出错时的爆炸半径越小:
- 它不能提交,所以不存在"AI 把一条错数据送进审核流";
- 它不分配机构 ID,单位名到机构节点的解析在代码里做,解析不到就标
unconfigured,不会凭空造一个不存在的单位; - 它不自行判断关键状态------比如项目状态由实施期限在代码里推导,不是模型说了算。
代价也很明确:这个 Agent 的能力上限被这套动作钉死了。 它做不了开放式调研报告,因为它连"写一段总结到任意位置"这个动作都没有。
五、证据:每个写动作都要能被机器复核
动作少,不代表不会错。所以每一条写动作都要带证据------而且这个证据必须是机器能复核的,不是模型自己说"我很有把握"。
规则只有一条,但很硬:模型给出的 snippet,去掉空白后必须能在原文里逐字命中。
命中不了会怎样?
| 情况 | 处理 |
|---|---|
snippet 逐字命中 |
进入校验层 |
snippet 命中不了 |
置信度降为 medium,字段标"待核对" |
金额、日期没给 snippet |
直接降级 |
| 枚举字段(如项目级别)给了候选之外的值 | 先按映射表归一,归一不了就降级 |
| 值为空 / 文档里没有 | 留空,并生成一条待确认 |
于是一个字段最终只有三种状态:
- 已填:语义明确,值带出处;
- 待核对:填了,但出处对不上、枚举靠推断,或校验没过;
- 留空:没有把握,附一条原因,等人补。

界面顶部就是这四个数:15 已填、1 待核对、1 按规则留空、0 项必填待补。它不告诉你"AI 很聪明",只告诉你"哪些能直接用、哪些要你看一眼"。
本文这次运行里,17 个字段的结果是 15 已填、1 待核、1 留空。留空的那条原文是"备注"字段,原因写得很直白:
remark / 需人工填写一条真实的字段补丁长这样:
json
{
  "key": "device_project_name",
  "label": "采购项目名称",
  "value": "高精度材料分析平台一期建设",
  "fill_state": "filled",
  "confidence": "high",
  "extractor": "llm",
  "source": { "snippet": "采购项目名称:高精度材料分析平台一期建设" }
}
这段 snippet 在 OCR 出来的原文里逐字存在,所以它可以被标成"已填",出处也可以给用户看。编造的数字在这里会当场露馅------原文里根本没有这一串,就过不了闸门。
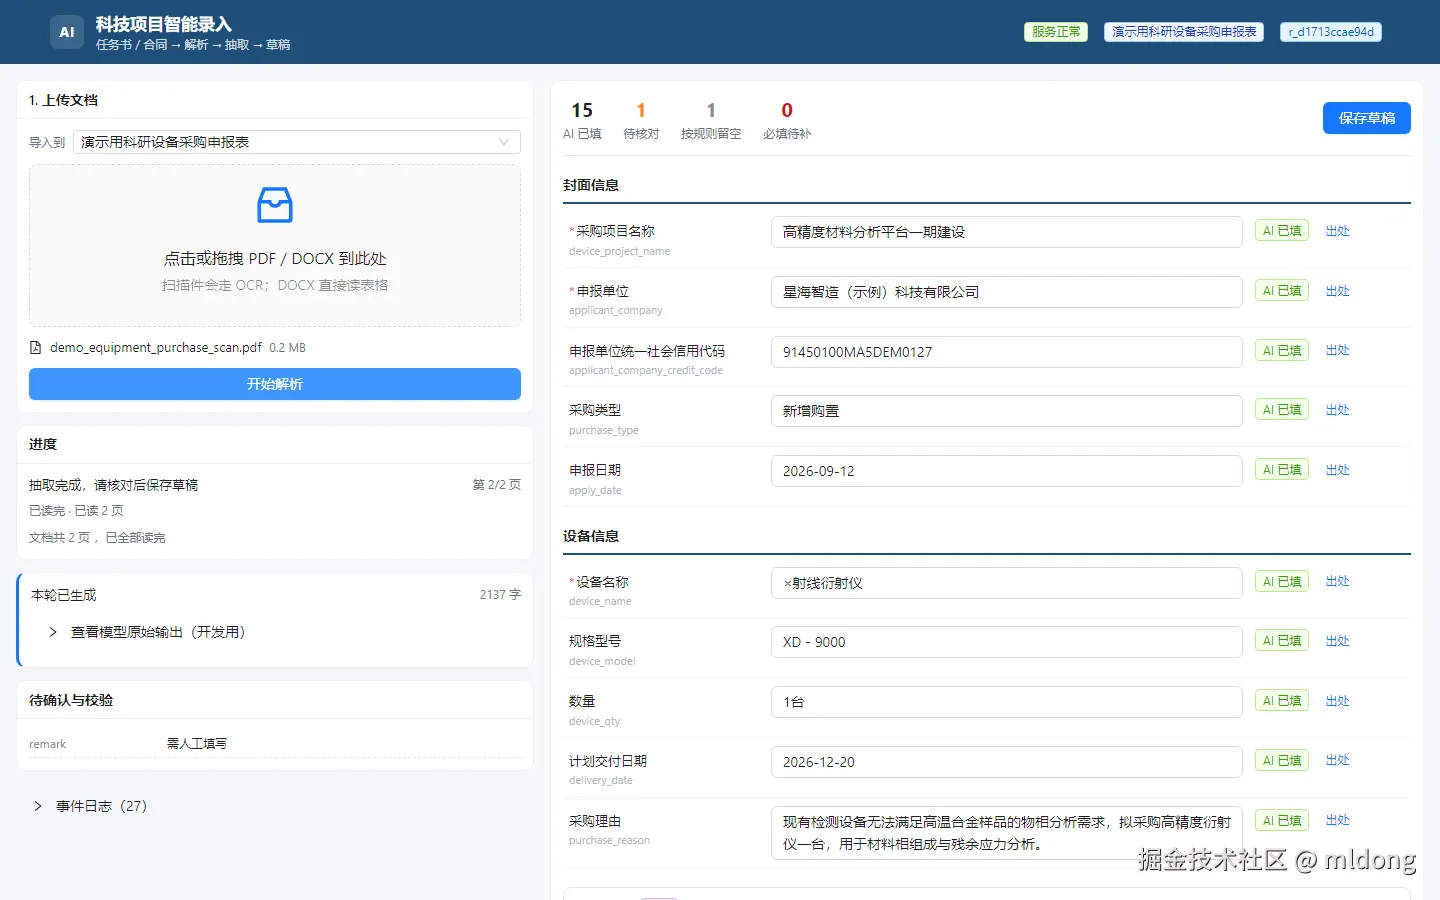
每个字段右侧的"出处"点开就是 snippet;左侧"待确认与校验"里躺着那条留空的备注。填完的表单和"哪里没填、为什么"是同时交付的。
这套东西的价值不在于"模型不会错",而在于错了会被抓住:抓不住的那些,正好落在"待核对"里,由人来看。
六、停止:没有停止条件的 Agent 是死循环
再看第一节那段伪代码的最后一行:连续两轮没有新增就停。
这句话背后是三道条件同时生效:
- 饱和:连续 2 轮没有新增字段;
- 预算:累计输入 token 超过上限;
- 安全阀:页数上限,只防异常文档。
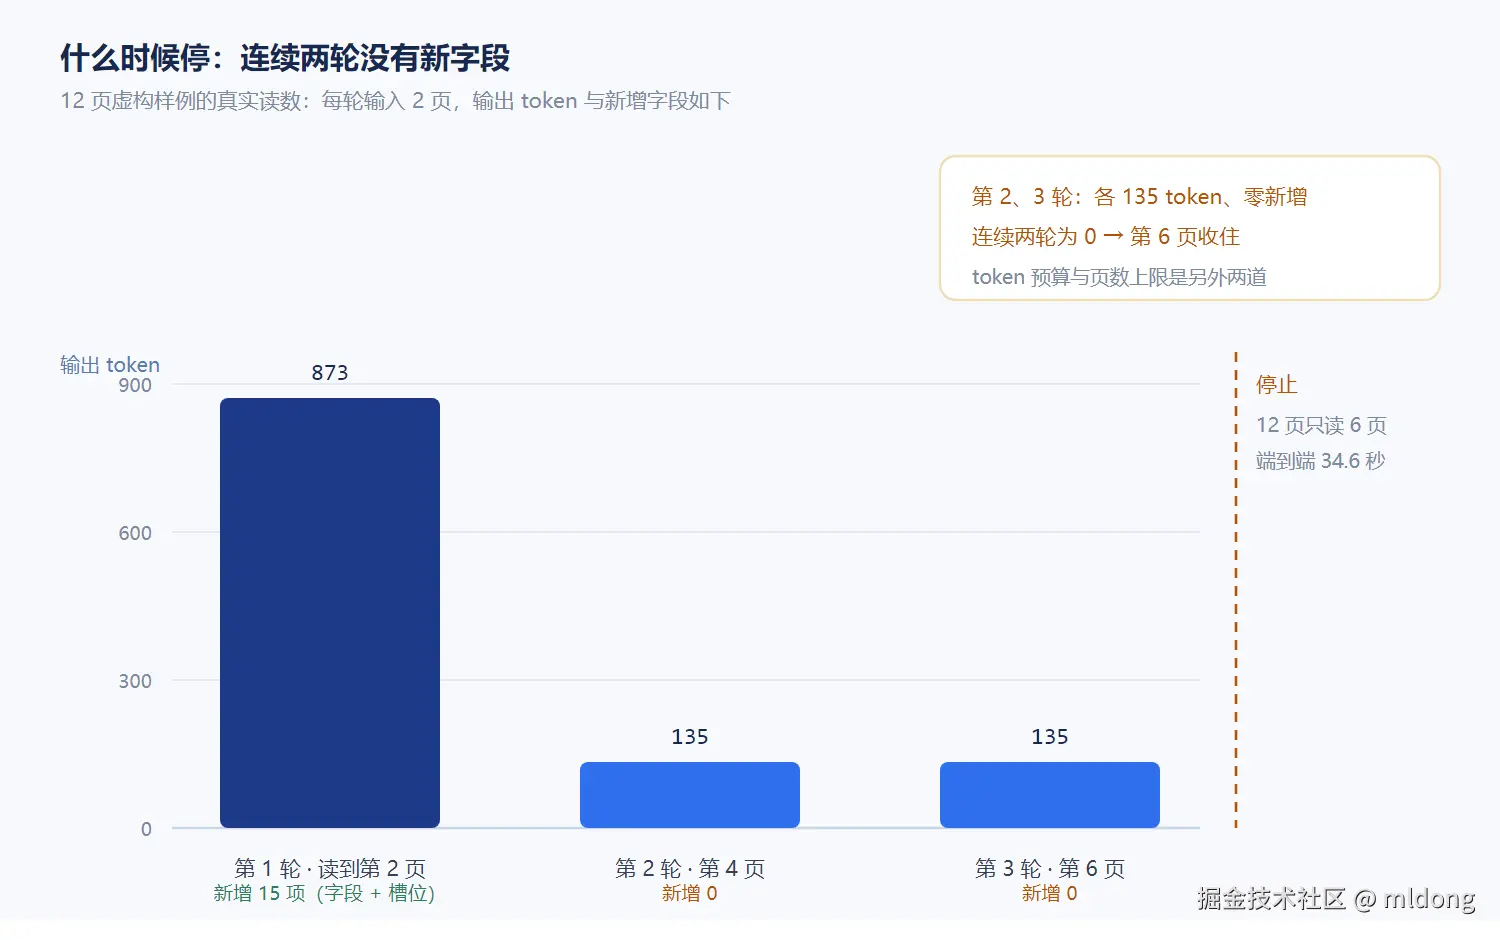
为什么要有饱和判断?因为信息在文档前几页就已经基本取完了,后面的附件、盖章页、归档页对字段没有增量。实测一份 12 页的虚构样例(2 页演示内容 + 10 页虚构附页,专门用来压停止条件):
| 轮次 | 读到第几页 | 输入 token | 输出 token | 耗时 | 新增字段 |
|---|---|---|---|---|---|
| 1 | 2 | 1056 | 873 | 16.3 s | 全部 |
| 2 | 4 | 1114 | 135 | 5.0 s | 0 |
| 3 | 6 | 1170 | 135 | 3.3 s | 0 |
第 2、3 轮各只花了 5 秒和 3 秒、输出 135 个 token,什么也没加。连续两轮为 0,于是停在第 6 页------12 页的文档,后 6 页一页都没读,端到端 34.6 秒。
如果不设饱和判断,按页数硬读到底,代价是:翻倍的时间、翻倍的输入 token,换回来零个新字段。
但早停有一个必须付出的代价:你得告诉用户"你只读到哪儿"。 否则用户会默认"表单里没填的字段,就是文档里没有"------这两件事完全不是一回事。所以每次运行结束都要发一条覆盖率:
json
{"pages_scanned": 6, "pages_total": 12, "early_stopped": true}读了几页、总共几页、是不是提前停的,一条都不能省。
七、人在回路:责任要落在一个具体按钮上
最后一块是交付边界。
这个 Agent 的产物不是"一条已经提交的记录",而是一组字段补丁 + 一份待确认清单。用户点"保存草稿",草稿落在系统里,然后该补的补、该核的核,选审核人,提交。
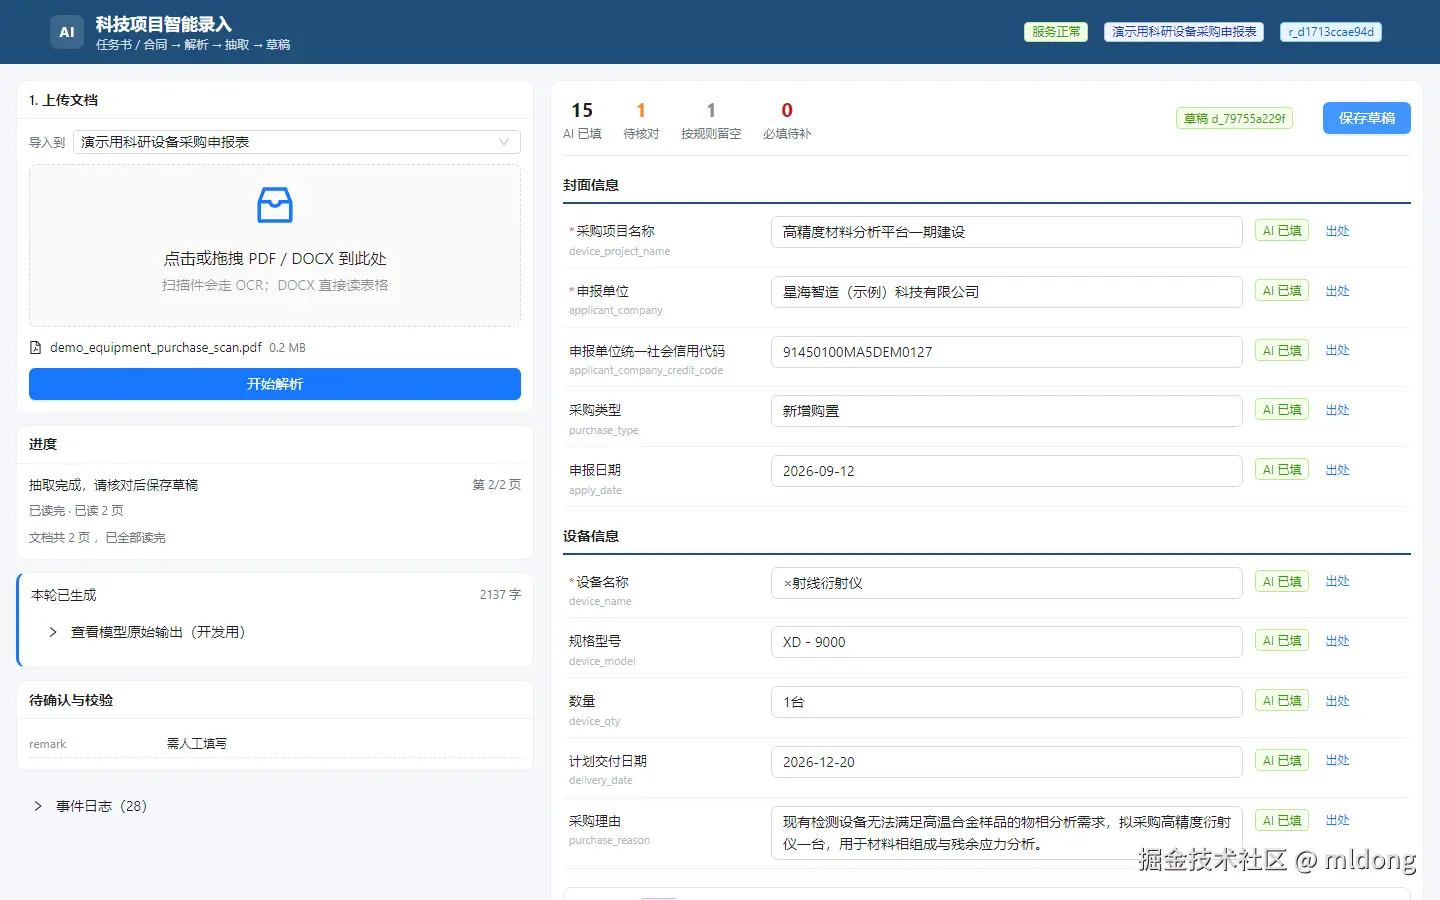
"保存草稿"是这个 Agent 能碰到的最后一个动作。它拿到一个草稿 id,并告诉你还差 0 项必填;至于审核人是谁、什么时候提交,它不参与。
为什么停在草稿?因为业务上提交流程要求选审核人,而草稿只有本人可见------AI 填错的字段不会污染单位数据,也影响不到别人。反过来,如果让 Agent 直接提交,等于让一个不承担责任的程序替人选了审核人。
"人在回路"经常被理解成在流程末尾加一个确认弹窗。但真正起作用的不是弹窗,是责任落在一个具体动作上:保存草稿和提交审核是两个不同的按钮,对应两种不同的责任。Agent 只被允许碰第一个。
这和给 coding agent 配沙箱是一个思路:不是靠"请确认"的提示语约束它,而是让它根本没有那个动作。
八、什么业务适合做成这种 Agent
把上面六节收一下,可以落成四条判据:
- 结果有明确形状:一张表单、一张表、一组字段清单------错了你能一眼指出来;
- 中间步骤能拆成确定性工具:OCR、线框检测、正则、校验位、换算,这些越厚,模型需要发挥的空间越小;
- 错了能被抓住:每个值都能给出处,每条留空都能给原因;
- 责任链清楚:谁保存、谁审核、谁入库,每个动作都有明确的人接住。
反过来,如果结果是开放式的(一份调研报告),或者动作必须跨系统写(下单、发款、改配置),或者关键判断只能靠模型(金额、状态、审批人),这个形态就不合适------动作空间一放大,前面三节的保证全部失效。
Agent 的能力上限,很多时候不取决于模型有多大,而取决于三件事:你给它多大的动作空间、多硬的停止条件、多容易被抓住的证据。 把这三样收窄,模型才有机会在业务里干真活。
本文的演示样例由脚本生成,单位、人员、金额、编号均为虚构;文中耗时、轮次与字段计数均为 2026-10-26 本机实测。下一篇拆观察层:为什么表格不该交给大模型读。