💡 一句话总结:Virginia Tech 团队解剖了 3211 条失败的多智能体辩论轨迹,发现 94.9% 的失败不是"答错"而是"救不回来"------正确答案明明出现过,却被团队讨论活活投死。这篇论文给的是一套通信失败分类法 + 四条设计建议,做 agent 编排的工程师都该看看。
导语:你肯定见过这场面
先问一个可能戳到你的问题:你有没有过这种经历------把同一个任务分给三个 agent 辩论,第一轮明明有个 agent 给出了正确答案,结果两轮讨论之后,系统最终输出的却是个错的?
更气人的是,你回头翻日志,发现那个答对的 agent 在第二轮被同伴"说服"了,主动放弃了自己的正确答案,跟着大部队一起往沟里走。你盯着屏幕,很想冲进日志里喊一句:你们仨刚才谁是对的,自己心里没数吗?
对,就是你想的那个坑。多智能体辩论(Multi-agent Debate,让多个 LLM 互相批评修正来提升推理质量)这个思路听起来很美------三个臭皮匠顶个诸葛亮嘛。但凡是真跑过这套东西的人都知道,有时候三个臭皮匠商量完,连第一个臭皮匠本来答对的题都能改错。
为什么会这样?失败到底发生在哪一步?是第一轮就答错了,还是讨论过程中被带偏的?如果你答不上来,不是你的问题------因为这个领域的失败分析,长期以来只有一个数字:最终准确率。它只告诉你系统挂了,不告诉你尸体是在哪一轮、被谁、以什么方式弄死的。
Virginia Tech 的这篇新论文 Understanding Communication Failures in Multi-Agent LLM Systems 干的就是"验尸"的活:他们收集了 3211 条失败的多轮辩论轨迹,横跨医疗问答、代码生成、金融、多跳推理、伦理判断等八个数据集,把"agent 之间怎么聊死的"做成了第一个以通信为中心的失败分类法。
想自己动手试?
- 📄 论文:arXiv 2610.32060
- 📊 数据集:FinQA / HotpotQA / MBPP / MMLU-Pro / MedQA / MuSiQue / Ethics / LiveCodeBench(均为公开基准)
这篇论文到底想解决什么问题?
在讲这篇论文之前,先看看前人都做到哪了。
多智能体失败分析这个方向,2025-2026 年已经有一波工作:MAST 回答了"为什么多智能体系统会失败"(系统设计、智能体错位、验证薄弱三类根因);TRAIL 做轨迹级失败定位;还有一系列归因工作专门找"哪个 agent、哪一步出的错"。
那这篇论文的贡献在哪?作者的观察很刁:这些工作都把失败定位在"某个 agent 内部",但多智能体的失败经常发生在 agent 之间。
什么意思?举几个论文里的真实模式:
- 一个正确的少数派答案,因为只有一个人支持,被多数派投票抹掉了;
- 一个错误的问题理解(错误框定),从第一轮一直存活到最后一轮,中间有人纠正过但没人理;
- 团队第二轮就达成了错误共识,之后工具返回了打脸的证据,没人看。
这些失败的共同点是:单独看每个 agent 都没毛病,毛病出在"聊天"这个动作本身。最终准确率这个数字对此完全失明------它只知道系统错了,分不清错误是首轮推理带来的,还是同伴压力、恢复失败、聚合环节搞出来的。
所以论文的研究问题可以概括成一句:多智能体系统的失败,在"通信层面"有哪些可复用的模式?这些模式能不能提前检测?
它的思路是什么?
整个研究分三步:先收集尸体(失败轨迹),再建分类法(验尸报告模板),最后证明分类法有用(做实时预警)。
第一步,收集失败轨迹。 作者用 7 个开源模型(LLaMA-3.2-3B 到 GPT-OSS-120B)在 8 个数据集上跑了 7300 个多智能体辩论任务,其中 3543 个以错误告终。他们筛出其中"多轮才失败"的 3211 条------注意这个筛选很关键,只挂一轮的失败说明是模型本身不行,跟"聊天聊死的"无关。
第二步,构建失败分类法。 这是最有意思的部分。他们没有让 LLM 自由发挥想标签,而是走了"证据绑定"的路线:
- 每条失败轨迹先被压缩成一张"证据卡"------失败行为摘要 + 候选标签 + 必须附上的轨迹原文证据;
- 自顶向下给定 6 个父维度:推理/任务理解、通信/审议、共识/决策、恢复/纠正、协调/编排、工具/证据使用;
- 自底向上:映射不进去的标签,用文本嵌入聚类自动生成新子标签,过大的叶子继续细分,直到收敛。
最终得到的分类法有 6 个父类、24 个子标签、11 个叶子。人工验证的结果相当扎实:93.4% 的人类盲标注错误能映射进这个分类法,自动标签与仲裁后人工标签的 micro-F1 达到 0.91(父级)。
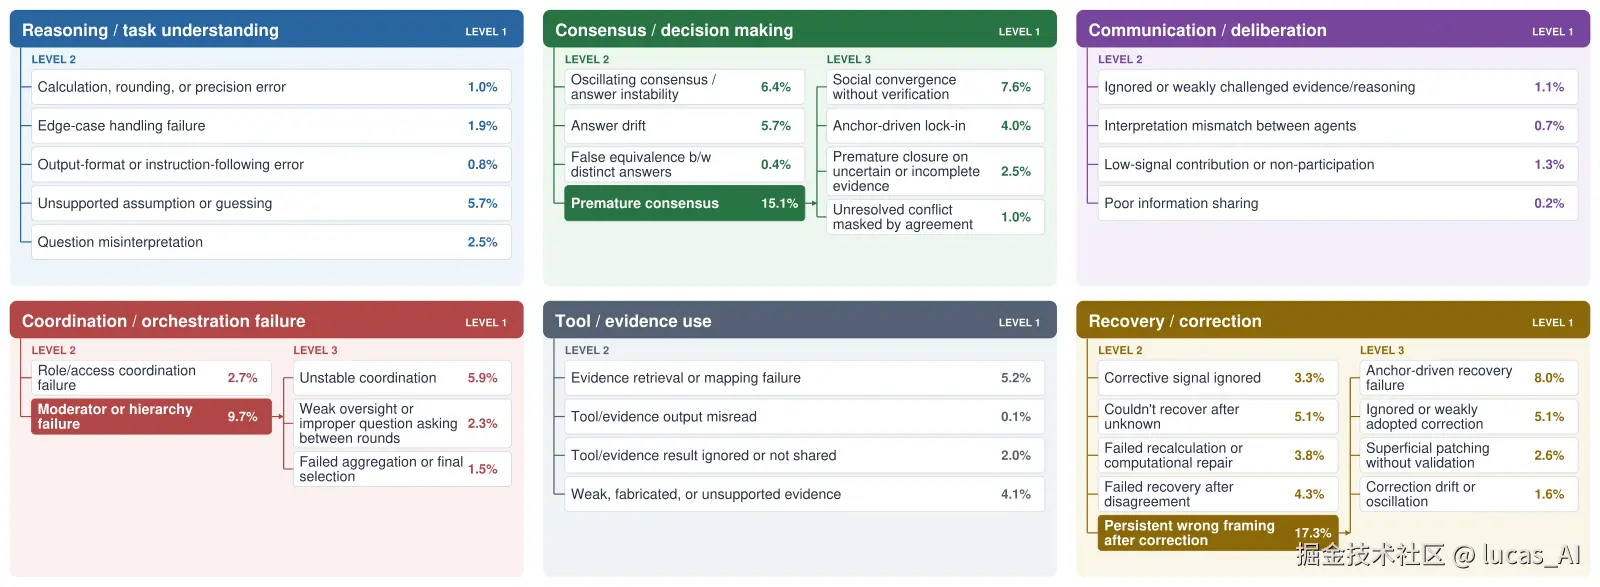
图说:完整的 AgentInteractError 分类法,从 6 个父类到 11 个叶子标签。注意"恢复/纠正"和"共识/决策"两个分支------后面你会看到,绝大多数失败都挂在这两棵树上。
第三步,做实时预警触发器。 作者训练了一个随机森林分类器,在每轮辩论结束后预测"下一轮会不会出事"。这里有个工程上很妙的取舍:特征完全不用消息文本,只用答案动态------分歧度、答案变化次数、共识振荡、自报置信度。不读文本意味着这个监控器便宜、快,可以插到任何编排框架上逐轮轮询。
那效果怎么样?往下看。
效果到底怎么样?
论文里数字很多,我挑三个最值得记住的。
第一个数字:94.9%。 失败轨迹里,94.9% 都包含"恢复/纠正失败"------也就是说,绝大多数失败不是"从头错到尾",而是中途出现过正确答案或有效纠正,但系统没能抓住。83.4% 的失败轨迹包含共识/决策问题。这俩才是主要死因,首轮就答错的"原生错误"反而是少数。
第二个数字:7.5 倍。 作者拿 500 条成功的多轮轨迹做对照,做了一个非常漂亮的对比分析:在"结果盲评"(标注员不知道最终对错)的条件下,91.2% 的成功轨迹里同样存在错误------推理类错误在成功和失败轨迹中的比例恰好都是 1.0 倍,工具/证据类也是 1.0 倍。
那差别在哪?看这张表:
| 错误类型 | 成功轨迹 | 失败轨迹 | 倍数 |
|---|---|---|---|
| 推理 | 0.35 | 0.35 | 1.0× |
| 工具/证据 | 0.39 | 0.38 | 1.0× |
| 恢复/纠正 | 0.37 | 0.94 | 2.6× |
| 协调/编排 | 0.14 | 0.53 | 3.6× |
| 过早共识 | 0.20 | 0.71 | 3.5× |
| 错误框定延续 | 0.08 | 0.60 | 7.5× |
成功的团队不是不犯错,而是犯了错能救回来;失败的团队不是错得多,而是错了救不回来。"错误框定延续"(一开始对问题的理解就歪了,且全程没被扭回来)在失败轨迹里是成功轨迹的 7.5 倍------这是全文我最在意的一个数字。
第三个数字:74.6% → 36.4%。 什么设计真能降失败?作者做了严格的因果分析(问题固定效应 + 多重校正),结果非常打脸:
- 把 agent 从 3 个加到 7 个:失败率没有显著下降。推理错误是少了,但"弃答后没救回"和"正确少数派被压制"反而多了;
- 给 agent 加层级(主持者):只减少共识振荡,总失败率不变;
- 给 agent 指定显式角色:没有可检测的效果;
- 接入检索证据(让 agent 能查资料):HotpotQA 和 MuSiQue 上的失败率从 74.6% 砍到 36.4%。
给钱不如给装备。你想靠人海战术堆 agent,不如老老实实给团队接一个搜索引擎。
还有两张图值得单独看。先是逐轮错误动态:
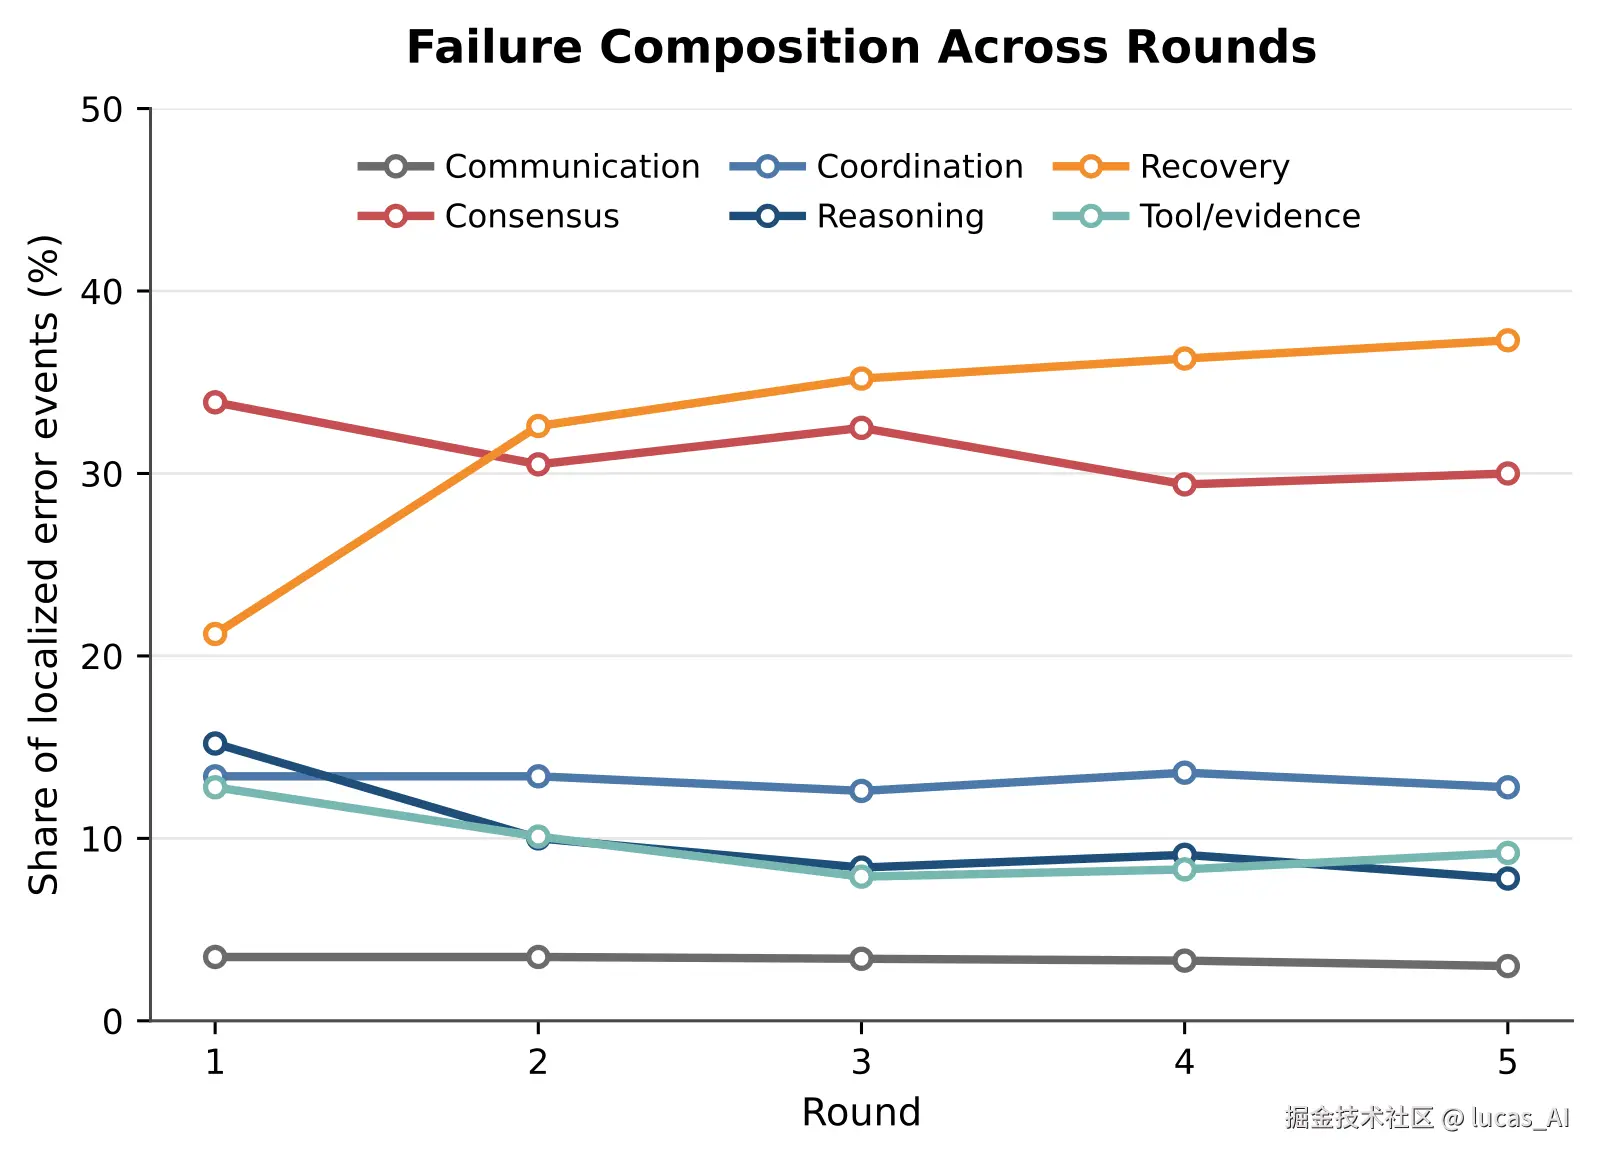
图说:每一轮的失败构成在变。第 1 轮以推理、框定类错误为主;第 2 轮(agent 首次看到同伴回答后)共识类错误占比明显抬头;后面几轮恢复类失败越来越多。第 2 轮是整个辩论的分水岭。
再看数据集维度的失败签名:
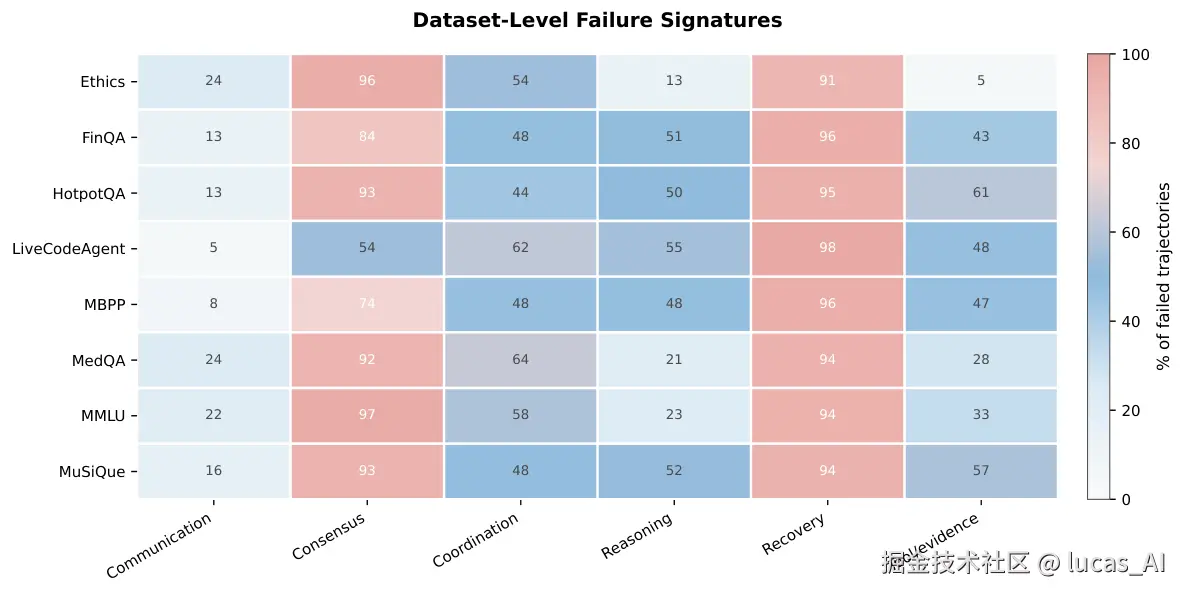
图说:不同任务类型的失败" signatures "不一样------问答类任务(HotpotQA、MMLU)偏共识失败,代码、金融、多跳推理任务则冒出更多推理与工具使用失败。这也解释了为什么没有放之四海皆准的修复方案。
以及最顽固的错误排行:
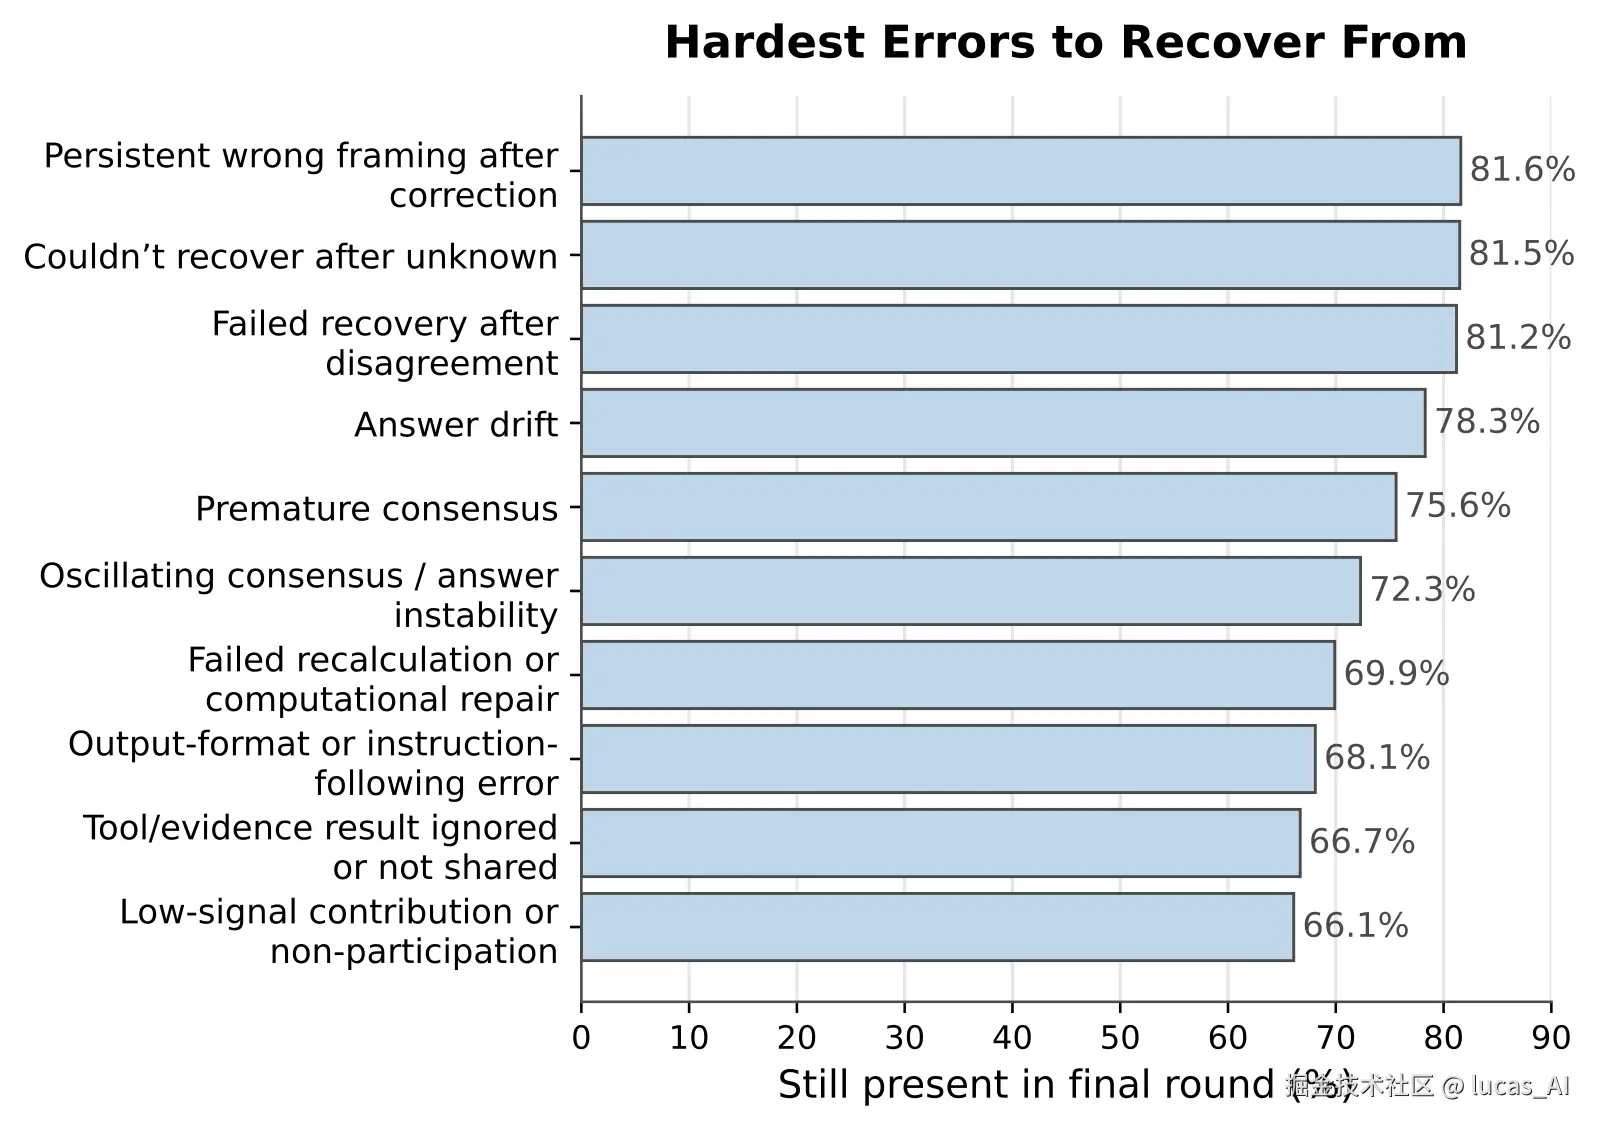
图说:把"在辩论中途出现过的错误"按"是否存活到最后一轮"排序。错误框定延续、振荡共识、未知后未恢复这类群体动力学错误最顽固------一旦出现,多半会陪跑到终局。
为什么第 2 轮这么危险?因为这是 agent 第一次看到彼此的答案。从这一轮起,错误就不再属于个人,而开始属于团队------一旦错误的多数派形成,后续讨论往往是在强化它而不是纠正它。
论文还用错误级联分析证明了一个恶性循环:过早共识之后,工具结果被忽视的概率提升 2.79 倍;反过来,忽视工具结果之后,有 70.7% 的概率滑向过早共识。团队提前闭嘴,打脸的证据就没人看;没人看证据,团队就更有底气提前闭嘴。
最后是预警触发器的成绩:提前一轮预测"未知答案后未恢复",AUROC 达到 0.96;预测"过早共识"是 0.75。对比之下,作者测评的 LLM judge 在前两类错误上基本是抛硬币(AUROC 0.57)。团队讨论的"形状"比讨论的"内容"更能预测失败------这个发现对做 agent 监控的人来说信息量很大。
为什么你要关心?
如果你在做(或打算做)多智能体系统,这篇论文有四条可以直接抄进设计文档的建议。
别信自报置信度。 论文附录的数据显示,agent 答错的时候置信度照样往上涨。所以"哪个 agent 自信就听谁的""没信心就继续辩"这类策略都是在给错误共识铺路。置信度只能当参考信号,不能当决策依据。
主动监督替代简单多数投票。 多数投票是少数派杀手------论文数据里,初始正确的少数派只有 5.78% 最终翻盘,13.5% 被直接压制。监督者应该干的是质疑没有证据支撑的主张、追踪分歧点、验证互相竞争的答案,而不是数人头。
按任务类型配验证。 数值任务配计算复核,代码任务配边界用例测试,多跳问答配证据核对,伦理类任务要给正确的少数派答案额外保护。没有通用银弹,每个任务的"救回机制"长得不一样。
按错误类型定向干预,别无脑加轮次。 过早共识要触发证据核查,错误框定要强制重读题,共识振荡要裁决冲突答案。论文证明"多辩几轮"经常是在强化错误而不是修复错误------更辩论不等于更正确,何时该终止和何时该继续一样重要。
落到实操:哪怕你只 takeaway 一件事,我建议是给你的编排框架加一个逐轮的"分歧度 + 答案振荡"监控------它不读文本、成本极低,却在论文里做到了最高 0.96 的 AUROC。这是全文性价比最高的一个工程点子。
理性看待
有几个坑得提前说明。首先,实验的 agent 阵容以 3B--14B 的中小开源模型为主(最大 GPT-OSS-120B),弱模型更容易互相带偏------前沿强模型之间辩论是否呈现同样的失败构成,论文没给数据,那些具体比例(94.9%、7.5 倍)不宜直接外推到你的 GPT-6/Claude 编排里,定性结论(恢复与共识是主要失败面)更可信。其次,语料全部来自"答案交换 + 投票/主持者"这类辩论式协作,论文作者自己承认:GAIA 式重工具任务、共享黑板协作、长周期文件交互这些形态不在覆盖范围内,那些场景的通信失败可能完全是另一套模式。触发器目前也只是研究原型,逐轮轮询的延迟成本没有报告。把它当诊断工具和设计参考,别当保命符。