本文为《昇腾 910C 大模型推理优化实践》下篇。上篇已覆盖昇腾 910C 的软硬件环境、性能基线与瓶颈分析,以及无需改动源码的镜像升级与参数调优。本篇承接上篇,继续深入 vllm-ascend 源码修改、算子层优化与 MTP 投机解码,并给出优化前后的完整性能对比与方法论总结。
一、优化实践(二):vllm-ascend 源码修改
参数调优见顶之后,我们深入 vllm 与 vllm_ascend 源码,围绕上篇定位的瓶颈做了一系列修改。
MoE 共享专家多流重叠(multistream_overlap_shared_expert)
动机与原理
MoE 层的标准执行顺序是:routed experts(GroupedMatmul)→ shared expert → AllReduce,三者串行。分析发现两个问题:
-
shared expert 的计算与 routed experts 没有数据依赖,完全可以并行。
-
在 MC2 通信模式下,maybe_all_reduce_tensor_model_parallel 对 MC2 是 no-op,shared expert 的 AllReduce 是唯一的通信开销,同样可以与计算重叠。
优化思路: 把 shared expert 放到独立的 side stream(shared_experts_calculation_stream)上,与 default stream 上的 routed expert 并行;shared expert 的 AllReduce 也留在 side stream 上,最后 default stream 等待 side stream 完成。
实现(vllm_ascend/ops/fused_moe/fused_moe_0_23_0.py)
改动集中在两处。第一处是 _forward_shared_experts:进入时用 npu_stream_switch 切到 side stream,shared expert 计算完成后不再切回 default stream 做 AllReduce,而是继续在 side stream 上完成 AllReduce。
Plain
    overlap_enabled = self.multistream_overlap_shared_expert and not get_forward_context().capturing
    with npu_stream_switch(shared_experts_calculation_stream(), enabled=overlap_enabled):
        shared_out = ...  # shared expert 计算(gate_up matmul + down matmul)
        if need_all_reduce:   # moe_comm_type in {ALLTOALL, MC2, FUSED_MC2} 且非 shared-expert-DP
            with torch.npu.stream(shared_experts_calculation_stream()):
                tensor_model_parallel_all_reduce(shared_out)   # AR 留在 side stream
            torch.npu.current_stream().wait_stream(shared_experts_calculation_stream())
bf16 非量化路径下,shared expert 的 part1(gate_up matmul)与 part2(down matmul)对同一 hidden_states 独立,不依赖 routed expert 输出,因此并行是安全的。
减少事件开销
并行化之后,routed 侧原先用于与 shared 侧同步的 dispatch/combine/gmm2 事件不再需要。继续保留这些 record_event/wait_event 会在每个 MoE 层产生额外开销。我们新增 forward context 标志 skip_dispatch_combine_events,在 overlap 路径进入前置位、退出后复位:
-
moe_comm_method.py,before_dispatch_evt、before_combine_evt 置 None;
-
moe_mlp.py,三处 before_gmm2_evt 置 None;
-
ascend_forward_context.py,extra_attrs 白名单加入该标志。
与 FUSED_MC2 共存及收益
上游代码中有一处互斥检查: VLLM_ASCEND_ENABLE_FUSED_MC2=1 时会强制把 multistream_overlap_shared_expert 置为 False。分析确认两者并不冲突(overlap 管计算流并行,FUSED_MC2 管通信算子融合),我们移除了该限制,使两项优化叠加生效。
收益汇总(均基于前序优化叠加): 初版的多流并行优化提升 0.3ms(c=1);shared expert 通过跳过冗余 event + shared expert 权重预取填补,再提升 0.2ms;最终未开投机解码时 c=1 TPOT 从 8.2ms 压到 8.0ms。
优化 decode host 侧开销
c=1 decode 时,每个 step 的 batch 结构几乎不变,但上游 model_runner 每步都无条件执行一大串 copy_to_gpu/fill_/commit 操作。这些拷贝虽标为 non_blocking,仍会插入多余的 host→device DMA、拉长异步流水。我们在 vllm_ascend/worker/model_runner_v1.py 中引入「上一轮状态」跟踪,结构不变就跳过:
-
lazy-init 跟踪变量 _prev_num_reqs/prev_total_tokens/prev_bt_checksum;
-
block table 提交,仅当 num_reqs==1 且与上一步相同时,用 block_table.np0.sum() 校验和判断是否变化,不变则跳过 commit_block_table();
-
尾部清零(seq_lens、query_start_loc、optimistic_seq_lens 的 fill)只在请求数收缩时执行;
-
discard_request_indices/mask、req_indices、query_pos、num_scheduled_tokens 的 copy_to_gpu 分别按「确有 discard / num_reqs 变化 / 总 token 数变化」条件化执行;
-
positions 计算路径重写,原来在 GPU 上用 index_select + cast + add 三个 kernel 现算,改为直接使用 CPU 侧已经算好的 pinned buffer,一次 H2D copy 完成(self.positions:n.copy(self._positions_cpu_buf:n, non_blocking=True))。
配套的还有 copy_snapshot_to_gpu 的 pinned staging 缓存改造(vllm_ascend/worker/utils.py):上游每次调用都 clone().pin_memory() 重新分配锁页内存,改为每个 buffer 复用一块预分配的 pinned staging,只拷数据不换内存。
Block Table 的 CPU 快路径
slot mapping 的计算(把每个 token 的逻辑位置映射到 KV Cache 的物理 slot),默认情况下,这个映射计算是在 NPU 设备上通过一个 Triton Kernel(_compute_slot_mapping_kernel)并行完成的。profile 发现 _compute_slot_mapping_kernel 在昇腾上固定约 131us 的 launch 开销------在解码(Decode)阶段,每次迭代通常只处理极少量 token(batch size 很小)。此时,为一个很小的计算任务去启动一个 NPU Kernel,其启动延迟可能远大于计算本身的时间,对这种只做简单整数运算的小 kernel,dispatch 开销远大于计算本身,小 batch 下不划算。
我们在 vllm_ascend/worker/block_table.py 的 compute_slot_mapping() 中加入 CPU 快路径:当未启动上下文并行且提供了 CPU 侧 positions 与 query_start_loc,且 num_tokens <= 80 时,positions 是每个 token 在序列中的绝对位置,query_start_loc 是每个请求在 batch 中的起始 token 索引,这两个数据在 Host 侧(CPU 内存)已有现成的 NumPy 数组,无需额外从设备拷贝回 CPU,因此可以直接使用,直接用 numpy 在 host 侧完成映射,再一次非阻塞 H2D 写回。
Python
req_idx    = np.repeat(np.arange(num_reqs, dtype=np.int32),
                       query_start_loc_cpu[1:] - query_start_loc_cpu[:-1])
pos_arr    = positions_cpu[:num_tokens].astype(np.int64)
pos_block  = pos_arr // self.block_size
pos_offset = pos_arr % self.block_size
block_ids  = self.block_table.np[req_idx, pos_block].astype(np.int64)
slots      = (block_ids * self.block_size + pos_offset).astype(np.int32)
self.slot_mapping.np[:num_tokens] = slots
self.slot_mapping.copy_to_gpu(num_tokens)      # 单次非阻塞 H2D
c=1~8 decode 的 num_tokens 恒小于 80,因此该快路径在目标场景 100% 命中,每步省下约 131us 的 kernel launch 与相关同步。 commit_block_table 也同步改为复用 pinned staging(_bt_pinned),避免每步重复分配锁页内存。
GDN(线性注意力)路径专项优化
Qwen3.5 的 30 层 GDN 是 decode 时间线上算子最密集的区域,原实现为:causal_conv1d → mixed_qkv 拆分(rearrange)→ l2norm → recurrent kernel,每层多个小 kernel,host 开销与 HBM 往返严重,我们从三个方向下手。
L2Norm 融合进 recurrent kernel(AscendC 算子改造)
decode 路径上每层对 q、k 各调用一次 triton l2norm_fwd kernel(每层 2 次 launch)。把 L2Norm 直接融合进 npu_recurrent_gated_delta_rule 的 AscendC kernel 内部,让 q/k/v 在片上完成归一化后直接参与状态更新,避免多次 HBM 往返与 kernel launch。
-
csrc 侧改动(csrc/attention/recurrent_gated_delta_rule/):
-
op_kernel/recurrent_gated_delta_rule_tiling_data.h,tiling 结构体新增 useL2Norm 字段;
-
op_kernel/recurrent_gated_delta_rule.h,构造函数读取 useL2Norm,在 CopyInQKV 阶段 Cast 之后、Mul 之前插入内联 L2 norm 计算;
-
op_host/recurrent_gated_delta_rule_tiling.cpp,useL2Norm=1 写入 tiling;
-
Python 侧 vllm_ascend/ops/gdn.py,删除 decode 路径的两次 l2norm_fwd(query/key) 调用。
编译: C++ 编译完成后执行 python3 setup.py build_ext --inplace 重新生成 .so。启动需配合 VLLM_ASCEND_KEEP_MAMBA_MODE=1。收益:c=1 TPOT 8.9→8.5ms(-0.4ms)、c=4 11.7→11.5ms(-0.2ms),c=8 出现 0.5ms 劣化。
host 侧小开销的优化
-
conv 权重转置缓存: causal_conv1d 每层每步都要对 conv 权重做 transpose(0,1).contiguous(),按权重 data_ptr 一次性缓存转置结果(conv_weights_T),消除约 4.3us × 30 层 ≈ 129us/step;
-
rearrange 视图化: 原实现用 torch.cat 拼接/重排 mixed_qkv,每层产生 Concat 操作,新增 rearrange_mixed_qkv:c=1 decode 时 split 出的 slice 在最后一维本就连续,直接 reshape 返回视图,省掉每层 Concat 操作(约 123us/step)。
mamba state 拷贝与计算重叠(多流并行)
GDN 层的 ssm_state(mamba state)在请求切换/淘汰时需要做 block 拷贝。原实现放在关键路径上同步执行。我们把 do_mamba_copy_block 挪到 global_stream 上,与 update_cos_sin / index_select 重叠执行,并用预分配的 torch.npu.Event 做同步------事件对象预分配复用,避免每 step 创建/销毁 event 的约 10us host 开销。
采样与投机解码路径优化(TPOT 降幅最大的一组)
这一组优化把 c=1 TPOT 从 7.02ms 直接压到 5.12ms(单项 -27%),并进一步压到 5.0ms。主要优化思想是:贪婪采样只需要 argmax,不需要计算并存储整个词汇表中每个 token 的 logits/概率。
MinTokens EOS 掩码缓存(rejection_sampler)
问题: 上游 MinTokensLogitsProcessor.apply_with_spec_decode 在每个 decode step 都在 host 侧用 numpy 重建 (rows, toks) 掩码,然后两次 torch.from_numpy(...).to(device, non_blocking=True) 拷到设备。由于源内存是分页内存(非锁页),这类 H2D 拷贝实际是同步的------host 必须等设备排空并完成拷贝,异步调度流水被硬生生打断,实测占单步时间约 30%。
解决: 分析发现掩码在「稳态期」是常量------只要每个请求剩余的最小生成长度 remaining = min_tokens - len(output) ≥ num_draft_tokens,掩码内容就不变。因此我们在 vllm_ascend/sample/rejection_sampler.py 实现 _apply_min_tokens_spec_cached:
-
_min_tokens_spec_steady_structure,判断是否处于稳态(临近 min_tokens 尾部或 batch 索引过期时返回 None,回退上游逐位置逻辑,语义完全一致);
-
get_min_tokens_spec_mask_indices,把掩码预计算成 device 端 int64 张量 (rows_t, toks_t, bonus_rows_t, bonus_toks_t) 并按 (batch 结构, 请求结构) 缓存,仅在结构变化时重建(重建时用锁页内存异步拷贝);
-
每步应用只执行一次纯设备端的 logits.index_put((rows_t, toks_t), neg_inf_tensor),无 numpy 重建、无 H2D 拷贝、无同步。
另一个关键细节: 昇腾上 masked_select 会编译为 NonZero 算子并触发 host-device 同步,因此所有掩码应用都改为纯整数 advanced indexing。该优化单项贡献 -1.9ms/token(7.02→5.12ms),是全部源码优化中收益最大的一项。
词表并行 argmax(Argument of the Maximum):跳过全词表 all-gather
argmax 找的是能让函数值达到最大的那个输入(索引或变量),而非最大值本身。
问题: 上游 compute_logits 会对全词表 logits 做 TP all-gather,通信量 O(batch × vocab_size)。对贪婪采样而言,最终只需要每行的 argmax。
解决: 先在每个 TP 分片内做局部计算,只聚合 (max_value, max_index) 对,通信量降为 O(batch × 2 × tp_size)------按 15 万词表、TP=2 估算,通信量下降约 31000 倍。 实现在 vllm_ascend/spec_decode/step3p5.py 的 _draft_greedy_shard_argmax:
Python
logits = lm_head.quant_method.apply(lm_head, hidden_states, bias=None)  # 只算本分片
logits[..., -num_pad:] = -float("inf")          # mask 掉分片内 vocab padding
local_max_vals, local_max_indices = logits.max(dim=-1)
global_indices = local_max_indices + vocab_start  # 分片内索引 -> 全局词表索引
local_pair = torch.stack([local_max_vals.float(), global_indices.float()], dim=-1)
gathered = tensor_model_parallel_all_gather(local_pair, dim=-1)   # 只 gather (值,索引) 对
max_rank_idx = gathered[:, :, 0].argmax(dim=-1, keepdim=True)     # 按值选最大分片
top_tokens = gathered[:, :, 1].gather(dim=-1, index=max_rank_idx) # 取对应 token id
正确性论证: soft_cap(tanh)与 scale 都是单调变换,不影响 argmax;padding 位置已置 -inf;「分片内 argmax + 跨分片比大小」与「全词表 argmax」严格等价。
该模式在三个位置落地: draft 侧(MTP 草稿生成),_draft_greedy_shard_argmax,draft 的 greedy 只需 argmax,不需要完整 logits 与 probs;target 验证侧(spec-decode verify),model_runner_v1.py 的 _spec_greedy_shard_argmax,lm_head 分片计算 + 本地分片 EOS 掩码(与上文「MinTokens EOS 掩码缓存」的缓存索引复用,掩码在 host 侧构建时就过滤到本分片并转换为分片内列号);普通 decode 侧,model_runner_v1.py 的 _vocab_parallel_argmax_eos_masked,在 execute_model 阶段预采样(ExecuteModelState.pre_sampled_tokens),sample 阶段直接构造 SamplerOutput,绕开全词表物化与通信。
贪婪采样快路径:跳过 bf16->fp32 的转换
通用采样路径会先把 bf16 logits 全量转成 fp32。对纯贪婪采样,这一步可以安全跳过:bf16 的指数位比 fp16 更宽,任意 bf16 值都可以被 fp32 精确表示,因此 argmax(bf16) == argmax(bf16.to(fp32)),逐元素比较顺序不会变化。
vllm_ascend/sample/sampler.py 的 AscendSampler.forward 增加快路径:当满足 all_greedy、没有 logprobs、没有 penalties、没有 allowed-token/bad-words 约束、且不改变 argmax 的 logits processor 条件时,直接对 bf16 logits 取 argmax 返回,省掉一次全词表(约 248K 元素/步)的 cast kernel。
预采样直接提供给拒绝采样
上述词表并行 argmax 产出的 token id 被直接喂给拒绝采样:rejection_sampler.py 新增 forward_greedy_presampled,接收全量 greedy 批次的预采样 argmax id(target draft 行 + 每请求一行 bonus 行),直接走 triton/pytorch 的 rejection_greedy_sample 完成验证,全程不再需要全词表 logits、fp32 的拷贝。
其他源码级小优化
单看每项都不起眼,但 decode 时间线就是由这些「每层每步几微秒」累加而成的:
-
RMSNorm (1.0+weight) 缓存: Gemma 风格 RMSNorm 每次 forward 都执行 1.0 + self.weight 与 .contiguous()。权重在推理期不变,按 id(self) 缓存结果(layernorm.py 的 GEMMA_WEIGHT_CACHE、patch_qwen3_5.py 的 get_weight_plus_one),全模型每步省下 40 层 × 2 处的加法拷贝。
-
rotary embedding 表达式合并: RoPE(旋转位置编码)通过旋转 Query/Key 的向量来注入位置信息。计算时需要根据每个 token 的位置,从预计算的 cos/sin 缓存中取出对应的值。update_cos_sin 是根据当前 batch 中每个 token 的位置索引,准备好形状匹配的 cos 和 sin 张量,供后续旋转操作使用,由于 RoPE 的 cos 和 sin 在数值上是对称的,形状和变换流程完全一致,可以合并优化,update_cos_sin 原先对 cos/sin 各做一次 index_select + view + repeat + chunk,可以把 cos 和 sin 合并成一个张量,先做一次 index_select 和形状变换,最后再 chunk 拆回 cos 和 sin,消除一半的重复操作,这些操作对 cos 和 sin 是完全重复的,形状、变换方式一模一样,只是数据不同。
-
去掉冗余 copy: rope_dsv4.py 中 ComplexExpRotaryEmbedding.forward 原先把结果 copy 到预分配 buffer 再返回,改为直接返回 x.view(ori_shape) 视图。
-
Attention 权重双流预取: weight prefetch 机制原本只覆盖 MoE 权重。我们利用「层按顺序构建」的特性建立层注册表,让第 L 层在进入自己的 MoE(全层最长的计算 + AR 窗口)时,在 prefetch 流上预取第 L+1 层的 attention 投影权重(qkv_proj/o_proj 等),第 L+1 层在消费前等待 prefetch 流,把 attention 权重的 HBM 加载藏进上一层的 MoE 窗口(patch_qwen3_5.py,VLLM_ASCEND_ATTN_WEIGHT_PREFETCH 默认开启)。
二、优化实践(三):算子层优化与编译融合
decode 关键路径上大量时间消耗在「matmul → AllReduce → 残差加 → RMSNorm」这种层间固定序列,以及 MoE 的通信-计算交织上。我们通过编译 MC2 通信融合、SuperKernel 与自研 910C 融合算子四条路径逐层压缩这些开销。
FUSED_MC2:MoE 通信-计算融合
MC2(Mixture-of-experts Communication & Computation)是昇腾针对 MoE dispatch/combine 通信的融合机制,把 AllToAll 通信与 GroupedMatmul 计算在算子内部交织。vllm-ascend 通过环境变量提供两级开关:export VLLM_ASCEND_ENABLE_FUSED_MC2=1 # 启用计算通信融合算子。实测 =1 有稳定收益,=2(更激进的融合级别)在 35B-A3B 上无额外收益。配套地,我们把 ascend_forward_context.py 中 MC2 路径的 token 容量上限从 min(num_tokens_per_tp_rank, 512) 放宽到 1024,让更大 batch 也走 MC2 的 RS+AG 路径而非 ALLTOALL,为未来扩大 capture 尺寸留余量。
SuperKernel:把小 kernel 合并为大 kernel 一起加载
低并发下单个 kernel 的计算时间常常只有几微秒,此时 kernel 的加载与发射开销占比极高。SuperKernel 的思路是:把多个连续的小 kernel 在编译期合并为一个大的 SuperKernel,同步 launch,减少 kernel 加载次数与通信开销,同时天然形成算子间的流水重叠。
在 vllm-ascend 侧通过编译选项启用(我们迁移后默认随静态 kernel 一起打开,见 compiler_interface.py):
Plain
options["static_kernel_compile"] = True
Plain
options["super_kernel_optimize"] = True
options["_vllm_aclnn_static_kernel_sym_range"] = \
    _compute_decode_cudagraph_batch_sizes(vllm_config)   # 限定静态编译的 batch 尺寸
其中 sym_range 把静态 kernel 编译限定在 cudagraph 捕获的 batch 尺寸上,避免编译时间爆炸。开启 SuperKernel 后(叠加前序全部优化),未开投机解码的 c=1 TPOT 从 8.5ms 降到 8.2ms(-0.3ms),开启 MTP 后收益进一步放大(详见下文「开启 MTP 投机解码」)。同时编译器 hash 因子中加入 super_kernel_optimize,保证开关变化时编译缓存正确失效。
融合算子:matmul_allreduce_add_rmsnorm_910c
动机
设置 VLLM_ASCEND_ENABLE_MATMUL_ALLREDUCE 开启计算和通信算子融合功能的时候,在 910C 上报「SoC version ascend910_93 verification failed」------算子库未覆盖该 SoC。自研了一个专为 910C 双 die TP=2 拓扑设计的融合算子,把 decoder 层内最重的序列:
o_proj(matmul) + AllReduce + residual add + RMSNorm(1+w)
压进单个算子。对应的 Python 侧封装在 vllm_ascend/ops/fused_ar_norm.py,由 VLLM_ASCEND_FUSED_O_PROJ_AR=1 开关控制,并在 patch_qwen3_5.py 的 AscendQwen3_5DecoderLayer.forward 中接入:attention 模块在算完 attn_output 后直接把 residual 与 (1+w) 归一化权重交给融合算子,整个 epilogue 一次完成,层前向只需接收融合输出作为新的 residual。
算子架构:AIC/AIV 双核流水
算子源码位于 csrc/mc2/matmul_allreduce_add_rmsnorm910c/,采用 AscendC 的 AIC(Cube)+ AIV(Vector)双核协同设计:
-
AIC 侧: 基于 Catlass 实现细粒度 matmul(L1 tile 16×224×512,双缓冲),每算完一个 (mTile, nTile) 输出 tile,就在 GM(全局内存)上置位对应的 tile-ready flag。
-
AIV 侧: 轮询 AIC 的 tile flag(WaitForAicTile),tile 就绪后立即启动跨 rank 的细粒度归约------两个 die 通过 HCCS 直接读写对方的 DataBank/StatusBank(RANK_DATA_STRIDE=1MB 布局),完成 reduce-add 后再做 RMSNorm(先各自求平方和、跨 rank 汇总求倒数、归一化输出),全程不回到 host。
-
流水协议: GM 上的 flag 区分为三段:AIC tile 就绪 flag、跨 rank 协议状态(protocol/add ready)、RMS 就绪,AIC 算得越往后,AIV 的归约与归一化越能与之重叠,形成 matmul 与通信的细粒度流水。
形状约束与可靠性设计: 算子支持 M ≤ 40 行(覆盖 MTP bs8 × (4+1)=40 行的验证场景)、TP=2、bf16、2048 维(Qwen3.5-35B-A3B 的 hidden size);Python 侧做第一道守卫(不满足条件返回 None 走未融合路径),算子内部还有第二道防线------不支持的形状会通过 c10::Dispatcher 回退到标准算子组合(matmul + vllm::all_reduce + add_rms_norm,这正是新增头文件 csrc/mc2/call_vllm_tensor_op.h 提供的能力)。双层回退保证了正确性永远不依赖融合算子的形状覆盖度。
收益
该算子接入后(叠加全部前序优化):c=1 TPOT 5.2→5.1ms、c=4 9.2→9.0ms、c=8 12.9→12.3ms(p99 从 18.8ms 降到 14.8ms);同时 TTFT c=1 从 213ms 降到 179ms(-16%)、c=8 从 432ms 降到 307ms(-29%),因为 prefill 阶段同样会走该融合算子。
静态 kernel 编译修复:从 37/43 到 43/43
静态 kernel 预编译(见上篇)依赖对图内所有算子的成功编译。实际编译 43 个自定义算子时,起初只有 37 个成功。排查发现两类问题:
-
头文件路径硬编码:编译脚本引用 /tmp/vllm-ascend/.../cann_compat.h 绝对路径,容器重启后即失效,改为基于 PYF_PATH 的相对路径后恢复到 42/43。
-
CausalConv1d 空输入处理,该算子的 bias/initialStateMode/numAcceptedTokens 参数传 None 时,tiling 描述的位置发生错位,修复方式是用「nullptr」空 tensor 描述 + 剥离 stride/offset/is_view 属性,最终 43/43 全部编译成功(100%)。
编译成功率提升的直接收益是 cudagraph 捕获覆盖所有 decode 形状,解码吞吐提升约 4.2%。
静态 kernel 与 MTP 的兼容性
静态 kernel 与 MTP 投机解码同时开启时,服务在发推理请求时直接报错------draft(MTP 草稿)模型的静态编译在 cudagraph capture 阶段触发 AICore 越界。分析发现根因:MTP draft 模型的 FX 图与目标模型不同(其 fc 层消费的是「token embedding 与目标 hidden states 拼接成的 2×hidden_size 张量」),这个图编译成静态 kernel 会越界。解决方法:compiler_interface 带上 super_kernel_optimize(static kernel + super kernel 协同),该组合下 MTP 图可正常编译(cudagraph 捕获 5/5 通过)。
cudagraph 捕获尺寸必须匹配投机后的 token 数
初次开启 MTP 时出现严重劣化: c=4 TPOT 从 10.4ms 飙到 42.2ms、c=8 从 13.5ms 飙到 42.9ms。排查发现原因:开启投机后每个 decode step 实际执行的 token 数变为 并发数/DP × (1 + num_speculative_tokens) 再加上可能的 bonus,例如 c=4/TP=2 对应约 10~20 个 token,而默认捕获尺寸 1,2,4,5,8 完全覆盖不到这些形状,导致投机步骤落不进图中。
修复方法是按公式重新设置捕获尺寸:
Plain
--compilation-config '{"cudagraph_mode": "FULL_DECODE_ONLY",
                        "cudagraph_capture_sizes": [5, 20, 40]}'
修复后 c=4 TPOT 42.2->10.4ms、c=8 42.9->13.5ms。
三、优化前后性能对比
c=1 优化瀑布:每一步优化贡献了多少
下表按时间顺序汇总 Qwen3.5-35B-A3B 在 c=1、输入 1024/输出 512、不开投机解码条件下,各优化措施叠加后的 TPOT 演进(752t 单卡双 die,TP=2):
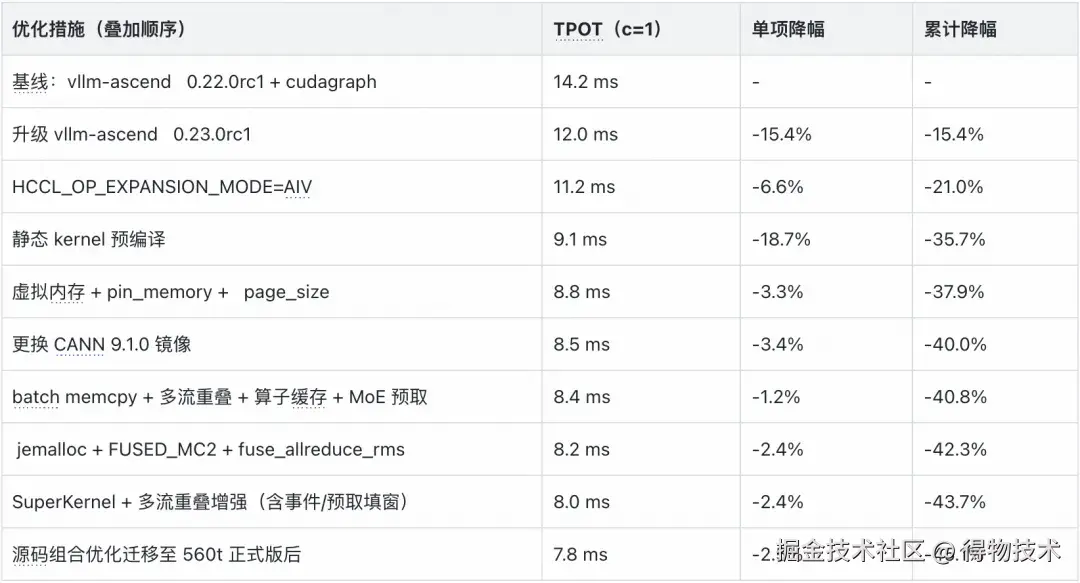
可以看到,最大的三个单项是版本升级(-15.4%)、静态 kernel(-18.7%)与 HCCL AIV(-6.6%),合计贡献约七成降幅;其余十余项合计贡献三成。
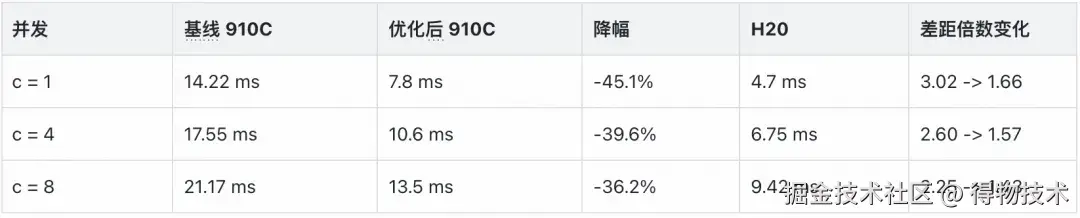
总览一:未开启投机解码(random 数据集 -> 真实数据集)
叠加全部非投机优化后(910C-560t,单卡双 die,TP=2),与基线及 H20 的对比:
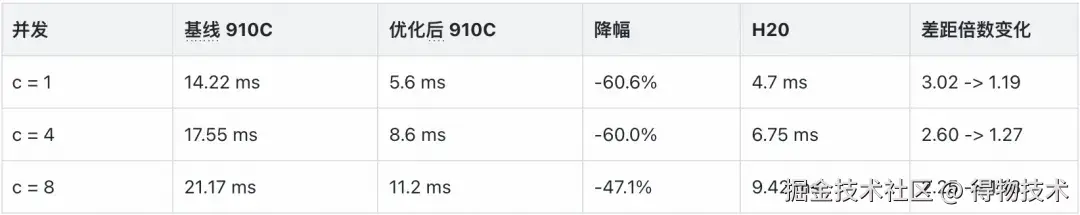
总览二:开启 MTP 投机解码(针对MTP进行源码优化后)
在 8.2 基础上开启 MTP(num_speculative_tokens=4)+ SuperKernel:
总览三:真实业务场景 RL 微调模型 + 真实业务场景数据集(最终状态)
最终状态下,真实业务数据集上 c=1 TPOT 达 5.0ms,较基线下降 64.8%。 生产验证使用真实业务场景 RL(GRPO/PPO,基于 verl)微调后的 Qwen3.5-35B-A3B 模型,配合三类真实数据集压测。在叠加最后一批源码优化(min_tokens 掩码缓存、词表并行 argmax、lm_head 分片计算)后:
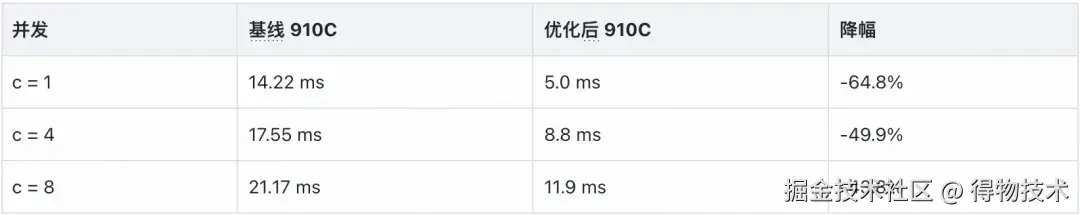
在 gsm8k 公开数据集(数学推理,token 分布与真实业务场景不同)上,优化效果更为突出:
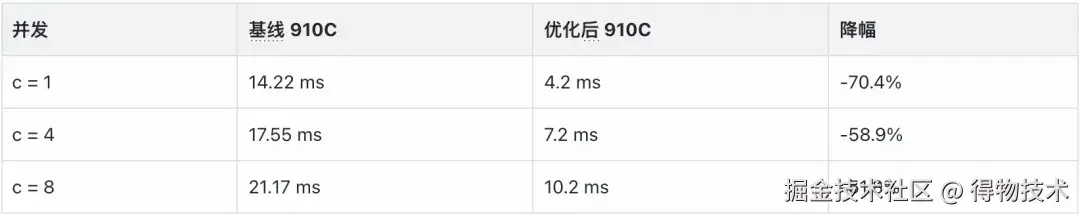
两个数据集的差异也提示:投机解码的收益与接受率强相关,而接受率受数据分布影响,评估国产化替代效果时应以真实业务数据集为准,公开数据集只能作参考。
推广验证:Qwen3.6-27B
为验证优化方案的通用性,我们在同一套环境(910C-560t、v0.23.0 内部分支)上对稠密模型 Qwen3.6-27B 做了同步验证。注意该模型与 MTP + 静态 kernel 的组合存在兼容性限制(混用在发推理请求时报错,需关闭 enable_super_kernel/static_kernel 之一,详见上文「静态 kernel 与 MTP 的兼容性」一节的问题背景;后续 0.26.0rc 版本镜像已解决)。
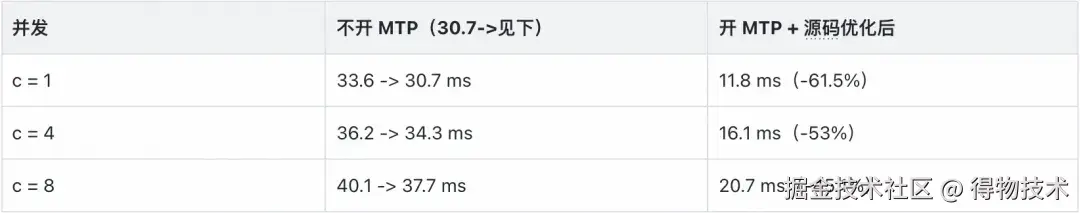
27B 稠密模型上,非 MoE、非混合注意力模型同样有效。
TTFT 与其他指标
TPOT 之外,其他指标的优化情况:
-
TTFT: 基线阶段昇腾本已优于 H20。源码优化后进一步改善:融合算子接入使 c=1 TTFT 213→179ms(-16%)、c=8 432→307ms(-29%)。
-
端到端延迟: 优化后 1024-512 请求的端到端延迟从 5.09s 降到 4.04s(-21%)。
-
高并发吞吐: 静态编译修复(43/43)使并发 10 的解码吞吐提升 4.2%cudagraph 捕获范围从 49 扩到 70 后,c=10 吞吐 173→477 tok/s------说明低并发优化方法论之外,高并发还需要单独调优捕获范围与调度。
四、经验总结与展望
方法论总结
-
Profile: 所有优化都始于 msprof 时间线上的具体瓶颈(某个算子的 launch 开销、某段 host 空窗、某次同步拷贝),每项优化都做单变量 A/B 压测并记录,无效尝试也要记录。
-
低并发优化要减少 host 开销: c=1 时 device 侧算子都在微秒级,TPOT 的大头是 host 调度、kernel launch、H2D 拷贝与同步等待。静态 kernel、SuperKernel、CPU 快路径、掩码缓存、冗余拷贝跳过,本质都是在压缩 host 侧每一微秒。
-
通信优化: 词表并行 argmax 把通信量降 3 万倍;fuse_allreduce_rms、MC2、910C 融合算子把通信压进计算流水。多流重叠让 shared expert 的通信与 routed 计算同时进行。
-
投机解码: MTP 对 TPOT 的优化提升明显,先做基线优化、再开投机解码。
-
版本更新: 版本升级之后,此前基于旧版本的所有源码修改都要重新迁移验证,采用「先迁移基线优化、再逐个叠加」的方式完成了从 0.23.0rc2 到正式版 0.23.0 的迁移。
不足与展望
-
高并发方向: 本轮优化聚焦在线低并发(c≤8),高并发下的调度、显存与吞吐优化(如 PD 分离、更大 capture 范围、DP attention)是下一阶段重点。
-
编译优化: 探索 PGO(Profile-Guided Optimization)反馈优化、更激进的算子融合(如 QKV proj 与 RoPE 的融合)。
-
上游协同: 把通用性好的优化(min_tokens 掩码缓存、词表并行 argmax、block_table CPU 快路径等)整理后向 vllm-ascend 社区回馈,减少长期维护成本。
-
规模扩展: 将同一套方法论与最佳实践脚本复制到更多机型(单机多卡、多机)与更多模型(Qwen3.5-9B/27B、后续稠密大模型)上,同步积累国产算力推理优化的经验。
往期回顾
1.国产算力·昇腾 910C 大模型推理优化(上):镜像更新与参数调优,提速 40%|得物技术
2.动态规则的 Agent 实践:用确定性工程驾驭 LLM 的资产智能验收
3.发一张图,它居然"跃"出屏幕了?一文读懂得物 3D 空间图片技术实践
4.别再只卷向量检索了,得物交易搜索如何用"生成式"实现召回范式跃迁?
文 / 映川、行星
关注得物技术,每周更新技术干货
要是觉得文章对你有帮助的话,欢迎评论转发点赞~
未经得物技术许可严禁转载,否则依法追究法律责任。