此次以mysql数据库为例来讲解如何提升查询效率。
目前大多数数据的查询都是老套路,一个一个的查询数据,然后返回数据,这种查询在很多情况下都会查询到相同的数据。那么有没有把请求查询合并且不会出现查相同数据的方式呢?答案肯定是有的,只是把原本的一次操作换成2次操作就行了,即先查主数据后异步请求合并参数。
什么是先查主数据?举个简单的例子,例如分页查询多个用户信息时,先查询用户信息的总数和用户信息id,然后在根据用户id列表查询用户信息。前一步多请求是同步操作,后一步操作是异步操作,把多个请求根据id查询用户信息放在一次异步操作上,异步操作拿到所有数据后把数据分发给各自请求即可。
先查主数据的好处,一是减少查询多个字的耗时,二是可以统一缓存处理。大多数情况下,多个请求查询用户信息所用的字段不一样,这样缓存数据也不一样,间接导致了缓存数据的管理混乱问题。
多请求异步的好处就是一次把多个请求数据查询出来,不会查到相同的数据,坏处就是要把需要用到的用户信息查全。看似是坏处,其实也有好处,主要体现在数据缓存上,多个操作只用到同一份缓存,减少了数据消耗。异步造作主要用到了线程池、队列、Future,把请求参数、查询数据方式、Future封装到一个数据上,然后放到队列,线程池从队列拿到请求封装数据进行处理,需要注意的是不是立即处理,而是需要等待一定时间,当等待条件不满足后就把多个请求归类,按分类型理,只有分类后才能把同一类型的参数合并并查询,然后把同类型的请求数据分到各请求封装Future上。
以上就是主要思路,接下来看代码实现。
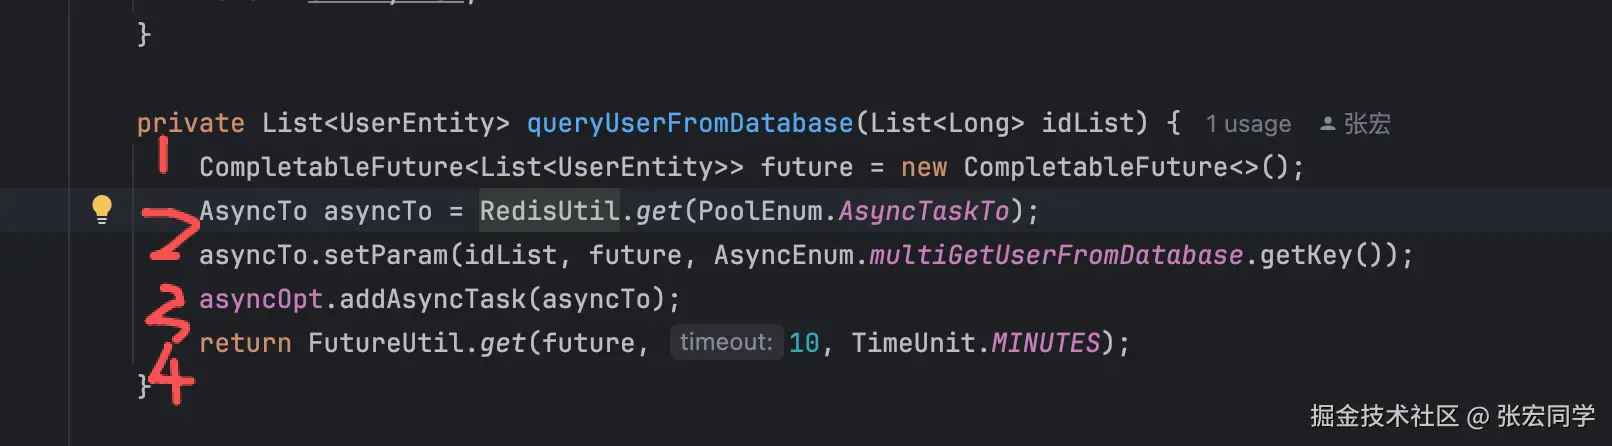
1是Future、2是封装对象、3是把封装对象放到队列、4是从Future拿到结果。
接下来看看AsyncTo的内容,如下图所示:
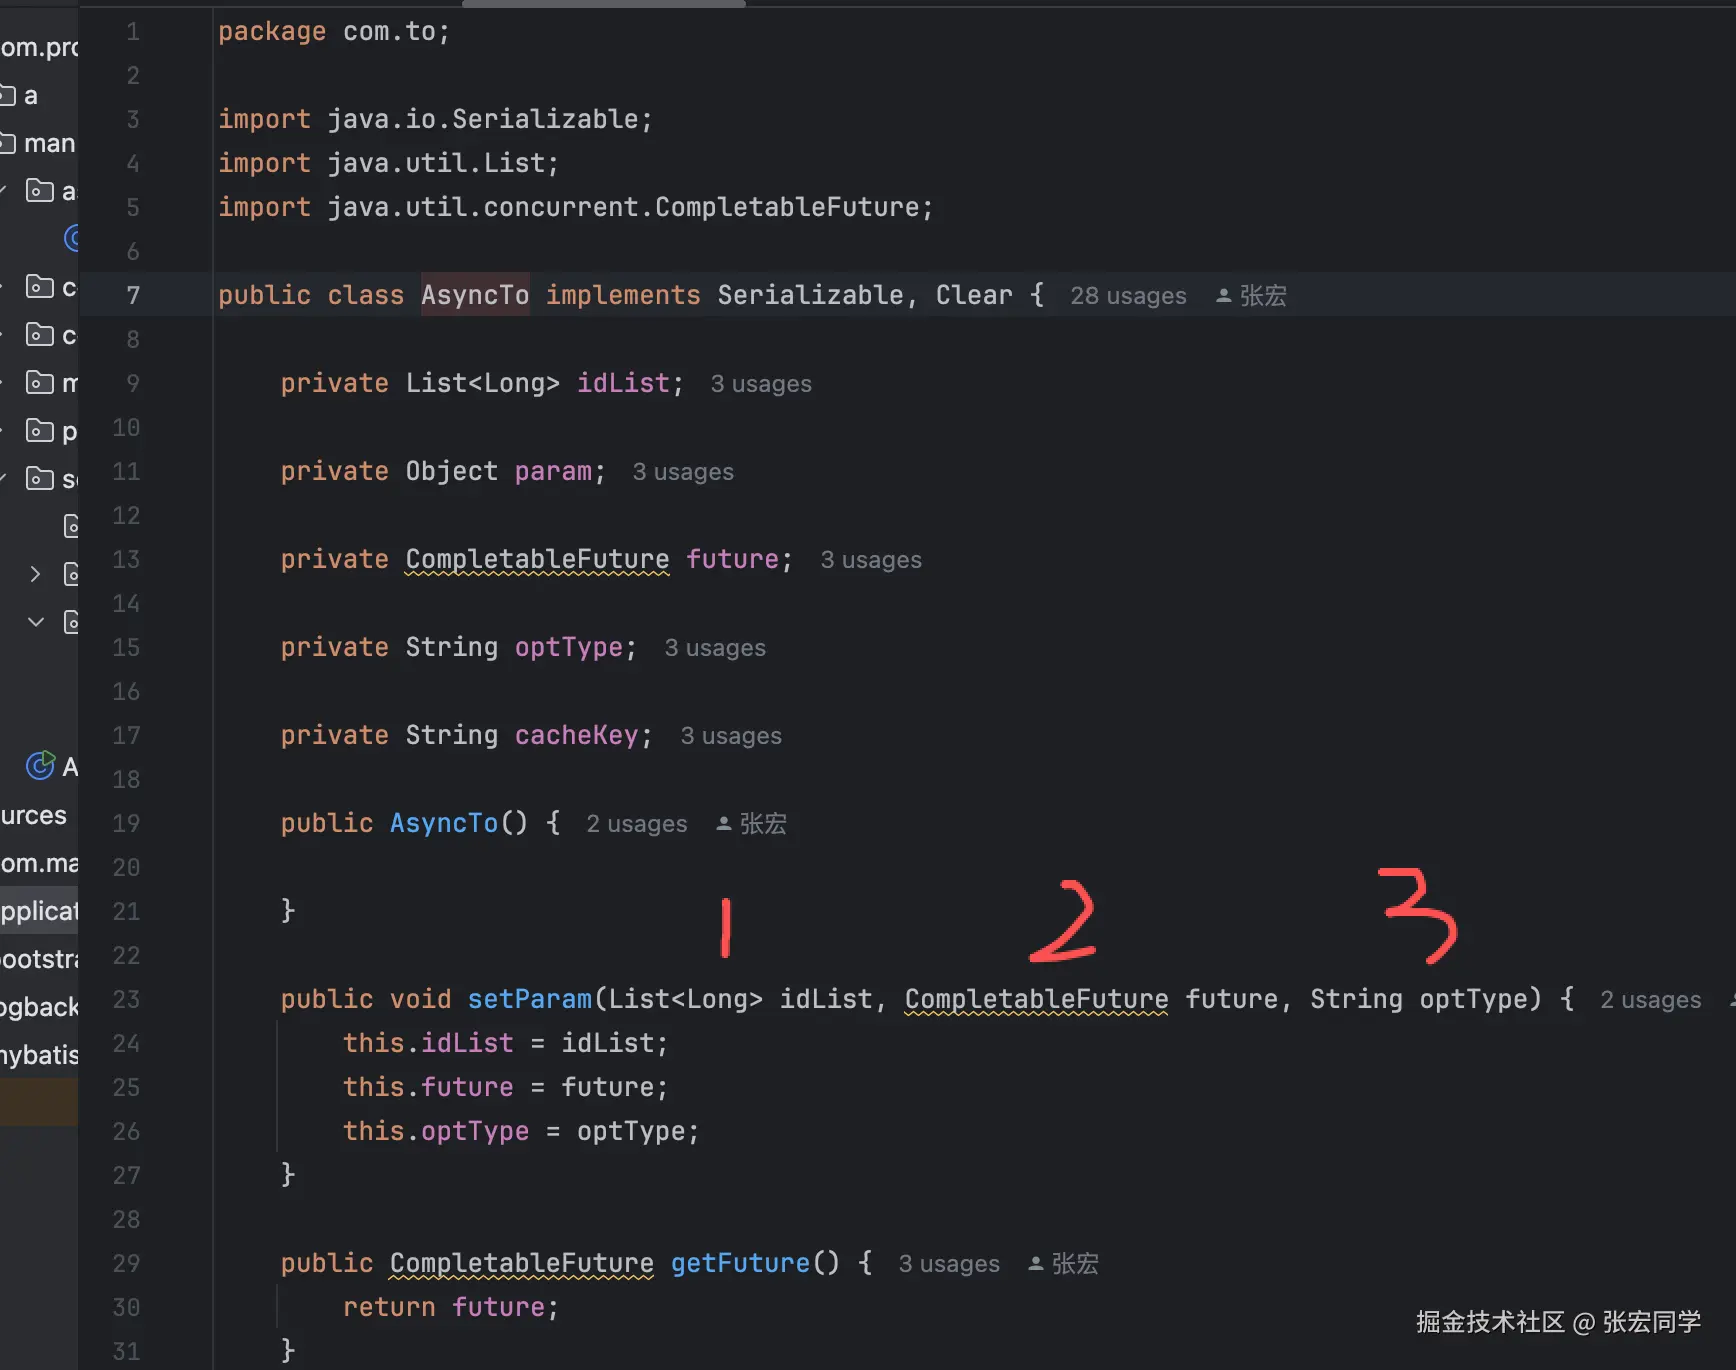
future负责拿结果、optType负责查询那个方法、参数的话看实际情况,这里的参数是idList。
接下来看看AsyncOpt的内容,如下所示:
ini
package com.provider.man.async;

import com.alibaba.fastjson.JSON;
import com.entity.system.UserEntity;
import com.provider.man.common.AsyncEnum;
import com.provider.man.common.PoolEnum;
import com.provider.man.common.RedisUtil;
import com.provider.man.mapper.system.UserMapper;
import com.to.AsyncTo;
import com.util.CommonUtil;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.scheduling.concurrent.ThreadPoolTaskExecutor;
import org.springframework.stereotype.Component;
import org.springframework.util.CollectionUtils;

import javax.annotation.PostConstruct;
import javax.annotation.PreDestroy;
import javax.annotation.Resource;
import java.util.List;
import java.util.Set;
import java.util.Map;
import java.util.ArrayList;
import java.util.HashMap;
import java.util.HashSet;

import java.util.concurrent.BlockingQueue;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;

@Component
public class AsyncOpt {

    private static final Logger log = LoggerFactory.getLogger(AsyncOpt.class);
    // 线程池
    @Resource
    private ThreadPoolTaskExecutor executor;
    // 请求封装队列
    @Resource(name = "asyncTaskQueue")
    private BlockingQueue<AsyncTo> queue;
    // 从数据库查询用户数据的接口
    @Resource(name = "userMapper")
    private UserMapper userMapper;

    @PostConstruct
    public void inti() {
        // 启动task0任务来执行任务,注意时间设置,任务数量多大或者时间过长都会导致各个请求响应变慢,需要根据实际仔细斟酌。
        task0(30, 50, TimeUnit.MILLISECONDS, 2);
    }

    /**
     * @param taskCount             任务数量,达到该数量就执行
     * @param timeUnit              任务阻塞时间单位
     * @param interruptTimeInterval 当没有任务时,等待时间依次按此时间间隔递增
     */
    protected void task0(int taskCount, int maxWaitTime, TimeUnit timeUnit, int interruptTimeInterval) {
        Runnable task = () -> {
            List<AsyncTo> list = new ArrayList<>(taskCount);
            // task0会一直执行
            while (true) {
                try {
                    log.info("task0 start");
                    // 阻塞队列,直到拿到请求封装对象
                    list.add(queue.take());
                    // 当任务数量未达到阈值,或者时间没有到达,且任务不为null,添加到list,数量+1
                    // 按等待条件等待,有数据就拿数据,直到不满足就退出,执行数据处理
                    // 当阻塞时,等待时间依次按时间间隔递增阻塞
                    // 等待时间超过最大等待时间时,重新开始循环
                    long maxWaitMillis = timeUnit.toMillis(maxWaitTime);
                    long intervalMillis = timeUnit.toMillis(interruptTimeInterval);
                    long waitedMillis = 0;
                    long pollTimeout = intervalMillis;
                    int index = 0;
                    // 等待条件, 不满足退出,执行后面数据操作
                    while (list.size() < taskCount && waitedMillis < maxWaitMillis) {
                        AsyncTo po = queue.poll(pollTimeout, timeUnit);
                        if (po != null) {
                            list.add(po);
                            waitedMillis = 0;          // 取到数据,重置累计等待
                            pollTimeout = intervalMillis; // 重置递增超时
                        } else {
                            waitedMillis += pollTimeout;
                            pollTimeout = Math.min(pollTimeout + intervalMillis, maxWaitMillis - waitedMillis);
                        }
                        log.info("index: {} waitedMillis: {}, pollTimeout: {}", index++, waitedMillis, pollTimeout);
                    }
                } catch (InterruptedException e) {
                    log.error("task0 err: ", e);
                }
                if (list.size() > 0) {
                    // 数据处理
                    doWith(list, taskCount);
                    // 清空列表,执行上面的相同逻辑
                    list.clear();
                }
            }
        };
        // 执行task0任务,
        executor.execute(task);
    }

    // 把任务添加到队列
    public void addAsyncTask(AsyncTo asyncTo) {
        this.queue.add(asyncTo);
    }

    // 具体的执行逻辑
    private void doWith(List<AsyncTo> taskList, int taskCount) {
        Map<String, List<AsyncTo>> taskMap = new HashMap<>();
        // 请求封装分类
        taskList.forEach(task -> {
            List<AsyncTo> list = taskMap.get(task.getOptType());
            if (list == null) {
                list = new ArrayList<>(taskCount);
                taskMap.put(task.getOptType(), list);
            }
            list.add(task);
        });
        //
        for (Map.Entry<String, List<AsyncTo>> ety : taskMap.entrySet()) {
            String key = ety.getKey();
            List<AsyncTo> list = ety.getValue();
            // 按类型开启新任务价到队列并执行
            Runnable curTask = () -> {
                // 从redis查询数据
                if (AsyncEnum.multiGetFromRedis.getKey().equals(key)) {
                    multiGet(list);
                } else if (AsyncEnum.multiGetUserFromDatabase.getKey().equals(key)) {
                    // 从mysql查询数据
                    multiGetUserFromDatabase(list);
                }
            };
            executor.execute(curTask);
        }
    }

    private void multiGetUserFromDatabase(List<AsyncTo> list) {
        Set<Long> idSet = new HashSet<>();
        List<Long> allIdList = new ArrayList<>();
        int index = 0;
        for (AsyncTo to : list) {
            List<Long> toIds = to.getIdList();
            log.info("multiGetUserFromDatabase {} id: {}", index++, JSON.toJSONString(toIds));
            // 把id合并到一起并去重复
            idSet.addAll(toIds);
        }
        allIdList.addAll(idSet);
        log.info("multiGetUserFromDatabase {} total id: {}", index, JSON.toJSONString(allIdList));
        // 实际mysql查询
        List<UserEntity> resultList = userMapper.queryUserEntity(allIdList);
        if (!CollectionUtils.isEmpty(resultList)) {
            // 有数据
            setResult(list, resultList);
        } else {
            // 没数据
            setNullResult(list);
        }
    }

    private void multiGet(List<AsyncTo> list) {
        // id合并且去重复
        List<String> cacheIds = new ArrayList<>();
        StringBuilder stringBuilder = new StringBuilder();
        Set<Long> idSet = new HashSet<>();
        int index = 0;
        for (AsyncTo to : list) {
            List<Long> toIds = to.getIdList();
            log.info("multiGet {} id: {}", index++, JSON.toJSONString(toIds));
            for (Long id : toIds) {
                // id去重复
                if (idSet.contains(id)) {
                    continue;
                }
                stringBuilder.append(to.getCacheKey());
                stringBuilder.append(id.toString());
                String str = stringBuilder.toString();
                cacheIds.add(str);
                idSet.add(id);
                stringBuilder.setLength(0);
            }
        }
        // 从redis获取数据
        List<String> resultList= RedisUtil.multiGet(cacheIds);
        if (!CollectionUtils.isEmpty(resultList)) {
            // 结果合并解析
            String jsonStr = CommonUtil.listJsonStrToArrayJsonStr(resultList, stringBuilder);
            List<UserEntity> userList = JSON.parseArray(jsonStr, UserEntity.class);
             // 有数据
            setResult(list, userList);
        } else {
            // 没数据
            setNullResult(list);
        }
    }

    // 处理mysql数据
    private void setResult(List<AsyncTo> list, List<UserEntity> userList) {
        // curMap存放所有结果
        Map<Long, UserEntity> curMap = new HashMap<>(userList.size());
        userList.forEach(u -> {
            curMap.put(u.getId(), u);
        });

        List<UserEntity> curList = new ArrayList<>(userList.size());
        for (AsyncTo to : list) {
            // 根据id获取实际数据,完成数据分发
            to.getIdList().forEach(id -> {
                curList.add(curMap.get(id));
            });
            if (CollectionUtils.isEmpty(curList)) {
                // 实际数据为null, 返回null,必须进行complete()
                to.getFuture().complete(null);
            } else {
                // 实际数据不为null 返回实际数据
                List<UserEntity> returnList = new ArrayList<>(curList.size());
                curList.forEach(c -> {
                    returnList.add(c);
                });
                // 数据写入,complete
                to.getFuture().complete(returnList);
            }
            curList.clear();
        }
    }

    private void setNullResult(List<AsyncTo> list) {
     // 实际数据为null 返回null,必须进行complete()
        for (AsyncTo to : list) {
            to.getFuture().complete(null);
        }
    }

    @PreDestroy
    public void destroy() {
        log.info("destroy");
        executor.shutdown();
        executor = null;
        queue = null;
    }

}
以上就是全部的代码了,需要注意的是任务总数和时间的配置。此外这种方式跟业务深度耦合,没做到通用处理,后面如果有优化,也会发出来和各位看官一起交流。
这就是我的一点小见解,各位看官有更666的操作可以私聊我。有问题可以一起讨论。
条条大路通罗马,想看看官的罗马。