视频翻译生成一段较长的配音后,字幕可能仍是一整段文字。把它一次铺在画面上,观众要在听声音的同时找当前读到的位置;机械地每隔几个字符切一刀,又容易把一个词或一句话截在中间。
字幕拆分需要同时处理文字边界和显示时间。本文以 Vimorph 的字幕预览服务为线索,用独立 Java 21 示例演示计算过程。示例补充了字符边界和时间窗校验,与业务实现的差异会在相应位置说明。
先把字幕和配音片段分开
音频片段保存配音和段级时间,SubtitleCue 单独保存 segmentId、text、startTime、endTime 和排序。一个片段对应多条 cue,拆分或编辑字幕时可以继续使用同一份音频。没有独立 cue 时,预览仍可回退到段级字幕。
这层区分让两个问题各有边界:音频处理负责声音的长度与位置,字幕服务负责何时显示哪段文字。本篇讨论 cue 的生成,不重复 SRT/WebVTT 的文件序列化。
字符数之外,还要看断点和时长
固定字符数很难同时照顾中文和英文。业务代码给空白约 0.3、中日韩范围字符约 1.0、其他字母与数字约 0.55,其余字符约 0.8 的权重。它提供的是容量估计;真实字体、字号、容器宽度与换行仍需在界面上检查。
显示时间也参与估算。教学示例沿用 24、6 和 4500ms 这组策略值:MAX_WEIGHT=24,MIN_WEIGHT=6,ESTIMATED_CUE_MILLIS=4500。在 split() 中,totalWeight 是全文权重,audioDurationMillis 是参考时长。plan() 会取音频参考时长与词时间末尾中的较大值,交给 split() 作估算。阈值计算节选如下:
java
double estimatedParts = Math.max(1.0, Math.ceil(audioDurationMillis / ESTIMATED_CUE_MILLIS));
double threshold = Math.min(MAX_WEIGHT, Math.max(MIN_WEIGHT, totalWeight / estimatedParts));
随后逐个字符簇累加权重,记录最近的空白或标点。达到阈值时,先在后面最多八个字符簇里找句末标点;找不到就退回已记录的自然断点,最后才按当前字符边界切开。这样能保留附近的完整句子,也可能让单条文字超过估算阈值。
这里保留容量优先的兜底:没有自然断点时,长英文单词、无空格字符串、URL、文件路径或变量名都可能按合法字符簇边界切开,不将它们识别为不可拆的 token。这样不会让一条超长字符串一直撑大 cue,但也不承诺单词和语义完整。24 是目标权重,向后寻找句末仍可超出它,并非严格长度上限。
4.5 秒只是估计拆分数量的依据,不是每条字幕的时长上限。 最低权重、标点位置和词时间映射都会改变最终结果;文本太短时,单靠缩小阈值也无法制造更多有意义的短句。
切分时保留完整字符
生产服务目前按 charAt() 遍历,教学实现改用 Java 21 的 BreakIterator.getCharacterInstance(Locale.ROOT)。它先找字符边界,再把每个簇的首个 code point 交给权重和断点函数。下面是教学类中的节选;内部 Cluster 记录起止 offset、权重、自然断点和句末标记,requireWellFormedUtf16() 负责拒绝孤立代理项:
java
private static List<Cluster> clusters(String text) {
    requireWellFormedUtf16(text);
    BreakIterator iterator = BreakIterator.getCharacterInstance(Locale.ROOT);
    iterator.setText(text);
    List<Cluster> result = new ArrayList<>();
    int start = iterator.first();
    for (int end = iterator.next(); end != BreakIterator.DONE; start = end, end = iterator.next()) {
        int first = text.codePointAt(start);
        result.add(new Cluster(start, end, clusterWeight(first), isNatural(first),
                "。?!.!?".indexOf(first) >= 0));
    }
    return result;
}
Java 21 文档说明默认字符边界实现遵循扩展字素簇规则。UTF-16 offset 是字符串切片位置,码点是 Unicode 编码值,字符簇则可能由多个码点组成,三者不能混用。本轮 Java 21.0.9 中,你好👩💻世界 的 UTF-16 长度为 9、码点数为 7、字符簇数为 5,边界为 0、1、2、7、8、9。这个实测结果不代表所有 JDK 都有相同的 Emoji 边界支持;示例也会拒绝孤立代理项,而不把损坏的 UTF-16 输入继续拆分。
文本口径也需要统一:教学示例拆分前只做一次 strip(),不做 NFC 转换;offset 始终指向这份文本。每个完整簇只按首码点计算一次权重,既不按 UTF-16 单元数,也不按簇内码点数重复计权。显示文字会去掉每条边缘空白,保留标点;业务服务还会移除 cue 边缘的软标点,因此不能一概要求拼接显示文字还原原始输入。
把短句映射到显示时间
示例的 SubtitlePlanner.plan() 接收以下参数,时间统一使用毫秒:
| 参数 | 含义 |
|---|---|
text |
字幕文本,先 strip() 去掉首尾空白,内部文字保留 |
startMillis / endMillis |
字幕所属片段在最终时间轴上的起止位置 |
speed |
配音的播放倍率,示例要求有限且在 0.5~2.0 之间 |
audioDurationMillis |
变速前的音频时长;0 表示没有这项参考 |
words |
变速前音频中的局部词时间;缺失或仅有一个合法词时用比例分配 |
Part 保存显示文字与归一化文本中的起止 offset,Cue 保存显示文字与最终起止时间。offset 仍使用 Java 字符串的 UTF-16 索引;字符边界检查决定哪些索引可以用来切分。教学入口对超出范围的倍率直接报错,业务服务则会限幅,两者的输入处理策略不同。
有了短句,还要给它们分配时间。原示例按 part.endOffset / normalizedText.length 估计进度,Emoji 的代理对或 ZWJ 序列会因此占用更多时间份额,和拆分时的权重口径不一致。本轮改为"断点处累计字符簇权重 ÷ 全文字符簇权重",再映射到段时间窗;UTF-16 offset 只用于定位断点,代码使用 cumulativeWeights[part.endOffset()] / totalWeight。两步使用相同权重,但权重仍不能反映实际发音速度和停顿。
有词时间时,先用同一累计权重进度选择相邻词,再取前词结束与后词开始之间的中点。该中点是变速前音频的局部时间,除以 speed,再加片段的 startMillis,得到最终时间轴上的候选边界。
这里没有按词文本逐一匹配,也没有运行强制对齐算法。词数明显偏少或偏多、长短词差异和长停顿都会影响估算;首词之前和末词之后的静音也不会自动形成独立 cue。缺失、空词表或仅一个合法词使用权重比例分配;已提供的词时间先全部校验,null 元素、负值、非正时长、乱序或重叠均报错,单个坏词也不会被回退逻辑跳过。音频时长已知时,词末端超出它会报错;传 0 表示未知,此时只能校验词时间结构,候选边界仍夹取到输出段内。源音频局部时间和最终段时间窗不是同一个坐标,不能直接比较。
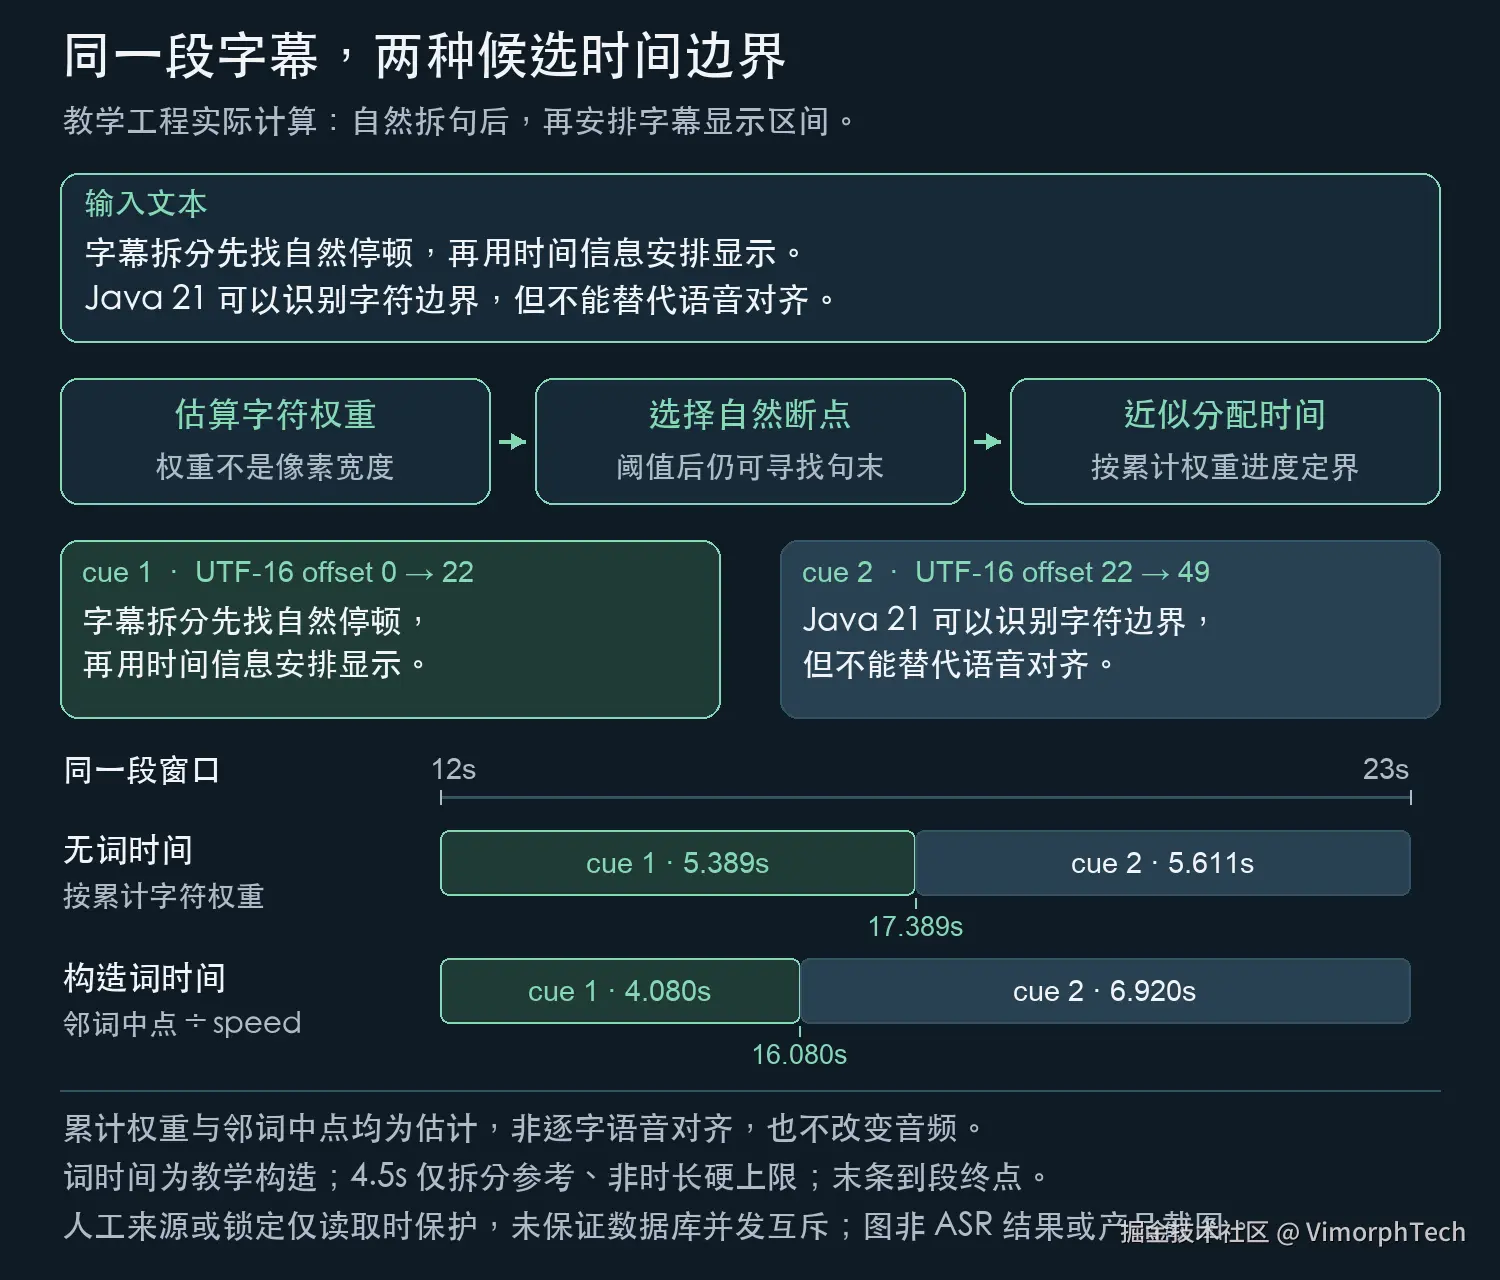
下面是本地 Java 示例的真实计算输出。输入文本为"字幕拆分先找自然停顿,再用时间信息安排显示。Java 21 可以识别字符边界,但不能替代语音对齐。",片段窗口 12000~23000ms,变速前音频参考时长 12000ms,倍率 1.25;词辅助组使用八个手工构造的词时间区间。
| cue 文本 | 无词时间(ms) | 词辅助(ms) |
|---|---|---|
| 1:字幕拆分先找自然停顿,再用时间信息安排显示。 | 12000~17389 | 12000~16080 |
| 2:Java 21 可以识别字符边界,但不能替代语音对齐。 | 17389~23000 | 16080~23000 |
两组采用相同的文本拆分,仅改变时间边界。最后一条固定结束于段终点;本例参考音频时长按倍率折算为 9.6 秒,段窗口却有 11 秒,因此字幕会继续保留到给定段终点。词区间是算法 fixture,没有真实识别音频;图中的时间条也是计算示意,不能据此判断哪一组更贴近真人发音。
时间窗要容得下每条字幕
时间夹取不能只写成"至少比上一条晚 1ms"。假设要在 2ms 内放三条字幕,前两条各向后加 1ms,最后一条就没有正时长可分。示例先检查 end-start >= cue数量,不满足就拒绝,交给调用方合并文字或调整时间窗。
分配中间边界时,还要为后续条目保留空间。下面是 plan() 的节选:duration=endMillis-startMillis,previousEnd 是前一条结束,remaining 是当前条之后的 cue 数量,candidateOffset 是相对段起点的候选时间:
java
long low = previousEnd - startMillis + 1;
long high = duration - remaining;
long boundedOffset = Math.max(low, Math.min(high, Math.round(candidateOffset)));
partEnd = startMillis + boundedOffset;
下界保证当前条有正时长,上界为每条后续 cue 至少留出 1ms;最后一条直接结束于段终点。先夹取 offset 再加起点,也避免先相加时发生整数溢出。合法区间只是结构要求:100ms 拆成十条,即使每条都有 10ms,也几乎无法阅读。实际需要结合语言、文字长度、屏幕和阅读速度减少拆分、合并相邻 cue 或提示人工调整;不能为了凑最短显示时长,擅自拉长原始音频时间轴。
WebVTT 规范要求 cue 的结束晚于开始,但允许普通字幕 cue 重叠。本例采用段内连续、不重叠的分配,是应用策略,不能推广成所有字幕格式的规定。
自动结果遇到人工修改
自动生成也需要尊重已有编辑。业务服务先查询当前片段的 cue;如果任一条带人工来源或文本/时间锁定,就跳过整个片段。existing 是仓储查询结果,判断节选如下:
java
if (existing.stream().anyMatch(cue -> cue.textLocked() || cue.timingLocked()
        || "MANUAL".equals(cue.textSource()) || "MANUAL".equals(cue.timingSource()))) {
    return;
}
SubtitleCue.withText() 会标记文本人工来源与锁定,withTiming() 同样标记时间。这样可以避免下一次自动对齐在已经读到这些标记后直接替换人工结果。
保护范围取决于读取时机:自动任务先读取未锁定 cue,随后用户保存人工修改,自动任务仍可能按旧快照删除并替换。当前已审查的写路径未见共同的版本条件或行锁协议;事务本身也不等于消除了这段竞争。版本号、条件更新或事务内重新检查可以作为后续设计,但需要自动和人工写入共同遵守,不能把一次性锁定检查当作并发安全保证。
本轮实际验证了什么
本轮使用 Temurin Java 21.0.9,在 macOS arm64 重新运行;原始 34 项记录保留:
| 验证组 | 结果 | 范围 |
|---|---|---|
原项目 AlignedSubtitleCueServiceTest |
5 项通过 | 短句、长中文、英文空白、长持续时间和软标点处理 |
| 独立教学算法 | 66 项通过 | 保留原 34 项,新增 32 项权重一致性、词时间异常、特殊文本与边界检查 |
| 教学 ZIP 独立解压复跑 | 同一套 66 项通过 | 归档与源文件一致,不增加独立测试数量 |
正文中的代码是当前已编译工程的节选。教学工程保留独立源码、测试和真实 fixture;原项目的五项只证明其文本测试通过,不能替代时间映射或数据库验证。
未运行真实 ASR/TTS、数据库并发、浏览器字幕预览、多设备阅读体验或 Vimorph 完整业务端到端。Unicode 测试覆盖选定样本,权重和时间映射没有得到通用可读性或逐字对齐保证。
让自动结果可以继续调整
文字切分、时间分配和人工编辑应保留各自的判断依据:字符权重帮助控制容量,自然断点改善句子边界,词时间提供近似参考,合法性检查保证时间区间可用。把这些自动结果交给界面展示和人工调整,才能继续判断字幕是否适合当前视频。