Android 联调的真实链路:网络层拦截器做加解密之后,抓包只能看到密文,logcat 里那行明文成了唯一能拿到接口最终形态的地方。可它有 4KB 上限,还会丢中间段。而通用的在线 JSON 工具,恰好假设你手里是一份完整数据。
和后端对字段,我打开 Charles,抓到的是密文。
回来看 logcat,明文在里面,但被切成五段,每段前面都挂着时间戳、pid、包名。
这是 Android 联调的日常。以前这一轮下来要五分钟,现在十秒。体验地址
一、为什么抓包不够用
网络层挂了一个 Interceptor,请求体加密,响应体解密。这套东西在安全和风控上是必要的,代价是抓包工具直接失效。
Charles 装上证书能看到 HTTPS 明文,但 body 是密文,一串 base64。改包更不行,签名对不上,服务端直接返回鉴权失败。
所以在整个链路里,能看到业务数据最终形态的地方只剩一处:解密之后、序列化之前,那一行日志。
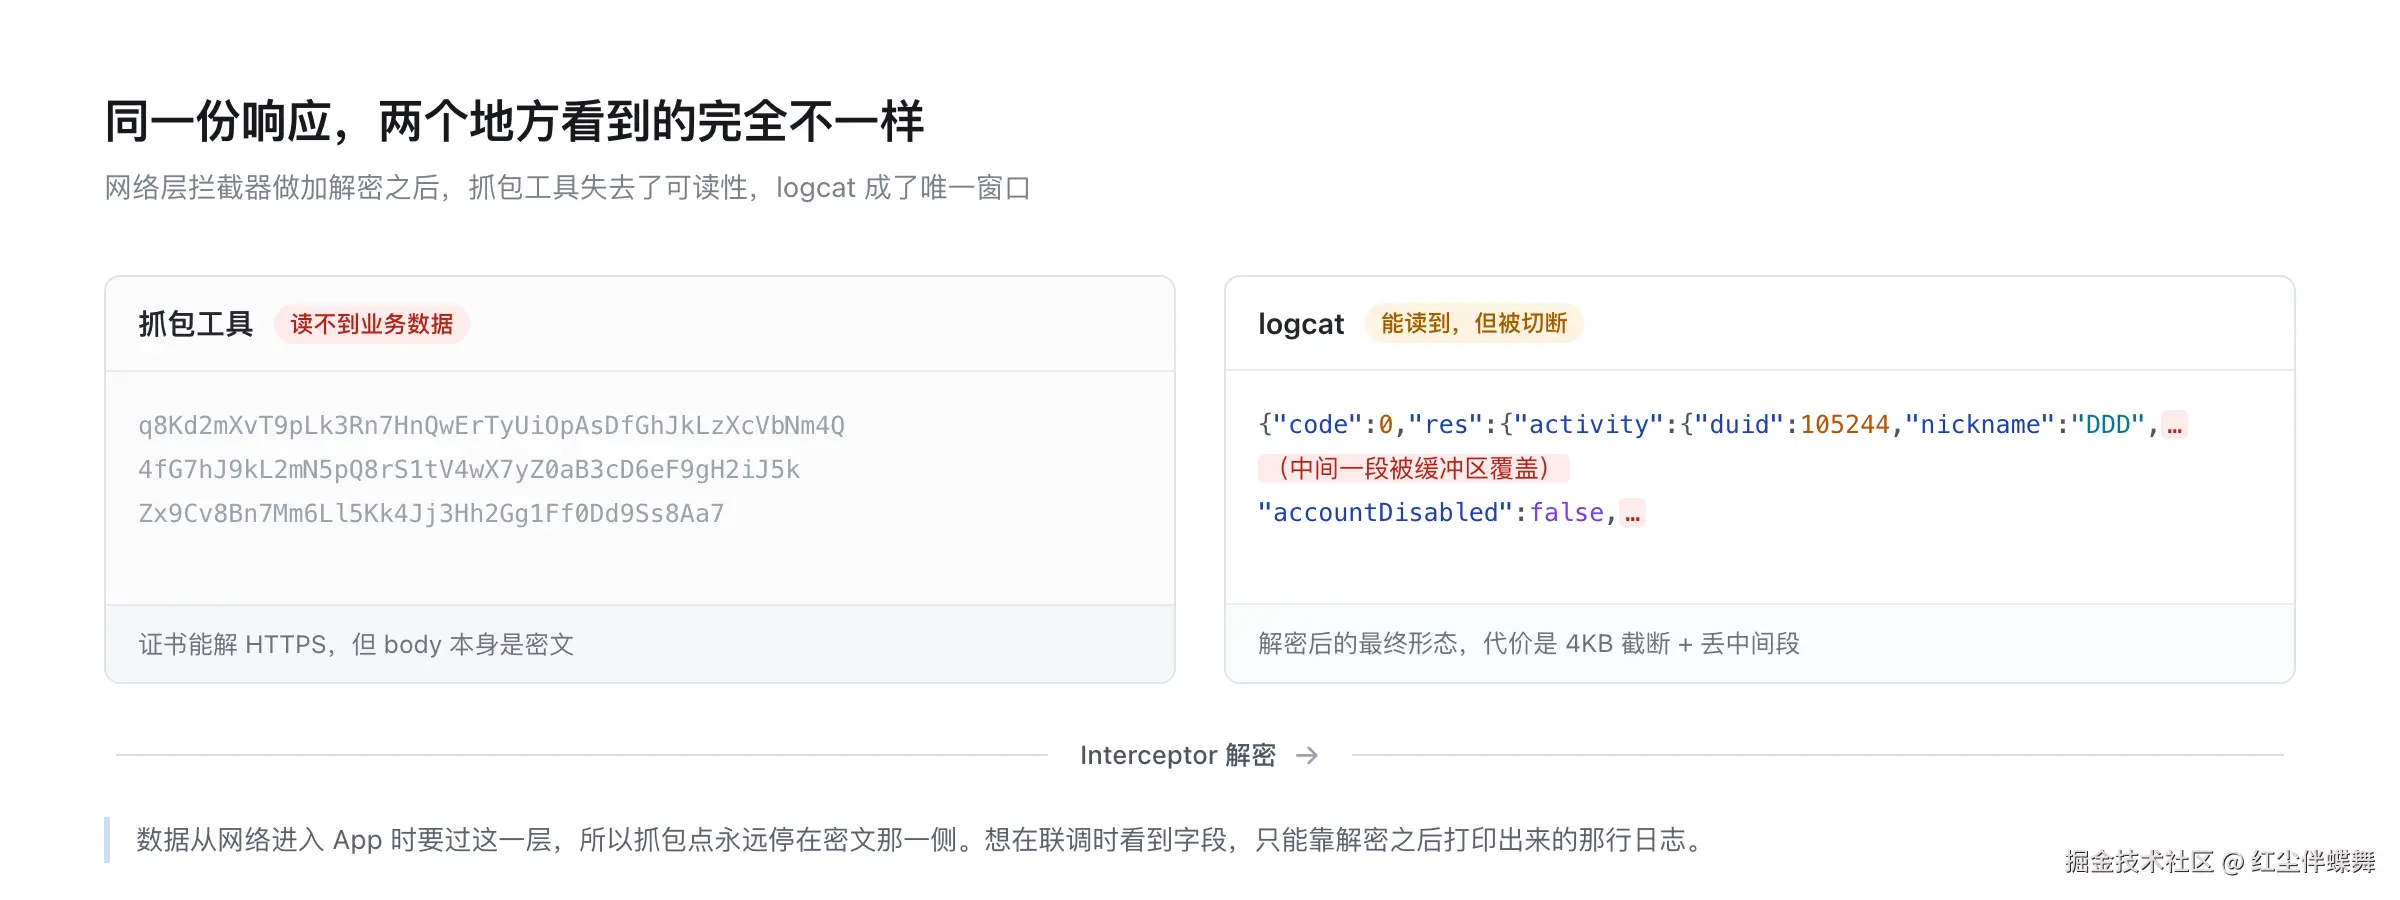 logcat 在这里不是备选方案,是唯一窗口。
这也解释了为什么很多 Android 开发者明明有抓包工具,遇到字段问题时还是第一反应去看日志。不是习惯问题,是数据只有在那里才是可读的。
二、这个窗口很窄
三个约束叠在一起:
单条消息有长度上限,四 KB 左右,超了系统直接切断。切断位置不看语法,可能正好落在一个 key 中间。
缓冲区是环形的,满了会覆盖旧数据。覆盖发生在中间,不是结尾。
每段都带前缀。时间戳、pid-tid、包名、级别、tag,切一次就加一遍。
结果就是:你想要一份 JSON,拿到的是几段碎片,每段前面还有一行元数据。
三、于是联调变成了这样
把手工流程完整走一遍,就知道损耗在哪。
第一步,复制。 要精确,多选一行少选一行都不行。少选的那行里可能就有 }。
第二步,粘到在线工具。 提示格式错误。
第三步,回去把每行前面的时间戳和包名删掉。 这里得小心,包名后面紧跟着 {,多删一个字符 JSON 就坏了。
第四步,再粘。 还是错。因为中间少了一段,删前缀解决不了。
第五步,放弃。 回到 Android Studio,肉眼找字段,一个个敲 data class。
一个接口十几个字段,嵌套三四层。敲到一半发现漏了一个,回去补。改个字段名,再敲一遍。
这个过程联调期一天重复十几次。单次三五分钟,一天就是将近一小时。
把时间拆开看:
| 环节 | 手工 | 用工具 |
|---|---|---|
| 复制 + 删前缀 | 1 到 2 分钟,还得小心别删多 | 原样粘贴 |
| 格式化 | 半分钟,遇到丢段还会失败 | 即时 |
| 敲 data class | 2 到 3 分钟,十几个字段 | 直接复制 |
| 单次合计 | 3 到 5 分钟 | 10 秒左右 |
| 一天 15 次 | 50 分钟以上 | 不到 3 分钟 |
四、通用工具的边界,就是垂直工具的机会
这类工具本身没错,问题在它的假设:输入是一份完整的、合法的 JSON。
这个假设对前端成立,对后端也成立,大家手里拿到的都是一份能直接跑的数据。但对 Android 不成立:你手里那份是从日志缓冲区里捞出来的碎片,前面挂着时间戳,中间还可能缺一段。
json.cn 这类站点不止一家,搜出来前几页功能都差不多:格式化、压缩、校验、转 XML、转 YAML、JSONPath。它们面向的是同一个通用需求,所以谁也不会为某一个场景把细节做透。换句话说,换一家也一样。
而我需要的三件事,它们一件都没有:
- 认得出
1234-5678/com.pkg D/OkHttp:这种前缀,并且知道1234-5678是一体的
- 看得出
pe":"GLOBAL"前面丢了东西,还能接回正确的层级
- 直接把结果生成 Kotlin data class,带注解、带可空性、带命名转换
不是它们做得不好,是服务的对象不是我。这是品类分工,不是能力问题。
广告是同一套逻辑。通用工具靠流量活着,流量要变现就得挂广告;我要的是一个打开就能用、不切浏览器、数据不出本机的东西。两个目标不在一条线上,所以每次切过去用,都是一次妥协。
真正缺的不是"更好的 JSON 格式化",是"给 Android 联调用的那一个"。
五、所以我做了一个
用 AI 辅助写的,单文件 HTML,离线,双击就开。打开就有示例数据,不用先准备日志就知道它能干什么。
不用装 Node,不用配环境,不用注册账号。界面就两个框,左边粘日志,右边出结果,没有要学的配置项。发给测试同学也能直接用,他们手里有线上包的日志,一样能还原出字段,不用每次都来问你。
核心是四件事:
| 环节 | 做什么 |
|---|---|
| 剥前缀 | 七种 logcat 复制格式,按信息量从多到少依次匹配 |
| 拼碎片 | 括号和引号平衡扫描,同 tag 且上一条未闭合才拼 |
| 宽容解析 | 尾逗号、单引号、无引号 key、Data(a=1, b=2) 这种 toString |
| 生成类 | Int/Long 按 int32 边界分,输出 Gson 或 kotlinx 注解 |
这里有一个决定值得单独说:没有用 JSON.parse。
js
JSON.parse('{"orderId":9007199254740993123}')
// {"orderId":9007199254740993000}
JS 的 Number 是双精度浮点,安全整数上限 2^53-1。十九位的订单号、用户 ID 直接报废,而且不报错。你只会觉得后端返回的 ID 有点怪。
所以 parser 是自己写的递归下降,数字保留原始字符串,Int 还是 Long 也从原文判断。
六、AI 一次就过的部分
上面那张表里的四件事,第一版基本一次成型。
正则、递归下降 parser、模板生成、Kotlin 类型映射,这些都是 AI 的舒适区,因为输入输出明确,没有歧义。整个工具单文件 1900 行,零依赖,写完就能跑。
到这里完成度看起来不错。然后我拿真实日志喂了它一次。
七、被真实日志打回的三次
第一次:拼接时吞掉换行
早期版本拼碎片是一律直接接:
js
prev.content += line;JSON 无所谓,反正空白不影响解析。但多行 protobuf TextFormat 会被压成一行,后续"是否多行结构"的判定直接失效,整段走错分支。
修法是看平衡扫描的状态:断在字符串中间就直接接,断在 token 之间补一个换行。
第二次:宽容 parser 吞掉下一个字段的首字母
parseObject 末尾有一句无条件 i++,本意是容错跳过异常字符。遇到没有逗号分隔的输入(protobuf 风格),它会把下一个字段名的首字母吃掉。
nickname 变成 ickname。
这个 bug 在 JSON 里永远不会触发,因为 JSON 有逗号。它只在另一种格式下暴露。
第三次:日志从中间断掉
这次最难。
我原本假设截断只发生在尾部,处理方式也简单:读不到闭合符就带着已解析的部分返回,能拿多少算多少。
真实日志是这样的:
sql
..."accountDisabled":false,
17:45:15.895  D  pe":"GLOBAL","rankType":"honor",...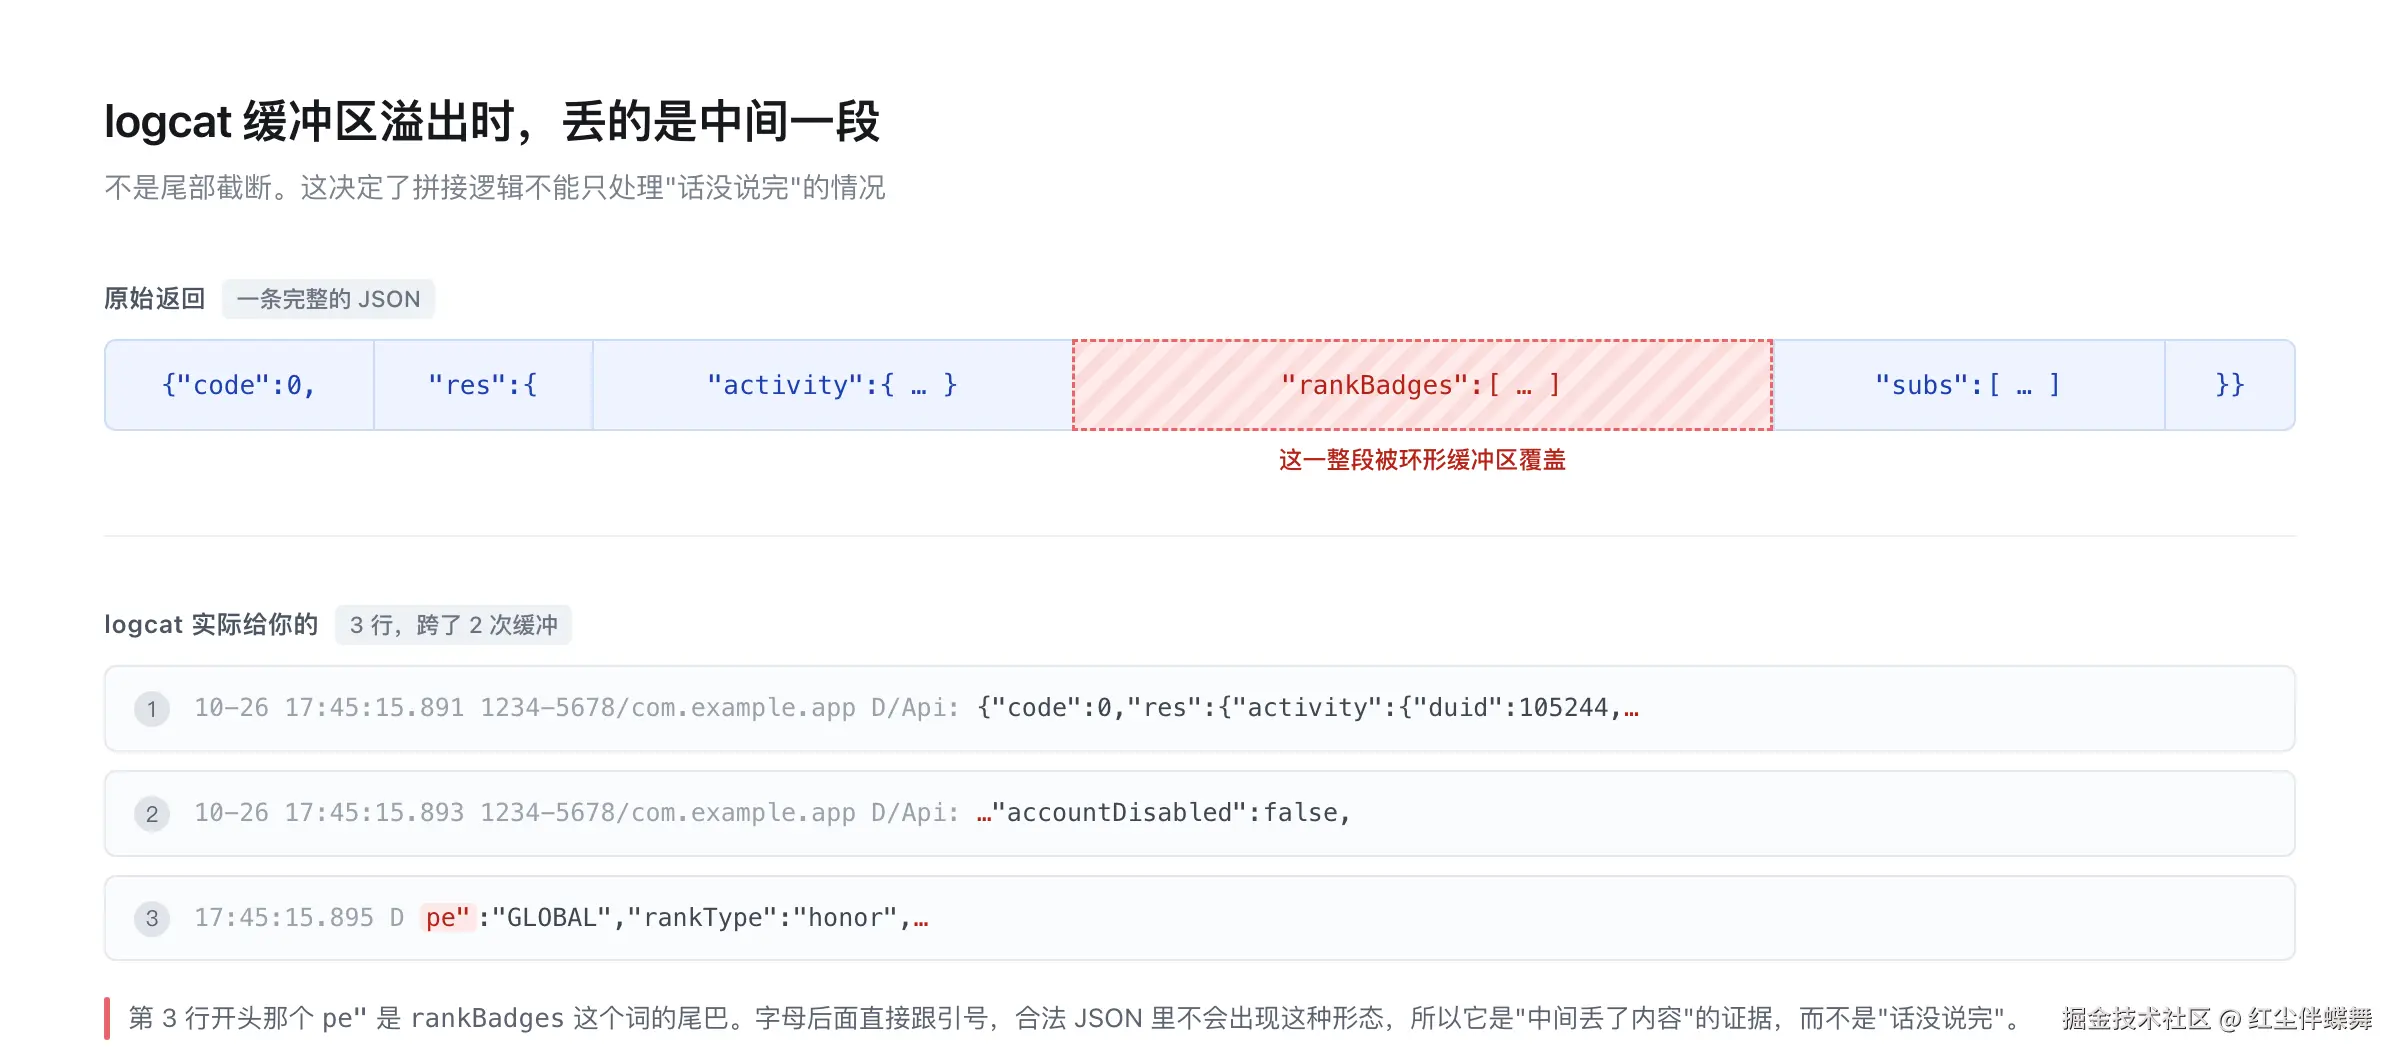
pe 是什么?它是 rankBadges 这个词的尾巴。中间那一段 "rankBadges":[{"topN":1,... 不在任何一行里。
环形缓冲区溢出时,丢的是中间一整段,不是结尾。丢在哪,跟你复制的时间点有关。
在加密链路里这件事没有兜底:抓包那边是密文,服务端日志你拿不到。丢掉的那段,就是真的没了。
拼起来就变成 "accountDisabled":false,pe":"GLOBAL",pe 被当成新字段名,后面所有 key 全部错位。生成出来的类里会冒出 val 17: Int? 这种不可能编译的东西。
八、修复里踩的两个坑
判定:什么才算"丢了东西"
左端停在 token 边界,右端却不是合法的 token 起始,才可能是丢段。普通的尾部截断左端会停在字符串中间或数字中间,不能混为一谈。
js
function isLostSegment(prevText, nextText) {
  var left = prevText.replace(/\s+$/, '');
  var right = nextText.replace(/^\s+/, '');
  if (!left || !right) return false;
  var lastCh = left.charAt(left.length - 1);
  // 左端必须停在 token 边界上,否则就是普通截断
  if (lastCh !== ',' && lastCh !== '{' && lastCh !== '[' && lastCh !== ':') return false;

  var firstCh = right.charAt(0);
  // 合法的 JSON token 起始
  if (firstCh === '"' || firstCh === '{' || firstCh === '[' ||
      firstCh === '}' || firstCh === ']') return false;
  if (firstCh === '-' || (firstCh >= '0' && firstCh <= '9')) return false;

  if (/[A-Za-z_]/.test(firstCh)) {
    var m = /^[A-Za-z_]\w*/.exec(right);
    // xxx" → 残缺的 key 尾巴,说明中间丢了内容;否则可能是 true/false/null
    if (m && right.charAt(m[0].length) === '"') return true;
    return false;
  }
  return true;
}
关键在最后那个 xxx":字母后面直接跟引号。合法 JSON 里不会出现这种形态,它是残缺 key 的证据。
对齐:括号深度扫描为什么会失败
判定出丢段之后,得把后面的内容接回正确的层级。第一版做法是括号深度扫描,从左往右数 { [ 和 } ],第一个让深度变负的位置就是"回到了外层"。
听起来没问题,实际全错。
原因很朴素。残片开头那个 " 也丢了。原本 "rankBadges" 的引号是成对的,现在只剩一个孤零零的收尾引号。整段文本的引号奇偶性翻转了 ,后面每一个字符串的起止判断都错一位。字符串内部的 {、}、, 被当成结构符号,深度计算彻底失效。
这个坑没有通用解法,因为信息本身已经丢了。只能换个不依赖引号配对的思路。
缺失段一定吞掉了数组的 [,所以残片里第一个 ]," 或 ]} 就是数组真正的结束位置,跳过残片接到那里:
js
function findRealign(text, start) {
  var rest = text.slice(start);
  var m = /][ \t\r\n]*,[ \t\r\n]*"/.exec(rest);
  if (m) return start + m.index + 1;
  m = /][ \t\r\n]*}/.exec(rest);
  if (m) return start + m.index + 1;
  // 缺失段里没有数组时,退回到对象结束
  m = /}[ \t\r\n]*,[ \t\r\n]*"/.exec(rest);
  if (m) return start + m.index + 1;
  return text.length;
}
效果是 activity 从 74 个字段恢复到 111 个,lang、groupInfo、subs 全部回来,只丢 rankBadges 一个。它确实找不回来,在被丢弃的那一段里。
九、Android 特有的那批坑
这部分跟 AI 无关,跟平台有关。做通用 JSON 工具的人不会遇到,只有天天看 logcat 的人才会。
前缀格式比想象的多。 至少七种,取决于 AS 版本、是否开了 threadtime、是不是从表格视图复制的。最容易写错的是 1234-5678/com.pkg 这一段:/ 不是空格,pid 和包名是连在一起的一个整体,正则按空格切会直接匹配失败。
长文本日志的续行没有 tag。 公司内部的长日志框架打续行时,形态是 17:45:15.895 D 内容,只有时间和级别。识别不了的话,整行连时间戳一起被当内容拼进去,17 和 15.895 就变成了字段名。
类名会撞。 字段叫 list,生成出来是 data class List(...),直接把 Kotlin 的 List 遮蔽掉,整份代码编译报错。字段叫 activity,生成 data class Activity,和 android.app.Activity 撞名。这类错误肉眼很难发现,因为类名本身完全合法,它只是抢了一个标准类型的名字。
现在的做法是维护一份黑名单,List、Map、String、Activity、View、Fragment、Context、Intent 这些统一加 Item 后缀。
可空性是个取舍。 工具里给了三档:全部可空、按样本推断、全部非空,默认全部可空。
按样本推断听起来聪明,实际不可靠。样本只有一次,这个字段这次出现,不代表下次接口还返回它,服务端加个灰度开关就能让它消失。所以"样本里非空"不能推出"实际非空",推错了就是线上崩溃。
全部可空的代价是业务代码里到处 ?:。全部非空的代价是一个字段缺失直接抛异常。默认选前者,因为解析工具不该替你做业务决策。
protobuf 有三种形态。 JSON 映射(JsonFormat.printer())天然支持,但注意 int64 在 proto JSON 里是字符串,会推成 String。TextFormat(proto.toString())也能解,关键是 repeated 字段靠重复 key 表达,不是数组,必须做合并。二进制 hex 没有 schema 也能解,但字段名只能给 field_N。
十、AI 的盲区在哪
这三次返工让我把边界看得比较清楚了。
AI 的盲区不是"写不对",是不知道有这种情况存在。
它写正则、写 parser、写类型映射都很稳,因为这些都是有明确输入输出的确定性任务。但"logcat 缓冲区会丢中间一段"这件事,不在它的先验里,也不在任何一份需求文档里。它只在我把真实日志贴进去之后才浮现。
同理,nickname 变 ickname 那个 bug,逻辑上完全正确,只是前提(有逗号分隔)不成立。
所以我把流程调成了这样:
真实数据先于构造数据。 第一版构造的样例全都是合法 JSON,测不出任何问题。真实日志一进来,三个 bug 同时暴露。测试用例应该从真实数据里长出来,而不是先想好再构造。
让工具说人话。 状态栏会显示"日志行 4 / 条目 1 / 自动拼接 10 次 / 日志缺失 1 处已跳过"。这行信息救了我好几次,因为"拼接 10 次"和"缺失 1 处"本身就是异常信号,比结果对不对更早暴露问题。如果工具静默处理,我永远不会知道它在猜。
测试脱离 DOM 跑。 parser 全部是纯函数,在 IIFE 末尾挂一个导出对象,测试脚本 mock 最小 document 之后直接 eval 页面里的 script。这样测的就是线上那份代码,不是复制品。断言从 42 项长到 86 项,每次改解析逻辑都先跑一遍。
十一、AI 真正改变的是"值不值得写"
前面几节说的都是 AI 做不了什么。但它确实改变了一件事,只是不在代码层面。
以前给自己写工具是不划算的。为了每天省五十分钟,要花两天写代码,将近一个月才回本。中途需求一变还得改,改完再测。所以大部分人宁愿忍着,忍着忍着一年就过去了。
AI 把第一版的门槛压到了几十分钟。当天回本,"给自己写个工具"这件事才重新成立。
这个变化对 Android 开发尤其明显,因为日常要碰的碎工具太多了:logcat 过滤、dp 和 px 换算、颜色值转换、JSON 对比、埋点参数拼装、崩溃堆栈还原。每一个都不值得立项排期,但每一个都在偷时间。
这些工具的共同点是很垂直。通用工具不会做,因为用户盘子太小,做出来收不回成本;但对你来说,它每天都要用。
现在它们可以各花半小时做出来,扔进一个文件夹,双击就能用。不用上架,不用过审,不用管服务器。
判断标准也简单:这件事我一周要做超过五次吗。 是,就值得花半小时;不是,继续忍着。
这也是为什么这类工具用 AI 写特别合适。它们没有复杂架构,没有并发,不需要考虑扩展性,只需要在一个很窄的场景里把边界处理干净。AI 擅长写这种确定性强的代码,剩下的事交给真实数据。
十二、为什么是单文件、零依赖
这个小工具我没有做成 npm 包,也没做构建流程。一个 HTML 文件,双击就开。
理由很实际:这类工具的生命周期取决于还能不能打开。带构建链的东西,两年后 npm install 大概率失败,Node 版本、依赖冲突、锁文件,随便一个就能劝退。单文件没有这个问题,十年后浏览器还在,它就能跑。
离线也是同一个考虑。数据不出本机,不用为"这个页面上的第三方脚本在做什么"操心。
开源的意义在我看来不是"免费给你用",而是这类小工具靠维护活着。我不用了、不维护了,别人还能 fork 走继续改,它就不会死。
如果你只想拿走解析逻辑:parseLog、parseLoose、typeOf、genKotlin 这几个函数没有一行 DOM 依赖,复制出去就能跑,搬到 CLI(adb logcat | logcat2kt)或者 Android Studio 插件里都行。
十三、它的边界
没有 .proto 就没有真实字段名。二进制解码只能给 field_1、field_2,这是信息论层面的上限,不是实现问题。
中间丢段只能部分恢复。落在缺失段里的字段永远拿不回来,状态栏会显示丢了几处,但不会假装完整。
gzip 或加密的 body 无能为力。不过加密的数据在拦截器那层就解完了,能进日志的已经是明文,所以这条其实很少碰到。
混合类型数组会退化成 List<Any>。[1, "a", null] 这种推不出统一类型,也不该硬猜。
枚举也推不出来。code: 0 到底是枚举还是状态码,工具不知道。
最后
如果接口一周只碰两次,手搓比配工具快,那用什么工具都行。
我写它是因为联调期一天要碰十几次,而且每次都要在浏览器和 IDE 之间来回切。省下来的时间是实的,一天五十分钟,一个迭代就是一天。
链条其实很短:拦截器解密之后,数据只有 logcat 这一个出口。这个出口被 4KB 卡着,被环形缓冲区啃掉中间一段,还要手工删前缀。工具只是把这一段修好。
下次再被日志坑到,改的还是 parser。