代码来源 : github.com/openai/code... · Rust 工作区 codex-rs · commit 8c07694(2026-10-18 克隆)
分析范围:本文只分析 V2 实现(工具命名空间 collaboration)。仓库中另有 V1 实现;V1 与普通 ReAct 执行模式的对比已单独成文《Codex 多智能体机制·执行模式对比》,本文不再展开。
篇目结构 :全文分上下两篇。上篇(第 0--6 章,另见《Codex 多智能体机制分析_上篇_机制与架构》 )讲机制与架构;下篇(本篇,第 7--14 章)讲治理与实践。两篇章节编号接续,本篇多处引用上篇的机制章节(均标注"上篇");阅读门槛为了解 spawn_agent 派生流程与消息投递路径。
7. 并发与资源治理:真正的工程难点
多智能体的难点从来不是"如何派发",而是"派发过多会怎样"。Codex 在这里叠了五层防线(7.1--7.5)。 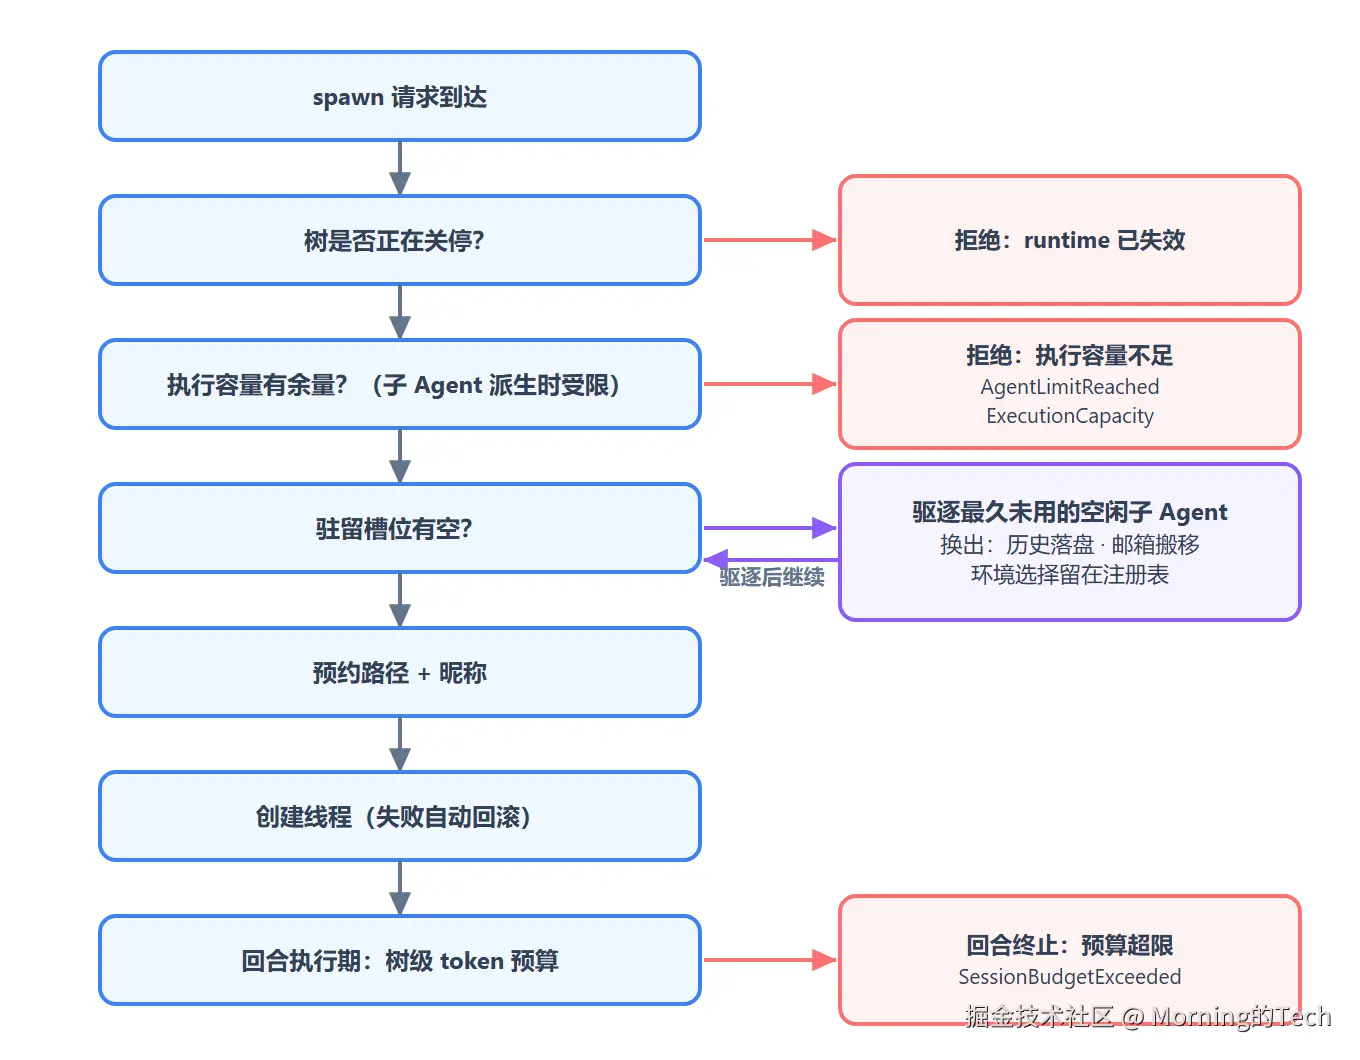 图 7:派生过程中的资源治理闸门。该图表达 spawn 请求到达后依次经过的树关停检查、执行容量、驻留槽位、路径与昵称预约、线程创建各道闸门,以及回合执行期的树级 token 预算约束;右侧为各拒绝出口,紫色为槽位满员时的驱逐旁路。
7.1 防线一:执行容量(Execution Capacity)
只限制子 Agent。根 Agent 必须始终可执行------否则整个系统将无法运行。这个限定条件很讲究:限流的目的是防止单棵 Agent 树耗尽机器资源,而根 Agent 是用户直接对话的对象,限制它等于让产品不可用。
容量上限来自 max_concurrent_threads_per_session,默认 4(含根),实际可派的子 Agent 数是它减一(根占一个)。
7.2 防线二:驻留与驱逐(Residency / Eviction)
在允许深层嵌套的情况下,如果每个子 Agent 都常驻内存,20 个 Agent × 每个数万 token 上下文,内存占用将急剧膨胀。因此引入"驻留槽位"概念:逻辑上可以存在很多 Agent,物理上只有少数几个真正装载在内存中。 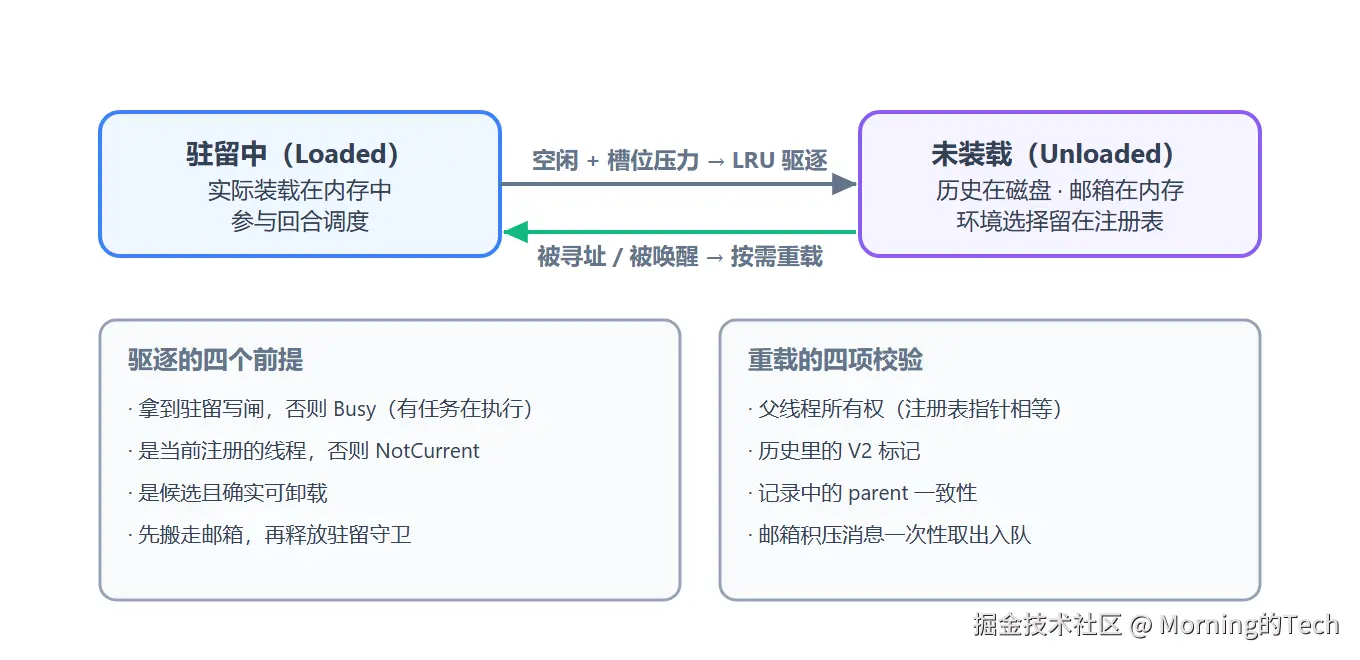 图 8:驻留状态机。该图表达「驻留中 ↔ 未装载」的迁移条件,以及驱逐的四个前提与重新加载的四项校验。
把图 8 的迁移条件展开成表:
| 迁移 | 触发条件 | 守卫与前提 | 结果 |
|---|---|---|---|
| 装载 | 派生流程创建线程,或唤醒型消息到达未装载目标 | 驻留槽预约成功(槽位不足时先 LRU 驱逐腾位) | 线程进入注册表,计入驻留槽 |
| 驻留中 → 未装载(驱逐) | 新派生需要驻留槽而槽位已满 | 候选须空闲:状态为 PendingInit/Completed/Errored/Interrupted 之一,无活跃回合,无 durable sleep,无待触发邮箱项;并能抢到目标线程的驻留写闸(抢不到则本次驱逐返回 Busy,稍后重试) | 停止回合调度 → 邮箱搬入树级邮箱 → 环境选择存入注册表 → 摘除注册表条目 → 释放驻留槽 |
| 未装载 → 驻留中(重载) | followup_task 等唤醒型消息到达,或冷恢复的子 Agent 收到任何消息 | 校验父线程所有权、历史 V2 标记、记录中的 parent 一致性 | 从磁盘恢复历史 → 重建线程 → 树级邮箱中的积压消息一次性取回输入队列 → 开新回合 |
| 终态后保持 | 回合到达终态(Completed/Errored/Interrupted) | 线程空闲即可被选为驱逐候选 | 不主动销毁;消息仍可进入树级邮箱,等待下次重载 |
驱逐候选按 LRU 选择(最近使用过的移到队尾),并跳过两类线程:本次派生受保护的线程,以及尚未启动(PendingInit)的线程------后者是容量驱逐的既有策略:保留未启动的线程。
驱逐子Agent不是"杀掉",是"换出":历史在磁盘上、邮箱在内存里、环境选择记在注册表里,下次需要时按原样重新展开。重新加载时会校验父线程所有权、历史中的 V2 标记、记录里的 parent 一致性。
这套机制让 Codex 能做到"逻辑上容纳 20 个 Agent,物理上 4 个在内存中运行",用户感知不到差异。
7.3 防线三:不设深度上限,用并发间接约束
V2 不设嵌套深度上限,只累加深度不做判断。这一判断基于现实考量:用户真正在意的不是"套了几层",而是"同时有多少在消耗资源"。控制并发数,深度自然被间接限制(一层派两个,两层就 4 个,很快逼近容量上限)。
7.4 防线四:共享 token 预算
预算记录在树级共享运行时上,整棵树共享。这解决了一个真实痛点:3 个子 Agent 并行运行时,每个都认为"我还剩 80% 预算可用",合计便会超支。共享记账让"树的总额"成为硬约束,超限时回合直接终止于 SessionBudgetExceeded。
7.5 防线五:关停可追踪、不悬挂
所有树成员(spawn、完成监听器、清理任务)都记在一个任务跟踪器里,关停时等全部退出,并收集失败报告(最多保留 64 条,防止长生命周期树把失败记录无限堆积)。
同时,所有"应该在完成后标记完成"的操作都由一个关停守卫覆盖:如果任务意外退出而未能标记完成,会被记为显式失败。这是将"静默泄漏"转为"显式告警"的典型手法。
8. 角色与模型分层:默认继承,显式窄化
子 Agent 派生出来的瞬间,有两件事必须当场定下来:它是"谁"------角色决定它的指令与能力面;它用哪个"大脑"------使用哪个大模型与推理强度决定它的智力与成本。本章讲解这两个决定的规则,一句话可以概括:默认全部跟随父 Agent;任何例外都必须显式设置,且只能收窄、不能放大。 这条哲学同时照顾能力与成本:子 Agent 默认不会比父弱,也不会悄悄换成一个更贵的模型;所有差异化入口都带着明确边界。
8.1 角色:一层有界的「减配覆盖」
角色是什么。 角色是一份打包好的差异配置,模型在 spawn_agent 时通过 agent_type 参数按名选用。它能改的项有一个白名单:开发者指令、模型、推理强度、推理摘要、输出详细度、人格、服务档位,以及一组功能开关与技能。
模型如何知道有哪些角色。 模型并不靠猜------spawn_agent 的工具描述里固有一段 Available roles: 清单:用户角色排在前,内置角色排在后,每个角色附带定位描述;配置文件锁定了模型或推理强度的角色,还会附带一句 "This role's model is set to X and cannot be changed."。选用哪个角色是模型的决定,而清单的措辞是运行时影响这个决定的方式。
解析顺序:用户优先,内置兜底。 角色名先查用户角色,再查内置角色,同名时用户角色覆盖内置角色。用户角色来自 $CODEX_HOME/agents/ 目录(递归扫描其中的 toml 文件),也可在配置文件中显式声明。省略 agent_type 时使用内置的 default 角色------它不带任何覆盖,等同于纯继承。当前内置角色有三个:default(无覆盖)、worker(定位是执行与生产工作,描述中强调必须明确文件所有权,并提醒"你不是唯一在改这个代码库的人")、explorer(定位是快而权威的代码库问答;它虽带一个嵌入式配置文件,但当前内容为空,不产生实际覆盖)。另一个 awaiter(长命令守候)已从内置列表移除。角色名不存在时报 "unknown agent_type ''";应用失败时返回固定文案 "agent type is currently not available",细节只进日志------面向模型的错误要可读,面向调试的错误走日志。
为什么叫减配。 白名单中的功能开关只包含五个可关闭项(shell 工具、apps、插件、记忆工具、权限请求工具),技能同样只能关闭:角色可以让子 Agent 比父弱,不可能比父强。其动机与安全论证见上篇 3.5------如果角色可以提权,一个被 prompt injection 影响的子 Agent 就能给自己开更宽的沙箱。测试同样印证了这条边界:角色应用后,权限、模型提供商、MCP 服务器、通知等父级配置原样保留,只有白名单内的项发生变化。
什么时候角色根本不生效。 V2 全历史 fork 不指定角色时,连 default 都不应用,子 Agent 整体继承父配置;只有 V2 全历史 fork 且显式指定角色时,角色才参与配置合成。
8.2 模型:默认继承,覆盖受提示词引导、受运行时校验
默认规则。 子 Agent 默认使用父 Agent 当前这一轮正在使用的模型与推理强度------不是会话启动时那份静态配置,而是调用 spawn_agent 这一刻的生效值;父会话中途切换模型,随后派生的子 Agent 跟上新模型。配置层还可以给所有子 Agent 预设默认(agent_default_subagent_model 与 agent_default_subagent_reasoning_effort)。
提示词立规矩。 V2 的使用提示(注入在 multi_agent_role 指令中)原文是:
Full-history forks (
fork_turnsomitted or"all") inherit the parent model and reasoning effort and do not accept overrides. Only setmodelorreasoning_effortwhen explicitly requested by the user, applicableAGENTS.mdinstructions, or skill instructions; when doing so, setfork_turnsto"none".
译成大白话:继承了父的全部上下文,就老老实实用父的模型;确有必要换,只有用户、AGENTS.md 或技能明确要求时才换,并且要用 fork_turns="none" 明示"我主动放弃了上下文继承"。
关键区分:这是提示词的规矩,不是运行时的拦截。 上文 "do not accept overrides" 约束的是模型的行为,不是程序的执行。运行时测试专门覆盖了 fork_turns="all" 加显式 model 的组合,断言子 Agent 照样使用请求的模型(测试名 spawned_full_history_v2_child_uses_model_precedence_without_dropping_context)------模型不守规矩时,程序并不会拒绝执行。提示词负责防患于未然,运行时负责的是另一类兜底:
运行时真正强制三件事。
- 模型名必须在候选列表内。 候选只收录"在模型选择器中可见、且支持多智能体后端"的模型,最多 5 个。不在名单内会直接报错,并把可用模型列出来给模型看:"Unknown model
Xfor spawn_agent. Available models: ..."。 - 推理强度必须是该模型支持的档位,否则同样报错。
- 角色锁定的模型优先于调用参数。 工具参数里的模型先应用、角色后应用,因此角色自带的模型会盖住调用时传入的 model。
这三条合起来正是"用工具 schema 做约束"的范例:与其在运行时报一堆难以理解的错误,不如让不合法的选项根本不出现在候选列表里。
9. Guardian:第二类多智能体
Codex 中还有一套多智能体用法,容易被忽略但很有参考价值:评审型 Agent。
Guardian 的职责不是执行任务,而是在动作执行前由另一个模型评估其危险性 。它通过线程管理器启动隔离的评审会话来运行,而非简单地调用一次模型。它具有独立的工具策略,只能读取父会话的受限视图。
这套设计有三点值得借鉴:
- 评审 Agent 与被评审 Agent 不共享控制权,只共享"只读视图"------评审者不能修改被评审者的状态;
- 评审是异步/同步双路径:一路边走边打分(工具调用级别),一路在需要决策时同步介入;
- 失败即拒绝(fail-closed) :评审器不可用时不是"放行",而是"拒绝"------安全机制的默认值必须是保守的。
未验证说明:Guardian V2 的采样器数量、连接池上限、抢占式调度等实现参数,本快照中未能逐项核对,上文仅描述机制,不引用数值。
10. 可观测性:一棵树如何被记录
多智能体的调试难度很高:出现问题时,面对的是树形结构而非单线流程。Codex 用四种粒度记录。
粒度一:线程级。每个线程有独立 rollout 文件,记录完整对话与工具调用。
粒度二:树级。rollout-trace 把派生关系还原成运行时节点与信息流边:
| 记录项 | 来源 | 含义 |
|---|---|---|
| AgentThread | 子线程派生 | 子线程在 trace 里的节点 |
| ToolCall | 5 个协作工具 | 根侧发起的协作工具调用 |
| ConversationItem | 子 Agent 面向模型的消息 | 子 Agent 看到的历史 |
| InteractionEdge | spawn / task / result / close | 父子之间的信息流 |
粒度三:事件级。SubAgentActivityItem(Started / Completed,带线程 ID、路径、模型)会作为父回合的正式条目发出,所以 TUI 里能实时看到"某个分支开始了/完成了"。
粒度四:指标级。埋点包括派生计数(带角色、版本标签)、结果投递(queued / failed 分开统计)、工具级调用记录。
值得借鉴的一点:result_delivery 将"入队成功"与"投递失败"分开统计。消息系统中"已发送"与"已送达"是两件事,混合统计会在故障排查中导致错误结论。
11. 功能清单(可作为配置手册使用)
11.1 协作工具面
| 工具 | 必填参数 | 一句话语义 | 关键限制 |
|---|---|---|---|
| spawn_agent | task_name, message | 派生子 Agent 执行单项任务 | task_name 只能小写字母/数字/下划线;fork_turns 只能是 none/all |
| send_message | target, message | 给某个 Agent 留言,不唤醒 | 目标是路径或 ID |
| followup_task | target, message | 派后续任务,空闲则唤醒 | 不能指向根 |
| wait_agent | 无 | 等任意 Agent 有状态更新 | 超时 10s~1h,默认 30s;只回摘要不回内容 |
| list_agents | 无(可选 path_prefix) | 列出树里的活 Agent | 支持子树前缀过滤 |
| interrupt_agent | target | 打断目标当前回合 | 不销毁线程 |
11.2 关键配置项
| 配置 | 默认 | 作用 |
|---|---|---|
| enabled | --- | 开启多智能体工具面 |
| max_concurrent_threads_per_session | 4 | 树内线程总数上限(含根),可派 = N-1 |
| min_wait_timeout_ms / default_wait_timeout_ms / max_wait_timeout_ms | 10s / 30s / 1h | wait_agent 超时约束 |
| tool_namespace | collaboration | 工具命名空间,可避免与宿主工具命名冲突 |
| hide_spawn_agent_metadata | true | 只返回 task_name,不暴露线程 UUID |
| expose_spawn_agent_model_overrides | true | 是否暴露 model / reasoning_effort 字段 |
| wait_agent_enabled | true | 是否暴露 wait_agent |
| disable_native_tools | false | 隐藏原生工具但保留多智能体运行时(给宿主自定义工具用) |
| disable_direct_message | false | 关掉 Agent 间直接私聊,只保留派生和结果回流 |
| preserve_fork_prefix | false | 全量 fork 时是否保留父级 prompt 前缀(影响缓存命中) |
| message_board_in_memory / message_board_remote | false / 空 | 消息板内存模式 / 远端板 |
| root_agent_usage_hint_text / subagent_usage_hint_text | 空 | 直接覆盖注入给根/子的行为准则 |
| subagent_developer_instructions | 空 | 覆盖没有专属角色的子 Agent 的开发者指令 |
hide_spawn_agent_metadata = true 是个很有想法的默认值:不把 UUID 暴露给模型。模型不需要它(路径就够了),给了反而可能被幻觉编造。
12. 两个完整例子:一次复杂任务是如何执行完成的
前面各章介绍的是各个组成机制,本章将它们组合为完整流程。两个例子覆盖两类最典型的复杂任务:
- 例一是"一对多并行":一条主任务拆分出三条互不依赖的支线,考察派生、并行、结果回流;
- 例二是"多层级联 + 动态纠偏":任务在执行中才暴露出深层结构,考察嵌套派生、容量驱逐、重载、中断纠偏、预算熔断。
再次提醒:例子的流程与资源行为严格对应代码机制;模型每轮的具体措辞是示意。横轴是逻辑时间,不追求真实耗时比例。
12.1 例一:三平台 webhook 签名调研 + 对比汇总
用户请求 :"调研 Stripe、PayPal、PayID 三个支付平台的 webhook 签名验证机制,汇总成对比表。" 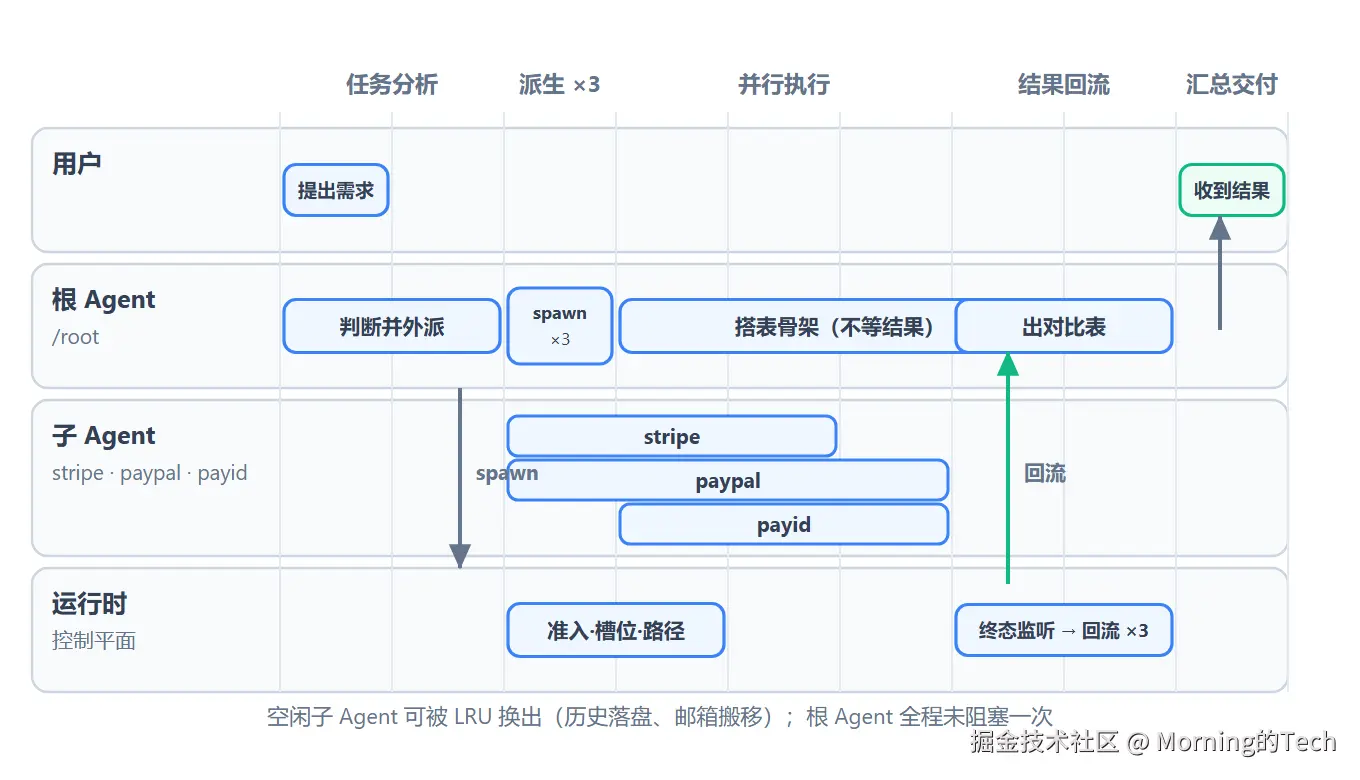 图 9:例一执行推演(甘特图)。该图表达三条边车任务并行派生、根 Agent 全程未阻塞、结论经终态监听异步回流的完整过程。
分步讲解:
| 阶段 | 谁在做什么 | 背后机制 |
|---|---|---|
| ① 任务分析 | 根 Agent 读取请求并判断:三条支线互不依赖 → 边车任务;"汇总成表"卡在三条结论上 → 关键路径,由根 Agent 自行处理 | 编排策略在 prompt 层(上篇 3.1);阻塞任务由根 Agent 自行处理,不派发给子 Agent |
| ② 派生 ×3 | 根 Agent 连续发起三次 spawn_agent,task_name 分别取 stripe / paypal / payid,message 里写明"只结论、带出处、按统一字段返回" | 每次派生都走完整的运行时流程(上篇第 5 章):准入 → 容量 → 槽位 → 路径注册 → fork 历史 → 建线程 → 写 Open 边 → 完成监听 |
| ③ 路径就位 | 三个子 Agent 分别获得 /root/stripe、/root/paypal、/root/payid,UUID 对模型不可见 | 路径规划(上篇 2.1);hide_spawn_agent_metadata |
| ④ 并行执行 | 三个子 Agent 各自搜索文档、读规范、交叉验证。每个的上下文只有自己的任务,互不污染 | 同构副本(上篇 3.3);上下文隔离是场景三的解法 |
| ⑤ 根不等待 | 根 Agent 获得三个 task_name 后即返回,继续搭建汇总表骨架(列名、评分维度),未调用 wait_agent | 异步回流是主路径,wait_agent 是兜底机制(上篇 6.4) |
| ⑥ 终态回流 | 三个子 Agent 先后 Completed。完成监听器把每条结论渲染成 FINAL_ANSWER 消息,作为根回合的正式条目注入,role = "assistant",带 Task name 溯源 | 终态映射(上篇 2.2);回流格式(上篇 6.3) |
| ⑦ 汇总交付 | 根 Agent 收齐三条结论,填进骨架,输出对比表;子 Agent 空闲后被 LRU 换出,树随根会话结束整体关停 | 驻留驱逐(7.2);关停跟踪(7.5) |
本例的核心认知 :根 Agent 全程未发生阻塞 。派发任务后它继续处理自身任务,三条结论由子 Agent 自动回流。多智能体在此换来的是墙钟时间(实际耗时)的缩短,代价是三份并行的 token 消耗。
12.2 例二:跨模块 bug 修复(Safari 导出 CSV 乱码)
用户请求:"用户反馈在 Safari 里导出 CSV 文件名和内容都乱码,帮忙定位并修复。"
这个任务的复杂之处在于:结构是在执行过程中才暴露的 ------先要定位,定位后才发现链路跨前后端,需要再拆分;中途还会出现执行方向偏离、容量达到上限、Agent 被换出后重载等情况。 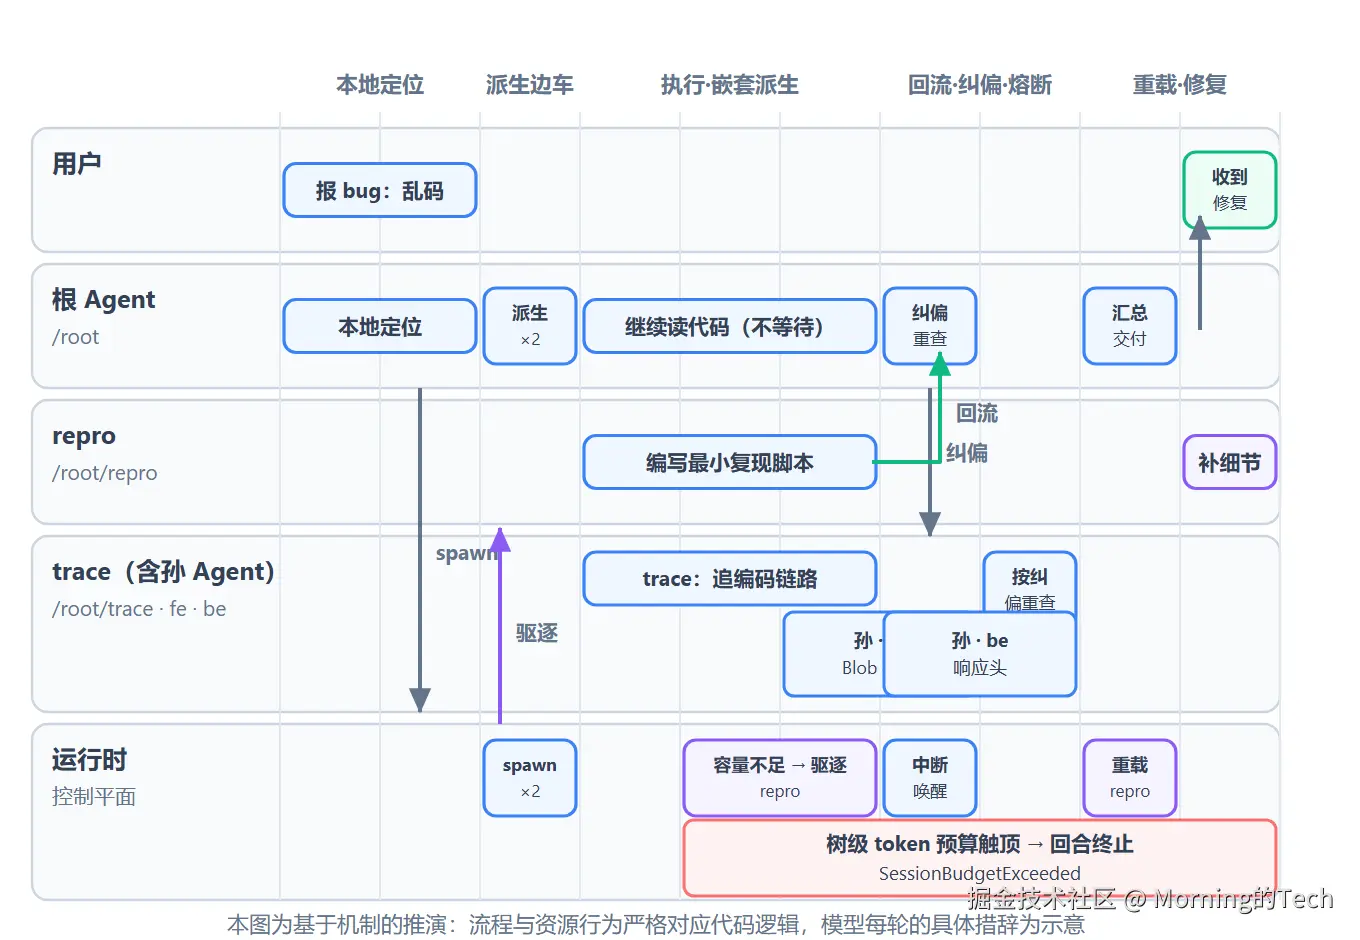 图 10:例二执行推演(甘特图)。该图表达嵌套派生、容量驱逐、中断纠偏、预算熔断与按需重载在一条时间轴上的动态过程。
分步讲解:
| 阶段 | 谁在做什么 | 背后机制 |
|---|---|---|
| ① 本地定位 | 根 Agent 首先自行读取 issue、复现步骤、查看导出入口代码。"到底是不是编码问题"卡在后续所有步骤上 → 阻塞任务,由根 Agent 自行完成 | 说明书明确约束:阻塞关键路径自行处理(上篇 3.1) |
| ② 派生两个边车 | 确认是编码链路问题后,根 Agent 派 /root/repro(写最小复现脚本)和 /root/trace(排查"前端 Blob 构造 → 传输 → 后端响应头"全链路)。两者互不依赖,且都不阻塞根 Agent 继续读代码 | 场景一并行;fork 历史让子 Agent 携带"用户提出了什么",但不携带父级的中间推理过程(上篇 5.3) |
| ③ 嵌套派生 | trace 发现链路跨前后端,派孙 Agent /root/trace/fe(查 Blob 构造与 charset)和 /root/trace/be(查 Content-Disposition 头) | 不设深度限制,路径自然长成 /root/trace/fe(7.3) |
| ④ 容量与驱逐 | 孙 Agent 同样计入执行容量(子 Agent 派生的也一样受限)。槽位不够 → 运行时驱逐最久未用的空闲子 Agent------repro 刚执行完毕正好空闲,被换出:历史落盘、邮箱搬进 Mailboxes、环境选择留在注册表 | 执行容量只限子 Agent(7.1);先搬邮箱再释放守卫(7.2) |
| ⑤ 结果回流 | repro 的复现脚本结论先流回根 Agent;fe/be 的结论流回 trace,由它汇总成"链路结论"再流回根 | 结果回流是消息而非返回值(上篇 6.3);中间层自然承担汇总与压缩职责 |
| ⑥ 发现方向偏离 → 纠偏 | 根 Agent 发现 trace 正在排查一个无关的转码逻辑。先 interrupt_agent 中止其当前回合(不销毁线程),再 followup_task 带上纠偏指令唤醒它重新排查 | send_message 只入队不唤醒,纠偏必须用 followup_task(上篇 6.2);中断不算结果,不产生回流消息(上篇 2.2) |
| ⑦ 预算熔断 | 孙 Agent 大批量读源码时把整棵树的 token 预算推到上限,某个回合直接终止于 SessionBudgetExceeded,错误作为 Errored 结果回流给根 | 树级共享记账(7.4):防止"每个分支都认为仍有余量,合计就会超支" |
| ⑧ 按需重载 | 根 Agent 想找 repro 补充一个细节,但它已被驱逐。运行时从磁盘重载:校验父线程所有权、历史 V2 标记、parent 一致性 → 通过 → 邮箱里积压的消息一次性取出进输入队列 | 懒驻留换来的能力(7.2);"逻辑上存在,物理上未装载" |
| ⑨ 修复交付 | 根 Agent 汇总:前端补 BOM/charset、后端补响应头、附复现脚本与回归测试。各 Agent 陆续终态,树随根会话关停 | RAII 回滚守护全程待命,均未触发------治理机制的价值在于:未发生故障时其持续生效 |
本例的核心认知 :多智能体系统真正的考验不是"能否派发",而是执行过程中状态不断变化时系统仍能保持自洽------容量不够就换出、方向错了就纠偏、预算超了就熔断、要对话的 Agent 不在内存就重载。这些全是运行时职责,模型只负责在合适的时机发起对应的工具调用。
12.3 例子与机制对应表
| 例子里的动作 | 机制 | 章节 |
|---|---|---|
| 判断"这个能并行、这个不能" | prompt 层编排策略 | 上篇 3.1 |
| task_name → /root/trace/fe | 路径规划 | 上篇 2.1 |
| 派生时复制配置与历史 | 同构副本 + 有损 fork | 上篇 3.3 / 5.3 |
| 三个/五个 Agent 同时跑也不触限 | 执行容量 + 驻留槽 + LRU 驱逐 | 7.1 / 7.2 |
| 结论自动回流 | 终态监听 + FINAL_ANSWER 回流 | 上篇 6.3 |
| 留言不唤醒、派发任务才唤醒 | MessageDeliveryMode 两态 | 上篇 6.2 |
| 打断偏离方向的回合 | interrupt_agent | 上篇 6.2 |
| 整棵树 token 不超支 | 树级共享预算 | 7.4 |
| 被驱逐的 Agent 还能对话 | 按需重载 + 所有权校验 | 7.2 |
| 出事不留"半棵树" | RAII 回滚 + 关停跟踪 | 上篇 3.7 / 7.5 |
13. 设计取舍与批判
以上为设计优势,本节讨论其代价。以下是借鉴前必须充分考虑的问题。
① 编排质量完全依赖模型。 没有可复用的编排 DSL,没有"任务图编译期检查"。同一个任务,换模型、换 reasoning effort、甚至换一次采样,拆分方式可能完全不同。生产环境中这意味着行为不可复现------对需要审计的行业(金融、医疗)是严重障碍。
② 结果消息的信任边界被弱化。 子 Agent 的结论以 role = "assistant" 注入父上下文,形式上等同于"父自己的判断"。如果子 Agent 被注入攻击或产生了幻觉,父 Agent 缺少"这是外部输入,需要核验"的警觉。这是本分析中最值得讨论的一处设计(不少实践者也会自行改造:将子 Agent 结论放入 role = "user" 或添加显式的"未经核验"标记)。
③ 路径寻址对模型的分支推理能力有要求。 /root/task1/task_3 这类绝对路径在小树中很好用,树较深时(4 层、十余个分支)模型容易拼接错误路径。Codex 的缓解手段是 list_agents(path_prefix) + 相对名解析,但仍然依赖模型主动查询。
④ 驱逐/重载的语义对用户不透明。 "逻辑上存在的 Agent 可能已不在内存",重载要校验父所有权、历史 V2 标记、parent 一致性。这套校验完备,但代价是恢复失败时的错误信息对用户不友好。对 CLI 场景可以接受,对产品化场景需要额外封装。
13.1 与常见多智能体方案的对比
下表只对比模式类型(业界常见做法的归类),不对任何具体框架的版本下结论------具体框架的实现随版本变化很快,需要以各自最新文档为准。
| 维度 | 中心编排器(supervisor / 图 DSL) | 纯 prompt 委派 | Codex:模型决策 + 运行时治理 |
|---|---|---|---|
| 编排决策者 | 框架代码(预定义任务图/状态机) | 模型自主决策 | 模型(prompt 层),运行时只做硬约束 |
| 子 Agent 形态 | 图节点 / 受限工具调用 | 另开一段对话 | 同构线程(同工具、同沙箱、可再派) |
| 身份与寻址 | 图节点 ID / 队列名 | 弱(靠对话历史) | 规范路径 /root/a/b |
| 资源治理 | 框架统一管(队列/并发) | 基本没有 | 容量 + 驻留槽 + 树级预算 + 原子回滚 |
| 可复现性 | 强(图是代码,可测试) | 弱 | 弱(编排不可复现,治理可复现) |
| 灵活度 | 低(改行为要改图、发版) | 高 | 高(改行为改 prompt) |
| 典型风险 | 过度工程;为简单任务付架构税 | 失控、重复派发任务、无法排障 | 依赖模型能力;治理参数需调 |
Codex 的选择落在第三列:用 prompt 的灵活性换取架构的简单性,再以运行时的硬约束为这种灵活性设定边界。这个交换是否值得,取决于你的场景对"可复现"和"灵活"的权重。
13.2 明确的不适用场景
- 不适用于需要严格复现、逐笔审计的批处理流水线------编排不可复现是结构性属性,调参无法消除;
- 不适用于子任务间有大量细粒度共享状态的场景------消息是唯一耦合,没有共享内存/黑板,高频状态同步会淹没在消息里;
- 不适用于需要跨会话常驻的"专家 Agent"------Agent 树随根会话消亡,常驻需求应交给外部服务或 AgentMessageBoard;
- 不适用于轻量单轮任务------派生有固定开销(建线程、fork 历史、写图谱边),任务本身几十秒能做完时,多智能体得不偿失;
- 不适用于根 Agent 模型能力弱的场景------编排质量完全依赖根模型,ExplicitRequestOnly 模式下至少不会主动拆分错误,但用户明确要求拆分时仍可能错误地拆分任务。
14. 如果要借鉴,落地清单
按重要程度排序:
必做(缺了就不算多智能体)
- 定义"Agent 的物理载体" :一条有独立上下文/工具/持久化的线程。不宜将"一次函数调用"视为 Agent。
- 把"派生"做成原子操作:占槽 → 建线程 → 注册身份 → 写拓扑 → 投递任务,任何一步失败都要能回滚(RAII 守护是最稳妥的实现方式)。
- 给 Agent 一个稳定身份:使用路径或命名,不宜使用 UUID。模型友好的身份比机器友好的身份更重要。
- 消息是唯一耦合:不要共享可变状态。有共享状态,就无法做懒加载、无法做驱逐、无法做独立恢复。
强烈建议(决定上限)
- 两层容量治理:逻辑并发数(能派几个)+ 物理驻留数(同时几个在内存)。两者分离才能实现"逻辑上无上限,物理上可控"。
- 树级预算记账:token 预算挂在树根,不挂在单个 Agent。
- 权限单调不增:角色/子配置只能关闭能力,不能开启。
- 结果回流用"消息"而不是"返回值" :让父 Agent 能在不阻塞的情况下继续工作。
加分项(决定体验)
- 把编排策略写成 prompt,并给出"何时不该做" 。多数实现仅说明"能做什么",Codex 则以大量篇幅说明"不该做什么",这才是行为稳定的关键。
- 模式闸门:用模型档位/用户设置控制"是否允许主动拆解",成本低于事后纠错。
- 可观测性分层齐备:线程级日志 + 树级 trace + 事件级 UI 通知 + 指标级埋点。
附录 关键常量与事实核对
| 事实 | 值 | 出处 |
|---|---|---|
| 默认线程上限 | 4(可派 3 个) | config/mod.rs |
| 默认工具命名空间 | collaboration | config/mod.rs |
| wait_agent 超时 | 最小 10s / 默认 30s / 最大 1h | multi_agents_common.rs |
| 默认角色名 | default | agent/role.rs |
| 模型覆盖候选上限 | 5(仅收录选择器可见且支持多智能体后端的模型) | agent/child_config.rs |
| 全量 fork 的默认值 | fork_turns 缺省即 all | multi_agents_v2/spawn.rs |
| 默认隐藏 Agent 元数据 | true | MultiAgentV2Config::defaults_for_max_concurrency |