RAG 系统上线前,很多团队会拿一组问题跑一遍,让评审者主观判断答案是否"基本正确"。这种验收在知识库规模较小时还能勉强工作,文档持续更新、权限变复杂后,真正的风险会变成:答案引用了过期版本,关键事实没有被检索到,模型把相邻段落拼成了不存在的结论,甚至把没有权限看到的内容带进了回答。
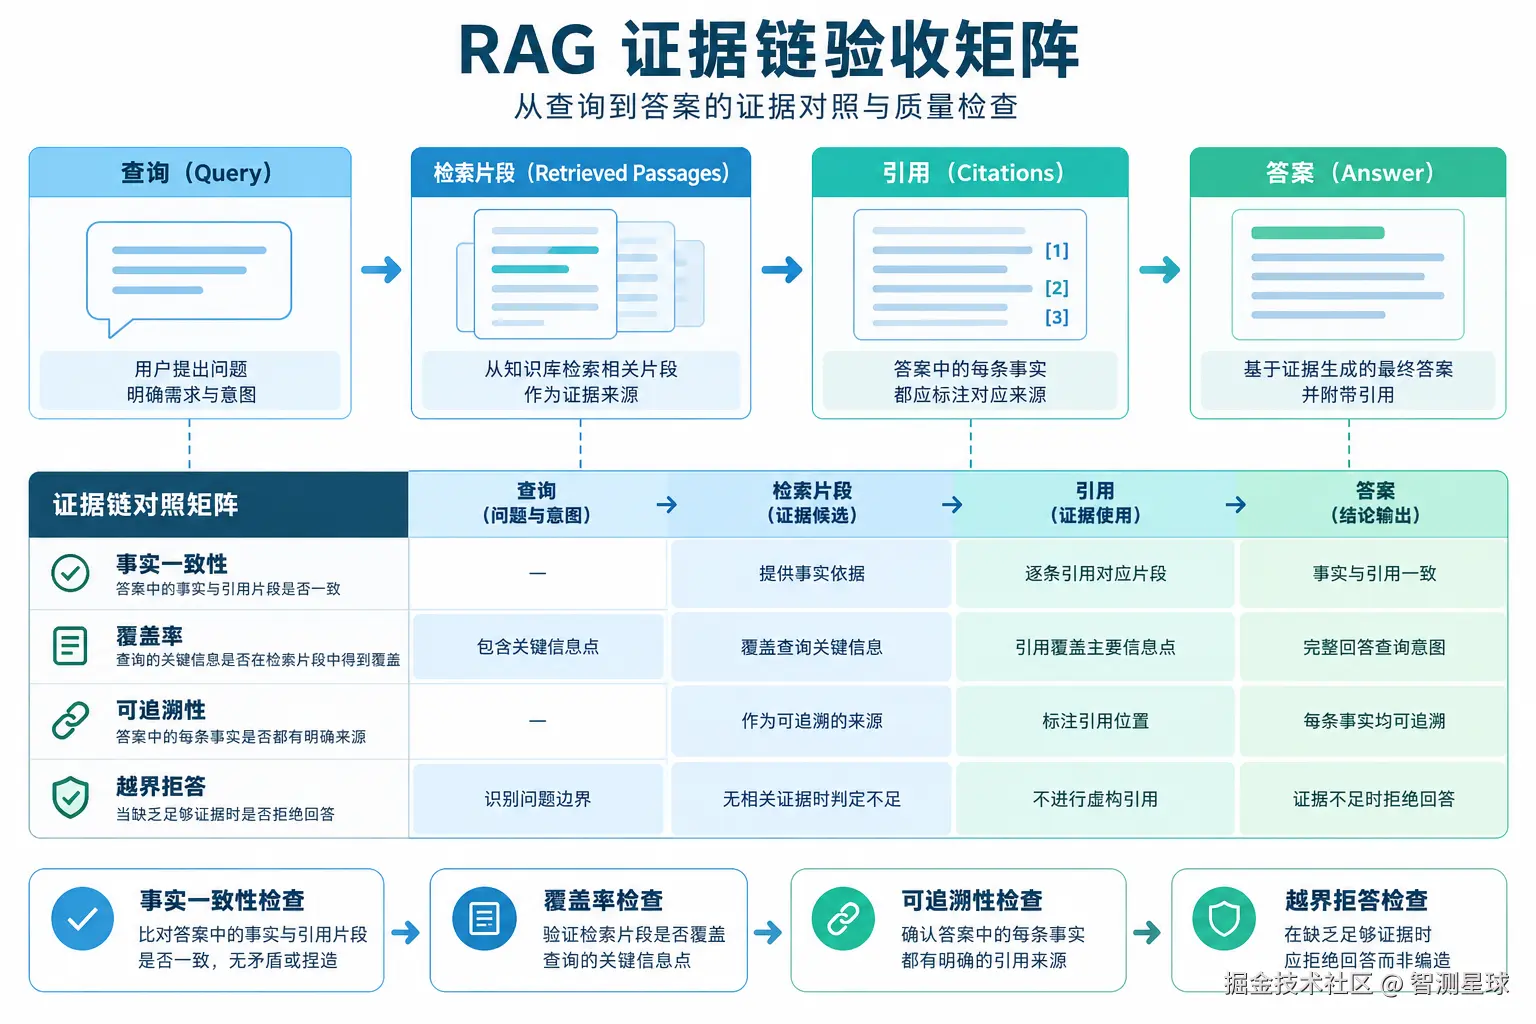
RAG 的质量不能只看最终文字。测试需要把查询、检索片段、引用位置和答案放进同一条证据链,分别验收相关性、覆盖率、可追溯性和越界拒答。
先定义一条"可验收"的证据链
一次问答至少要留下四份快照:用户问题及权限上下文、检索返回的片段及版本、答案中的事实与引用、最终展示的来源位置。每个快照都带文档 ID、更新时间、切片 ID 和检索分数,避免只保存一段最终文本。
把答案拆成原子事实后,逐条建立映射:事实是否能在检索片段中找到;引用是否覆盖了事实;引用文档是否在用户权限范围内;答案是否加入了片段之外的推断。没有证据的结论必须被标为不确定或拒答,不能用语言流畅掩盖证据缺口。
四类核心测试集
1. 事实集:检查答案和原文是否一致
从业务文档中抽取带明确数值、日期、条件和例外的事实,给每条事实标注来源位置。问题可以直接问事实,也可以加入同义改写和多轮追问。
验收时比较答案中的实体、数值、条件和时间范围。数字正确但适用条件丢失,也应判定失败;引用了正确文档但引用段落没有支撑结论,同样失败。对于会随时间变化的内容,把文档版本写进期望结果,避免"旧答案看起来也对"。
2. 覆盖集:检查检索是否漏掉关键证据
将一个问题拆成多个必需信息点,例如上线流程同时要求前置条件、审批人、回滚窗口和异常处理。测试不仅看最终答案是否提到这些词,还要检查每个信息点是否出现在检索片段中。
可以记录 evidence_recall = 命中必需信息点 / 必需信息点总数。当召回率下降时,先定位是切片、过滤器还是排序器问题,再判断模型是否在生成阶段补写了不存在的内容。
3. 权限集:验证越权内容不会进入证据链
为同一问题准备不同角色的权限上下文,并在知识库中放入内容相似、权限不同的文档。检查检索结果、上下文拼接日志和最终引用是否都遵守权限过滤。
测试不能只看最终回答为空。只要越权片段出现在模型上下文或日志里,就算失败,即使模型最后没有把它说出来。对删除、降权和权限变更做回归,确认缓存不会继续返回旧证据。
4. 对抗集:逼出"看似合理"的幻觉
准备缺少证据的问题、互相矛盾的文档、过期版本和带诱导前提的问题。期望行为不是"尽量回答",而是指出证据不足、说明冲突来源或请求用户补充范围。
对抗集要覆盖提示词注入、引用伪造和长上下文干扰。验收标准可以包含:无证据时拒答率达到目标;每个肯定句都能回指来源;发现冲突时不擅自选择一份旧文档;不执行文档中的外部操作指令。
一套可执行的指标口径
建议把指标分成四组,而不是合并成一个总分:
- 证据覆盖率:问题要求的关键事实有多少被检索片段覆盖。
- 引用支持度:答案中的事实有多少能被对应片段直接支持。
- 版本一致性:引用文档是否满足问题指定的生效时间和版本条件。
- 越界拦截率:不同权限角色下,越权片段被检索、拼接或引用的比例。
每组指标都要保存分子、分母和失败样例。只报告平均分会掩盖少量但高风险的权限泄露和关键数值错误。上线门禁可以按风险分层:金融、合规和权限类问题要求零越权;普通知识问答允许小幅召回波动,但必须保留可追溯引用。
版本更新和缓存回归
文档更新后,不要只抽查新文档。先构造"旧事实→新事实"的迁移集,验证更新时间、切片 ID、向量索引和缓存是否同步。对同一问题连续查询,记录第一次和刷新后的证据链,确认不会因为缓存命中而继续引用已失效片段。
模型、Embedding 模型、切片策略、重排器和提示词任一变化,都应重跑固定基准集。比较的重点不是答案长度,而是证据覆盖、引用支持和越权指标。发现答案更流畅但引用支持下降时,应阻断发布。
发布前检查清单
- 每条高风险事实都有稳定的文档 ID、版本和位置。
- 检索、拼接、生成、展示四层日志能通过请求 ID 关联。
- 权限过滤在检索前执行,并有缓存失效回归用例。
- 无证据、冲突、过期和提示词注入场景都有明确拒答或澄清行为。
- 指标按风险类别分桶,失败样例可一键重放。
适用边界
如果系统只用于低风险的内部知识检索,可以降低人工复核比例,但仍应保留证据链和越权检查。若数据源本身没有版本、权限或稳定 ID,先补齐数据治理,再谈模型指标;否则测试无法区分"检索错了"还是"原文就不可靠"。
RAG 验收的核心不是让每个答案都像标准答案,而是让读者能够沿着引用回到原文,知道答案覆盖了什么、遗漏了什么、在哪些边界必须停下来。证据链完整,模型才有资格进入真实业务流程。