很多人用 AI 写代码的流程是这样的:
- 提需求;
- 等它写完;
- 打开 diff;
- 发现它把不该动的地方也动了;
- 重来。
这个流程最大的问题不是模型不听话,而是范围从一开始就只存在于提示词里。
你说"只改订单模块",它听到的是一句自然语言;你说"不要引入新依赖",它可能在 第三十个文件里已经忘了。提示词能表达意图,但它不是系统约束。
Jin 想做的第一件事,是把"范围"从聊天里拿出来,变成一份可以先审阅的架构提案。
一、先审架构,不是先审每一行代码
"先审架构"听起来很重,其实不是让你在 Agent 写代码之前逐行 design review。
它只要求先确认四件事:
- 这次改动涉及哪些模块?
- 允许新增或修改哪些公开实体?
- 允许出现哪些依赖?
- 哪些东西明确不能动?
这些东西用 L0/L1 表达,比几百行代码短得多,也更容易看出方向对不对。
比如你要给取消订单加审计,可以先让 Agent 提案:
text
目标:
- 新增 audit 模块,负责审计事件;
- orders 通过事件发布审计,不直接依赖 audit 的实现;
- 不修改 payment 模块;
- 不新增外部依赖;
- 只允许修改 src/orders 和 src/audit。
这段文字本身不是强制约束,但它会进入提案的 scope 和 acceptance,成为审阅 时的检查清单。更重要的是,Agent 需要把它翻译成目标架构:
audit模块是否存在;orders -> audit的依赖是什么类型;- 新增了哪些实体;
- 这些实体落在哪个文件、哪个符号;
- 有没有跨层依赖。
Agent 接下来不是"自由发挥",而是对着这份目标写代码。
二、Jin 的实际流程
Jin 把流程拆成几个明确的步骤:
1. 读取当前架构
Agent 先调用 jin_arch_read,拿到当前 L0/L1 和校验摘要。它不需要猜项目结构, 也不需要一上来把整个仓库读一遍。
2. 创建提案
jin_proposal_create 会生成一个版本化的目标快照:
text
arch/proposals/<REQ>/versions/v1/
  target-L0.yaml
  target-L1/<module>.yaml
  summary.yaml
从这一刻起,Agent 要改的是目标快照,不是直接改正式 arch/。
3. 修改代码并对齐目标
Agent 可以改代码,但架构部分只能落在目标文件里。它要新增模块、实体或依赖,必须 在目标 L0/L1 里写出来,而不是"代码里先加上,架构以后再说"。
4. 校验
jin_validate 会检查目标快照本身的架构一致性:
- 模块、实体、依赖的引用是否存在;
- 公开实体是否指向真实实体;
- 跨层依赖是否违反约束;
- 有没有重复或孤立的 L1。
校验不通过,Agent 继续修;校验通过,提案进入 in_review。应用后的漂移检查 再对照真实代码,确认模块路径、实体位置和符号是否存在。
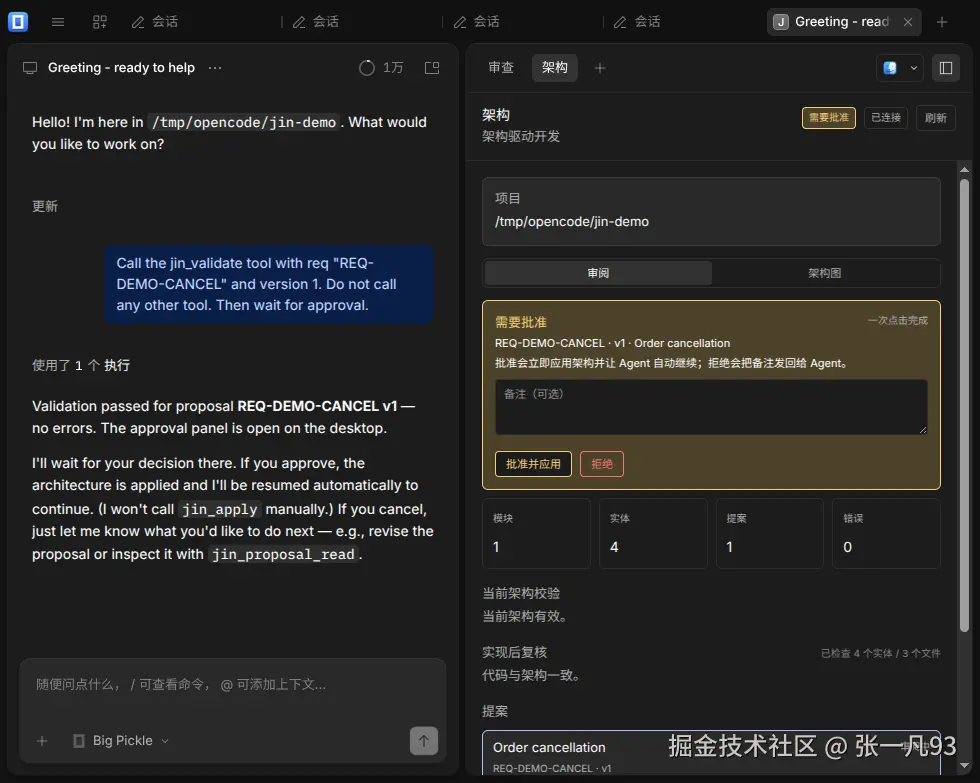
5. 人审批
审批面板自动打开。你看到的是结构差异,不是"它说它改好了"。
你可以批准,也可以写备注拒绝。批准由服务器验证签名、目标哈希和基线架构,然后把 目标写入正式 arch/,再让 Agent 自动继续。
三、它到底约束了什么?
Jin 约束的是架构层的事实:
- 模块边界;
- 公开实体;
- 实体位置;
- 依赖方向;
- 分层约束;
- 提案目标与真实代码的一致性。
这些约束会在几个地方起作用:
- Agent 创建提案时,只能编辑指定的目标文件;
- 校验时,模块、实体和依赖的引用必须成立;
- 跨层依赖如果违反约束,会直接报错;
- 批准时,目标哈希和基线架构必须匹配;
- 应用后,漂移检查会确认位置和符号,并指出未登记符号和模块外位置。
所以它能让"越界"变得更难、更显眼:
- 想偷偷加一个模块?提案里会出现;
- 想加一条跨层依赖?校验或 diff 会暴露;
- 想把实体放到别的模块?位置变化会被标出来;
- 想在代码里加公开符号但不登记?漂移检查会警告。
但我要把话说清楚:Jin 不是代码沙箱。
它不能阻止 Agent 在代码层写一个范围外的函数,也不能保证它没有改某个它不该改的 文件。它做的是把架构决策变成显式提案,把结构变化变成可审阅的差异。代码层的 review、测试和 CI 仍然必要。
四、为什么"先审架构"能减少乱写?
因为它在 Agent 开始实现之前,先固定了三件事:
1. 目标
Agent 不是从一张白纸开始,而是从一个明确的目标架构开始。它知道新模块应该叫 什么、放在哪里、对外暴露什么。
2. 边界
它知道哪些模块可以动,哪些依赖不能加。即使它仍然可能越界,越界也会在提案或 差异里留下痕迹,而不是藏在几十个文件里。
3. 决策点
它知道"校验通过后要停下来等人批准"。jin_validate 不是一个普通的工具调用, 而是流程的交接点。Agent 不需要猜用户是不是同意了,用户也不需要在一堆聊天记录 里找自己有没有说过"可以"。
这三点加起来,改变的是默认行为:
- 以前:先写,写完再说;
- 现在:先定义结构,批准后再写。
这不会让 Agent 变成不会犯错的工程师,但会让它更像在一个有边界的项目里工作, 而不是在一个没有规则的空地上随便盖房子。
五、一个反例
假设你对 Agent 说:
把订单取消逻辑改一下,顺便把审计也加上。
它可能:
- 在
orders里直接 importaudit的实现; - 把审计事件定义在
orders实体里; - 为了复用,把
payment的工具函数也拖进来; - 顺手改了三个不相关的调用方。
每一处都可能是"为了让功能跑通"的合理选择。但没有目标架构,这些选择不会被提前 摆到桌面上。
换成 Jin 的提示:
text
创建一个 Jin 提案:
- 只允许修改 orders 和 audit;
- orders 不直接依赖 audit 的实现,通过事件解耦;
- 不修改 payment;
- 校验通过后停下来等我批准。
你仍然需要 review 代码,但至少可以先在结构层看到:它是不是新增了模块、是不是 加了不该加的依赖、是不是把实体放错了地方。
先审架构,不是相信架构图,而是先把最难回溯的决策放到最前面。
六、边界
Jin 现在还很早期:
- 以桌面端为主;
- 扫描器是声明级的,不是完整编译器;
- 提案里的
scope/acceptance是审阅信息,不是代码沙箱; - 审批不替代测试、代码 review 和 CI;
- 安装包未签名,自动更新关闭;
- 模型由用户通过 OpenCode 配置。
如果你想要的是"AI 全自动写代码,人完全不用看",Jin 不适合你。它的前提就是: 结构性改动值得停下来让人看一眼。
项目地址:
v2.0.32-jin.1 下载:
中文完整指南:
Jin 是 OpenCode 的社区分支,不是 OpenCode 官方产品。