场景
我写了 8 年前端,这个月第一次把自己的页面,接到了自己写的后端上。
流程是先用 mock 数据把页面撑起来,等 Node + Express 服务真的跑通了,再把请求从 mock 切到真接口。
切完我查了下提交记录:mock 文件删了 81 行,新增两个 api 文件,每个组件只改了一行 import。
这篇文章记录这"一行"背后踩的两个坑,以及我是怎么解的。
卡点一:CORS 错误

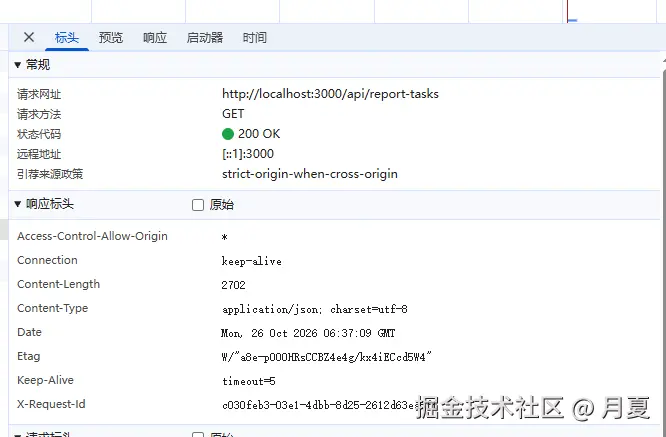
后端服务器正常启动,前端请求的 url 也没写错。仔细一看,原来是端口不一样造成跨域了:本地后端跑在 3000,前端项目跑在 5173,跨端口就是跨域,浏览器直接给你一句 CORS policy 报错。
解决也很简单,就两行代码,加在后端入口 app.ts:
Ts
import cors from 'cors';
app.use(cors());

/** 如果只想对特定源开放,可以搞成白名单形式 */
app.use(cors({ origin: ['https://your-demo.vercel.app'] }));
改完重启后端,页面热更新一下,打开 Network 面板就能看到请求正常了:
卡点二:后端返回的不是数组
接口通了,但页面还是不对。
看响应才发现:mock 返回的是一个数组,真接口返回的是 { success, data: { items, total } }------外面包了一层。页面层其实只关心 items,但组件拿到的东西形状变了,直接就崩了。
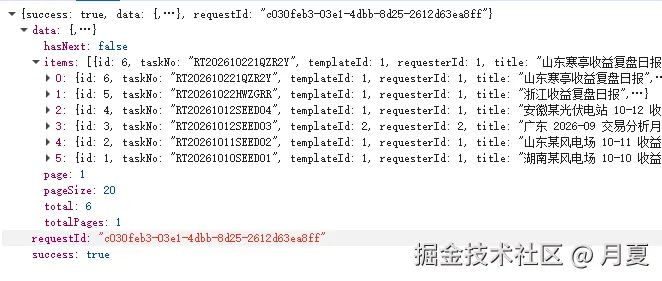
这是我第一次对「数据契约」有具象的概念:mock 和真接口长得不一样,调用的人就遭殃。
解决的思路其实也很简单:页面逻辑已经写好了,后端 schema 也定好了,两边都不动,那就从调用层统一。
解法:client 统一封装
先封装统一的 api 请求,get 和 post 示例代码如下。逻辑主要是按后端约定结构 { success, data, error } 解包,失败抛错:
Ts
export async function apiGet<T>(path: string): Promise<T> {
  const res = await fetch(`${API_BASE}${path}`);
  if (!res.ok) {
    throw new Error(`网络错误 ${res.status} ${path}`);
  }
  const json = (await res.json()) as {
    success: boolean;
    data: T;
    error?: { message: string };
    requestId?: string;
  };
  if (!json.success) {
    throw new Error(json.error?.message ?? '未知错误');
  }
  return json.data;
}

export async function apiPost<T>(path: string, body: unknown): Promise<T> {
  const res = await fetch(`${API_BASE}${path}`, {
    method: 'POST',
    headers: {
      'Content-Type': 'application/json',
    },
    body: JSON.stringify(body),
  });
  if (!res.ok) {
    throw new Error(`网络错误 ${res.status} ${path}`);
  }
  const json = (await res.json()) as {
    success: boolean;
    data: T;
    error?: { message: string };
    requestId?: string;
  };
  if (!json.success) {
    throw new Error(json.error?.message ?? '未知错误');
  }
  return json.data;
}
调用层只取 items,函数签名和 mock 版完全一致:
Ts
export function fetchTasks(): Promise<ReportTask[]> {
  return apiGet<{ items: ReportTask[] }>('/api/report-tasks').then((d) => d.items);
}
页面层的调用逻辑一行没动,联调就结束了。
为什么 mock 要和真接口同签名
回头看,这次改动能这么小,不是因为我后端写得好------是因为写 mock 的时候无意中做对了一件事:让 mock 的函数签名和真接口完全一致。
两边的 fetchTasks() 都返回 Promise<ReportTask[]>。
如果当时图省事,让 mock 直接照搬后端那个 { success, data: { items } } 结构,会怎样?
那这次切换就不只是改 import 了。每个用到数据的组件都得跟着多剥一层,tasks.map 要变成 data.items.map。页面越多,改得越乱,而且这些改动跟业务逻辑一点关系都没有------纯粹是被数据的形状拖累的。
所以 mock 的作用,不是"先随便给点假数据把页面撑起来"。它是在后端还没写的时候,先把"我要什么形状的数据"这件事钉死。
钉死之后,后端是 Node 写的、Python 写的,还是买的第三方服务,对页面来说都一样。
(顺便说一句:上面 apiGet 和 apiPost 里那段解包逻辑是一模一样的,我后面会抽成一个 unwrap(),现在先这么写着。)
结果
最后看提交记录。git show --stat 一查:
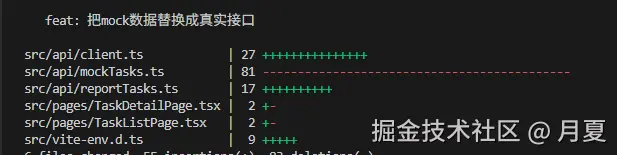
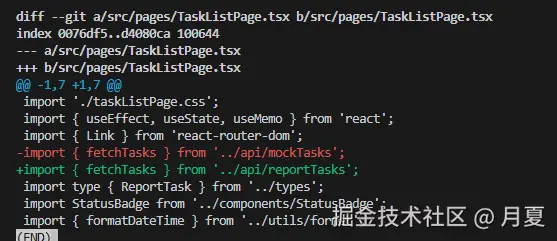
mock 文件删了 81 行,api 层新增两个文件,两个页面各改了一行 import:
diff
- import { fetchTasks } from '../api/mockTasks';
+ import { fetchTasks } from '../api/reportTasks';
连函数名都没换------因为 mock 版和真接口版的 fetchTasks() 签名完全一致,都返回 Promise<ReportTask[]>。组件从头到尾只认这个契约,不关心数据来自内存还是 MySQL。
结论
这次切换给我的最大感受是:前端转全栈,最先要懂的不是后端代码,是接口契约。
mock 的意义不是假数据,是把契约先钉死。契约定稳了,换数据源就是改一行 import 的事。
前端转全栈这段路,我发现真正难的不是"学会写后端",是改掉一个习惯:以前我只关心数据长什么样,现在得先想清楚"我要什么",并且把它写下来。
你第一次联调的时候卡在哪儿?是跨域,还是发现返回的数据形状跟你以为的不一样?
评论区说说,我下一篇可能正好也踩到。