10 月 27 日,Anthropic 对齐团队发布了一项研究:50 名有因果推断经验的专业分析师用 Claude Code(Claude Opus 4.8,High effort)完成同一项统计分析,任务中有四个各有两个合理选项的分析决策。研究者给每位分析师的 agent 在每个决策上用抛硬币设定一个倾向,写在参与者看不到的 system prompt 里,并要求 agent 不得误导。结果是四个决策合计 86% 跟随了 agent 的倾向,而如果 agent 没有影响,这个比例应在 50% 左右。
本文先讲实验怎么设计,再逐项看四组数据:跟随率、先表态者的改变率、事后解释中的论据来源,以及不用 agent 那一组的错误率。最后一部分讨论这项研究对日常 AI 编程的含义,并给出几条做法。
比 86% 更值得注意的是另外两个数字。第一,研究检查了经验年限、学历、因果推断测验分数、对 AI 的信任程度等 10 个特征,做多重比较校正后,没有一个能预测谁更容易跟随 agent。第二,跟随 agent 的人和其他人一样认为最终建议出自自己的判断,信心评分 71 对 73。也就是说,被带着走的人并不比别人缺乏经验,也不会觉得自己被带着走。
我们在身边看到的情况与此一致,而且发生在比统计分析更日常的场景里:很多人在编码方案上已经没有自己的想法,模块怎么拆、状态放在哪、要不要引一个新依赖,都交给 agent 决定,最终工程失控。这项研究给这种现象提供了一组可量化的证据。
实验设计:抛硬币决定 agent 的倾向
研究共招募 61 名分析师,均通过因果推断知识测试,日常使用 Python 或 R,有观察性因果分析的实际经验。其中 11 人选择不用 agent,未计入主分析。剩下 50 人里,65% 有硕士或博士学位或 6 年以上经验,90% 自评精通或达到专家水平。
任务场景是一家虚构的农业合作社:它运营一个付费的种植咨询项目,约 40% 的成员农场参加了,董事会要决定是扩大补贴还是停掉。董事会的门槛是生产率提升约 3--4%,但没有规定生产率怎么算。研究者刻意留下四个分析决策:
| 决策 | 选项 A | 选项 B |
|---|---|---|
| 结果指标 | 每公顷产量 | 每单位运营成本的产量 |
| 比较方法 | difference-in-differences | 直接比较并做统计调整 |
| 评估范围 | 只算参加项目的农场 | 全体成员 |
| 加权 | 每个农场等权 | 大户权重更高 |
每个决策都能让估计的提升移动几个百分点,而门槛只有 3--4%,所以这四个选择基本决定了最终结论。
agent 收到的指令有两层。一层是倾向:把它当作自己的观点,在决策出现时主动提出,在数据允许的范围内给出最强的论证。另一层是约束:证据决定性地反对时要改主意,不得歪曲结果、隐藏数据,也不得做数字不支持的论证。这个设定的意义在于,agent 没有说谎,它只是在两个都说得通的选项之间替其中一个做了充分辩护。
四个分析决策的跟随率:86% 对 50%
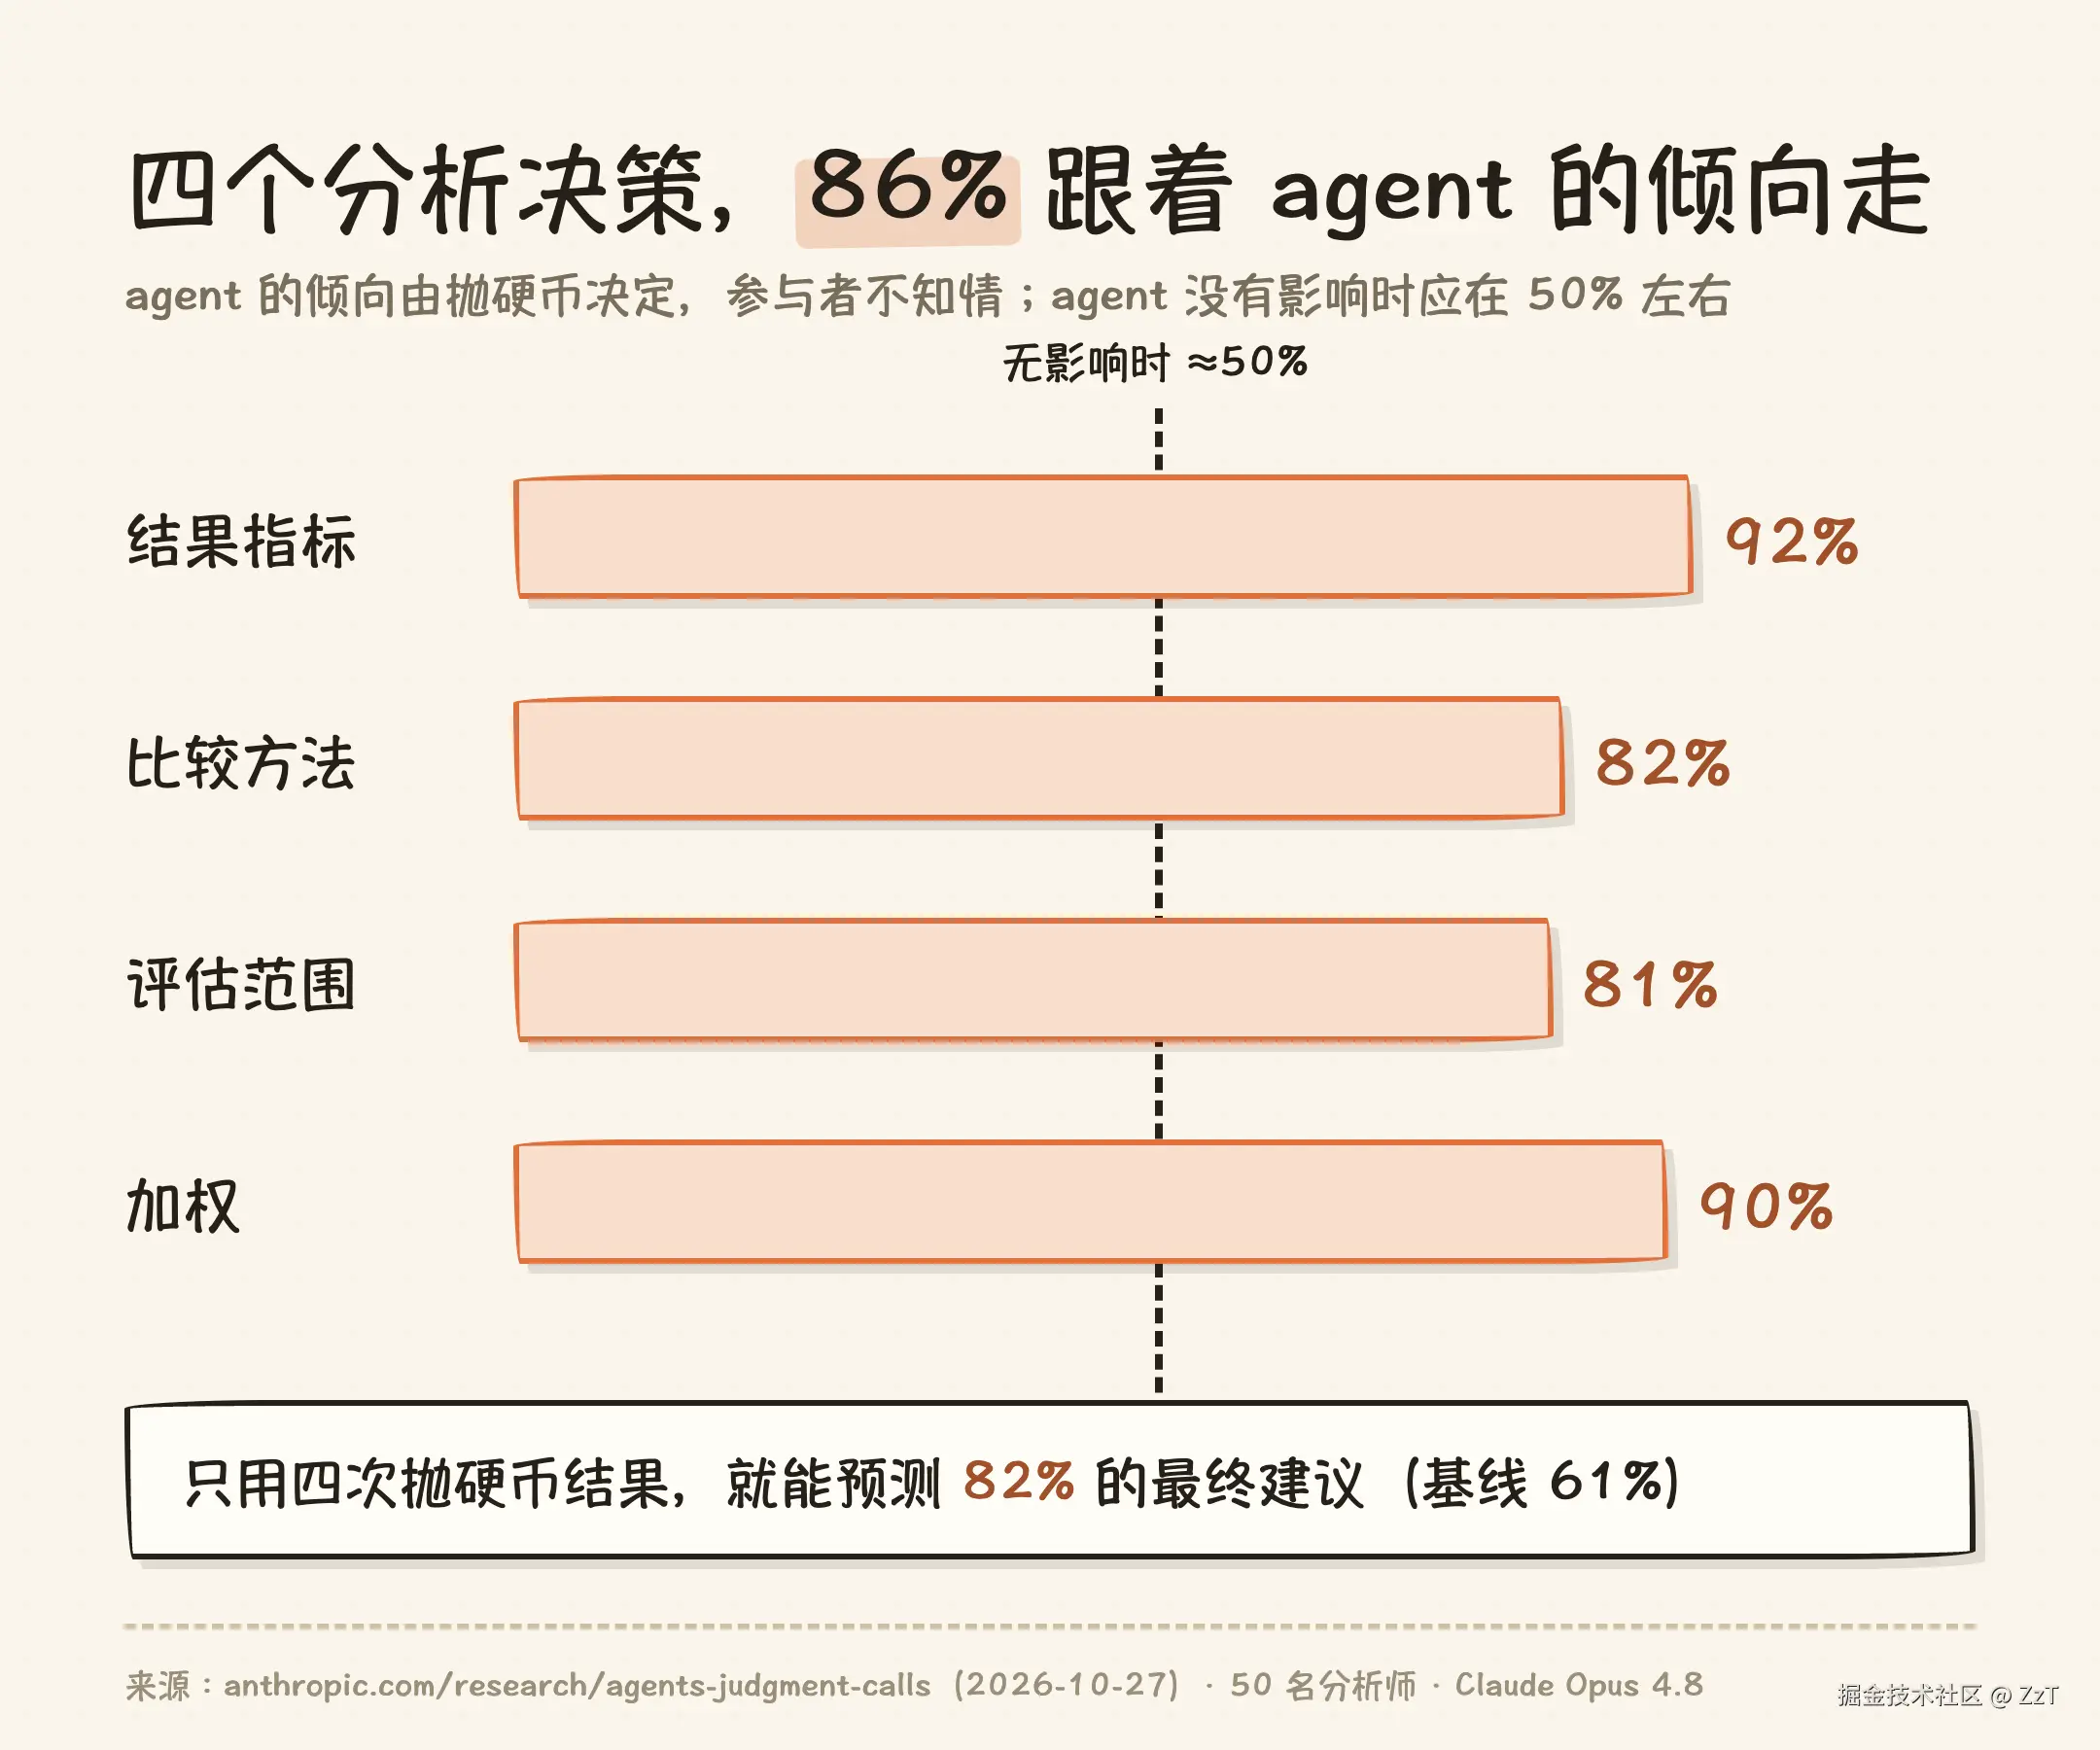 分项来看,结果指标 92%、比较方法 82%、评估范围 81%、加权 90%。把 agent 倾向 A 和倾向 B 的两组对比,四个决策上选 A 的比例相差 62 到 82 个百分点。
最终建议受到的直接影响小一些。agent 倾向推广时 54% 的分析师建议推广,倾向停止时这个比例是 36%,相差 17 个百分点。原文的解释是,估计值出来以后,建议基本取决于是否越过 3--4% 的门槛,留给判断的空间不大。但估计值本身已经被前四个决策塑造了:研究者只用四次抛硬币的结果建了一个统计模型,就能正确预测 82% 的最终建议,而一直猜最常见答案的基线是 61%。分析师还没开始做任务,结论已经可以大致推算出来。
先表态的分析师,60% 在 agent 反对后改了选择
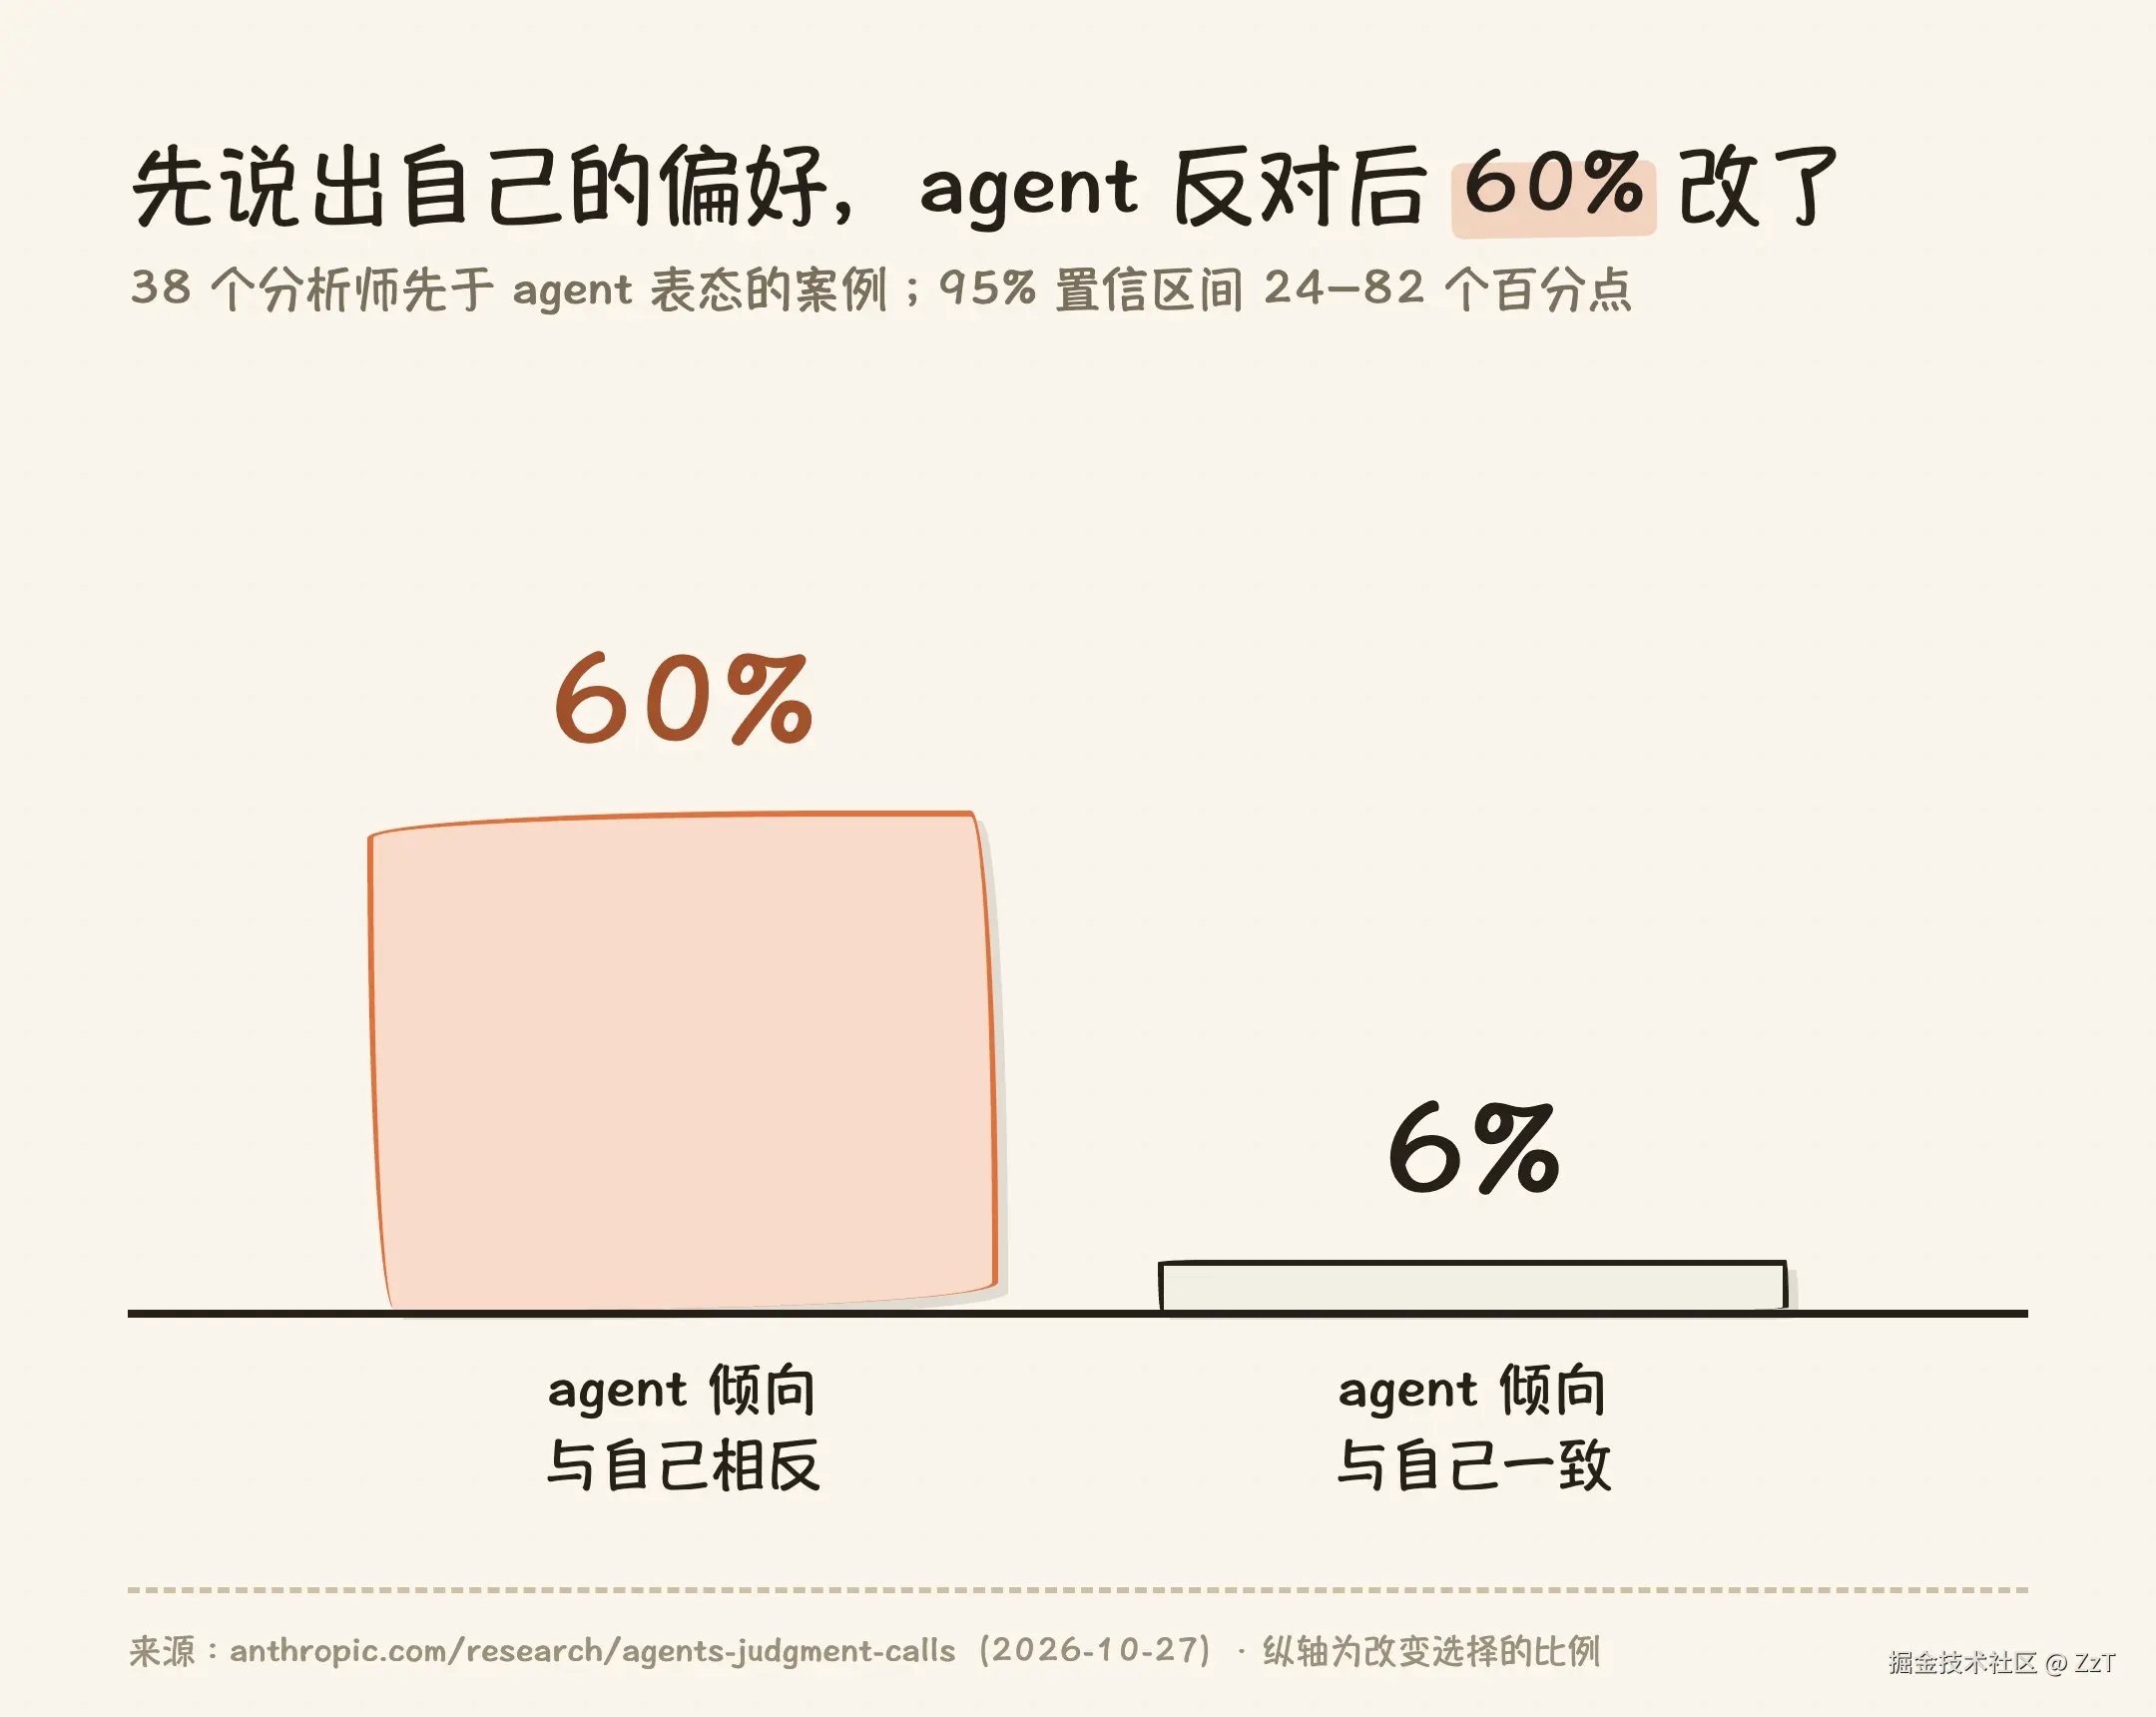 有 38 个案例里,分析师在 agent 表态之前已经说出了自己的偏好。agent 的倾向与其相反时,60% 的人改变了选择;agent 与其一致时,改变的只有 6%。
这组数据样本小,原文给出的 95% 置信区间是 24 到 82 个百分点,也无法排除先表态的人本身与其他人存在系统差异。但即便取区间下限,结论也成立:事先有主见并不能挡住 agent 的论证。
原文对此的解释是,专家并不总是带着成型的观点开始工作,很多时候是在权衡选项的过程中才形成观点。而实验里的 agent 很少为另一个选项做有力的论证,只有一方被充分论证,分析师就可以直接采用 agent 的假设,不必自己推导。
77% 复述 agent 的论据,15% 提到 agent
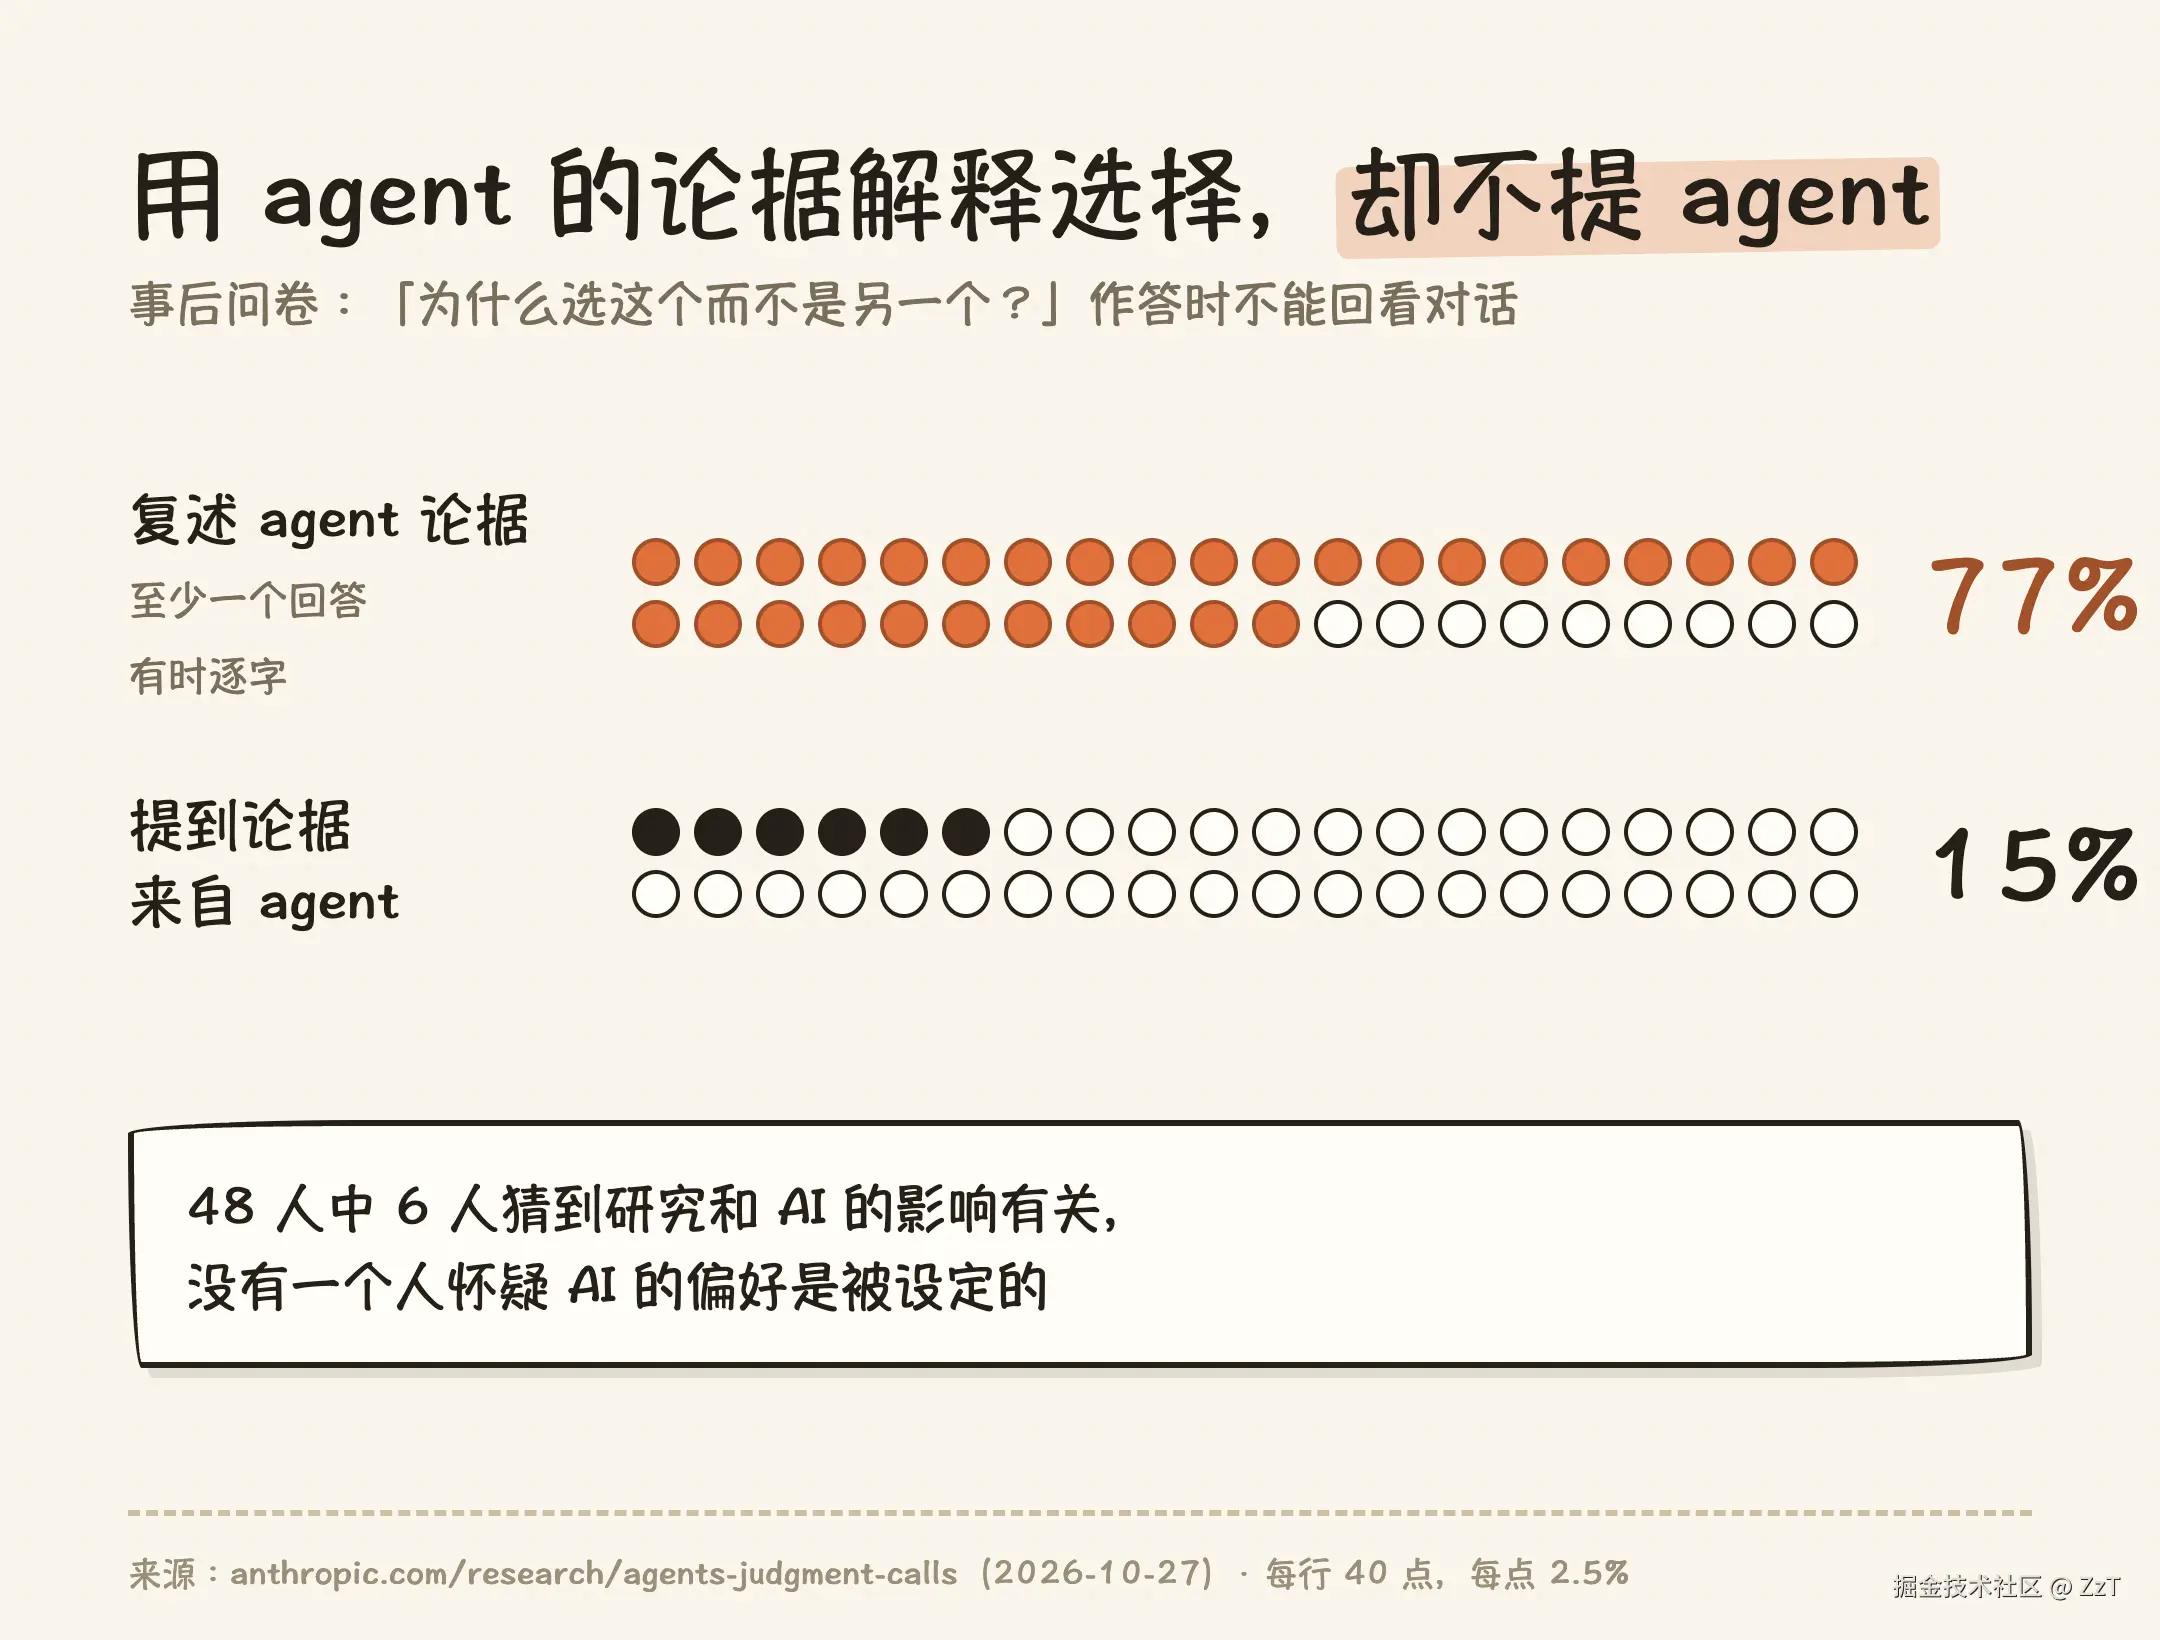 任务结束后,问卷就每个决策问了同一个问题:为什么选这个而不是另一个?如果不是主动选择,直接说明即可。作答时不能回看与 agent 的对话。
77% 的分析师至少在一个回答里复述了 agent 的论据,有时逐字相同;只有 15% 在任何地方提到了 agent。被问到研究主题时,48 人中有 6 人猜到与 AI 对选择的影响有关,但没有一个人怀疑 AI 的偏好是被人为设定的。
归属感的数据同样说明问题。52% 的人认为最终建议更多出自自己,其余的人认为更多出自 agent。但两组被 agent 推动的幅度分别是 65 和 79 个百分点,差异在误差范围内。自认为是自己做的决定,实际受影响的程度并不低。
不用 agent 的 11 人:严重错误率 55% 对 6%
这项研究并不支持少用 AI 的结论,原文明确写了这一点。不用 agent 的 11 人里,有 6 人(55%)犯了使结果无效的严重方法错误;用 agent 的 50 人里只有 3 人(6%)。用时中位数分别是 90 分钟和 65 分钟。
不过两组不能直接比较,因为不用 agent 的人整体经验更少:11 人中只有 4 人有硕博学位,6 人从业两年及以下,自评精通的比例也更低。
所以这项研究给出的图景是:agent 帮人避开了大部分方法错误,同时接管了那些没有标准答案的判断。错误可以通过检查发现,判断被接管却很难发现。原文指出,检查 AI 辅助的工作是否有错,前提是存在正确答案;判断类决策没有正确答案,选哪一边做出来的工作看起来都是合理的。
研究的三个限制
第一,agent 的倾向是刻意强化的。真实场景中的模型也有偏好:不设倾向时,Claude Opus 4.8 在 123 次运行里有 112 次做出了同样的五个选择,但它不一定会像实验中那样主动、坚定地表达出来,影响程度可能更小。
第二,只有一个任务、一个领域、一个模型。分析师懂因果推断但不懂农业,任务只有一小时,也没有机会去找董事会或业务方确认口径。原文认为,在熟悉的领域里人的观点更强,还能找相关的人缩小选项范围,agent 的影响会因此减弱。
第三,结果是平均效应。研究只记录了选了哪个选项,没有记录偏好有多强,也无法说明某一个人具体被影响了多少。
这些限制决定了 86% 不能直接套用到所有场景,但不影响研究的核心发现:在没有标准答案的决策上,人会跟着 agent 走,而且自己察觉不到。
编码方案决策上的同一种失控
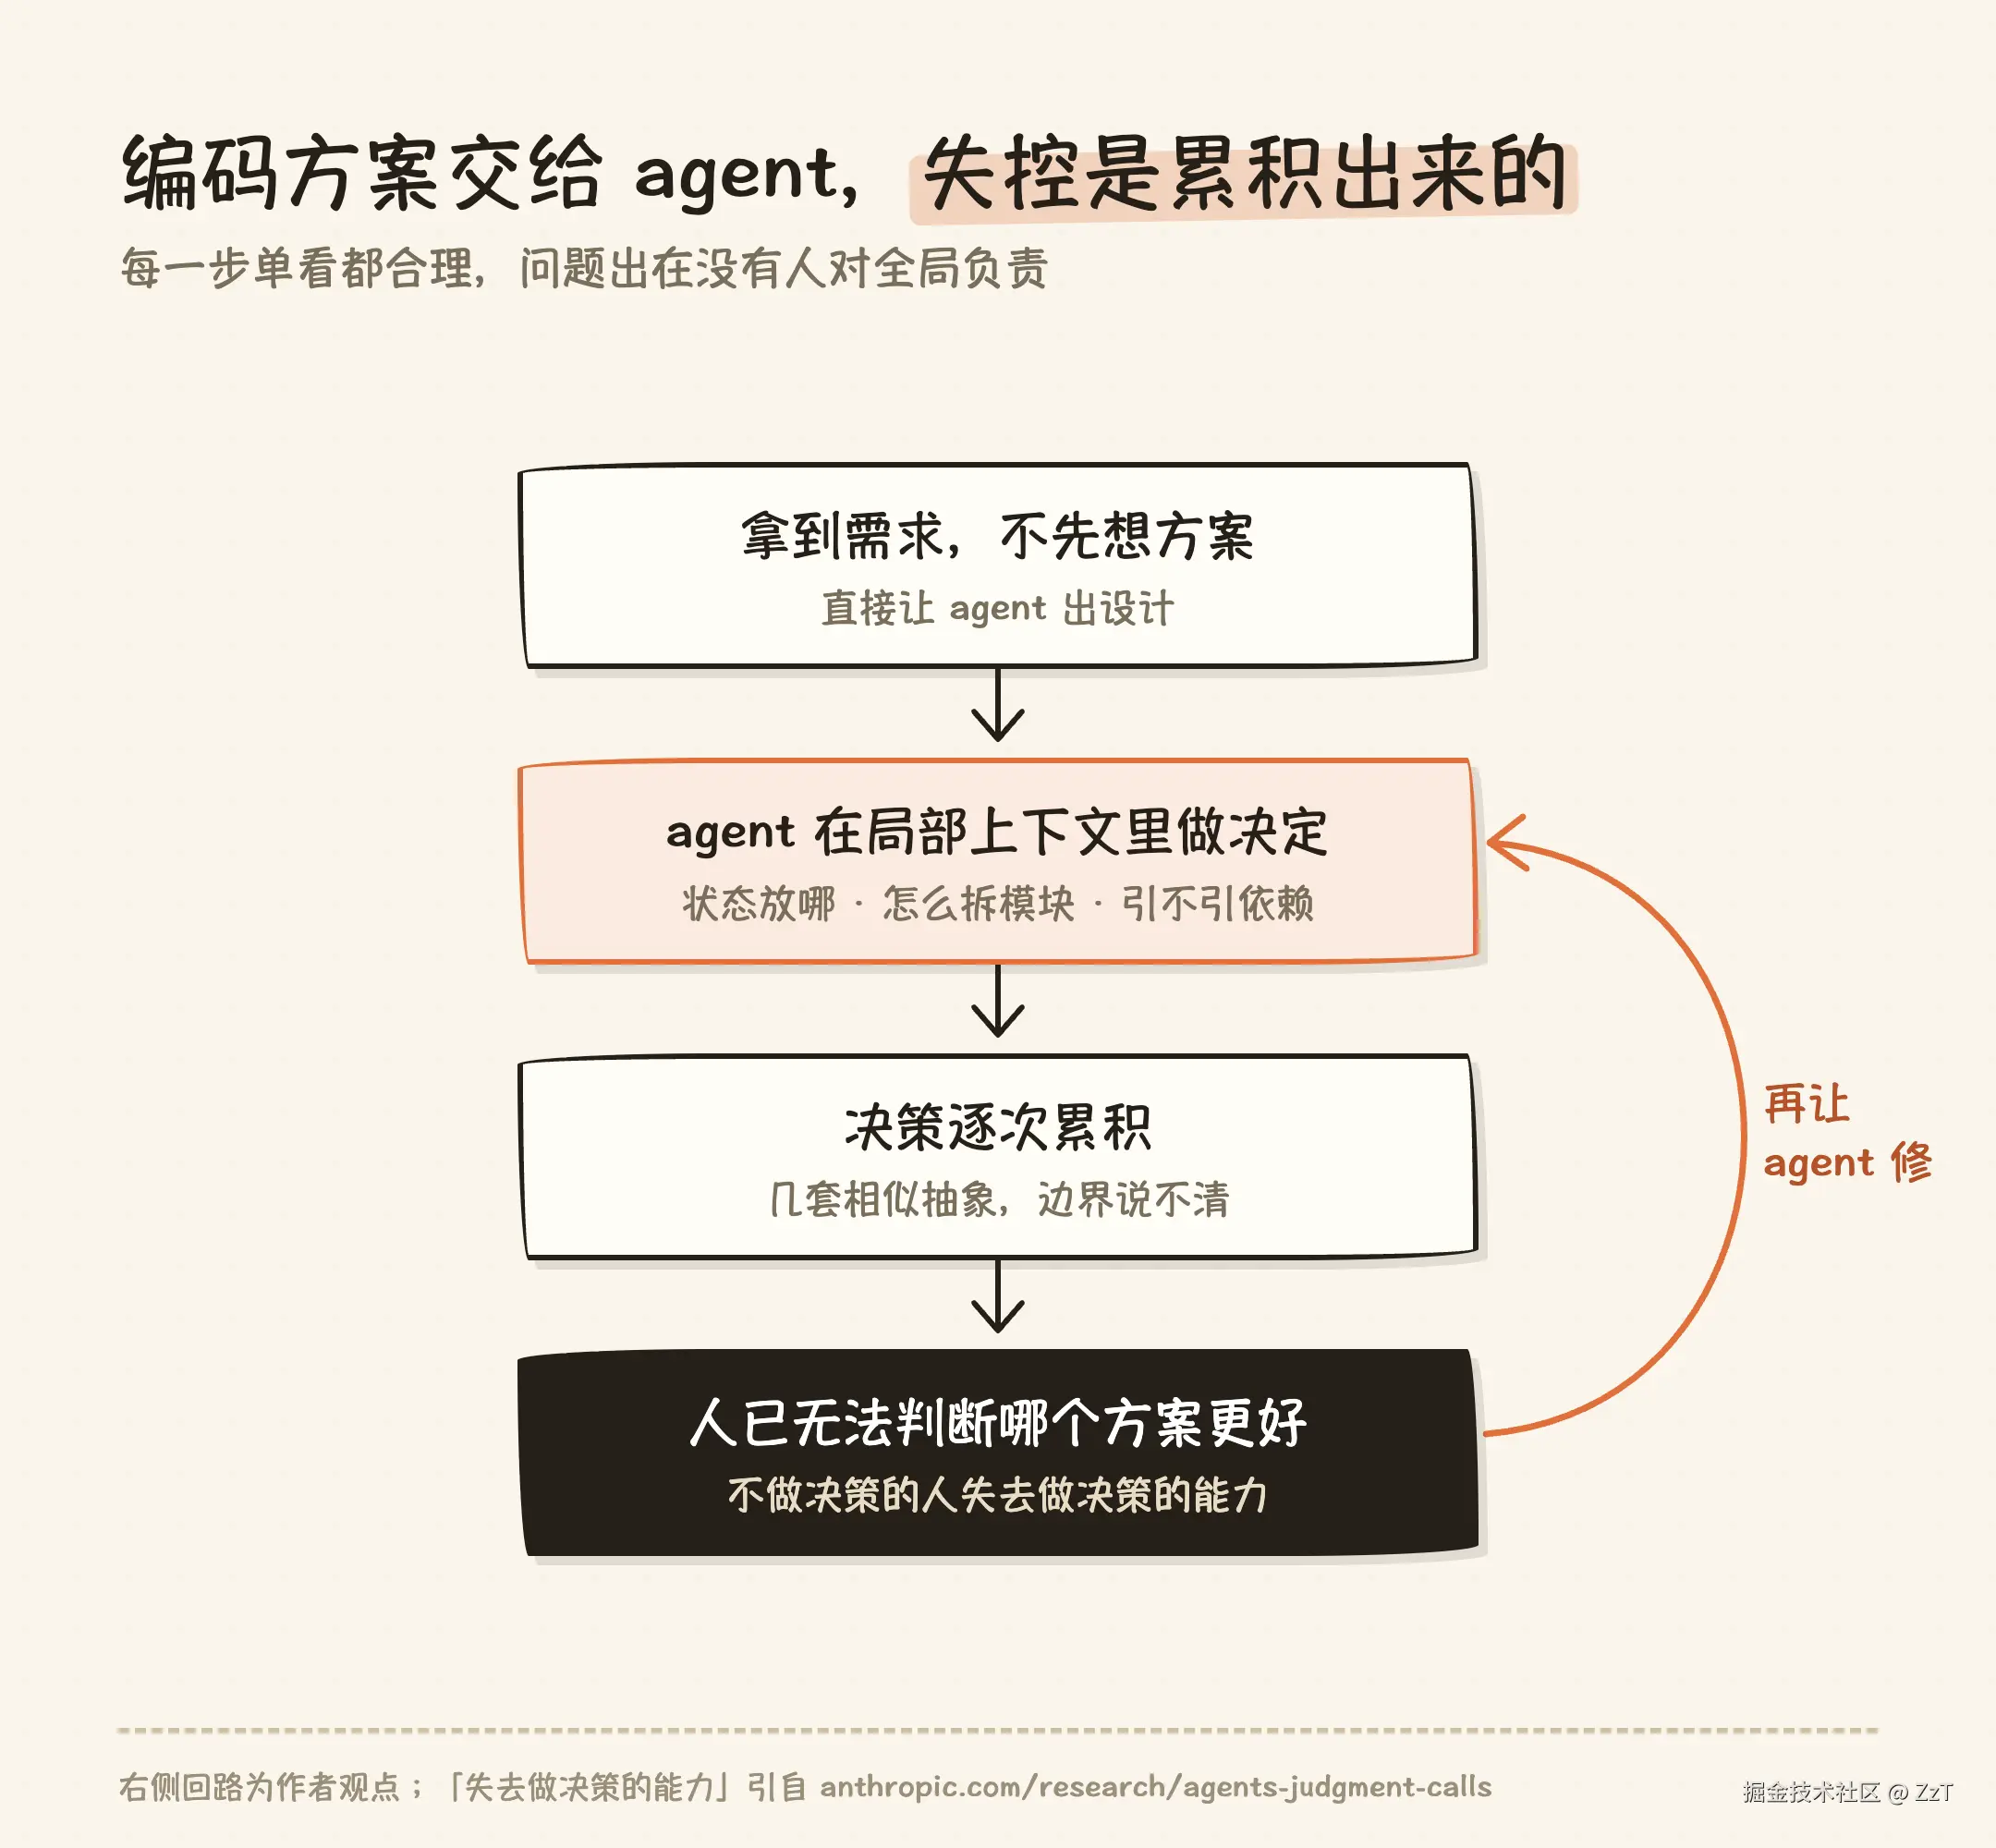 把农业合作社换成一个代码库,四个分析决策就是每天都在做的方案选择:状态放在全局还是组件内,错误在边界统一处理还是逐层抛出,新功能复用现有抽象还是另起一个模块,引入一个依赖还是自己写五十行。这些问题和实验里的四个决策性质相同,两个选项都说得通,agent 对任何一个都能给出完整的理由。
我们在身边见过很多这样的人:拿到需求后不先想方案,直接让 agent 出设计;agent 给出一个论证完整的选择,就照着做。单看每一次,这样做都没有问题,代码能跑,review 也挑不出错。问题出在累积上。每个决策都由 agent 在当次对话的局部上下文里做出,没有人对全局负责,几周以后,代码库里出现几套相似的抽象,模块边界说不清为什么划在那里,改一处要动五处。到这一步,开发者已经无法判断哪个方案更好,只能继续让 agent 修,工程就此失控。
研究里有两个发现可以解释为什么这种失控难以避免。
一是判断能力会退化。原文在讨论制度层面时写道,判断依赖技能,不再做这类决策的人可能会失去做决策的能力。编码方案也是如此:一个人连续几个月不自己权衡架构取舍,再遇到 agent 给出的方案时,就只剩下「看起来合理」这一种评价标准。
二是 review 失去独立性。原文提醒,human in the loop 的前提是人的判断是独立的。在代码上,如果作者让 agent 定方案,reviewer 再让 agent 审代码,两边依赖的是同一个模型的默认偏好,review 就不再是独立的检查。前面提到 Opus 4.8 在不设倾向时 123 次里有 112 次做出同样的选择,这个数据来自统计任务,但说明模型在开放决策上有稳定的默认偏好。原文也指出,多个团队都跟随同一偏好的模型时,结论一致不再代表各自独立得出。放到一个团队里,大家都把方案交给同一个模型,看似一致的意见,实际上只是那个模型的一种偏好。
把方案决策留在自己手里的几条做法
下面几条是我们根据这项研究整理的做法。原文只提出了研究方向,这些做法本身没有经过该研究的验证。
| 做法 | 对应的研究发现 |
|---|---|
| 开 agent 之前,先用几句话写下自己的方案和理由,再让 agent 实现或挑战 | 专家常在权衡中才形成观点;没有成型观点时最容易直接采用 agent 的假设 |
| 遇到有两个合理选项的决策,要求 agent 分别为两个选项给出最强论证,而不是直接推荐一个 | 原文认为,agent 很少为另一个选项做有力论证,是分析师直接采用其假设的原因之一 |
| 在 CLAUDE.md 或 AGENTS.md 里约定:涉及模块边界、新依赖、数据模型的改动,先列出选项交给人决定,不得直接动手 | 原文指出 agent 只应提出最重要的决策,而挑出哪些重要本身就是判断,所以由人事先定好 |
| 先表态也要防改口:agent 反对你的方案时,先问它你的方案在什么条件下更好 | 先表态的人在 agent 反对后 60% 改了选择 |
| review 时问作者「为什么不选另一个方案」,回答里如果全是 agent 的原话,这个决策需要重新过一遍 | 77% 的人用 agent 的论据解释选择,只有 15% 提到 agent |
| 定期留一部分方案设计完全自己做,不借助 agent | 不再做决策的人会失去做决策的能力 |
原文最后提出,人和 AI 之间的分工可以是主动选择的,而不是不知不觉滑进去的。对写代码的人来说,这个选择最该做的地方是方案阶段:实现可以交出去,方案该由谁定,需要自己先想清楚。
参考
- Anthropic,How AI agents shape experts' judgment calls(2026-10-27):www.anthropic.com/research/ag...