前言:让数据看板开发变得像对话一样简单
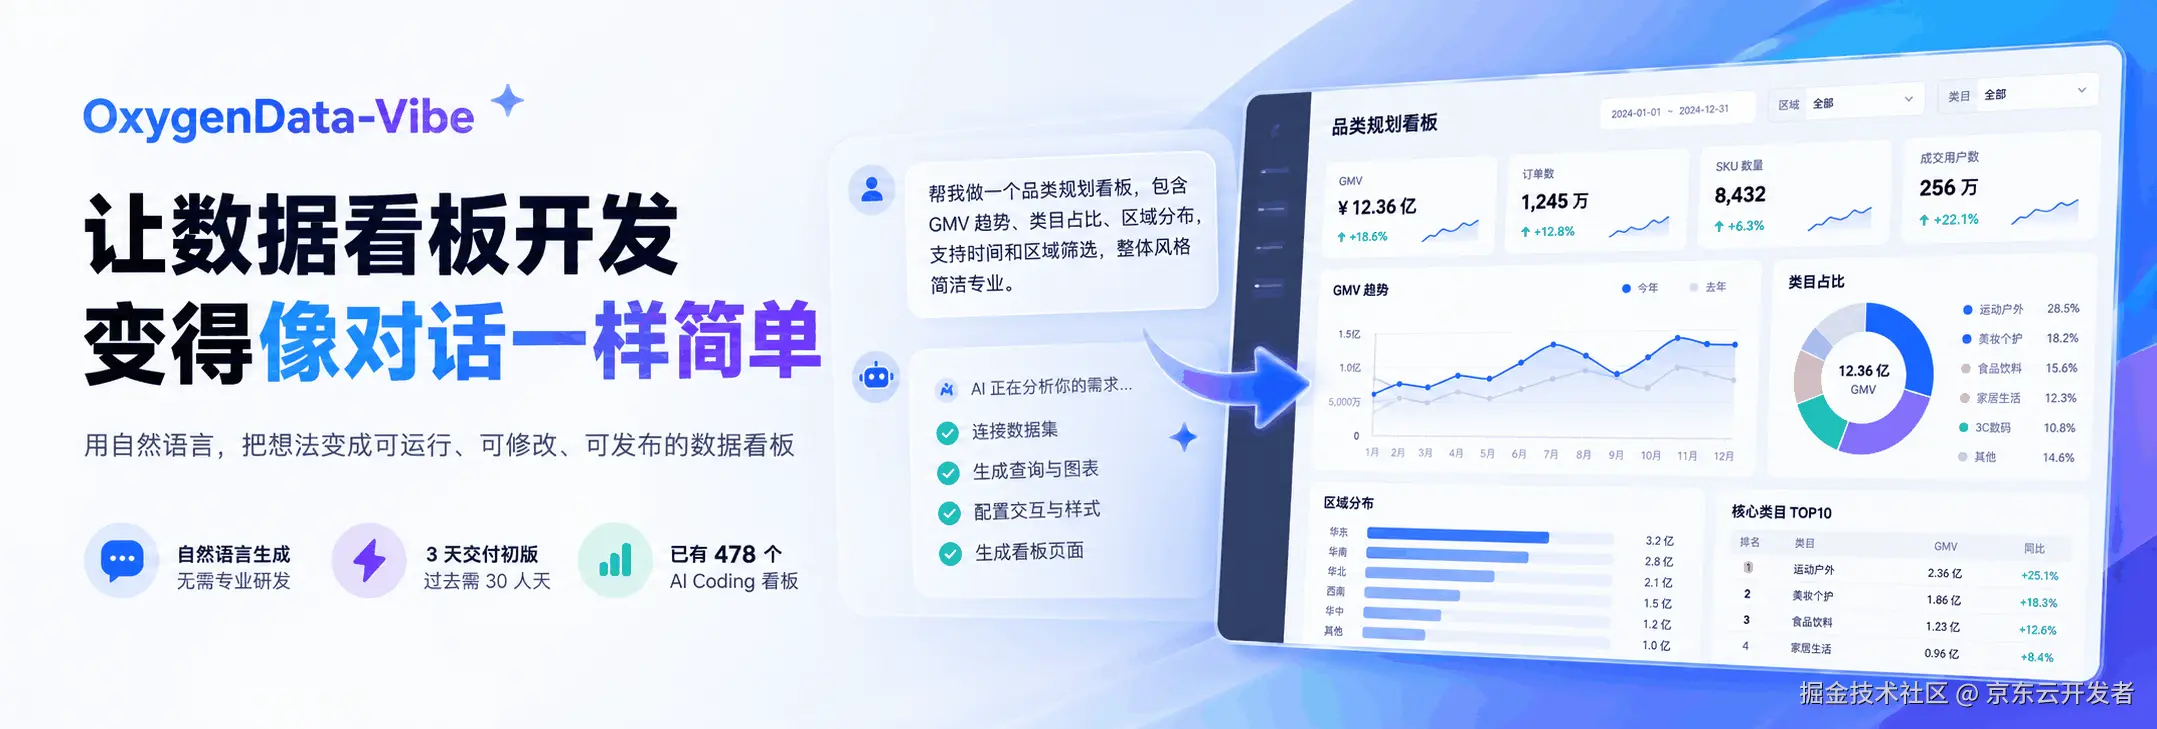
长期以来,数据看板开发主要有两种方式:一种是使用标准化 BI 工具 ,交付快、成本低,但图表样式、交互体验和功能扩展都受限于 BI 本身的能力;另一种是自研定制开发,能够充分满足复杂和个性化需求,但需要投入大量研发资源,交付周期也更长。比如一个通过 BI 只需要 1 天就能搭建出来的看板,如果采用自研方式,可能需要投入 30 PD 的研发人力。
既然 BI 交付这么快,为什么不把所有看板需求都交给 BI?
原因在于,业务某些场景需要的不只是把数据展示出来。 当看板对交互体验、业务流程和个性化能力有更高要求时,标准化 BI 的通用组件往往难以满足。阿里生意参谋、字节电商罗盘等产品之所以投入大量资源自研,正是为了突破通用 BI 的能力边界,提供更好的用户体验和业务价值。我们内部不少面向采销业务的数据看板,同样选择了自研的方式。
这就带来了一个长期存在的矛盾:能不能既拥有自研看板的灵活性和体验,又具备接近 BI 的开发效率和成本?
AI Coding 的快速发展,让这个问题有了新的解法。今年上半年,零售数据工程前端团队已经在自研看板项目中进行了实践,AI 生成代码占比超过 90%。这意味着,过去需要研发人员投入大量时间完成的页面开发工作,现在已经可以很大程度上交给 AI。
但这也让我们开始思考一个更进一步的问题:既然 AI 已经能够完成大部分编码工作,能不能让业务用户绕过专业研发,直接通过自然语言生成自己需要的数据看板?
OxygenData-Vibe 就是在这一思路下诞生的。用户只需要先配置好数据集,再通过自然语言描述自己的需求,Agent 就能将想法转化为可运行、可持续修改、可发布的数据看板。 不必再受限于固定的图表和组件,也不必依赖专业研发逐个实现交互功能,而是通过持续对话,让看板逐步长成自己需要的样子。
这不仅是开发效率的提升,更是数据看板生产方式的变化:从过去的「研发写代码」或「用户配置组件」,走向「用户表达需求,AI 完成开发」。
成果
•自今年 9 月上线以来,用户已经通过这种方式创建了 478 个AI Coding看板
•过去自研交付需要30人天, 用新的 OxygenData-Vibe 3天交付初版
创建AI看板是通过AI对话式交互搭建看板的功能,零门槛上手 。您只需用自然语言描述需求,AI即可自动生成数据看板。看板支持更多个性化交互和图表可视化,视觉呈现更加灵活美观
一些案例:
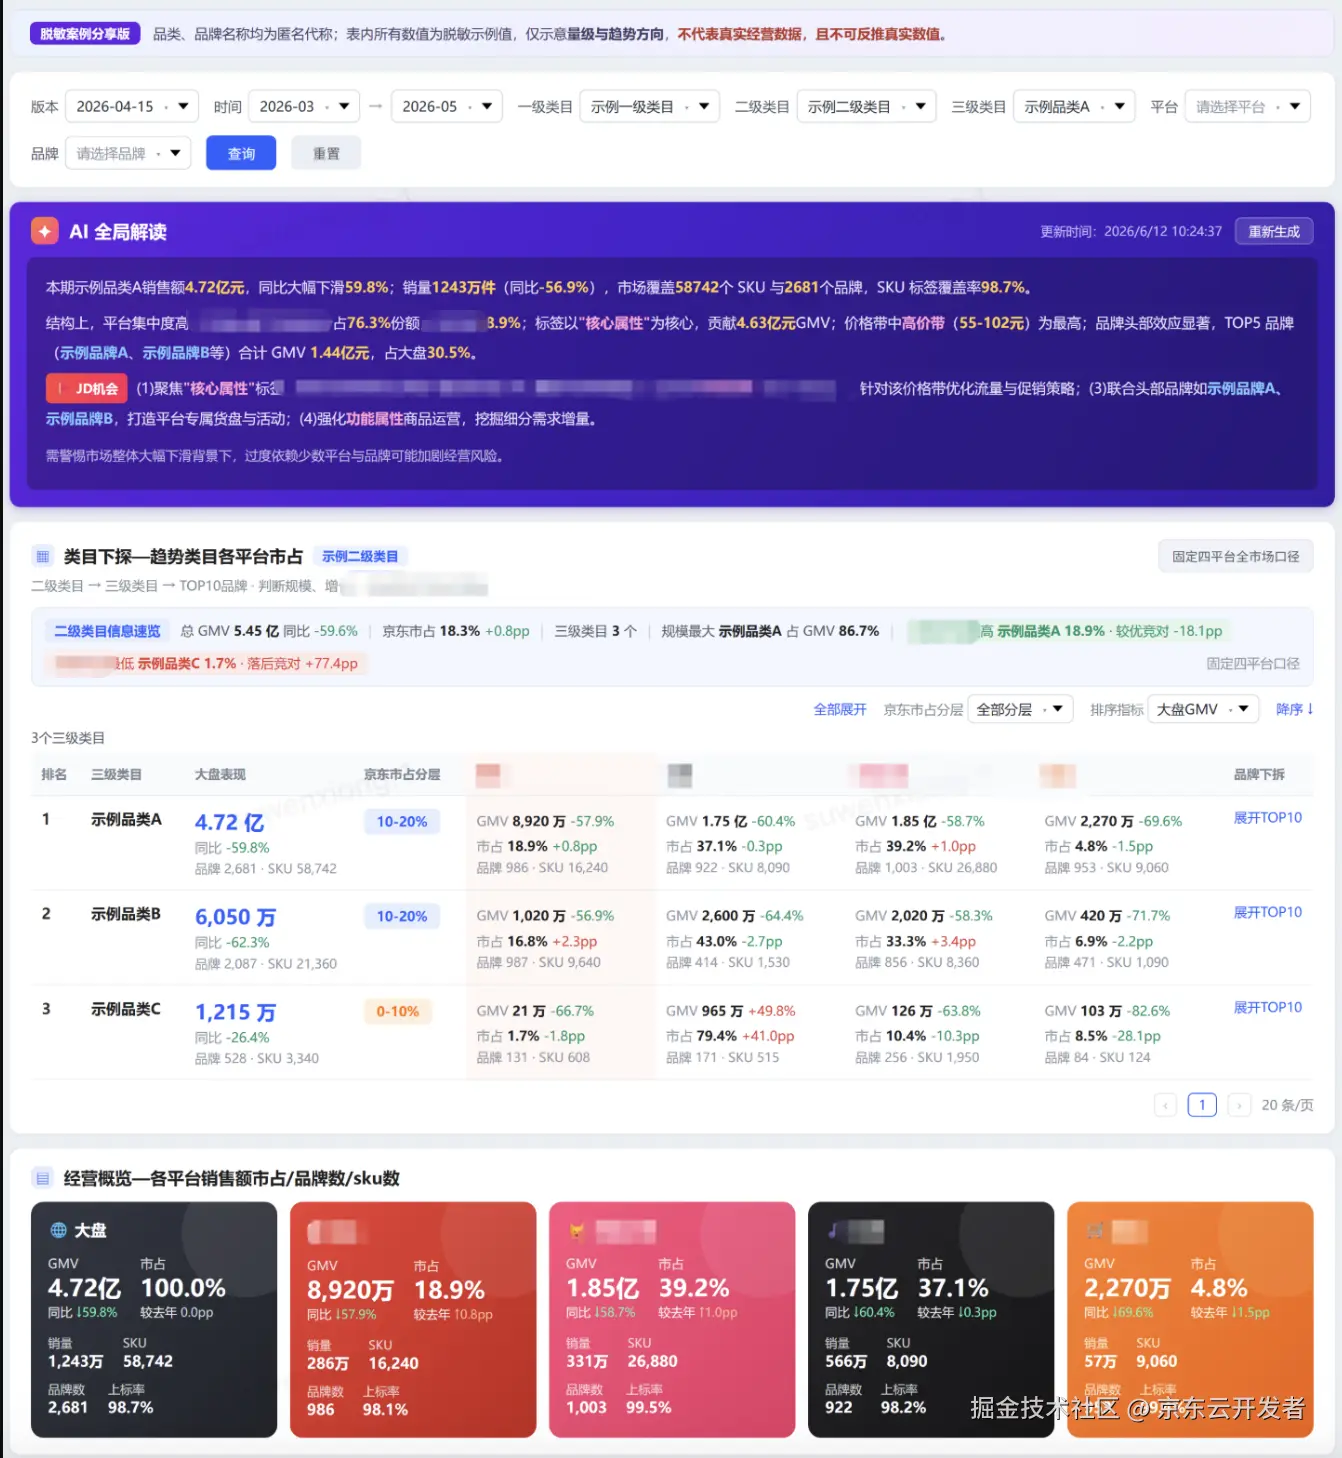
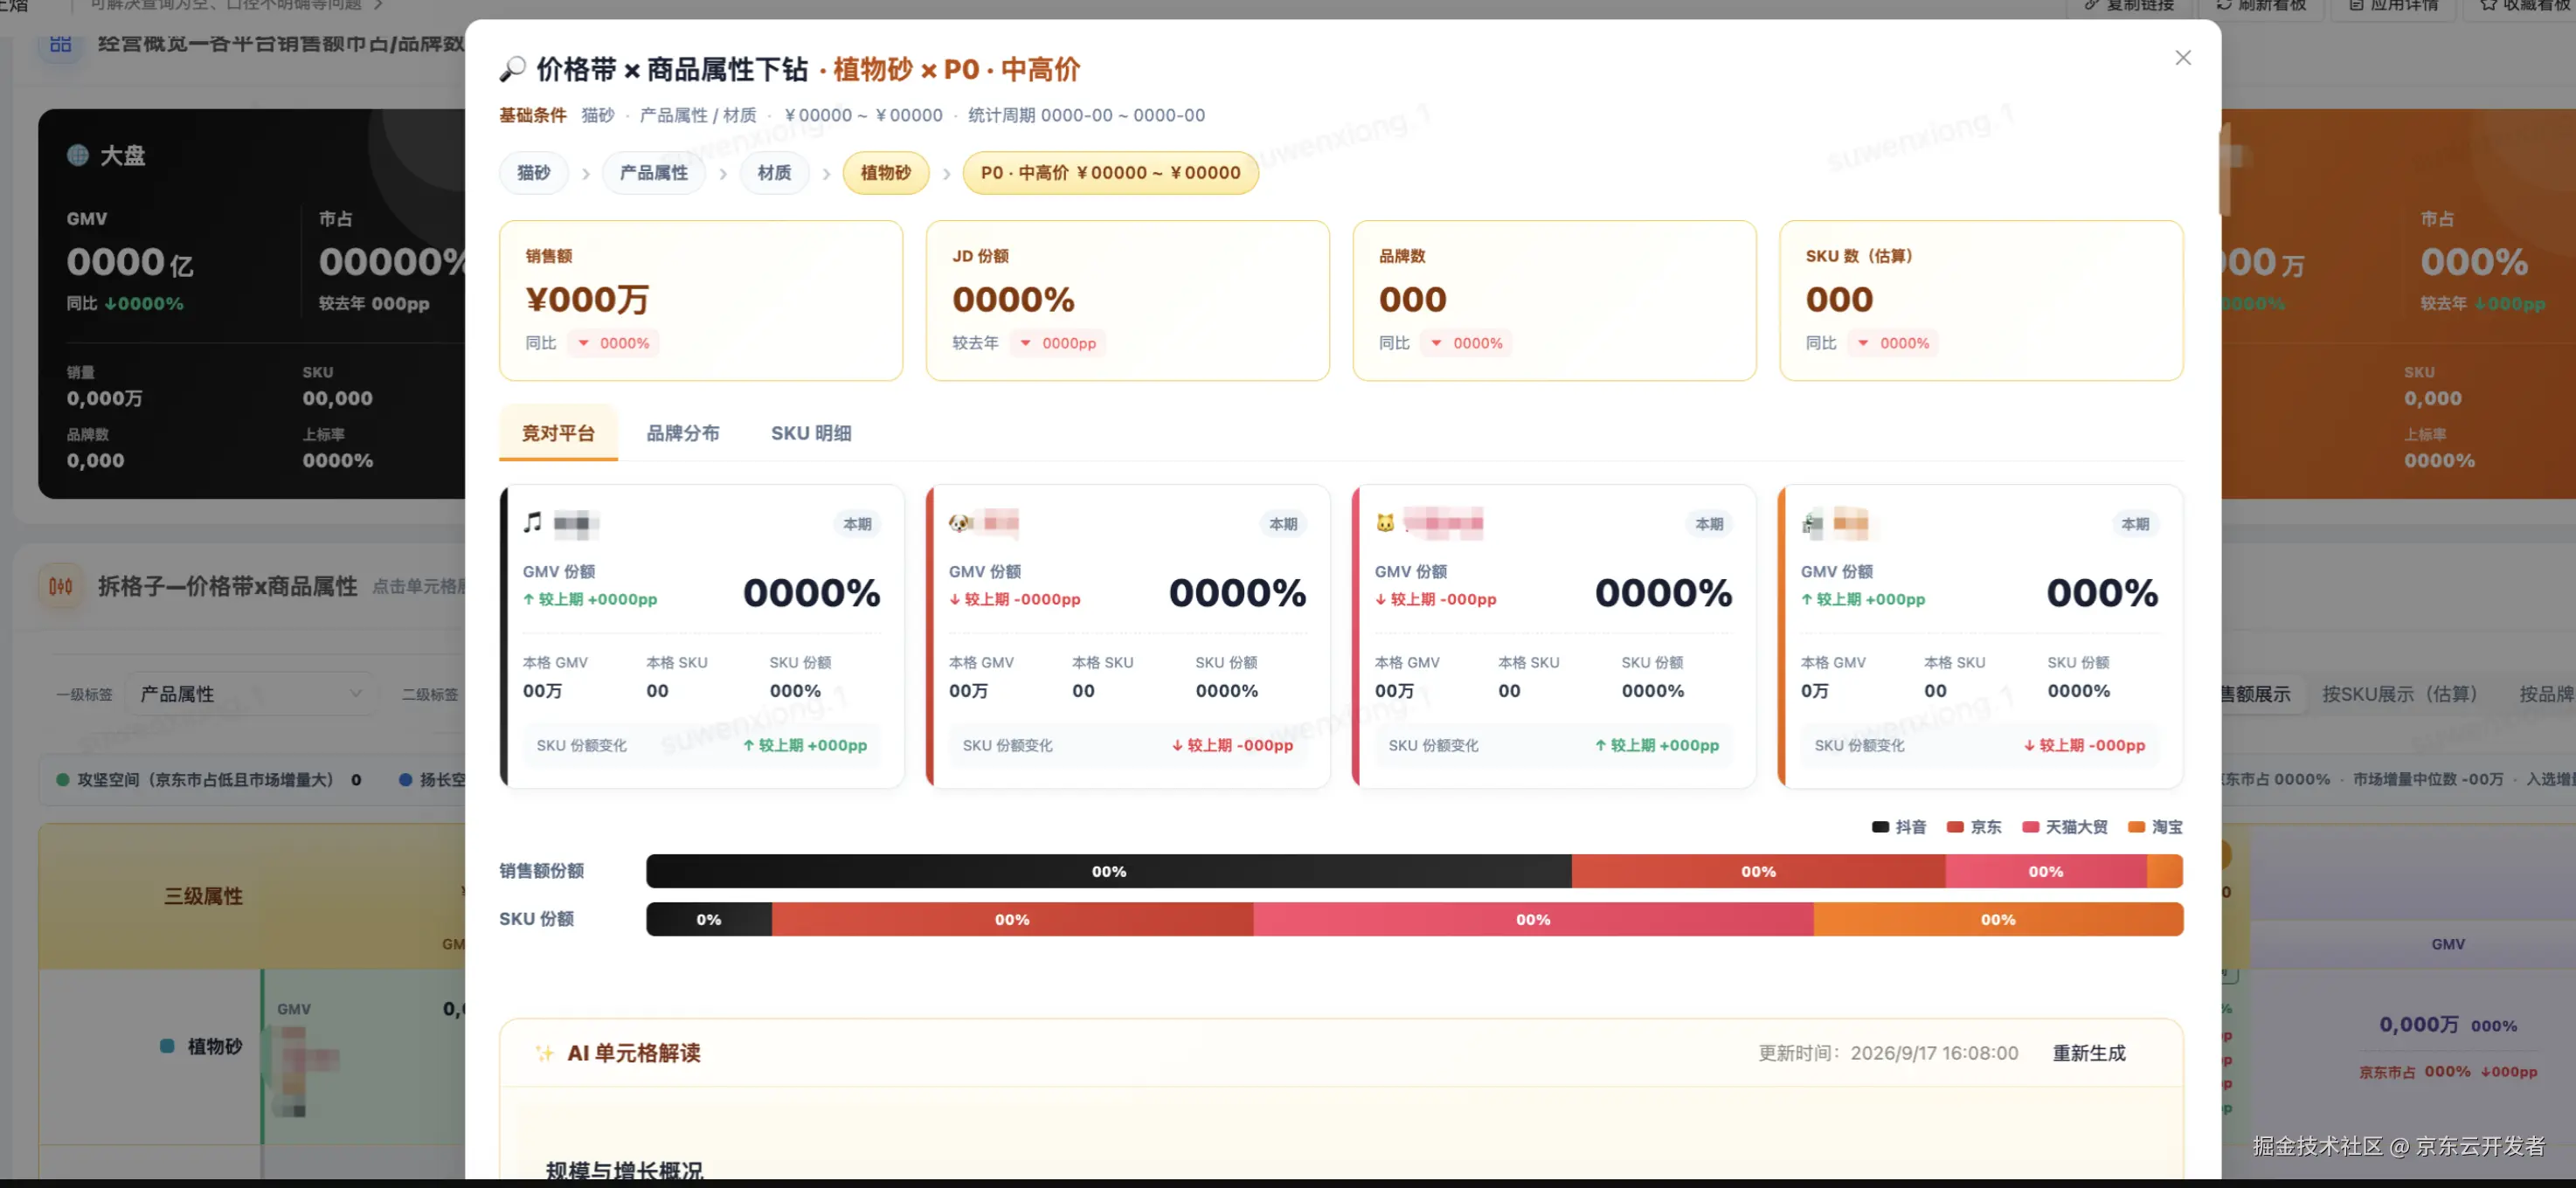
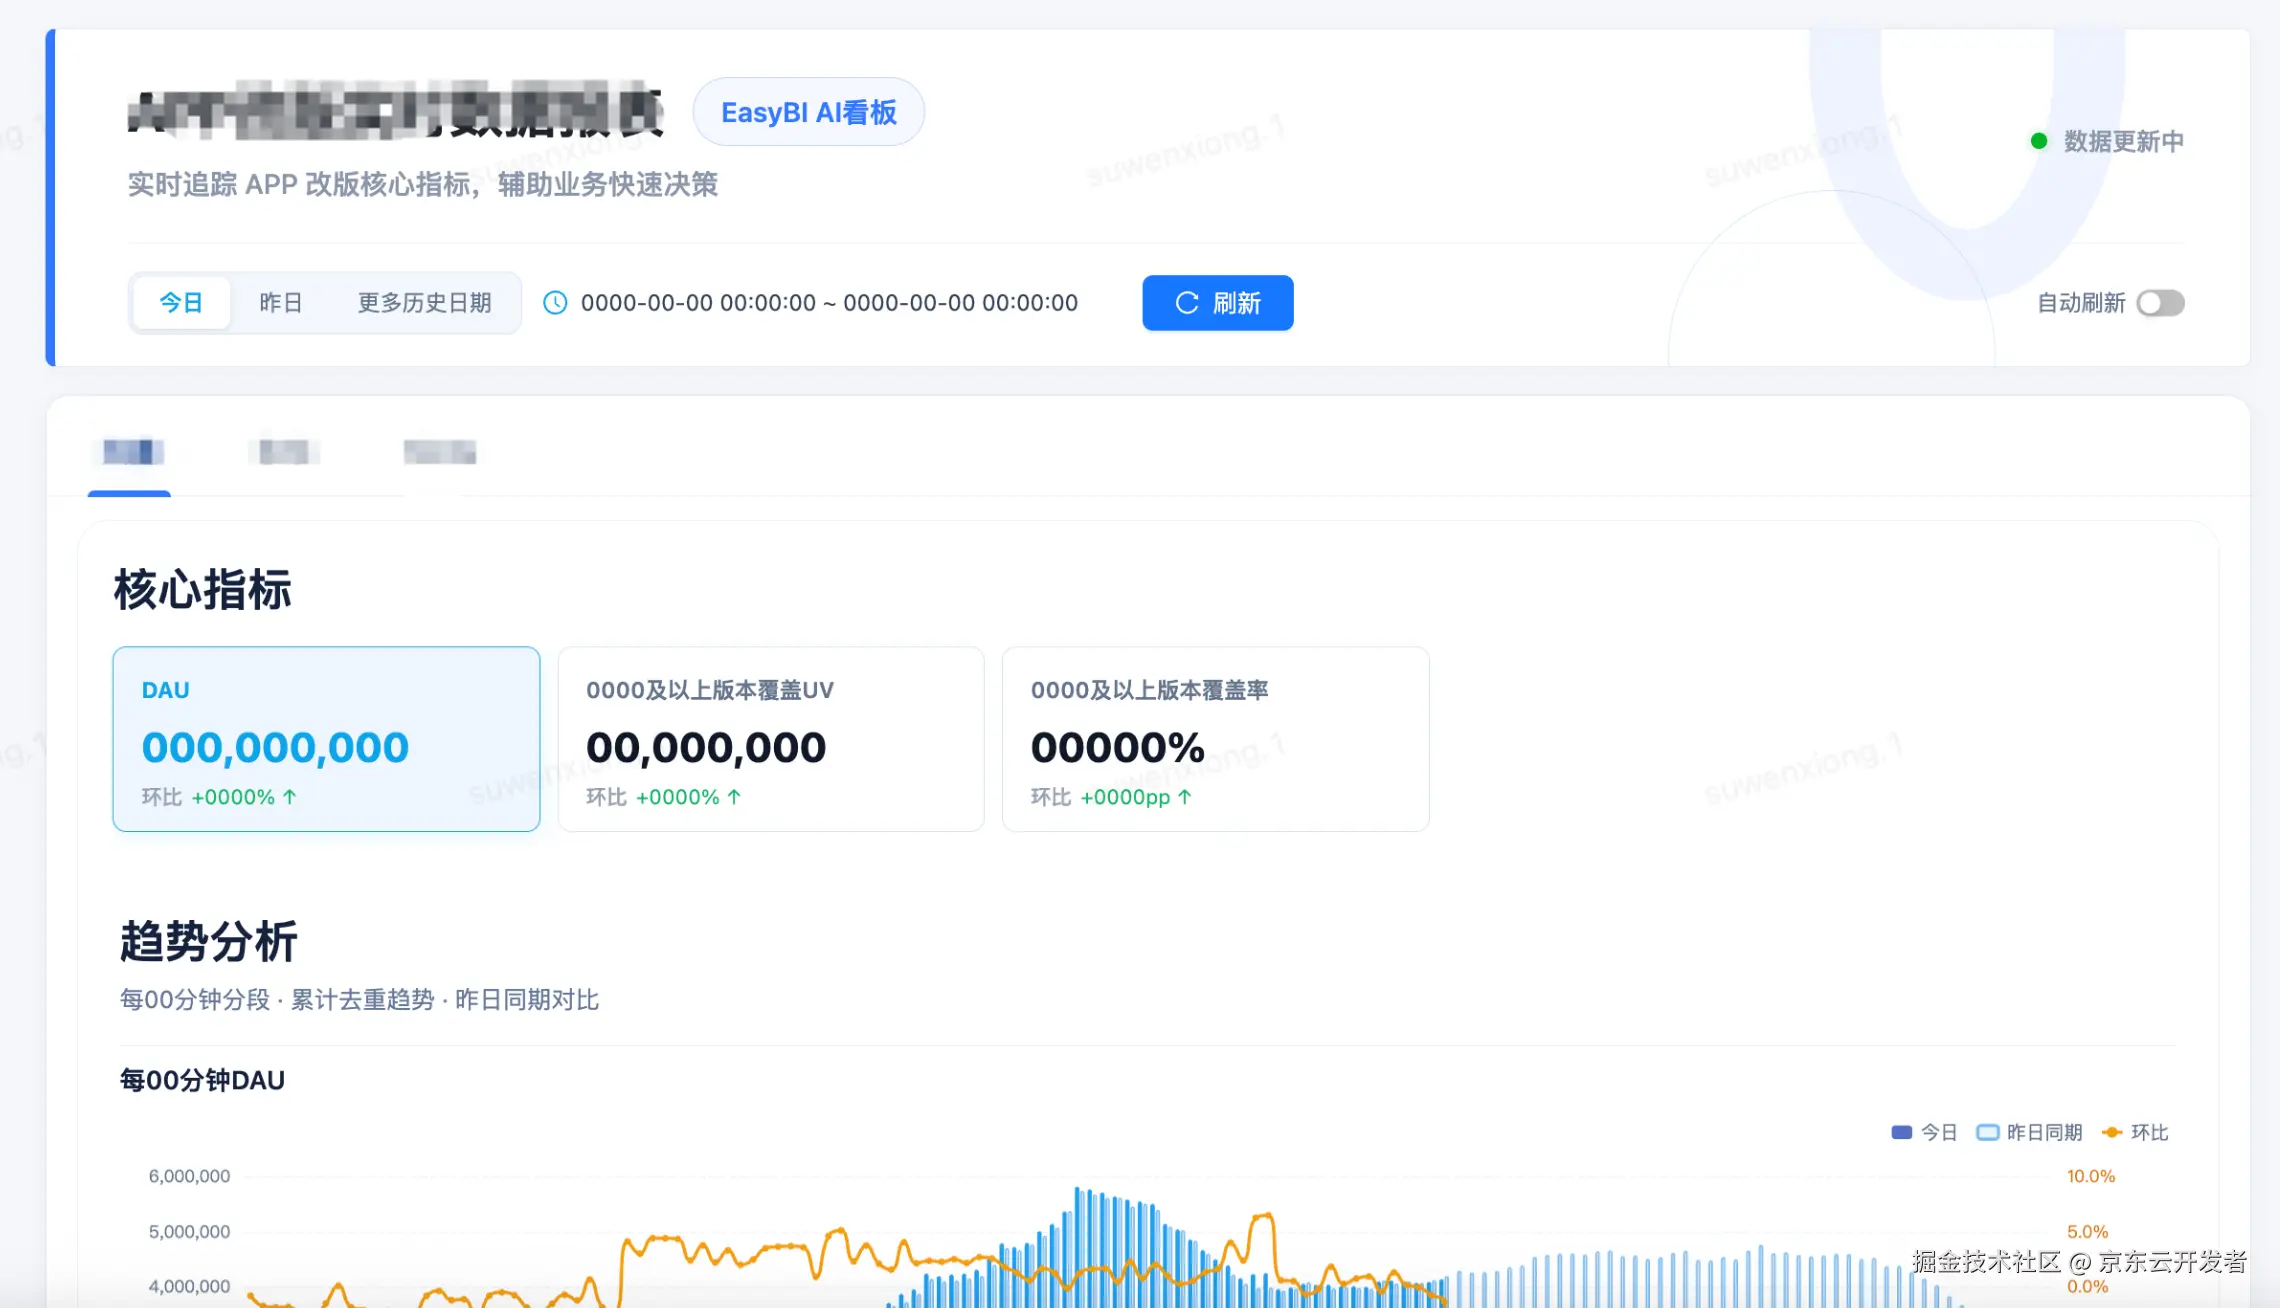
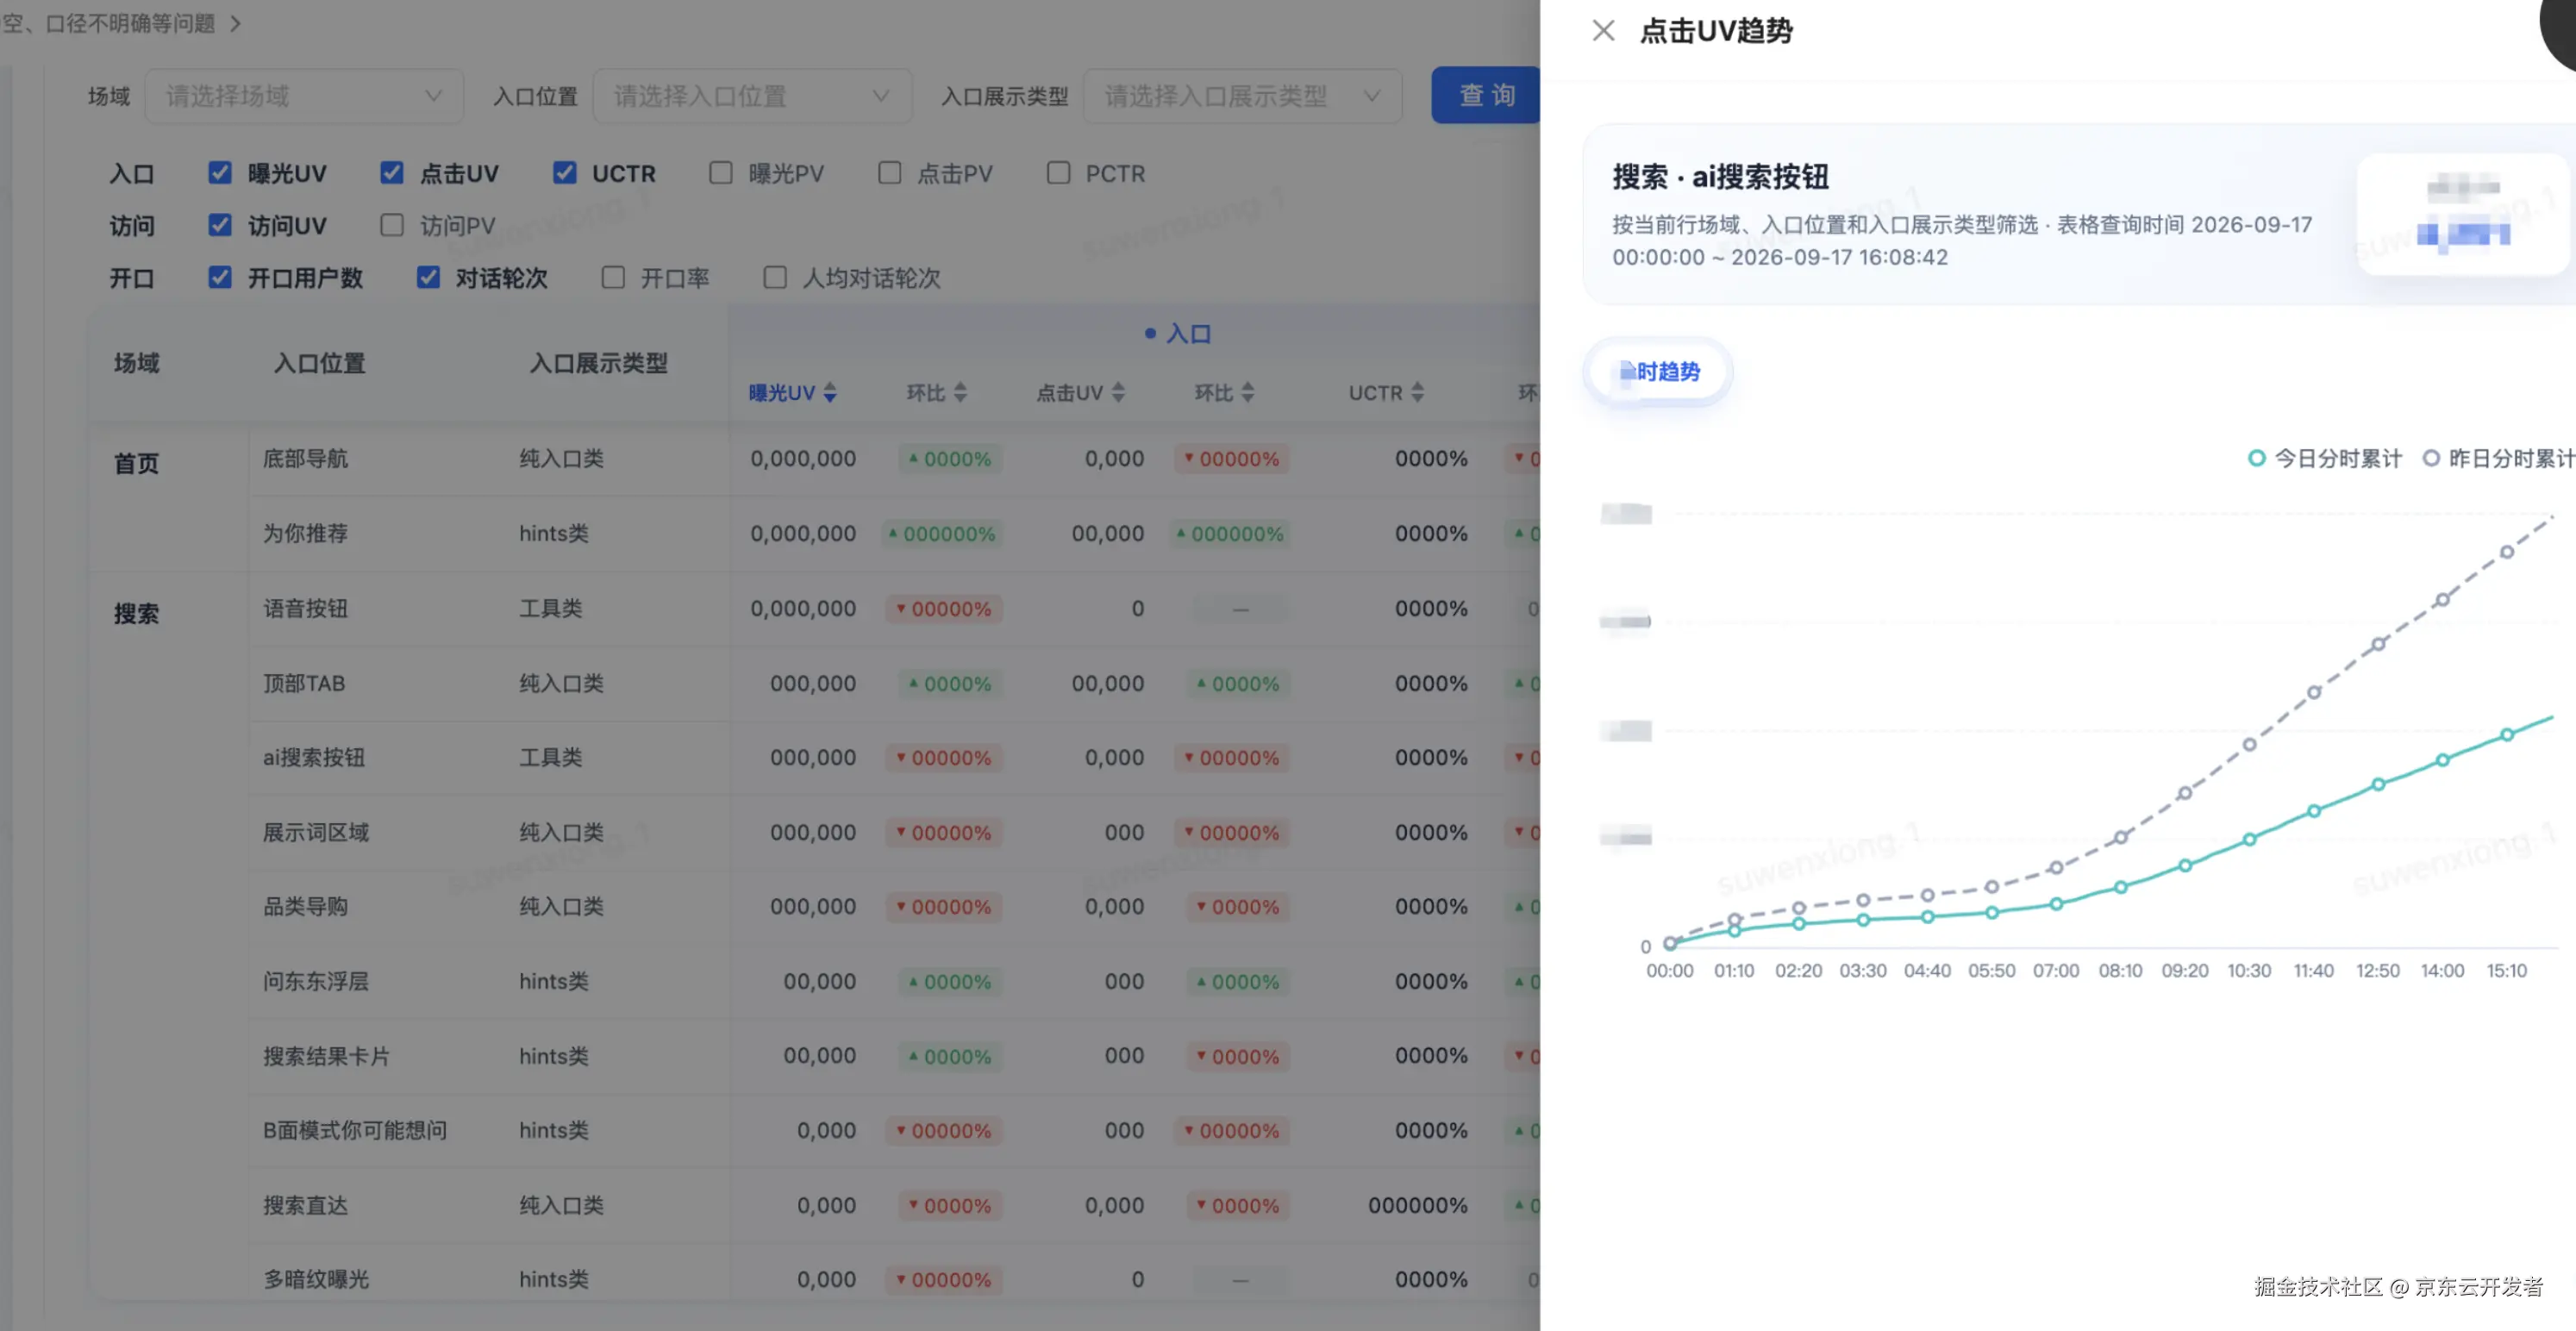
下面先通过一个完整案例看看是怎么使用的
实际使用演示
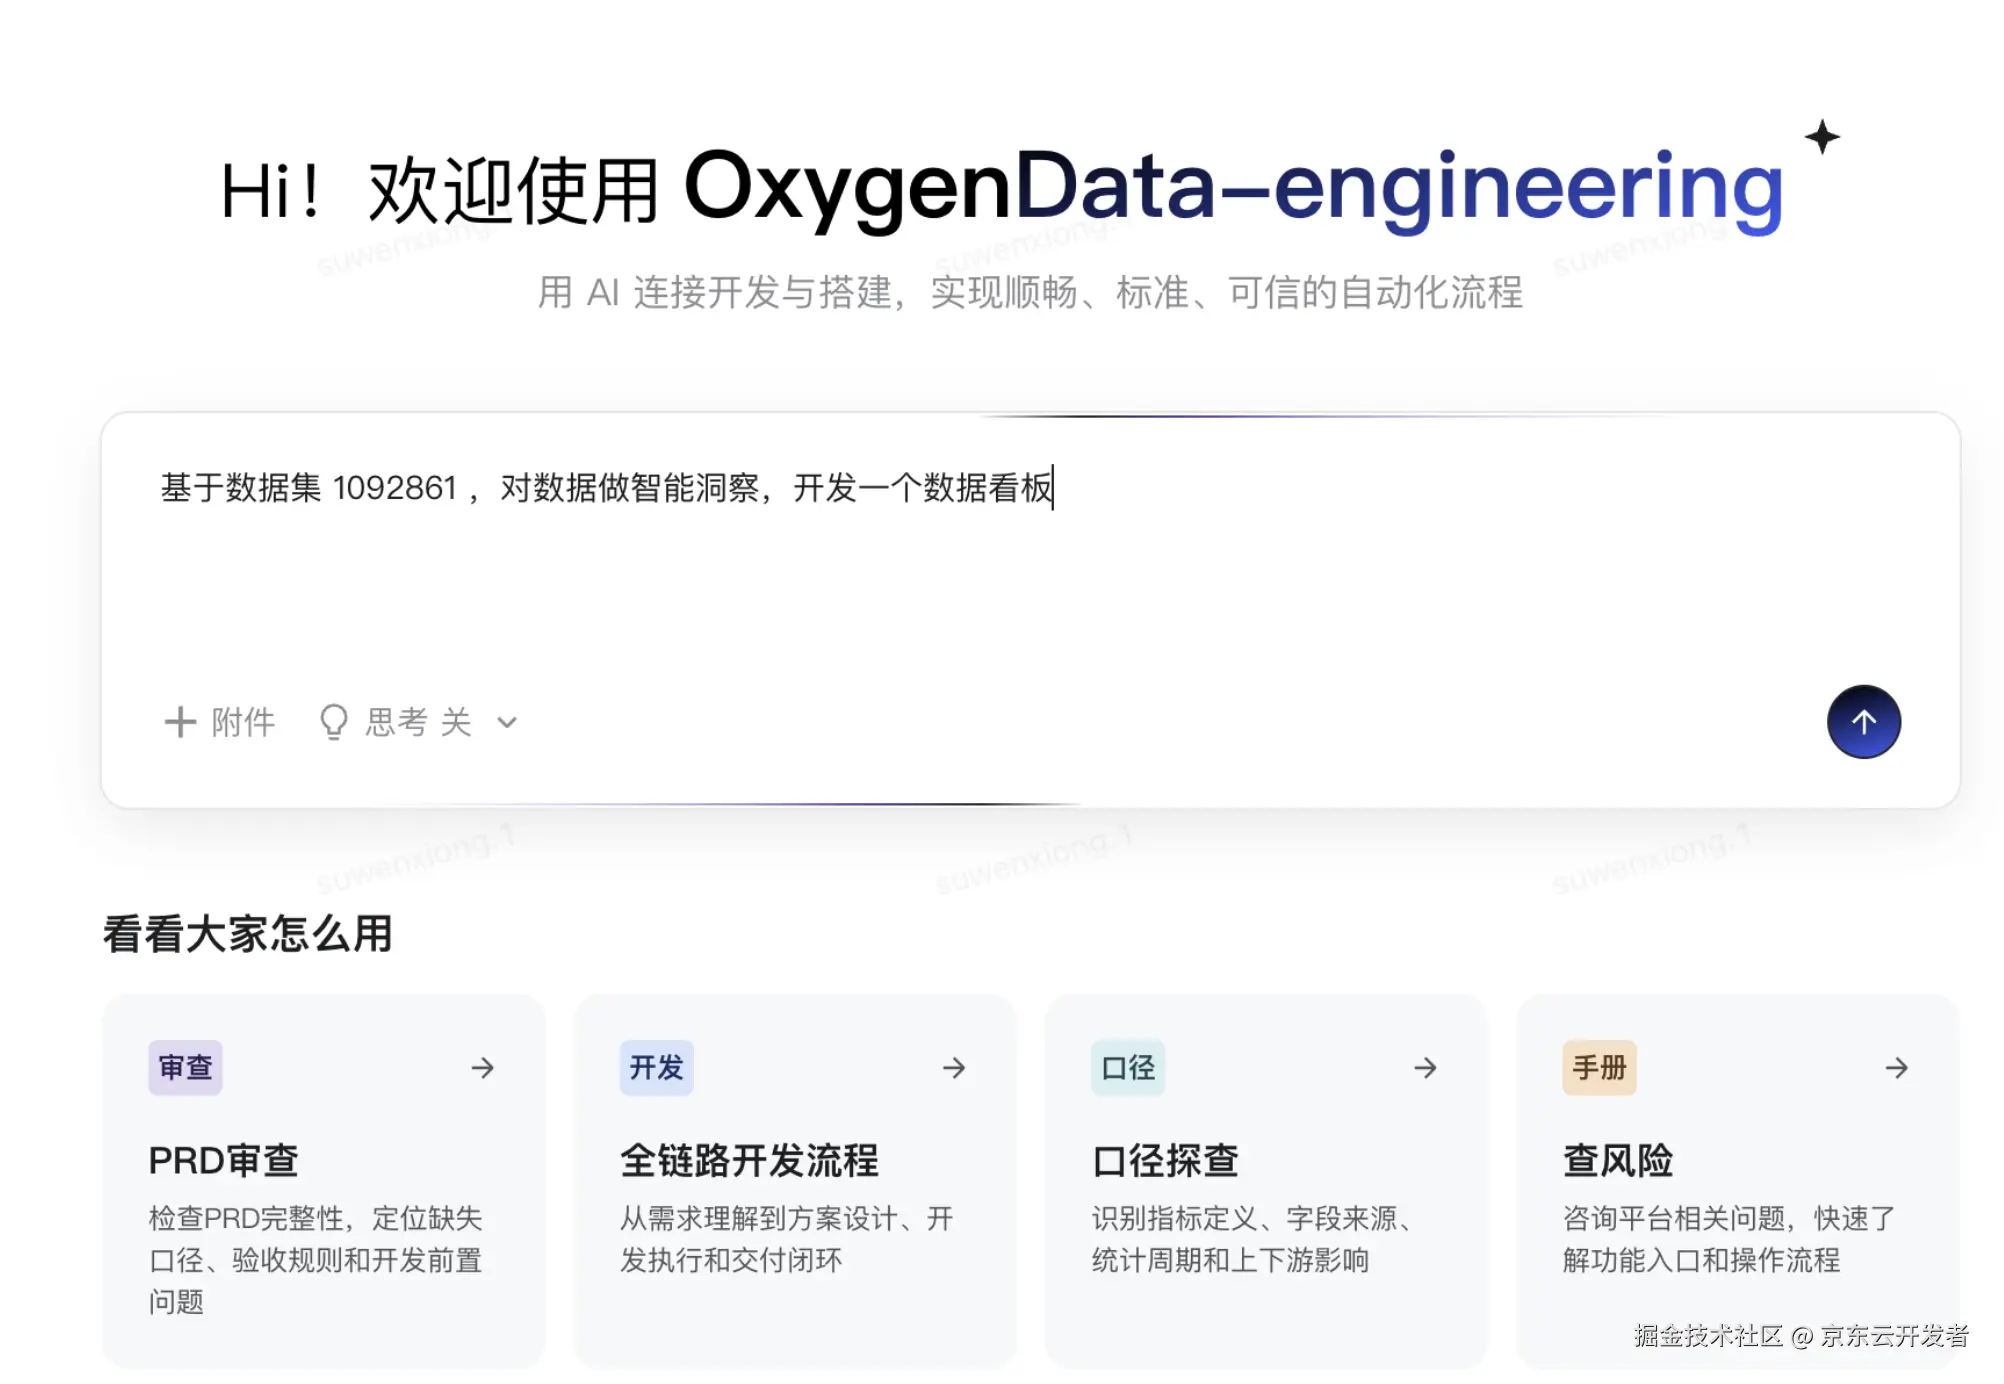
第一步:描述业务意图
用户既可以直接描述分析目标,也可以导入已有的需求文档。Agent 会基于意图和真实数据集,自主完成看板开发,业务语言本身就是开发的起点。
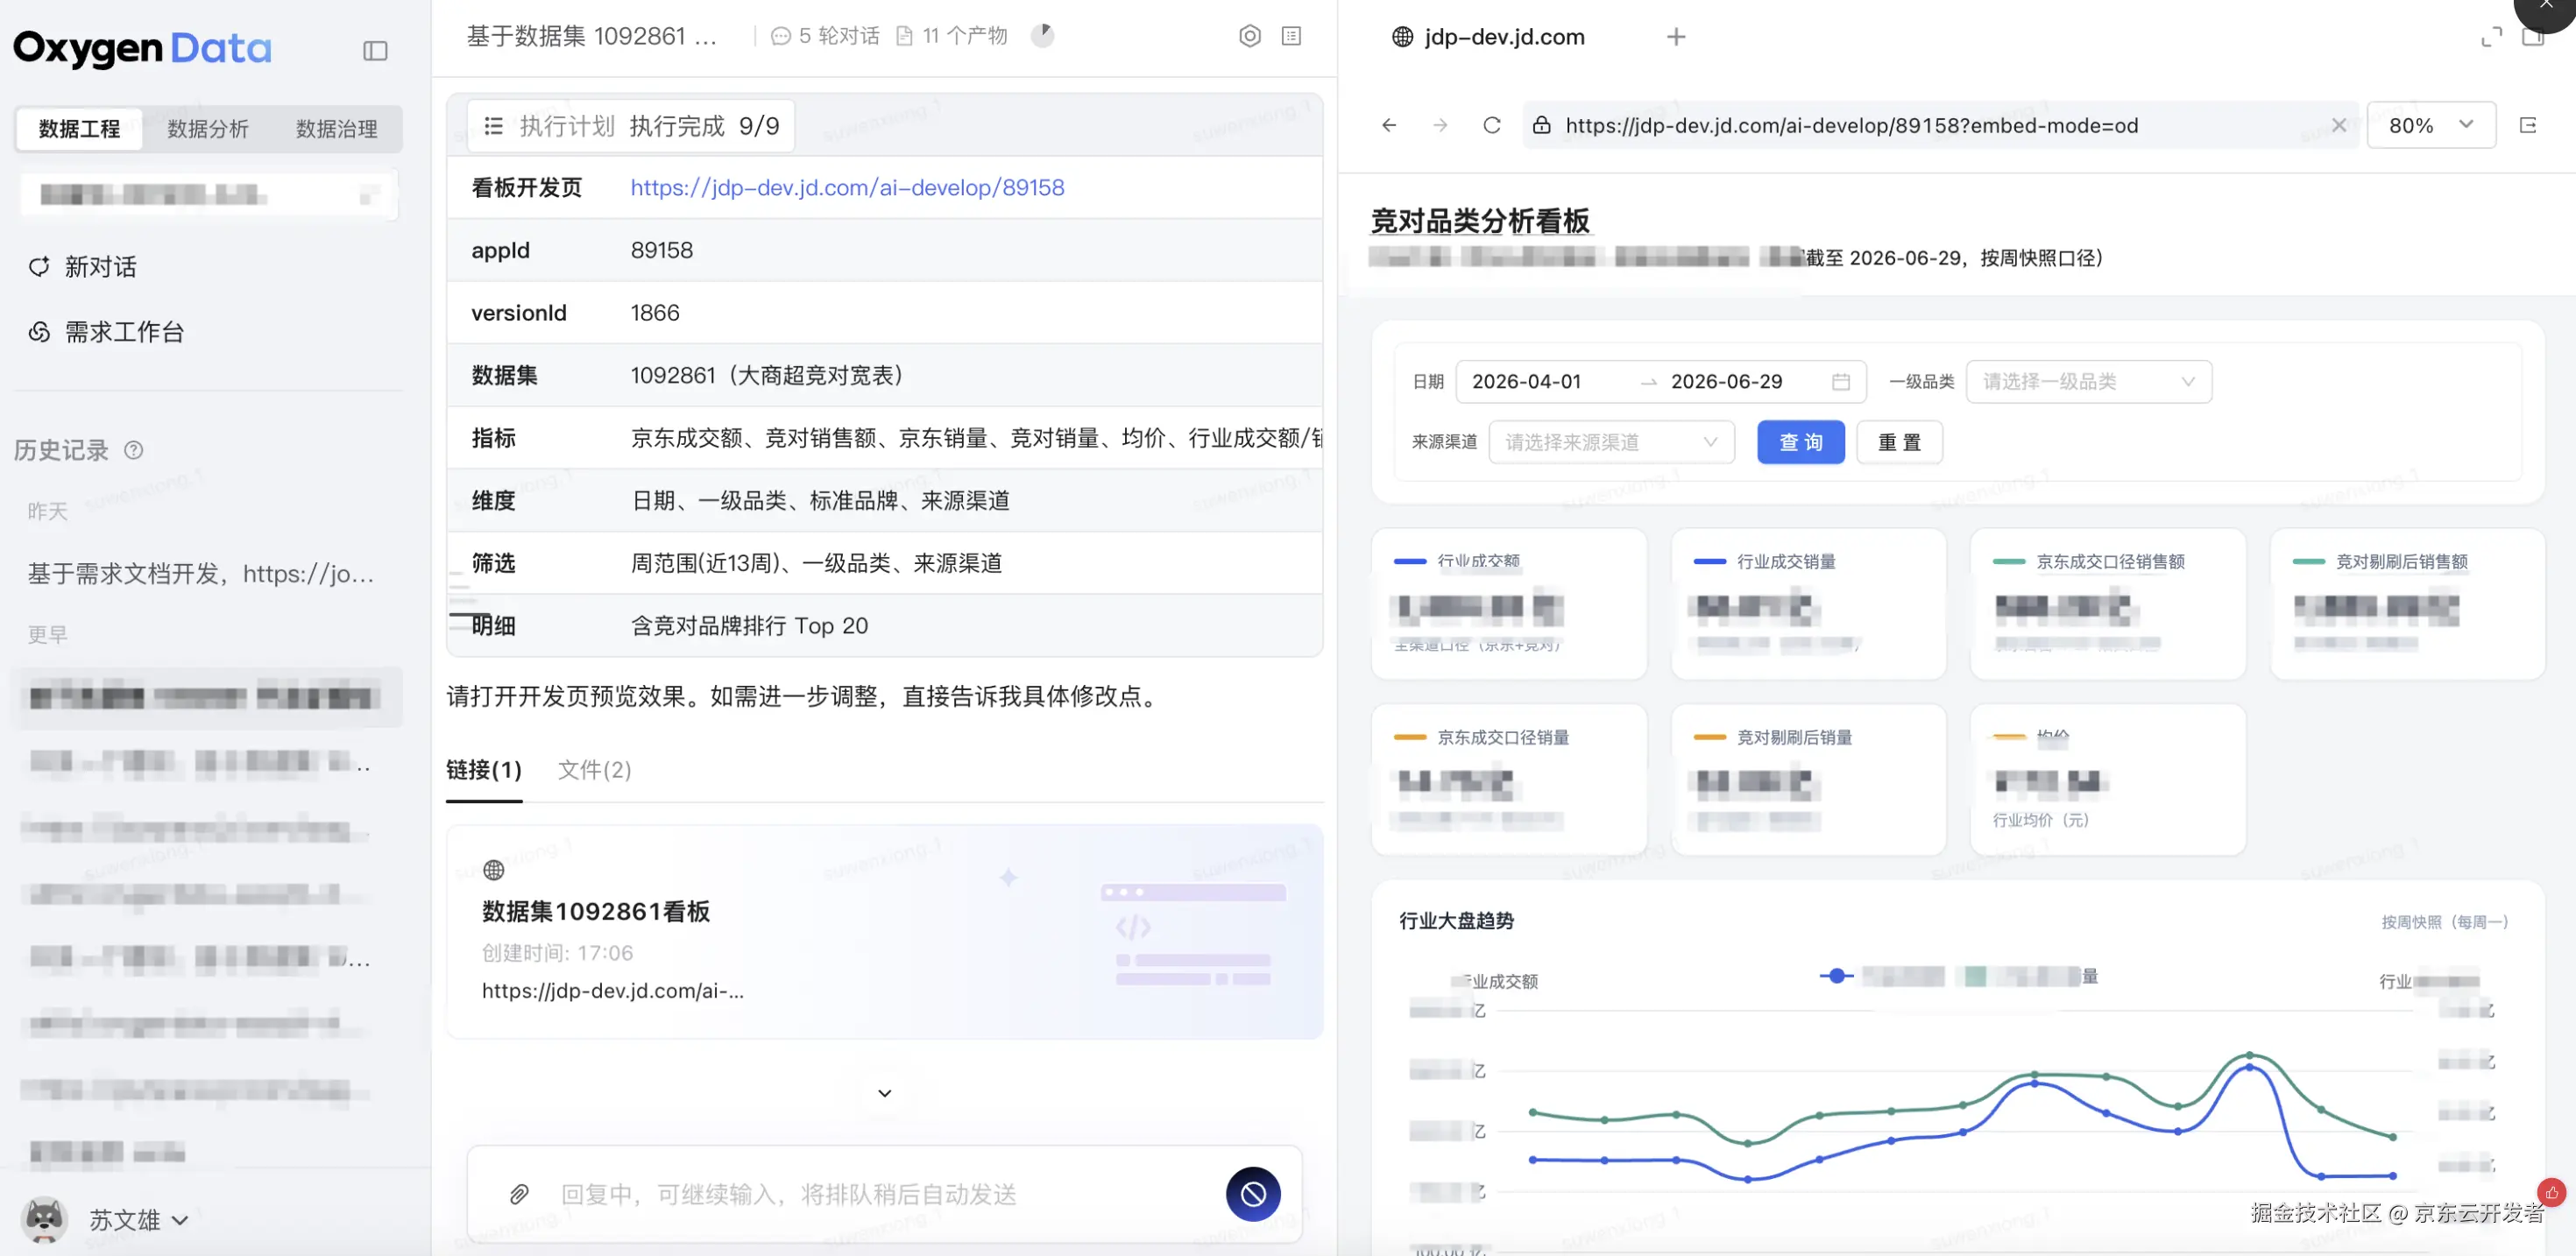
第二步:从需求到成品,实时预览结果
开发完成后,页面右侧则展示生成的看板。
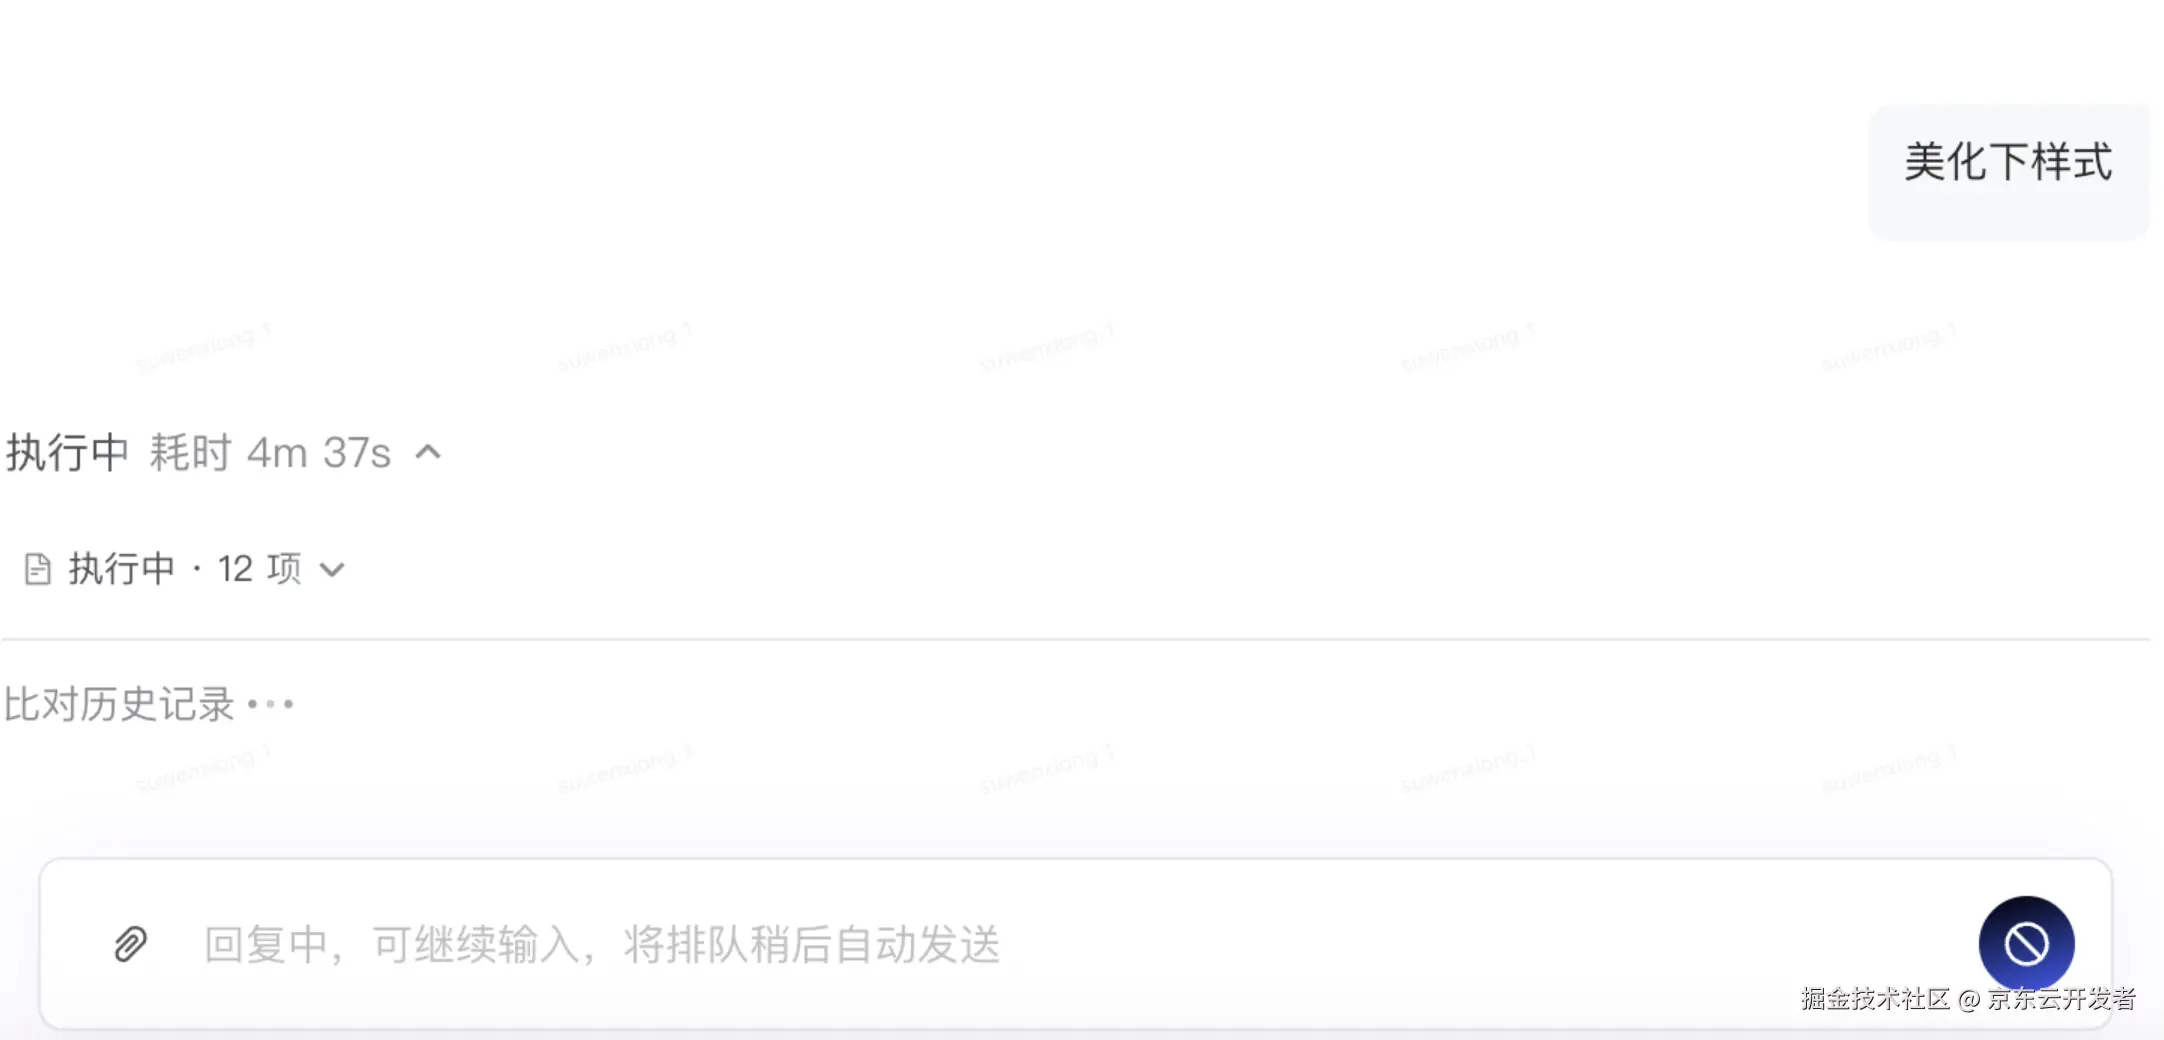
第三步:持续对话,让应用随想法演进
无论是布局、配色、图表还是交互,用户都可以继续用自然语言提出调整要求,Agent 会理解上下文,并在当前成果上持续迭代。比如只需输入"美化下样式",即可触发新一轮优化。
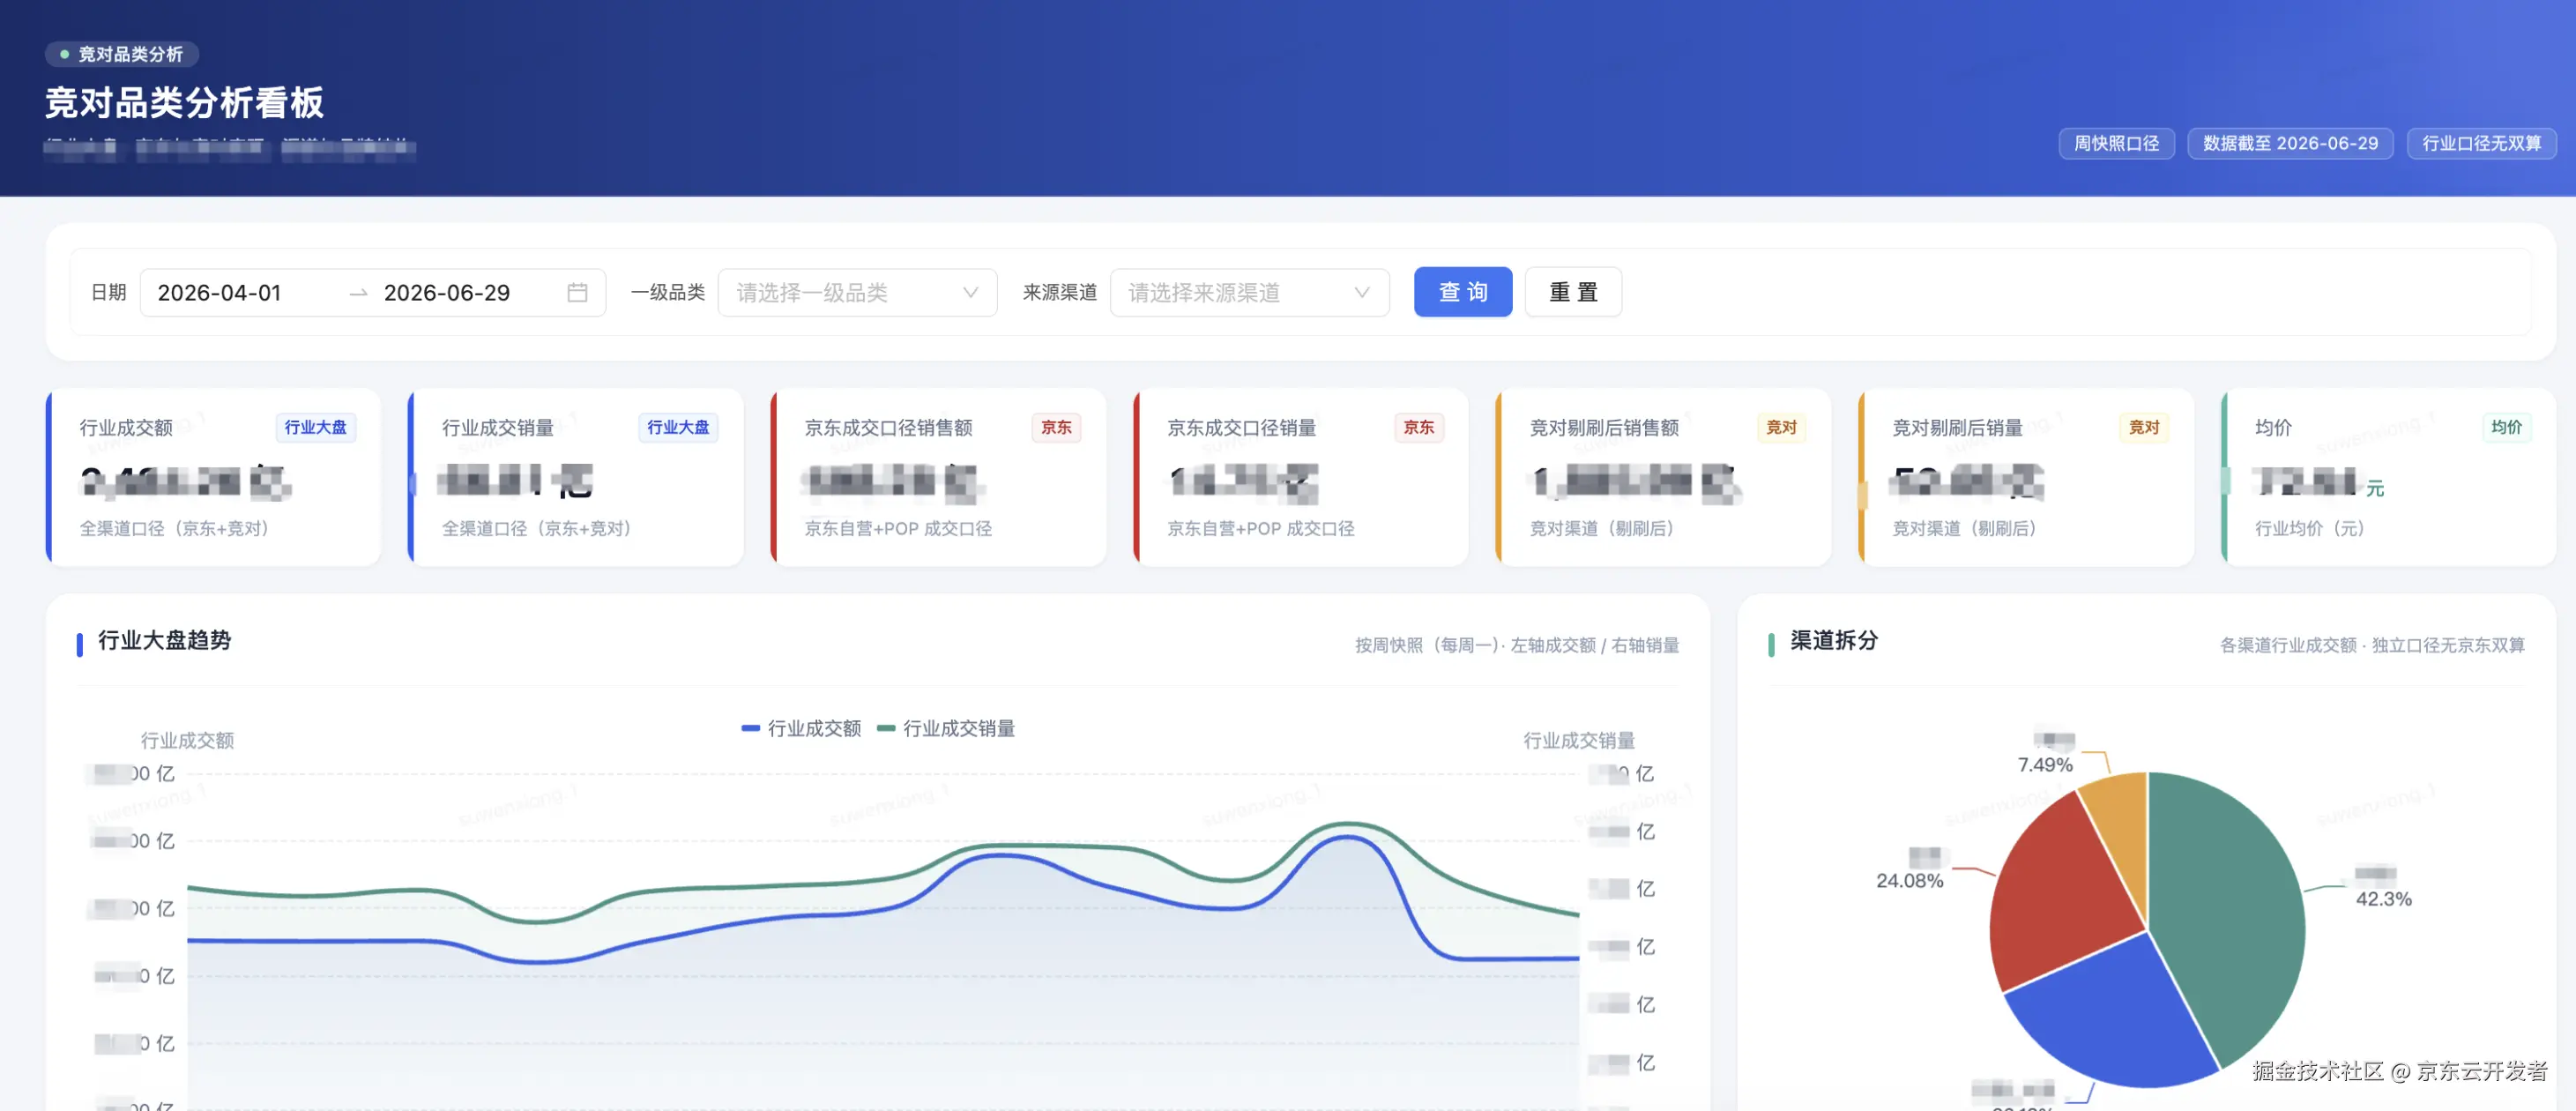
最终,一个连接真实数据、具备定制视觉与交互能力的数据看板,就在连续对话中完成了从构想到落地:
我们是怎么做到的
从上面的过程看,用户只需要描述需求,等待一段时间,就能得到一个可以直接使用的数据看板。但在这个看似简单的过程背后,要解决的问题并不少。
1.项目挑战
生成的看板要连接真实动态的数据集,能够基于筛选器的查询准确使用数据集中的指标和维度;当出现问题时,还能基于当前结果继续优化和修复问题;最终生成的内容也不能只停留在 Demo 阶段,而是要能够发布并真正投入使用。
动态看板复杂度很高
从技术上看,我们真正要构建的是支持动态查询的数据看板,而不是生成一份写死数据的静态页面。相比 Claude Code 分析 Excel 后生成网页,动态查询看板的复杂度要高得多。
动态查询看板与静态看板的复杂度对比如下,简单来说:
•静态看板:是Demo
•动态看板:是真实的业务应用
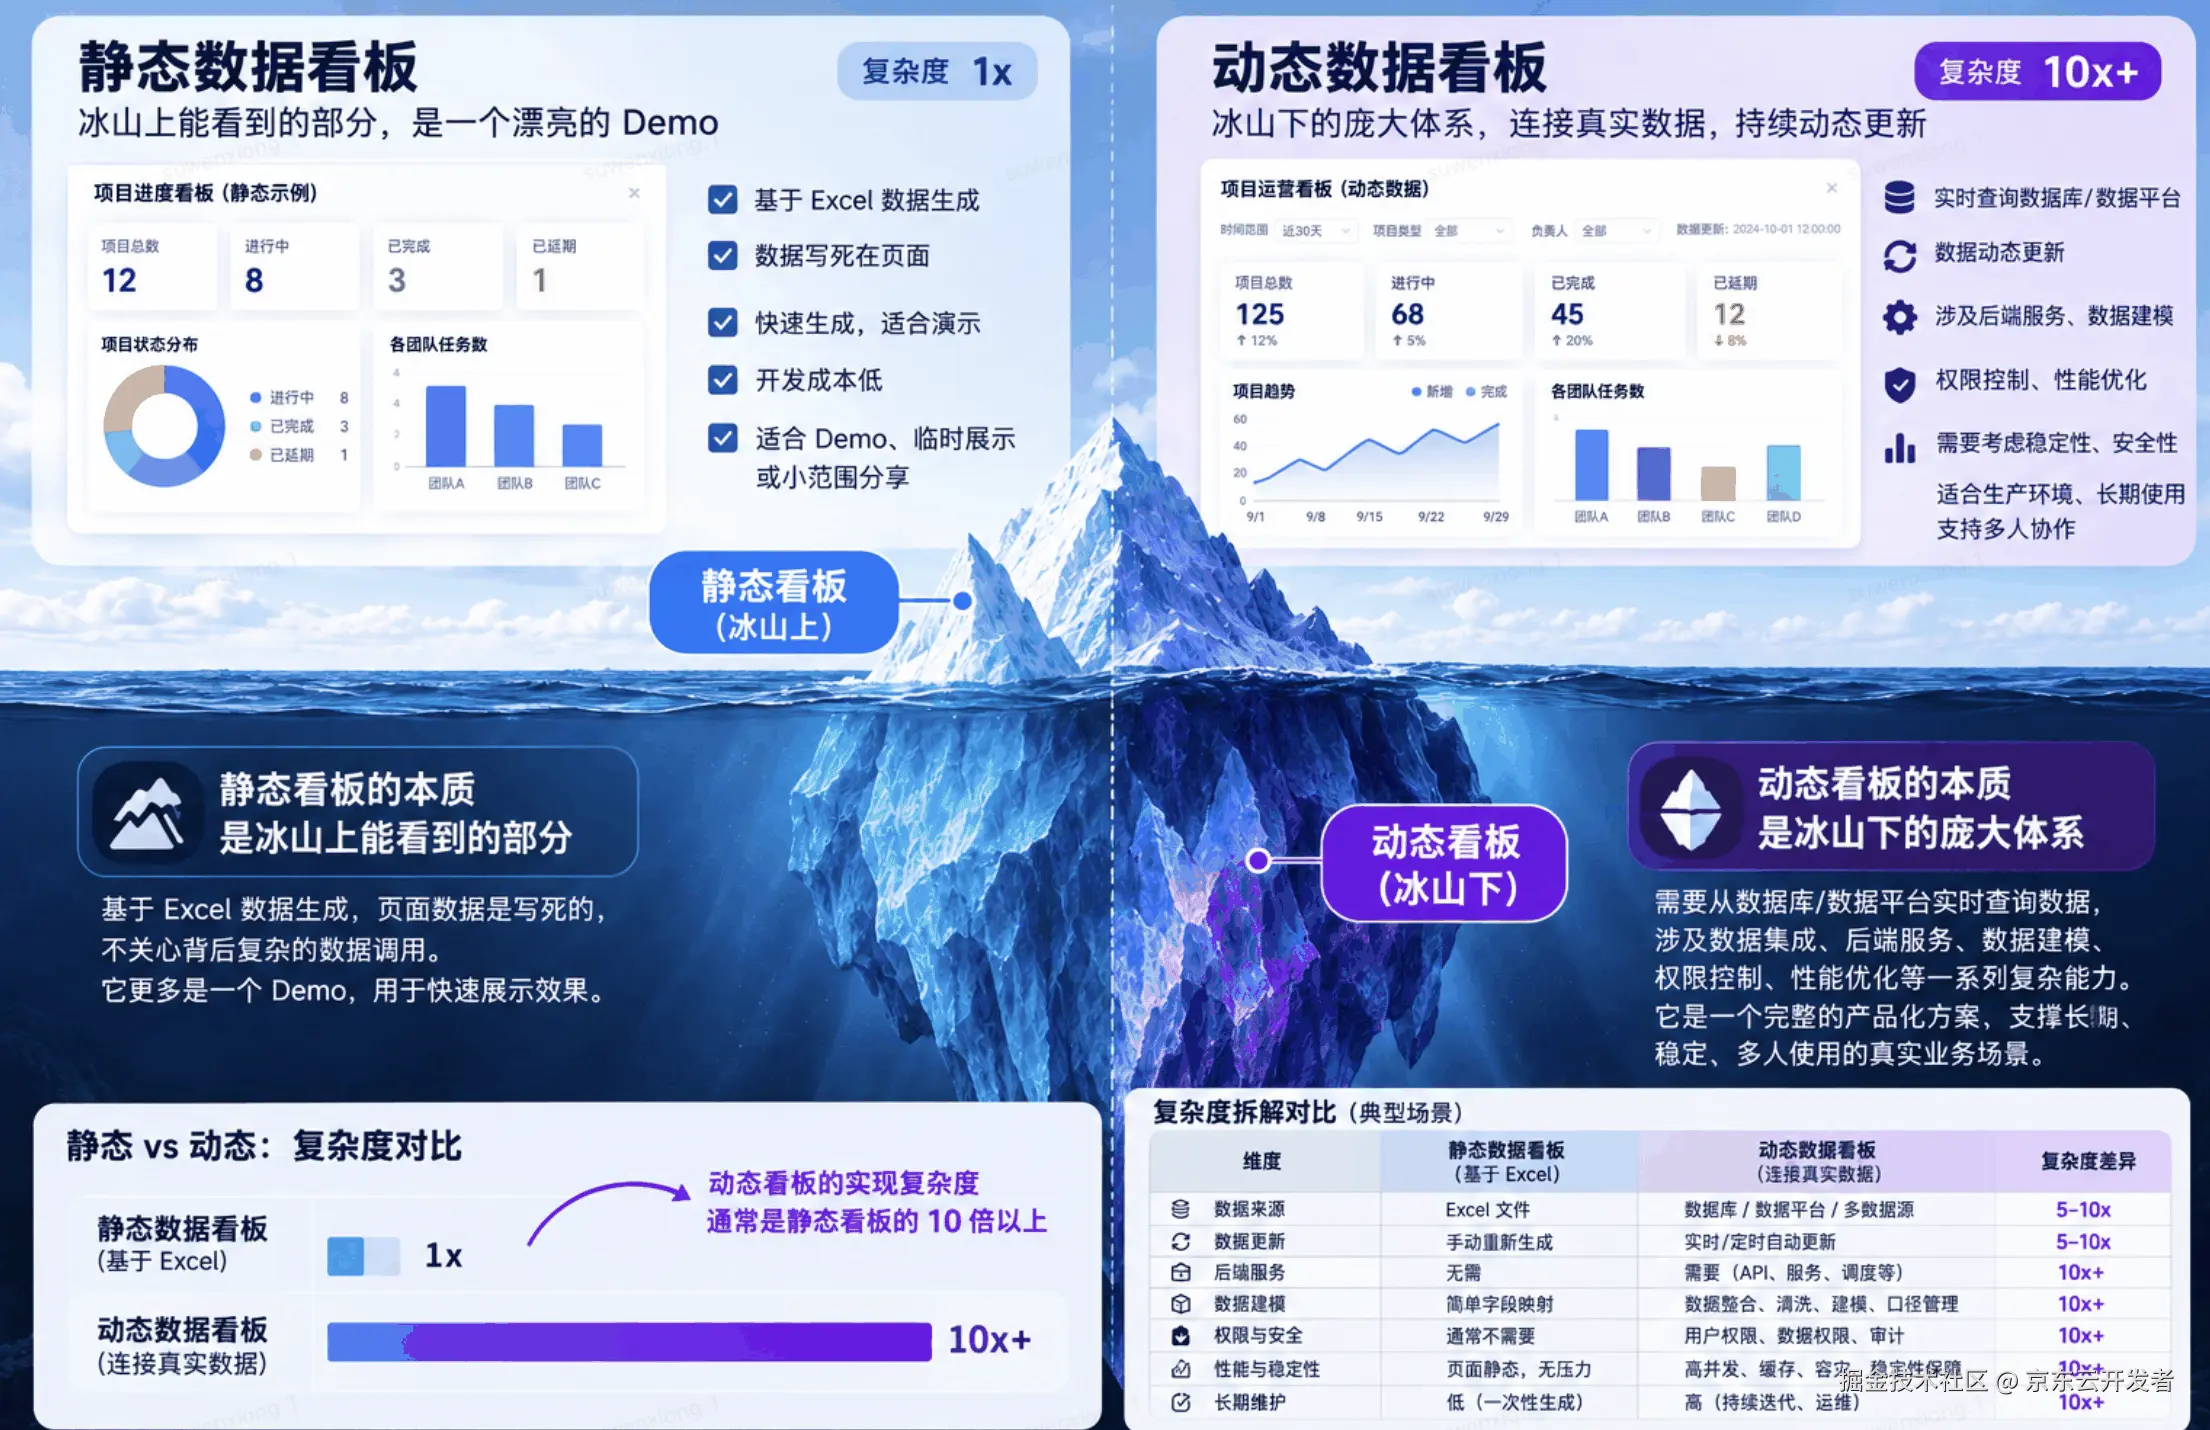
| 对比维度 | 静态看板(Excel → HTML) | 动态看板(数据集 → 查询) |
|---|---|---|
| 整体复杂度 | 1×(基准) | 10×+(示意) |
| 数据规模 | 通常几十万行以内,数据边界明确 | 千万至上亿行,数据规模和分布难以完整感知 |
| 数据理解 | AI 可以直接读取、分析本地数据 | AI 主要依赖 Schema、抽样数据,无法全面理解真实数据 |
| 业务规则 | 数据中异常和规则相对容易发现 | 存在脏数据、隐性规则、复杂指标口径,难以完整识别 |
| 开发方式 | 直接生成包含固定数据的 HTML | 需要生成查询 DSL、动态参数、数据接口及前端交互 |
| 筛选交互 | 基于本地数据筛选,逻辑简单 | 筛选条件变化需要重新构造查询并获取数据 |
| 数据验证 | 可以直接基于 Excel 全量核对 | 需验证不同时间、筛选条件和数据变化下的正确性 |
| 多数据源 | 通常单 Excel 文件 | 多类型数据集,查询能力及接入方式不统一 |
| 行业解法 | 相对成熟,已有较多实践 | 仍处于探索阶段,无成熟方案 |
举例来说对于动态看板,用户把时间范围从"全部"切换为"近一年",再选择"华东区域"。看似只是两次点击,系统背后却要重新识别筛选条件、调整时间粒度、计算同比周期,并为多个图表分别构造查询、处理空值与异常数据,最后完成结果渲染。任何一个环节出现偏差,都可能产生一个"看起来合理、实际错误"的结果。因此,动态看板不仅要保证生成时正确,还要保证在不同数据版本、筛选组合和交互状态下持续正确。
两条看似可行的实现路径
1.沿用静态看板的 AI Coding 模式:将数据直接发送给 AI 生成页面。但 BI 数据集通常达到亿级规模,而静态看板处理的数据一般不超过几十万,受模型上下文限制,这条路径并不可行。
2.沿用常规自研看板模式:将 BI 数据查询 API 文档交给大模型,由 AI 自由生成前端代码。经过大量实际测试,这条路径同样没有跑通。BI 查询协议中的筛选条件、环比同比和对比分析等配置非常复杂,会显著影响开发效果,数据正确性也难以保证。
两条看似直接的路径最终都没有跑通 。这足以说明:动态数据看板既不能照搬静态看板的 AI Coding 模式,也不能简单地把复杂的数据查询交给大模型自由生成代码。真正可行的方案,必须跳出已有模式,以看板生成效率和数据可靠性为核心进行架构创新。
2.我们的设计理念
1.需认识到 AI 并非万能,必须降低AI开发复杂度。以下情况AI实际表现并不好:
◦私域知识:llm 未经过该领域知识训练,私域知识并不能通过知识库从根本上解决,因为大模型的token有限制,并且随着输入token 增多幻觉会变多;而Rag信息召回技术,容易召回错误信息或者丢失重要信息,也存在较多问题,比如像 claude-code 并没有使用 rag 技术
◦业务规则多和复杂性高,可能在不同场合还有不同的用法
2.把原本对 AI 不友好的业务规则,接口查询协议,通过巧妙的架构拆分,构建一套 AI 可理解、上下文充足的环境(for AI 的新宇宙), 在这个新环境里,AI 不需要凭空理解所有底层细节,而是可以在明确的边界内发挥创造力。
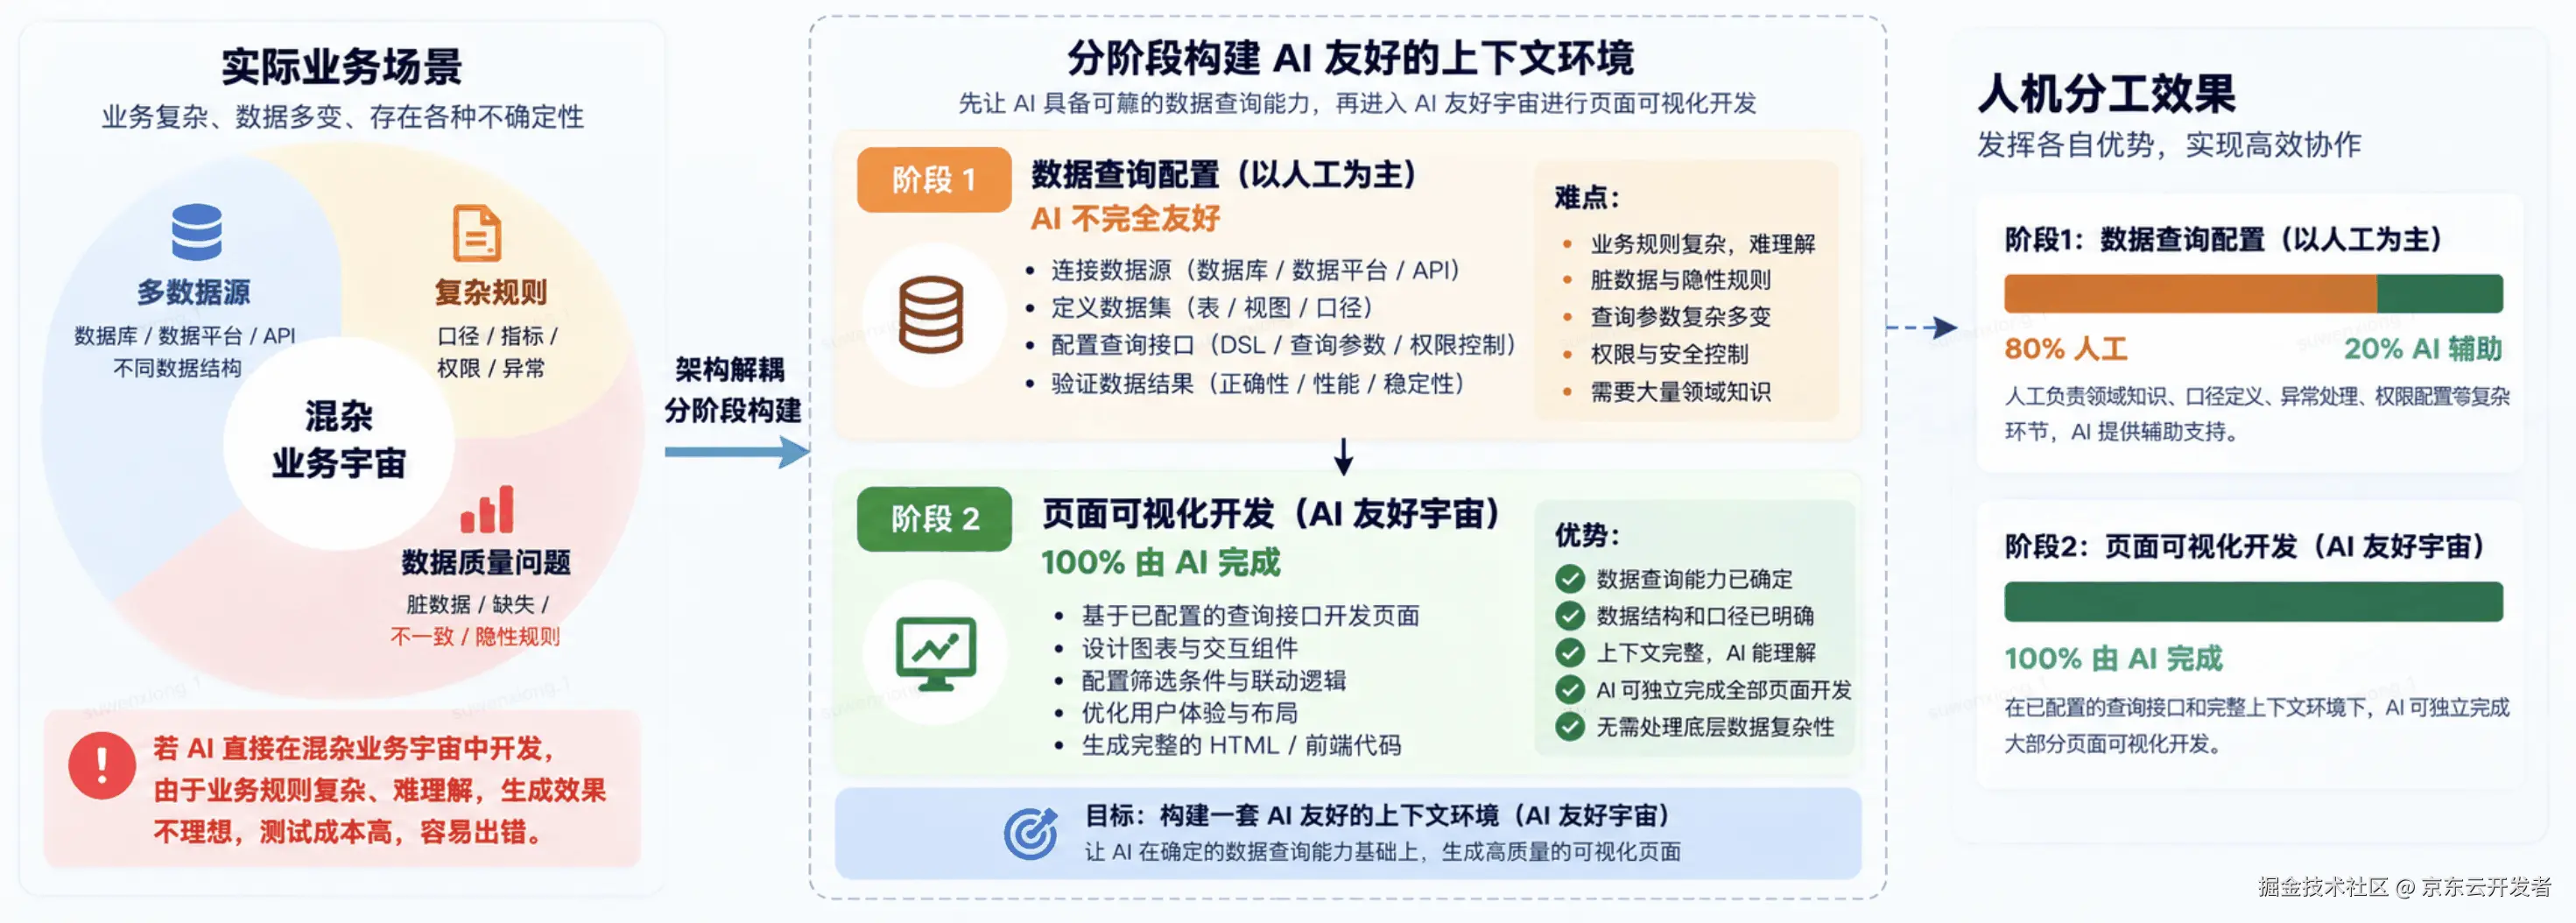
什么是"面向 AI 的新宇宙"
"面向 AI 的新宇宙"并不是让 AI 学会更多 BI 专有知识,而是重新设计 AI 看到的世界,让它需要理解的东西更少、更通用。
大模型在训练阶段学习了大量代码、技术文档和通用知识,因此对非私域的业务知识理解很强。相反,企业内部长期演化形成的 BI 协议和业务规则并不在其通用训练知识中,仅靠提示词临时解释,很难保证模型每次都能准确理解。面向 AI 的关键设计,就是把内部专有知识转化为大模型已经熟悉的通用表达,让模型在自己的能力优势区间内工作。
在传统 BI 开发中,AI 如果要生成一个同比指标,就需要理解同比周期、时间字段、数据对齐和计算公式;如果要生成一个树形筛选器,还需要理解多层条件 and、or 如何组合,并手工构造复杂的查询参数。这些都是 BI 系统长期积累的专有规则,也是 AI 最容易出错的部分。
在新的架构里,复杂规则会在进入 AI 开发环境之前被查询层和组件层消化。站在 AI 的视角,整个世界发生了三个显著变化:
1.开发过程不再包含私域业务规则 。 同比周期怎样确定、指标如何聚合、筛选条件如何嵌套等 BI 专有规则,不再作为背景知识和接口文档交给 AI。AI 面对的是结构稳定的通用协议,不需要先学习企业内部规则,再尝试把规则翻译成代码。
2.请求参数被转换为简单的筛选值 。 AI 不再负责构造带有复杂业务逻辑的查询 DSL,只需要传递筛选字段及用户选择的值。树形筛选中的多层 and、or、权限条件和数据集特有参数,都由组件与查询层自动补全。对 AI 来说,一次查询只是"查询哪个数据模块,并传入哪些筛选值"。
3.响应结果被转换为普通返回字段 。 无论是同比、环比、占比、累计值还是其他衍生指标,计算过程都在查询层完成,并以普通字段形式出现在 response 中。例如,sku_total_yoy_rate 与 sku_total 对 AI 而言没有本质区别:都有明确的字段名、数据类型和业务含义,可以直接绑定到指标卡、图表或表格。
因此,"新宇宙"最重要的变化可以概括为:开发侧无业务私域知识,请求侧只有简单筛选值,响应侧只有普通数据字段。 BI 专有知识并没有消失,而是下沉到查询层和组件层,成为稳定的系统能力,不再要求 AI 在每次页面开发中重新理解和实现。
这种封装也不是不可理解的"黑盒"。AI 不需要知道环比如何计算、复杂协议如何拼装,但能够清楚地看到字段含义、参数结构和返回结果。也就是说,内部实现被封装,对外使用保持透明。
3.架构解耦
基于这一理念,我们通过架构解耦,把动态看板开发拆分为两个阶段:
第一阶段:查询协议构建。
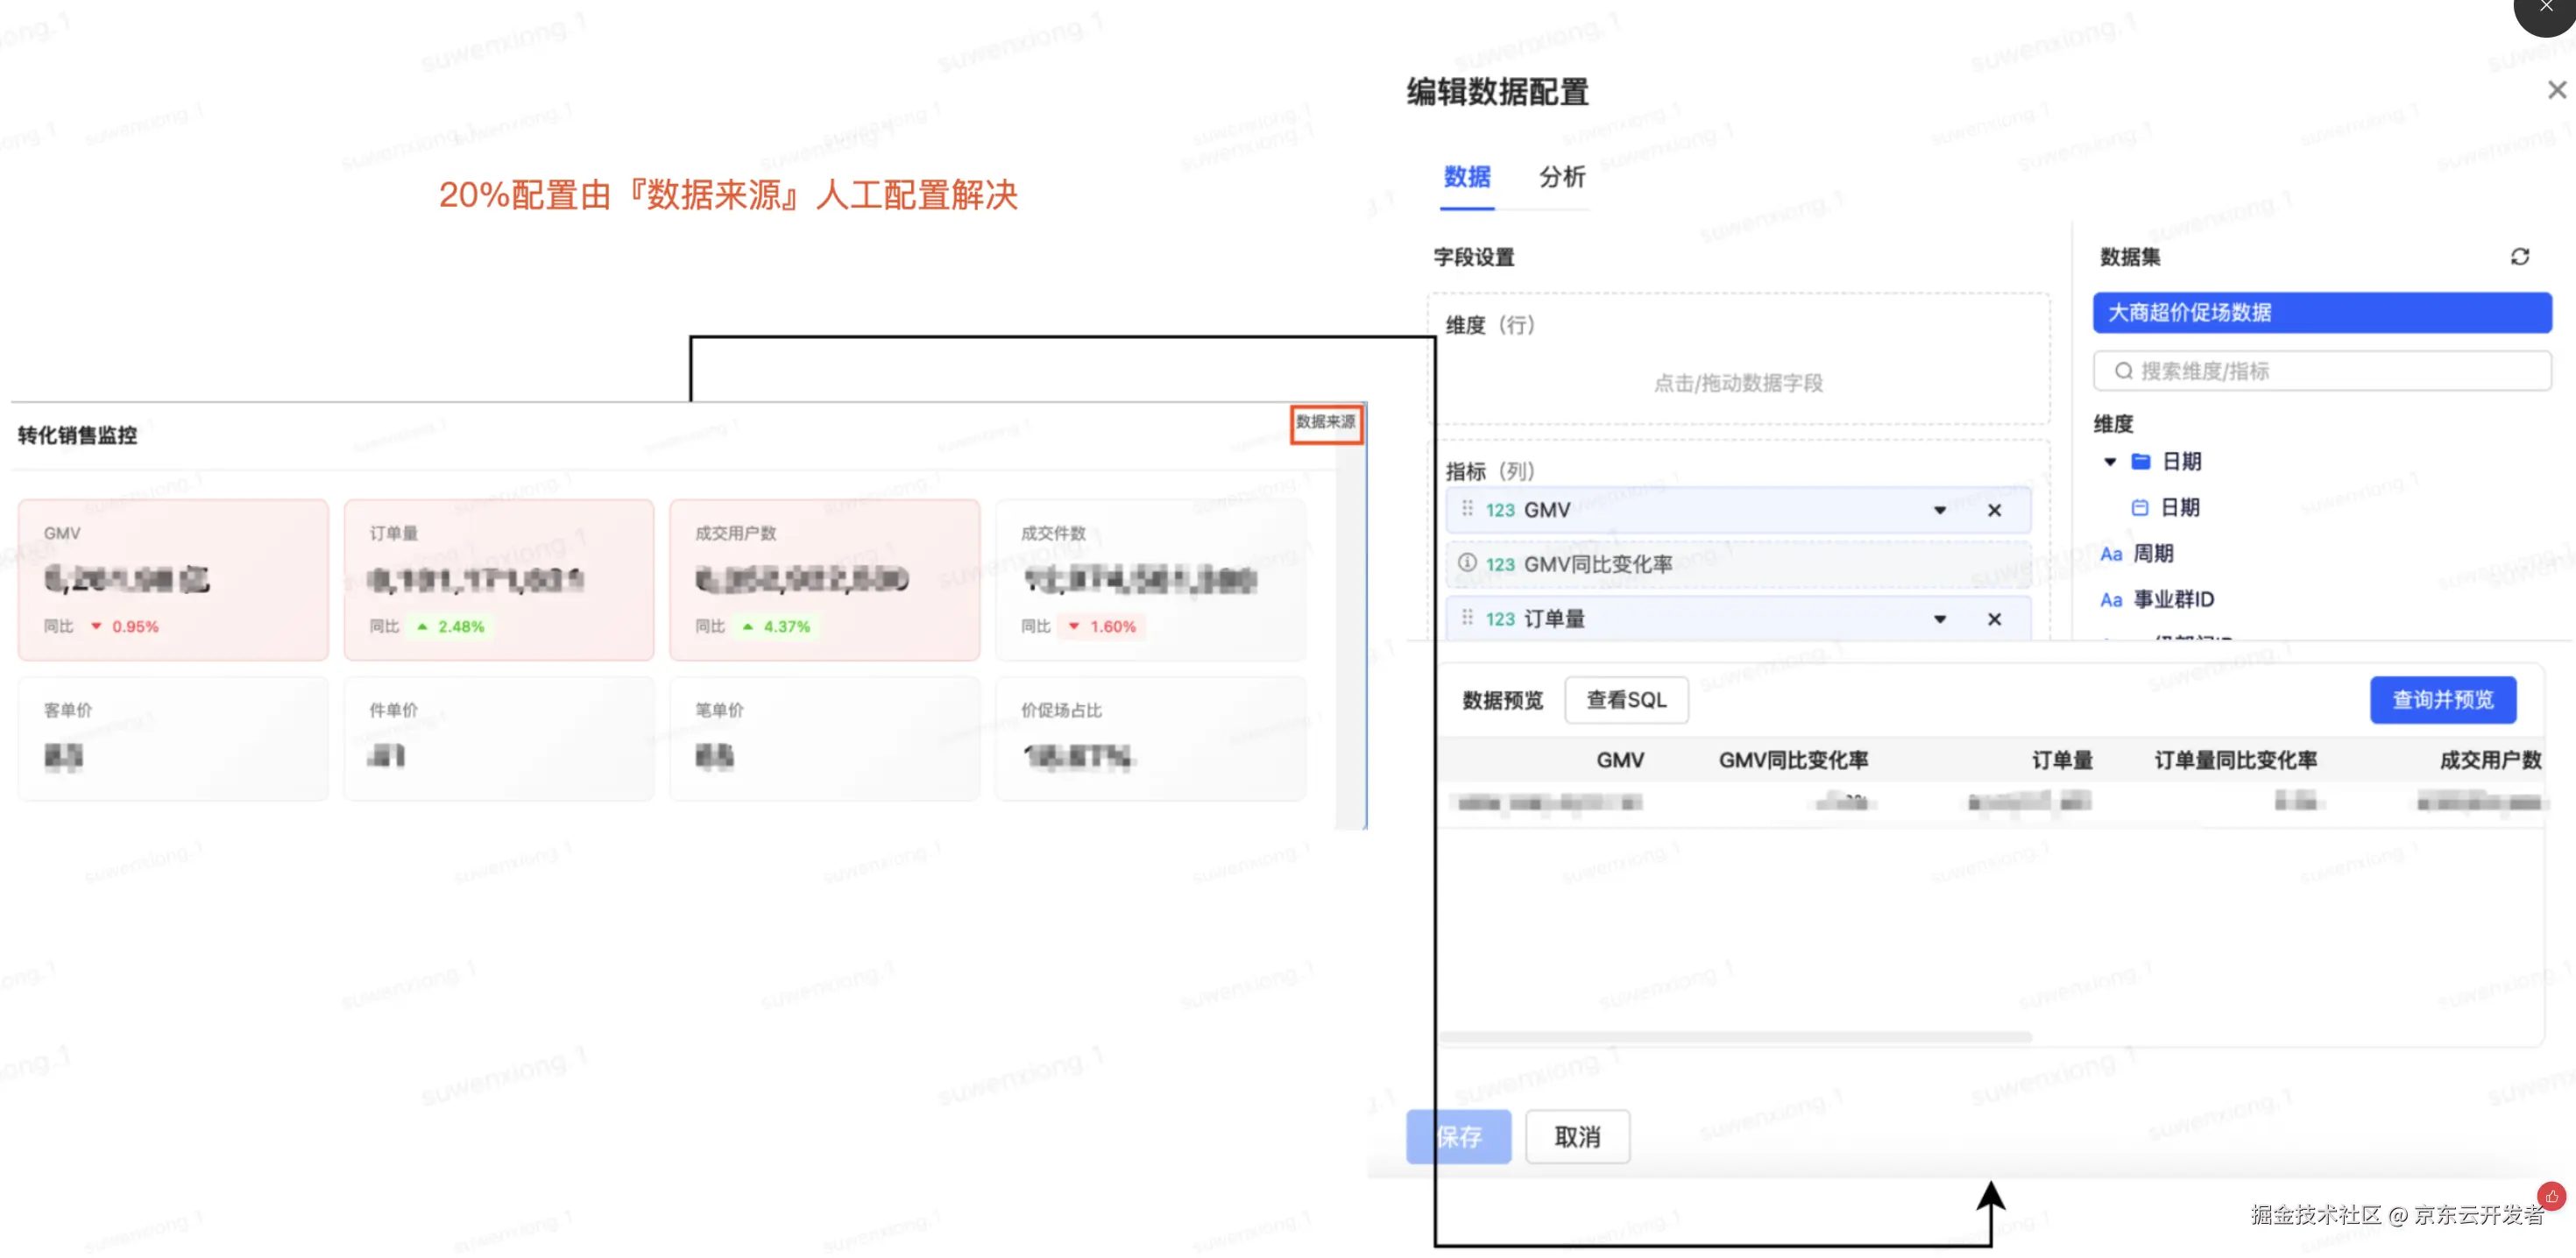
这一阶段需要处理数据集、指标、维度、筛选条件以及复杂的 BI 查询规则,无法做到完全 AI 友好。因此我们采用人机协同的方式,由 AI 辅助理解和生成,由平台 GUI 能力与人工判断提供约束和确认,最终形成准确、标准化的查询协议。
支持GUI人机协同能力:通过图表数据源功能,调整配置和查看 sql 等:
第二阶段:基于 AI 友好协议的页面构建。
查询复杂度被第一阶段隔离后,AI 面对的不再是底层 BI 协议,而是一套语义明确、结构稳定、易于理解和调用的协议。AI 可以据此专注于页面布局、图表表达和交互实现,将业务意图高效转化为最终看板。
架构解耦的关键,不是让 AI 强行掌握所有复杂规则,而是先通过人机协同把复杂查询转化为 AI 友好的协议,再让 AI 基于这套协议完成页面创造。由此,我们既保留了查询环节所需的准确性,也释放了 AI 在页面生成阶段的创造力。
下面两个具体的 JSON 协议,可以更直观地说明这种解耦。
示例一:环比规则被转换为普通指标字段
在第一阶段,查询协议需要明确参与计算的原始指标、对比方式、输出类型以及关联的时间筛选器。例如,要计算 SKU 数量同比,实际配置如下:
css
{
  "ref": [
    "sku_total",
    "tag_enum_total",
    "gmv_total",
    "sale_qty_total",
    "brand_total"
  ],
  "derive": {
    "transform": "periodCompare",
    "compare": "yoy",
    "output": "rate",
    "dateRef": "dateFilter"
  }
}
这段协议意味着:以 dateFilter 为时间基准,对引用的指标执行 periodCompare 转换,计算同比 yoy,并以比率 rate 形式输出。时间周期对齐、同期数据查询和比率计算等逻辑均由查询层处理。
到了第二阶段,查询结果会把衍生指标转换成普通字段:
json
{
  "response": {
    "rows": {
      "type": "array",
      "item": {
        "sku_total_yoy_rate": {
          "type": "number",
          "role": "measure"
        },
        "tag_enum_total_yoy_rate": {
          "type": "number",
          "role": "measure"
        }
      }
    }
  }
}此时,sku_total_yoy_rate 对 AI 来说只是一个普通数值指标。AI 可以直接绑定到指标卡或图表,无需知道同比周期如何推算、两期数据如何对齐,也不需要在页面代码中实现同比计算。
示例二:树形筛选组件自动生成复杂查询条件
对于树形筛选,AI 在页面构建阶段只需要感知可筛选字段和操作符:
css
[ { "name": "a1", "op": "in" }, { "name": "a2", "op": "in" }]当用户在组件中选择"a1 属于 2 或 3",或者选择"a1 等于 11,并且 a2 属于 11、22、33"时,前端树形筛选组件会自动生成实际查询协议:
json
{
  "type": "or",
  "children": [
    { "a1": [2, 3] },
    {
      "type": "and",
      "children": [
        { "a1": 11, "a2": [11, 22, 33] }
      ]
    }
  ]
}
AI 只负责声明"有哪些字段可以筛选",组件负责把用户操作转换成包含 and、or 和嵌套 children 的查询树。这样既降低了 AI 生成错误协议的概率,也避免了页面构建阶段反复解释底层查询规则。
技术架构
如果把一句业务需求变成一个真正能运行的看板,背后大致要经过三步:先对数据做画像理解数据集,再让 Agent 按既定流程完成开发和纠错,最后把代码放进浏览器里跑起来。我们的技术架构基本就是围绕这三件事搭建的。
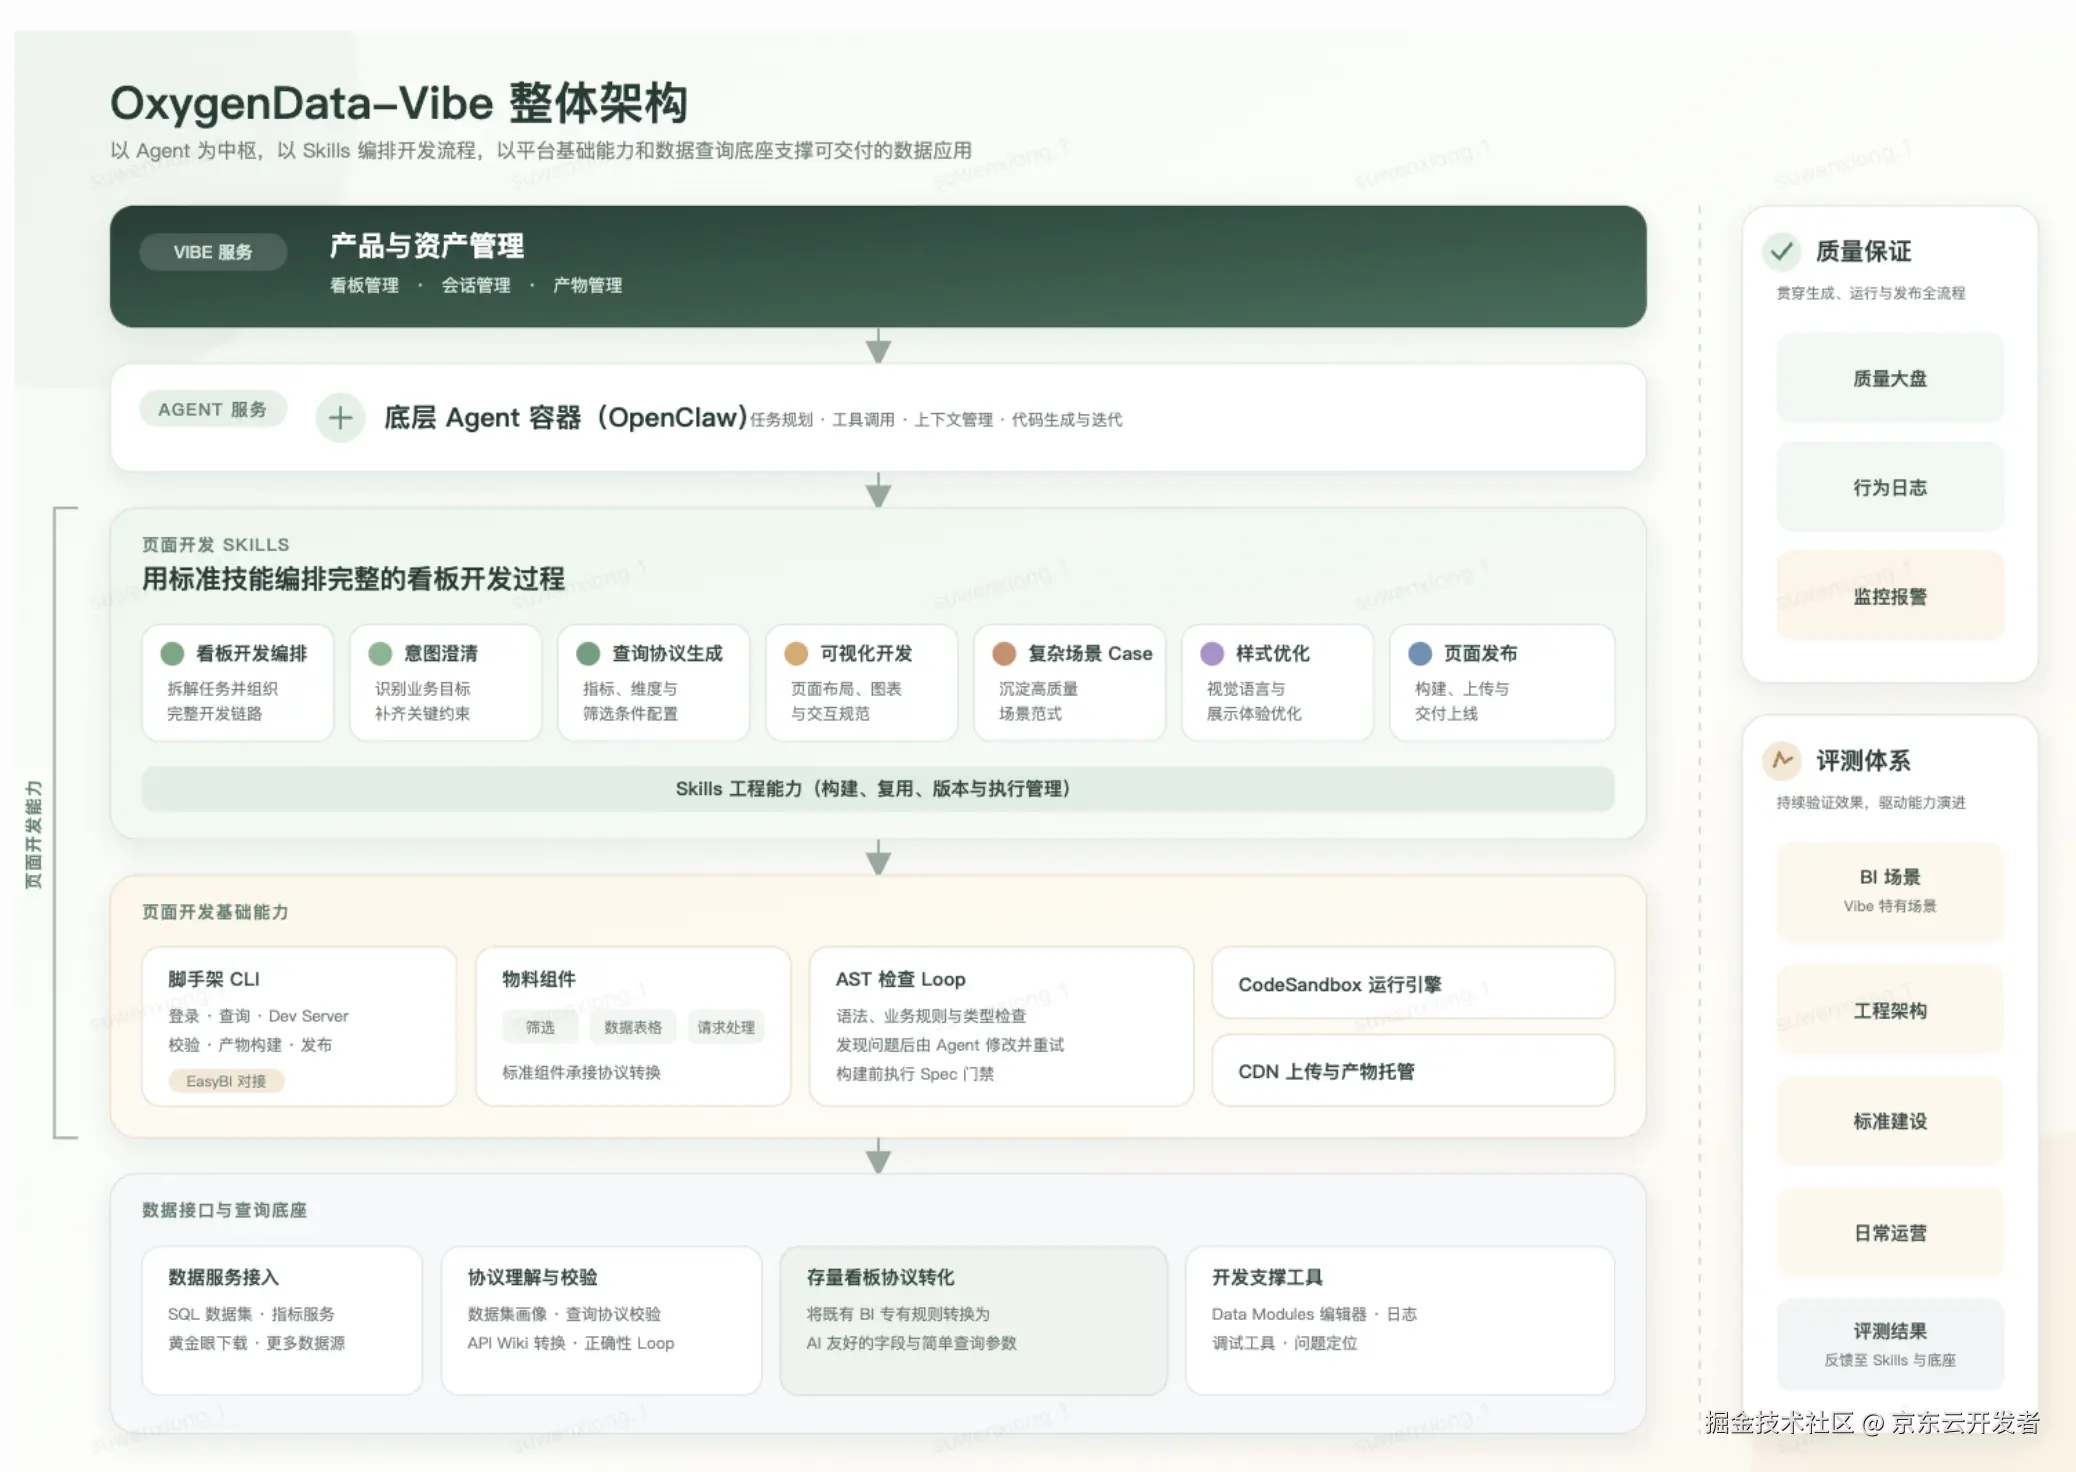
0. 数据画像
数据画像可以简单理解为:在让 AI 做看板之前,先把数据集看明白。
如果只给 AI 一份字段列表,AI其实很难判断这些数据应该怎么用。比如一个字段叫"销售额",AI 还需要知道是金额还是数量、通常在什么范围、能不能求和;一个字段叫"区域",也需要知道里面是华北、华东这样的枚举值,还是更细的省市层级。不了解这些信息,AI 虽然也能生成页面,但很容易选错字段、用错图表,甚至做出看起来合理、实际没有业务意义的分析。
数据画像做的事情,就是先把这些问题回答清楚。会告诉 AI:数据集中有哪些字段,哪些是维度、哪些是指标,字段里大概有哪些值,指标的数据分布是什么样,哪些指标和维度可以一起查询。这样 AI 拿到的就不再是一堆陌生字段,而是一份关于这个数据集的"使用说明书"。
这个思路灵感来自我们对 "Claude Code + Excel 生成 HTML" 过程的研究。Claude Code 拿到 Excel 后,通常不会马上开始写页面,而是先查看表结构和字段信息,再分析维度有哪些典型取值、指标的数值有什么特征。等对数据形成比较完整的认识后,才会结合用户需求决定使用哪些字段、怎样聚合,以及选择什么图表。静态看板之所以容易取得不错的效果,"先理解数据,再开发页面"是一个很重要的原因。
但动态数据集通常有千万甚至上亿行,不可能像 Excel 一样把全部数据交给大模型。我们保留了这个思路,把全量读取改成了数据集画像:先获取字段元信息和统计特征,在条件允许时补充少量样本和维度枚举值,同时识别数据集支持哪些查询方式、需要什么权限、哪些字段可以组合。
最终交给 AI 的不是全量数据,而是一张足够准确的数据地图。
1. 把数据查询变成 AI 看得懂的 API
页面开发并不是从写代码开始的。对动态看板来说,首先要回答的是:这个页面能查询哪些数据、能传入哪些筛选值、又会返回哪些字段?
这些先被写进 data-modules.json。可以理解为看板的设计稿,记录每个数据模块使用的数据集、指标、维度、筛选条件,以及派生计算、排序、下钻和汇总方式。AI 和用户通过图形化界面一起完成配置;字段名称、类型等客观信息则直接从数据集元数据中获取,不让模型凭空猜测。
配置通过结构校验、数据集校验和线上组合校验后,会被编译成 api-wiki.json。到了这一步,每个 Data Module 都变成了一条清晰的 API:用哪个 queryId 发起查询,可以传哪些筛选值,是否支持分页和排序,以及 response.rows.item 中会返回哪些字段。
API Wiki 不是一份需要人工维护的文档,而是 Data Modules 的编译产物。两者变化的关键在于:复杂 BI 规则停留在 Data Module 这一侧,交给 AI 的只是一份简单的接口契约。请求时传普通筛选值,返回时消费普通字段;即使某个字段背后是同比或环比计算,AI 也只需要知道的名称、类型和业务含义。
2. 前端 UI 开发
有了 API,还需要告诉 Agent 怎样把页面一步步做出来。
2.1 代码开发
进入代码开发后,Agent 拿到的是业务需求和 API Wiki,同时还可以使用页面模板、组件规范、业务 Case 和 UI 规范。从 params 中知道页面能提供哪些筛选项,从 response 中知道图表能使用哪些字段,不再直接触碰底层 BI 协议。
整条链路由 Skill 串起来:先澄清需求,再准备查询协议,然后生成代码、检查错误、打包预览,最后发布。AI 仍然有足够空间决定页面长什么样、采用什么图表和交互,但每一步该用什么输入、工具和完成标准,都是明确的。
2.2 自研 AST Loop:让错误可以被定位和修复
代码能编译,并不代表看板就能正确运行。模型可能写出一个不存在的 queryId,可能让筛选字段与 API Wiki 对不上,也可能用错查询参数或组件。这些代码在语法上完全合法,普通的 Lint 很难发现,真正运行时却一定会出问题。
为了解决这类问题,我们基于 TypeScript Compiler API 做了一套 AST Checker。AI会分析源码 AST 和模块依赖,再用查询、筛选、表格、运行时等领域规则检查代码,同时结合 TypeScript 做类型校验。不仅知道"这段代码是否合法",还知道页面使用的字段、查询和组件是否符合 API Wiki 与平台规范。
更重要的是,这个检查不是发布前才跑一次。每一轮代码生成后,Agent 都会执行检查;Checker 会把错误定位到具体文件和代码位置,并给出明确原因;Agent 根据结果修改代码,然后再次检查。这个过程会一直重复,直到所有规则通过。
这就是我们所说的 AST Loop:生成代码 → 发现问题 → 定位并修复 → 再次检查 。除此之外,spec-check 还会在开发和打包阶段检查工程结构与交付要求。前者关注代码有没有正确使用平台能力,后者关注产物是否满足交付规范,两道检查一起把模型生成的代码逐步收敛成可运行的页面。
3. 打包与运行:自研 CodeSandbox
最后一个问题是:Agent 写完代码后,在哪里运行?
传统前端工程通常要先安装 node_modules,再启动 Node 开发服务,这套流程并不适合在线 Agent。依赖安装很容易受到网络、包源、锁文件和运行环境差异的影响,导致运行不稳定和同一份代码可能在不同容器中出现不同结果。为此,我们自研了一套 CodeSandbox。把 Agent 生成的文件放进内存虚拟文件系统,使用 esbuild 在运行时完成模块解析、编译和打包;React、图表库、EasyBI 等公共依赖组件,则从预先构建好的 CDN 中加载。这样无需安装 node_modules,代码生成后就能直接运行。
最直接的收益是节省时间。过去创建新的开发环境,都要先下载和安装完整依赖,通常需要 10 分钟左右;现在公共依赖已经提前构建,Agent 拿到代码后可以直接进入编译和预览。打包也从分钟级缩短到秒级,用户不需要在每一轮修改后长时间等待结果。
CodeSandbox 使用统一 CDN Vendor 和同一套运行时,避免了依赖版本漂移,开发和预览、发布使用的依赖环境始终一致。
开发过程中,代码可以直接进入沙箱预览,Dev Server 负责实时构建和热更新。发布时,同一套构建能力会把项目代码编译成 IIFE,再与运行时依赖组装成一个可以独立打开的 HTML。HTML 和源码归档上传到 CDN 后,再写入 EasyBI 完成发布。
对 Agent 来说,这条链路从传统的"安装依赖---启动服务---本地构建",变成了更简单的"生成代码---秒级编译---沙箱运行"。更短的反馈周期意味着 Agent 可以在相同时间内完成更多轮生成、验证和修复,也让整个在线开发过程更稳定。
尾声
从上文可以看出,在 AI coding 高速发展下,数据看板的生产方式已经开始发生变化。过去做看板,要么在 BI 已有的图表和组件里配置,要么交给研发从头开发;现在,用户可以直接说清楚自己的分析思路,由 AI 把需求变成页面。看板能做成什么样,不再只取决于 BI 预设了哪些能力,或者能投入多少研发资源,而是可以更多地从业务需求本身出发。这个变化一方面提升了开发看板效率,另外一方面让以前做不了高体验需求通过 AI Coding方式支持。从 9 月上线至今,用户已经通过 OxygenData-Vibe 创建了 478 个看板,其中 117 个完成发布并投入使用,也说明这种方式确实能够解决一部分真实需求。