在华为云 GaussDB(DWS) 中,谓词下推的语义比原生 PostgreSQL 多了一层------除了 PG 继承下来的"把 WHERE 条件尽可能下沉到扫描节点 "之外,更关键的是分布式层面的"语句下推"(把整个查询从 CN 推到各 DN 并行执行)
对 DWS 而言,调优的第一优先级往往不是索引,而是先判断"整条语句有没有下推"------因为不下推意味着所有数据要汇聚到 CN 单点执行,性能会差几个数量级。
一、先理解架构:为什么 DWS 的下推分两层
DWS 采用 GaussDB 内核 、Shared-nothing MPP 架构:
(1)CN(Coordinator,协调节点) 负责解析、优化和任务分发
(2)DN(Datanode,数据节点) 各自持有独立的 CPU/内存/存储,数据按 Hash/Replication 分布在 DN 上。
这决定了下推有两个层级:
- DN 内部(单机层) :与 PG 一致------谓词下沉到 Scan 节点作为 Filter,若命中索引则成为 Index Cond,若列存表则进一步触发 PCK 的 min/max 稀疏索引预过滤(RoughCheck)。
- CN → DN(分布式层) :DWS 优化器为每条语句选择三种执行策略之一------下推语句计划 (整条 SQL 发到 DN 执行,最优)、分布式执行计划 (CN 生成计划树下发 DN,多数场景)、发送语句的分布式执行计划(只有基表扫描在 DN 执行,其余回 CN 执行,最差,应当避免)
第三种策略的问题在于:大量中间结果从 DN 拉回 CN,CN 成为带宽、存储、计算的瓶颈,分布式优势完全丧失。
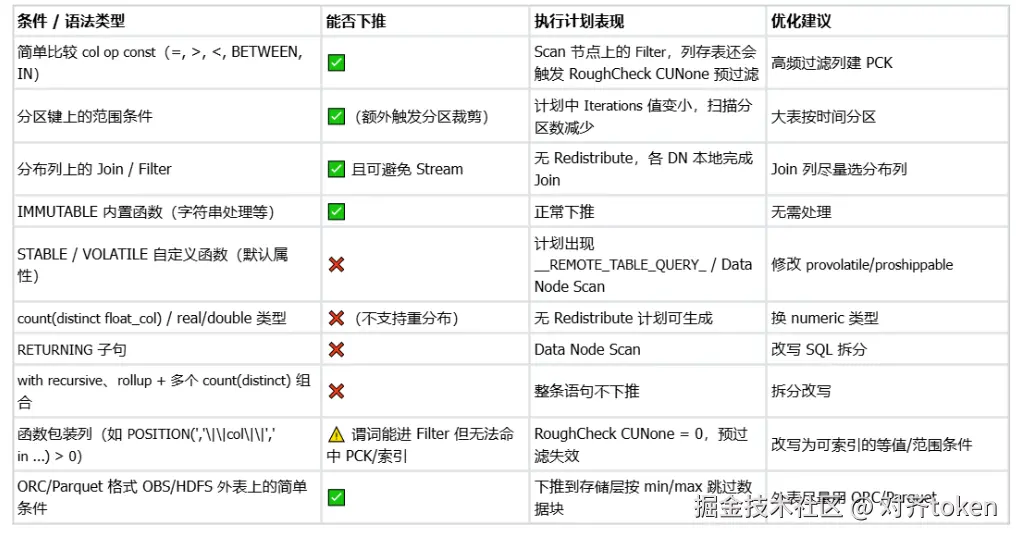
二、各类谓词 / 语法在 DWS 中的下推情况速查
三、排查步骤:三步确认下推是否生效
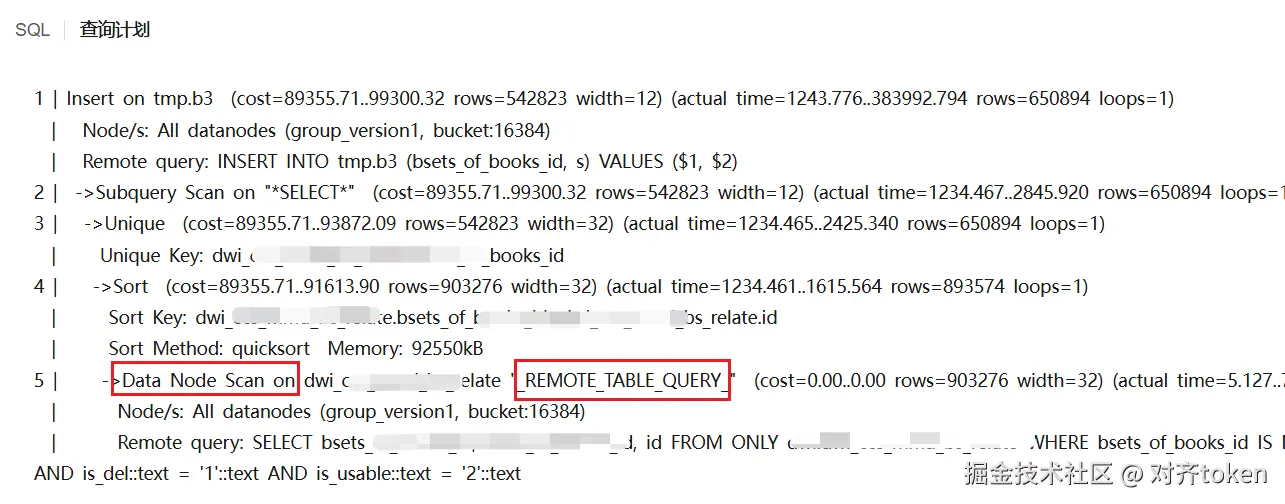
第一步:抓分布式执行计划并关闭 FQS 看真实形态。
vbnet
  SET enable_fast_query_shipping = off;   -- 关闭快速语句下推,看优化器真实选择
  EXPLAIN PERFORMANCE
  SELECT ... FROM t1 JOIN t2 ON ... WHERE ...;
判断标准非常明确:
- 计划中出现
Streaming节点 → 语句可以下推,DN 之间有数据重分布; - 计划中出现
Data Node Scan节点 +REMOTE_TABLE_QUERY字样 → 语句不能下推,数据要拉回 CN。
第二步:用 VERBOSE 看细节。
ini
EXPLAIN VERBOSE SELECT ...;__REMOTE 关键字同样是不下推的标志;CN 的 pg_log($GAUSSLOG)里会打印具体不下推的原因(例如哪个函数、哪段语法阻断),这是最直接的证据。
第三步:分析 DN 内部的扫描效率
在 EXPLAIN PERFORMANCE 输出的 Datanode Information 段:
- 看
RoughCheck的CUNone比例------值越大说明 PCK 稀疏索引预过滤掉的 CU 越多,扫描越高效;接近 0 说明过滤条件没有落到可 min/max 求值的列上; - 看
averCuRow是否过小(< 1 万)------存在小 CU 问题,需要VACUUM FULL收敛; - 看各 DN 扫描行数是否悬殊------数据倾斜信号。
四、DWS 相对 PG 的下推增强能力
- 分区裁剪(Partition Pruning)
优化器根据 WHERE 中的分区键条件自动剔除无关分区,只扫描相关分区;
分区裁剪配合分区表能把扫描时间从"全表"降到"局部",实测从 73ms 降到 40ms、扫描时间从 44ms 降到 13ms 的案例。
- PCK(Partial Cluster Key,局部聚簇)
列存表上一种基于 min/max 稀疏索引的快速过滤技术。
导入时按 PCK 列局部排序,使相邻 CU 的 min/max 聚集在小区间内
查询时通过 RoughCheck 直接跳过整个 CU
建表语法:ALTER TABLE t ADD PARTIAL CLUSTER KEY (col);,一张表只能建一个 PCK,一般不超过 2 列,选 distinct 值较少、出现在 col op const 简单过滤条件中的列。
- OBS/HDFS 外表下推
DWS 通过 HDFS_FDW/DFS_FDW 直接读取 HDFS/OBS 上的 ORC/Parquet 数据(而非远程查询方式),CN 把任务分解下发各 DN,谓词可下推到存储层按数据块 min/max 跳读,并支持与本地表 Join、多 DN 并发读。
- LLVM 动态编译 + 向量化执行
热点函数编译成机器码、按批处理元组,与下推配合在 DN 上把 CPU 效率拉满。
- FQS(Fast Query Shipping)
enable_fast_query_shipping = on(默认)时,简单语句直接整条下发 DN,跳过 CN 的完整计划生成,进一步降低时延。
五、常见"下推失效"场景与改写方案
自定义函数阻断(最常见)。 用户自定义函数在 pg_proc 里默认是 VOLATILE + NOT SHIPPABLE,包含它的整条语句都不下推。处理方法是核对函数真实行为并改属性:
sql
  -- IMMUTABLE 类函数(同输入必同输出,如数值/日期计算):始终可下推
  ALTER FUNCTION my_func(...) IMMUTABLE;
  -- STABLE/VOLATILE 类函数:只有 proshippable = t 才可下推
ALTER FUNCTION my_func(...) STABLE SHIPPABLE;判断规则:provolatile = 'i' 时无论 proshippable 取值都可下推;provolatile 为 s/v 时必须 proshippable = t。若函数内部读复制表且为只读、不涉及事务,可安全设置 shippable;错误设置会引发不可预知错误,需谨慎。
真无法下推时的"部分下推"改写。 把不下推的函数隔离到最外层,让 Join/过滤先在 DN 完成:
vbnet
  -- 原句(整句不下推)
  SELECT unship_func() FROM t1 JOIN t2 ON t1.a = t2.a;
  -- 改写(t1 JOIN t2 下推 DN,仅函数逐行在 CN)
  SELECT unship_func() FROM (SELECT * FROM t1 JOIN t2 ON t1.a = t2.a);
Join 结果集较小时,性能提升明显。
函数包装列使 PCK/索引失效。 例如 POSITION(','||a.ItemNo||',' in ',0835TXWY,') > 0 这种条件,过滤效果虽好但既不能建索引也不能进 PCK,RoughCheck 完全失效;应与业务沟通改写为 ItemNo IN (...) 等可 min/max 求值的等值条件。
类型问题阻断重分布。 real/double 类型列参与 count(distinct ...) 或 Join 时无法生成重分布计划,导致语句不下推;建表时应以 numeric 替代
复杂语法组合。 with recursive、rollup + 多个 count(distinct) 等组合场景不支持整体下推,需拆分改写为多次简单查询。
六、容易踩的认知误区
- "谓词下推 = 建索引" :在 DWS 中索引只是手段之一,且列存大表更推荐 PCK + 分区裁剪;很多场景下先把"整句下推"修好,收益远大于加索引。
- "PG 的下推规则在 DWS 完全适用" :单机层的规则大体适用,但 DWS 还叠加了 CN/DN 可下推性判定(函数 shippable、类型可重分布、复杂语法),一个函数属性错误就能让整条语句退化为 CN 单点执行------这在原生 PG 里根本没有对应概念。
- "执行计划里看到 Filter 就没下推" :不对。
Filter出现在 DN 的 Scan 节点上恰恰是正常的下推;真正的异常信号是Data Node Scan+REMOTE_TABLE_QUERY出现在计划顶层。
七、落地最佳实践 checklist
sql
  -- 1. 收集/更新统计信息(CBO 的前提)
  ANALYZE big_table;
  -- 2. 检查分布列是否合理(避免倾斜 + 让 Join 可本地完成)
  SELECT table_skewness('big_table');
  -- 3. 关闭 FQS 检查真实下推形态
  SET enable_fast_query_shipping = off;
  EXPLAIN VERBOSE SELECT ...;    -- 盯住 Data Node Scan / __REMOTE
  -- 4. 恢复默认并抓完整执行性能
  SET enable_fast_query_shipping = on;
  EXPLAIN PERFORMANCE SELECT ...;  -- 观察 Streaming、RoughCheck CUNone、Datanode Information
  -- 5. 为列存大表的高频简单过滤列加 PCK
  ALTER TABLE big_table ADD PARTIAL CLUSTER KEY (filter_col);
  -- 6. 检查并修正自定义函数的下推属性
  SELECT proname, provolatile, proshippable FROM pg_proc WHERE proname = 'my_func';