一句需求,AI 自己搜资讯、扒配图、画图表、搭页面。这篇把 prompt 模板和每一步的实际动作都摊开,代码可复制。
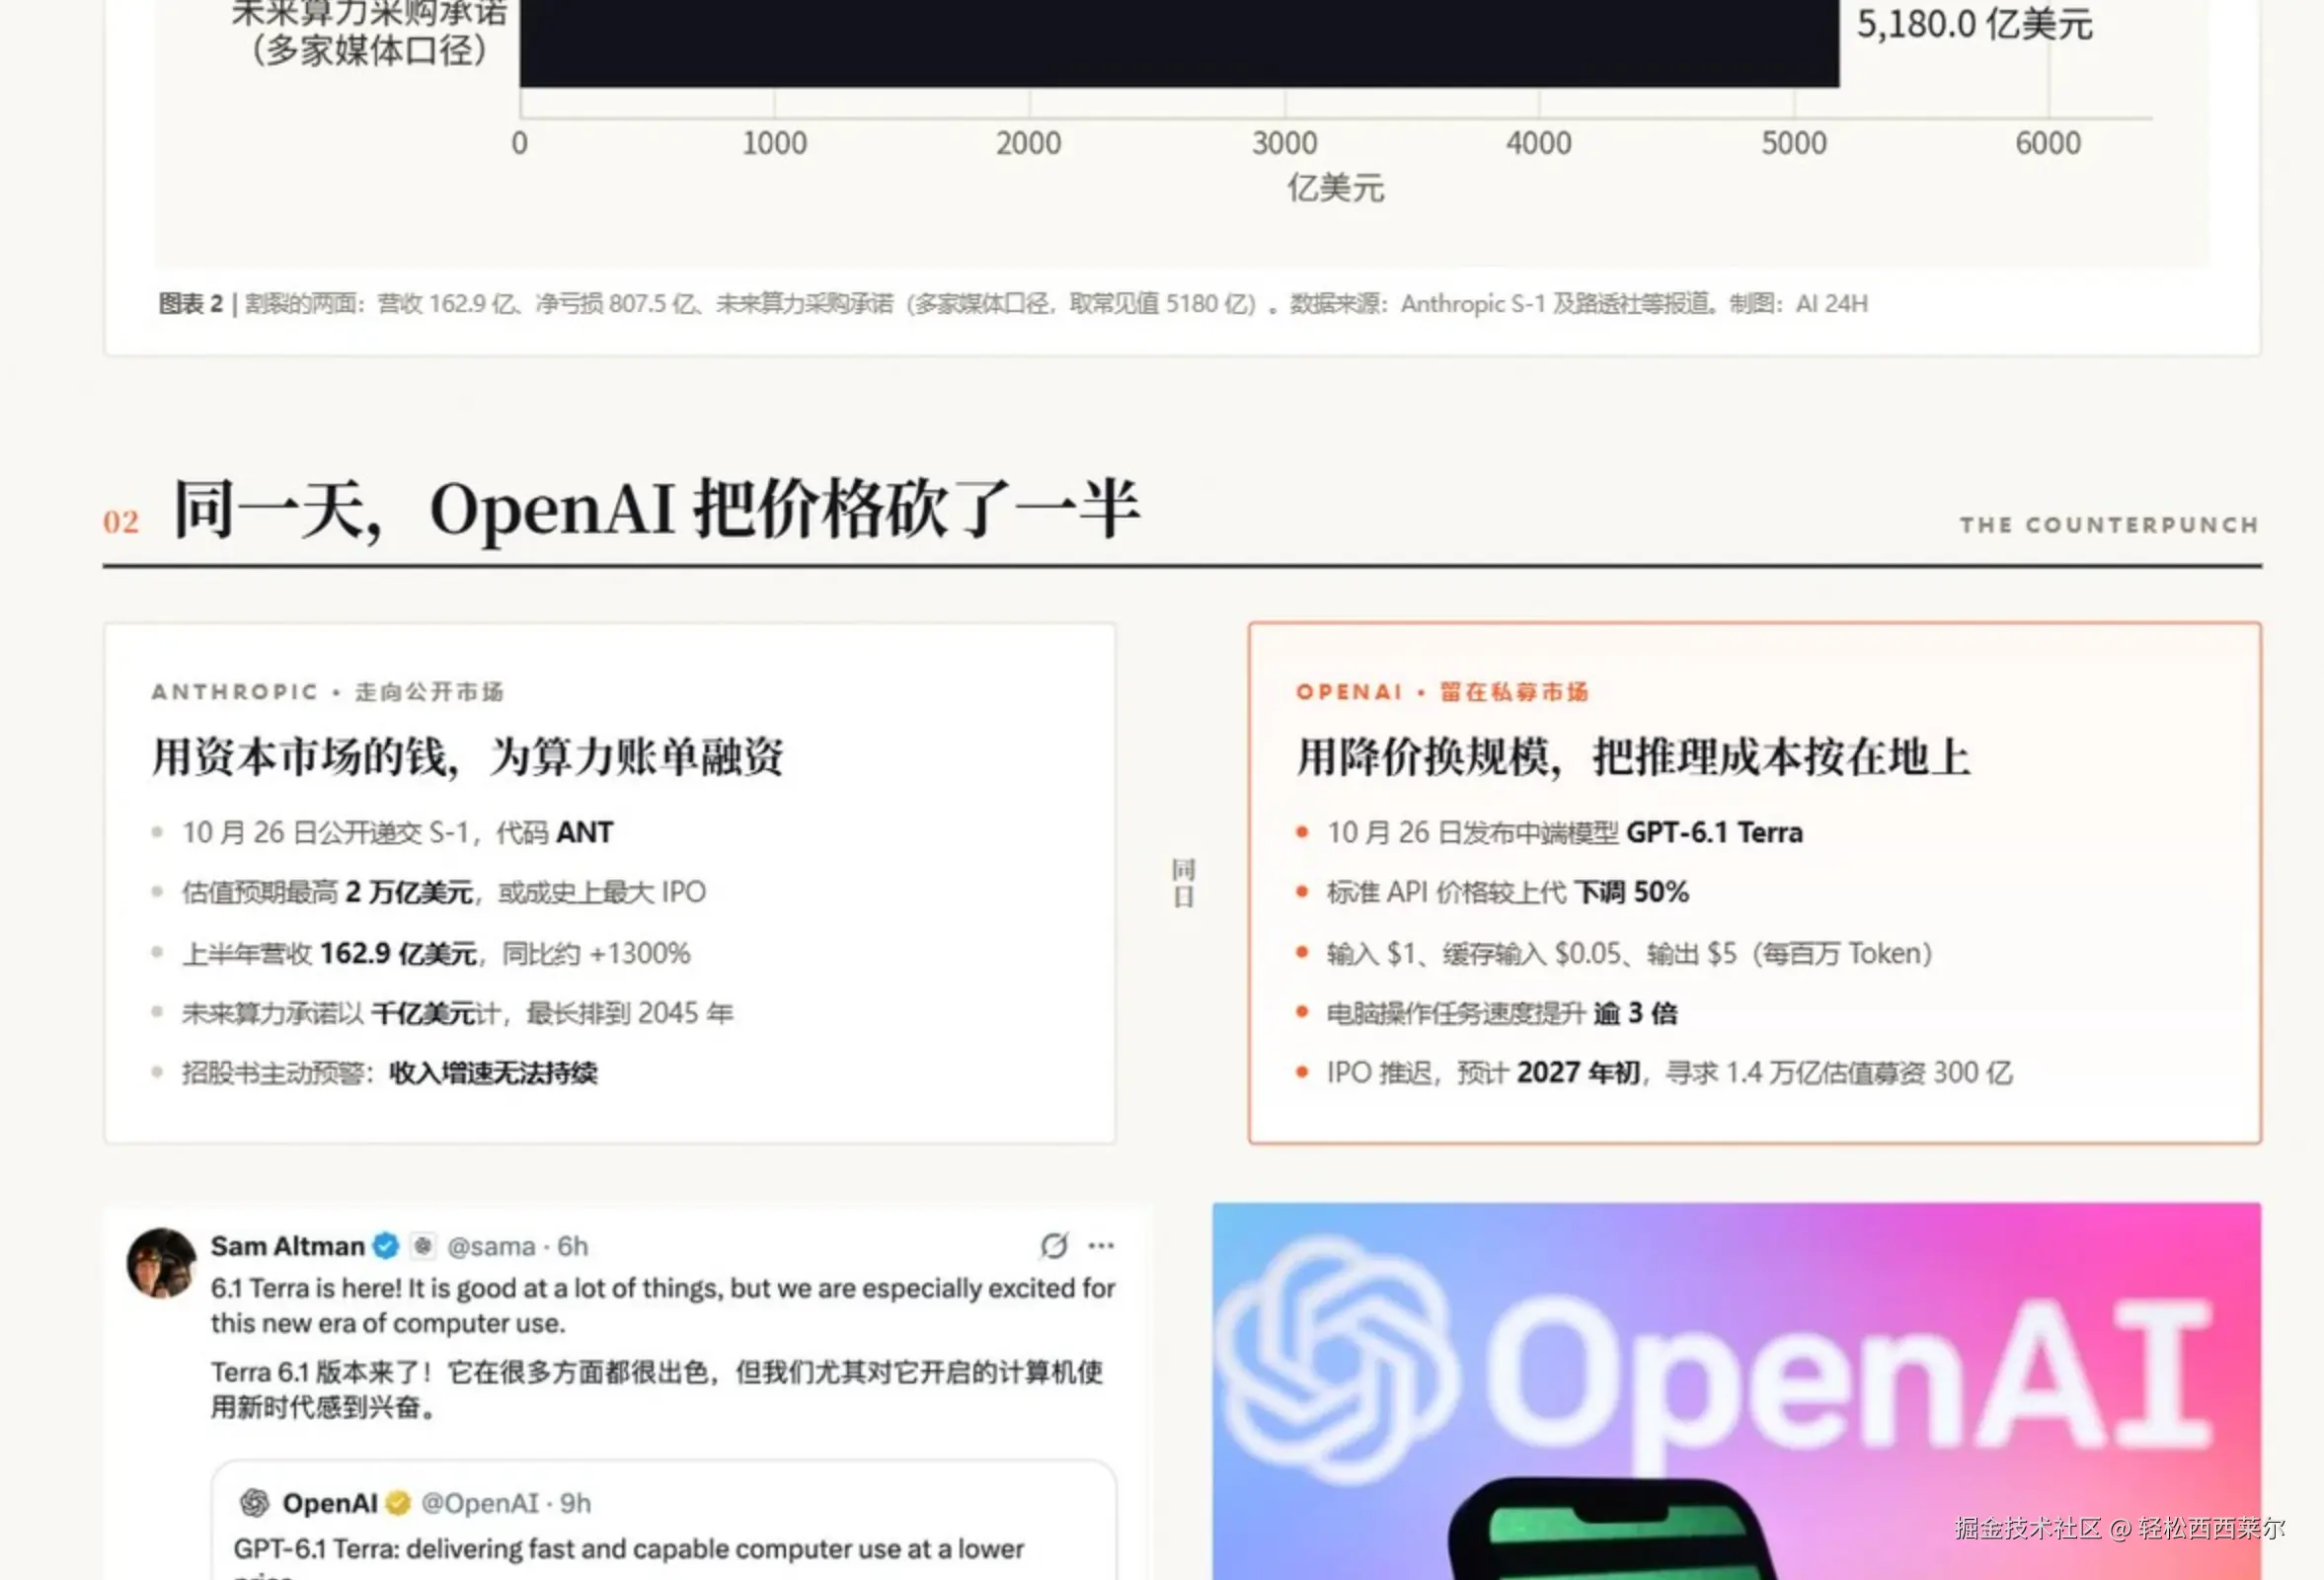
图一:成品效果------左边 Anthropic 走向公开市场,右边 OpenAI 留在私募市场,中间竖排「同日」
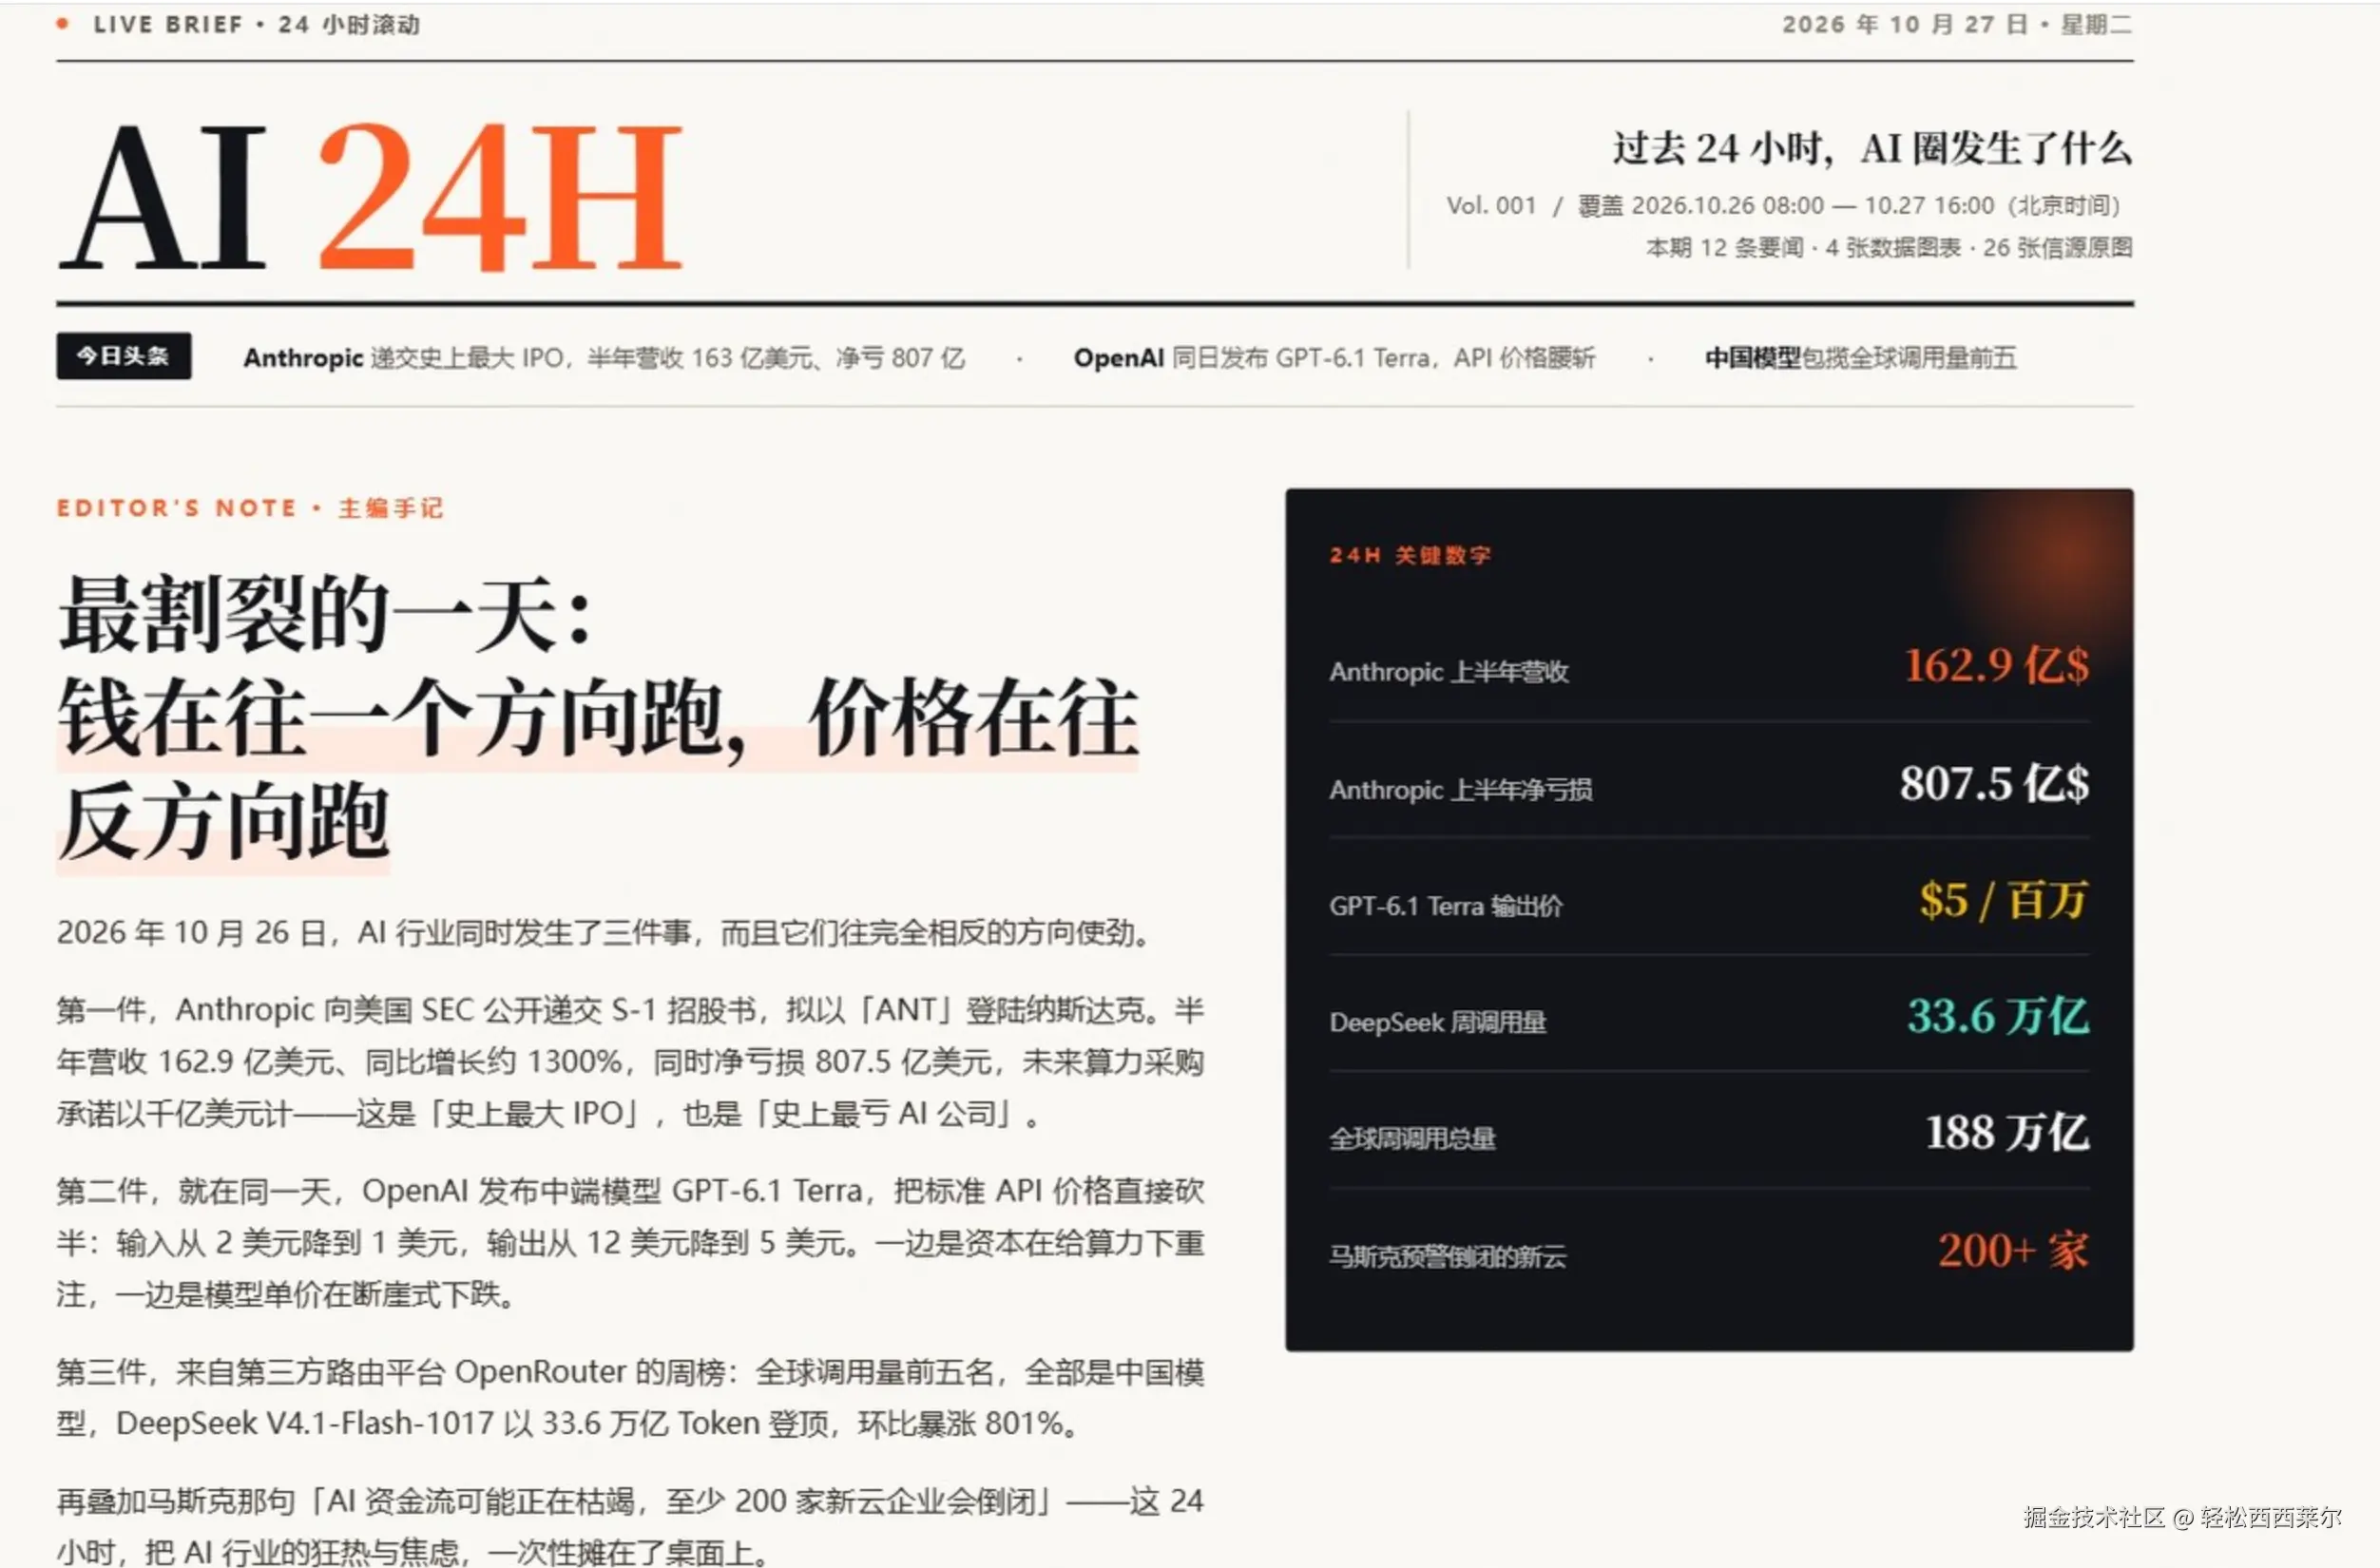
图二:首屏------报头 AI 24H、期号、今日头条横带、主编手记 + 黑底数字卡
一、Prompt 模板
markdown
> 我想让你收集《过去24小时AI圈发生了什么》,做成一个html。
> 要有配图(最好是合法合规地直接用信源原图)、合适的地方要有
> 数据可视化图表。整体要有一种线上科技杂志的感觉,丰富多彩、
> 信息合理准确。
> 【可选补充】
> - 时间范围:[过去24小时 / 指定日期]
> - 重点方向:[大模型 / 算力芯片 / 机器人 / 全都要]
> - 图表数量:[4 张左右]
> - 视觉风格:[米白纸感+墨黑+橙色点缀 / 深色科技风 / 杂志感]
这段 prompt 的关键在三个词:「信源原图」 (不编图,去原文扒)、「数据可视化」 (要图表,不只是文字)、「科技杂志感」(定风格,不是随便排版)。
二、Agent 实际怎么做的
Step 01 · 检索
Agent 没有直接开写,而是先分头搜:中文关键词、英文关键词、算力芯片、国产模型,时间范围全部限定「最近一天」。
实际调了 11 次搜索,命中 Anthropic 递交 S-1、OpenAI 发布 GPT-6.1 Terra、OpenRouter 周榜前五全是中国模型、马斯克警告 200 家新云倒闭、SpaceX 400 亿租 GPU、智元 G2 Max 发布等事件。
Step 02 · 交叉核验
Anthropic 的算力采购承诺,不同媒体写 4170 亿、5180 亿、6500 亿、8000 亿美元。Agent 没有随便挑一个,而是继续翻原文,最后确认招股书写的是「未来最低算力付款义务约 4170 亿美元」,其他是不同统计范围。
处理方式是在成品里标注口径差异,而不是当成一个确定数字。这一步是人给 agent 定的规矩------不许编,只许标。
Step 03 · 抓图
Agent 直接去信源文章里扒原图,不自己生成。带 Referer 和 UA 请求头,绕过部分防盗链。
失败清单:虎嗅、中国证券网、OFweek 返回 403。成功来源:新浪、搜狐、东方财富、36氪、UC、上海证券报。26 张原图统一压成 webp,总计 1.35MB,平均 53KB。
Step 04 · 画图:三个坑
用 Seaborn + Matplotlib 画了四张。坑不少,说三个。
坑一:中文字体。
scss
import matplotlib.font_manager as fm
FONT = "NotoSansSC-Regular.ttf"
fm.fontManager.addfont(FONT)
plt.rcParams["font.family"] = fm.FontProperties(fname=FONT).get_name()
plt.rcParams["axes.unicode_minus"] = False
最后一行容易漏。负号属于独立字符集,不单独设置的话,坐标轴上的负数还是方块。
坑二:模块名冲突。 临时脚本命名成 inspect.py 放项目根目录,matplotlib 导入直接挂了:
javascript
ImportError: cannot import name 'Parameter' from 'inspect'
  (C:...\246\inspect.py)
原因是 Python 模块搜索路径里,当前目录优先级高于标准库。我的 inspect.py 把标准库的 inspect 顶掉了,而 matplotlib 内部依赖它。报错信息其实写清楚了路径,但第一眼看容易以为是 matplotlib 装坏了。常见雷区还有 json.py、random.py、types.py、email.py。
坑三:布局边界。 柱状图 Y 轴上限设 12,最高柱子正好 12,标签被裁一半,改成 16 留白。副标题也有讲究,用 ax.set_title() 加副标题时,如果副标题用 ax.text(transform=ax.transAxes) 定位,很容易和主标题重叠。改用 fig.suptitle() + fig.text() 配合 tight_layout(rect=[0,0,1,0.885]) 更稳。
Step 05 · 搭页面:纯 CSS 实现
没引任何框架,全部原生实现。
纸张肌理用 SVG 噪点滤镜:
css
body::before{
  content:"";position:fixed;inset:0;pointer-events:none;
  background-image:url("data:image/svg+xml,...feTurbulence...");
  mix-blend-mode:multiply;
}
滚动进度条 用 scroll 事件算比例,注意加 {passive:true} 避免阻塞滚动。
入场动画用 IntersectionObserver,比监听 scroll 性能好得多,触发一次就解绑:
ini
const io = new IntersectionObserver((entries) => {
  entries.forEach(e => {
    if (e.isIntersecting) {
      e.target.classList.add('in');
      io.unobserve(e.target);
    }
  });
}, {threshold: 0.08, rootMargin: '0px 0px -40px 0px'});
Step 06 · 自检
Agent 用 JS 检查每张图的 naturalWidth,确认无裂图;切到 390px 视口确认无横向溢出;点击图片确认灯箱正常。
最终结果:16 张图全部加载,移动端无溢出,灯箱正常,4 张图表中文无乱码。
三、最终产出
| 项目 | 数量 / 说明 |
|---|---|
| 要闻 | 12 条,覆盖大模型、算力、机器人、资本 |
| 信源原图 | 14 张,全部标注出处 |
| 自制图表 | 4 张(营收增长、割裂两面、价格对比、调用量 Top9) |
| 页面 | 单文件 HTML,44KB,图片 1.35MB |
| 交互 | 滚动进度条、入场动画、图片灯箱、移动端适配 |
四、写在最后
这次整套流程跑下来,检索、抓图、画图、写页面,中间要反复读写本地文件。我用 AiPy 做的,它默认本地处理,文件不出机器,省去了上传下载的来回,跑批量任务时体感比较明显。像这次要扒几十张图、跑好几轮图表迭代,本地跑省了不少等待。
不过工具只是工具。Agent 干的是体力活------搜、扒、画、搭、验。人干的是判断题------哪个数字要拆开看,哪句话不能说满,哪个结论要加限定。
数据来自公开信源,配图版权归原作者及原媒体所有,仅作新闻报道引用。