用 VS Code 写代码的同学,对左边那个 Git 面板应该很熟,改完文件,鼠标移到文件名上点一下加号,也就是暂存更改,这个文件就挪到了暂存区那一栏。整个过程很快,看上去就像在清单上打了个勾,告诉 Git 这个文件下次提交带上。
命令行里的 git add 也是同一个动作。所以不少人觉得 add 就是做个标记,真正把文件存进仓库,得等到 git commit。
那这个说法对吗?好在 Git 把所有东西都放在项目根目录下一个叫 .git 的隐藏目录里,这一篇我们就打开它看看。
先建一个空仓库
后面的实验基于 Git 2.56.0 ,可以先用 git --version 确认,版本不同的话个别输出会对不上。后续操作的实验都在 demo-notes 这个仓库里做,我们先把它建出来:
bash
mkdir -p ~/projects-personal
cd ~/projects-personal
git init -b main demo-notes
cd demo-notes
-b main 是显式指定初始分支叫 main,没配置过 init.defaultBranch 的话,Git 2.56 默认叫 master,统一成 main 免得你我的输出对不上。
git init 跑完会告诉你它在哪里初始化了仓库。想从头再来的话,先 rm -rf ~/projects-personal/demo-notes 再跑,不然 git init 只会重新初始化已有仓库。
注意它报出的位置是 demo-notes/.git/,而不是 demo-notes/。也就是说,.git 才是仓库 ,demo-notes 下面那些你天天编辑的文件叫工作区(working tree),也就是从仓库里检出到磁盘、你能直接改的那一份。
仓库建好后,再给它单独配一个演示用的名字和邮箱:
bash
git config user.name "demo"
git config user.email "demo@example.com"
不加 --global 就只对这个仓库生效,不动你的全局配置,以后提交的作者一栏都记成 demo。
空仓库的 .git 里有什么
现在工作区里一个文件都没有,那 .git 里呢?我们用 find 把它整个列出来:
bash
find .git
text
.git
.git/config
.git/objects
.git/objects/pack
.git/objects/info
.git/HEAD
.git/info
.git/info/exclude
.git/description
.git/hooks
.git/hooks/commit-msg.sample
.git/hooks/pre-rebase.sample
.git/hooks/sendemail-validate.sample
.git/hooks/pre-commit.sample
.git/hooks/applypatch-msg.sample
.git/hooks/fsmonitor-watchman.sample
.git/hooks/pre-receive.sample
.git/hooks/prepare-commit-msg.sample
.git/hooks/post-update.sample
.git/hooks/pre-merge-commit.sample
.git/hooks/pre-applypatch.sample
.git/hooks/pre-push.sample
.git/hooks/update.sample
.git/hooks/push-to-checkout.sample
.git/refs
.git/refs/heads
.git/refs/tags
find 的输出顺序取决于文件系统,你那边可能不同,但内容是一样的。
可以看到,一个空的仓库里面就已经有二十多个文件和目录了。我不打算一个个讲,像 description、info/exclude 这些对理解原理没什么帮助,我们只挑几个重点讲。
核心是 objects/、refs/ 和 HEAD 这三样,拿写代码的思路去想比较好懂。objects/ 像一张只能往里加的哈希表,key 是按内容算出来的编号,value 是内容本身。refs/ 里的每个引用像一个变量,比如 main,里面存着哈希表的某个 key。HEAD 也是个变量,存的却是另一个变量的名字,相当于指针的指针。
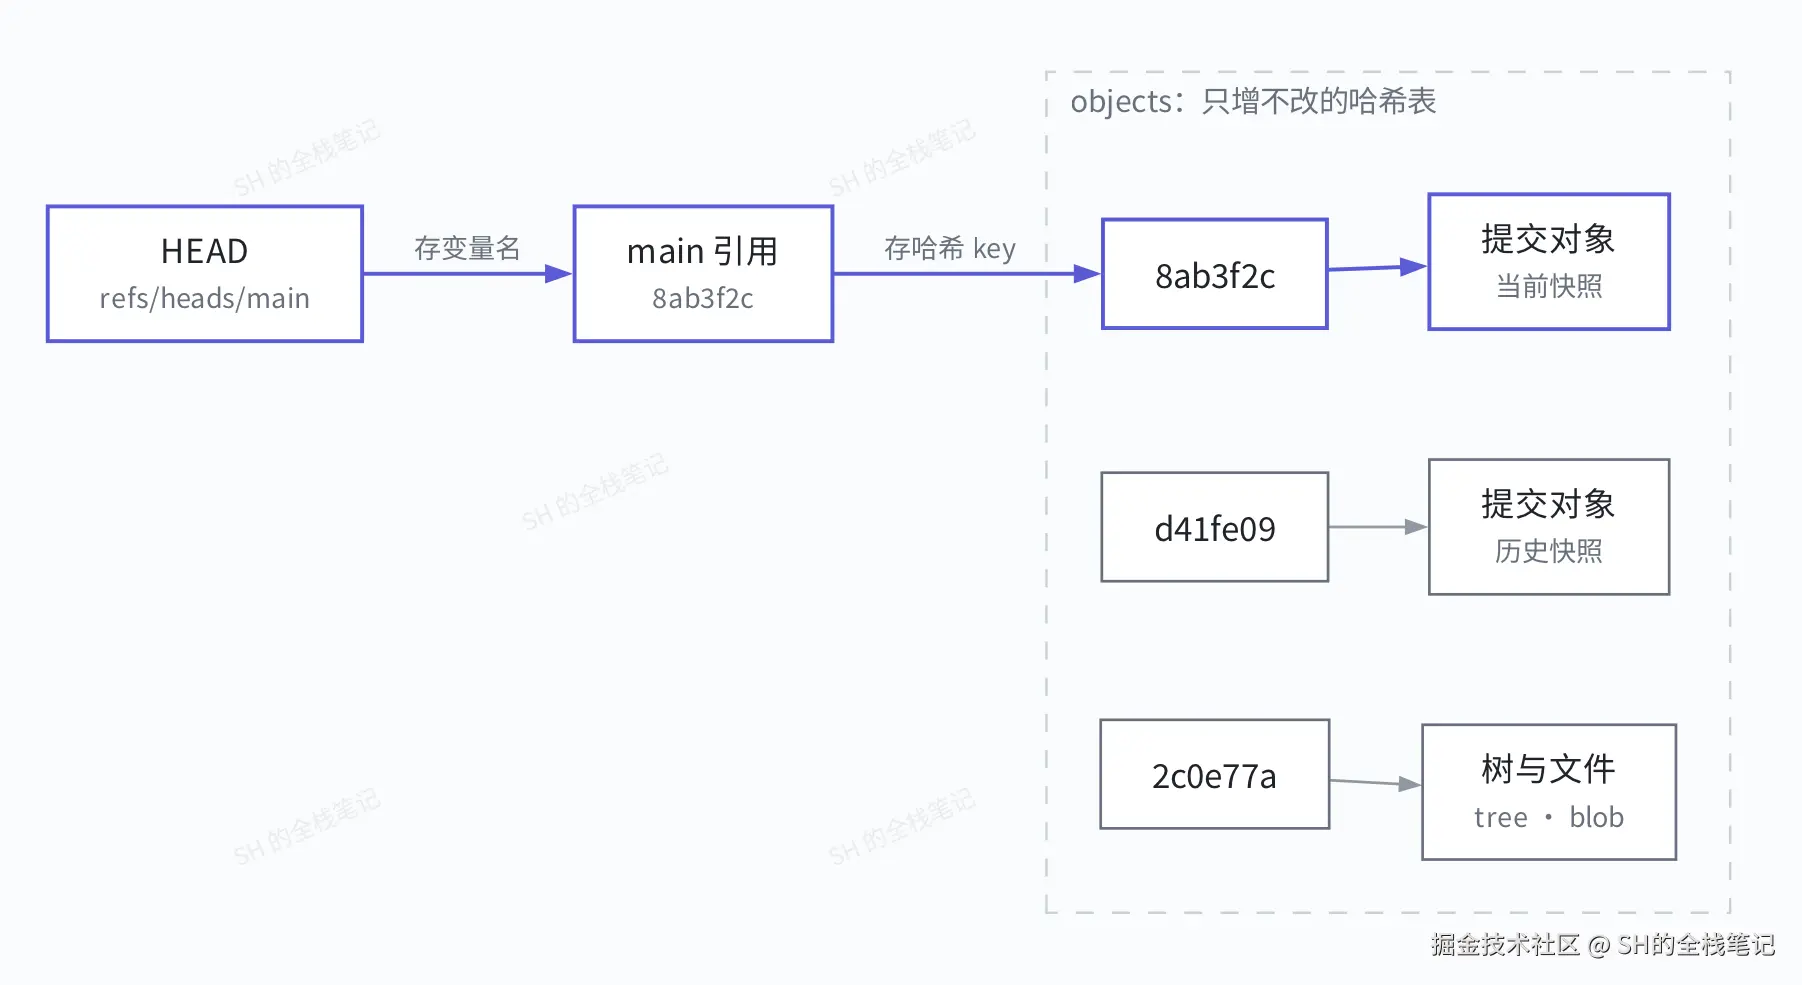
挨个说一下:
objects/(装数据):对象库 。Git 存的所有内容最后都会存在这里,每一条记录叫一个对象(object),类型只有 blob、tree、commit、tag 四种。现在它下面只有两个空目录,pack是以后把大量对象打包存放的地方,这一篇用不到。refs/(装数据):存引用 (ref)的地方。引用就是一个名字,指向某个对象。refs/heads/用来放分支,refs/tags/放标签,现在两个目录都是空的。HEAD(记录状态):记录你现在在哪个分支上。config(配置):这个仓库自己的配置文件,平时git config不加--global写进去的配置就存在这里。hooks/(配置):hook 是 Git 在特定时刻(比如提交前、推送前)自动调用的用户脚本。git init往这里放了一堆例子,全都带着.sample后缀,默认一个都不生效,你要启用的话就把对应文件的后缀去掉就行。
顺手看一眼 config 的内容:
bash
cat .git/config
text
[core]
	repositoryformatversion = 0
	filemode = true
	bare = false
	logallrefupdates = true
	ignorecase = true
	precomposeunicode = true
[user]
	name = demo
	email = demo@example.com
最后的 [user] 是刚才配的名字和邮箱,[core] 里则有几行和平台有关:filemode、ignorecase 是 git init 探测当前文件系统后自动写上的,比如我的 Mac 文件系统默认不区分大小写,所以 ignorecase = true。precomposeunicode 则只有 macOS 上的 Git 才会用到。
把这几样按用途归一下类,用图来表示大概就是这样:
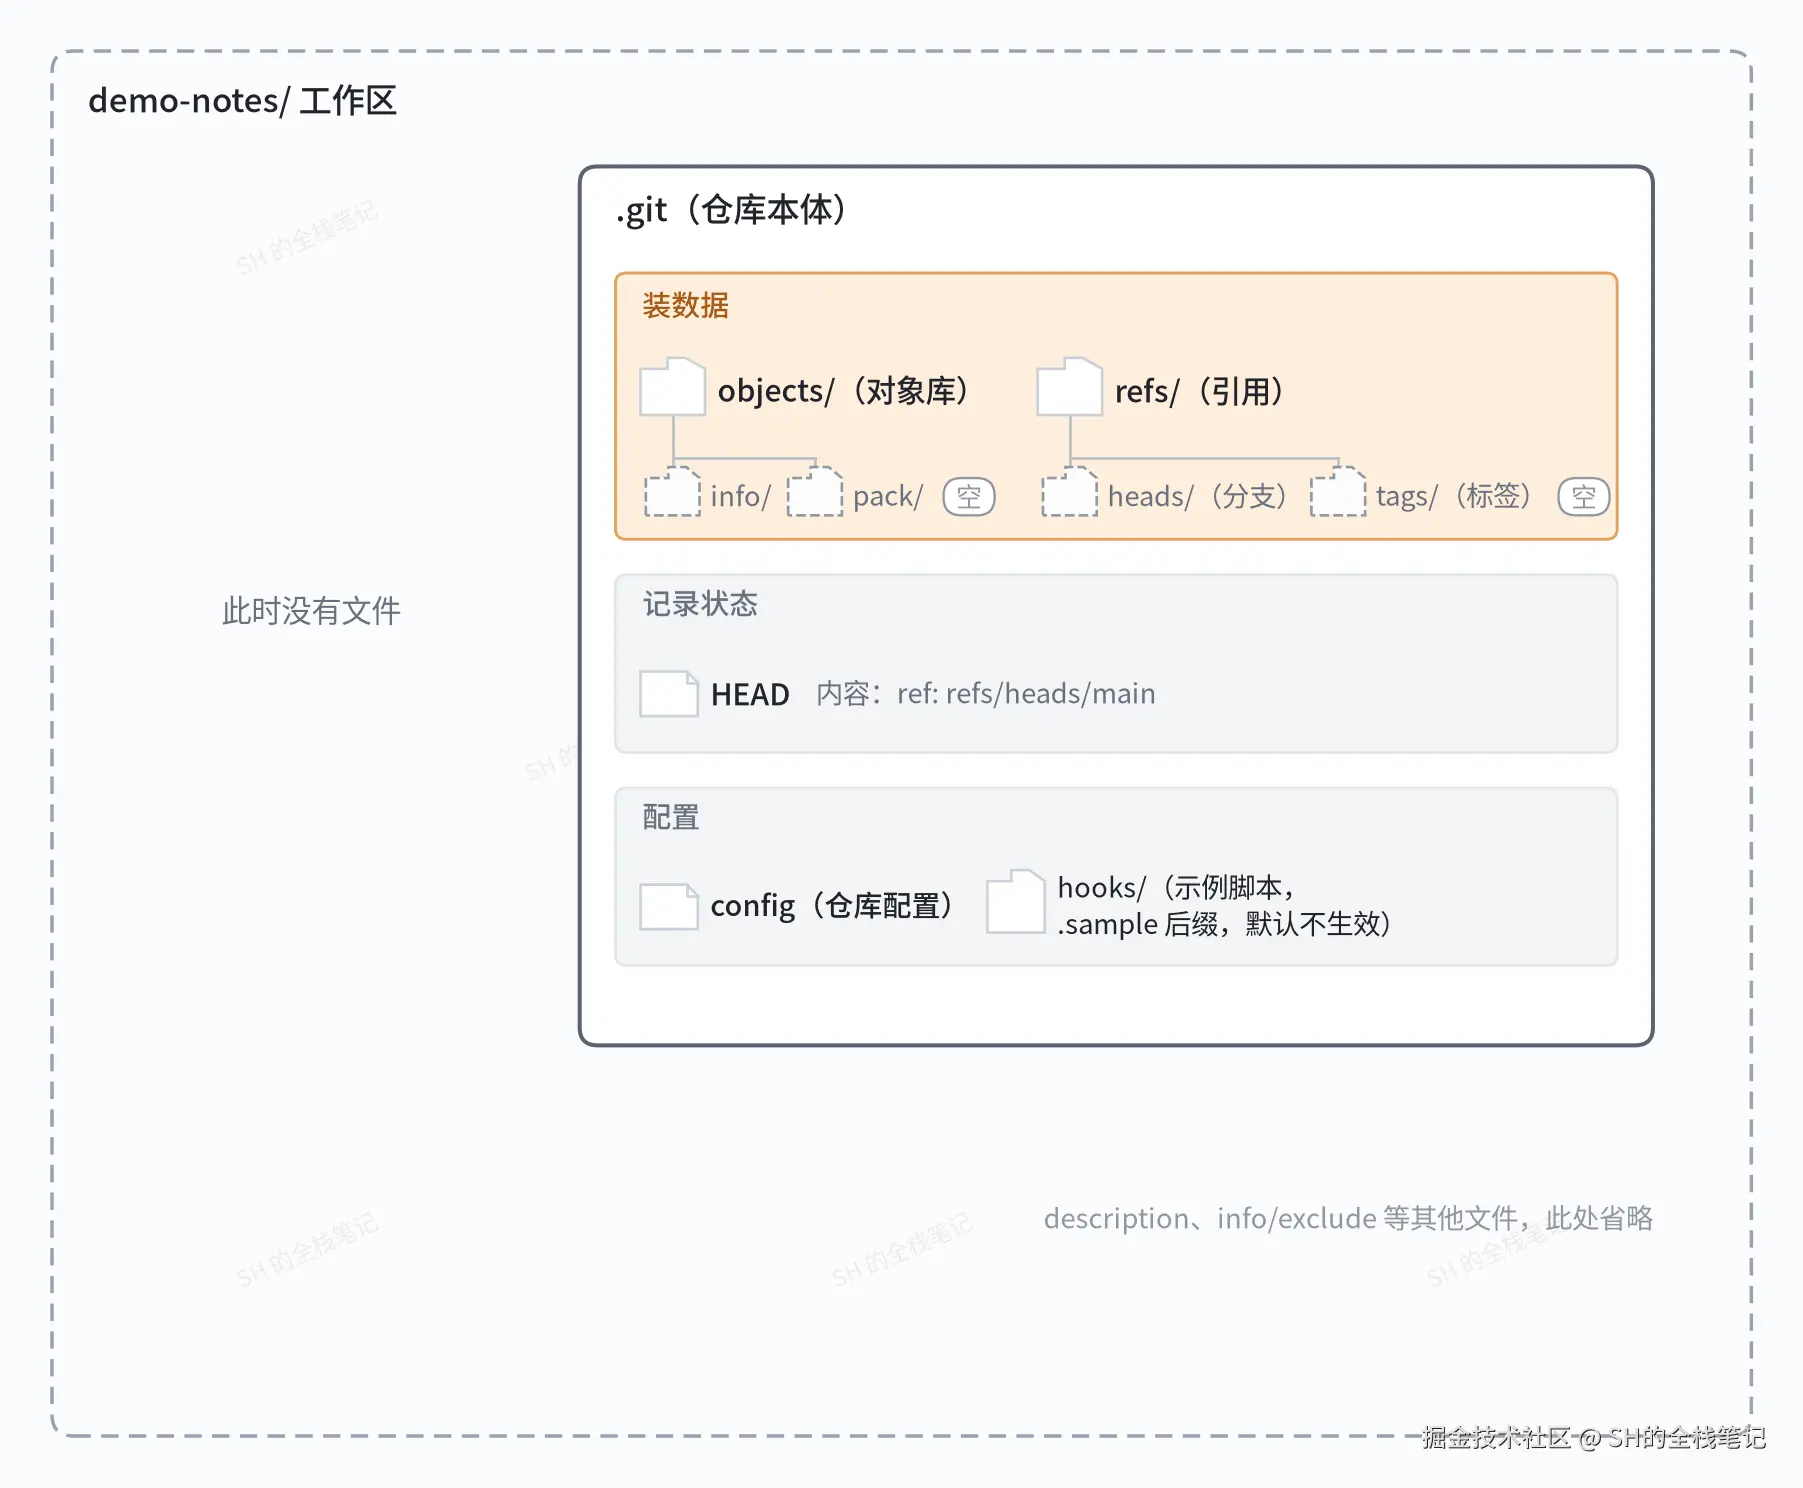
可以看到,装数据那一格里两个目录都是空的,没有对象,也没有引用。那 HEAD 里写着的 main 是从哪来的?
分支名有了,分支文件却没有
我们看看 HEAD 里到底写了什么:
bash
cat .git/HEAD
text
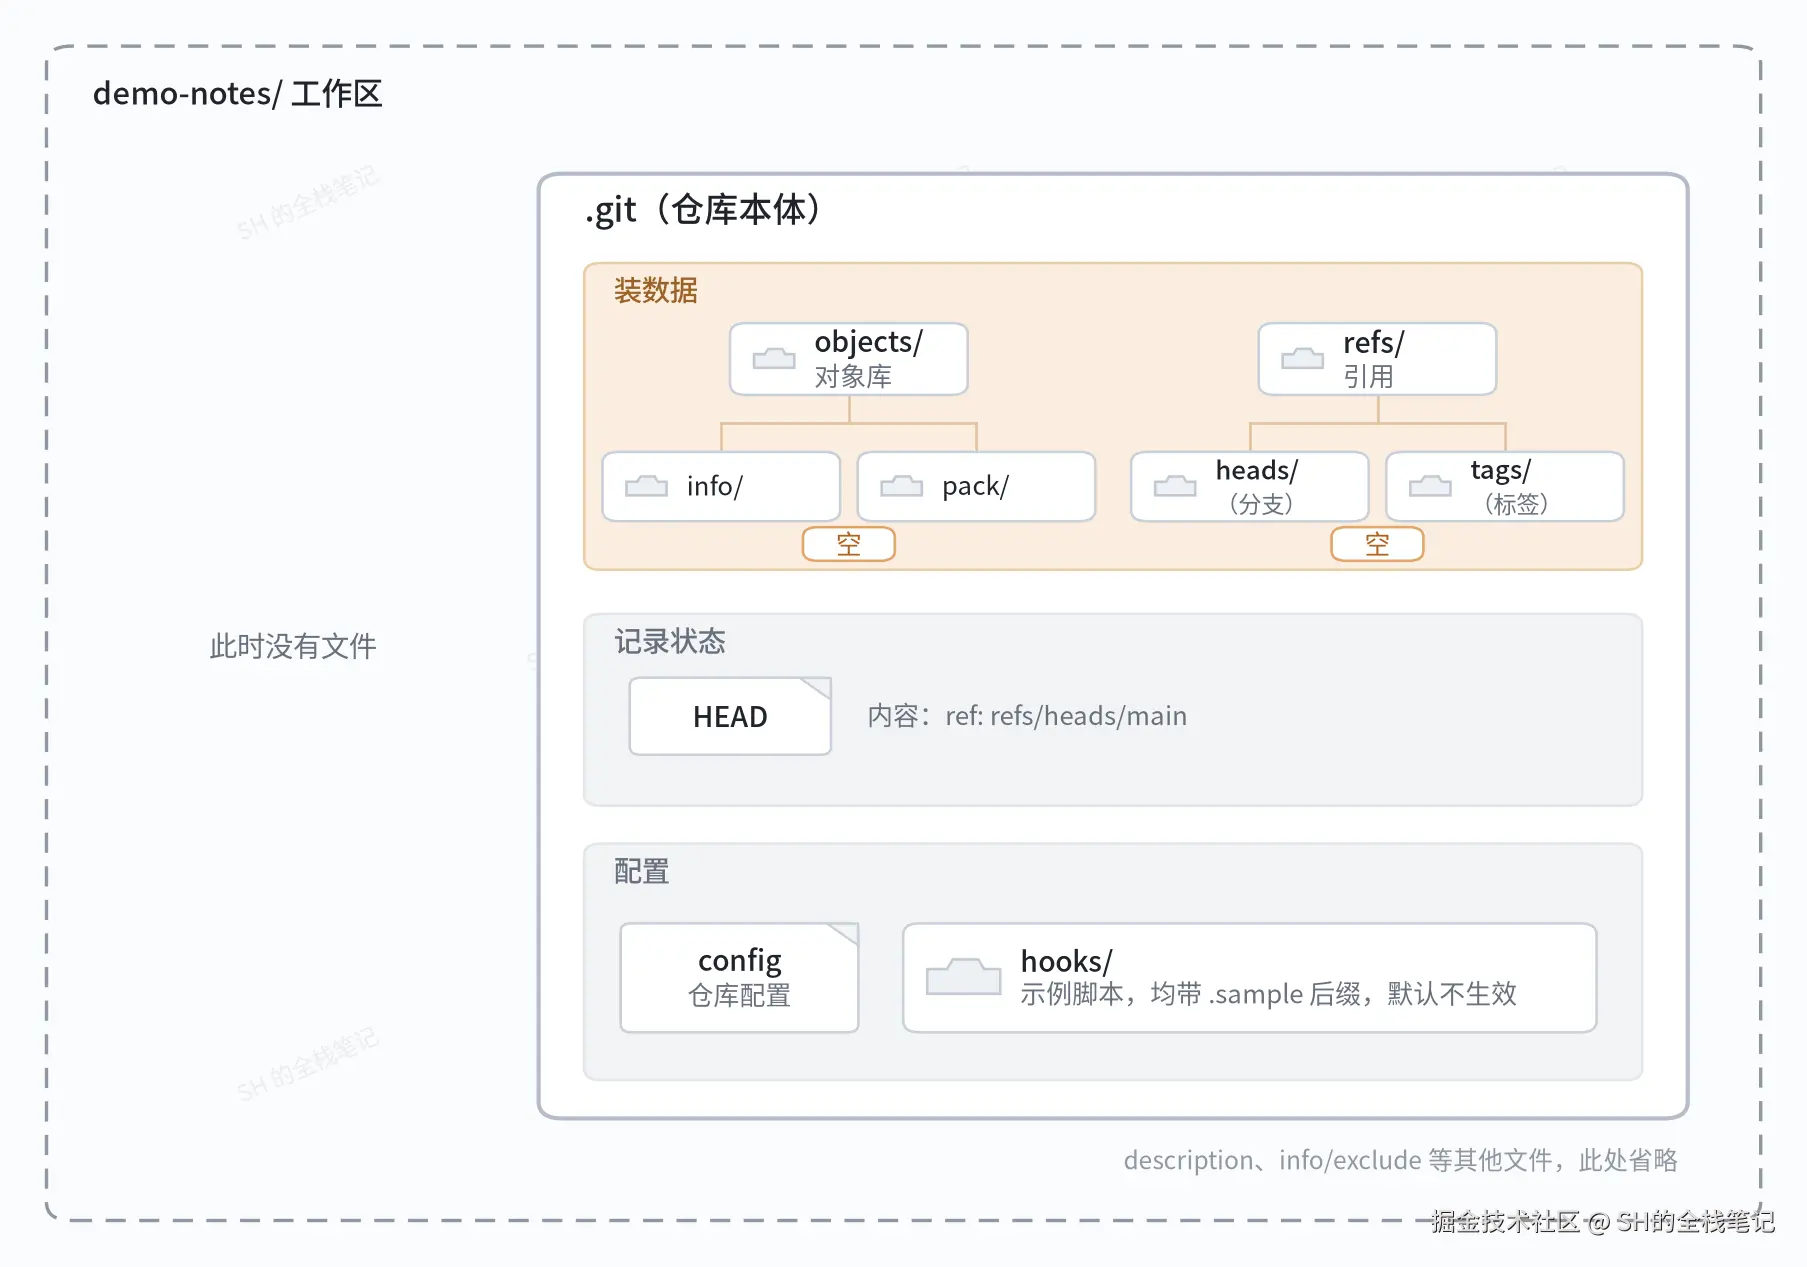
ref: refs/heads/mainHEAD 里只有一行 ref: refs/heads/main,意思是当前分支请去看 refs/heads/main 这个引用。像这样内容是另一个引用名字的引用,叫符号引用 (symbolic ref)。换成变量的说法,HEAD 里存的是 main 这个变量名,要拿到真正的 key,还得再去读 main 这个变量的值。
那我们就去读 main。执行 ls .git/refs/heads,什么都没输出,refs/heads/ 是空的,main 这个引用根本不存在。
这时候如果问 Git 当前提交是哪个,它会怎么回答呢?git rev-parse 干的就是把名字翻译成对象名,我们让它翻译一下 HEAD:
bash
git rev-parse HEAD
text
fatal: ambiguous argument 'HEAD': unknown revision or path not in the working tree.
Use '--' to separate paths from revisions, like this:
'git <command> [<revision>...] -- [<file>...]'
HEAD
好家伙,一个仓库连自己的 HEAD 是谁都说不上来,还直接报了 fatal 错误。报错里说的 revision 指的就是提交,Git 顺着 HEAD 找到 refs/heads/main,发现这个文件不存在,自然也就定位不到任何提交。最后单独一行的 HEAD 是 rev-parse 把没认出来的参数原样吐了回来,不用管它。
那有同学可能有疑问了:"HEAD 指向一个不存在的东西,这仓库是不是坏了?"
当然是没坏的。
HEAD 指向的分支还不存在是正常的 。git init 本来就会创建一个还没有任何提交的初始分支,名字先定好写进 HEAD。可分支总得指向一个提交,现在一个提交都没有,分支文件里也就没东西可写。等第一次 git commit 以后,refs/heads/main 才会出现。
把这条从 HEAD 出发的链画出来,就能看清它断在哪:
还有个地方要注意,这个时候 .git 里还没有 index 这个文件,前面 find 的输出里找不到它。index 就是大家常说的暂存区,别急,它马上就会出现。
git add 之后多了哪两个文件
现在往工作区里写一个文件:
bash
echo 'hello git' > note.txt先别急着 add,我们来猜一下,按 add 只是打个勾的思路来说,.git 里应该多出什么?大概只会多一份记着 note.txt 已勾选的小文件吧。
眼见为实,我们在 add 前后各用 find .git -type f | sort 列一遍 .git 里的所有文件,前一份存进变量 before,再用 comm -13 只打印后一份有、前一份没有的行:
bash
before=$(find .git -type f | sort)
git add note.txt
comm -13 <(echo "$before") <(find .git -type f | sort)
<(...) 把命令的输出当成文件交给 comm,bash 和 zsh 都支持。输出是:
text
.git/index
.git/objects/8d/0e41234f24b6da002d962a26c2495ea16a425f不多不少,正好两个文件。index 出现了,这在意料之中,可对象库里也多了一个文件。commit 都还没敲,说好的只是打个勾呢?
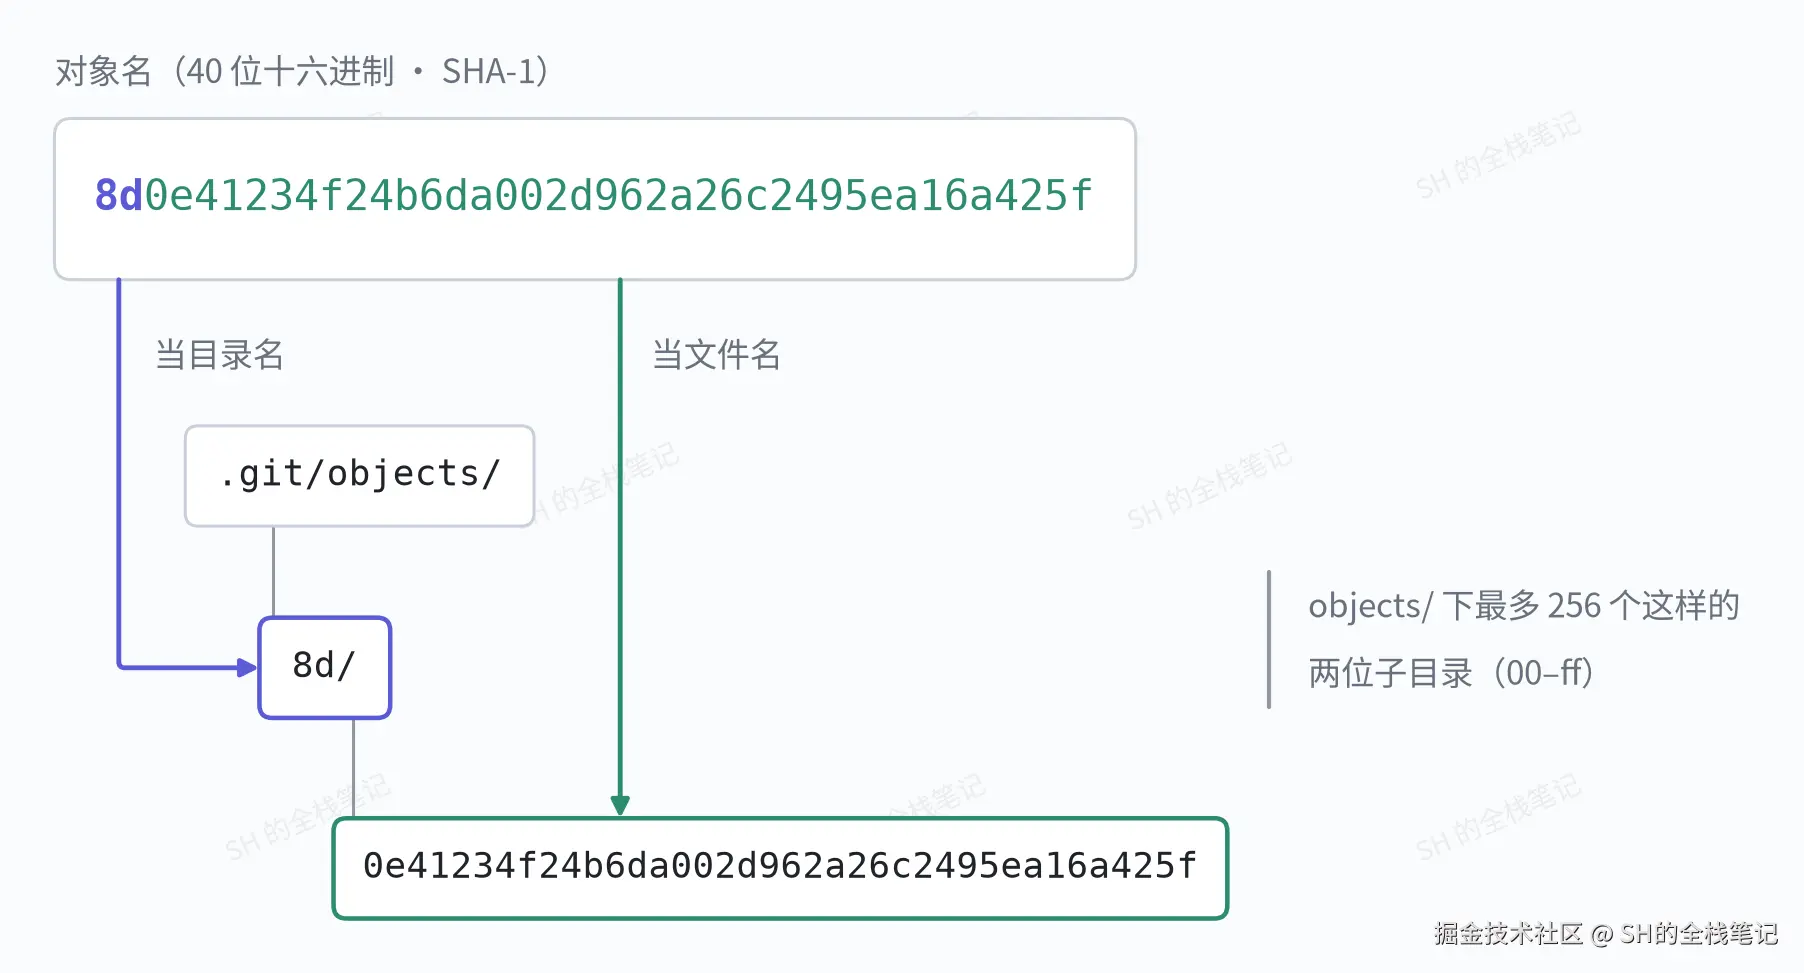
先看这个文件的路径,它有点特别:目录名 8d 是一串 40 位十六进制字符的前 2 位 ,文件名是剩下的 38 位,拼起来的 8d0e41234f24b6da002d962a26c2495ea16a425f 就是这个对象的对象名。
Git 这样拆是为了分片 。所有对象都塞进 objects/ 一个目录的话,对象一多,单个目录里的文件数会大到难以管理;按前两位分开,就最多分成 256 个子目录,像这样:
那文件里装的是什么?直接 cat 只会得到一屏乱码,我们换 xxd 按字节看:
bash
xxd .git/objects/8d/0e41234f24b6da002d962a26c2495ea16a425f
text
00000000: 7801 4bca c94f 5230 3460 c848 cdc9 c957  x.K..OR04`.H...W
00000010: 48cf 2ce1 0200 3641 05a3                 H.,...6A..
右边那栏是把字节当字符显示的结果,完全看不出 hello git。这也谈不上加密,Git 只是把对象用 zlib(一种无损压缩算法,和 zip 是一类东西)压缩以后才写进文件。
想读懂它,用 Git 自己的工具就行。git cat-file -t 会告诉我们对象的类型,-p 会把内容解压后打印出来:
bash
git cat-file -t 8d0e41234f24b6da002d962a26c2495ea16a425f
git cat-file -p 8d0e41234f24b6da002d962a26c2495ea16a425f
两条命令依次输出:
text
blob
hello git
类型是 blob ,内容就是我们刚写进 note.txt 的 hello git。blob 是专门存一个文件内容的对象,注意它只存内容,不存文件名 ,上面的输出里找不到 note.txt 这几个字。
也就是说,add 的那一刻,文件内容就已经压缩成 blob 进了对象库。add 只是打勾、commit 才存东西这个说法并不成立。把 add 前后对比着画出来:
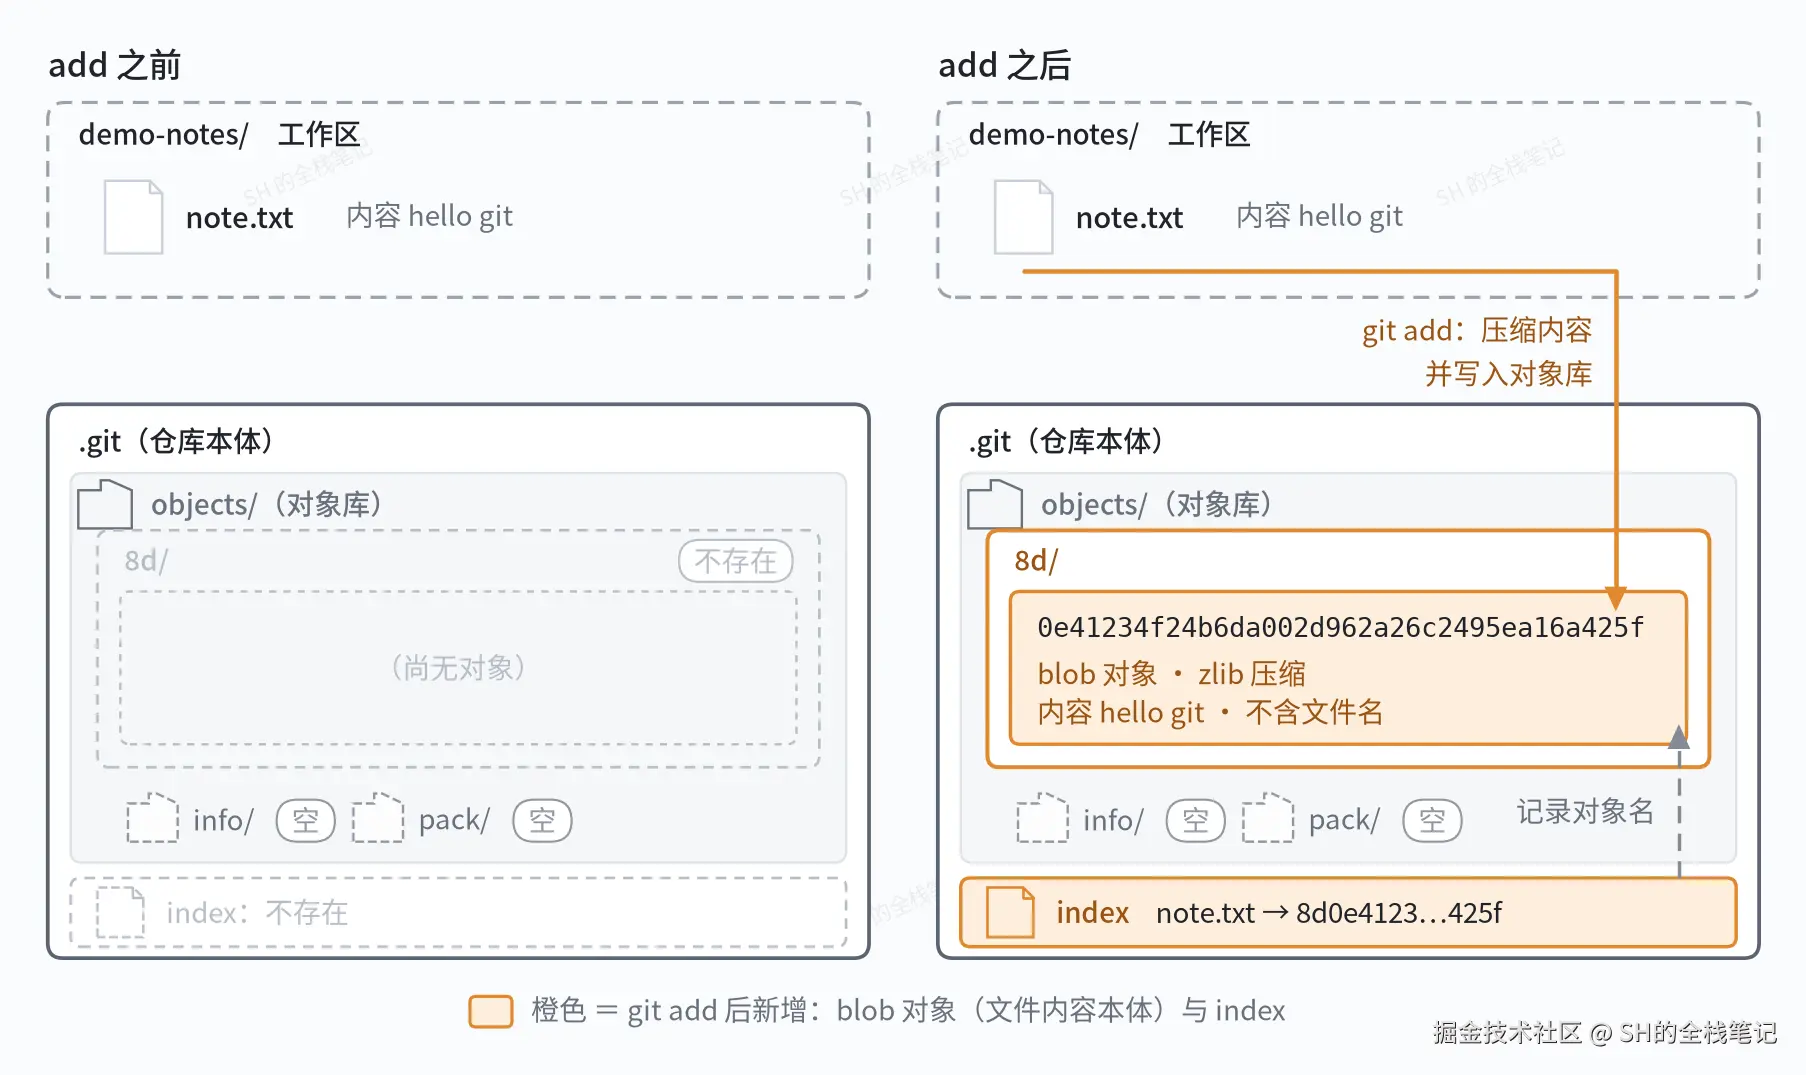
换成哈希表的说法,add 就是往对象库里插了一条记录,key 由内容算出来,就是这串 8d0e4123...。
这串 key 就是内容的哈希值 ,哈希函数能把任意内容变成固定长度的一串字符,同样的输入一定得到同样的结果,差一个字节结果就完全不同。所以你在自己电脑上跑同样的命令,对象名也会是 8d0e4123...,一个都不差。
index:一张不放内容的清单
blob 弄清楚了,那另一个新文件 index 呢?它是二进制格式,Git 提供了 git ls-files --stage 把它按行打印出来:
bash
git ls-files --stage
text
100644 8d0e41234f24b6da002d962a26c2495ea16a425f 0 note.txt我们从左往右看:
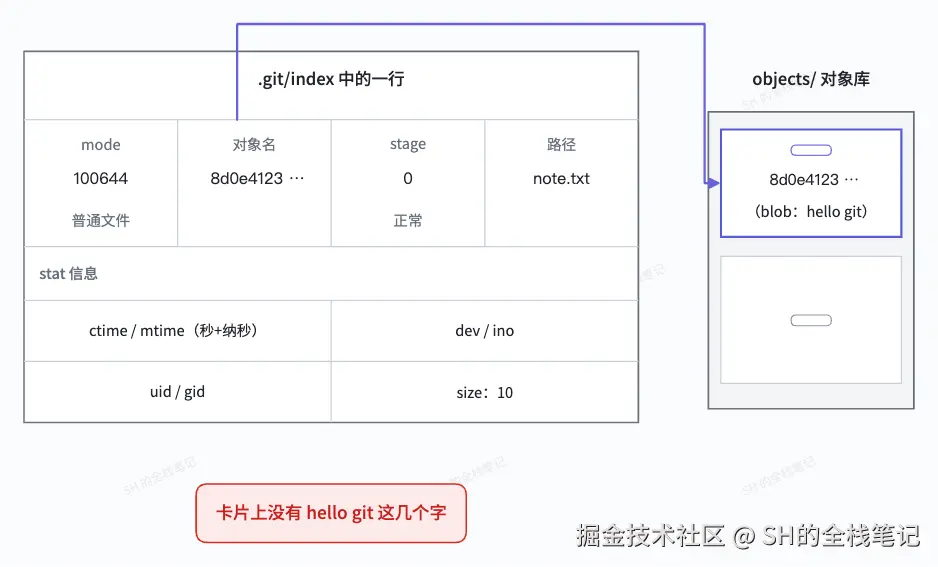
100644:mode,表示这是一个普通的、不可执行的文件。8d0e4123...:对象名,正是刚才写进对象库的那个 blob。0:stage 编号,正常情况下都是 0。note.txt:路径。
看到这你可能会问,既然叫暂存区,这个文件里总该暂存了一份 hello git 吧?我们可以直接在 index 文件里搜。grep -a 让 grep 把二进制文件当文本处理,-c 只输出匹配的行数:
bash
grep -a -c 'hello git' .git/index
grep -a -c 'note.txt' .git/index
两条命令依次输出:
text
0
1
可以看到只找到了 note.txt,也就是说,index 里没有文件内容 ,它只记这个路径对应对象库里哪个 blob。暂存区这个名字很容易让人以为里面存了一份副本,其实它更像一张清单,上面写着 note.txt 对应 8d0e4123 这个对象,内容本身则一个字都没存。
不过也别以为它只有路径和对象名。加上 --debug 再看一次:
bash
git ls-files --stage --debug
text
100644 8d0e41234f24b6da002d962a26c2495ea16a425f 0	note.txt
  ctime: 1793012999:476151015
  mtime: 1793012999:476151015
  dev: 16777232	ino: 259985183
  uid: 501	gid: 20
  size: 10	flags: 0
每个条目下面还挂着一串文件的状态信息,这些数字每台机器都不一样:
ctime、mtime:分别代表文件元数据最后一次变化的时间和内容最后一次修改的时间,都是秒加纳秒。dev、ino:文件所在的设备号和 inode 号。uid、gid:文件是谁的。size:文件大小,hello git加上 echo 带的换行正好 10 个字节。
这些信息统称为 stat 信息 ,因为它们是操作系统 stat 一类调用返回的文件元数据。Git 把它们记在 index 里,是给 git status 用的,拿当前文件的 stat 和这里一比,就能先筛出哪些文件可能改过,不用把每个文件都读一遍。index 里的一行画出来是这样:
删掉文件,从对象库取回来
add 时内容就进了对象库,听起来像个冷知识,有什么用呢?
比如你把改好的 note.txt add 了,然后让 Agent 接着干活,结果它一顿操作把这个文件删了,或者用别的内容覆盖了。这份你 add 过的内容还能找回来吗?
我们来模拟一下,直接删掉工作区的文件,看看 git status 怎么说:
bash
rm note.txt
git status
text
On branch main

No commits yet

Changes to be committed:
  (use "git rm --cached <file>..." to unstage)
	new file:   note.txt

Changes not staged for commit:
  (use "git add/rm <file>..." to update what will be committed)
  (use "git restore <file>..." to discard changes in working directory)
	deleted:    note.txt
上半部分 Changes to be committed 是拿 index 和当前提交比,由于当前还没有任何提交,所以 index 里的 note.txt 算新文件(new file)。
下半部分 Changes not staged for commit 是拿工作区 和 index 比,工作区里的文件没了,所以是删除(deleted)。可见 index 和工作区是两样独立的东西,删的只是工作区里的文件,index 和对象库都没动。
既然 index 那一行还在,对象名我们也知道,那就顺着它去对象库把内容取出来:
bash
git cat-file -p 8d0e4123 > note.txt
cat note.txt
text
hello git对象名不用写全 40 位,写个开头就行,只要仓库里没有别的对象也以这几位开头。可以看到文件又恢复了,内容一字不差。
这里有个前提,仓库没配会在 add 时改写内容的过滤器。Git LFS 就是这类东西,它专门管大文件,配了以后 add 写进对象库的是一个记录大文件位置的小指针文件,从 blob 里取回的也只是这个指针。
日常也没人这么手工去取。还记得 git status 上面输出里那句 use "git restore <file>..." to discard changes in working directory 吗?意思是我们可以用 git restore 丢弃工作区的改动。
git restore 命令默认就是从 index 恢复工作区的文件,它做的事和我们刚才手工做的一样,查 index 里这个路径对应的对象名,从对象库取出内容,写回工作区。整个过程是这样的:
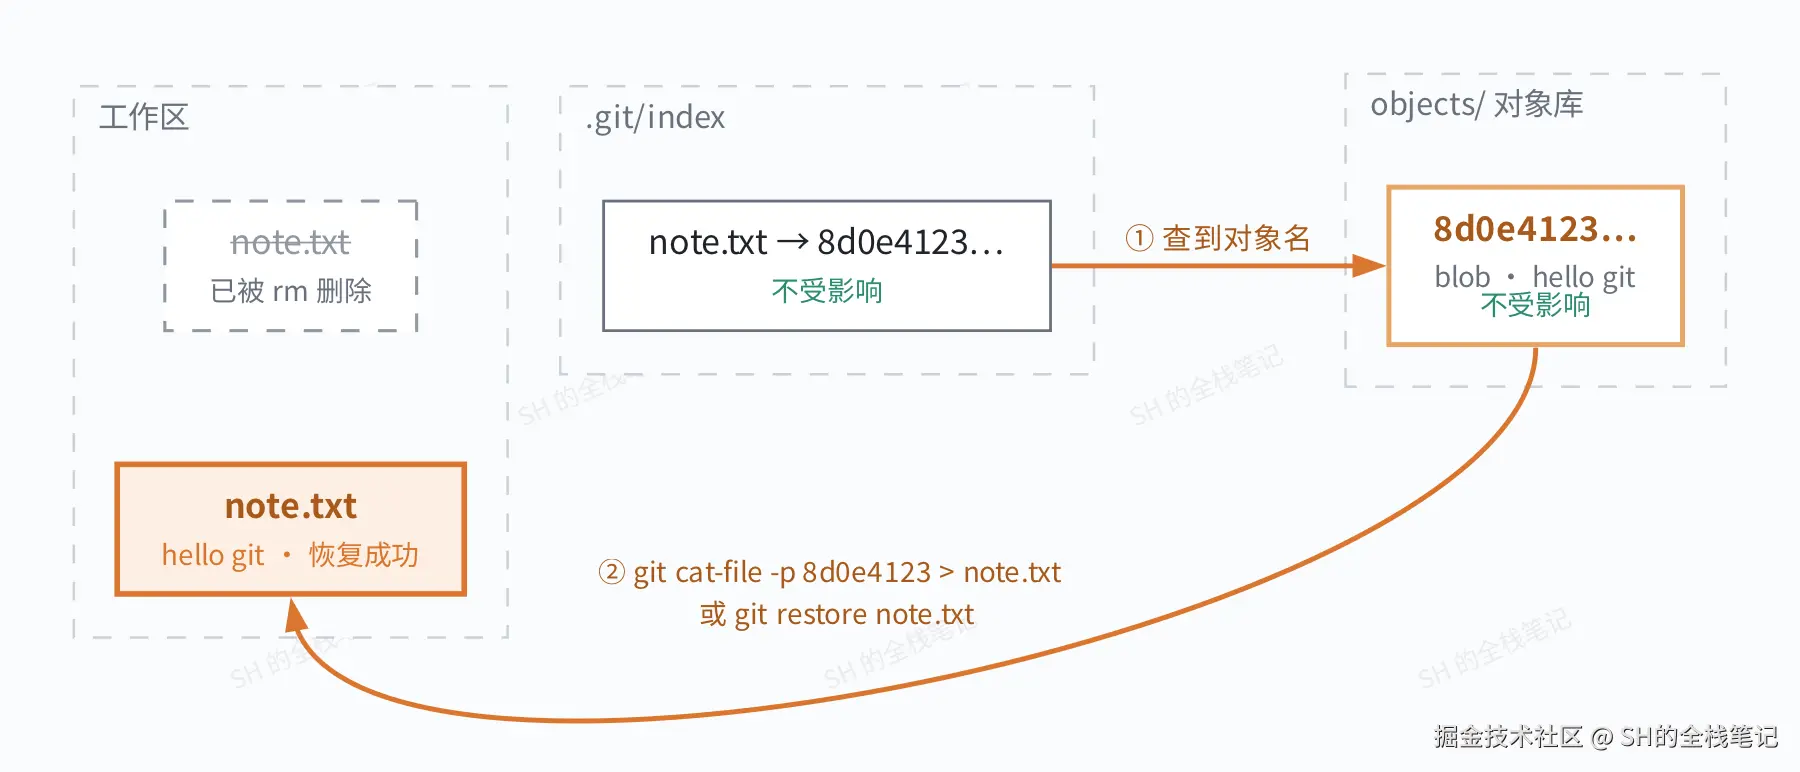
图里的 1、2 两步都发生在 .git 内部,工作区删得再干净也不影响它们。不过眼尖的同学可能发现了,文件能取回的前提,是 index 里这一行还指着那个 blob,要是我又 add 了一次呢?
那就取不回来了,至少没法靠 index 取回来。我们把文件改成别的内容再 add 一次,看看 index 和对象库:
bash
echo 'hello git, again' > note.txt
git add note.txt
git ls-files --stage
text
100644 00ebb5c5f78e7db40b9cea60687cdeed625e0cf3 0 note.txt再看看旧的 blob 还在不在:
bash
git cat-file -p 8d0e4123
find .git/objects -type f
text
hello git
.git/objects/00/ebb5c5f78e7db40b9cea60687cdeed625e0cf3
.git/objects/8d/0e41234f24b6da002d962a26c2495ea16a425f
index 里 note.txt 这一行已经改指新的 blob 00ebb5c5...,这时候 git restore 取回的是新内容。旧的 8d0e4123... 倒没被删,还躺在对象库里,你只要记得它的对象名,cat-file -p 照样能读出来。画出来是这样:
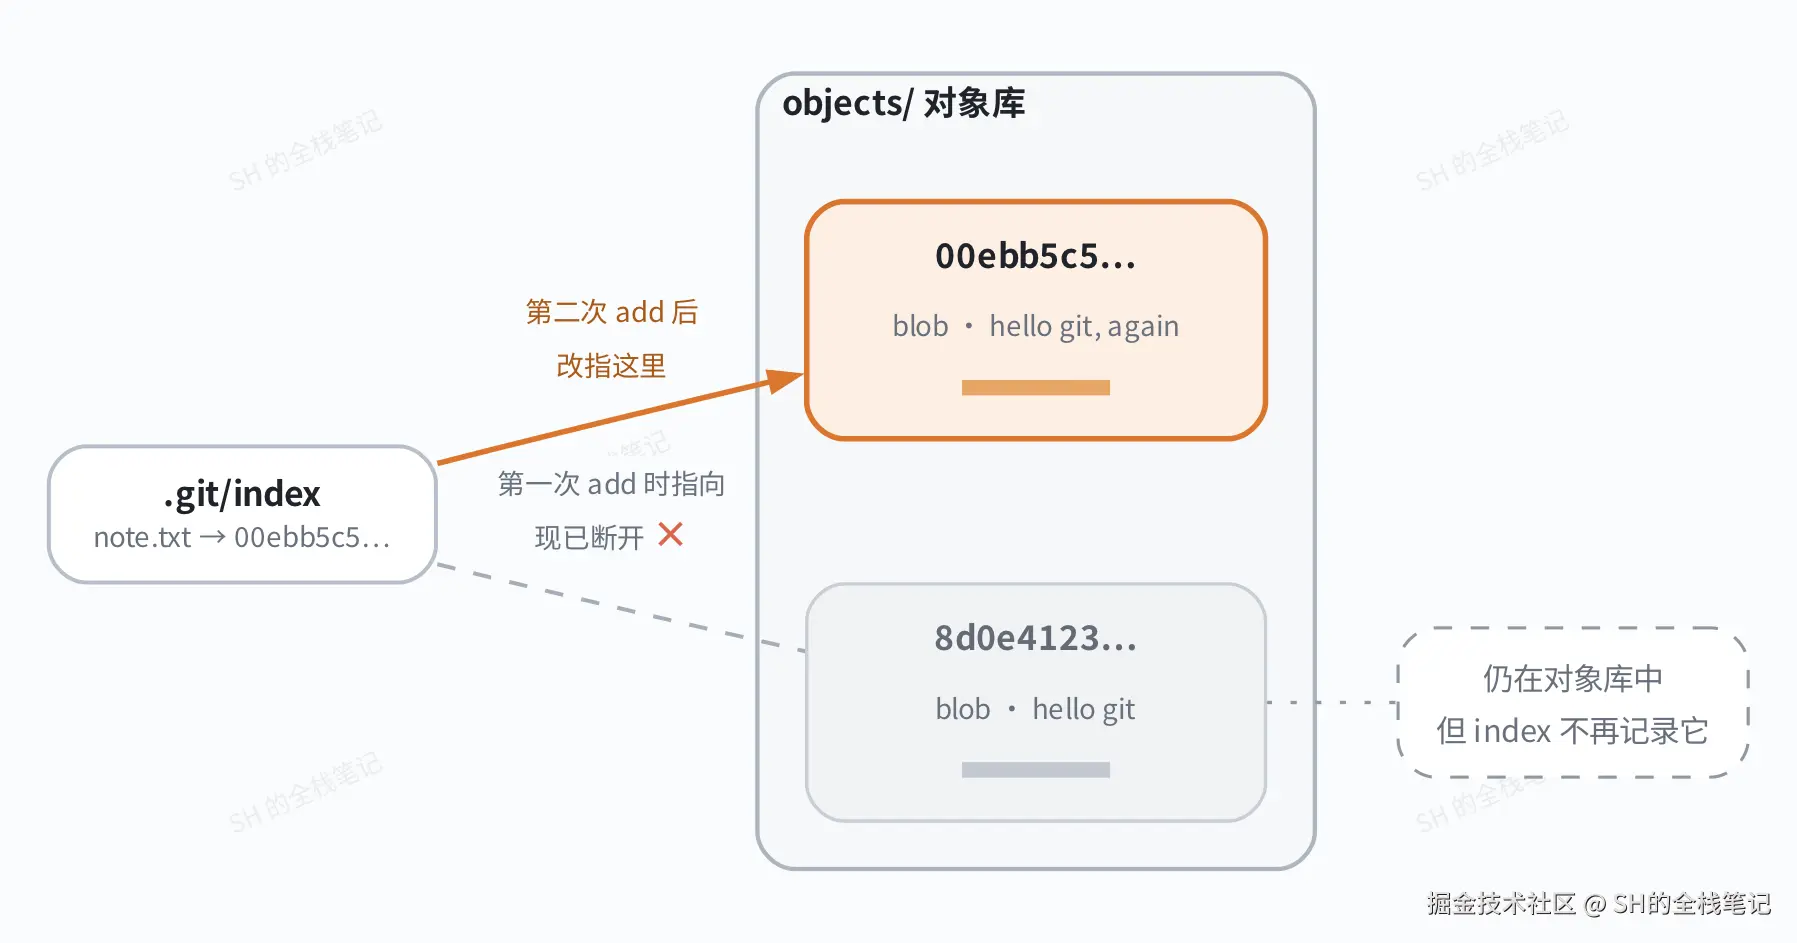
旧的 blob 还在,只是 index 里已经没有指向它的条目,而平时谁会记得一串哈希呢?除了再次 add,像 reset、stash 这类会改写 index 的操作也有同样的效果。
最后把内容改回去再 add 一次:
bash
echo 'hello git' > note.txt
git add note.txt
git ls-files --stage
find .git/objects -type f
text
100644 8d0e41234f24b6da002d962a26c2495ea16a425f 0	note.txt
.git/objects/00/ebb5c5f78e7db40b9cea60687cdeed625e0cf3
.git/objects/8d/0e41234f24b6da002d962a26c2495ea16a425f
index 又指回了 8d0e4123...,对象库里还是那两个文件。
总结
至此,空仓库和一次 git add 我们从里到外看了一遍。
空仓库里装数据的地方都是空的,HEAD 指向的 main 还没出现。敲下 git add,也就是在 VS Code 里点暂存的那一刻,内容就压缩成 blob 进了对象库,index 只是记下路径、对象名和 stat 信息的一张清单。
知道了这一点,平常我们改到一半要做有风险的操作,比如让 AI agent 大改一个文件之前,先 add 一下,这一版内容就已经进了对象库,改坏了用 git restore 就能拿回来,像 JetBrains 的 IDE 就可以配置自动 add。当然,前提是这之后没有再 add 覆盖掉 index 里那一行。
欢迎 wx 关注「SH的全栈笔记」