国产模型最近是"被虐"得太惨了,以前宣传都是追上甚至超越国际水平了,也就一年光景,现在是尾灯都快看不到了。
AA 算法一调整,所有国模排名又下滑~~ 除了最新的K3.1 Pro 还能扛一下,其它全部跌出前 10!
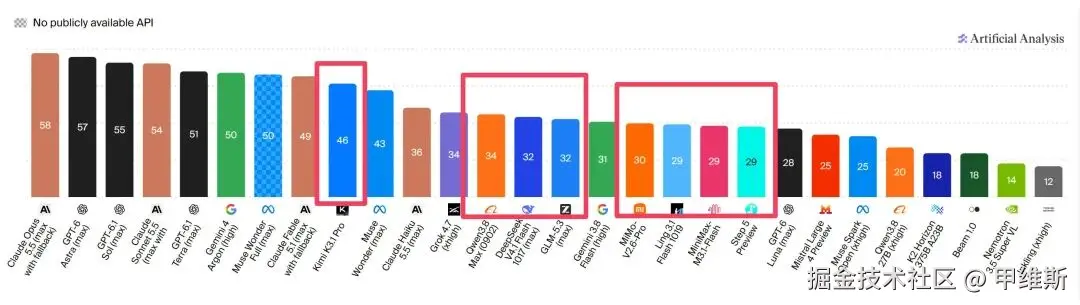
我一向不太相信榜单,但是这个调整整体来说更加接近真实情况了,其实,实战情况,比这个排名还要往后挪~~
这里有非常多耐人寻味的地方!
1、国产"最强"也弱!
国产最强模型 K3.1 Pro 从第4名掉到了第 9 名,从旗舰模型的角度来看,Anthropic、OpenAI、谷歌、Meta 这些外国模型全面领先。
2、"小弟"都这么能打!
Haiku 作为 Claude 系列中最便宜、最弱的模型居然也这么能打。直接把 Qwen3.8 Max、DeepSeek 4.1 Flash、GLM5.3 踩在脚下了。这里面不乏国产旗舰模型啊! Anthropic 太可怕了,直接用下下等马跑赢了上等马。
3、Gemini 3.8 抬起了头!
谷歌的 Flash 模型,居然把一大半国产模型给比下去。 什么小米 MiMo2.6P、Ling3.1、MiniMax 3.1、Step5 都排在了它后面。
4、Haiku 比 Luna 强很多。
同样是系列最低档,Haiku 要比 Luna 高九个名次。 Haiku 跑赢了上面提到的几乎所有国产模型,而 Luna 全部跑输了。
5、"性价比"极高的模型
从这个排名来看,次旗舰 Sonnet5.5 和 GPT-6.1 Sol 性价比奇高,它们的价格至少是旗舰的 1/2,但是能力非常接近。
另外 Haiku 的价格性价比已经"夯爆了"!
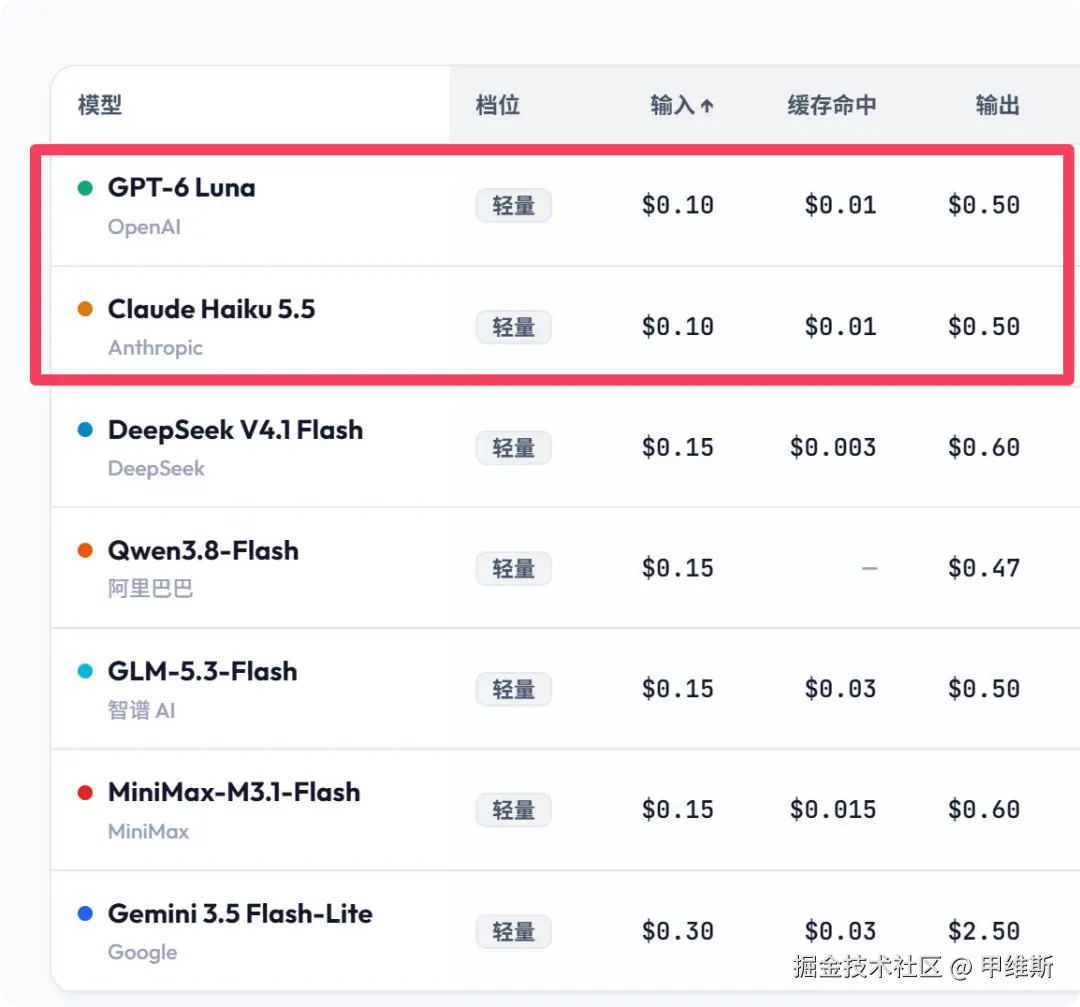
(我专门搞了价目表:topai.jarvisuni.com/price)
它的能力比国产 Flash 强,甚至比大部分国产旗舰模型都强,但是价格是 Flash 的价格,甚至比国产 Flash 还便宜。
这里面有多少剪刀差啊!
单看最新版可能不明显,对比一下老版:
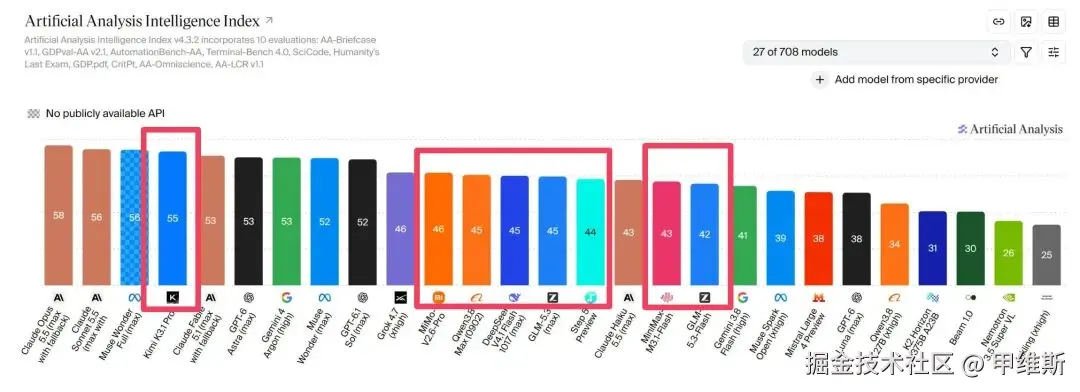
从对比可以看出来,排名大幅度波动。
波动的主要原因就是测试方法变了。
测评标准从 4.3.2 升级到了 v5.0,刷老题没用了!
v5.0 主要包含 9 项评估:
AA-Briefcase v1.1、AutomationBench-AA、GDP.pdf、FrontierCode 2.0、Terminal-Bench 4.0、AA-Omniscience v1.1、HLE-Diamond、CritPt v2(困难子集)和 Terminal-Bench-Science 0.1.0。
测评方法论强调公平性和实际应用性。
智力指数是根据四个类别的加权平均值计算得出的:
知识工作(25%)、编程(25%)、科学(25%)和综合(25%)。
类别归属和每次评估的权重如下所示:
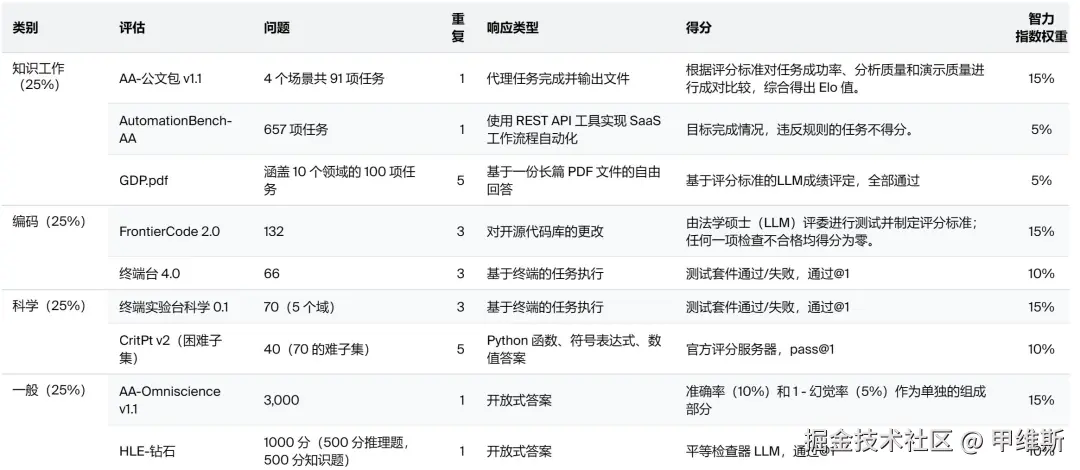
v5.0 主要变化如下:
- 将 HLE-Diamond (10%) 添加到通用(General)类别
- 将 Terminal-Bench-Science (15%) 添加到科学(Science)类别
- 将 FrontierCode 2.0 (15%) 添加到编码(Coding)类别
- 将 GDP.pdf 的权重从 10% 调整(降低)至 5%
- 用 CritPt v2(困难子集)替换了 CritPt,权重保持 10% 不变
- 从智能指数(Intelligence Index)中移除了 GDPval-AA
- 从智能指数中移除了 SciCode
- 从智能指数中移除了 AA-LCR
- 从智能指数中移除了 Humanity's Last Exam
- 将 AA-Omniscience 升级至 v1.1 版本
- 重新平衡各类别权重:知识工作(Knowledge Work)25%、编码(Coding)25%、科学(Science)25%、通用(General)25%
- 将"智能体(Agents)"类别重命名为"知识工作(Knowledge Work)",将"科学推理(Scientific Reasoning)"重命名为"科学(Science)",并将 GDP.pdf 移至"知识工作"类别中
虽然不能全信,但是整体来说,还算均衡的! 基本能体现模型的整体能力。
既然看了 AA 的智能榜,我们再来看另外两个榜单,看看性价比和时间比。
一个叫单任务消耗(Cost per task) ,越低越好!
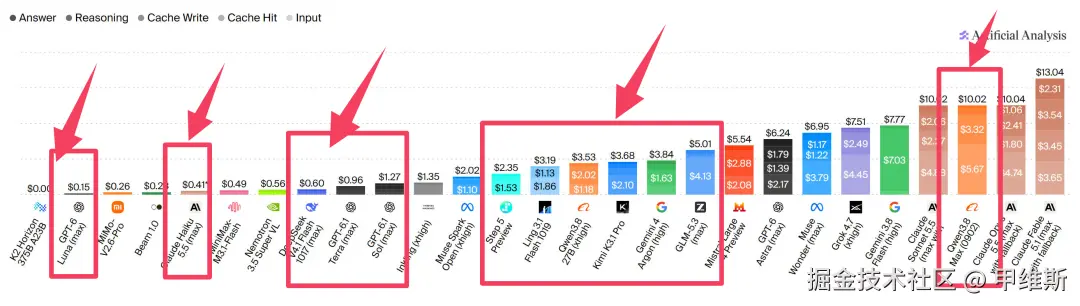
从这个表中可以看到:
GPT-6 Luna 消耗很低,几乎打败了所有人!
Haiku 也很低,比 DS 都要低。
GPT-6.1 Terra 和 DS 挨得很近。
Step、Qwen3.8、K3.1、GLM5.3 这些能力不如 Haiku,消耗的钱又比 Haiku 高几十倍。
Qwen3.8 Max 真的是"无敌"了,能力很拉垮,价格却特别出众。
别人比的是性价比,它比的是反向性价比。
还有一个叫单任务时间(Time per task)越少越好!
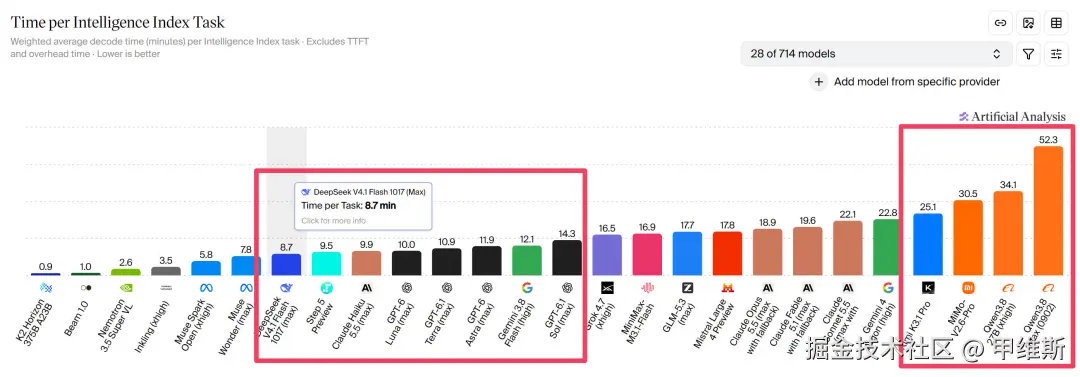
从这个表中可以看到:
这个榜单里 DS 还有一点领先优势。但是和 Haiku、Luna 这些也拉不开距离。
GPT-6 系列居然都这么快,真的假的!
Gemini 3.8 跑很快是实至名归。
另外不得不提一下最慢的几个家伙。它们分别是 Kimi 3.1 Pro、MiMo2.6 Pro、Qwen3.8 Max。
K3当时好像最慢,现在是有所提升,整体还是慢!
Qwen3.8 真的"反向无敌"了。 又拉胯,又慢,又费时间。
MiMo 确实也是"卧龙"般存在了,"凤雏"反而有点中庸了。
K3.1 Pro 能力尚可,消耗尚可,但是速度很慢。
这个仅仅是根据 AA 的图表的总结啊,有些数据,和我的实际体验还有出入。
这么看下来,国产模型能力被吊打,性价比也被吊打,速度也没有优势。
综合来看,确实也就大肥鱼还比较能打。
它的特点是:能力一般,速度快,价格低!
如果你有得选的情况下,想要性能,可以无脑入 Opus5.5。
想要性能又想要性价比就用 GPT-6.1 Sol 和 Sonnet5.5。
如果想要便宜又有性能还很快那就是 Haiku 了。
国内用户没得选的情况下,DS4.1F 可能就是最佳选择了。
当然,这个建议,仅限当下! 未来可能还会发生巨大变化。
整体来说,还是那句话,你可以什么都不研究,只要研究一下如何拥有一个Claude账号就可以了。 如果你不搞高精尖,不在乎时间,效率,那么什么模型都可以。