很多人第一次想把 AI 机器人塞进 QQ 群,都会先去搜「怎么部署一个机器人」。搜完基本就停在那儿了:要买服务器、要有域名、要申请证书、要装运行环境、要让进程一直活着、还要去某个模型平台申请一串 key。每一步都不算难,但六步连起来,足够让「我只是想在群里有个能接话的家伙」这个念头原地死掉。
这篇文章想拆开的是这六步里到底有哪些是必须的。结论先说:对于「群里有个 AI 能答话」这个目标,其中大部分是别人的问题,不是你的问题。
先说没有服务器,到底省掉了什么
把「部署一个聊天机器人」这件事按运维的视角摊开,会发现它要求你同时解决五件事,而这五件事跟「机器人说什么」一点关系都没有。
第一是公网入口。 群里的消息要能送到你机器上,你的机器就得在一个外部能找到的位置。家用宽带没有固定公网地址,很多人卡在这一步就开始研究各种穿透方案,然后发现方案本身比机器人更难维护。
第二是常驻运行。 机器人是一个常驻进程。它要一直醒着,消息来了能接。笔记本一合盖、一断网、一重启,它就没了。要让它真的「一直在」,你得处理开机自启、崩溃重启、长期运行维护这一整套。
第三是持久化。 人格设定、群配置、对话上下文,总得存在某个地方。存在内存里,重启就清空;存在文件里,你得想清楚备份和迁移。
第四是证书。 要让群里的消息安全地到达你的服务,加密和续期是一套单独的活。自己签的浏览器和平台都不认,申请和续期又是一套流程。
第五是模型 key。 机器人得有个模型来生成回复,这通常意味着你要去另一个平台注册、实名、拿 key、管额度。
这五件事的共同点是:它们全是运维,不是「养鱼」。你要的是群里有人 @ 它,它答得像那么回事;你不要的是深夜里收到一条「进程已退出」的通知。
云端把五件事收成了账号里的三样东西
LangBot 本身是一个开源的 IM AI 机器人平台,代码公开在 GitHub 上,愿意自己部署完全可以。这是它的底色,也是判断后面所有建议的前提。
LangBot Cloud 是官方托管的版本,入口是 cloud.langbot.app。在这条路上,上面那五件事被收进了账号里的三样东西里。
机器人。 它代表「群里那个身份」。QQ 这条线走的是 QQ 官方机器人 API,绑定方式是扫码,不需要你去处理对外入口。公网入口和证书这两件事,在这里直接消失了。
流水线。 它定义这只鱼怎么思考和说话:用哪个模型、人格怎么描述、什么消息才算触发。常驻运行和数据保存,落在这套托管配置里,你不用管它在哪台机器上跑。
模型额度。 用 LangBot 账号登录之后,可以直接选用 LangBot Models 里的模型,比如 deepseek-v4-flash 和 deepseek-v4-pro,并且送免费额度。第五件事也不需要你跑一趟别的平台。
登录界面上就是账号加密码这一件事,没有部署,也没有一堆要填的配置项。这一步的心理成本比技术成本重要得多------它意味着你可以先看到东西跑起来,再决定要不要认真。
免费档的边界:1 个机器人,3 条流水线
免费档是 ¥0,1 个机器人,3 条流水线。这两个数字值得认真读一遍,因为它们决定了你该怎么规划,而不是决定你要不要开始。
1 个机器人意味着你养一只。你可以把它放进一个群,也可以按官方机器人的能力放进多个群,但不要指望同时开三只不同性格的。
3 条流水线意味着你可以做「默认聊天」「一个特定角色」「一条备用实验」这种组合。听起来不多,但绝大多数人真正需要的就是一条。
我反而觉得这个约束是好事。见过太多人一开始就想设计一套多角色路由,结果第一条流水线的人格都没写清楚。先把一条写好,比先想清楚怎么扩容有用得多。
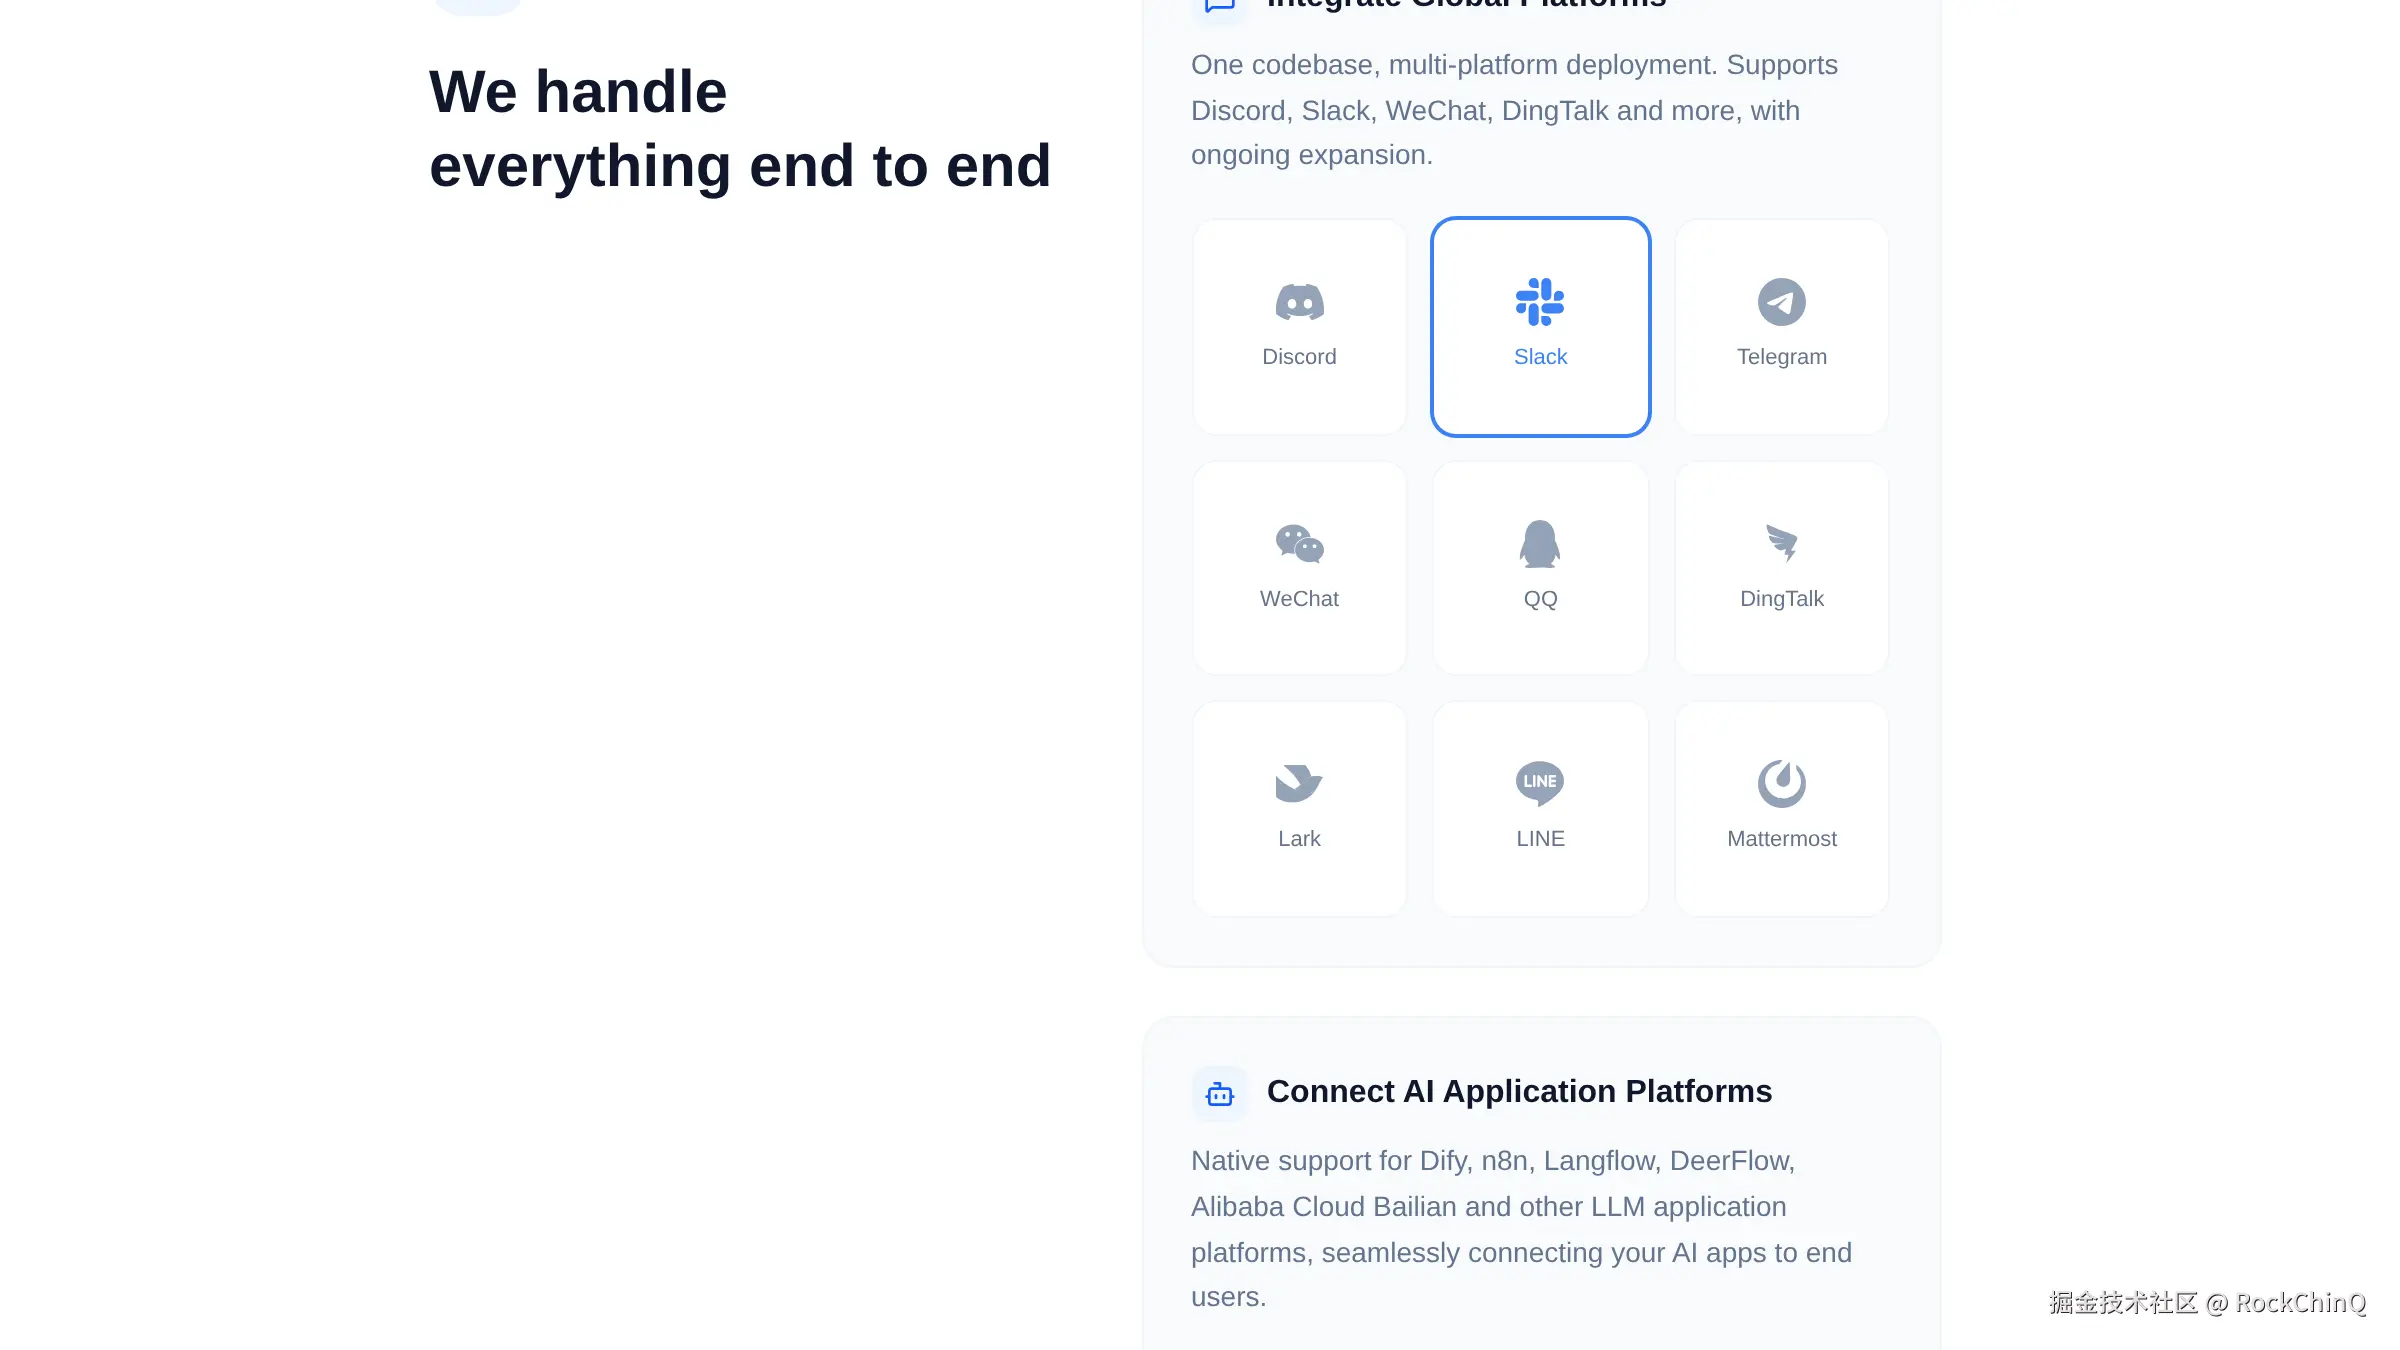
群触发只勾 At,是一个社交决定
设置里有一个选项是群聊的触发方式。常见的诱惑是全选------什么消息都回,显得机器人很活跃。别这么干。
QQ 群里人多,如果它对每句话都接,噪音会立刻把正常聊天淹掉,而且每条消息都在消耗模型额度。只留 At,效果是:群里的人知道「@ 它才会出声」,于是它不会抢话,也不会在你聊正事的时候插一句。
这条设置省下的不是钱,是别人的耐心。一个群能长期容忍一个机器人,靠的从来不是它多聪明。
界面上的顺序
整个路径在界面里是固定的,没有分支:
打开 cloud.langbot.app,用 LangBot 账号登录 → 选一个 LangBot Models 的模型 → 建一条流水线,写好人设 → 群触发方式只勾 At → 建机器人,适配器选 QQ 官方 API → 一键扫码绑定,用手机 QQ 扫 → 启用 → 回到群里 @ 它说话。
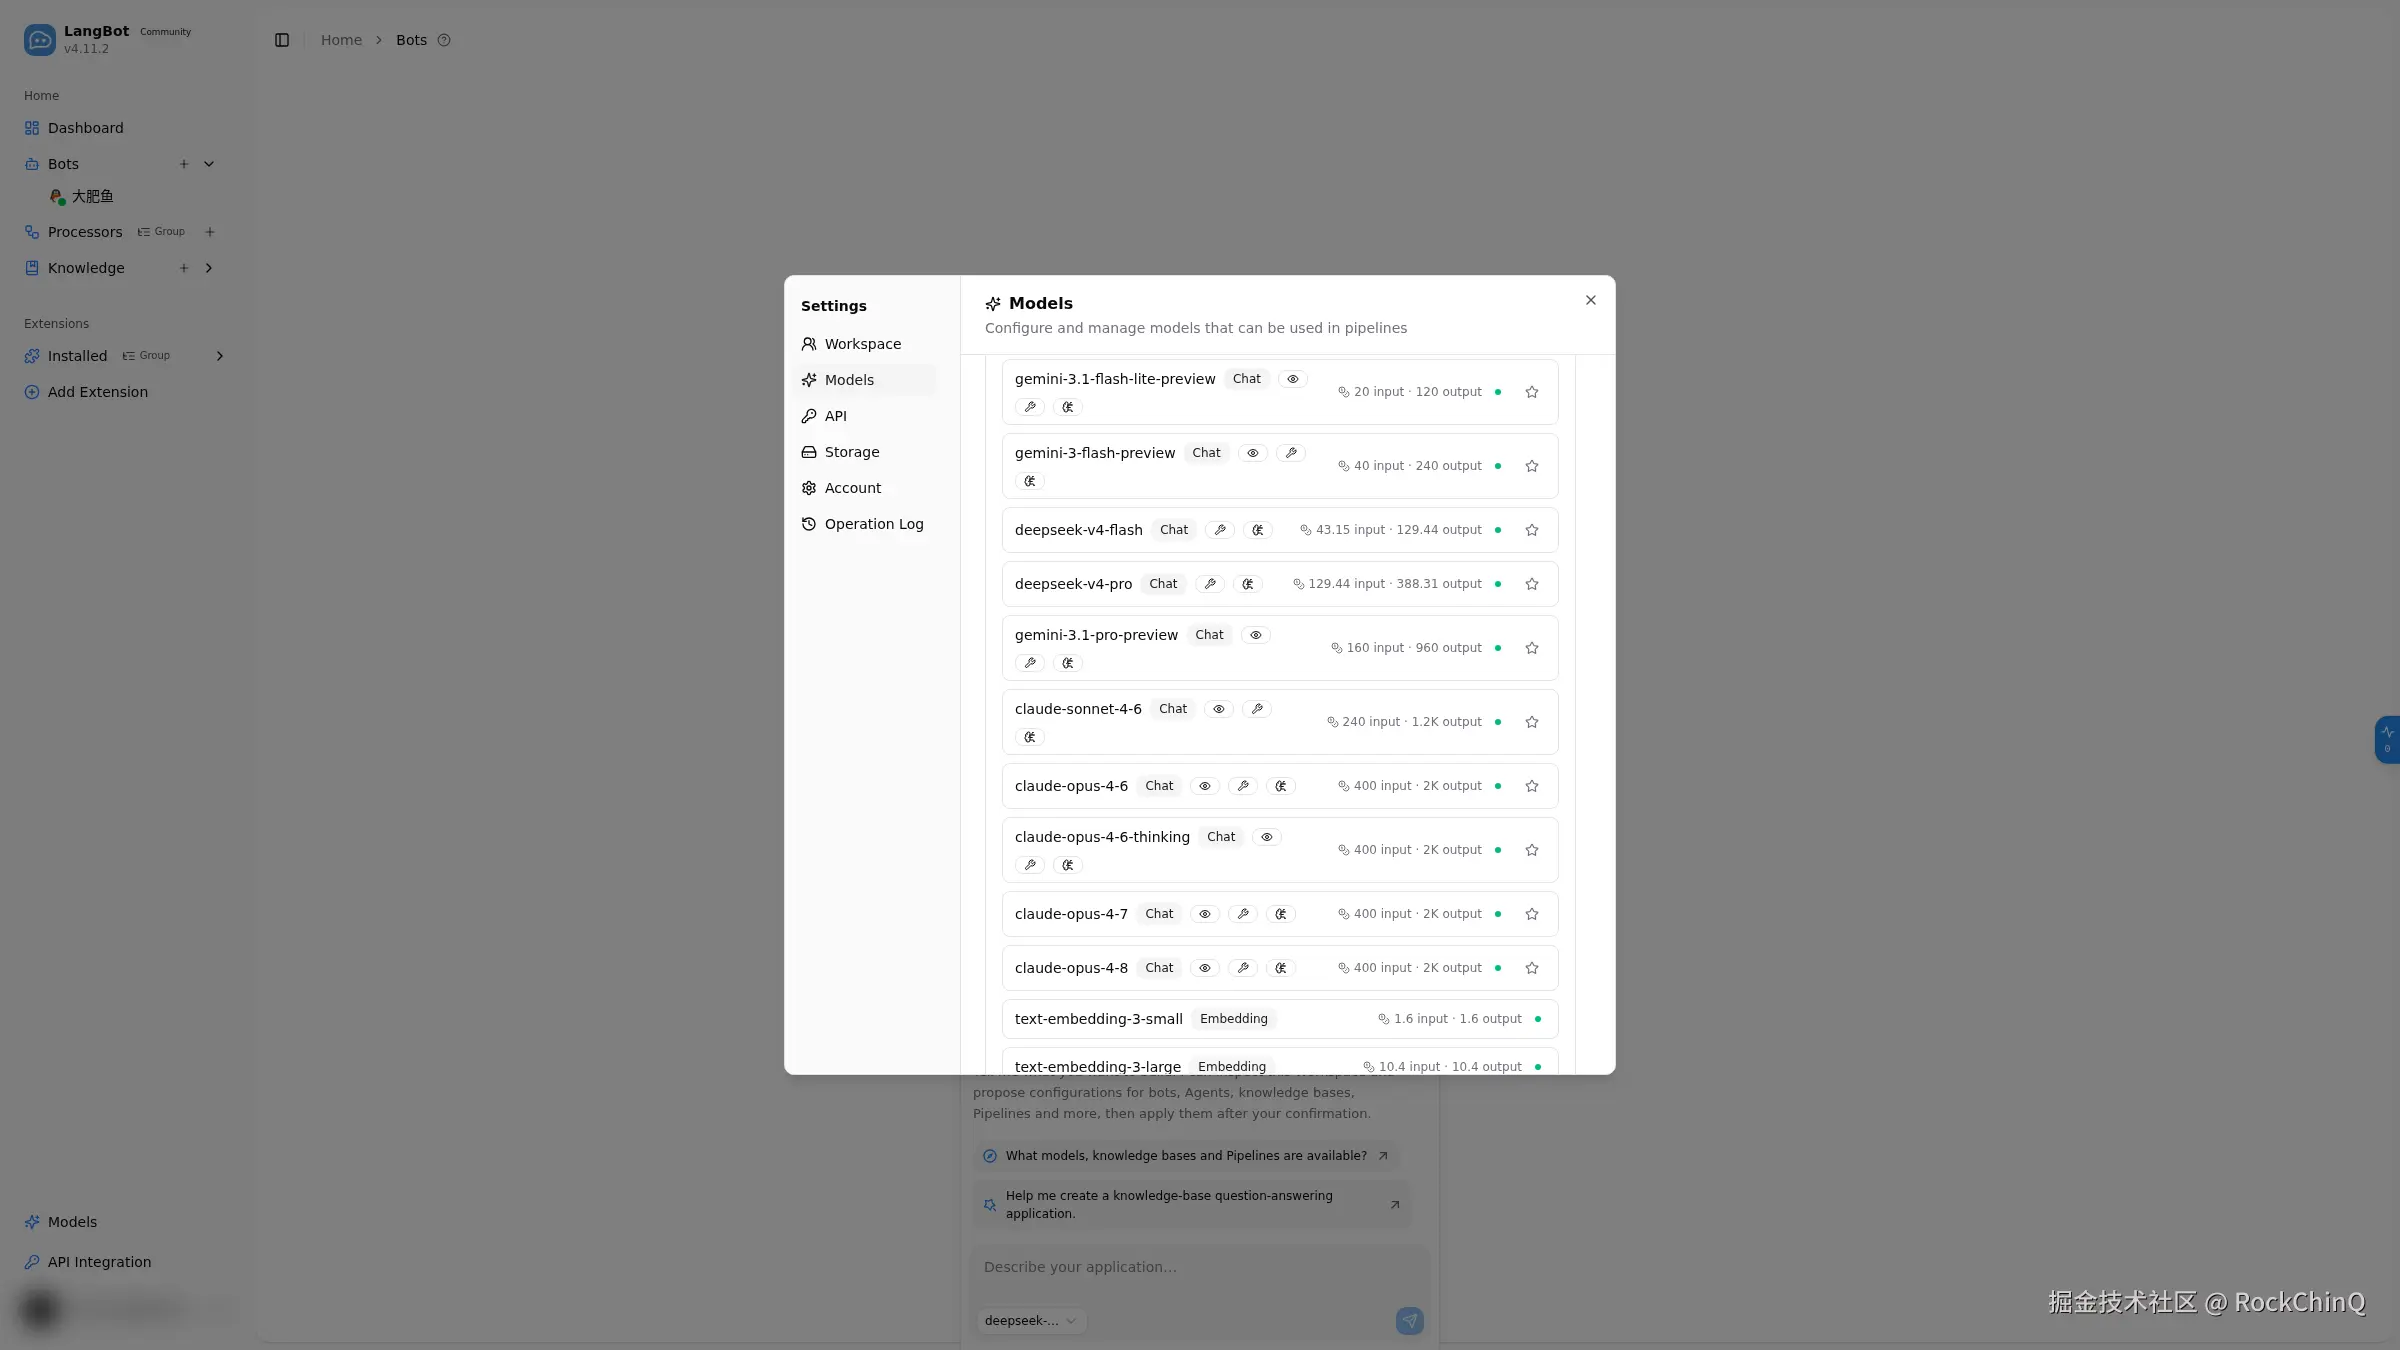
中间唯一需要动脑的是写人格。这一段没有标准答案,但有一个经验:写「你是谁、你说话什么风格、什么情况下闭嘴」,比写一长串「你要聪明、要专业、要有同理心」有效。后者模型读不出区别,前者能。
什么情况下还是该自己搭
写完这些,得说清云端不是万能。有三种情况,自己部署确实更合适。
数据必须留在自己机器上。 如果对话内容不能离开你的环境,那托管这条路就不成立,去仓库里按文档部署。
网络环境特殊。 内网、离线、需要固定出口地址的场景,托管服务帮不上。
需要深度定制。 改源码、写自己的插件、接自己的消息通道,这些只有自己跑一份才做得到。
判断标准其实很简单:如果你的目标是「群里有个能答话的 AI」,云端够用;如果目标是「我要控制它怎么跑、跑在哪、代码长什么样」,那就自己搭。这两件事不冲突,也没有高下------它们解决的是不同的问题。
开源保证了后者永远存在,托管保证了前者不需要门槛。这也是我建议大多数人从托管开始的原因:先确认自己真的想养,再决定要不要为它修一个鱼缸。
仓库在这里:langbot-app/LangBot,官网在 langbot.app。想直接试的,登录 cloud.langbot.app,配完就能在群里 @ 到它。有问题评论区聊。