平时做经营分析或者跑日报,第一步往往不是画图,而是先面对一份"不太干净"的导出的明细表:重复的单号、位数对不上的手机号、莫名其妙的负数金额、格式乱掉的日期......
在跑任何分析之前,得先确认数据靠谱。
下面介绍一种简单的做法:用几十行 Python 写一个轻量的数据质量 DSL,把校验规则写成能看懂的话,还能顺手接进你的数据管道。
1. 为什么要用DSL
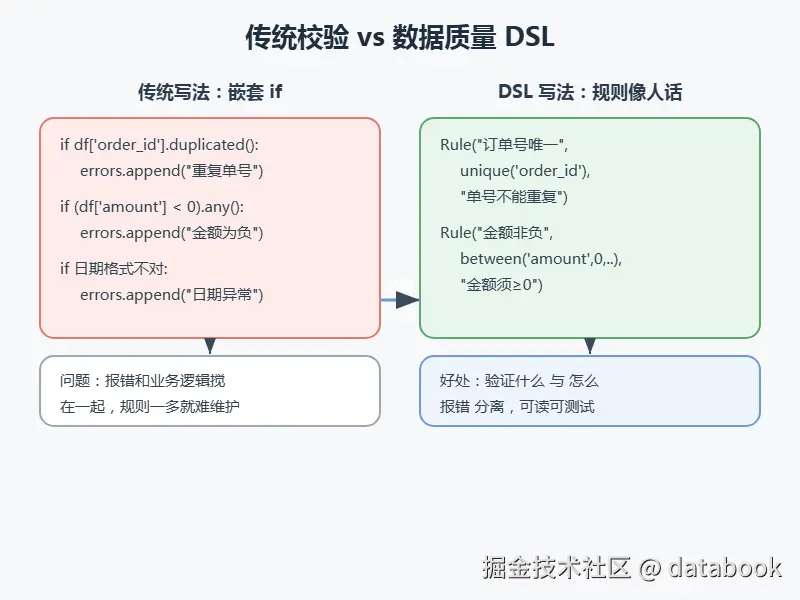
提到"数据质量校验",很多人第一反应是写个函数,读进 DataFrame 之后用一串 if 去判断重复、空值、范围。
短期内没问题,但规则一多起来就露馅了:报错信息和业务逻辑搅在同一层,函数越写越长,改一条规则都要担心牵动别的检查。
说白了,你是在用通用编程语言去硬凑一套"校验规范",而这套规范本身并没有自己的形状。
DSL(Domain-Specific Language,领域特定语言)的思路正好反过来:它不要求你另学一门语言,而是在 Python 里搭一套只管"数据质量"的小词汇。
我们把每条检查抽象成 Rule("订单号唯一", 条件, "单号不能重复") 这样的写法。
读起来像业务需求本身,而不是一段控制流。
它的好处很实在:
- 规则可读,新人看一眼就知道定了什么规矩;
- 规则可测,每条独立运行、互不影响;
- 规则可复用,换个数据集照样套得上。
接下来就沿着这个思路,一边搭这套词汇,一边用它去查一份真实的门店销售明细。
2. 先造一份"带病"的样例数据
为了方便你直接尝试文中的代码,不用再去下载什么数据集,文中所有示例都基于一份模拟的门店销售明细。
字段就五个:订单号、手机号、金额、销售日期、备注。
这里,我们故意往里混了重复单号、位数不足的手机号、负金额、畸形日期,还有高金额却没备注的订单。
这样后面每加一条规则,都能立刻看到它抓出什么问题。
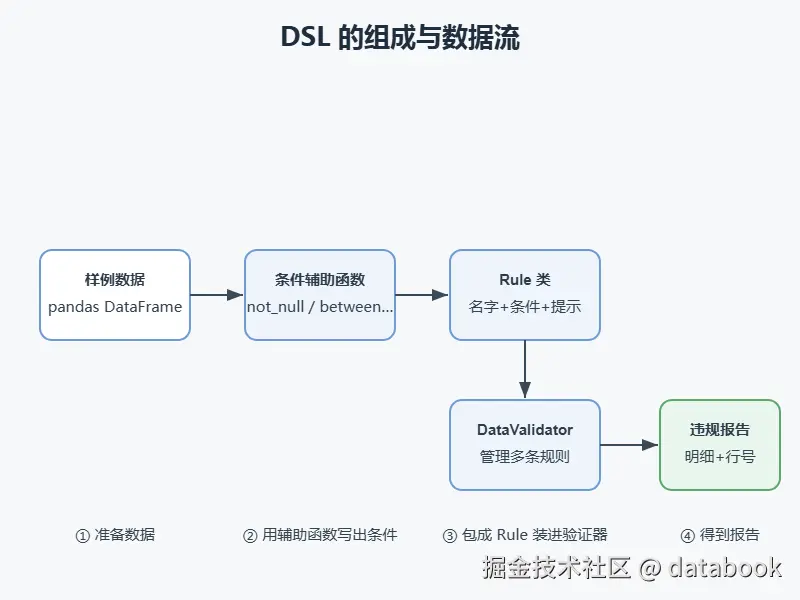
3. 核心就一个 Rule 类
整个 DSL 的核心抽象只有一个:Rule。
它接收三样东西:
- 规则名字
- 一个返回"有效行"布尔序列的条件函数
- 以及一句报错提示
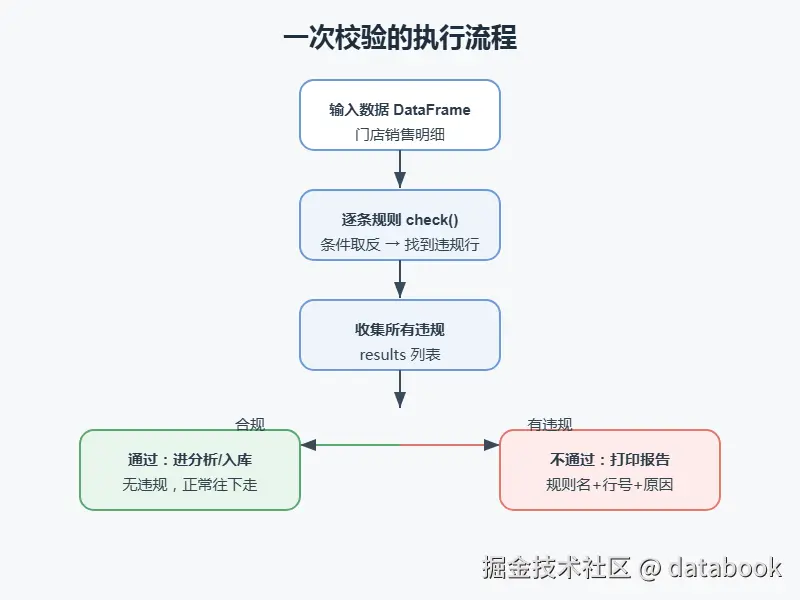
判断违规时,对条件取反 ~ 就得到违规行,check 方法统一吐出一份报告(规则名、原因、违规行数、样例行号)。
python
class Rule:
    def __init__(self, name, condition, error_msg):
        self.name, self.condition, self.error_msg = name, condition, error_msg
    def check(self, df):
        violations = df[~self.condition(df)]
        ...  # 有违规就返回报告字典,否则返回 None
关键约定是:条件函数返回 True 表示"这行没问题"。
后面所有辅助函数都遵守这个约定,于是 Rule 本身永远不用改。
4. 让条件说人话:几个辅助函数
如果每条规则都现写 lambda,代码照样难读。
所以我们先准备一批返回条件函数的"小词",像搭积木一样拼规则:
python
def not_null(col):         return lambda df: df[col].notna()
def unique_values(col):    return lambda df: ~df.duplicated(subset=[col], keep=False)
def between(col, lo, hi):  return lambda df: df[col].between(lo, hi)
def matches_pattern(col, pat): return lambda df: df[col].astype(str).str.match(pat, na=False)
unique_values 用 keep=False 把所有重复行都标出来;
matches_pattern 配合正则校验手机号格式,na=False 保证空值直接判失败。
这套"词汇表"就是 DSL 可读的来源。
5. 装进 DataValidator 跑起来
Rule 本身不负责"跑多条规则",这件事交给 DataValidator。
它维护一个规则列表,add_rule 返回 self 所以能链式调用,validate 逐条检查、把有问题的报告收集起来------某条规则挂了也不会中断其他检查。
python
v = DataValidator()
v.add_rule(Rule("订单号唯一", unique_values("order_id"), "订单号不能重复"))
v.add_rule(Rule("金额非负", between("amount", 0, 100000), "金额须 ≥ 0"))
issues = v.validate(df)
for i in issues:
    print(i["rule"], i["sample_rows"])  # 打印规则名和违规行号
跑完你会拿到一份清单:哪条规则没过、影响了哪几行。定位脏数据从此不用靠肉眼翻表。
6. 真实场景:跨列校验与日期校验
真实业务里很多规则是"跨列"的。
比如我们定:金额超过 500 的订单必须有备注。
它同时看 amount 和 note 两列,写成一个普通函数即可,照样包进 Rule:
python
def high_amount_needs_note(df, threshold=500):
    high = df["amount"] > threshold
    has_note = df["note"].notna() & (df["note"].astype(str).str.strip() != "")
    return ~high | has_note
日期更麻烦,畸形字符串(如 2024-13-45)解析会失败。
做法是先用 pd.to_datetime(..., errors="coerce") 把解析不了的变成 NaT,再判断原值非空且解析也非空才算有效。
7. 接进管道:用装饰器兜底
校验写好了,关键是"卡住"坏数据,别让它流到下游分析。
最省事的方式是包一层装饰器:在真正处理函数之前先跑一遍 validate,有问题直接抛异常,把具体规则细节带出来。
python
def validate_dataframe(validator):
    def decorator(func):
        def wrapper(df, *a, **k):
            issues = validator.validate(df)
            if issues: raise ValueError("数据校验未通过:" + str(issues))
            return func(df, *a, **k)
        return wrapper
    return decorator
把它盖在 analyze、to_excel 这类入口函数上,数据一不对劲就被拦在门口,下游再也不会被脏数据坑。
8. 最终效果
完整的代码共享在:data_quality_dsl.py url11.ctfile.com/f/45455611-...
代码用 pandas 写了一个轻量数据质量校验工具,核心是两个类:
- Rule 把"一条规则"封装成「名字 + 条件函数 + 报错提示」
- DataValidator 负责收集多条规则并逐条检查、汇总违规报告。
代码里还提供了一批可读的条件辅助函数(非空、唯一、范围、正则、日期格式)和跨列校验(高金额订单必须有备注),规则读起来就像业务需求本身。
最后用一份故意混入脏数据的「门店销售明细」做样例,并通过一个装饰器把校验卡在数据处理入口,直接运行就能看到哪几条规则没过、影响了哪些行。
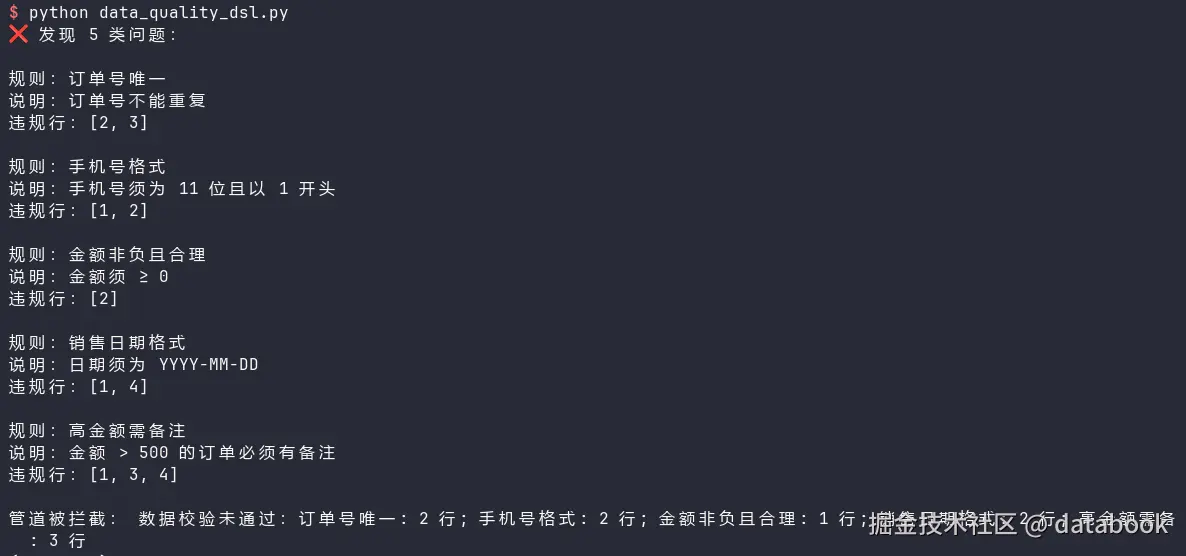
基于这个代码,可以扩展一些适合自己业务的质量校验规则,然后就可以自动检测数据的质量了。