我带学员做 AI 项目,第一天挂掉的人里,十个有七个不是死在代码上,是死在环境上。
典型现场是这样的:教程说 pip install xxx,他装了,运行报错说找不到包;再装一次,装到全局去了,把另一个项目的版本顶掉了;上网搜,看到有人说用 root 装,加 sudo,装完能跑了,第二天开机又不行。来回折腾三个晚上,兴趣磨没了,人也没影了。
这一篇我不打算教你"复制这几行命令"。我要把为什么要这么做 讲清楚------虚拟环境到底隔离了什么、API Key 为什么不能写进代码、.env 是怎么被读进去的、一次问答在网络上到底发生了什么。你把这些弄明白,后面九篇的代码才不会变成"照抄能跑,改一行就崩"。
这一篇结束的时候,你会有一个真的能跑的工程:配了 Key 就调真实 DeepSeek,没配 Key 也能把整条链路跑通并让测试全绿。
一、先扫盲:五个概念,不懂它们后面全是黑盒
1. 虚拟环境:给每个项目一间独立的房间
你机器上可能同时跑着好几个 Python 项目。A 项目要 requests 2.28,B 项目要 requests 2.32,装在系统里只能留一个版本,于是必有一个项目崩。
虚拟环境(virtualenv)做的事很朴素:把一份 Python 解释器和一个空的 site-packages 目录复制到项目里的 .venv/ 文件夹下。激活它,你用的 python 和 pip 就全指向这个文件夹,装的包只躺在里面。它不是模拟器,不是容器,就是一个被隔离出来的目录。
怎么判断自己有没有激活成功?看命令行提示符前面有没有 (.venv),或者跑一句:
bash
which python
# 输出应该是:/你的项目路径/.venv/bin/python
# 如果输出是 /usr/bin/python 或 /opt/homebrew/bin/python,说明还在用系统的
2. pip:把别人写好的代码搬到你机器上
Python 能火,一半功劳在生态。你要发 HTTP 请求,不用自己写 socket,直接 pip install httpx 就能用别人写好的。
requirements.txt 是这份"购物清单"的固化:把你项目用到的包和版本写下来,换台机器 pip install -r requirements.txt 就能还原。我这次踩到一个坑,正好说出来:国内直连 PyPI 常常很慢,换清华镜像我却吃到了 403------镜像源之间同步有延迟,某些冷门包没拉全。最后换成阿里云镜像一次成功。这不是玄学,换源重试是标准操作。
bash
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/3. API Key:一把会被计费的钥匙
调大模型不是免费的,平台靠 Key 认你是谁、扣谁的钱。所以:
- 绝不能写死在代码里。代码一旦推到公开仓库,爬虫几分钟就能扫到你的 Key,然后你的余额就没了。
- 放
.env文件,并把.env写进.gitignore。代码从环境变量读(.env只是本地开发的便捷方式)。
为什么 Key 会丢?不是黑客多高明,是忘了加 .gitignore。这是我见过最普遍的一次性损失。
4. HTTP 请求与 JSON:模型交互的全部秘密
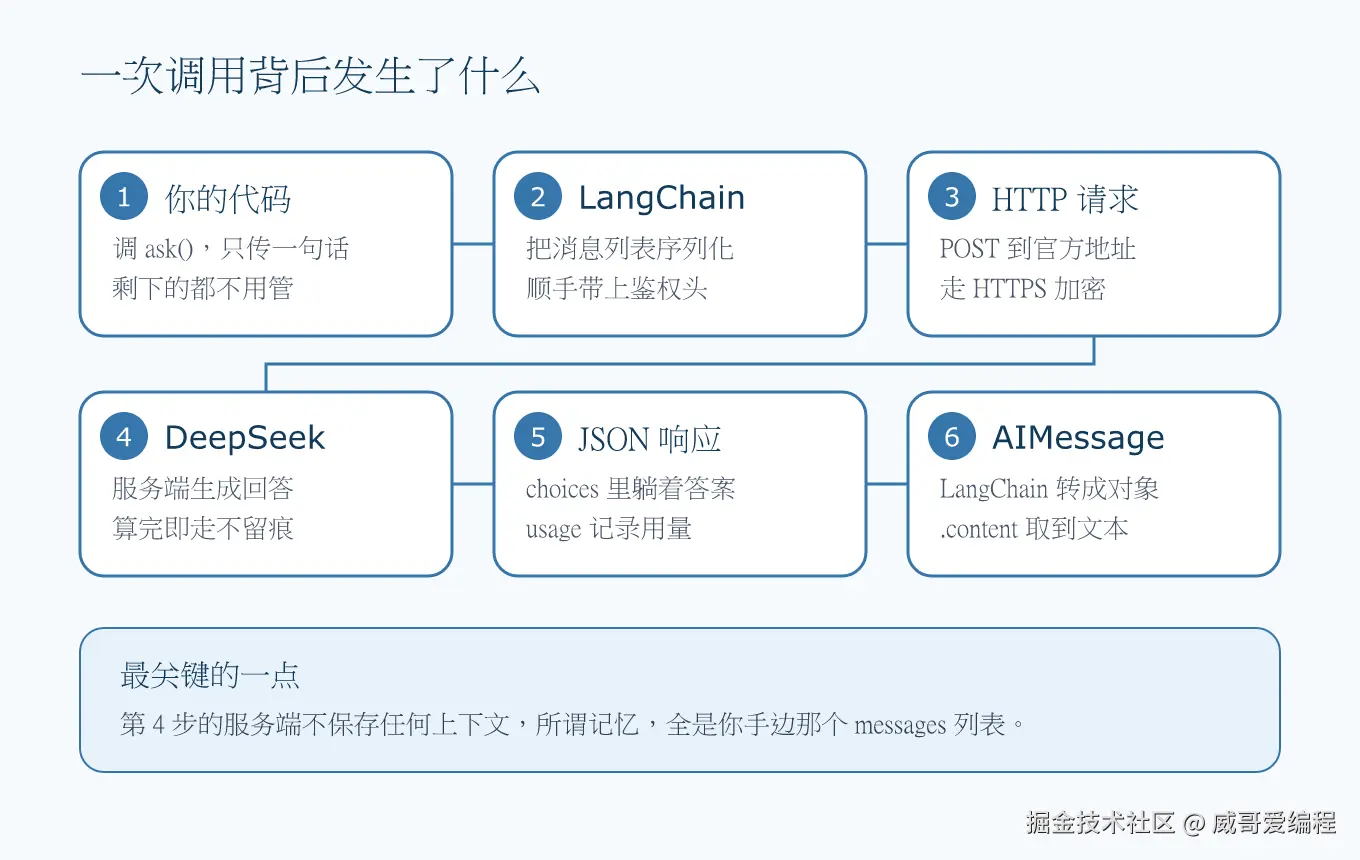
调大模型本质上就是一次 HTTPS 请求:你 POST 一段 JSON 过去,服务器回一段 JSON 回来。没了。
请求体大概长这样(DeepSeek 是 OpenAI 兼容格式):
json
{
  "model": "deepseek-flash",
  "messages": [
    {"role": "system", "content": "你是英语助教"},
    {"role": "user", "content": "这个句子对吗?"}
  ],
  "temperature": 0.7
}
role 有三种:system 定身份、user 是用户说的、assistant 是模型回的。注意最后一点:服务端不保存任何东西。 你以为的"多轮对话",其实是每一次都把前面所有内容重发一遍。这一点到下一篇讲上下文时会要命------它是 Token 账单失控的根源。
5. 模型名换代:抄旧教程会直接 404
这条必须单独拎出来讲,因为我查官方文档时确认了一件很多人还不知道的事:
deepseek-chat 和 deepseek-reasoner 这两个名字,已经在 2026 年 7 月 24 日退役了。
现在正确的是:
| 用途 | 模型名 | 说明 |
|---|---|---|
| 日常对话、工具调用 | deepseek-flash |
便宜、快,本项目主力 |
| 复杂推理 | deepseek-v4-pro |
留给真难题 |
你要是照着 2025 年的博客抄 deepseek-chat,拿到的是冷冰冰的 404。所以我养成一个习惯:每次开新项目,先去官方文档瞄一眼模型名,比事后 debug 一小时便宜太多。
另一个小坑:DeepSeek 的 base_url 是 https://api.deepseek.com,后面没有 /v1。很多人习惯性加上路由前缀,然后得到一串看不懂的报错。
二、工程长什么样
我按"一个功能一个文件"的方式来组织,为的是你改某一块时不用在几百行里翻:
bash
01-环境与首次调用/
├── .env.example        # 配置样例;复制成 .env 后填自己的 Key
├── .gitignore          # 必须包含 .env 和 .venv/
├── requirements.txt    # 依赖清单
├── pytest.ini          # 告诉 pytest 去哪儿找测试
├── demo.py             # 一键演示:有 Key 走真实,没 Key 走离线
├── src/
│   ├── settings.py     # 配置集中读取
│   ├── llm.py          # 模型工厂(真/假两条路)
│   ├── chat.py         # 消息拼装与问答
│   └── graph.py        # 最小 LangGraph 图
└── tests/ # 五个测试文件,全程离线可跑依赖就四个:langchain-deepseek、langgraph、python-dotenv、pytest。我这次装到的版本是 langchain-deepseek 1.1.1、langgraph 1.2.18、langchain-core 1.7.0,Python 是 3.13.12。
三、第一步:配置集中到一处(settings.py)
新手最爱在代码各处写 os.getenv("DEEPSEEK_API_KEY")。等你要换模型、换地址、给同事部署,就得满项目搜索。集中起来,改一处搞定。
python
"""配置集中管理:只在这一处读环境变量。"""

from __future__ import annotations

import os
from dataclasses import dataclass

from dotenv import load_dotenv

# DeepSeek 的 OpenAI 兼容入口,官方文档给出的地址
# 注意:不是 https://api.deepseek.com/v1,DeepSeek 直接用根路径
DEEPSEEK_BASE_URL = "https://api.deepseek.com"

# 2026 年当前的主力模型(旧的 deepseek-chat / deepseek-reasoner 已退役)
DEFAULT_MODEL = "deepseek-flash"


@dataclass(frozen=True)
class Settings:
    """一个只读的配置容器。

    frozen=True 表示创建后不能再改,
    避免代码某个角落偷偷把 model 改掉,排查半天。
    """

    api_key: str = ""
    base_url: str = DEEPSEEK_BASE_URL
    model: str = DEFAULT_MODEL

    @property
    def has_key(self) -> bool:
        """有没有配 Key。"""
        return bool(self.api_key)


def load_settings(env_file: str | None = None, override: bool = False) -> Settings:
    """读取配置。

    env_file  : 指定 .env 文件路径,传 None 就用项目根目录的默认 .env
    override  : True 表示 .env 里的值覆盖已有系统环境变量。
    """
    # load_dotenv 会把 .env 里的键值对写进 os.environ
    # 这一行执行前,os.getenv 是读不到 .env 内容的
    load_dotenv(env_file, override=override)

    return Settings(
        api_key=os.getenv("DEEPSEEK_API_KEY", "").strip(),
        base_url=os.getenv("DEEPSEEK_BASE_URL", DEEPSEEK_BASE_URL).strip(),
        model=os.getenv("DEEPSEEK_MODEL", DEFAULT_MODEL).strip(),
    )
两个细节值得说:
@dataclass(frozen=True):frozen让实例只读。这不是炫技------配置对象在代码里到处传,一旦被某个函数悄悄改了model,你能查到怀疑人生。.strip():.env文件是在行尾多打了一个空格导致的"Key 无效",这类问题我见过太多次,strip 一下省事。
四、第二步:模型工厂,留一条不花钱的退路(llm.py)
这是本篇里我认为最重要的一段设计。它解决一个现实问题:写教程的人不能假设读者手上有 Key。
python
from langchain_core.language_models import BaseChatModel
from langchain_core.language_models.fake_chat_models import FakeListChatModel
from langchain_deepseek import ChatDeepSeek

from settings import Settings

DEFAULT_TEMPERATURE = 0.7
DEFAULT_TIMEOUT = 60


def build_llm(
    settings: Settings,
    *,
    temperature: float = DEFAULT_TEMPERATURE,
    timeout: int = DEFAULT_TIMEOUT,
    offline_responses: Sequence[str] | None = None,
) -> BaseChatModel:
    """创建一个聊天模型。

    返回值类型是 BaseChatModel(抽象基类)而不是具体类,
    这叫"面向接口编程":调用方只管 .invoke() 能用,
    不在意背后是真模型还是假模型。
    """
    # 通路一:离线假模型,给测试和演示用
    if offline_responses is not None:
        # FakeListChatModel 会按列表顺序依次返回,用完从头再来
        return FakeListChatModel(responses=list(offline_responses))

    # 通路二:真实 DeepSeek
    if not settings.has_key:
        raise RuntimeError(
            "没有读到 DEEPSEEK_API_KEY。\n"
            "两种解决方式:\n"
            "  1. 在项目根目录建 .env 文件,写一行 DEEPSEEK_API_KEY=sk-xxx\n"
            "  2. 或者调用 build_llm(..., offline_responses=['...']) 走离线模式"
        )

    return ChatDeepSeek(
        model=settings.model,
        api_key=settings.api_key,
        api_base=settings.base_url,
        temperature=temperature,
        timeout=timeout,
        max_retries=2,  # 网络抖动时自动重试两次
    )
三条通路,按优先级判断:
- 传了
offline_responses→ 假模型,不发网络请求、不花钱 - 有 Key → 真模型
ChatDeepSeek - 没 Key 又没给离线答案 → 抛出一句告诉人怎么修的错误
第三条是我特意做的。默认情况下缺 Key 会抛一大串看不懂的认证异常,新手直接懵。换成"你该干什么",体验完全不同:
ini
has_key = False
RuntimeError:
没有读到 DEEPSEEK_API_KEY。
两种解决方式:
  1. 在项目根目录建 .env 文件,写一行 DEEPSEEK_API_KEY=sk-xxx
  2. 或者调用 build_llm(..., offline_responses=['...']) 走离线模式
temperature=0.7 是什么?它控制回答的随机程度。0 接近确定(同一句提问几乎同一句回答),1 以上天马行空。做英语教学这种讲语法的场景,我建议压到 0.3 以下------你不想让助教把时态讲得一回一个样。
五、第三步:拼消息,看清"记忆"的真相(chat.py)
python
SYSTEM_PROMPT = """你是「启明英语」培训机构的在线助教,名字叫小E。

你的职责:
1. 用中文答疑,涉及英语的部分保留英文原文并给出中文说明
2. 回答控制在 3 句话以内,老师用它备课,不需要客套话
3. 遇到不确定的语法点,直接说"这个我不确定",不要编规则

你的语气:像带了一年班的助教,直接、具体、不绕弯。
"""


def build_messages(
    question: str,
    history: list[tuple[str, str]] | None = None,
    system: str = SYSTEM_PROMPT,
) -> list[SystemMessage | HumanMessage | AIMessage]:
    """把一次提问组装成模型认识的消息列表。

    history : [(用户说的话, 助手回的话), ...],按时间从早到晚排
    """
    # system 永远排第一
    messages: list[SystemMessage | HumanMessage | AIMessage] = [SystemMessage(content=system)]

    # 历史轮次拆成 user / assistant 交替的形式
    for user_text, assistant_text in history or []:
        messages.append(HumanMessage(content=user_text))
        messages.append(AIMessage(content=assistant_text))

    # 最后才是本次提问
    messages.append(HumanMessage(content=question))
    return messages


def ask(question: str, llm: BaseChatModel, history=None) -> str:
    """问一句,拿一句答案。

    参数里接收 llm 而不是自己创建,这是"依赖注入":
    谁调用谁负责传模型进来,测试时塞假模型就完事了。
    """
    messages = build_messages(question, history=history)
    response = llm.invoke(messages)
    # 模型返回的是 AIMessage 对象,文本在 .content 里
    return response.content
跑一下这个函数,看看多轮对话到底长什么样:
python
msgs = build_messages(
    '那过去式呢?',
    history=[('I have finished my homework this morning 对吗?',
              '不对,this morning 是过去时间,要用一般过去时。')],
)
真实输出:
css
1. [SystemMessage] 你是「启明英语」培训机构的在线助教,名字叫小E。  你的职责: 1. 用中文答疑,涉及英语的
2. [HumanMessage] I have finished my homework this morning 对吗?
3. [AIMessage] 不对,this morning 是过去时间,要用一般过去时。
4. [HumanMessage] 那过去式呢?
共 4 条消息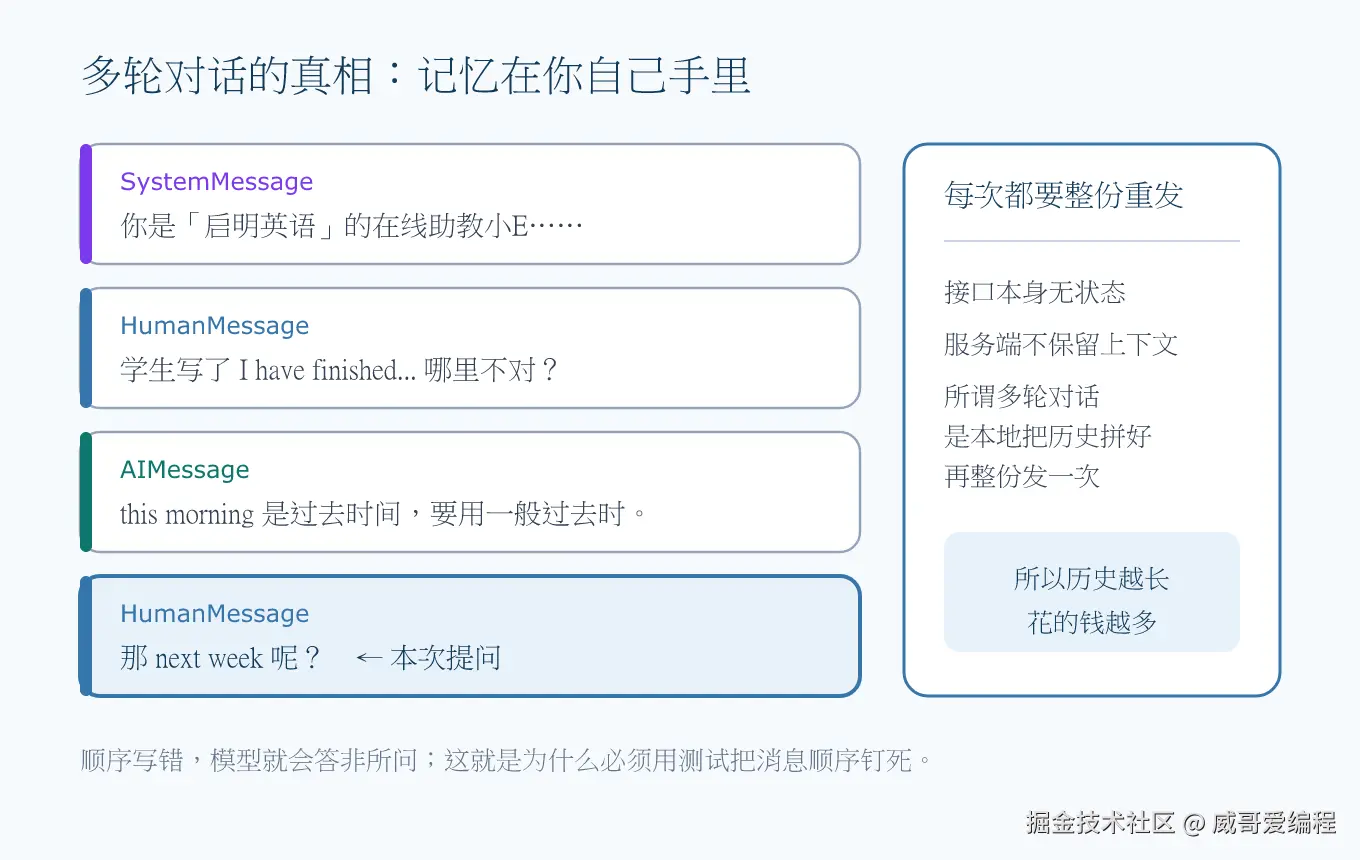
请把这张图记牢:所谓的对话记忆,不是一个存在服务端的聊天记录,而是你本地的一个列表,每次请求原封不动再发一遍。 到第 3 篇讲上下文裁剪时,你才会明白为什么账单会失控、为什么聊久了模型会"失忆"。
另外注意 ask() 的写法:它接收 llm 作为参数,而不是自己 build_llm()。这叫依赖注入,看起来多此一举,但它是整个项目能被测试的前提------测试时塞进假模型,一个字都不用改。
六、第四步:先用 LangGraph 打个底(graph.py)
有同学问我:LangChain 和 LangGraph 到底什么关系?
一句话区分:LangChain 管"怎么调模型",LangGraph 管"好几步之间怎么流转"。 单轮问答看不出区别,一旦要做"查词典 → 判断要不要继续 → 组织答案"这种循环,手写 while 循环很快就会变成一坨面条。
第 1 篇先搭个只有单节点的空壳,后面加节点就是填空题:
python
from langchain_core.language_models import BaseChatModel
from langgraph.graph import END, START, StateGraph
from langgraph.graph.message import MessagesState

from chat import build_messages


def build_graph(llm: BaseChatModel) -> StateGraph:
    """搭一个只有单个节点的图:进来 → 问模型 → 出去。

    MessagesState 是 LangGraph 内置的状态结构,
    本质就是一个带 messages 键的字典,
    并且约定:节点返回的消息会"追加"而不是"覆盖"。
    """

    def call_model(state: MessagesState) -> dict:
        """节点函数:签名固定是"进状态,出字典"。

        返回的键必须和状态里的键同名,
        LangGraph 拿到后按既定规则合并回去。
        """
        response = llm.invoke(state["messages"])
        # 返回列表,LangGraph 会追加到历史里
        return {"messages": [response]}

    graph = StateGraph(MessagesState)
    graph.add_node("assistant", call_model)  # 注册节点
    graph.add_edge(START, "assistant")       # 入口指向这个节点
    graph.add_edge("assistant", END)         # 这个节点结束就收工
    return graph.compile()


def run_graph(question: str, llm: BaseChatModel) -> str:
    """用图的方式跑一次问答。"""
    app = build_graph(llm)
    result = app.invoke({"messages": build_messages(question)})
    # result 是完整状态;[-1] 是最后一条,也就是助手的回答
    return result["messages"][-1].content
MessagesState 的关键约定我标在图上了:节点返回列表,LangGraph 是追加到历史,而不是覆盖。 这是新手最常写错的地方------返回 dict 覆盖会导致历史丢失,模型每次都当你在问第一句。
七、跑起来:真实输出
配好依赖后,我把 .env 留空(不配 Key)直接跑演示脚本:
kotlin
==========================================================
  StudyBuddy · 第 1 篇:环境与首次调用
==========================================================
  接口地址:https://api.deepseek.com
  使用模型:deepseek-flash
  API Key :未配置 → 本次走离线演示

  >>> 提问:学生写了 I have finished my homework this morning,哪里不对?
  <<< 回答:时态用错了。this morning 是明确的过去时间,不能用现在完成时,
      改成 I finished my homework this morning。

  >>> 提问:在机场问登机口怎么走,怎么说比较自然?
  <<< 走 LangGraph 图:最自然的说法是 Could you tell me where Gate 23 is?
      加 Could 比直接 Where is 更礼貌。

  离线模式下答案是预置的,为的是先把链路跑通;
把 DEEPSEEK_API_KEY 写进 .env,同样的代码就能拿到真实回答。链路由此证明是通的:两条不同路径(直接 ask 和走 LangGraph 图)拿到了同一个模型的回答。 你把 .env 里的 Key 填上,不改一行代码,答案就变成真实大模型给的。
再跑测试:
ini
platform darwin -- Python 3.13.12, pytest-9.1.1, pluggy-1.7.0
plugins: langsmith-0.14.12, anyio-4.15.1
collecting ... collected 15 items

tests/test_chat.py::test_system_message_always_first PASSED              [  6%]
tests/test_chat.py::test_last_message_is_the_question PASSED             [ 13%]
tests/test_chat.py::test_history_is_expanded_in_order PASSED             [ 20%]
tests/test_chat.py::test_ask_returns_model_text PASSED                   [ 26%]
tests/test_chat.py::test_ask_really_sends_history PASSED                 [ 33%]
tests/test_graph.py::test_graph_has_expected_node PASSED                 [ 40%]
tests/test_graph.py::test_graph_returns_last_message PASSED              [ 46%]
tests/test_graph.py::test_graph_appends_not_overwrites PASSED            [ 53%]
tests/test_llm.py::test_offline_mode_returns_usable_model PASSED         [ 60%]
tests/test_llm.py::test_missing_key_raises_actionable_error PASSED       [ 66%]
tests/test_llm.py::test_offline_mode_never_touches_network PASSED        [ 73%]
tests/test_settings.py::test_defaults_point_to_official_endpoint PASSED  [ 80%]
tests/test_settings.py::test_missing_key_is_not_confidential PASSED      [ 86%]
tests/test_settings.py::test_read_env_file PASSED                        [ 93%]
tests/test_settings.py::test_settings_is_frozen PASSED                   [100%]

============================== 15 passed in 2.28s ==============================
15 个用例全绿,全程离线、零花费。 这条线是我给自己定的验收标准,也是这篇教程对你最硬的承诺:后面每一篇的代码都必须这样------你可以不花钱就把测试跑通。
其中我最看重那个 test_ask_really_sends_history。一开始我图省事写了个占位断言,等于自我安慰。重写后用一个会记录入参的假模型,真正断言"历史确实被塞进了请求"。写测试最怕的就是断言了一个恒真的东西。
八、踩过的坑,先替你填了
which python还是系统路径 :说明虚拟环境没激活。每条新开的终端都要source .venv/bin/activate,激活成功提示符前有(.venv)。ModuleNotFoundError: No module named 'chat':直接python demo.py找不到src/下的模块。我在demo.py头部加了把src塞进sys.path的三行;规范做法是写成可安装的包,但那要引入打包工具,第 1 篇先不增加负担。- 镜像源 403 / 超时 :清华源这次对
langchain-deepseek返回 403,换阿里云源一次成功。换源重试是标准操作,不用怀疑人生。 - 模型名 404 :确认你用的是
deepseek-flash,不是已退役的deepseek-chat。 base_url多加了/v1:DeepSeek 用根路径,加了会报莫名其妙的错。- Key 写进了代码还推了仓库:立刻去平台删除重建。亡羊补牢也要做,公开仓库的 Key 几分钟就会被扫走。
pytest收集不到用例 :检查是不是缺pytest.ini,或者文件名没写成test_*.py。
九、这一篇留下了什么
一个配了 Key 就调真模型、不配 Key 也能跑通全流程的工程骨架,加上 15 个离线可跑的测试。四个模块分工清楚:settings 管配置、llm 管模型通路、chat 管消息、graph 管编排。
下一篇我们解决一个更刺眼的问题:同样是这句 system prompt,为什么你的助教说话像换了个人? 我会带你把 Prompt 拆成可配置模板,讲清 temperature、少样本示例、思维链分别管什么,并用一个真实的"作文批改"场景让你看见改一个参数答案能差多远。
最后一句:环境配不稳,不是因为你笨,是因为没人把"为什么"讲给你听------把为什么弄明白,那些报错你自己就能读懂了。